
{count, plural, one {Kursus} other {Kursus}}
Google: Agent Fundamentals
{hours} jam
819
Lanskap AI pada pertengahan 2026 dipenuhi model frontier monolitik yang bersaing pada skor tolok ukur mentah. Sakana AI mengambil pendekatan berbeda: alih-alih melatih model dasar yang lebih besar, mereka merilis Fugu, sebuah sistem yang mengorkestrasi kumpulan model frontier yang sudah ada di balik satu API yang kompatibel dengan OpenAI.
Klaim utamanya adalah bahwa Sakana Fugu Ultra menyamai Fable 5 dan Mythos Preview dari Anthropic pada tolok ukur rekayasa, sains, dan penalaran, tanpa memerlukan akses ke salah satu model yang dibatasi ekspor tersebut.
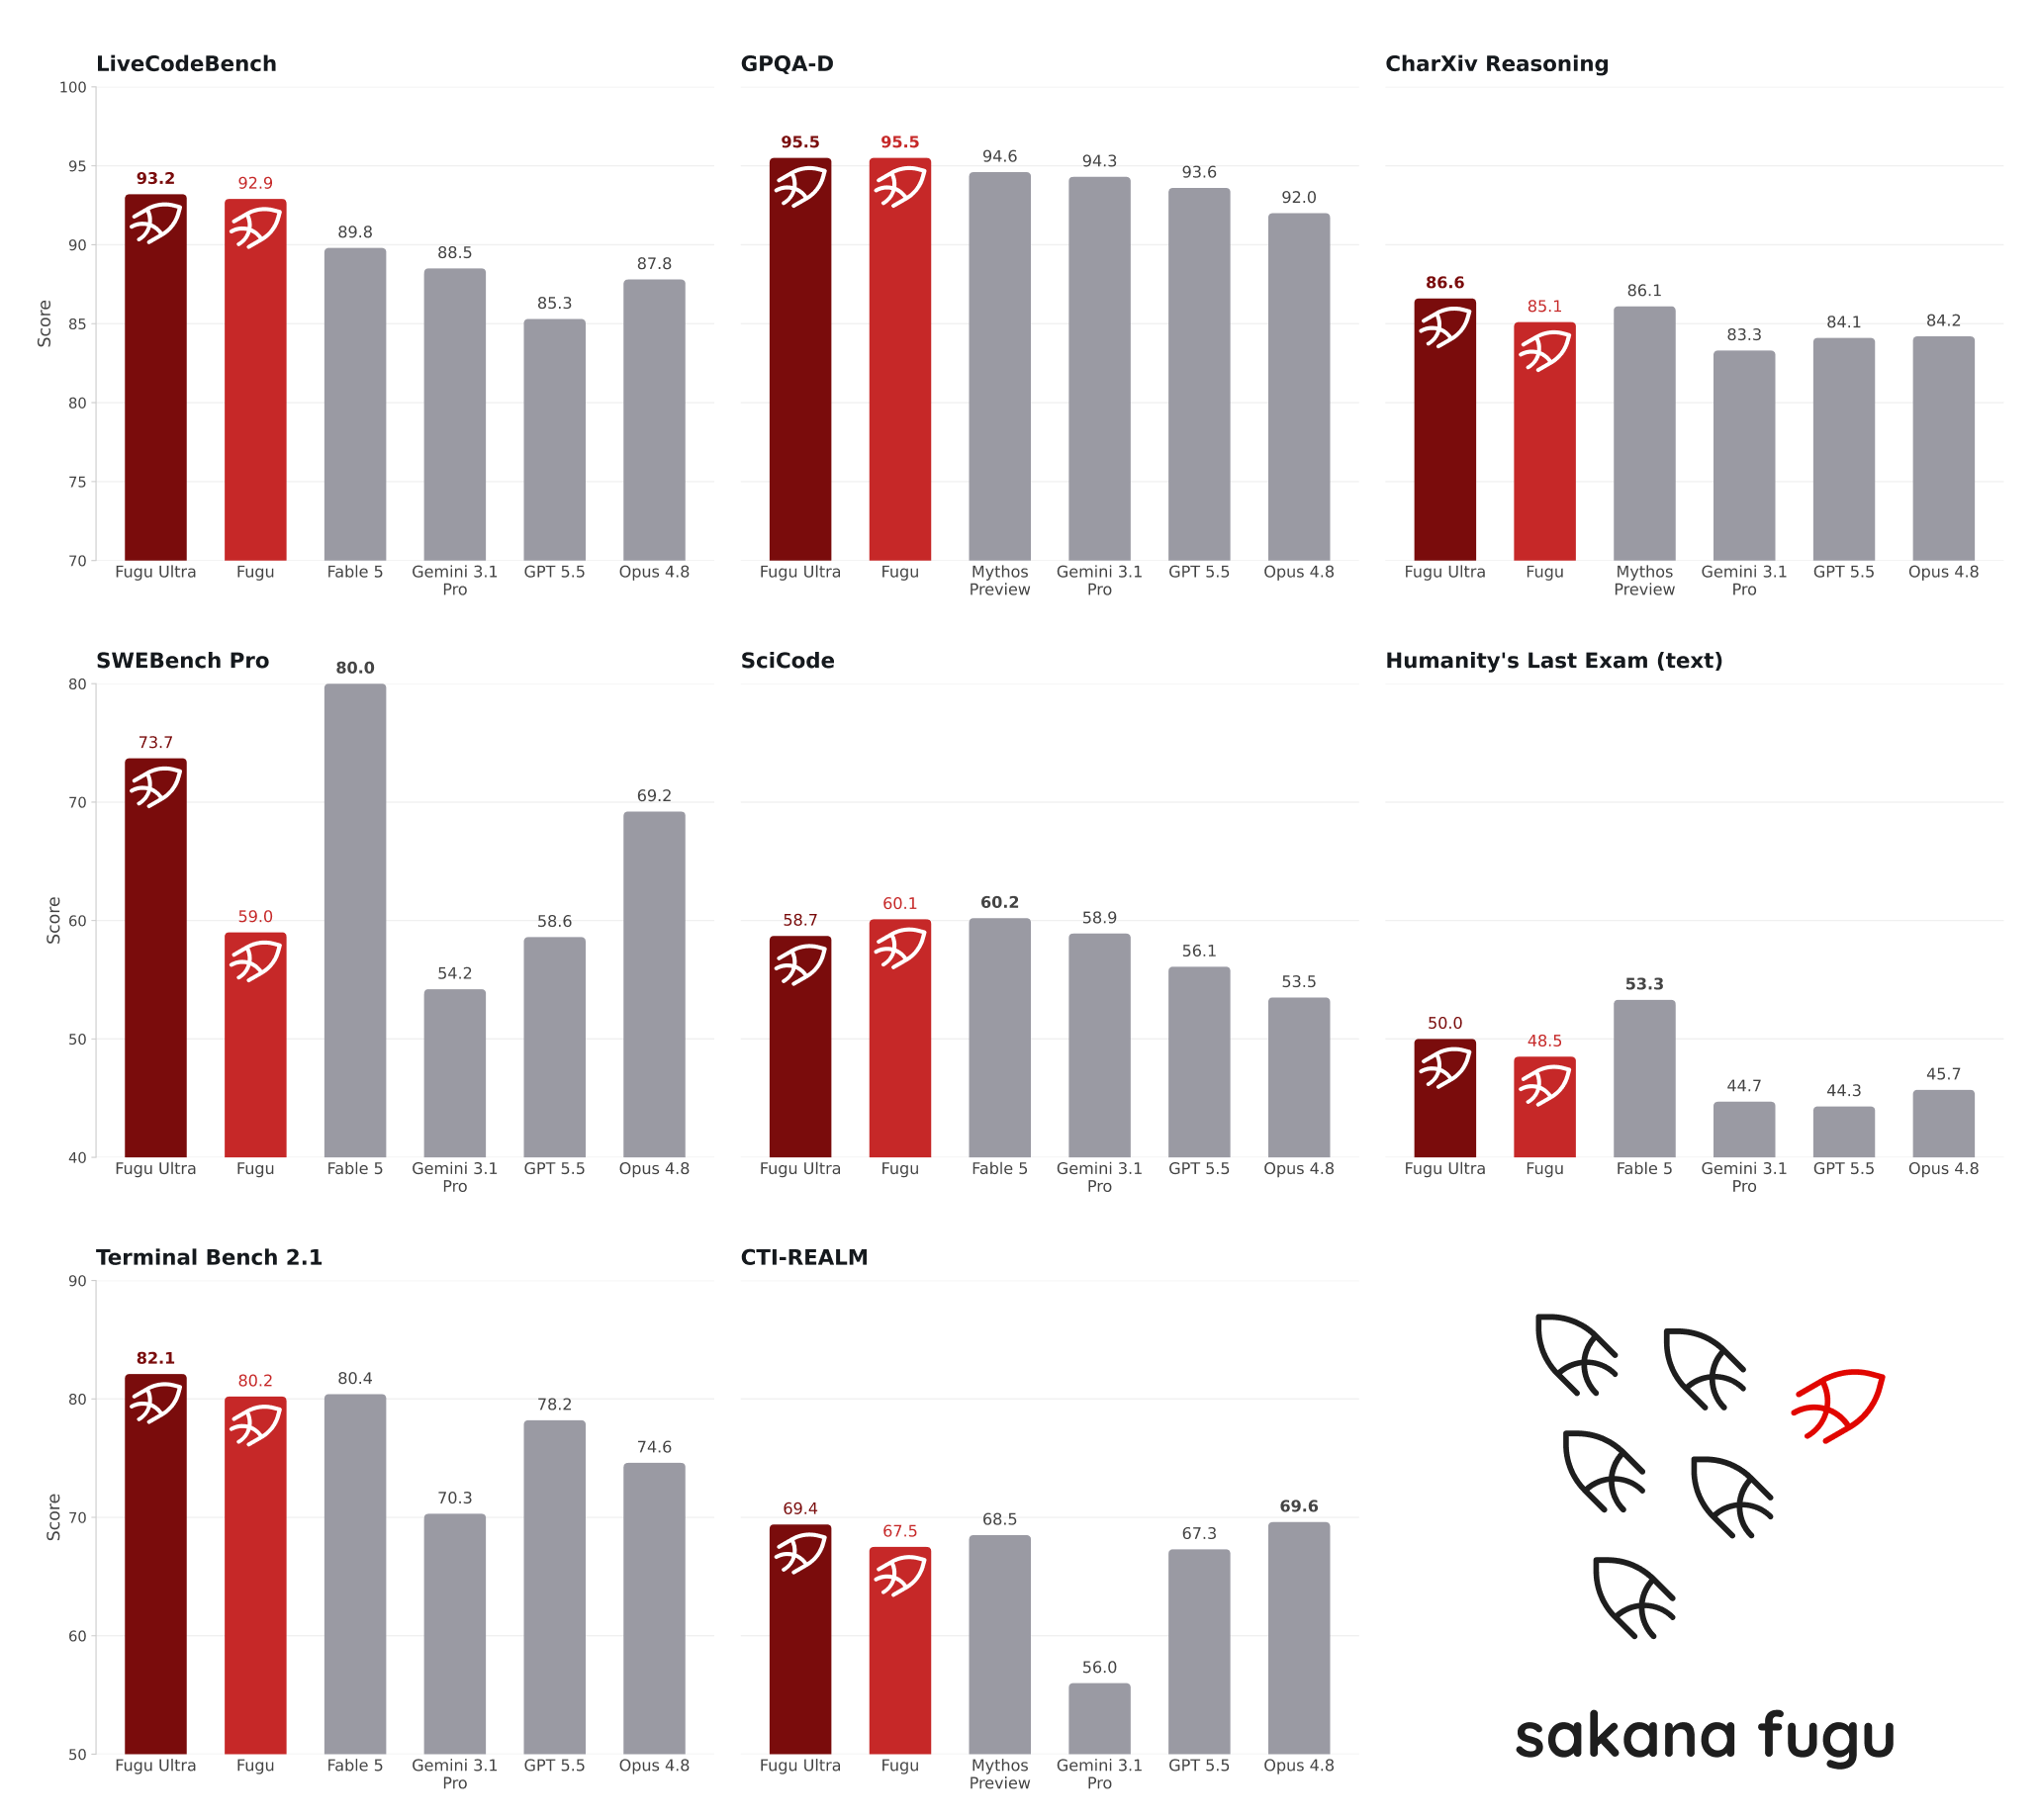
Sakana Fugu diluncurkan pada 22 Juni 2026 dalam dua varian: Fugu untuk pekerjaan sehari-hari yang sensitif terhadap latensi, dan Fugu Ultra untuk tugas kompleks multi-langkah. Pada SWE-Bench Pro, Fugu Ultra meraih skor 73,7%, di depan Claude Opus 4.8 (69,2%), GPT-5.5 (58,6%), dan Gemini 3.1 Pro (54,2%).
Semua angka tolok ukur dilaporkan oleh Sakana dan belum direproduksi secara independen oleh laboratorium pihak ketiga, yang patut diingat saat Anda membaca.
Dalam artikel ini, saya akan membahas apa sebenarnya Fugu, mengulas fitur-fitur utamanya, melihat tabel tolok ukur lengkap, dan meninjau beberapa kasus penggunaan. Anda juga dapat melihat perbandingan kami GPT-5.5 vs Gemini 3.1 Pro untuk konteks model yang menjadi pesaing Fugu.
Sakana Fugu adalah model bahasa yang dilatih untuk bertindak sebagai orkestrator: menerima permintaan, memutuskan apakah akan menanganinya langsung atau mendelegasikannya ke model spesialis dalam kumpulan agennya, mengelola verifikasi dan sintesis, lalu mengembalikan satu respons. Dari luar, Anda memanggil satu endpoint. Di dalamnya, serangkaian model yang terkoordinasi melakukan pekerjaan tersebut.
Sakana AI telah membangun menuju arsitektur ini sejak didirikan. Lab yang didirikan oleh Llion Jones (salah satu penulis makalah asli "Attention Is All You Need") dan David Ha ini sejak lama berpendapat bahwa ekosistem model yang terkoordinasi mengungguli monolit yang terisolasi pada tugas-tugas sulit dan berdurasi panjang.
Fugu adalah versi produk dari tesis tersebut, didasarkan pada dua makalah ICLR 2026: TRINITY (koordinator LLM yang berevolusi) dan Conductor (pembelajaran untuk mengorkestrasi agen dalam bahasa alami).
Pada saat penulisan, Fable 5 dan Mythos Preview dari Anthropic tidak dapat diakses publik karena pembatasan ekspor, yang berarti keduanya tidak dapat dimasukkan ke dalam kumpulan agen Fugu.
Argumen Sakana adalah bahwa perutean di seluruh kumpulan model yang dapat ditukar memberikan lindung nilai praktis terhadap gangguan akses seperti ini. Apakah itu merupakan "kedaulatan AI" yang sejati masih bisa diperdebatkan, tetapi logika operasionalnya masuk akal: jika satu penyedia membatasi akses, Fugu mencari jalur lain.
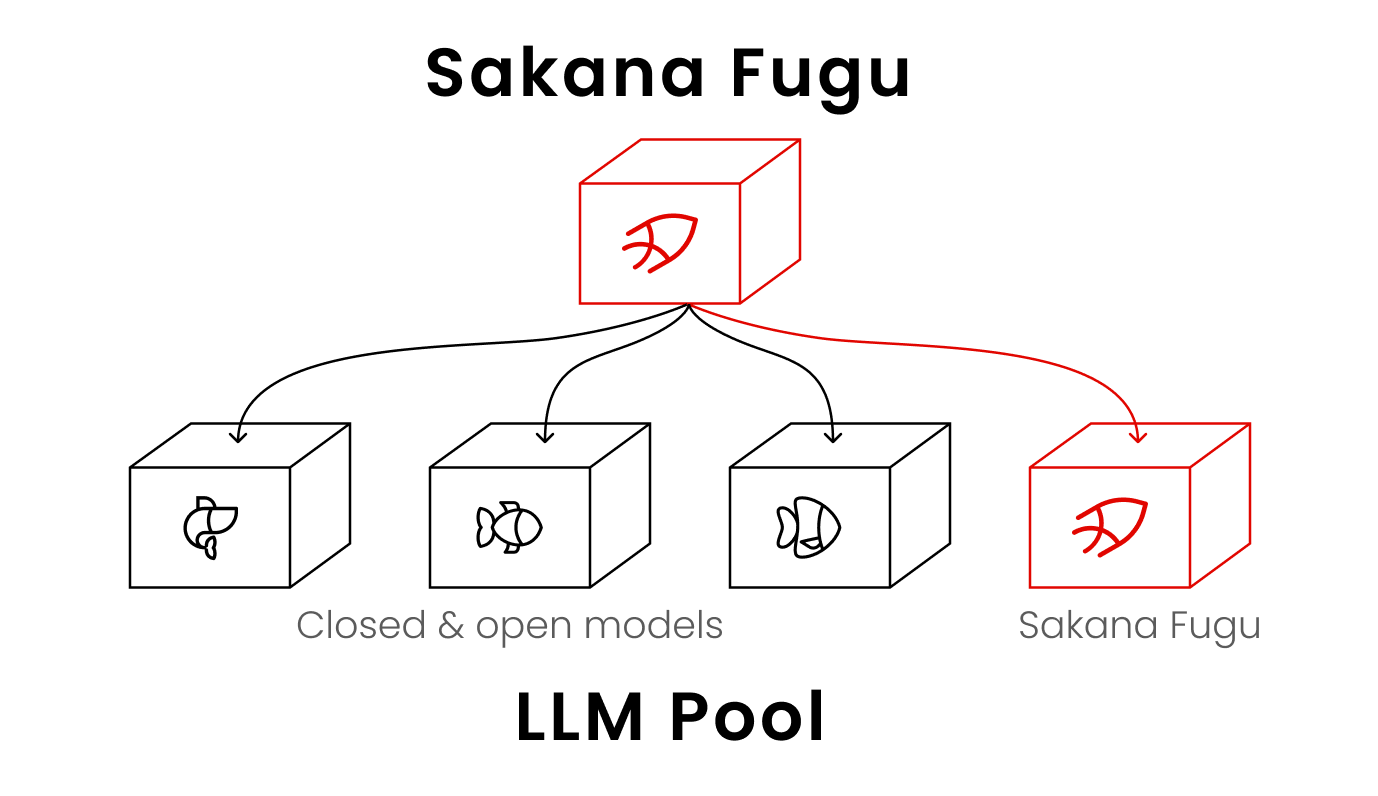
Fugu memperkenalkan beberapa gagasan yang membedakannya dari model frontier konvensional maupun kerangka multi-agen tradisional. Saya bahas yang utama di bawah ini.
Kebanyakan sistem multi-agen mengharuskan pengembang menentukan model mana yang menangani tugas mana. Fugu mempelajarinya. Model orkestrator dilatih untuk memutuskan kapan mendelegasikan, bagaimana agen harus berkomunikasi, dan bagaimana menggabungkan keluaran mereka menjadi satu jawaban. Ini adalah kontribusi inti dari riset TRINITY dan Conductor yang saya tautkan di atas.
Dalam praktiknya, ini berarti kompleksitas sistem multi-agen tidak pernah sampai ke kode Anda. Anda mengirim permintaan ke satu endpoint, dan Fugu menangani pemilihan model, pendelegasian, verifikasi, dan sintesis secara internal. Bagi tim yang pernah mencoba membangun lapisan orkestrasi sendiri, daya tariknya jelas: Anda mendapatkan keuntungan koordinasi tanpa harus memelihara harness.
Satu catatan penting: keputusan perutean bersifat proprietari dan tidak diekspos ke pengguna. Anda tidak dapat melihat model mana yang menangani sebuah permintaan. Untuk pekerjaan yang sensitif kepatuhan di mana Anda perlu mengaudit rantai penalaran, opasitas ini merupakan keterbatasan nyata.
Model dalam kumpulan Fugu tidak tetap. Ketika model frontier baru tersedia untuk publik, Sakana memperkirakan membutuhkan sekitar dua minggu untuk melatih dan mengevaluasi model Fugu yang diperbarui sebelum merilisnya. Ini berarti kinerja Fugu seharusnya meningkat seiring perbaikan ekosistem yang mendasarinya, tanpa mengharuskan pengguna mengubah integrasinya.
Untuk model Fugu standar, pengguna juga dapat memilih untuk mengecualikan agen tertentu dari kumpulan melalui pengaturan konsol, yang penting bagi tim dengan persyaratan privasi data atau kepatuhan. Kumpulan agen Fugu Ultra bersifat tetap karena bergantung pada set agen penuh untuk memberikan kinerja tolok ukurnya.
Fugu dan Fugu Ultra melayani beban kerja yang berbeda. Fugu menyeimbangkan kualitas dengan latensi rendah, menjadikannya pilihan wajar untuk pemrograman, tinjauan kode, dan layanan interaktif. Fugu Ultra mengoordinasikan kumpulan agen ahli yang lebih dalam dan disetel untuk kualitas jawaban maksimal pada masalah sulit multi-langkah.
Pengguna awal menggunakan Fugu Ultra untuk tugas seperti reproduksi makalah, analisis keamanan siber, data science ala Kaggle, dan investigasi paten.
Seorang insinyur perangkat lunak dalam beta melaporkan bahwa Fugu Ultra menemukan lebih dari dua puluh isu tinjauan kode, sementara alat lain menandai sekitar tiga.
Seorang insinyur keamanan siber melaporkan bahwa satu instruksi yang dibatasi ruang lingkup mendorong penilaian keamanan lengkap dari ujung ke ujung, termasuk laporan bersih dengan bukti dan langkah uji ulang.
Menurut saya, patut dicatat bahwa kompromi latensi ini nyata. Perutean dan sintesis multi-agen menambah overhead. Untuk kueri sederhana atau kebutuhan latensi ketat, panggilan langsung ke satu model frontier kemungkinan akan lebih cepat dan lebih murah.
Baik Fugu maupun Fugu Ultra dapat diakses melalui satu API yang kompatibel dengan OpenAI. Tidak diperlukan migrasi SDK.
Anda mengarahkan klien yang ada ke endpoint Fugu dengan kunci API Anda dan mulai mengirim permintaan. Ini adalah pilihan sengaja untuk menurunkan biaya peralihan bagi tim yang sudah menggunakan GPT-5.5 atau Claude Opus 4.8 melalui pustaka klien OpenAI.
Menurut tabel perbandingan Sakana, Fugu Ultra memimpin 10 dari 11 tolok ukur, dengan GPT-5.5 hanya menang di MRCRv2. Semua skor, kecuali milik Fugu, adalah laporan dari penyedia. Fable 5 dan Mythos Preview dikecualikan dari perbandingan karena tidak dapat diakses publik dan karenanya tidak dapat berada di kumpulan agen Fugu.
Reproduksi independen dari angka-angka ini belum muncul di papan peringkat pihak ketiga sejauh yang saya lihat saat penulisan.
| Tolok ukur | Fugu | Fugu Ultra | Opus 4.8 † | Gemini 3.1 Pro † | GPT 5.5 † |
|---|---|---|---|---|---|
| SWE Bench Pro * | 59.0 | 73.7 | 69.2 | 54.2 | 58.6 |
| TerminalBench 2.1 | 80.2 | 82.1 | 74.6 | 70.3 | 78.2 |
| LiveCodeBench | 92.9 | 93.2 | 87.8 | 88.5 | 85.3 |
| LiveCodeBench Pro | 87.8 | 90.8 | 84.8 | 82.9 | 88.4 |
| Humanity's Last Exam | 47.2 | 50.0 | 49.8 | 44.4 | 41.4 |
| CharXiv Reasoning | 85.1 | 86.6 | 84.2 | 83.3 | 84.1 |
| GPQA-D | 95.5 | 95.5 | 92.0 | 94.3 | 93.6 |
| SciCode | 60.1 | 58.7 | 53.5 | 58.9 | 56.1 |
| τ3 Banking | 21.7 | 20.6 | 20.6 | 8.4 | 20.6 |
| Long Context Reasoning | 74.7 | 73.3 | 67.7 | 72.7 | 74.3 |
| MRCRv2 | 86.6 | 93.6 | 87.9 | 84.9 | 94.8 |
Fugu Ultra meraih 73,7% pada SWE-Bench Pro, di depan Claude Opus 4.8 dengan 69,2%, GPT-5.5 dengan 58,6%, dan Gemini 3.1 Pro dengan 54,2%. Dalam peliputan kami tentang GPT-5.5, kami mencatat skornya 58,6% pada tolok ukur ini, yang dilampaui Fugu Ultra sebesar 15 poin.
SWE-Bench Pro menguji apakah model dapat menyelesaikan isu GitHub nyata dalam repositori perangkat lunak, menjadikannya salah satu tolok ukur pemrograman yang paling berlandaskan praktik. Kesenjangan antara Fugu Ultra dan model terbaik berikutnya yang dapat diakses publik cukup besar untuk berdampak bagi tim yang melakukan tinjauan kode serius atau pekerjaan perbaikan bug.
Fugu Ultra mencetak 93,2% pada LiveCodeBench dan 90,8% pada LiveCodeBench Pro. Skor terbaik berikutnya adalah Gemini 3.1 Pro dengan 88,5% dan Claude Opus 4.8 dengan 87,8% pada versi standar.
LiveCodeBench menguji masalah pemrograman kompetitif yang diambil dari kontes terbaru, yang berarti risiko kontaminasi data pelatihan lebih rendah dibanding tolok ukur pemrograman yang lebih lama. Varian Pro menggunakan masalah yang lebih sulit. Keunggulan Fugu di sini konsisten dengan laporan beta mengenai performa tinjauan kode yang kuat.
Fugu Ultra meraih 50,0% pada Humanity's Last Exam, dibandingkan dengan Claude Opus 4.8 di 49,8%, Gemini 3.1 Pro di 44,4%, dan GPT-5.5 di 41,4%.
Tolok ukur ini menguji pengetahuan tingkat ahli di berbagai domain ilmiah dan akademik, dengan pertanyaan yang dirancang sulit bahkan bagi spesialis domain. Skor 50% pada tolok ukur ini patut dicatat mengingat GPT-5.5 berada di 41,4%. Kesenjangan antara Fugu Ultra dan GPT-5.5 di sini adalah yang terbesar dari semua tolok ukur dalam tabel.
Baik Fugu maupun Fugu Ultra meraih 95,5% pada GPQA Diamond, dengan Gemini 3.1 Pro di 94,3%, GPT-5.5 di 93,6%, dan Claude Opus 4.8 di 92,0%.
GPQA Diamond menguji pertanyaan sains tingkat PhD dalam biologi, kimia, dan fisika, ditulis oleh pakar domain dan diverifikasi sulit bagi non-spesialis. Fakta bahwa Fugu standar menyamai Fugu Ultra di sini menunjukkan overhead orkestrasi pada tolok ukur ini tidak banyak menambah, yang masuk akal untuk tugas tanya jawab yang tidak memerlukan perencanaan multi-langkah.
Fugu Ultra meraih 82,1% pada TerminalBench 2.1, di depan GPT-5.5 dengan 78,2%, Claude Opus 4.8 dengan 74,6%, dan Gemini 3.1 Pro dengan 70,3%. TerminalBench menguji tugas pemrograman berbasis agen yang memerlukan interaksi dengan lingkungan terminal, termasuk manipulasi berkas, perintah shell, dan eksekusi multi-langkah.
Ini adalah salah satu tolok ukur yang paling relevan dengan alur kerja pengembang nyata, dan keunggulan Fugu Ultra atas GPT-5.5 di sini konsisten dengan kasus penggunaan penilaian keamanan siber yang dilaporkan dalam beta.
GPT-5.5 menang di MRCRv2 dengan 94,8%, dibandingkan Fugu Ultra di 93,6% dan Claude Opus 4.8 di 87,9%. MRCRv2 menguji pengingatan konteks panjang, khususnya apakah model dapat mengambil informasi spesifik dari dokumen yang sangat panjang.
Ini adalah satu-satunya tolok ukur di mana Fugu Ultra tidak memimpin, yang patut dicatat bagi tim yang kasus penggunaannya terutama melibatkan pengambilan fakta spesifik dari dokumen besar, alih-alih penalaran multi-langkah atau generasi kode.
Fugu tersedia sekarang melalui konsol Sakana di console.sakana.ai, dengan API yang kompatibel dengan OpenAI. Baik Fugu maupun Fugu Ultra termasuk dalam setiap paket. Tingkatan langganannya adalah:
Paket pay-as-you-go menagih berdasarkan penggunaan token alih-alih jatah bulanan. Untuk Fugu Ultra (ID model: fugu-ultra-20260615), harga adalah $5 per satu juta token masukan dan $30 per satu juta token keluaran untuk panjang konteks standar.
Untuk konteks di atas 272K token, tarif meningkat menjadi $10 untuk masukan dan $45 untuk keluaran. Masukan yang di-cache dikenai $0,50 per satu juta token, atau $1,00 di atas 272K. Harga standar Fugu mengikuti tarif model dasar mana pun yang aktif, dan Sakana tidak menumpuk biaya saat beberapa agen berjalan bersamaan.
Satu batasan regional yang perlu dicatat: Fugu saat ini tidak tersedia di negara anggota UE atau EEA, sementara Sakana menyelesaikan kepatuhan GDPR. Bagi tim Eropa, ini menjadi penghalang untuk saat ini. Sakana belum memublikasikan lini masa untuk ketersediaan di UE.
Fugu benar-benar merupakan pertaruhan yang berbeda dari apa yang dilakukan OpenAI, Anthropic, dan Google. Alih-alih bersaing pada skala model dasar, Sakana berargumen bahwa orkestrasi yang dipelajari di atas kumpulan model frontier yang dapat ditukar dapat menyamai atau mengungguli sistem individual mana pun pada tugas-tugas yang benar-benar memakan waktu: tinjauan kode panjang, riset multi-langkah, penilaian keamanan, dan reproduksi makalah.
Angka-angka tolok ukur, jika bertahan pada verifikasi independen, mendukung argumen tersebut pada sebagian besar metrik yang penting bagi pengembang. Tentu saja, sampai kita mendapatkan akses lagi ke Fable 5 dan Mythos, kita tidak bisa membandingkan langsung dengan keduanya.
Meski begitu, tentu ada beberapa catatan penting.
Semua skor tolok ukur dilaporkan oleh Sakana. Lapisan perutean bersifat buram, yang menimbulkan friksi untuk pekerjaan yang sensitif terhadap kepatuhan. Pengecualian UE/EEA membatasi adopsi bagi porsi besar komunitas pengembang global. Dan kompromi latensi pada tugas sederhana memang nyata: jika Anda membuat panggilan API cepat dan satu putaran, overhead orkestrasi Fugu Ultra adalah biaya murni tanpa manfaat.
Menurut saya, Fugu punya kasus kuat untuk tim yang menjalankan alur kerja agen berjangka panjang dan sudah mengelola kompleksitas penyiapan multi-model sendiri. Jika Anda memelihara harness orkestrasi di atas Claude dan GPT, Fugu Ultra layak dievaluasi serius.
Kerangka kedaulatan mungkin terlalu dilebih-lebihkan, tetapi nilai praktis dari satu endpoint yang dapat menghindari gangguan penyedia jelas terasa.
Jika Anda ingin mempercepat pemahaman tentang lanskap AI agen tempat Fugu beroperasi, saya sarankan mulai dari AI Agent Fundamentals skill track di DataCamp, yang membahas dasar-dasar model bahasa besar, agen, dan sistem multi-model.
Kursus Teratas di DataCamp
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Program} other {Program}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt




