
{count, plural, one {Cursus} other {Cursussen}}
Google: Agent Fundamentals
{hours} uur
819
Het AI-landschap midden 2026 is drukbezet met monolithische frontiermodellen die concurreren op ruwe benchmarkscoren. Sakana AI kiest een andere richting: in plaats van een groter basismodel te trainen, heeft het Fugu gelanceerd, een systeem dat een pool van bestaande frontiermodellen orkestreert achter één OpenAI-compatibele API.
De kopclaim is dat Sakana Fugu Ultra kan tippen aan Anthropic's Fable 5 en Mythos Preview op engineering-, wetenschappelijke en redeneerbenchmarks, zonder toegang te vereisen tot een van die exportgecontroleerde modellen.
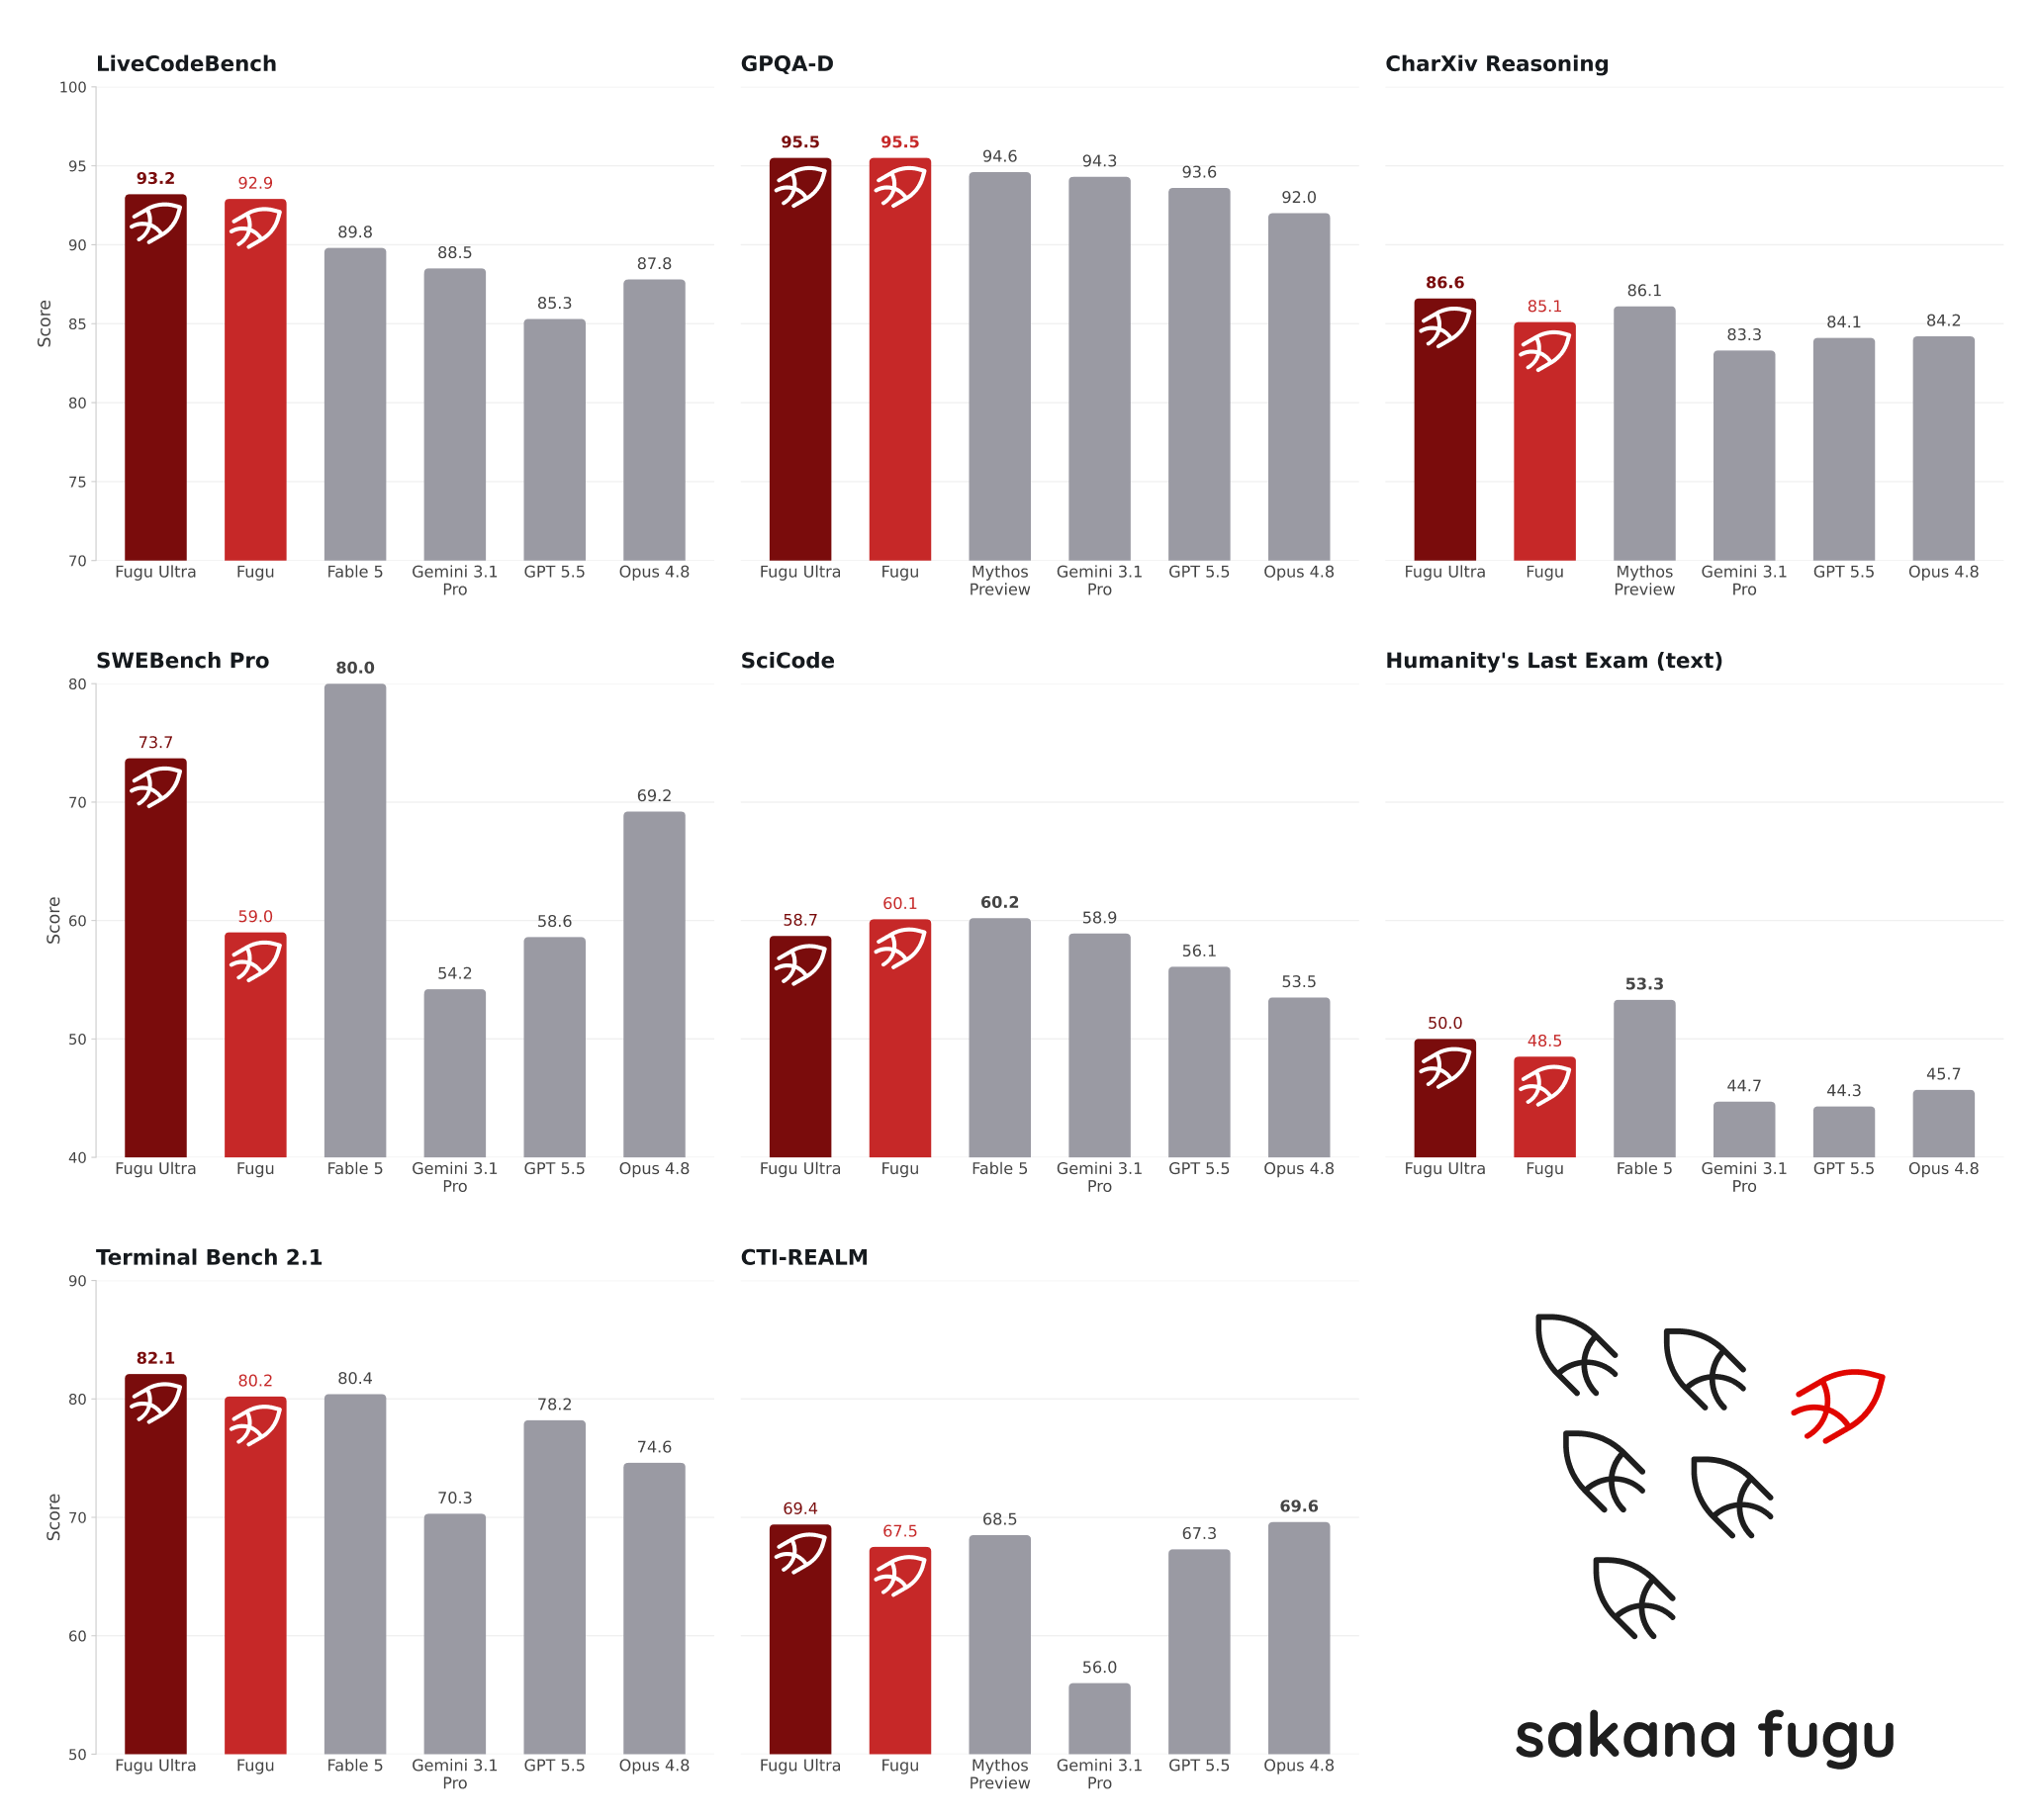
Sakana Fugu lanceerde op 22 juni 2026 in twee varianten: Fugu voor alledaagse, latency-gevoelige taken, en Fugu Ultra voor complexe, meerstapsopdrachten. Op SWE-Bench Pro scoort Fugu Ultra 73,7%, boven Claude Opus 4.8 (69,2%), GPT-5.5 (58,6%) en Gemini 3.1 Pro (54,2%).
Alle benchmarkcijfers zijn door Sakana gerapporteerd en zijn nog niet onafhankelijk gereproduceerd door derden, iets om in gedachten te houden tijdens het lezen.
In dit artikel leg ik uit wat Fugu precies is, loop ik door de belangrijkste functies, bekijken we de volledige benchmarktabel en enkele use-cases. Je kunt ook onze vergelijking van GPT-5.5 vs Gemini 3.1 Pro bekijken voor context over de modellen waar Fugu tegen concurreert.
Sakana Fugu is een taalmodel dat is getraind om als orkestrator te handelen: het ontvangt een verzoek, beslist of het dit direct afhandelt of delegeert aan specialistische modellen in zijn agentpool, beheert verificatie en synthese, en retourneert één antwoord. Van buitenaf roep je één endpoint aan. Van binnenuit doet een gecoördineerde set modellen het werk.
Sakana AI bouwt al sinds de oprichting richting deze architectuur. Het lab, gestart door Llion Jones (mede-auteur van het originele "Attention Is All You Need"-paper) en David Ha, stelt al langer dat gecoördineerde modelecosystemen beter presteren dan geïsoleerde monolieten bij moeilijke, langlopende taken.
Fugu is de geproductiseerde versie van die these, verankerd in twee ICLR 2026-papers: TRINITY (een geëvolueerde LLM-coördinator) en Conductor (leren agents te orkestreren in natuurlijke taal).
Op het moment van schrijven zijn Fable 5 en Mythos Preview van Anthropic niet publiek toegankelijk vanwege exportbeperkingen, wat betekent dat ze niet kunnen worden opgenomen in Fugu's agentpool.
Sakana's stelling is dat routering over een verwisselbare pool van modellen een praktische hedge biedt tegen precies dit soort toegangsverstoringen. Of dat echte "AI-soevereiniteit" vormt, is discutabel, maar de operationele logica is solide: als een provider de toegang beperkt, routeert Fugu eromheen.
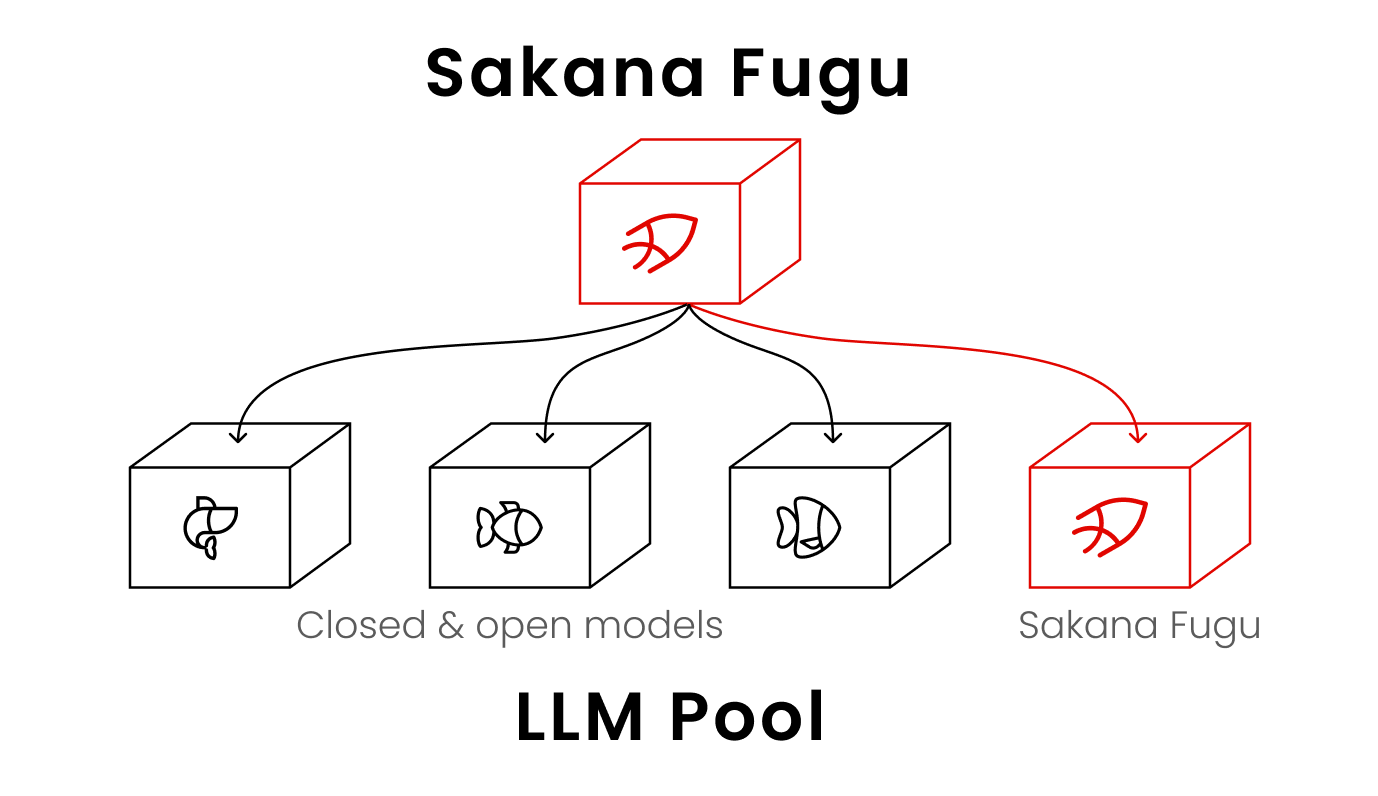
Fugu introduceert verschillende ideeën die het onderscheiden van zowel conventionele frontiermodellen als traditionele multi-agentraamwerken. Ik behandel de belangrijkste hieronder.
De meeste multi-agentsystemen vereisen dat ontwikkelaars definiëren welk model welke taak afhandelt. Fugu leert dit. Het orkestratormodel is getraind om te beslissen wanneer te delegeren, hoe agents moeten communiceren, en hoe hun outputs te combineren tot één antwoord. Dit is de kernbijdrage uit het TRINITY- en Conductor-onderzoek waar ik hierboven naar linkte.
In de praktijk betekent dit dat de complexiteit van een multi-agentsysteem je code nooit bereikt. Je stuurt een verzoek naar één endpoint, en Fugu handelt modelselectie, delegatie, verificatie en synthese intern af. Voor teams die hun eigen orkestratielaag hebben geprobeerd te bouwen, is de aantrekkingskracht duidelijk: je krijgt de coördinatiewinst zonder de harnas te hoeven onderhouden.
Eén kanttekening om te benoemen: de routeringsbeslissingen zijn proprietair en niet zichtbaar voor gebruikers. Je kunt niet zien welk onderliggend model een bepaald verzoek heeft afgehandeld. Voor compliance-gevoelig werk waarbij je de redeneerketen moet kunnen auditen, is deze ondoorzichtigheid een echte beperking.
De modellen in Fugu's pool liggen niet vast. Wanneer een nieuw frontiermodel publiek beschikbaar komt, verwacht Sakana ongeveer twee weken te besteden aan training en evaluatie van bijgewerkte Fugu-modellen voordat ze worden uitgerold. Dit betekent dat Fugu's prestaties moeten verbeteren naarmate het onderliggende ecosysteem verbetert, zonder dat gebruikers hun integratie hoeven aan te passen.
Voor het standaard Fugu-model kunnen gebruikers ook specifieke agents uit de pool uitsluiten via de console-instellingen, wat van belang is voor teams met vereisten rond gegevensprivacy of compliance. De pool van Fugu Ultra ligt vast omdat het op de volledige set agents steunt om zijn benchmarkprestaties te leveren.
Fugu en Fugu Ultra bedienen verschillende workloads. Fugu balanceert kwaliteit met lage latency, waardoor het een redelijk standaardmodel is voor coderen, code review en interactieve services. Fugu Ultra coördineert een diepere pool van expertagents en is afgestemd op maximale antwoordkwaliteit bij moeilijke, meerstapsproblemen.
Vroege gebruikers kozen Fugu Ultra voor taken als paperreproductie, cybersecurityanalyse, Kaggle-achtige data science en octrooionderzoek.
Een software engineer in de bèta meldde dat Fugu Ultra meer dan twintig code-reviewissues naar voren bracht, terwijl andere tools er ongeveer drie markeerden.
Een cybersecurity-engineer meldde dat één afgebakende instructie een volledige security assessment van begin tot eind aanstuurde, inclusief een helder rapport met bewijs en herteststappen.
Het is de moeite waard hier te benadrukken dat de latencyaftoets reëel is. De multi-agentroutering en -synthese voegen overhead toe. Voor eenvoudige vragen of strakke latency-eisen zal een directe call naar één enkel frontiermodel waarschijnlijk sneller en goedkoper zijn.
Zowel Fugu als Fugu Ultra zijn toegankelijk via één OpenAI-compatibele API. Er is geen SDK-migratie nodig.
Je wijst je bestaande client naar het Fugu-endpoint met je API-sleutel en begint verzoeken te sturen. Dit is een bewuste keuze om de overstapkosten te verlagen voor teams die al GPT-5.5 of Claude Opus 4.8 gebruiken via de OpenAI-clientbibliotheek.
Volgens Sakana's vergelijkings tabel voert Fugu Ultra 10 van de 11 benchmarks aan, met GPT-5.5 dat alleen MRCRv2 wint. Alle scores, behalve die van Fugu, zijn door de providers gerapporteerd. Fable 5 en Mythos Preview zijn uitgesloten van de vergelijking omdat ze niet publiek toegankelijk zijn en daarom niet in Fugu's agentpool kunnen zitten.
Onafhankelijke reproducties van deze cijfers zijn voor zover ik heb gezien op het moment van schrijven nog niet verschenen op derde-partij-leaderboards.
| Benchmark | Fugu | Fugu Ultra | Opus 4.8 † | Gemini 3.1 Pro † | GPT 5.5 † |
|---|---|---|---|---|---|
| SWE Bench Pro * | 59.0 | 73.7 | 69.2 | 54.2 | 58.6 |
| TerminalBench 2.1 | 80.2 | 82.1 | 74.6 | 70.3 | 78.2 |
| LiveCodeBench | 92.9 | 93.2 | 87.8 | 88.5 | 85.3 |
| LiveCodeBench Pro | 87.8 | 90.8 | 84.8 | 82.9 | 88.4 |
| Humanity's Last Exam | 47.2 | 50.0 | 49.8 | 44.4 | 41.4 |
| CharXiv Reasoning | 85.1 | 86.6 | 84.2 | 83.3 | 84.1 |
| GPQA-D | 95.5 | 95.5 | 92.0 | 94.3 | 93.6 |
| SciCode | 60.1 | 58.7 | 53.5 | 58.9 | 56.1 |
| τ3 Banking | 21.7 | 20.6 | 20.6 | 8.4 | 20.6 |
| Long Context Reasoning | 74.7 | 73.3 | 67.7 | 72.7 | 74.3 |
| MRCRv2 | 86.6 | 93.6 | 87.9 | 84.9 | 94.8 |
Fugu Ultra scoort 73,7% op SWE-Bench Pro, vóór Claude Opus 4.8 met 69,2%, GPT-5.5 met 58,6% en Gemini 3.1 Pro met 54,2%. In onze berichtgeving over GPT-5.5 noteerden we 58,6% op deze benchmark, wat Fugu Ultra met 15 punten overtreft.
SWE-Bench Pro test of een model echte GitHub-issues in software-repositories kan oplossen, waardoor het een van de meest praktijkgerichte codeerbenchmarks is. Het verschil tussen Fugu Ultra en het volgende publiek toegankelijke model is groot genoeg om te tellen voor teams die serieuze code reviews of bugfixing doen.
Fugu Ultra scoort 93,2% op LiveCodeBench en 90,8% op LiveCodeBench Pro. De volgende beste scores zijn Gemini 3.1 Pro met 88,5% en Claude Opus 4.8 met 87,8% op de standaardversie.
LiveCodeBench test competitive programming-problemen uit recente wedstrijden, wat betekent dat het risico op contaminatie van trainingsdata lager is dan bij oudere codeerbenchmarks. De Pro-variant gebruikt moeilijkere problemen. Fugu's voorsprong hier is in lijn met de bètarapporten over sterke prestaties bij code review.
Fugu Ultra scoort 50,0% op Humanity's Last Exam, vergeleken met Claude Opus 4.8 op 49,8%, Gemini 3.1 Pro op 44,4% en GPT-5.5 op 41,4%.
Deze benchmark test kennis op expertniveau over wetenschappelijke en academische domeinen, met vragen die zelfs voor vakspecialisten lastig zijn. Een score van 50% is opvallend, gezien GPT-5.5 op 41,4% zit. Het gat tussen Fugu Ultra en GPT-5.5 is hier het grootst van alle benchmarks in de tabel.
Zowel Fugu als Fugu Ultra scoren 95,5% op GPQA Diamond, met Gemini 3.1 Pro op 94,3%, GPT-5.5 op 93,6% en Claude Opus 4.8 op 92,0%.
GPQA Diamond test vragen op PhD-niveau in biologie, scheikunde en natuurkunde, geschreven door domeinexperts en geverifieerd als moeilijk voor niet-specialisten. Dat de standaard Fugu hier gelijk scoort aan Fugu Ultra suggereert dat de orkestratie-overhead op deze benchmark weinig toevoegt, wat logisch is voor een vraag-antwoordtaak die geen meerstapsplanning vereist.
Fugu Ultra scoort 82,1% op TerminalBench 2.1, boven GPT-5.5 met 78,2%, Claude Opus 4.8 met 74,6% en Gemini 3.1 Pro met 70,3%. TerminalBench test agentische coderingstaken die interactie met een terminalomgeving vereisen, inclusief bestandsmanipulatie, shellcommando's en meerstapsuitvoering.
Dit is een van de benchmarks die het meest relevant is voor echte ontwikkelaarsworkflows, en Fugu Ultra's voorsprong op GPT-5.5 is hier consistent met de cybersecurity-assessment use-case die in de bèta werd gemeld.
GPT-5.5 wint MRCRv2 met 94,8%, vergeleken met Fugu Ultra op 93,6% en Claude Opus 4.8 op 87,9%. MRCRv2 test lang-contextherinnering, specifiek of een model specifieke informatie uit zeer lange documenten kan ophalen.
Dit is de ene benchmark waar Fugu Ultra niet aan kop gaat, wat relevant is voor teams wiens primaire use-case draait om het ophalen van specifieke feiten uit grote documenten in plaats van meerstapsredeneren of codegeneratie.
Fugu is nu beschikbaar via Sakana's console op console.sakana.ai, met een OpenAI-compatibele API. Zowel Fugu als Fugu Ultra zijn inbegrepen in elk abonnement. De abonnementsniveaus zijn:
Het pay-as-you-go-abonnement rekent op tokenverbruik in plaats van een maandelijkse bundel. Voor Fugu Ultra (model-ID: fugu-ultra-20260615) is de prijs $5 per miljoen inputtokens en $30 per miljoen outputtokens voor standaard contextlengtes.
Voor contexten boven 272K tokens stijgen de tarieven naar $10 input en $45 output. Gecachte input kost $0,50 per miljoen tokens, of $1,00 boven 272K. Fugu's standaardprijzen volgen het tarief van het onderliggende model dat actief is, en Sakana stapelt geen kosten wanneer meerdere agents draaien.
Eén regionale beperking om te benoemen: Fugu is momenteel niet beschikbaar in EU- of EER-lidstaten, terwijl Sakana werkt aan GDPR-compliance. Voor Europese teams is dit voorlopig een blocker. Sakana heeft geen tijdlijn voor EU-beschikbaarheid gepubliceerd.
Fugu is echt een andere inzet dan wat OpenAI, Anthropic en Google doen. In plaats van te concurreren op schaal van basismodellen, stelt Sakana dat geleerde orkestratie over een verwisselbare pool van frontiermodellen kan evenaren of overtreffen wat een individueel systeem kan op de taken die daadwerkelijk tijd kosten: lange code reviews, meerstapsonderzoek, security assessments en paperreproductie.
De benchmarkcijfers, als ze standhouden bij onafhankelijke verificatie, ondersteunen dat betoog op de meeste metrics die ertoe doen voor ontwikkelaars. Natuurlijk kunnen we, totdat we weer toegang krijgen tot Fable 5 en Mythos, daar niet direct mee vergelijken.
Dat gezegd hebbende, zijn er zeker kanttekeningen.
Alle benchmarkscores zijn door Sakana gerapporteerd. De routeringslaag is ondoorzichtig, wat wrijving geeft bij compliance-gevoelig werk. De uitsluiting van EU/EER beperkt de adoptie voor een aanzienlijk deel van de wereldwijde ontwikkelaarscommunity. En de latencyaftoets bij eenvoudige taken is echt: als je snelle, single-turn API-calls maakt, is Fugu Ultra's orkestratie-overhead pure kost zonder voordeel.
Waar Fugu volgens mij echt kans maakt, is bij teams die langetermijn agentische workflows draaien en nu al de complexiteit van multimodelopstellingen zelf beheren. Als je je eigen orkestratieharnas bovenop Claude en GPT onderhoudt, is Fugu Ultra een serieuze evaluatie waard.
Het soevereiniteitsframe is waarschijnlijk overschat, maar de praktische waarde van één endpoint dat om providerstoringen heen routeert, is dat niet.
Als je snel wilt bijspijkeren over het agentische AI-landschap waarin Fugu opereert, raad ik aan te beginnen met de AI Agent Fundamentals skill track op DataCamp, die de basis behandelt van large language models, agents en multimodelsystemen.
Topcursussen op DataCamp
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Leerpad} other {Leerpaden}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min

