
Last chance! 50% off DataCamp Premium
Sale ends in
Il panorama dell’AI a metà 2026 è affollato di modelli monolitici di frontiera che competono sui punteggi grezzi dei benchmark. Sakana AI sta scommettendo in modo diverso: invece di addestrare un modello base più grande, ha lanciato Fugu, un sistema che orchestra un pool di modelli di frontiera esistenti dietro un’unica API compatibile con OpenAI.
La promessa principale è che Sakana Fugu Ultra eguaglia Fable 5 e Mythos Preview di Anthropic su benchmark di ingegneria, scienza e ragionamento, senza richiedere l’accesso a nessuno di questi modelli soggetti a controlli all’esportazione.
Sakana Fugu è stato lanciato il 22 giugno 2026 in due varianti: Fugu per il lavoro quotidiano sensibile alla latenza e Fugu Ultra per compiti complessi e multi-step. Su SWE-Bench Pro, Fugu Ultra segna il 73,7%, davanti a Claude Opus 4.8 (69,2%), GPT-5.5 (58,6%) e Gemini 3.1 Pro (54,2%).
Tutti i numeri dei benchmark sono riportati da Sakana e non sono ancora stati riprodotti in modo indipendente da laboratori terzi; è un aspetto da tenere a mente mentre leggi.
In questo articolo spiego cos’è davvero Fugu, ne illustro le funzionalità chiave, passo in rassegna l’intera tabella dei benchmark e alcuni casi d’uso. Per un confronto sul contesto dei modelli contro cui Fugu compete, vedi anche il nostro confronto GPT-5.5 vs Gemini 3.1 Pro.
Sakana Fugu è un modello linguistico addestrato ad agire da orchestratore: riceve una richiesta, decide se gestirla direttamente o delegarla a modelli specialistici nel suo pool di agenti, gestisce verifica e sintesi e restituisce una singola risposta. Dall’esterno, chiami un solo endpoint. All’interno, è un insieme coordinato di modelli a svolgere il lavoro.
Sakana AI ha lavorato verso questa architettura sin dalla sua fondazione. Il laboratorio, avviato da Llion Jones (coautore dell’articolo originale “Attention Is All You Need”) e David Ha, sostiene da tempo che ecosistemi di modelli coordinati superino i monoliti isolati su compiti difficili e di lunga durata.
Fugu è la versione prodotto di questa tesi, basata su due articoli ICLR 2026: TRINITY (un coordinatore LLM evoluto) e Conductor (apprendere a orchestrare agenti in linguaggio naturale).
Al momento in cui scrivo, Fable 5 e Mythos Preview di Anthropic non sono pubblicamente accessibili a causa dei controlli all’esportazione, il che significa che non possono essere inclusi nel pool di agenti di Fugu.
L’argomento di Sakana è che l’instradamento su un pool di modelli intercambiabili offre una copertura pratica proprio contro questo tipo di interruzione di accesso. Che ciò costituisca una vera “sovranità dell’AI” è discutibile, ma la logica operativa è solida: se un provider limita l’accesso, Fugu lo aggira.
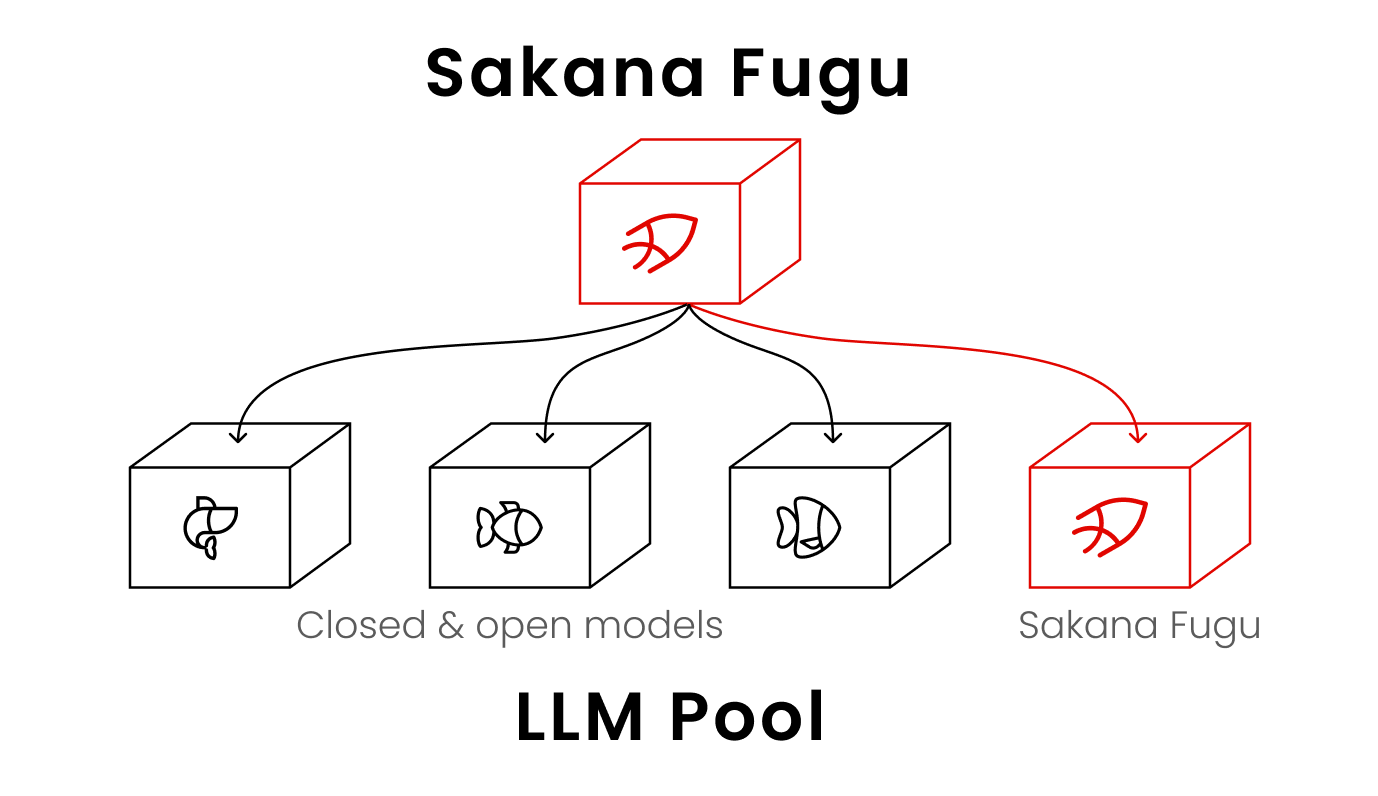
Fugu introduce diverse idee che lo distinguono sia dai modelli di frontiera convenzionali sia dai framework multi-agente tradizionali. Qui sotto ho riassunto le principali.
La maggior parte dei sistemi multi-agente richiede che gli sviluppatori definiscano quale modello gestisce quale attività. Fugu lo apprende. Il modello orchestratore è addestrato a decidere quando delegare, come dovrebbero comunicare gli agenti e come combinare i loro output in un’unica risposta. Questo è il contributo centrale della ricerca TRINITY e Conductor citata sopra.
In pratica, ciò significa che la complessità di un sistema multi-agente non arriva mai nel tuo codice. Invi una richiesta a un solo endpoint e Fugu gestisce internamente selezione dei modelli, delega, verifica e sintesi. Per i team che hanno provato a costruire propri livelli di orchestrazione, il vantaggio è evidente: ottieni i benefici della coordinazione senza dover mantenere l’harness.
Una precisazione importante: le decisioni di instradamento sono proprietarie e non esposte agli utenti. Non puoi vedere quale modello sottostante ha gestito una data richiesta. Per lavori sensibili alla compliance in cui devi revisionare la catena di ragionamento, questa opacità è un limite reale.
I modelli nel pool di Fugu non sono fissi. Quando un nuovo modello di frontiera diventa pubblicamente disponibile, Sakana prevede di impiegare circa due settimane per addestrare e valutare versioni aggiornate di Fugu prima del rilascio. Questo significa che le prestazioni di Fugu dovrebbero migliorare man mano che migliora l’ecosistema sottostante, senza richiedere agli utenti di modificare l’integrazione.
Per il modello Fugu standard, gli utenti possono anche escludere agenti specifici dal pool tramite le impostazioni della console, aspetto rilevante per team con requisiti di privacy o conformità dei dati. Il pool di Fugu Ultra è fisso perché si basa sull’intero set di agenti per offrire le prestazioni di benchmark.
Fugu e Fugu Ultra servono carichi di lavoro diversi. Fugu bilancia qualità e bassa latenza, risultando una scelta ragionevole per coding, code review e servizi interattivi. Fugu Ultra coordina un pool più profondo di agenti esperti ed è calibrato per la massima qualità delle risposte su problemi difficili e multi-step.
Gli early user hanno scelto Fugu Ultra per compiti come riproduzione di paper, analisi di cybersecurity, data science in stile Kaggle e indagini su brevetti.
Un software engineer nella beta ha riportato che Fugu Ultra ha evidenziato oltre venti problemi in code review, mentre altri strumenti ne hanno segnalati circa tre.
Un ingegnere della sicurezza informatica ha riferito che una singola istruzione circoscritta ha guidato un assessment di sicurezza end-to-end, incluso un report pulito con evidenze e passi di retest.
Vale la pena notare che il compromesso sulla latenza è reale. L’instradamento e la sintesi multi-agente aggiungono overhead. Per query semplici o con requisiti di latenza stretti, una chiamata diretta a un singolo modello di frontiera sarà probabilmente più veloce ed economica.
Sia Fugu che Fugu Ultra sono accessibili tramite un’unica API compatibile con OpenAI. Non è richiesta alcuna migrazione di SDK.
Punti il client esistente all’endpoint Fugu con la tua chiave API e inizi a inviare richieste. È una scelta deliberata per ridurre i costi di switching per i team che già usano GPT-5.5 o Claude Opus 4.8 tramite la libreria client di OpenAI.
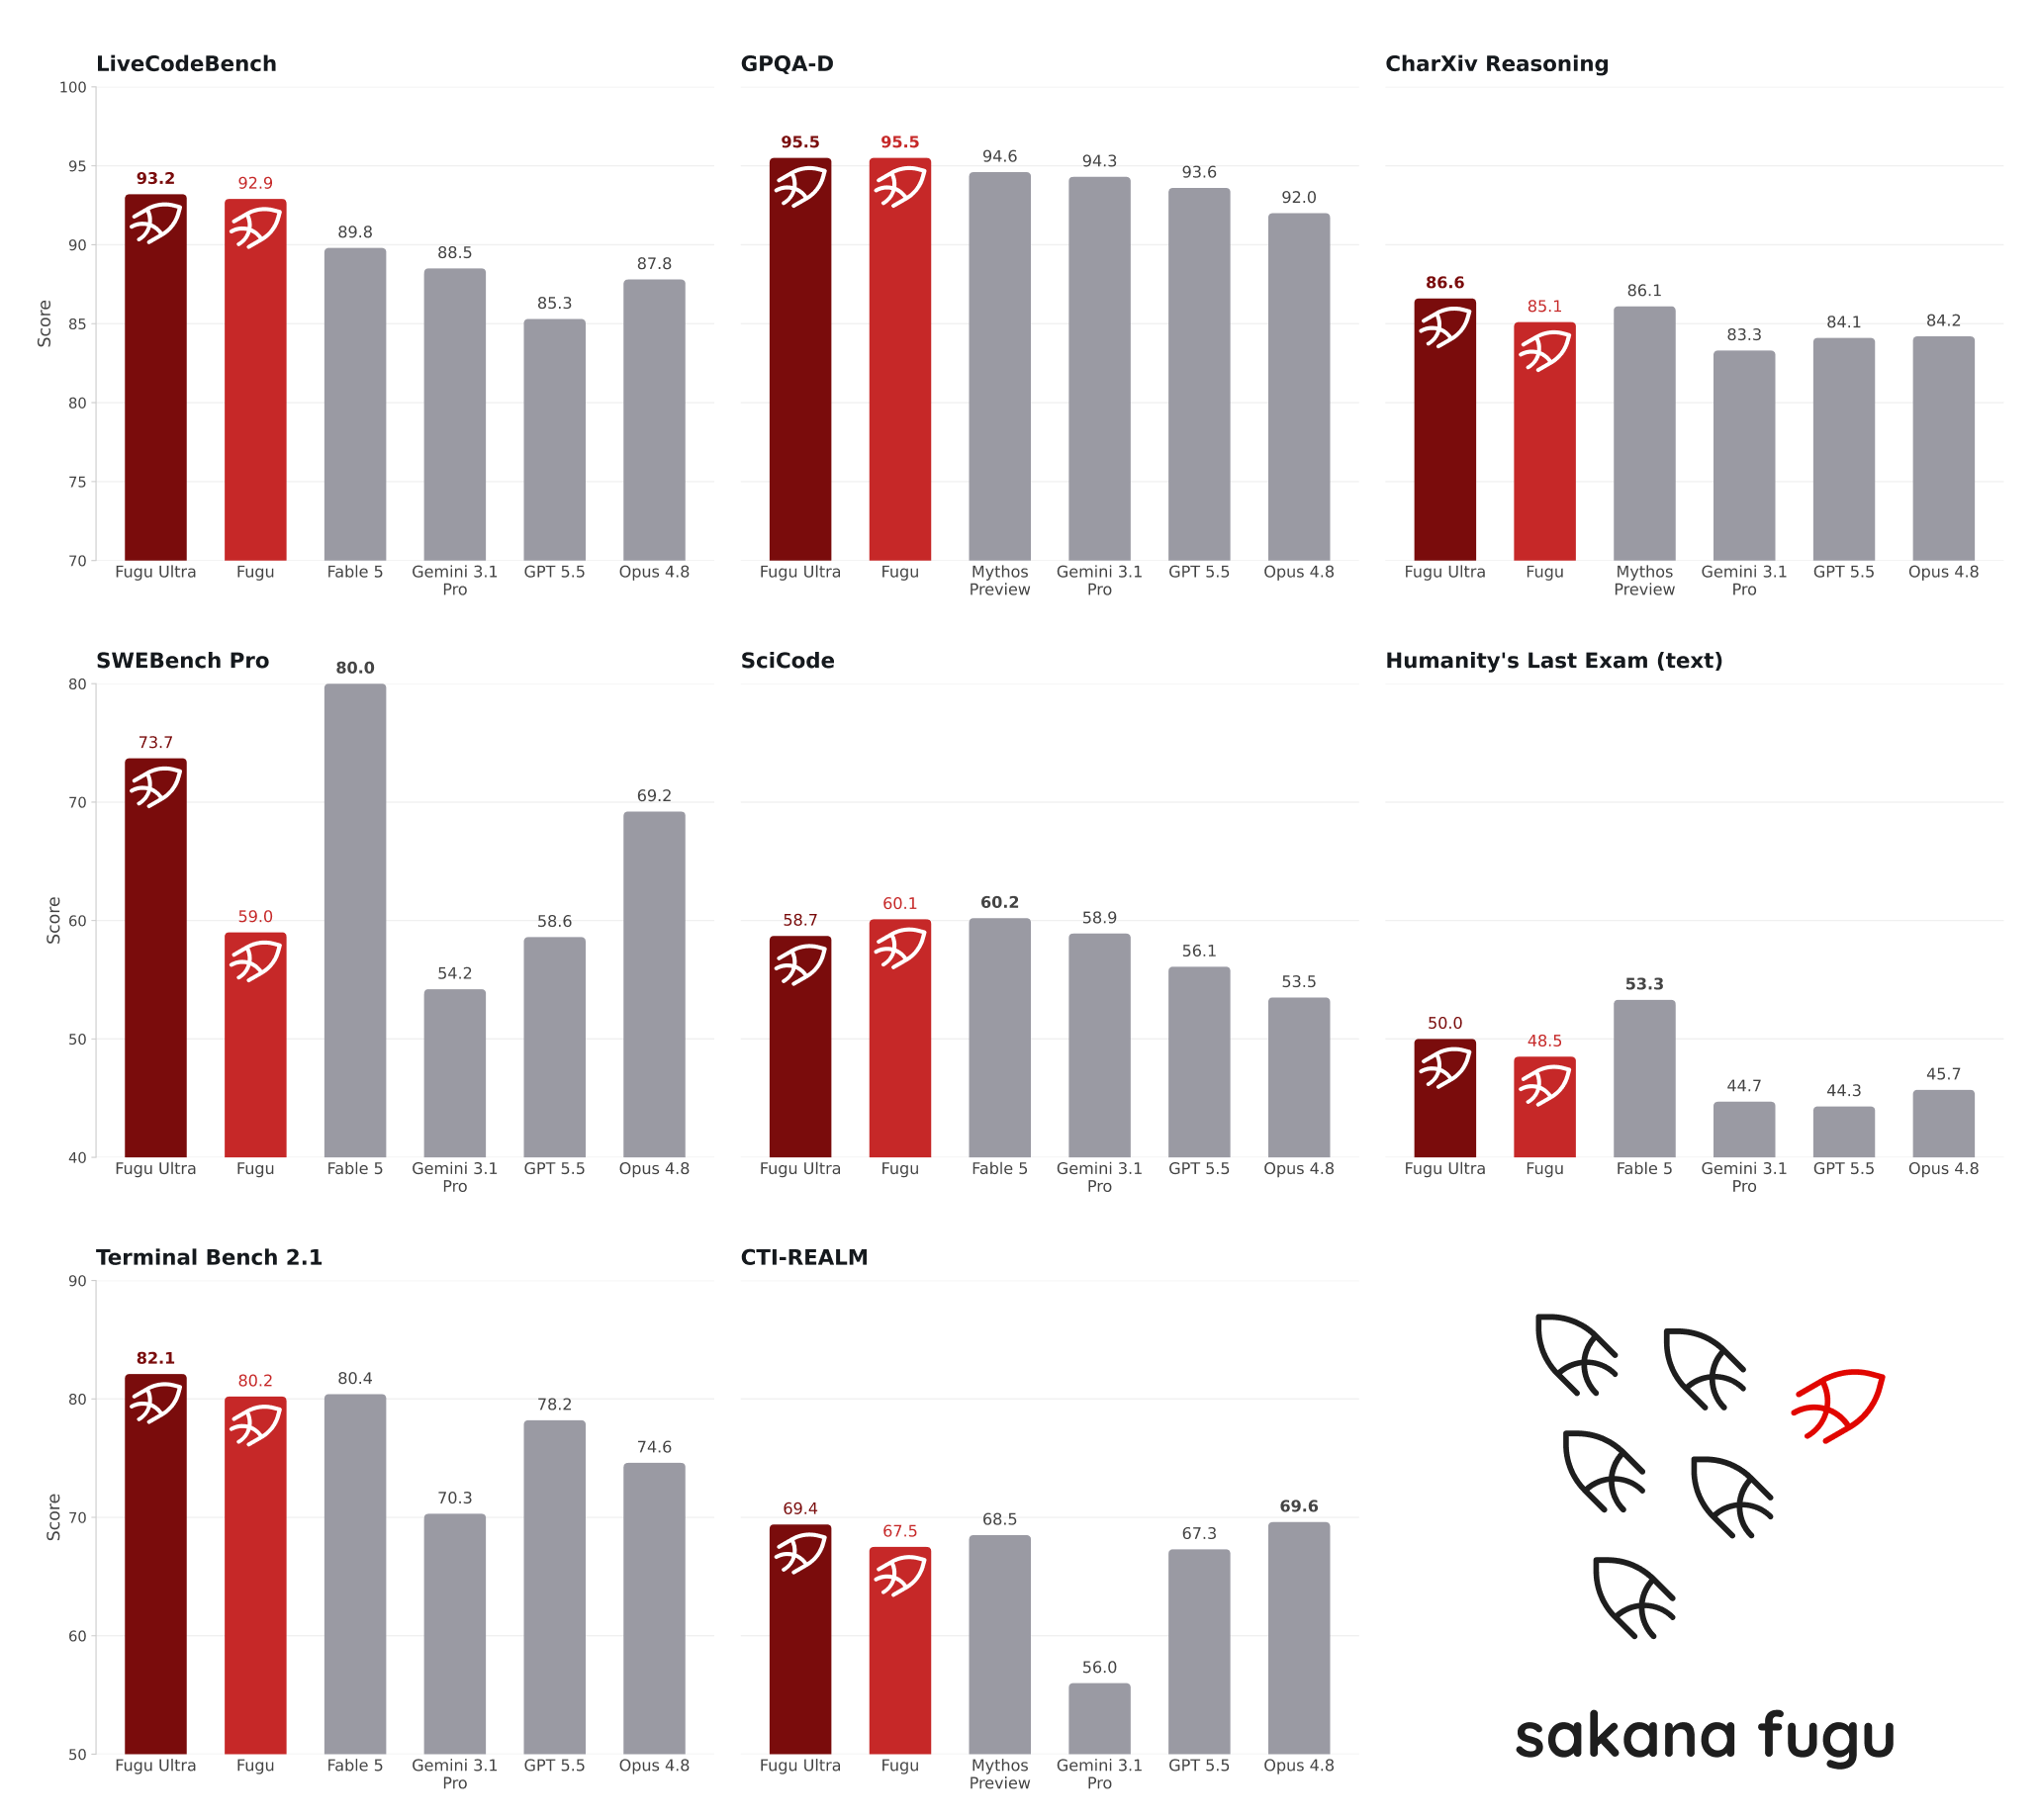
Secondo la tabella comparativa di Sakana, Fugu Ultra è in testa in 10 benchmark su 11, con GPT-5.5 che vince solo MRCRv2. Tutti i punteggi, tranne quelli di Fugu, sono riportati dai rispettivi provider. Fable 5 e Mythos Preview sono esclusi dal confronto perché non sono pubblicamente accessibili e quindi non possono essere nel pool di agenti di Fugu.
Riproduzioni indipendenti di questi numeri non sono ancora apparse su classifiche di terze parti per quanto ho visto al momento della stesura.
| Benchmark | Fugu | Fugu Ultra | Opus 4.8 † | Gemini 3.1 Pro † | GPT 5.5 † |
|---|---|---|---|---|---|
| SWE Bench Pro * | 59.0 | 73.7 | 69.2 | 54.2 | 58.6 |
| TerminalBench 2.1 | 80.2 | 82.1 | 74.6 | 70.3 | 78.2 |
| LiveCodeBench | 92.9 | 93.2 | 87.8 | 88.5 | 85.3 |
| LiveCodeBench Pro | 87.8 | 90.8 | 84.8 | 82.9 | 88.4 |
| Humanity's Last Exam | 47.2 | 50.0 | 49.8 | 44.4 | 41.4 |
| CharXiv Reasoning | 85.1 | 86.6 | 84.2 | 83.3 | 84.1 |
| GPQA-D | 95.5 | 95.5 | 92.0 | 94.3 | 93.6 |
| SciCode | 60.1 | 58.7 | 53.5 | 58.9 | 56.1 |
| τ3 Banking | 21.7 | 20.6 | 20.6 | 8.4 | 20.6 |
| Long Context Reasoning | 74.7 | 73.3 | 67.7 | 72.7 | 74.3 |
| MRCRv2 | 86.6 | 93.6 | 87.9 | 84.9 | 94.8 |
Fugu Ultra ottiene il 73,7% su SWE-Bench Pro, davanti a Claude Opus 4.8 al 69,2%, GPT-5.5 al 58,6% e Gemini 3.1 Pro al 54,2%. Nella nostra copertura di GPT-5.5, abbiamo notato che ha segnato il 58,6% su questo benchmark, che Fugu Ultra supera di 15 punti.
SWE-Bench Pro testa se un modello può risolvere issue reali su GitHub in repository software, rendendolo uno dei benchmark di coding più ancorati alla pratica. Il divario tra Fugu Ultra e il miglior modello pubblicamente accessibile successivo è abbastanza ampio da contare per i team che fanno code review seria o bug fixing.
Fugu Ultra segna il 93,2% su LiveCodeBench e il 90,8% su LiveCodeBench Pro. I punteggi successivi migliori sono Gemini 3.1 Pro all’88,5% e Claude Opus 4.8 all’87,8% sulla versione standard.
LiveCodeBench testa problemi di programmazione competitiva tratti da contest recenti, il che riduce il rischio di contaminazione dei dati di training rispetto ai benchmark di coding più vecchi. La variante Pro usa problemi più difficili. Il vantaggio di Fugu qui è coerente con i report della beta su forti prestazioni in code review.
Fugu Ultra ottiene il 50,0% su Humanity's Last Exam, rispetto a Claude Opus 4.8 al 49,8%, Gemini 3.1 Pro al 44,4% e GPT-5.5 al 41,4%.
Questo benchmark testa conoscenze a livello esperto in ambito scientifico e accademico, con domande progettate per essere difficili anche per specialisti del dominio. Un punteggio del 50% è notevole considerando che GPT-5.5 è al 41,4%. Il divario tra Fugu Ultra e GPT-5.5 qui è il più ampio di qualsiasi benchmark in tabella.
Sia Fugu che Fugu Ultra segnano il 95,5% su GPQA Diamond, con Gemini 3.1 Pro al 94,3%, GPT-5.5 al 93,6% e Claude Opus 4.8 al 92,0%.
GPQA Diamond testa domande scientifiche a livello PhD in biologia, chimica e fisica, scritte da esperti di dominio e verificate per essere difficili per i non specialisti. Il fatto che Fugu standard eguagli Fugu Ultra qui suggerisce che l’overhead di orchestrazione su questo benchmark non aggiunge molto, il che ha senso per un compito di domanda-risposta che non richiede pianificazione multi-step.
Fugu Ultra ottiene l’82,1% su TerminalBench 2.1, davanti a GPT-5.5 al 78,2%, Claude Opus 4.8 al 74,6% e Gemini 3.1 Pro al 70,3%. TerminalBench testa compiti di coding agentico che richiedono l’interazione con un ambiente terminale, tra cui manipolazione di file, comandi shell ed esecuzione multi-step.
È uno dei benchmark più rilevanti per i flussi di lavoro reali degli sviluppatori e il vantaggio di Fugu Ultra su GPT-5.5 qui è coerente con il caso d’uso dell’assessment di sicurezza riportato nella beta.
GPT-5.5 vince MRCRv2 con il 94,8%, rispetto a Fugu Ultra al 93,6% e Claude Opus 4.8 all’87,9%. MRCRv2 testa il richiamo su contesti lunghi, in particolare se un modello sa recuperare informazioni specifiche da documenti molto lunghi.
Questo è l’unico benchmark in cui Fugu Ultra non guida, aspetto da notare per team il cui caso d’uso principale consiste nel recuperare fatti specifici da documenti voluminosi piuttosto che nel ragionamento multi-step o nella generazione di codice.
Fugu è disponibile ora tramite la console di Sakana su console.sakana.ai, con un’API compatibile con OpenAI. Sia Fugu che Fugu Ultra sono inclusi in ogni piano. I livelli di abbonamento sono:
Il piano pay-as-you-go fattura in base ai token usati anziché a una quota mensile. Per Fugu Ultra (ID modello: fugu-ultra-20260615), il prezzo è di 5 $ per milione di token in input e 30 $ per milione di token in output per lunghezze di contesto standard.
Per contesti oltre 272K token, le tariffe aumentano a 10 $ input e 45 $ output. L’input in cache costa 0,50 $ per milione di token, o 1,00 $ oltre 272K. Il prezzo standard di Fugu corrisponde alla tariffa del modello sottostante attivo, e Sakana non somma commissioni quando più agenti sono in esecuzione.
Una limitazione regionale da segnalare: Fugu attualmente non è disponibile negli Stati membri dell’UE o dello SEE, mentre Sakana lavora alla conformità al GDPR. Per i team europei, questo è al momento un blocco. Sakana non ha pubblicato una timeline per la disponibilità nell’UE.
Fugu è una scommessa davvero diversa rispetto a quanto fanno OpenAI, Anthropic e Google. Invece di competere sulla scala del modello base, Sakana sostiene che un’orchestrazione appresa su un pool intercambiabile di modelli di frontiera possa eguagliare o superare qualsiasi sistema individuale nei compiti che richiedono davvero tempo: code review lunghe, ricerche multi-step, assessment di sicurezza e riproduzione di paper.
I numeri dei benchmark, se reggeranno a una verifica indipendente, supportano questo argomento sulla maggior parte delle metriche che contano per gli sviluppatori. Ovviamente, finché non riavremo accesso a Fable 5 e Mythos, non possiamo confrontarci direttamente con questi.
Detto ciò, ci sono sicuramente alcune avvertenze.
Tutti i punteggi dei benchmark sono riportati da Sakana. Il livello di routing è opaco, il che crea attrito per lavori sensibili alla conformità. L’esclusione per UE/SEE limita l’adozione per una parte significativa della comunità globale di sviluppatori. E il compromesso di latenza sui compiti semplici è reale: se stai effettuando chiamate API rapide e a singolo turno, l’overhead di orchestrazione di Fugu Ultra è puro costo senza beneficio.
Dove credo che Fugu abbia una vera carta da giocare è per i team che eseguono workflow agentici di lungo periodo e stanno già gestendo la complessità di setup multi-modello. Se stai mantenendo un tuo harness di orchestrazione sopra Claude e GPT, Fugu Ultra merita una valutazione seria.
La cornice della sovranità forse è un po’ gonfiata, ma il valore pratico di un singolo endpoint che aggira le interruzioni dei provider non lo è.
Se vuoi metterti al passo con il panorama dell’AI agentica in cui opera Fugu, ti consiglio di iniziare con lo skill track AI Agent Fundamentals su DataCamp, che copre le basi dei large language model, degli agenti e dei sistemi multi-modello.
I migliori corsi DataCamp
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Programma} other {Programmi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min




