Curso
Google: Agent Fundamentals
1 h
750
El panorama de la IA a mediados de 2026 está saturado de modelos punteros monolíticos que compiten por batir récords en benchmarks. Sakana AI apuesta por otra vía: en lugar de entrenar un modelo base más grande, ha lanzado Fugu, un sistema que orquesta un conjunto de modelos punteros existentes detrás de una única API compatible con OpenAI.
El gran titular: Sakana Fugu Ultra iguala a Fable 5 de Anthropic y a Mythos Preview en benchmarks de ingeniería, ciencia y razonamiento, sin requerir acceso a ninguno de esos modelos sujetos a control de exportaciones.
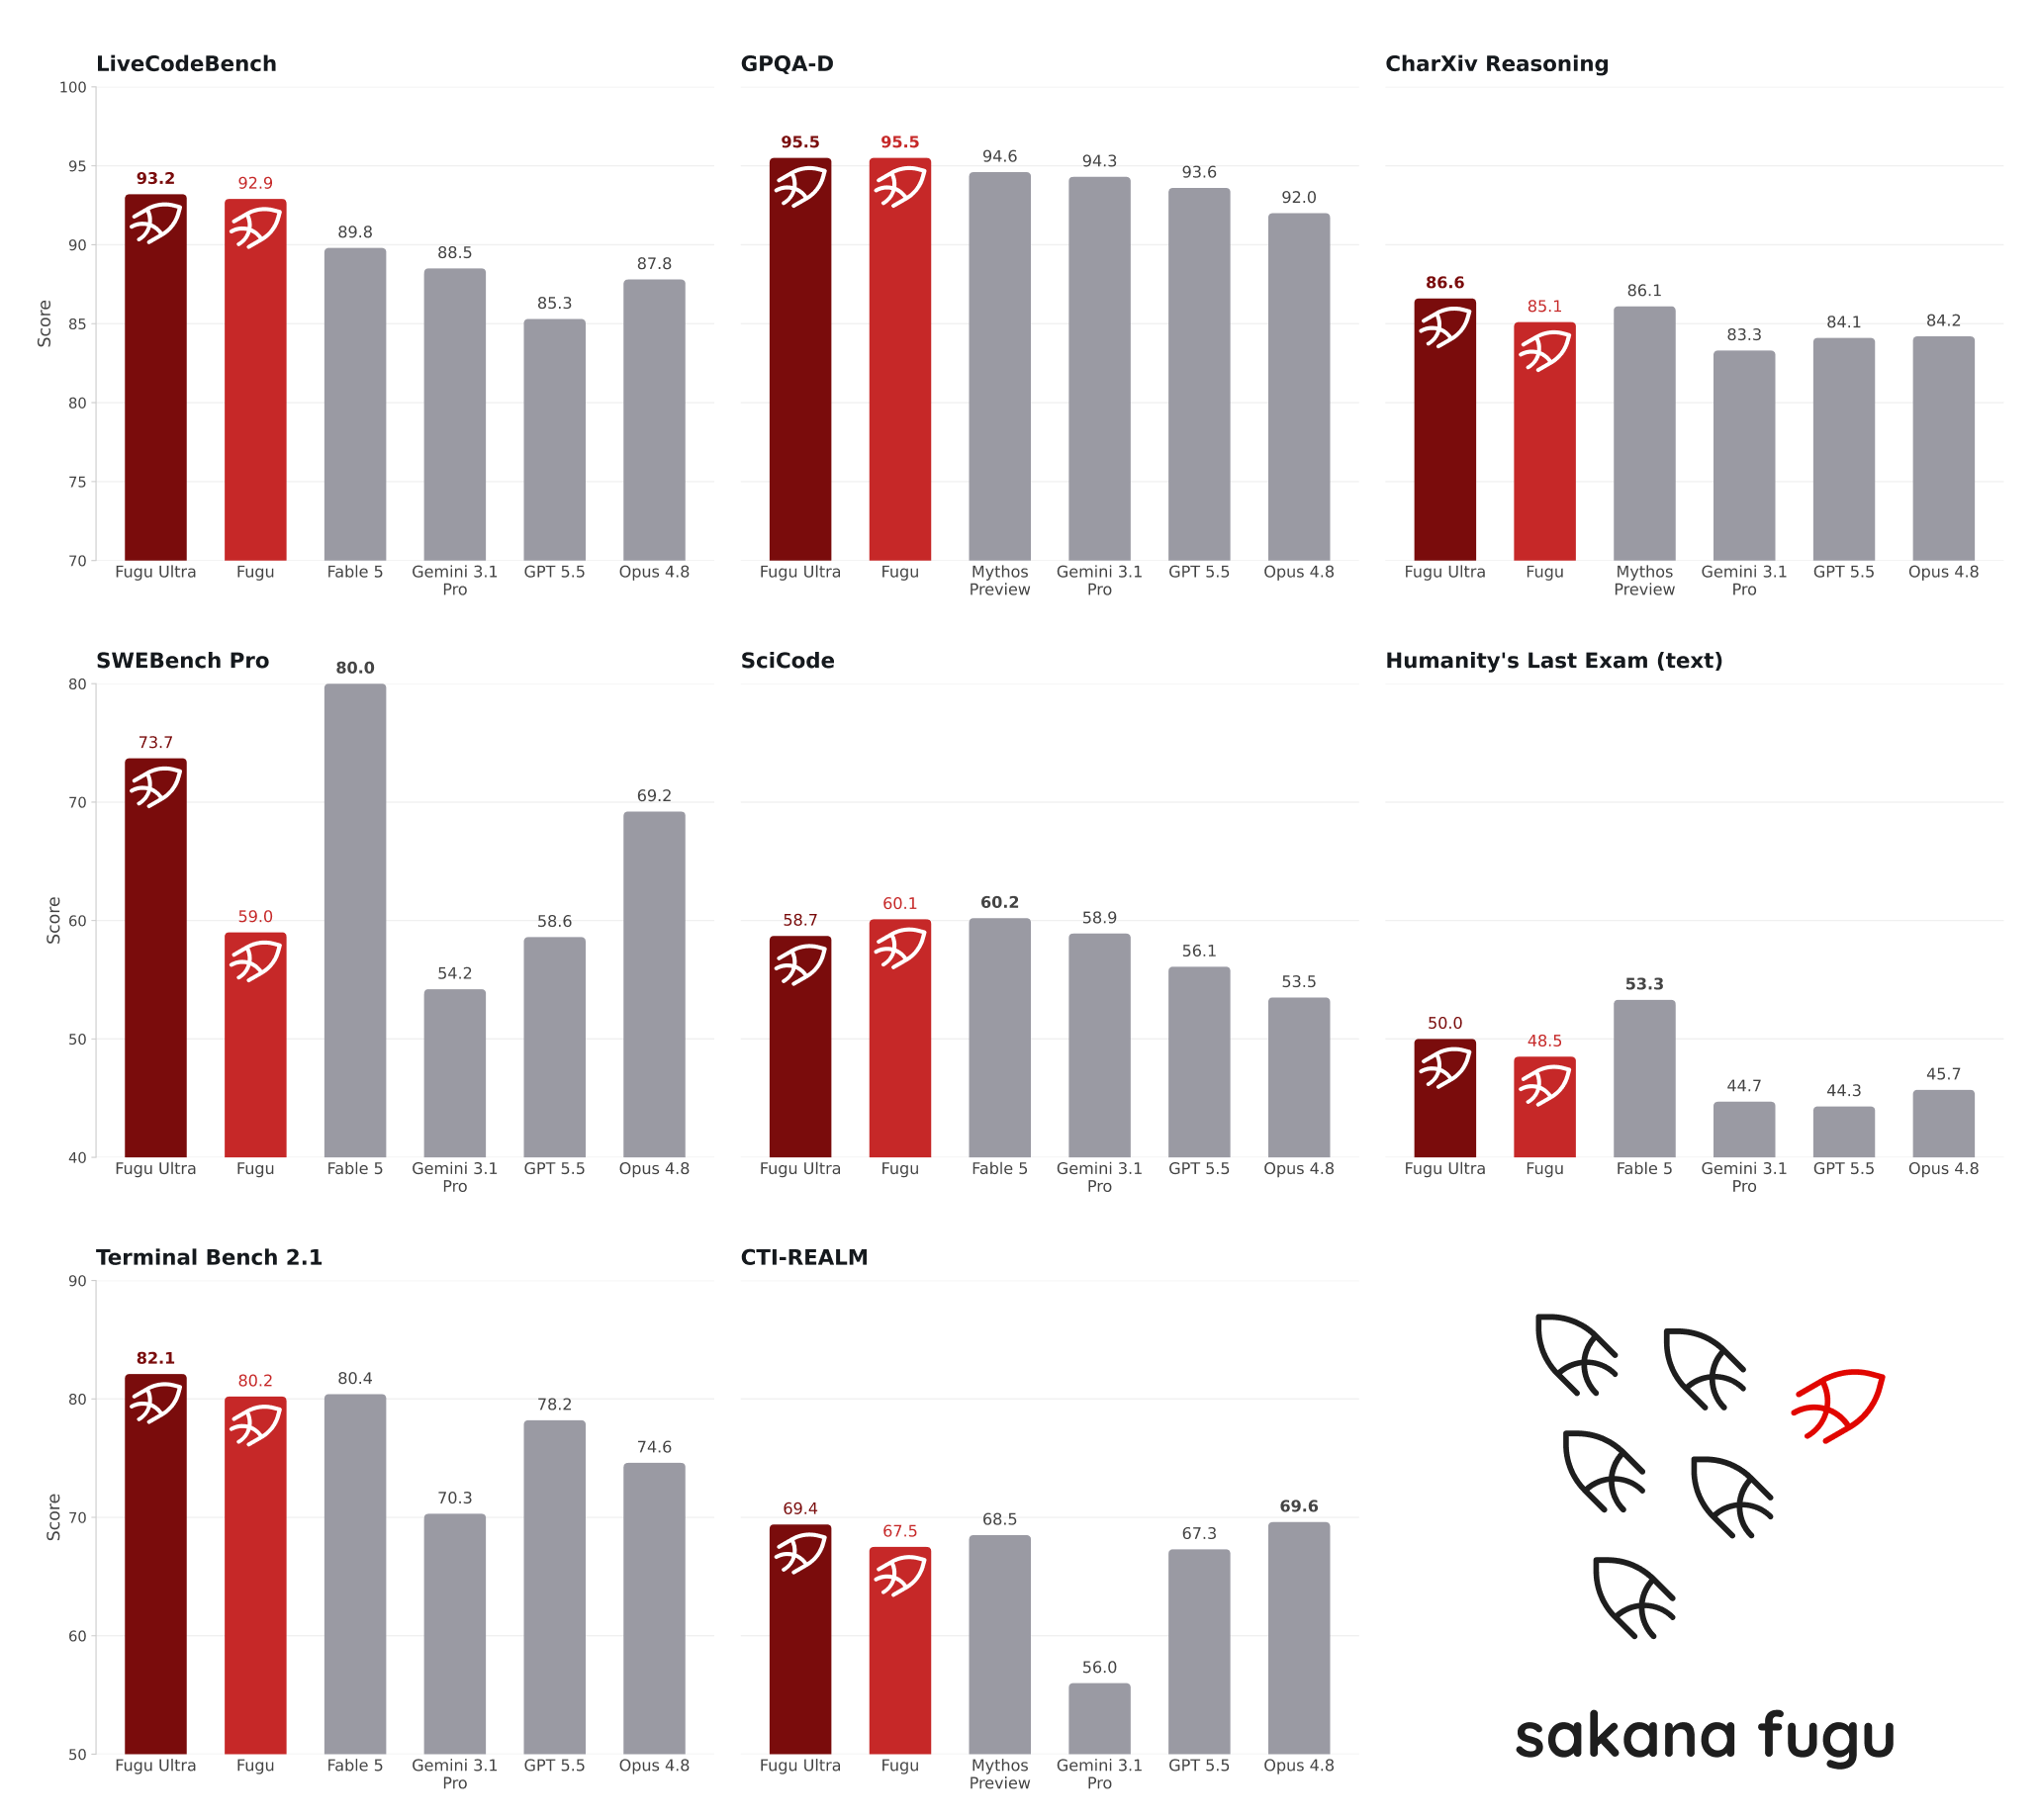
Sakana Fugu se lanzó el 22 de junio de 2026 en dos variantes: Fugu para trabajo diario sensible a la latencia y Fugu Ultra para tareas complejas y de varios pasos. En SWE-Bench Pro, Fugu Ultra logra un 73,7%, por delante de Claude Opus 4.8 (69,2%), GPT-5.5 (58,6%) y Gemini 3.1 Pro (54,2%).
Todos los números de benchmarks los reporta Sakana y aún no han sido reproducidos de forma independiente por laboratorios externos, algo que conviene tener presente al leer.
En este artículo, te cuento qué es realmente Fugu, repaso sus funciones clave, reviso la tabla completa de benchmarks y algunos casos de uso. También puedes ver nuestra comparativa de GPT-5.5 vs Gemini 3.1 Pro para situar los modelos contra los que compite Fugu.
Sakana Fugu es un modelo lingüístico entrenado para actuar como orquestador: recibe una solicitud, decide si resolverla directamente o delegar en modelos especialistas de su pool de agentes, gestiona la verificación y la síntesis, y devuelve una única respuesta. Por fuera llamas a un único endpoint. Por dentro, un conjunto coordinado de modelos hace el trabajo.
Sakana AI lleva avanzando hacia esta arquitectura desde su fundación. El laboratorio, creado por Llion Jones (coautor del artículo original "Attention Is All You Need") y David Ha, defiende desde hace tiempo que los ecosistemas de modelos coordinados superan a los monolitos aislados en tareas difíciles y de larga duración.
Fugu es la materialización de esa tesis, respaldada por dos artículos de ICLR 2026: TRINITY (un coordinador de LLM evolucionado) y Conductor (aprendizaje para orquestar agentes en lenguaje natural).
En el momento de escribir esto, Fable 5 y Mythos Preview de Anthropic no son accesibles públicamente por controles de exportación, lo que impide que formen parte del pool de agentes de Fugu.
El argumento de Sakana es que la ruta a través de un pool de modelos intercambiables es una cobertura práctica ante este tipo de interrupciones de acceso. Si eso constituye una verdadera "soberanía de la IA" es discutible, pero la lógica operativa es clara: si un proveedor restringe el acceso, Fugu busca otra ruta.
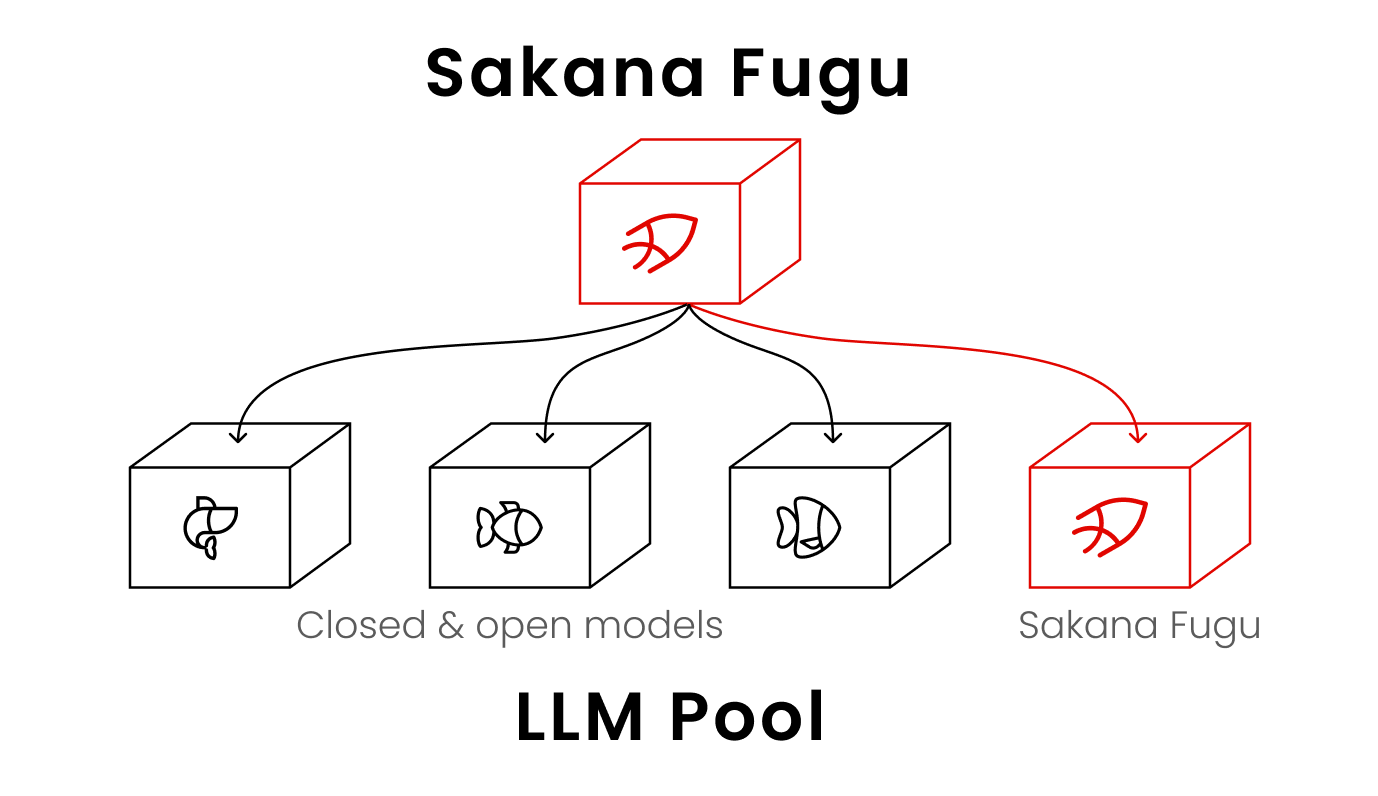
Fugu introduce varias ideas que lo diferencian tanto de los modelos punteros convencionales como de los marcos multiagente tradicionales. A continuación destaco las más importantes.
La mayoría de sistemas multiagente requieren que los desarrolladores definan qué modelo gestiona cada tarea. Fugu lo aprende. El modelo orquestador está entrenado para decidir cuándo delegar, cómo deben comunicarse los agentes y cómo combinar sus salidas en una única respuesta. Esta es la aportación central de las investigaciones TRINITY y Conductor que enlazo arriba.
En la práctica, esto significa que la complejidad de un sistema multiagente nunca llega a tu código. Envías una solicitud a un endpoint y Fugu gestiona internamente la selección de modelos, la delegación, la verificación y la síntesis. Para equipos que han intentado construir su propia capa de orquestación, el atractivo es evidente: obtienes las ventajas de coordinación sin mantener el arnés.
Un matiz importante: las decisiones de enrutado son propietarias y no están expuestas a los usuarios. No puedes ver qué modelo subyacente gestionó una solicitud concreta. Para trabajos sensibles al cumplimiento normativo donde necesitas auditar la cadena de razonamiento, esta opacidad es una limitación real.
Los modelos del pool de Fugu no son fijos. Cuando un nuevo modelo puntero pasa a estar disponible públicamente, Sakana prevé dedicar unas dos semanas a entrenar y evaluar versiones actualizadas de Fugu antes de lanzarlas. Esto implica que el rendimiento de Fugu debería mejorar a medida que mejora el ecosistema subyacente, sin que los usuarios tengan que cambiar su integración.
En el Fugu estándar, los usuarios también pueden excluir agentes concretos del pool desde la consola, algo relevante para equipos con requisitos de privacidad de datos o cumplimiento. El pool de Fugu Ultra es fijo porque depende del conjunto completo de agentes para alcanzar sus resultados en benchmarks.
Fugu y Fugu Ultra cubren cargas distintas. Fugu equilibra calidad y baja latencia, por lo que es una opción razonable para programar, revisar código y servicios interactivos. Fugu Ultra coordina un pool más profundo de agentes expertos y está ajustado para maximizar la calidad de respuesta en problemas difíciles y de varios pasos.
Los primeros usuarios recurrieron a Fugu Ultra para tareas como reproducir artículos científicos, análisis de ciberseguridad, ciencia de datos tipo Kaggle e investigación de patentes.
Un ingeniero de software en la beta contó que Fugu Ultra detectó más de veinte incidencias en una revisión de código, mientras que otras herramientas señalaron alrededor de tres.
Una ingeniera de ciberseguridad informó de que una sola instrucción acotada impulsó una evaluación de seguridad completa de principio a fin, con un informe limpio con evidencias y pasos de revalidación.
Conviene señalar que la compensación en latencia es real. El enrutado multiagente y la síntesis añaden sobrecarga. Para consultas simples o requisitos de latencia muy ajustados, una llamada directa a un único modelo puntero probablemente será más rápida y barata.
Tanto Fugu como Fugu Ultra se acceden a través de una única API compatible con OpenAI. No hace falta migrar SDKs.
Solo tienes que apuntar tu cliente actual al endpoint de Fugu con tu clave de API y empezar a enviar solicitudes. Es una decisión deliberada para reducir el coste de cambio de equipos que ya usan GPT-5.5 o Claude Opus 4.8 mediante la librería cliente de OpenAI.
Según la tabla comparativa de Sakana, Fugu Ultra encabeza 10 de 11 benchmarks, con GPT-5.5 ganando únicamente MRCRv2. Todas las puntuaciones, excepto las de Fugu, son reportadas por los respectivos proveedores. Fable 5 y Mythos Preview se excluyen de la comparación porque no son accesibles públicamente y, por tanto, no pueden formar parte del pool de agentes de Fugu.
Hasta donde he visto al escribir esto, aún no han aparecido reproducciones independientes de estas cifras en rankings de terceros.
| Benchmark | Fugu | Fugu Ultra | Opus 4.8 † | Gemini 3.1 Pro † | GPT 5.5 † |
|---|---|---|---|---|---|
| SWE Bench Pro * | 59.0 | 73.7 | 69.2 | 54.2 | 58.6 |
| TerminalBench 2.1 | 80.2 | 82.1 | 74.6 | 70.3 | 78.2 |
| LiveCodeBench | 92.9 | 93.2 | 87.8 | 88.5 | 85.3 |
| LiveCodeBench Pro | 87.8 | 90.8 | 84.8 | 82.9 | 88.4 |
| Humanity's Last Exam | 47.2 | 50.0 | 49.8 | 44.4 | 41.4 |
| CharXiv Reasoning | 85.1 | 86.6 | 84.2 | 83.3 | 84.1 |
| GPQA-D | 95.5 | 95.5 | 92.0 | 94.3 | 93.6 |
| SciCode | 60.1 | 58.7 | 53.5 | 58.9 | 56.1 |
| τ3 Banking | 21.7 | 20.6 | 20.6 | 8.4 | 20.6 |
| Long Context Reasoning | 74.7 | 73.3 | 67.7 | 72.7 | 74.3 |
| MRCRv2 | 86.6 | 93.6 | 87.9 | 84.9 | 94.8 |
Fugu Ultra consigue un 73,7% en SWE-Bench Pro, por delante de Claude Opus 4.8 con 69,2%, GPT-5.5 con 58,6% y Gemini 3.1 Pro con 54,2%. En nuestra cobertura de GPT-5.5, señalamos que obtuvo un 58,6% en este benchmark, cifra que Fugu Ultra supera por 15 puntos.
SWE-Bench Pro evalúa si un modelo puede resolver incidencias reales de GitHub en repositorios de software, lo que lo convierte en uno de los benchmarks de programación con mayor anclaje práctico. La diferencia entre Fugu Ultra y el siguiente modelo accesible públicamente es lo bastante grande como para marcar la diferencia en equipos que hacen revisión de código o corrección de bugs en serio.
Fugu Ultra logra un 93,2% en LiveCodeBench y un 90,8% en LiveCodeBench Pro. Las siguientes mejores puntuaciones son Gemini 3.1 Pro con 88,5% y Claude Opus 4.8 con 87,8% en la versión estándar.
LiveCodeBench evalúa problemas de programación competitiva extraídos de concursos recientes, lo que reduce el riesgo de contaminación del entrenamiento respecto a benchmarks más antiguos. La variante Pro usa problemas más difíciles. La ventaja de Fugu aquí cuadra con los informes de la beta sobre su fuerte rendimiento en revisión de código.
Fugu Ultra obtiene un 50,0% en Humanity's Last Exam, frente al 49,8% de Claude Opus 4.8, el 44,4% de Gemini 3.1 Pro y el 41,4% de GPT-5.5.
Este benchmark evalúa conocimiento experto en ámbitos científicos y académicos, con preguntas diseñadas para ser difíciles incluso para especialistas. Un 50% es reseñable teniendo en cuenta que GPT-5.5 se queda en 41,4%. La brecha entre Fugu Ultra y GPT-5.5 aquí es la mayor de toda la tabla.
Tanto Fugu como Fugu Ultra obtienen un 95,5% en GPQA Diamond, con Gemini 3.1 Pro en 94,3%, GPT-5.5 en 93,6% y Claude Opus 4.8 en 92,0%.
GPQA Diamond evalúa preguntas de nivel doctorado en biología, química y física, redactadas por expertos y verificadas para ser difíciles para no especialistas. Que el Fugu estándar iguale a Fugu Ultra sugiere que la sobrecarga de orquestación aquí aporta poco, lo cual tiene sentido en una tarea de preguntas y respuestas que no requiere planificación multietapa.
Fugu Ultra obtiene un 82,1% en TerminalBench 2.1, por delante de GPT-5.5 con 78,2%, Claude Opus 4.8 con 74,6% y Gemini 3.1 Pro con 70,3%. TerminalBench evalúa tareas de programación agente que requieren interactuar con un entorno de terminal, incluyendo manipulación de archivos, comandos de shell y ejecución en varios pasos.
Es uno de los benchmarks más relevantes para flujos reales de desarrolladores, y la ventaja de Fugu Ultra sobre GPT-5.5 aquí encaja con el caso de uso de evaluación de ciberseguridad reportado en la beta.
GPT-5.5 gana MRCRv2 con un 94,8%, frente al 93,6% de Fugu Ultra y el 87,9% de Claude Opus 4.8. MRCRv2 evalúa la recuperación en contextos largos, en concreto la capacidad del modelo para localizar información específica en documentos muy extensos.
Es el único benchmark donde Fugu Ultra no lidera, algo a tener en cuenta para equipos cuyo caso principal consiste en recuperar datos exactos de grandes documentos, más que en razonamiento multietapa o generación de código.
Fugu está disponible ya a través de la consola de Sakana en console.sakana.ai, con una API compatible con OpenAI. Todos los planes incluyen Fugu y Fugu Ultra. Los niveles de suscripción son:
El plan de pago por uso factura por tokens consumidos en lugar de una asignación mensual. Para Fugu Ultra (ID de modelo: fugu-ultra-20260615), el precio es de 5 $ por millón de tokens de entrada y 30 $ por millón de tokens de salida para longitudes de contexto estándar.
Para contextos por encima de 272K tokens, las tarifas suben a 10 $ de entrada y 45 $ de salida. La entrada en caché cuesta 0,50 $ por millón de tokens, o 1,00 $ por encima de 272K. El precio estándar de Fugu se ajusta a la tarifa del modelo subyacente activo, y Sakana no añade recargos cuando se ejecutan varios agentes.
Una limitación regional a destacar: Fugu no está disponible actualmente en los estados miembros de la UE o del EEE, mientras Sakana trabaja en el cumplimiento del RGPD. Para equipos europeos, esto es un bloqueo por ahora. Sakana no ha publicado un calendario para su disponibilidad en la UE.
Fugu es una apuesta realmente distinta a la de OpenAI, Anthropic y Google. En lugar de competir por el tamaño del modelo base, Sakana sostiene que una orquestación aprendida sobre un pool intercambiable de modelos punteros puede igualar o superar a cualquier sistema individual en las tareas que de verdad consumen tiempo: revisiones de código extensas, investigación en varios pasos, evaluaciones de seguridad y reproducción de artículos.
Las cifras de benchmarks, si resisten la verificación independiente, apoyan ese argumento en la mayoría de métricas que importan a los desarrolladores. Claro que, hasta que volvamos a tener acceso a Fable 5 y Mythos, no podemos compararlos directamente.
Dicho esto, hay matices a tener en cuenta.
Todas las puntuaciones de benchmarks las reporta Sakana. La capa de enrutado es opaca, lo que complica trabajos sensibles al cumplimiento. La exclusión de UE/EEE limita la adopción en una parte importante de la comunidad global de desarrolladores. Y la penalización de latencia en tareas simples es real: si haces llamadas API rápidas de un solo turno, la orquestación de Fugu Ultra es coste puro sin beneficio.
Donde creo que Fugu tiene un encaje claro es en equipos que ejecutan flujos agente de largo recorrido y ya gestionan por su cuenta la complejidad de configuraciones con varios modelos. Si mantienes tu propio arnés de orquestación sobre Claude y GPT, Fugu Ultra merece una evaluación seria.
La narrativa de soberanía quizá esté algo inflada, pero el valor práctico de un único endpoint que sortea interrupciones de proveedores no lo está.
Si quieres ponerte al día sobre el panorama de la IA agente en el que opera Fugu, te recomiendo empezar por el itinerario de aprendizaje AI Agent Fundamentals en DataCamp, que cubre los fundamentos de los grandes modelos de lenguaje, los agentes y los sistemas multimodelo.
Los mejores cursos de DataCamp
Curso
programa
Curso
blog
Richie Cotton
8 min
Tutorial
Arunn Thevapalan
13 min
Tutorial
Aashi Dutt
14 min
Tutorial
Zoumana Keita
15 min
Tutorial
Zoumana Keita
12 min
Tutorial
Zoumana Keita
14 min