
Last chance! 50% off DataCamp Premium
Sale ends in
2026 के मध्य तक AI परिदृश्य कच्चे बेंचमार्क स्कोर पर प्रतिस्पर्धा करते एकल, विशाल फ्रंटियर मॉडलों से भरा हुआ है। Sakana AI अलग दांव लगा रहा है: एक बड़ा बेस मॉडल ट्रेन करने के बजाय, उसने Fugu जारी किया है—एक सिस्टम जो मौजूदा फ्रंटियर मॉडलों के पूल का एक OpenAI-संगत API के पीछे संयोजन करता है।
प्रमुख दावा यह है कि Sakana Fugu Ultra, Anthropic के Fable 5 और Mythos Preview के बराबर इंजीनियरिंग, वैज्ञानिक, और रीजनिंग बेंचमार्क पर प्रदर्शन करता है—वह भी बिना उन निर्यात-नियंत्रित मॉडलों तक पहुँच की आवश्यकता के।
Sakana Fugu का लॉन्च 22 जून, 2026 को दो वेरिएंट्स में हुआ: Fugu, रोज़मर्रा के कम विलंबता-सम्वेदनशील काम के लिए; और Fugu Ultra, जटिल, बहु-चरणीय कार्यों के लिए। SWE-Bench Pro पर, Fugu Ultra 73.7% स्कोर करता है, जो Claude Opus 4.8 (69.2%), GPT-5.5 (58.6%), और Gemini 3.1 Pro (54.2%) से आगे है।
सभी बेंचमार्क संख्याएँ Sakana द्वारा रिपोर्ट की गई हैं और अभी तक तृतीय-पक्ष लैब्स द्वारा स्वतंत्र रूप से पुनरुत्पादित नहीं की गई हैं—पढ़ते समय इसे ध्यान में रखना चाहिए।
इस लेख में, मैं बताऊँगा कि Fugu वास्तव में क्या है, इसकी प्रमुख विशेषताओं से गुजरूँगा, पूर्ण बेंचमार्क तालिका देखूँगा, और कुछ उपयोग के मामलों पर नज़र डालूँगा। संदर्भ के लिए आप हमारा GPT-5.5 बनाम Gemini 3.1 Pro का तुलना लेख भी देख सकते हैं—वे मॉडल जिनसे Fugu मुकाबला कर रहा है।
Sakana Fugu एक भाषा मॉडल है जिसे संयोजक (orchestrator) की तरह काम करने के लिए प्रशिक्षित किया गया है: यह कोई अनुरोध प्राप्त करता है, तय करता है कि उसे सीधे संभालना है या अपने एजेंट पूल के विशेषज्ञ मॉडलों को सौंपना है, सत्यापन और संयोजन का प्रबंधन करता है, और एकल उत्तर लौटाता है। बाहर से, आप एक एंडपॉइंट कॉल करते हैं। अंदर, समन्वित मॉडलों का सेट काम करता है।
Sakana AI अपनी स्थापना से ही इस आर्किटेक्चर की ओर बढ़ रहा है। यह लैब, जिसे Llion Jones (मूल "Attention Is All You Need" पेपर के सह-लेखक) और David Ha ने शुरू किया, लंबे समय से तर्क देती आई है कि समन्वित मॉडल इकोसिस्टम कठिन, लंबी अवधि के कार्यों पर अलग-थलग मोनोलिथ्स से बेहतर प्रदर्शन करते हैं।
Fugu उसी थीसिस का उत्पादित संस्करण है, जो ICLR 2026 के दो पेपर्स पर आधारित है: TRINITY (एक विकसित LLM कोऑर्डिनेटर) और Conductor (एजेंट्स को प्राकृतिक भाषा में संयोजित करना सीखना)।
लेखन के समय, Anthropic के Fable 5 और Mythos Preview निर्यात नियंत्रण के कारण सार्वजनिक रूप से सुलभ नहीं हैं, जिसका अर्थ है कि वे Fugu के एजेंट पूल में शामिल नहीं हो सकते।
Sakana का तर्क है कि अदला-बदली योग्य मॉडलों के पूल में रूटिंग इस तरह की एक्सेस बाधाओं के खिलाफ व्यावहारिक सुरक्षा कवच देती है। यह "AI संप्रभुता" का वास्तविक रूप है या नहीं, इस पर बहस हो सकती है, लेकिन परिचालन तर्क सुदृढ़ है: यदि कोई प्रदाता पहुँच सीमित करता है, तो Fugu उसके इर्द-गिर्द रूट कर देता है।
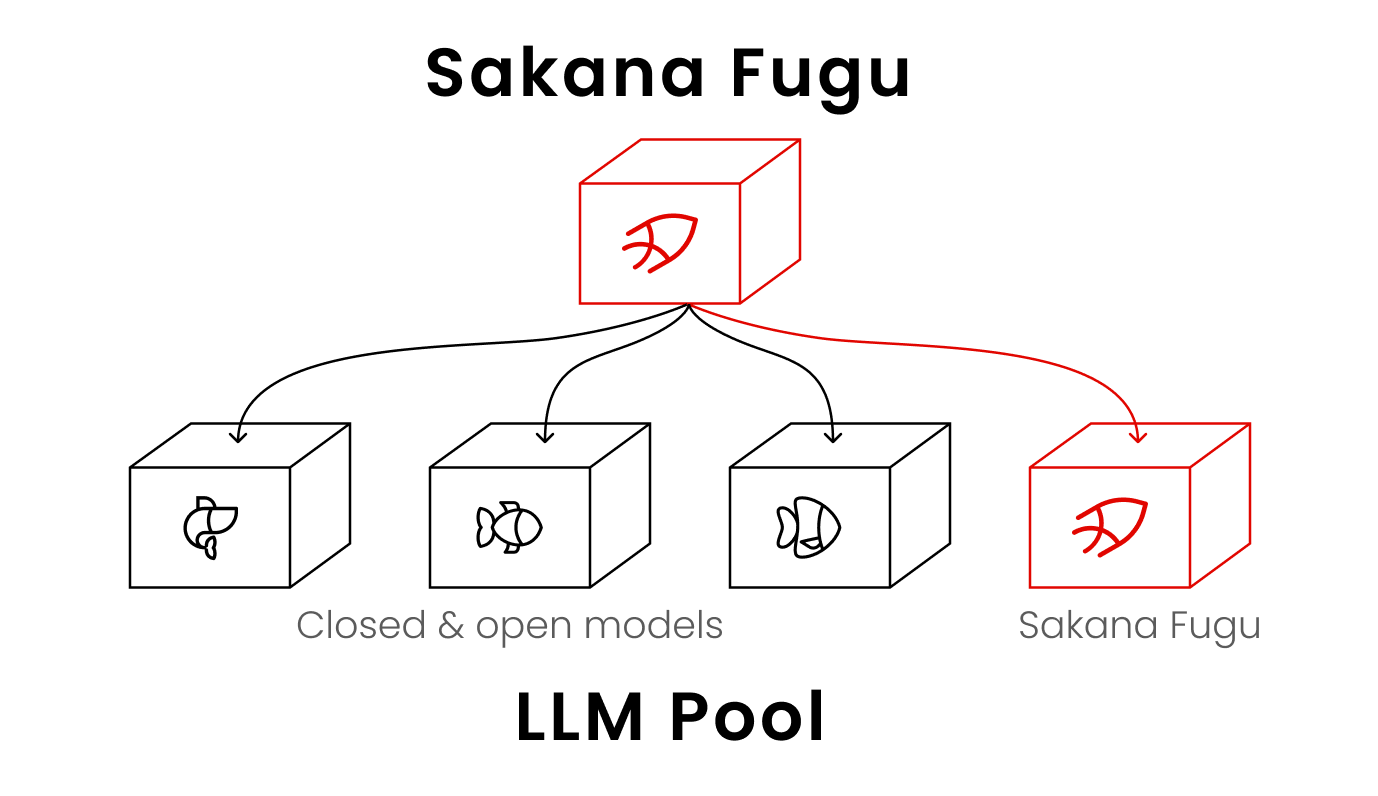
Fugu कई ऐसे विचार प्रस्तुत करता है जो उसे पारंपरिक फ्रंटियर मॉडलों और पारंपरिक मल्टी-एजेंट फ्रेमवर्क्स दोनों से अलग करते हैं। मैंने नीचे प्रमुख बिंदु कवर किए हैं।
अधिकांश मल्टी-एजेंट सिस्टम डेवलपर्स से यह परिभाषित करवाते हैं कि कौन सा मॉडल कौन सा कार्य संभालेगा। Fugu यह स्वयं सीखता है। ऑर्केस्ट्रेटर मॉडल को यह तय करने के लिए प्रशिक्षित किया गया है कि कब डेलीगेट करना है, एजेंट्स को कैसे संवाद करना चाहिए, और उनके आउटपुट्स को एक उत्तर में कैसे संयोजित करना है। यही ऊपर लिंक किए गए TRINITY और Conductor अनुसंधान का मूल योगदान है।
व्यवहार में, इसका अर्थ है कि मल्टी-एजेंट सिस्टम की जटिलता कभी भी आपके कोड तक नहीं पहुँचती। आप एक एंडपॉइंट पर अनुरोध भेजते हैं, और Fugu आंतरिक रूप से मॉडल चयन, डेलीगेशन, सत्यापन, और संयोजन संभालता है। जिन टीमों ने अपना ऑर्केस्ट्रेशन लेयर बनाने की कोशिश की है, उनके लिए आकर्षण स्पष्ट है: आपको हार्नेस को मेंटेन किए बिना समन्वय के लाभ मिलते हैं।
एक सावधानी जो उल्लेखनीय है: रूटिंग निर्णय स्वामित्वाधीन हैं और उपयोगकर्ताओं को प्रदर्शित नहीं किए जाते। आप यह नहीं देख सकते कि किसी दिए गए अनुरोध को किस अंतर्निहित मॉडल ने संभाला। अनुपालन-संवेदनशील कार्यों के लिए जहाँ आपको रीजनिंग चेन का ऑडिट करना होता है, यह अपारदर्शिता एक वास्तविक सीमा है।
Fugu के पूल में मॉडल तय नहीं हैं। जब कोई नया फ्रंटियर मॉडल सार्वजनिक रूप से उपलब्ध होता है, तो Sakana को अद्यतन Fugu मॉडलों को प्रशिक्षित और मूल्यांकित करने में लगभग दो सप्ताह लगने की उम्मीद है, उसके बाद उन्हें रोलआउट किया जाता है। इसका मतलब है कि जैसे-जैसे अंतर्निहित इकोसिस्टम बेहतर होता जाएगा, वैसे-वैसे Fugu का प्रदर्शन भी बेहतर होना चाहिए—उपयोगकर्ताओं को अपने इंटीग्रेशन में बदलाव किए बिना।
स्टैंडर्ड Fugu मॉडल के लिए, उपयोगकर्ता कंसोल सेटिंग्स से पूल में विशिष्ट एजेंट्स को ऑप्ट-आउट भी कर सकते हैं—जो डेटा गोपनीयता या अनुपालन आवश्यकताओं वाली टीमों के लिए महत्वपूर्ण है। Fugu Ultra का पूल तय है क्योंकि अपने बेंचमार्क प्रदर्शन के लिए उसे एजेंट्स के पूरे सेट पर निर्भर रहना पड़ता है।
Fugu और Fugu Ultra अलग-अलग वर्कलोड्स सर्व करते हैं। Fugu गुणवत्ता और कम विलंबता में संतुलन बनाता है, जिससे यह कोडिंग, कोड रिव्यू, और इंटरैक्टिव सर्विसेज के लिए एक उचित डिफ़ॉल्ट बनता है। Fugu Ultra विशेषज्ञ एजेंट्स के गहरे पूल का समन्वय करता है और कठिन, बहु-चरणीय समस्याओं पर अधिकतम उत्तर गुणवत्ता के लिए ट्यून किया गया है।
प्रारंभिक उपयोगकर्ताओं ने Fugu Ultra को पेपर पुनरुत्पादन, साइबरसुरक्षा विश्लेषण, Kaggle-शैली डेटा साइंस, और पेटेंट जांच जैसे कार्यों में इस्तेमाल किया।
बीटा के एक सॉफ्टवेयर इंजीनियर ने बताया कि Fugu Ultra ने बीस से अधिक कोड रिव्यू इश्यूज़ सतह पर लाए, जबकि अन्य टूल्स ने लगभग तीन को फ़्लैग किया।
एक साइबरसुरक्षा इंजीनियर ने रिपोर्ट किया कि एक ही स्कोप्ड निर्देश ने एंड-टू-एंड एक पूर्ण सुरक्षा आकलन चलाया, जिसमें साक्ष्यों और रीटेस्ट चरणों सहित साफ-सुथरी रिपोर्ट शामिल थी।
यहाँ यह उल्लेख करना उचित है कि विलंबता का ट्रेड-ऑफ वास्तविक है। मल्टी-एजेंट रूटिंग और संयोजन अतिरिक्त ओवरहेड जोड़ते हैं। सरल क्वेरीज़ या तंग विलंबता आवश्यकताओं के लिए, किसी एकल फ्रंटियर मॉडल को सीधे कॉल करना संभवतः तेज़ और सस्ता होगा।
Fugu और Fugu Ultra, दोनों, एकल OpenAI-संगत API के माध्यम से सुलभ हैं। किसी SDK माइग्रेशन की आवश्यकता नहीं है।
आप अपने मौजूदा क्लाइंट को Fugu एंडपॉइंट पर अपने API कुंजी के साथ पॉइंट करें और अनुरोध भेजना शुरू करें। यह पहले से OpenAI क्लाइंट लाइब्रेरी के जरिए GPT-5.5 या Claude Opus 4.8 का उपयोग करने वाली टीमों के लिए स्विचिंग लागत कम करने की सोची-समझी पसंद है।
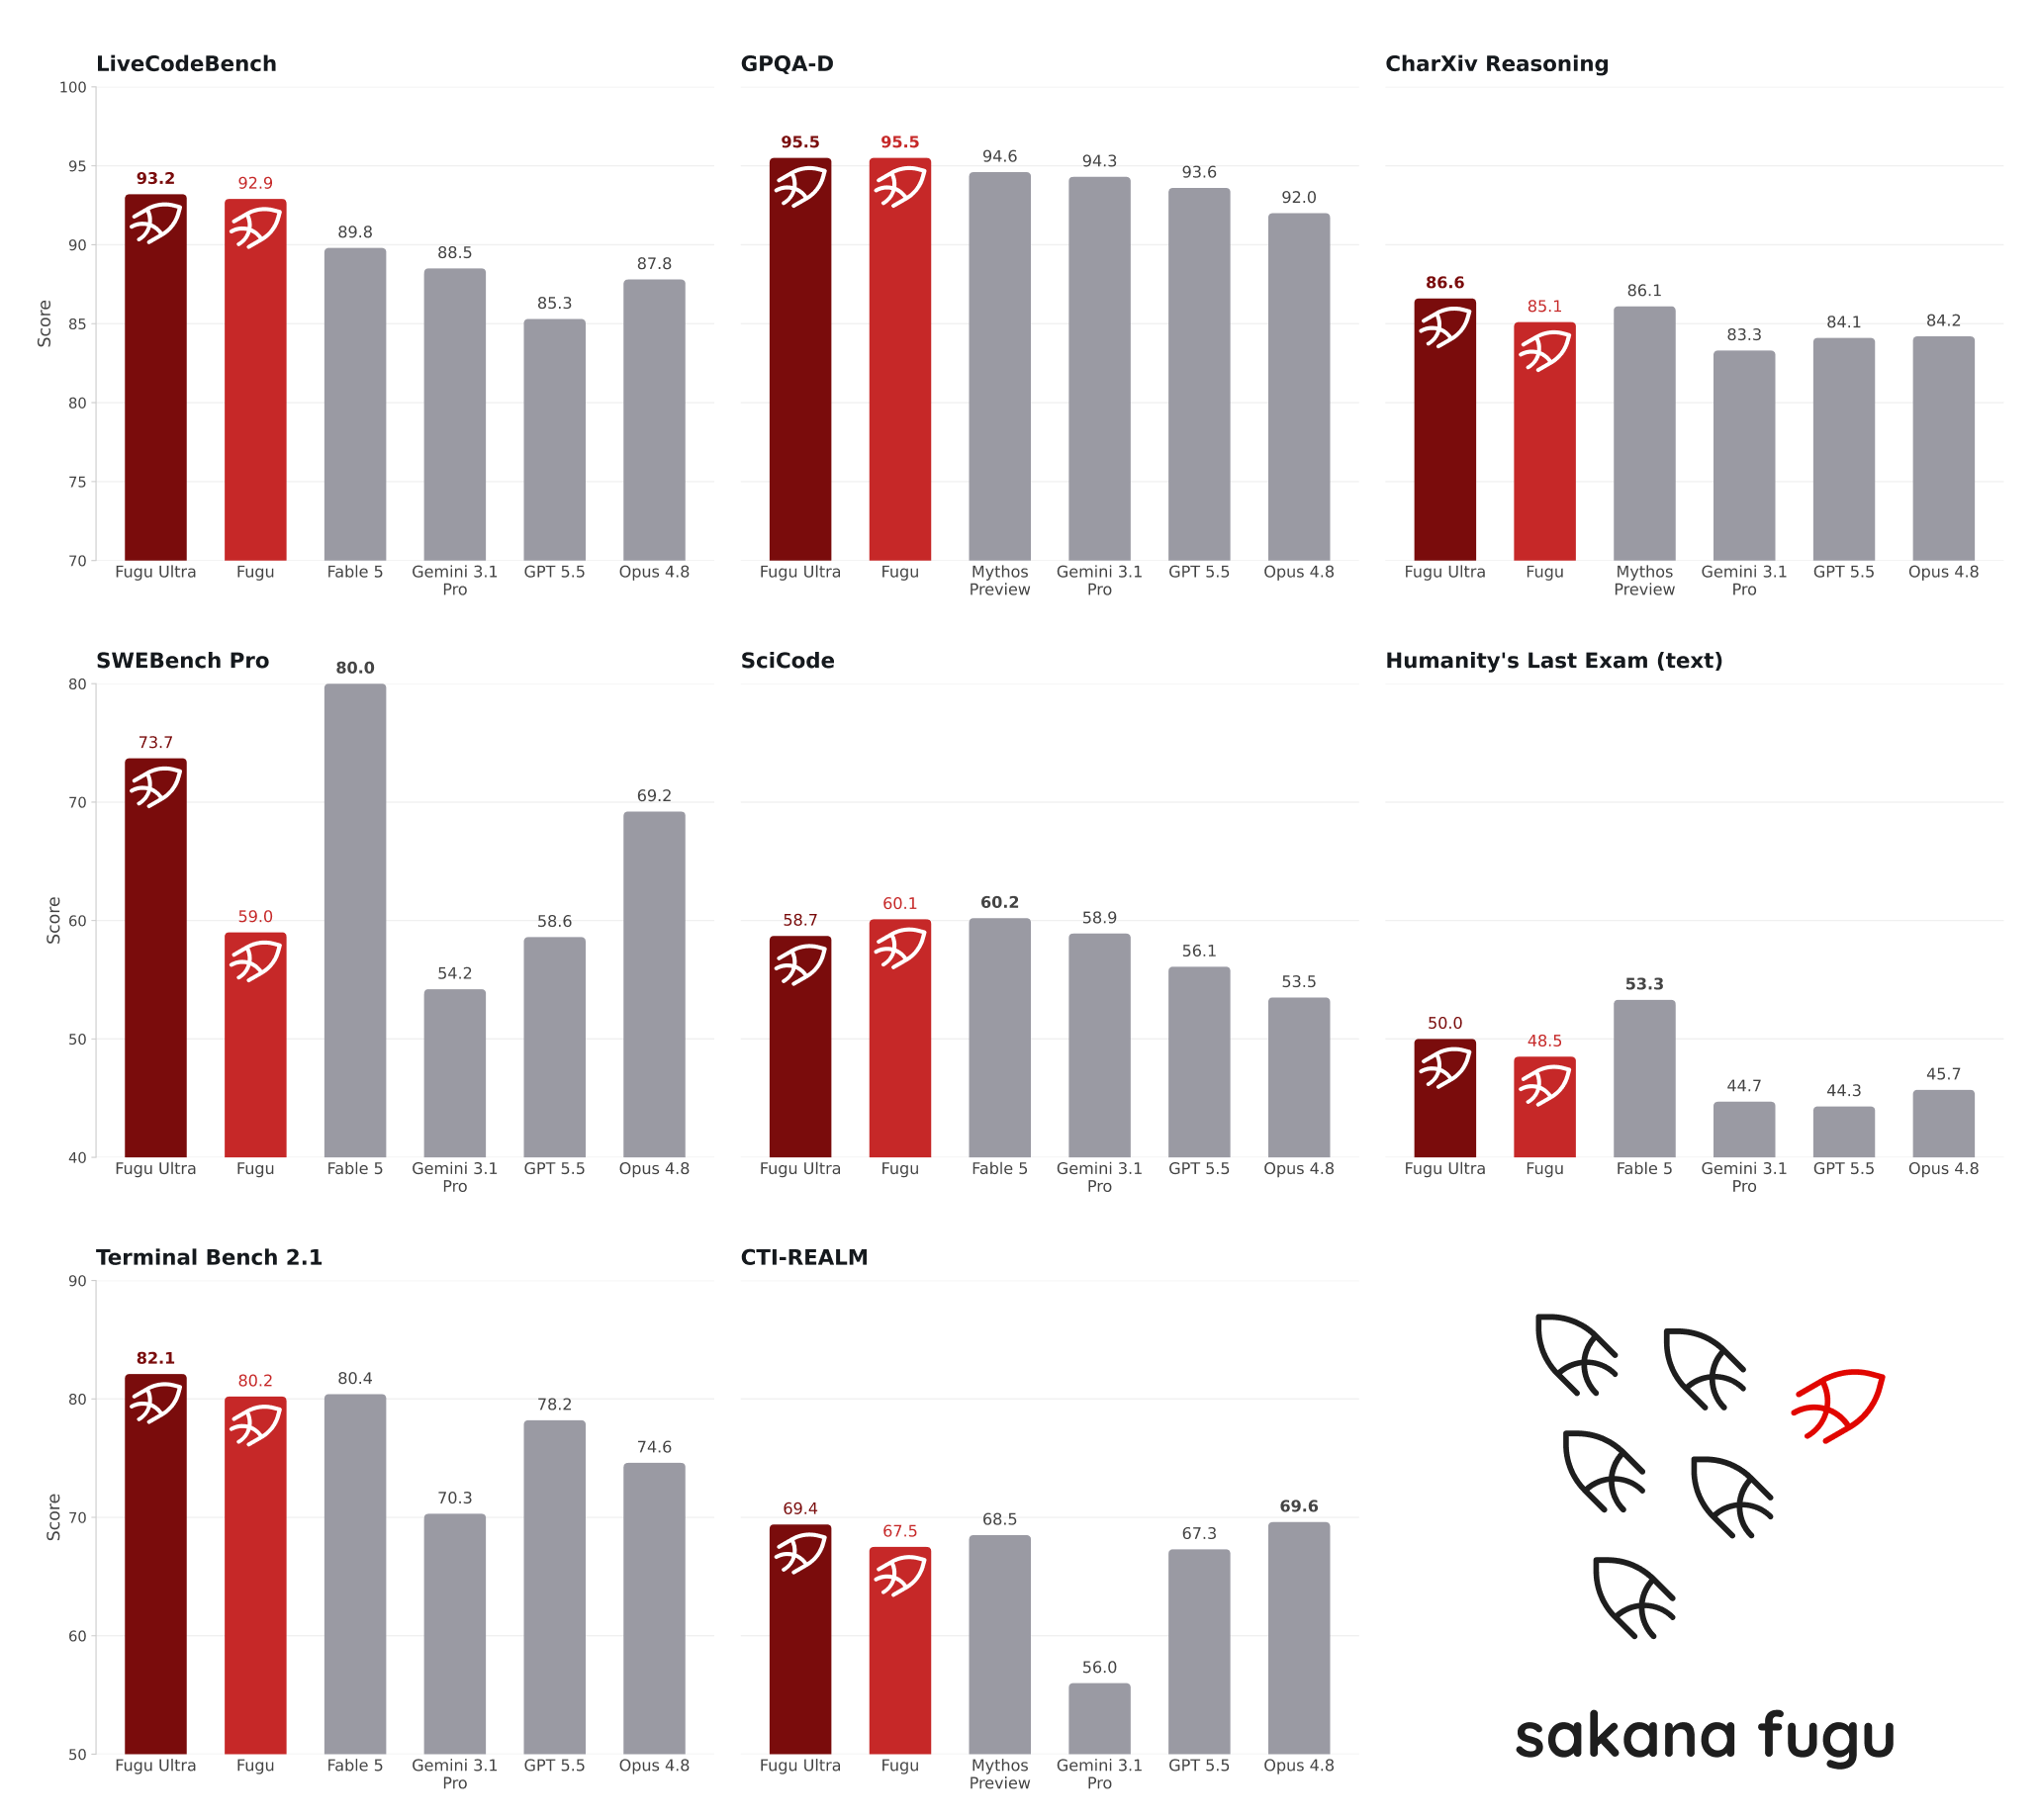
Sakana की तुलना तालिका के अनुसार, Fugu Ultra 11 में से 10 बेंचमार्क्स में शीर्ष पर है, जबकि GPT-5.5 केवल MRCRv2 में जीतता है। सभी स्कोर, Fugu को छोड़कर, प्रदाता-रिपोर्टेड हैं। Fable 5 और Mythos Preview को तुलना से बाहर रखा गया है क्योंकि वे सार्वजनिक रूप से सुलभ नहीं हैं और इसलिए Fugu के एजेंट पूल में नहीं हो सकते।
लेखन के समय तक, इन संख्याओं के स्वतंत्र पुनरुत्पादन मुझे तृतीय-पक्ष लीडरबोर्ड्स पर दिखाई नहीं दिए हैं।
| Benchmark | Fugu | Fugu Ultra | Opus 4.8 † | Gemini 3.1 Pro † | GPT 5.5 † |
|---|---|---|---|---|---|
| SWE Bench Pro * | 59.0 | 73.7 | 69.2 | 54.2 | 58.6 |
| TerminalBench 2.1 | 80.2 | 82.1 | 74.6 | 70.3 | 78.2 |
| LiveCodeBench | 92.9 | 93.2 | 87.8 | 88.5 | 85.3 |
| LiveCodeBench Pro | 87.8 | 90.8 | 84.8 | 82.9 | 88.4 |
| Humanity's Last Exam | 47.2 | 50.0 | 49.8 | 44.4 | 41.4 |
| CharXiv Reasoning | 85.1 | 86.6 | 84.2 | 83.3 | 84.1 |
| GPQA-D | 95.5 | 95.5 | 92.0 | 94.3 | 93.6 |
| SciCode | 60.1 | 58.7 | 53.5 | 58.9 | 56.1 |
| τ3 Banking | 21.7 | 20.6 | 20.6 | 8.4 | 20.6 |
| Long Context Reasoning | 74.7 | 73.3 | 67.7 | 72.7 | 74.3 |
| MRCRv2 | 86.6 | 93.6 | 87.9 | 84.9 | 94.8 |
SWE-Bench Pro पर Fugu Ultra 73.7% स्कोर करता है—Claude Opus 4.8 के 69.2%, GPT-5.5 के 58.6%, और Gemini 3.1 Pro के 54.2% से आगे। GPT-5.5 की कवरेज में हमने नोट किया था कि उसने इस बेंचमार्क पर 58.6% स्कोर किया, जिसे Fugu Ultra 15 अंक से पीछे छोड़ देता है।
SWE-Bench Pro यह जाँचता है कि कोई मॉडल सॉफ्टवेयर रिपॉज़िटरीज़ में वास्तविक GitHub इश्यूज़ को हल कर सकता है या नहीं, जिससे यह उपलब्ध अधिक व्यावहारिक कोडिंग बेंचमार्क्स में से एक बनता है। Fugu Ultra और अगले सर्वश्रेष्ठ सार्वजनिक रूप से सुलभ मॉडल के बीच का अंतर उन टीमों के लिए पर्याप्त मायने रखता है जो गंभीर कोड रिव्यू या बग-फिक्सिंग कार्य करती हैं।
Fugu Ultra, LiveCodeBench पर 93.2% और LiveCodeBench Pro पर 90.8% स्कोर करता है। अगले सर्वश्रेष्ठ स्कोर क्रमशः Gemini 3.1 Pro के 88.5% और Claude Opus 4.8 के 87.8% हैं (स्टैंडर्ड संस्करण पर)।
LiveCodeBench हाल की प्रतियोगिताओं से लिए गए प्रतिस्पर्धी प्रोग्रामिंग समस्याओं का परीक्षण करता है, जिसका अर्थ है कि पुराने कोडिंग बेंचमार्क्स की तुलना में प्रशिक्षण डेटा संदूषण का जोखिम कम है। Pro वेरिएंट कठिन समस्याओं का उपयोग करता है। यहाँ Fugu की बढ़त बीटा रिपोर्ट्स में दिखाई दिए मज़बूत कोड रिव्यू प्रदर्शन के अनुरूप है।
Humanity's Last Exam पर Fugu Ultra 50.0% स्कोर करता है, जबकि Claude Opus 4.8 49.8%, Gemini 3.1 Pro 44.4%, और GPT-5.5 41.4% पर हैं।
यह बेंचमार्क वैज्ञानिक और अकादमिक डोमेन्स में विशेषज्ञ-स्तरीय ज्ञान का परीक्षण करता है, जिनके प्रश्न डोमेन विशेषज्ञों के लिए भी कठिन बनाए जाते हैं। इस बेंचमार्क पर 50% का स्कोर उल्लेखनीय है, खासकर जब GPT-5.5 41.4% पर बैठा है। तालिका में किसी भी बेंचमार्क की तुलना में यहाँ Fugu Ultra और GPT-5.5 के बीच का अंतर सबसे बड़ा है।
Fugu और Fugu Ultra, दोनों, GPQA Diamond पर 95.5% स्कोर करते हैं, जबकि Gemini 3.1 Pro 94.3%, GPT-5.5 93.6%, और Claude Opus 4.8 92.0% पर हैं।
GPQA Diamond जीवविज्ञान, रसायन विज्ञान, और भौतिकी में PhD-स्तरीय विज्ञान प्रश्नों का परीक्षण करता है, जो डोमेन विशेषज्ञों द्वारा लिखे गए हैं और गैर-विशेषज्ञों के लिए कठिन होने की पुष्टि की गई है। यह तथ्य कि स्टैंडर्ड Fugu यहाँ Fugu Ultra के बराबर है, संकेत देता है कि इस बेंचमार्क पर ऑर्केस्ट्रेशन ओवरहेड बहुत योगदान नहीं दे रहा—जो उस Q&A कार्य के लिए तर्कसंगत है जिसे बहु-चरणीय योजना की आवश्यकता नहीं होती।
TerminalBench 2.1 पर Fugu Ultra 82.1% स्कोर करता है—GPT-5.5 के 78.2%, Claude Opus 4.8 के 74.6%, और Gemini 3.1 Pro के 70.3% से आगे। TerminalBench उन एजेंटिक कोडिंग कार्यों का परीक्षण करता है जिनमें टर्मिनल वातावरण के साथ इंटरैक्शन की आवश्यकता होती है, जैसे फाइल मैनीपुलेशन, शेल कमांड्स, और बहु-चरणीय निष्पादन।
यह उन बेंचमार्क्स में से एक है जो वास्तविक डेवलपर वर्कफ़्लोज़ से सबसे अधिक संबंधित हैं, और यहाँ GPT-5.5 पर Fugu Ultra की बढ़त बीटा में रिपोर्ट किए गए साइबरसुरक्षा मूल्यांकन उपयोग-केस के अनुरूप है।
MRCRv2 में GPT-5.5 94.8% के साथ जीतता है, जबकि Fugu Ultra 93.6% और Claude Opus 4.8 87.9% पर हैं। MRCRv2 लंबी संदर्भ-वाली स्मृति (लॉन्ग-कॉन्टेक्स्ट रिकॉल) का परीक्षण करता है—विशेष रूप से यह कि क्या कोई मॉडल बहुत लंबे दस्तावेजों से विशिष्ट जानकारी पुनः प्राप्त कर सकता है।
यह एकमात्र बेंचमार्क है जहाँ Fugu Ultra अग्रणी नहीं है—जो उन टीमों के लिए ध्यान देने योग्य है जिनका प्राथमिक उपयोग-केस बड़े दस्तावेजों से विशिष्ट तथ्य पुनः प्राप्त करना है, न कि बहु-चरणीय तर्क या कोड जेनरेशन।
Fugu अभी Sakana के कंसोल console.sakana.ai के माध्यम से उपलब्ध है, एक OpenAI-संगत API के साथ। हर प्लान में Fugu और Fugu Ultra दोनों शामिल हैं। सब्सक्रिप्शन टियर इस प्रकार हैं:
पे-एज़-यू-गो प्लान मासिक भत्ते के बजाय टोकन उपयोग के अनुसार बिल करता है। Fugu Ultra (मॉडल ID: fugu-ultra-20260615) के लिए, स्टैंडर्ड कॉन्टेक्स्ट लंबाइयों पर कीमतें $5 प्रति मिलियन इनपुट टोकन और $30 प्रति मिलियन आउटपुट टोकन हैं।
272K टोकन से ऊपर के कॉन्टेक्स्ट्स के लिए दरें $10 इनपुट और $45 आउटपुट तक बढ़ जाती हैं। कैश्ड इनपुट $0.50 प्रति मिलियन टोकन है, या 272K से ऊपर $1.00। Fugu की स्टैंडर्ड प्राइसिंग सक्रिय अंतर्निहित मॉडल की दर से मेल खाती है, और जब कई एजेंट्स चल रहे होते हैं तो Sakana शुल्कों को स्टैक नहीं करता।
एक क्षेत्रीय सीमा पर ध्यान दें: Fugu वर्तमान में EU या EEA सदस्य देशों में उपलब्ध नहीं है, जबकि Sakana GDPR अनुपालन पर काम कर रहा है। यूरोपीय टीमों के लिए, फिलहाल यह एक बाधा है। Sakana ने EU उपलब्धता की समय-सीमा प्रकाशित नहीं की है।
Fugu, OpenAI, Anthropic, और Google की दिशा से वास्तव में अलग दांव है। बेस मॉडल स्केल पर प्रतिस्पर्धा करने के बजाय, Sakana तर्क देता है कि अदला-बदली योग्य फ्रंटियर मॉडलों के पूल में सीखा हुआ ऑर्केस्ट्रेशन, उन कार्यों पर किसी भी एकल सिस्टम की बराबरी या उससे बेहतर कर सकता है जो वास्तव में समय लेते हैं: लंबे कोड रिव्यू, बहु-चरणीय रिसर्च, सुरक्षा आकलन, और पेपर पुनरुत्पादन।
यदि ये बेंचमार्क संख्याएँ स्वतंत्र सत्यापन पर खड़ी उतरती हैं, तो वे डेवलपर्स के लिए मायने रखने वाले अधिकांश मेट्रिक्स पर इस तर्क का समर्थन करती हैं। बेशक, जब तक हमें Fable 5 और Mythos तक फिर से पहुँच नहीं मिलती, तब तक हम उनसे सीधी तुलना नहीं कर सकते।
यह कहने के बाद भी, निश्चित रूप से कुछ सावधानियाँ हैं।
सभी बेंचमार्क स्कोर Sakana-रिपोर्टेड हैं। रूटिंग लेयर अपारदर्शी है, जो अनुपालन-संवेदनशील कार्यों के लिए घर्षण पैदा करती है। EU/EEA अपवर्जन वैश्विक डेवलपर समुदाय के एक बड़े हिस्से के लिए अपनाने को सीमित करता है। और सरल कार्यों पर विलंबता का ट्रेड-ऑफ वास्तविक है: यदि आप तेज़, सिंगल-टर्न API कॉल्स कर रहे हैं, तो Fugu Ultra का ऑर्केस्ट्रेशन ओवरहेड बिना लाभ के शुद्ध लागत है।
जहाँ मुझे लगता है कि Fugu का ठोस मामला बनता है, वह टीमें हैं जो लंबे क्षितिज वाले एजेंटिक वर्कफ़्लोज़ चला रही हैं और पहले से ही स्वयं मल्टी-मॉडल सेटअप्स की जटिलता संभाल रही हैं। यदि आप Claude और GPT के ऊपर अपना ऑर्केस्ट्रेशन हार्नेस मेंटेन कर रहे हैं, तो Fugu Ultra एक गंभीर मूल्यांकन के योग्य है।
संप्रभुता का खाका शायद ज्यादा बेचा गया है, लेकिन एकल एंडपॉइंट का व्यावहारिक मूल्य, जो प्रदाता व्यवधानों के आसपास रूट कर देता है, कम नहीं आँका जा सकता।
यदि आप उस एजेंटिक AI परिदृश्य पर पकड़ बनाना चाहते हैं जिसमें Fugu काम कर रहा है, तो मैं DataCamp के AI Agent Fundamentals स्किल ट्रैक से शुरू करने की सलाह दूँगा, जो बड़े भाषा मॉडलों, एजेंट्स, और मल्टी-मॉडल सिस्टम्स की बुनियाद कवर करता है।
श्रेष्ठ DataCamp पाठ्यक्रम
कोर्स
लर्निंग पाथ
कोर्स
