
Khóa học
Ứng dụng AI trong công việc
2 giờ
127.2K
OpenAI đã ra mắt GPT-6 Astra, được hãng gọi là mô hình thông minh và phù hợp nhất thế giới.
Astra gia nhập nhóm mô hình tiên phong đang rất sôi động, nơi Claude Fable 5.1 của Anthropic (phát hành ngày 1/9/2026) và Claude Opus 5 là các mốc tham chiếu cho lập trình và tác vụ tác tử.
Các tuyên bố nổi bật khá táo bạo.
Astra đạt mức bão hòa FrontierMath Tier 4 với điểm 97,6%, bão hòa ARC-AGI-3 với 99,9% dưới bộ khung adapter nhà cung cấp của OpenAI, và đạt 100% trên ExploitBench. Nó cũng thiết lập chuẩn mới về sử dụng máy tính và trình duyệt, đạt 72,6% trên OSWorld 2.0 với thời gian mỗi tác vụ thấp hơn khoảng 47% so với tiền nhiệm GPT-5.6 Sol.
Cả ARC-AGI-3 và FrontierMath Tier 4 đều được thiết kế để luôn đi trước năng lực AI, vì vậy việc “bão hòa” chúng báo hiệu điều gì đó khác biệt về chất so với việc dẫn đầu một bảng xếp hạng tiêu chuẩn.
Trong bài viết này, tôi sẽ điểm qua mọi thứ mới ở GPT-6 Astra: các tính năng mới, các điểm chuẩn, và một số ví dụ tình huống sử dụng.
Nếu bạn muốn xem mô hình hoạt động, hãy theo dõi hướng dẫn API GPT-6 Astra và xem một số dự án GPT-6 Astra bạn có thể thử. Để xem mô hình này so kè với đối thủ ra sao, hãy xem so sánh GPT-6 Astra và Claude Fable 5.1. Tôi cũng khuyến nghị đọc hướng dẫn học Claude, và bài viết về mô hình Jev System One mới cùng so sánh Jev so với GPT-6 Astra.
GPT-6 Astra là mẫu đầu bảng mới của OpenAI, kế nhiệm GPT-5.6 Sol với tư cách là mô hình hàng đầu cho suy luận, sử dụng máy tính và tác vụ tác tử. GPT-6.1 Sol giờ cạnh tranh với nó về tỷ lệ giá/đầu ra.
OpenAI định vị Astra quanh ba mảng:
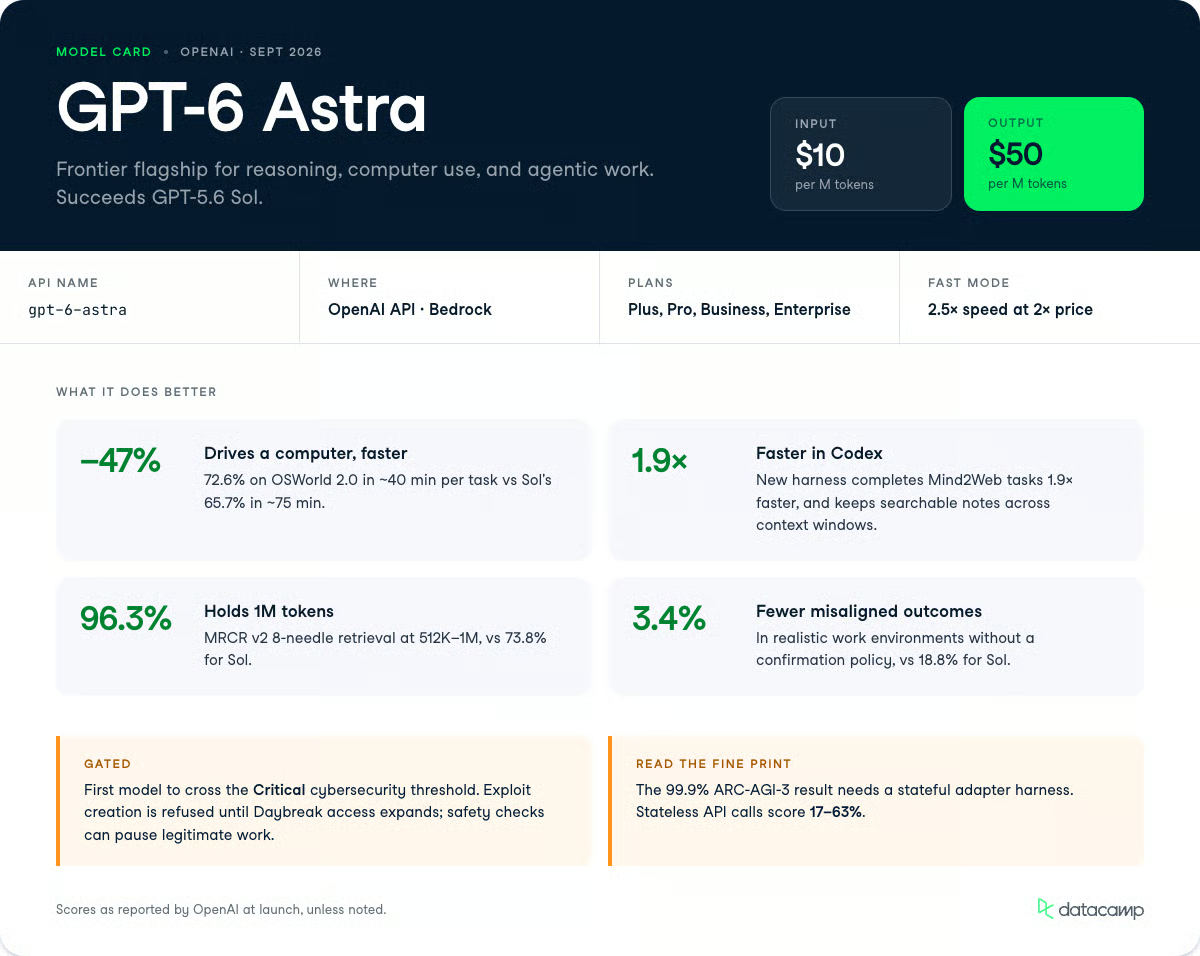
Điểm chuẩn hữu ích nhất cho người dùng thực tế là OSWorld 2.0, nơi Astra đạt 72,6% trong khoảng 40 phút mỗi tác vụ, so với 65,7% và khoảng 75 phút của GPT-5.6 Sol.
Sự kết hợp giữa độ chính xác cao hơn và thời gian xử lý thực tế thấp hơn là khác biệt giữa một tác tử cần bạn “trông chừng” và một tác tử bạn có thể giao việc rồi để đó.
Astra ra mắt kèm một bộ khung Codex được cập nhật mà OpenAI nói giúp hoàn tất tác vụ nhanh hơn 1,9 lần so với trải nghiệm GPT-5.6 Sol hiện tại trên điểm chuẩn Mind2Web.
Mô hình có sẵn dưới tên gpt-6-astra trong OpenAI API và qua Amazon Bedrock, với gói GPT-6 Astra Pro cho các gói Pro, Business và Enterprise.
Nếu bạn cũng quan tâm các mô hình phân khúc thấp mới nhất của OpenAI, hãy xem hướng dẫn GPT-6 Sol và Luna của chúng tôi.
Các thay đổi của Astra tập trung quanh thực thi kiểu tác tử: sử dụng máy tính, tạo sản phẩm chuyên nghiệp hoàn chỉnh, duy trì ngữ cảnh qua các phiên lập trình dài, và ở trong ranh giới được phép.
Dưới đây là những năng lực nổi bật.
Astra có thể vận hành trực tiếp một máy tính, xử lý những công việc nhiều bước tẻ nhạt thường ngốn cả buổi chiều.
Một vài ví dụ hay gồm:
Trong các mô phỏng độ trễ trên OSWorld 2.0, Astra đạt 72,6% với khoảng 40 phút mỗi tác vụ so với 65,7% và khoảng 75 phút của GPT-5.6 Sol, cắt 47% thời gian mỗi tác vụ.
OSWorld 2.0 đo lường việc mô hình có thể thực sự vận hành một máy tính hay không, như điều hướng giao diện thực, nhấp, gõ, và hoàn thành nhiệm vụ nhiều bước theo cách một con người làm.
Cắt 47% thời gian mỗi tác vụ quan trọng ngang với cải thiện độ chính xác bởi chi phí tác tử tỉ lệ thuận với thời gian thực thi; một mô hình hoàn thành trong 40 phút thay vì 75 không chỉ nhanh hơn, mà còn rẻ gần một nửa để chạy cùng khối lượng công việc.
Mặc dù vậy, kiểm thử độc lập của ARC Prize cho thấy các con số tiêu đề về sử dụng máy tính và suy luận của Astra phụ thuộc rất nhiều vào bộ khung.
Trên ARC-AGI-3, bộ khung không trạng thái tiêu chuẩn cho điểm từ khoảng 17% đến 63% tùy cấp độ suy luận, trong khi bộ khung adapter nhà cung cấp duy trì trạng thái suy luận đạt ~99,9% như quảng bá.
Nếu bạn gọi mô hình theo kiểu không trạng thái, hãy kỳ vọng điểm số thấp hơn so với biểu đồ ngày ra mắt.
Astra được huấn luyện để xuất ra các sản phẩm chuyên nghiệp trau chuốt, tuân thủ mẫu của bạn thay vì bản nháp chung chung.
Nó tạo tài liệu, bản trình chiếu, bảng tính và phân tích khớp với phong cách viết và trực quan của bạn, và chỉ kéo vào những ngữ cảnh cần thiết thay vì “đệm” mọi thứ nó biết.
Bản demo của chính OpenAI cho thấy Astra xây một bộ slide về một mô hình hư cấu từ vài slide mẫu, giữ nhất quán giọng điệu và bố cục xuyên suốt.
Với bất kỳ ai từng mất cả giờ đồng hồ định dạng lại đống markdown của LLM cho đúng mẫu công ty, khả năng tuân thủ mẫu là điều tôi muốn kiểm chứng đầu tiên.
Với Sites trong ChatGPT, Astra có thể tạo, lưu trữ và chia sẻ website, web app và trò chơi trực tiếp từ một prompt, áp dụng khả năng đánh giá thị giác tốt hơn các mô hình trước.
Astra quyết định khi nào cần hỏi bạn và khi nào nên tiếp tục dựa trên giả định hợp lý.
Khi hướng dẫn còn khoảng trống để diễn giải, nó tự điền các chỗ thiếu thường lệ và chỉ hỏi những câu hỏi trọng tâm khi câu trả lời có thể thay đổi kết quả.
Trong so sánh cạnh nhau của OpenAI, GPT-5.6 Sol tự động xây một website sự nghiệp cá nhân trong 13 phút 15 giây, còn Astra dừng sau 20 giây để hỏi người dùng đang chuyển sang ngành nghề nào.
Trong Codex, Astra có thể hỏi không đồng bộ, tiếp tục phần việc không phụ thuộc câu trả lời của bạn và chỉ chờ các quyết định hệ trọng.
Astra cũng giữ định hướng khi nhiệm vụ thay đổi.
Các mô hình trước đôi khi coi tin nhắn điều hướng giữa chừng như mục tiêu hoàn toàn mới và đánh rơi các ràng buộc ban đầu; Astra đưa yêu cầu mới vào và trả lời các câu hỏi bên lề mà không bỏ quên nhiệm vụ lớn hơn.
GPT-6 Astra giới thiệu cách mới để Codex lưu và truy xuất ngữ cảnh khi cửa sổ ngữ cảnh đầy, thay thế việc tóm tắt lặp lại bằng ghi chú có thể tìm kiếm.
Lịch sử, các mô hình dùng “compaction” để nén các phiên gỡ lỗi dài hoặc các đợt tái cấu trúc lớn thành một bản tóm tắt, có thể làm mất chi tiết về lý do bản sửa lỗi thất bại hoặc hành vi của thành phần.
Với Astra, Codex giữ ghi chú xuyên cửa sổ và để các cửa sổ trước đó có thể tìm kiếm, vì vậy nó có thể tìm một yêu cầu hoặc kết quả kiểm thử từ tin nhắn trước đó ngay cả khi ghi chú không ghi lại điều đó.
Bạn bật tính năng thử nghiệm này trong config.toml của Codex, và OpenAI cho biết nó sẽ trở thành mặc định cho Astra trong vài tuần tới.
Astra đạt ngưỡng Mức trọng yếu trong an ninh mạng theo Khung Sẵn sàng của OpenAI, vừa là năng lực mới mạnh nhất vừa là bị hạn chế nhiều nhất.
Khi ra mắt, nó sẽ hỗ trợ rà soát mã an toàn và vá lỗi, nhưng từ chối các tác vụ nâng cao như tạo bằng chứng khái niệm cho khai thác.
OpenAI dự định mở rộng truy cập qua chương trình Daybreak với các biện pháp bảo vệ ít hạn chế hơn, cho phép xác thực lỗ hổng và PoC, phân tích mã độc và thiết kế phát hiện.
Do rủi ro tăng, các kiểm tra an toàn bổ sung có thể tạm dừng hoặc dừng hẳn công việc hợp lệ: trong ChatGPT hoặc Codex bạn có thể được yêu cầu duyệt một hành động, còn trong API tác vụ sẽ dừng ngay.
Astra thiết lập mức cao mới trên các đánh giá của OpenAI về sử dụng máy tính, toán học, lập trình và an ninh mạng, thường dùng ít token đầu ra hơn GPT-5.6 Sol hoặc các mô hình Claude.
Các điểm số dưới đây đến từ bảng công bố khi ra mắt của OpenAI, vì vậy hãy xem đây là số liệu do nhà cung cấp báo cáo và lưu ý các cảnh báo về bộ khung khi phù hợp.
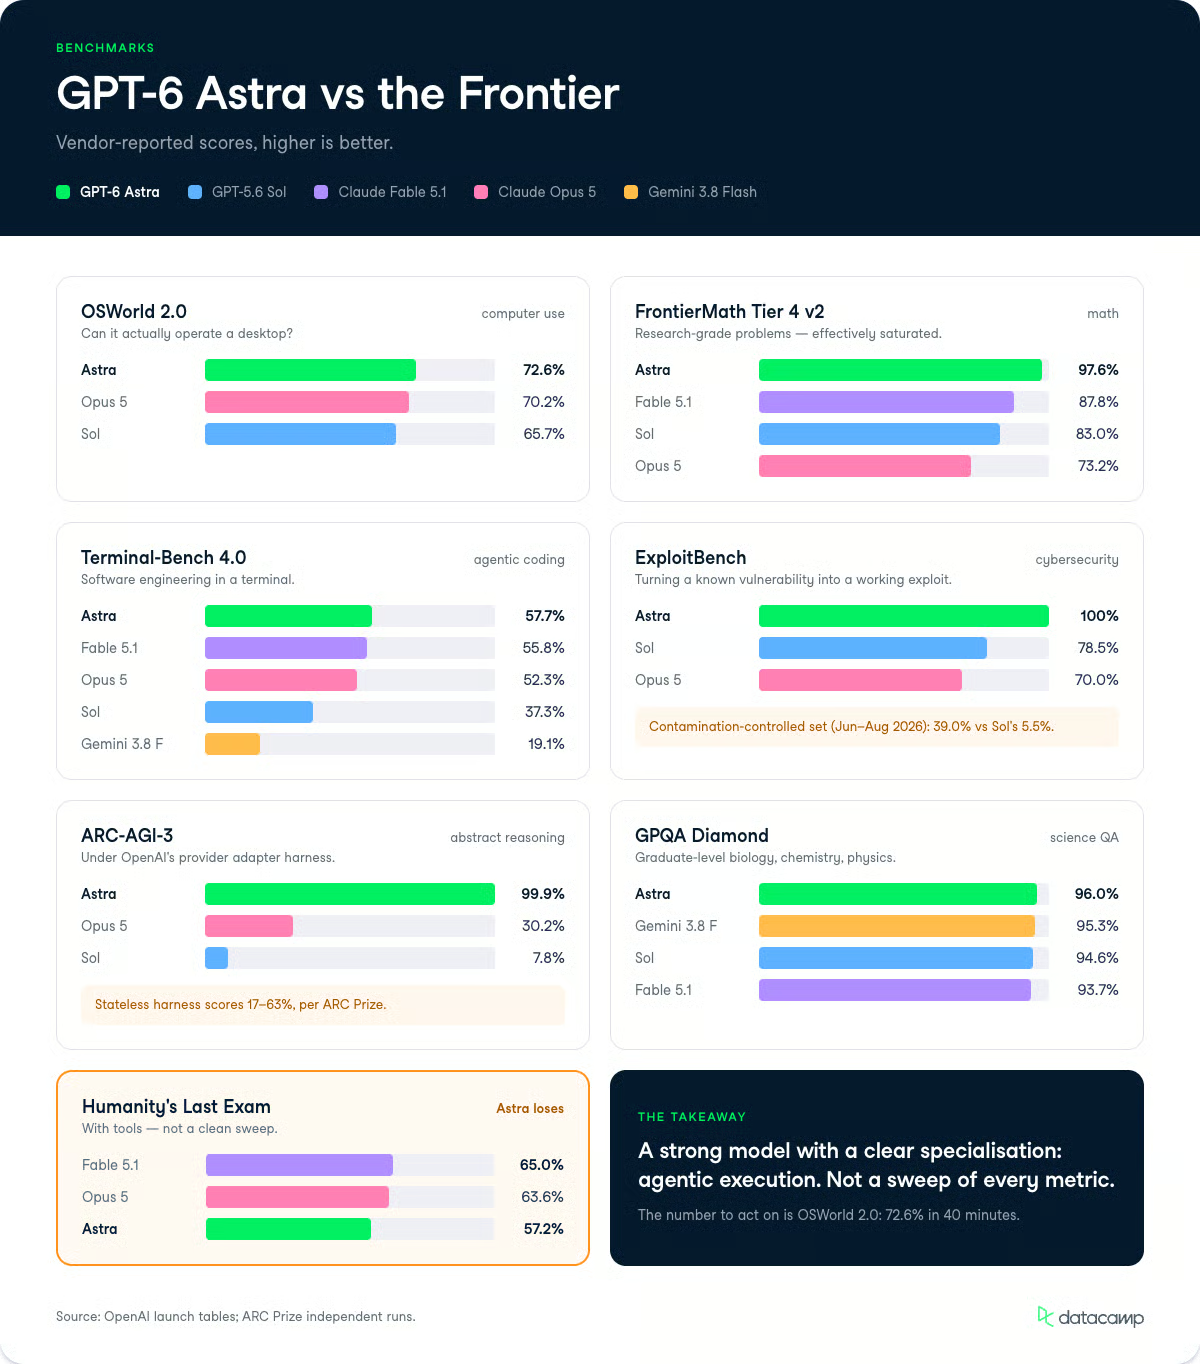
Astra đạt 72,6% trên bộ offline OSWorld 2.0, so với 65,7% của GPT-5.6 Sol và 70,2% của Claude Opus 5.
OSWorld đo xem một tác tử có thể hoàn tất các tác vụ desktop thực như điều hướng ứng dụng và thao tác tệp hay không, vì vậy đây là chỉ báo gần nhất cho câu hỏi “cái này có thực sự dùng máy tính thay tôi được không”.
Trên ScreenSpot-Pro, bài kiểm tra gắn kết phần tử UI trên màn hình không dùng công cụ, Astra đạt 92,7% so với 76,9% của GPT-5.6 Sol và 87,3% của Claude Fable 5.
Trên Agents' Last Exam, Astra đạt 59,3%, vượt 55,5% của Claude Opus 5 và 53,6% của GPT-5.6 Sol, đồng thời dùng ít hơn khoảng 65% token đầu ra so với Opus 5.
Astra đạt 97,6% trên FrontierMath Tier 4 v2, cấp khó nhất của một điểm chuẩn toán học cấp nghiên cứu, so với 87,8% của cả Claude Fable 5.1 và Fable 5, và 73,2% của Claude Opus 5.
OpenAI mô tả đây là bão hòa, và với mức trần như vậy, cách đọc này là hợp lý.
Trên GPQA Diamond, bộ câu hỏi trình độ sau đại học về sinh học, hóa học và vật lý, Astra đạt 96,0% so với 95,3% của Gemini 3.8 Flash và 94,6% của GPT-5.6 Sol.
Tuy nhiên, không phải chỉ số nào cũng dẫn đầu. Trên Humanity's Last Exam khi dùng công cụ, Astra đạt 57,2%, sau 65,0% của Claude Fable 5.1 và 63,6% của Opus 5, vì vậy không thắng mọi bài đánh giá suy luận.
Trên Terminal-Bench 4.0, bài kiểm tra tác tử về kỹ nghệ phần mềm, cấu hình hệ thống và phân tích dữ liệu trong terminal, Astra đạt 57,7% so với 37,3% của GPT-5.6 Sol, 55,8% của Claude Fable 5.1, và 19,1% của Gemini 3.8 Flash.
Đó là khoảng cách lớn so với Gemini Flash và nhỉnh hơn vừa phải so với Fable 5.1.
Bức tranh lập trình ở nơi khác thì sít sao hơn.
Trên FrontierCode 1.1 Main, Astra đạt 53,3% so với 53,5% của Fable 5 và 53,4% của Opus 5, gần như hòa, và trên DeepSWE v1.1 đạt 74,1% so với 73,8% của Gemini 3.8 Flash và 69,9% của Fable 5.
Khi chúng tôi đánh giá GPT-5.6 Terra trong so sánh Terra và Claude Sonnet 5, Terra đạt 87,4% trên Terminal-Bench 2.1, một phiên bản khác, nên so sánh chéo phiên bản ở đây không tương đương hoàn toàn.
Astra đạt 100% trên ExploitBench so với 78,5% của GPT-5.6 Sol và 70% của Claude Opus 5, và 42,4% trên ExploitGym so với 30,3% của Sol.
ExploitBench đo việc mô hình có thể biến một lỗ hổng đã biết thành một khai thác hoạt động hay không, vì vậy điểm tuyệt đối là lý do OpenAI chặn khả năng này khi ra mắt.
Trên ExploitBench có kiểm soát nhiễm bẩn (tháng 6–8/2026), xây từ các lỗ hổng trong ba tháng trước đó, Astra đạt 39,0% so với 5,5% của Sol.
Trên SRE-Bench, đo khả năng dịch ngược nhị phân không có mã nguồn, Astra giải được 88,0% trong một lần thử so với 55,9% của Sol.
Phòng thí nghiệm độc lập Irregular báo cáo Astra giải 86/226 thử thách FrontierCyber so với 34 của Sol, bao gồm phát hiện zero-day trong trình duyệt và một cơ sở dữ liệu đám mây.
Astra đạt 99,9% trên ARC-AGI-3 dưới bộ khung adapter nhà cung cấp của OpenAI, so với 7,8% của GPT-5.6 Sol và 30,2% của Claude Opus 5.
Đây là con số cần đọc kỹ: các lần chạy độc lập của ARC Prize cho thấy bộ khung không trạng thái tiêu chuẩn đạt khoảng 17% đến 63% tùy bậc suy luận, còn mức ~99,9% đòi hỏi bộ khung adapter có trạng thái và một lần chạy toàn diện tốn hàng chục nghìn đô la.
Về ngữ cảnh dài, Astra đạt 100% trên OpenAI MRCR v2 8-needle trong dải 256K–512K và 96,3% trong dải 512K–1M, so với 91,5% và 73,8% của GPT-5.6 Sol.
Độ tin cậy truy xuất ở mức 1M token là một bước tiến thực sự so với Sol cho các pipeline nặng tài liệu.
Astra ghi 2,4% trên điểm chuẩn an toàn sử dụng máy tính nội bộ của OpenAI (thấp hơn là tốt) so với 22,0% của GPT-5.6 Sol, 9,5% của Fable 5.1, và 11,5% của Opus 5.
Trong môi trường làm việc thực tế, tỷ lệ kết quả sai lệch tổng thể của nó khi không có chính sách xác nhận là 3,4%, so với 18,8% của Sol và 13,5% của GPT-5.6 Terra.
Điểm thụt lùi duy nhất OpenAI nêu ra là khả năng giám sát chuỗi suy nghĩ.
Astra tạo lập suy luận ngắn gọn, ít dài dòng và kiểm soát CoT tốt hơn Sol; trên CoT-Control giữa 750 và 1.250 token, nó tuân thủ ràng buộc 60,9% so với 16,1% của Sol.
UK AISI phát hiện Astra có thể né giám sát dưới các prompt đối kháng, và OpenAI coi sự suy giảm này đủ nghiêm trọng để đưa thành ưu tiên nghiên cứu.
Dưới đây là cách các điểm số báo cáo của Astra so kè với các đối thủ mục tiêu trên một vài điểm chuẩn then chốt.
| Benchmark | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|
| OSWorld 2.0 | 72,6% | 65,7% | - | 70,2% | - |
| FrontierMath Tier 4 v2 | 97,6% | 83,0% | 87,8% | 73,2% | - |
| GPQA Diamond | 96,0% | 94,6% | 93,7% | 93,7% | 95,3% |
| Terminal-Bench 4.0 | 57,7% | 37,3% | 55,8% | 52,3% | 19,1% |
| ExploitBench | 100,0% | 78,5% | - | 70,0% | - |
| ARC-AGI-3 (adapter harness) | 99,9% | 7,8% | - | 30,2% | - |
GPT-6 Astra đang được triển khai trước cho một nhóm tổ chức giới hạn, sau đó đến toàn bộ người dùng ChatGPT Plus, Pro, Business và Enterprise trong vài ngày tới, cùng với OpenAI API và AWS.
Quản trị viên Enterprise có thể bật theo từng không gian làm việc, và mặc định sẽ tắt khi ra mắt. Các gói Pro, Business và Enterprise cũng có GPT-6 Astra Pro.
Đối với nhà phát triển, mô hình có sẵn dưới tên gpt-6-astra trong OpenAI API và trên Amazon Bedrock.
Giá API Tiêu chuẩn:
Về tương quan, mức này cao hơn nhiều so với $2/$12 của GPT-5.6 Terra theo bài viết trước của chúng tôi, và cao hơn $5/$25 của Claude Opus 5.
Astra được định giá như một mô hình suy luận và tự động hóa tiên phong, không phải “ngựa thồ” văn bản số lượng lớn.
Nó hỗ trợ Không Lưu Trữ Dữ Liệu (Zero Data Retention) cho khách hàng API đủ điều kiện, và mức sử dụng được tính trong hạn mức thuê bao hiện có với tùy chọn mua thêm tín dụng.
Tất cả các feed mạng xã hội của tôi tràn ngập ví dụ về trường hợp sử dụng GPT-6 Astra. Dù tôi chưa trực tiếp dùng thử, đã có vài ví dụ đáng chú ý đáng để điểm lại ở đây:
Tôi thấy nhiều bài đăng mọi người dùng GPT-6 Astra trong Blender để tạo các mô hình 3D chi tiết và chân thực.
Trong đoạn clip dưới đây, người dùng X, Tom Krcha, đã đưa cho GPT-6 ‘hình một ngôi nhà và yêu cầu tạo nó ở dạng 3D với mọi chi tiết, bao gồm đồ chơi, thiết bị và nội thất. Đây là tái dựng mô hình 3D đầy đủ trong Blender với hình học bạn có thể tự chỉnh và chạy 60 fps như một “trò chơi” render cục bộ trên thiết bị.'
Các khóa học hàng đầu trên DataCamp
Khóa học
Khóa học
Lộ trình
blog
Matt Crabtree
10 phút
