
Khóa học
Lập trình với AI dành cho Developer
1 giờ 30 phút
10.7K
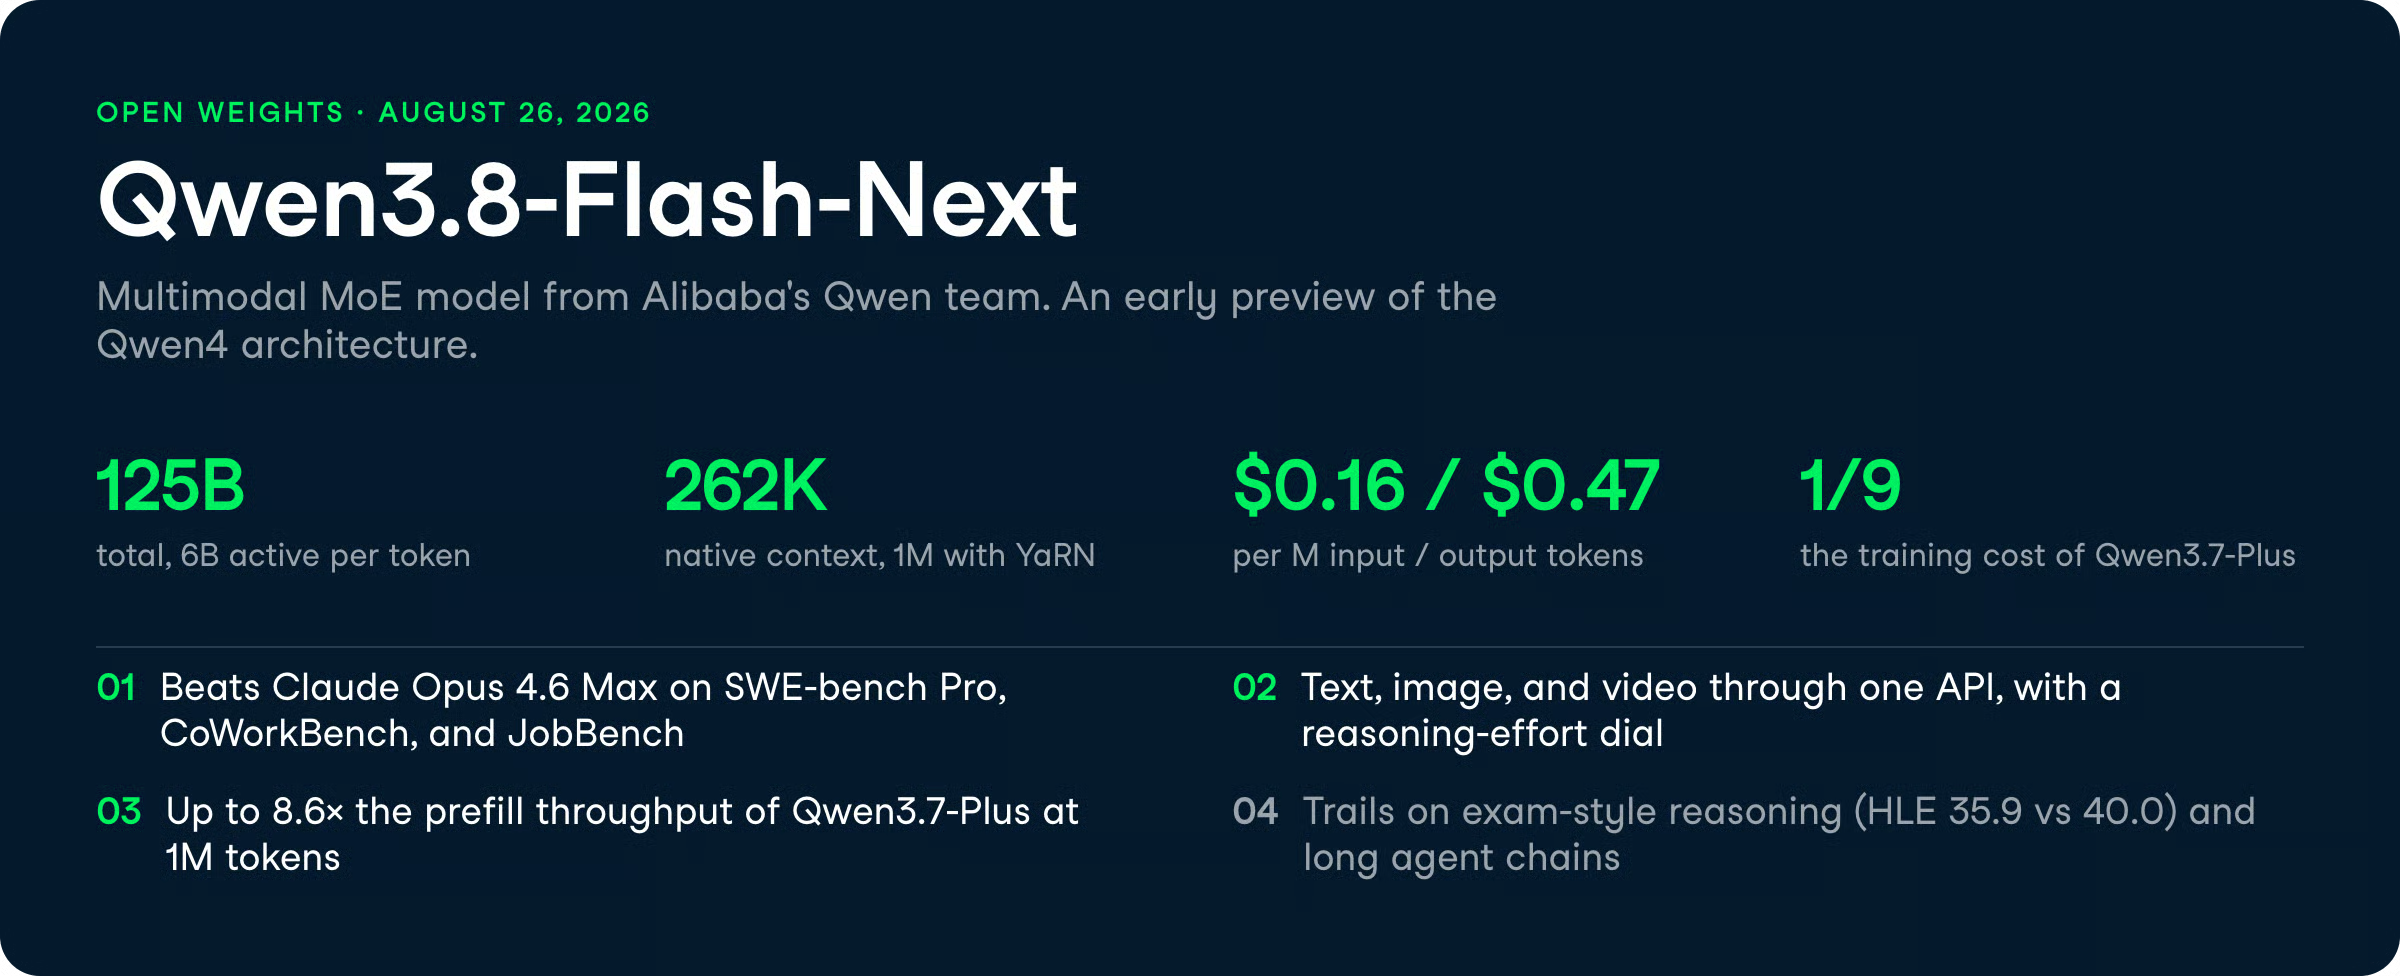
Trong cùng ngày ra mắt GLM-5.3 Flash, đội Qwen của Alibaba đã mở trọng số của Qwen3.8-Flash-Next, một mô hình mixture-of-experts (MoE) đa phương thức, đồng thời là bản xem trước sớm của kiến trúc đứng sau dòng Qwen4 sắp tới.
Động thái này phản chiếu những gì Qwen3-Next từng làm cho Qwen3.5: phát hành thay đổi kiến trúc trước toàn bộ dòng mô hình để cộng đồng có thể mổ xẻ trước.
Câu chuyện lớn ở đây là chi phí. Nhờ kiến trúc mới hiệu quả cao, Qwen3.8-Flash-Next có chi phí huấn luyện chỉ khoảng một phần chín so với người tiền nhiệm Qwen3.7-Plus. Nhưng sức mạnh không bị đánh đổi; mô hình thực tế vượt qua các “tay nặng đô” như Claude Opus 4.6 Max ở các bài kiểm tra mã hóa lớn như SWE-bench.
Trong bài viết này, tôi sẽ điểm qua mọi điều mới với Qwen3.8-Flash-Next, từ kiến trúc, tính năng đến các điểm chuẩn. Để tìm hiểu chi tiết cách tải và chạy mô hình cục bộ, hãy đọc hướng dẫn Qwen3.8-Flash-Next của chúng tôi. Nếu bạn muốn bối cảnh về các mô hình Trung Quốc khác, xem hướng dẫn về Qwen3.8-Max và bài hướng dẫn chạy DeepSeek-V4-Flash-0731 cục bộ. Tôi cũng khuyến nghị xem bản phát hành mới Qwen3.8-Omni-Flash.
Qwen3.8-Flash-Next là mô hình MoE đa phương thức của đội Qwen (Alibaba), phát hành ngày 26/08/2026, được định vị là một “ngựa thồ” tiết kiệm chi phí hơn là một mẫu flagship hạng đầu.
Mức độ thông minh thấp hơn dòng Max, nhưng gần như đánh bại tất cả về giá — đúng với mục tiêu của dòng “Flash”.
Mô hình hỗ trợ gốc cửa sổ ngữ cảnh 262.144 token, mở rộng lên 1.000.000 token với YaRN (phương pháp [Yet another RoPE extensioN], một kỹ thuật mã hóa vị trí kéo giãn cửa sổ ngữ cảnh của mô hình, cho phép xử lý đầu vào văn bản khổng lồ trong khi vẫn giữ hiệu năng gốc).
Mô hình xử lý văn bản, hình ảnh và video qua một API duy nhất — một trong những lý do khiến nhiều bình luận gọi đây là “ngôi sao cộng đồng sau một đêm” trong các tổng hợp phát hành tháng 8/2026.
Điều khiến bản phát hành này quan trọng với người dùng thực hành là tỷ lệ điểm chuẩn trên mỗi đô la.
Qwen3.8-Flash-Next vượt người anh em 27B của chính nó trên mọi điểm chuẩn đã công bố, và vượt Claude Opus 4.6 Max trên hầu hết các đánh giá mã hóa và agent thực tế, trong khi chỉ kích hoạt 6B tham số mỗi token. Đây là bản xem trước kiến trúc Qwen4, nên các lựa chọn thiết kế ở đây báo hiệu hướng đi tiếp theo của Alibaba.
Qwen3.8-Flash-Next nâng cấp mô hình theo bốn trục: attention, residual, embedding và tối ưu hóa.
Bên dưới, tôi sẽ phân tích mỗi thay đổi mang lại lợi ích thực tế gì cho bạn, chứ không chỉ là nó là gì.
Lợi ích thực tiễn lớn nhất là tốc độ trên các đầu vào dài.
Qwen3.8-Flash-Next dùng thiết kế attention lai, trong đó phần lớn lịch sử ngữ cảnh được nén để tiết kiệm dung lượng, và dùng công cụ “Sparse Attention” có mục tiêu để truy xuất đúng chi tiết liên quan khi cần.
Tăng tốc ở mức 1 triệu token là rất lớn: xử lý prompt (prefill) nhanh hơn tới 7.6 lần và sinh (decode) nhanh hơn 4.9 lần. Trong thiết lập phục vụ điển hình với tiền tố được cache, thông lượng tổng thể tăng 8.6 lần so với Qwen3.7-Plus.
Với bất kỳ ai chạy truy xuất khối lượng lớn hoặc agent mã hóa cấp độ kho mã, khác biệt thông lượng đó chính là tính năng.
Bạn trả tiền cho tài nguyên tính toán, và thiết kế này cắt giảm hóa đơn đúng ở những chuỗi dài vốn nổi tiếng là đắt đỏ.
Qwen dùng một mẹo hay gọi là N-gram Embedding để bổ sung 51 tỷ tham số gần như miễn phí. Thay vì chỉ nhìn một token tại một thời điểm, mô hình nhìn token hiện tại cộng các “hàng xóm” gần đây, tạo cho mô hình một “bộ nhớ mẫu cục bộ” khổng lồ.
Vì mô hình biết trước cần tra cứu gì, 51B tham số bổ sung này nằm trong bộ nhớ hệ thống tiêu chuẩn (RAM), không nằm trên GPU. Chúng được nạp tự động ở hậu trường, nghĩa là không chiếm VRAM thường trực hay làm chậm tính toán mỗi token.
Bạn nhận được “bộ não” của một mô hình lớn hơn nhiều mà không phải trả “thuế VRAM” thường thấy.
Qwen3.8-Flash-Next xử lý văn bản, hình ảnh và video qua một giao diện duy nhất, và năng lực thị giác vượt xa tầm giá.
Mô hình vượt Claude Opus 4.6 Max ở các bài kiểm tra sử dụng trên di động (84.5 so với 62.0 trên AndroidWorld) và hiểu thị giác trong thế giới thực (88.5 so với 73.9 trên RealWorldQA).
Mô hình cũng vượt trội ở toán thị giác, đạt tới 95.7 trên MathVision (vượt xa mức 65.5 của Opus).
Nếu quy trình làm việc của bạn liên quan đến phân tích ảnh chụp màn hình, biểu đồ hay giao diện ứng dụng, Qwen mang lại lợi thế thực sự so với Claude ở mức giá này.
API cung cấp một núm reasoning effort với ba chế độ (cao, trung bình, thấp), cho phép bạn đánh đổi giữa độ “suy nghĩ sâu” và độ trễ cùng chi phí thấp hơn.
Mô hình cũng tích hợp mô-đun dự đoán đa token, nghĩa là dự đoán trước nhiều bước để tăng tốc sinh đầu ra trong khối lượng công việc thực tế.
Lợi ích thực tiễn là khả năng kiểm soát.
Bạn có thể hạ mức suy luận cho lưu lượng lớn nhạy chi phí, và tăng nó cho nhiệm vụ agent phức tạp — tất cả vẫn dùng cùng một ID mô hình.
Xuyên suốt các con số đã công bố, Qwen3.8-Flash-Next dẫn đầu ở hầu hết điểm chuẩn mã hóa và agent, dù tụt lại ở một vài đánh giá suy luận kiểu bài thi.
Mô hình vượt phiên bản 27B của chính nó ở mọi nơi, với khoảng cách lớn nhất ở công việc agent.
Mọi so sánh bên dưới đều từ bảng phát hành của Qwen trừ khi có ghi chú khác.
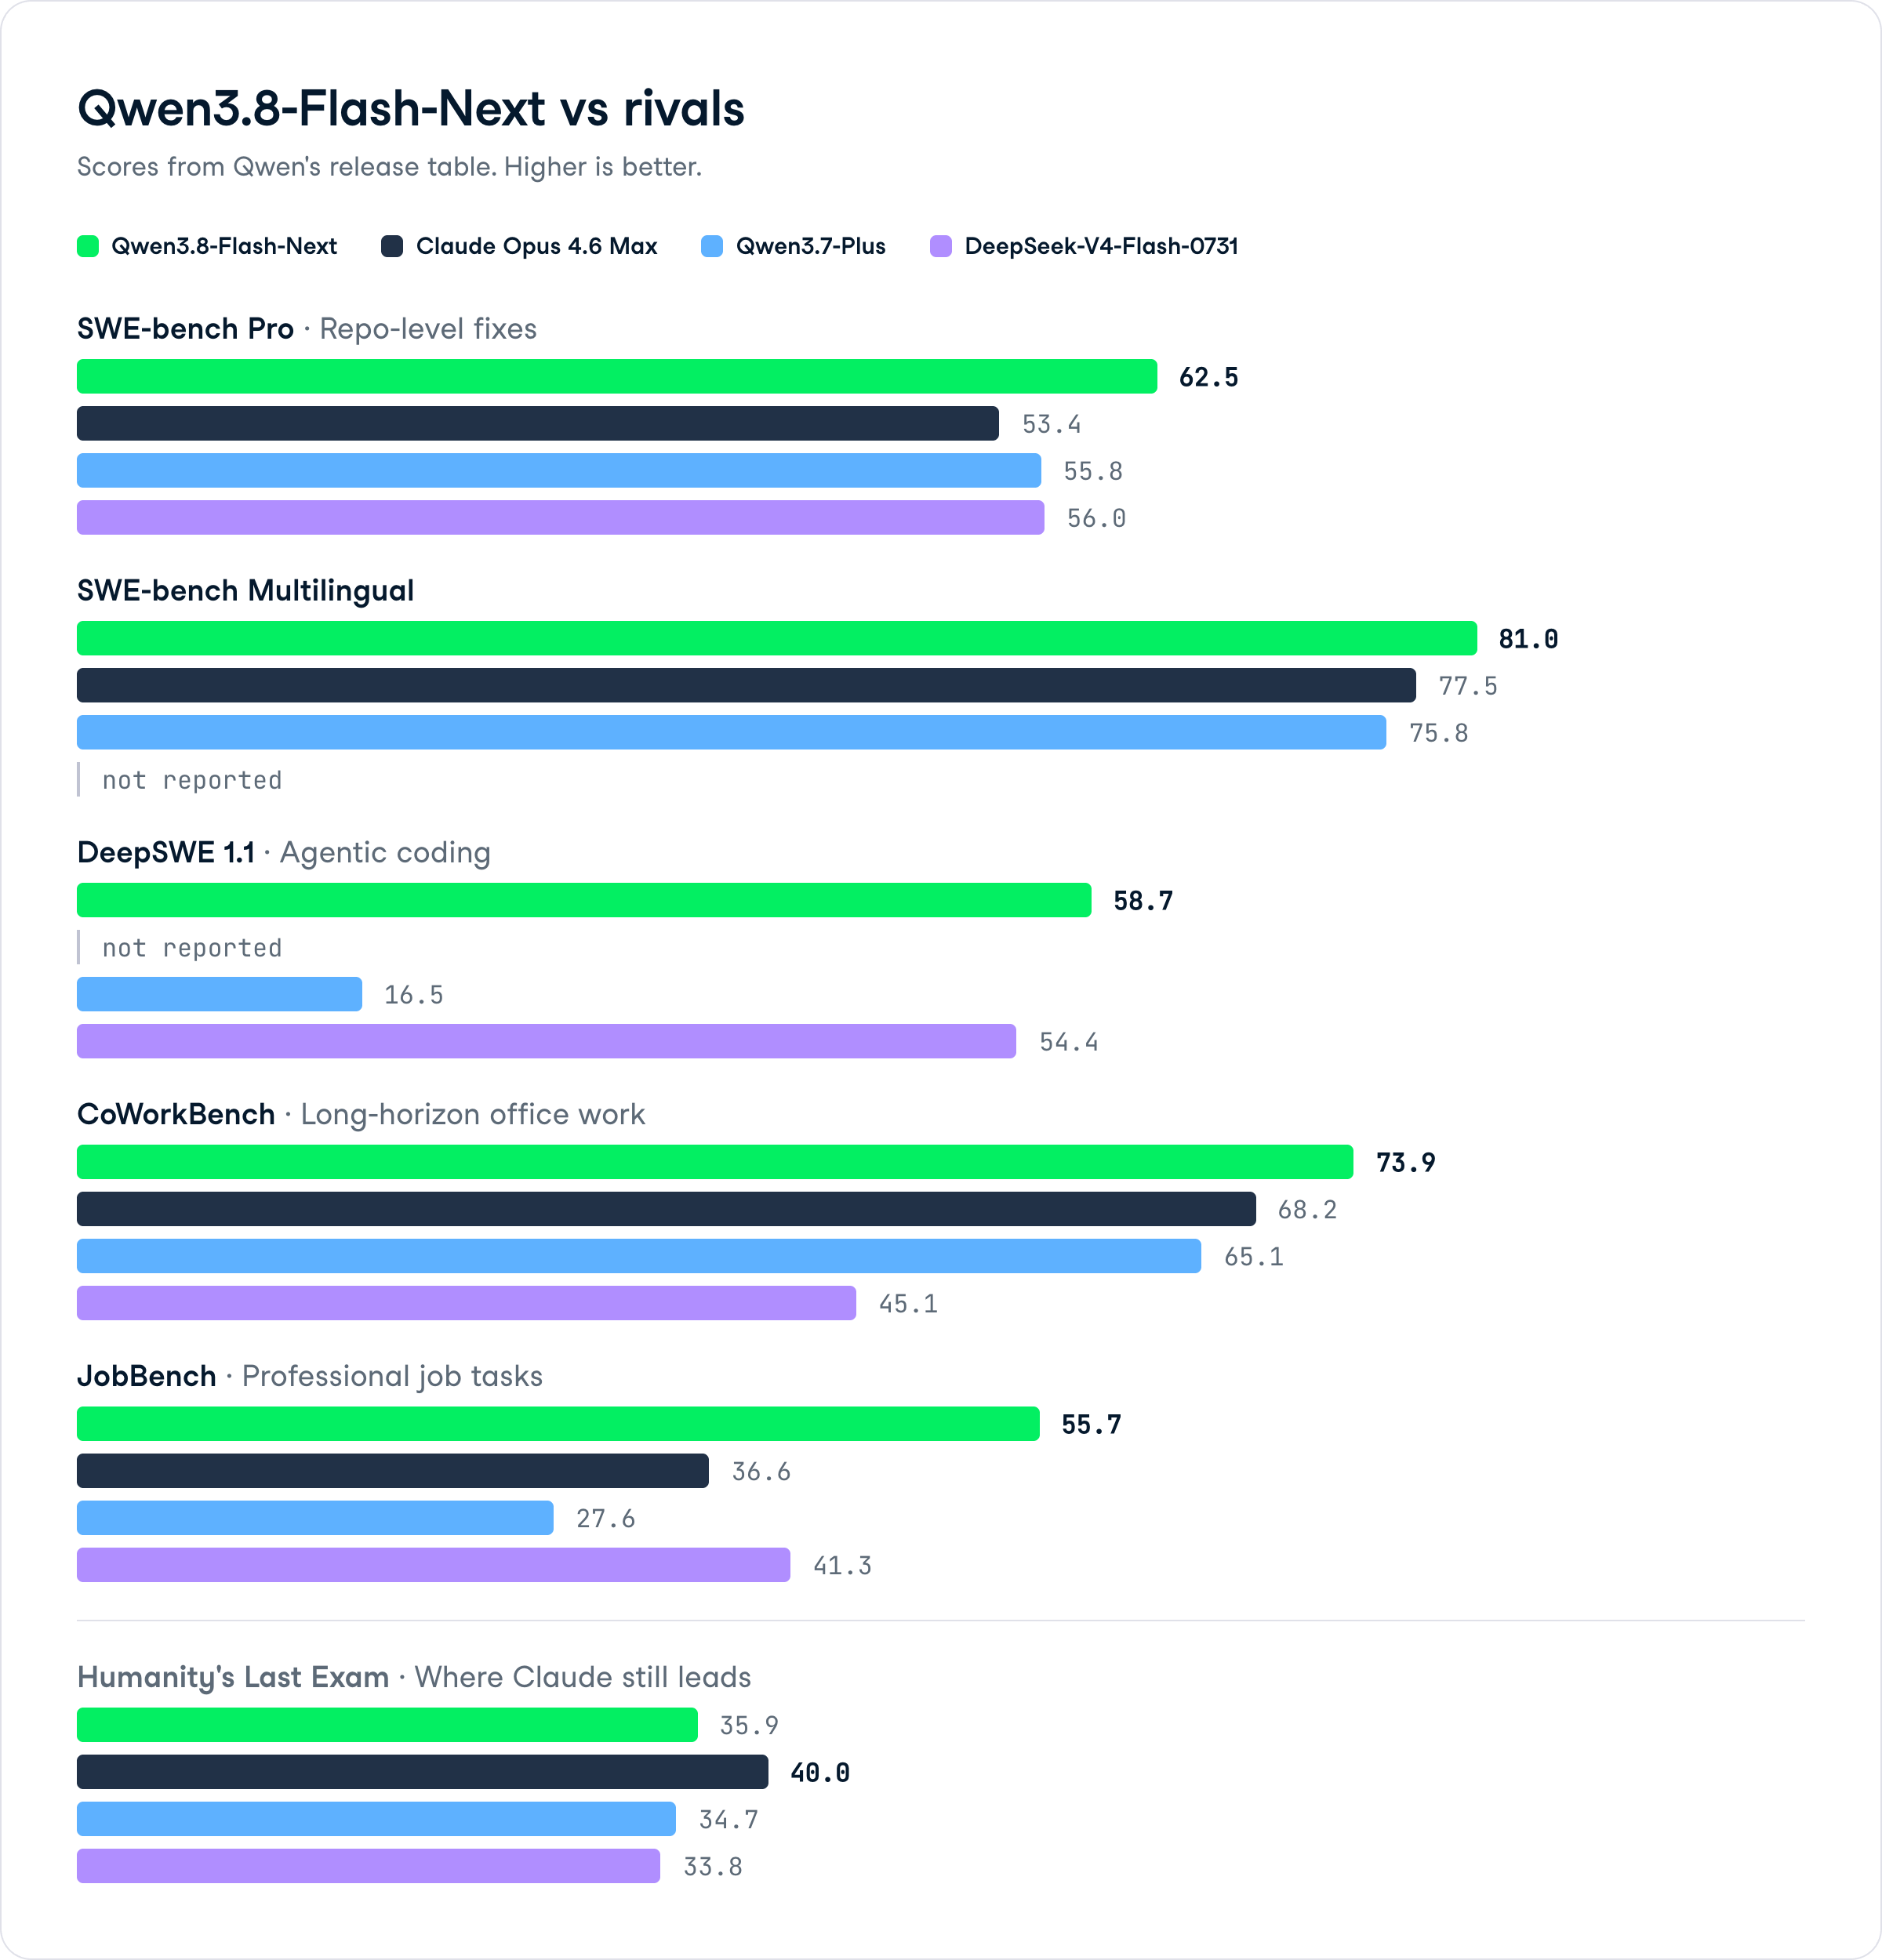
SWE-bench Pro đo lường các bản sửa lỗi phần mềm cấp độ kho mã thực tế, và Qwen3.8-Flash-Next đạt 62.5, vượt Claude Opus 4.6 Max (53.4) và Qwen3.7-Plus (55.8).
Trên SWE-bench Multilingual, bài kiểm tra sửa lỗi đa ngôn ngữ, mô hình đạt 81.0 so với 77.5 của Opus 4.6 Max.
Đây là những con số “gánh team” cho bản phát hành.
Việc một mô hình kích hoạt 6B đánh bại Claude hạng Max ở kỹ thuật cấp kho mã chính là lý do nó thu hút quá nhiều chú ý.
DeepSWE 1.1 đánh giá mã hóa theo kiểu agent qua các bộ khung như Claude Code và mini-SWE-agent, và Qwen3.8-Flash-Next đạt 58.7 so với 42.2 của bản 27B và 16.5 của Qwen3.7-Plus.
DeepSeek-V4-Flash-0731 đạt 54.4 ở đây.
Khi chúng tôi chạy DeepSeek-V4-Flash-0731 như một agent mã hóa trong hướng dẫn, nó xây dựng một website phân tích cổ phiếu hoàn chỉnh từ một prompt duy nhất trong khoảng 20 phút, tạo chat ở tốc độ khoảng 33 token/giây.
Khoảng cách DeepSWE giữa hai mô hình cho thấy Qwen3.8-Flash-Next sẽ hoạt động tốt trong các vòng lặp mã hóa agent tương tự.
Ở phía agent, mô hình đạt điểm mạnh trên nhiều đánh giá:
Khoảng cách ở JobBench là nổi bật.
Với các nhiệm vụ quy trình công việc chuyên nghiệp, Qwen3.8-Flash-Next cao hơn gần 20 điểm so với Claude hạng Max — loại kết quả đáng để thử nghiệm cho tự động hóa doanh nghiệp.
Về suy luận tổng quát, Qwen3.8-Flash-Next đạt 91.7 trên GPQA Diamond (suy luận khoa học), nhỉnh hơn 91.3 của Claude Opus 4.6 Max, và 91.9 trên LiveCodeBench v6 (mã hóa thi đấu) so với 88.8 của Opus 4.6 Max.
Nhưng không phải ở đâu cũng thắng.
Trên Humanity's Last Exam (HLE), bài kiểm tra suy luận đa ngành, mô hình đạt 35.9 so với 40.0 của Claude Opus 4.6 Max. Trên Agents' Last Exam Pass@1, DeepSeek-V4-Flash-0731 nhỉnh hơn 25.2 so với 24.3.
Mẫu hình này nhất quán ở các bộ theo dõi độc lập: Qwen3.8-Flash-Next dẫn ở mã hóa thực tế và công việc agent, trong khi Claude vẫn dẫn ở một số bài suy luận kiểu bài thi.
Qwen3.8-Flash-Next-Base thắng 8/14 điểm chuẩn tiền huấn luyện so với các mô hình nền của Qwen3.8-27B và Qwen3.7-Plus lớn hơn nhiều.
Mô hình dẫn trên MMLU-Pro (73.23), SuperGPQA (51.36), BBH (90.87), GSM8K (93.29), EvalPlus (78.76), SWEBench-Pretrain (50.99), MGSM (89.33) và MMMLU (84.86).
Điều đáng chú ý là làm được điều này với 6B tham số kích hoạt so với 17B kích hoạt và 397B tổng của Qwen3.7-Plus, và vẫn trong khoảng một điểm trên MMLU, MMLU-Redux, GPQA, MATH và MultiPL-E.
51B tham số embedding N-gram được truy cập xác định và không bao giờ đi vào ngân sách nhân ma trận mỗi token, vì vậy đây là hiệu quả thực sự chứ không phải mẹo đếm tham số.
Dưới đây là so sánh với Claude Opus 4.6 Max, người tiền nhiệm Qwen3.7-Plus và DeepSeek-V4-Flash-0731 trên các đánh giá nổi bật.
| Benchmark | Qwen3.8-Flash-Next | Claude Opus 4.6 Max | Qwen3.7-Plus | DeepSeek-V4-Flash-0731 |
|---|---|---|---|---|
| SWE-bench Pro | 62.5 | 53.4 | 55.8 | 56.0 |
| SWE-bench Multilingual | 81.0 | 77.5 | 75.8 | -- |
| DeepSWE 1.1 | 58.7 | -- | 16.5 | 54.4 |
| CoWorkBench | 73.9 | 68.2 | 65.1 | 45.1 |
| JobBench | 55.7 | 36.6 | 27.6 | 41.3 |
| GPQA Diamond | 91.7 | 91.3 | 90.3 | 90.8 |
| LiveCodeBench v6 | 91.9 | 88.8 | 89.6 | 90.6 |
| HLE | 35.9 | 40.0 | 34.7 | 33.8 |
Trọng số Qwen3.8-Flash-Next hiện có sẵn dưới dạng mô hình mở trên Hugging Face và ModelScope.
Bản sản xuất, với ngữ cảnh 1M mặc định và công cụ tích hợp, được phục vụ dưới tên Qwen3.8-Flash trên QwenCloud với ID mô hình qwen3.8-flash.
Giá là nơi mô hình này cạnh tranh mạnh nhất:
Để so sánh, bài viết về Qwen3.8-Max của chúng tôi liệt kê mô hình đó ở mức $2.00 đầu vào và $6.00 đầu ra mỗi triệu token, nên Flash-Next rẻ hơn người anh Max của chính nó hơn 10 lần ở phía đầu vào.
QwenCloud hỗ trợ Chat Completions và Responses API tương thích OpenAI cùng giao diện tương thích Anthropic, nên có thể tích hợp vào Claude Code, Codex và Qwen Code với rất ít thay đổi cấu hình.
Lưu ý tại thời điểm công bố, API được ghi nhận là sắp ra mắt, nên hãy kiểm tra QwenCloud để biết tình trạng trực tiếp.
GLM-5.3-Flash là mô hình tiết kiệm khác ra mắt cùng ngày, và là đối thủ trực diện đáng đặt cạnh nhau nhất.
| Qwen3.8-Flash-Next | GLM-5.3-Flash | |
|---|---|---|
| Kiến trúc | 125B tổng / 6B kích hoạt | 320B tổng / 18B kích hoạt |
| Ngữ cảnh gốc | 262K (1M với YaRN) | 1M token |
| DeepSWE v1.1 | 58.7 | 63.4 |
| SWE-bench Pro | 62.5 | Chưa công bố |
| Giá đầu vào | $0.16/1M | ~$0.075/1M (khuyến mãi) |
| Đa phương thức | Có | Có |
GLM-5.3-Flash dẫn trên DeepSWE v1.1 (63.4 so với 58.7) và đạt 84.3 trên Terminal-Bench 2.1, một điểm chuẩn mà Qwen không công bố số liệu.
Mô hình này cũng có giá đầu vào thấp hơn trong thời gian khuyến mãi và cửa sổ ngữ cảnh 1M token gốc, không cần YaRN.
Qwen3.8-Flash-Next dẫn trên SWE-bench Pro (62.5), CoWorkBench (73.9) và JobBench (55.7), nơi GLM không công bố số tương đương. Qwen cũng kích hoạt ít tham số hơn nhiều mỗi token (6B so với 18B), giúp tự lưu trữ rẻ hơn đáng kể và phục vụ nhanh hơn ở quy mô lớn.
Tóm lại, GLM có số liệu công bố mạnh hơn trên các điểm chuẩn trùng nhau. Qwen dẫn ở các đánh giá công việc văn phòng và quy trình chuyên nghiệp, và là lựa chọn tốt hơn nếu bạn tự vận hành hạ tầng. Để xem phân tích đầy đủ GLM-5.3-Flash, xem hướng dẫn chi tiết của chúng tôi.
Qwen3.8-Flash-Next cho thấy Alibaba tuyên bố rõ ràng: hiệu quả chi phí là chiến trường.
Vượt Claude Opus 4.6 Max trên SWE-bench Pro, CoWorkBench và JobBench chỉ với 6B tham số kích hoạt, với giá $0.16 mỗi triệu token đầu vào, là lời đề nghị nghiêm túc cho bất kỳ ai chạy tác vụ mã hóa hay agent khối lượng lớn.
Tôi sẽ xem đây là lựa chọn mặc định mạnh cho các pipeline dựa trên công cụ và đậm tính mã hóa, với hai lưu ý.
Cộng đồng báo cáo thỉnh thoảng bất ổn trên các chuỗi agent rất dài và dễ vỡ khi công cụ trả về JSON phi chuẩn; mô hình cũng “thoáng” hơn về an toàn so với dòng Claude, nên cần gợi ý cẩn trọng cho nội dung ranh giới.
Kết quả HLE và Agents' Last Exam cũng cho thấy đây không phải mô hình để nhắm tới các bài suy luận kiểu bài thi khó nhất.
Với tư cách là bản xem trước sớm của kiến trúc Qwen4, thiết kế lai GDN + QSA và N-gram Embedding rất đáng theo dõi, vì chúng sẽ là nền tảng cho cả dòng Qwen4 đầy đủ.
Nếu Alibaba duy trì được tỷ lệ điểm chuẩn trên mỗi đô la này ở tầng flagship, câu chuyện định giá ở “vùng biên” sẽ thay đổi.
Nếu bạn muốn xây dựng quy trình agent và mã hóa quanh những mô hình như thế này, tôi khuyến nghị bắt đầu với lộ trình kỹ năng AI Agent Fundamentals để nắm bắt các khái niệm cốt lõi.
Các khóa học hàng đầu trên DataCamp
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
