Cập nhật: SpaceXAI đã phát hành một mẫu mới hơn. Xem bài viết về Grok 4.6 để biết điểm chuẩn, giá và cách so sánh với Grok 4.5
SpaceXAI, công ty mà hầu hết mọi người vẫn gọi là xAI, đã phát hành Grok 4.5 vào ngày 8 tháng 7 năm 2026. Mẫu này nhắm đến lập trình, tác vụ agent và công việc tri thức.
Luận điểm của SpaceXAI về Grok 4.5 không phải là chuỗi thắng tuyệt đối trên các điểm chuẩn. Cursor cho biết hai công ty đã cùng huấn luyện trên hàng nghìn tỷ token từ tương tác của nhà phát triển và agent, trong khi SpaceXAI tập trung vào số token cần để hoàn thành một tác vụ. Biểu đồ công bố cho thấy kết quả đan xen.
Trong bài viết này, tôi so sánh các tuyên bố của SpaceXAI với kết quả độc lập, kiểm thử mẫu thông qua API và Cursor, và xem xét giá, kênh truy cập, cùng giới hạn của nó. Khi biên soạn bài này, tôi đặc biệt muốn kiểm tra chi phí trên mỗi tác vụ hoàn thành, vì tôi biết mức giá theo token chỉ phản ánh một phần khi suy luận, thử lại, và gọi công cụ bắt đầu tính tiền.
Grok 4.5 là gì?
Grok 4.5 là mẫu suy luận mixture-of-experts độc quyền của SpaceXAI. Công dụng nêu ra gồm lập trình, tác vụ agent, và công việc văn phòng nói chung.
Tên "Grok" có thể chỉ ba thứ khác nhau. Chúng có liên quan, nhưng không thể hoán đổi cho nhau.
-
grok-4.5, mẫu lõi, truy cập qua API -
Grok, trợ lý chat cho người dùng tại grok.com và trên X
-
Grok Build, agent lập trình và môi trường dòng lệnh của SpaceXAI, nơi Grok 4.5 hiện là mẫu mặc định
Trong bài viết này, "Grok 4.5" đề cập đến mẫu trừ khi có nêu tên sản phẩm.
Thông tin thêm về Grok 4.5:
- Grok 4.5 có cửa sổ ngữ cảnh 500.000 token.
- Mức độ suy luận có thể đặt thấp, trung bình, hoặc cao, với mặc định là cao.
- Mốc kiến thức là ngày 1 tháng 2 năm 2026.
- Nhận văn bản và hình ảnh, trả về văn bản. Không thể trả về ảnh sinh bởi mẫu. SpaceXAI có các mẫu tạo ảnh riêng cho việc đó.
Grok 4.5 có gì mới?
SpaceXAI nhóm các tuyên bố ra mắt vào lập trình với agent, sử dụng token, công việc văn phòng và hỗ trợ công cụ. Cụm "tác vụ agent" có thể mơ hồ, nên hành động cụ thể quan trọng hơn nhãn gọi.
Lập trình và tác vụ agent
Trong một tác vụ lập trình kiểu agent, mẫu có thể kiểm tra kho mã, lập kế hoạch thay đổi, chỉnh sửa tệp, chạy lệnh, kiểm thử kết quả và thử lại sau lỗi. Điều này khác với trả lời một câu hỏi lập trình đơn lẻ.
SpaceXAI dùng bốn điểm chuẩn kỹ thuật để hỗ trợ tuyên bố này.
Tốc độ và sử dụng token
SpaceXAI báo cáo khoảng 80 token mỗi giây và ít token hơn một số mẫu khác trên cùng tác vụ. Biểu đồ SWE-Bench Pro của họ cho thấy 15.954 token đầu ra trên mỗi tác vụ được giải quyết so với 67.020 của Claude Opus 4.8 ở chế độ tối đa.
Công việc tri thức và tác vụ văn phòng
SpaceXAI nói Grok 4.5 có thể làm nghiên cứu, tài liệu quyết định, bảng tính và bài thuyết trình. Ví dụ của họ dùng các add-in Office, nhưng bản demo của nhà cung cấp không chứng minh được tỷ lệ thành công. Tôi đã tự kiểm thử một tác vụ văn phòng. Đánh giá GDPval+ sớm của Snorkel AI cho kết quả khác: tỷ lệ qua trung bình 29%, so với 22% cho GPT-5.5 và 21% cho Claude Opus 4.8.
GDPval+ gồm khoảng 2.000 tác vụ dựa trên công việc chuyên môn. Tỷ lệ qua áp dụng cho bộ tác vụ đó và phương pháp chấm, không phải cho mọi bảng tính, báo cáo hay bài thuyết trình. Bài kiểm thử API của tôi tách biệt với điểm chuẩn đó.
Công cụ và tính năng API
Grok 4.5 hỗ trợ gọi hàm, đầu ra có cấu trúc, tìm kiếm web và X, thực thi mã, tìm kiếm tài liệu qua bộ sưu tập, và nén ngữ cảnh cho phiên dài. Những công cụ này cho phép ứng dụng tìm thông tin, chạy mã, hoặc kiểm tra kết quả thay vì chỉ trả về văn bản.
Nén ngữ cảnh rút ngắn phần đầu của phiên dài trước yêu cầu tiếp theo. Điều này cho phép tiếp tục phiên mà không cần gửi lại toàn bộ lịch sử. Một số chi tiết có thể mất, và giới hạn ngữ cảnh nêu trước đó vẫn áp dụng.
Grok 4.5 được huấn luyện như thế nào?
Nếu bạn ở đây vì kiểm thử hoặc giá, có thể bỏ qua phần này. SpaceXAI chỉ công bố thông tin huấn luyện hạn chế.
SpaceXAI cho biết Grok 4.5 được huấn luyện trên hàng chục nghìn GPU NVIDIA GB300 với dữ liệu về lập trình, khoa học, kỹ thuật và toán. Học tăng cường bao phủ hàng trăm nghìn tác vụ, gồm các lượt chạy agent kéo dài hàng giờ. Bài ra mắt của Cursor nói bộ huấn luyện bao phủ nhiều chủ đề hơn so với mẫu lập trình Composer 2.5.
Trang ra mắt nói SpaceXAI loại bỏ trùng lặp, chấm điểm chất lượng dữ liệu và chọn dữ liệu theo chủ đề. SpaceXAI cũng mô tả cấu hình huấn luyện cho phép các lượt chạy agent dài tiếp tục trong khi mẫu học từ tác vụ khác. Đây là tiết lộ từ công ty, và tôi sẽ không suy diễn kiến trúc không được liệt kê từ đó.
Điểm chuẩn Grok 4.5: Kết quả chính thức và độc lập
Nguồn và cách thiết lập kiểm thử ảnh hưởng đến khả năng so sánh điểm số.
Điểm chuẩn lập trình chính thức
Biểu đồ của SpaceXAI kết hợp số liệu từ thẻ hệ thống và bảng xếp hạng của nhà cung cấp, thay vì một thiết lập đánh giá nhất quán. DeepSWE 1.0 dùng khung agent của từng nhà cung cấp, trong khi DeepSWE 1.1 dùng thiết lập mini-swe-agent dùng chung. Cursor cũng tiết lộ rằng một snapshot sớm của codebase của họ đã vào dữ liệu huấn luyện và làm tăng điểm CursorBench, nên tôi loại trừ điểm chuẩn đó. Tôi sẽ không coi một khoảng cách nhỏ là quyết định khi thiết lập thay đổi.
Các kiểm thử cũng bao phủ công việc khác nhau. DeepSWE kiểm tra liệu một agent có thể thay đổi một kho mã. SWE Marathon dùng tác vụ dài hơn có thể cần vài bước để hoàn thành. Terminal-Bench 2.1 tập trung vào công việc qua terminal, trong khi SWE-Bench Pro dùng lỗi phần mềm từ các kho. Một điểm số không thể mô tả hiệu năng trên cả bốn loại công việc.
Biểu đồ so sánh Grok 4.5 với Claude Fable 5, GPT-5.5, và Claude Opus 4.8 ở thiết lập suy luận tối đa:
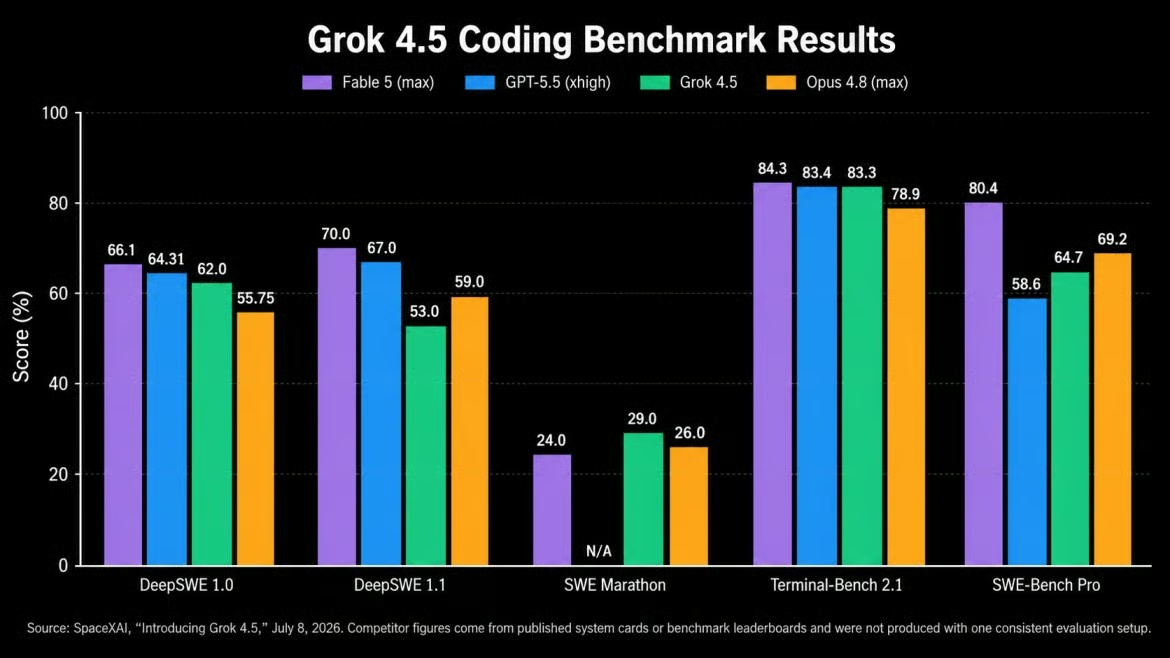
Grok 4.5 dẫn đầu dứt điểm ở một điểm chuẩn. Ảnh: Tác giả.
Trên DeepSWE 1.0, Grok 4.5 đạt 62%, sau Fable 5 ở 66,1 và GPT-5.5 ở 64,3. Nó dẫn đầu SWE Marathon với 29% so với 26 của Opus 4.8. Trên Terminal-Bench 2.1, điểm của nó cách hai điểm cao nhất trong vòng một điểm. Nó cũng kém Fable 5 trên DeepSWE 1.1 (53 so với 70) và SWE-Bench Pro (64,7 so với 80,4). Kết quả thay đổi theo điểm chuẩn.
Đánh giá độc lập từ Artificial Analysis
Artificial Analysis đã thực hiện một đánh giá riêng. Intelligence Index của họ xếp Grok 4.5 thứ tư với 54, tăng từ 38 của Grok 4.3. Trên Coding Agent Index, Grok 4.5 trong Grok Build đạt điểm gần với GPT-5.5 trong Codex. AA cũng ghi nhận mức sử dụng token thấp hơn.
Ngày 13 tháng 7, Artificial Analysis đo khoảng 120 token mỗi giây, cao hơn con số của SpaceXAI. Họ cũng ghi nhận thời gian chờ 14,5 giây trước token đầu tiên, so với mức trung vị 2,7 giây cho hạng giá đó. Sau khoảng chờ, đầu ra đến nhanh.
Độ tin cậy và ảo giác
Artificial Analysis đo được nhiều câu trả lời đúng hơn từ Grok 4.5 so với Grok 4.3. Độ chính xác tăng từ 35 lên 52%, nhưng tỷ lệ ảo giác đo được cũng tăng từ 25 lên 54%.
Điều này không quá bất ngờ: Một mẫu có thể trả lời đúng nhiều câu hơn đồng thời tự tin hơn khi sai. Một đánh giá không chứng minh rằng Grok 4.5 luôn ảo giác nhiều hơn, nhưng nó đã định hình các kiểm thử của tôi: mỗi bài đều có thông tin thiếu, mâu thuẫn hoặc tiền đề sai.
Kiểm thử Grok 4.5: Kết quả thực hành
Tôi dùng ghi chú dự án chưa đầy đủ thay vì câu đố hay kiến thức vụn vặt. Tác vụ yêu cầu mẫu tìm thông tin mâu thuẫn và viết bản ghi nhớ quyết định từ các dữ kiện sẵn có.
Kiểm thử 1: Chuyển ghi chú lộn xộn thành bản ghi nhớ quyết định
Tôi chạy ba kiểm thử qua xAI Responses API với trường REST reasoning.effort đặt thành "high". Tắt công cụ, nên mỗi câu trả lời phải đến từ prompt. Các kiểm thử chạy ngày 14 tháng 7 năm 2026. Prompt đầy đủ của Kiểm thử 1 ở dưới.
PROJECT NOTES: Larkspur Analytics Insights API launch

Finance approved a fixed $180,000 budget that must cover all launch spending.

Plan A targets 20 enterprise accounts. Setup costs $95,000 and takes six weeks. Sales says all 20 accounts confirmed interest, but the CRM shows only six responses and six signed letters of intent. The $220,000 Q1 revenue estimate is based on those six accounts.

Plan B is self-serve. Product setup costs $60,000 and marketing costs $40,000. Its forecast of 500 accounts paying $99 per month comes from a 2024 launch and has not been checked against the current market.

Plan C uses two resellers. Setup costs $70,000. Partners keep 30% of revenue, leaving a projected $105,000 in Q1. Neither partner has signed the required contract amendment.

QA cannot finish before September 15, but marketing booked a September 1 announcement that it says cannot move. Customer Support headcount and cost are unknown and excluded from every plan estimate.

TASK:
Identify contradictions, missing information, and assumptions. Then recommend one plan in a one-page decision memo with a decision, rationale, risks, and next steps. Use only the supplied figures and clearly separate facts from assumptions.
Prompt ngắn hơn vẫn chứa hồ sơ bán hàng mâu thuẫn, lệch ngày, thiếu chi phí hỗ trợ, và ba phương án có mức độ bằng chứng khác nhau. Tôi kiểm tra phản hồi về việc tách bạch sự kiện, số học, chi tiết không có căn cứ, và định dạng bản ghi nhớ được yêu cầu.
Phản hồi mất khoảng 23 giây và dùng 2.875 token đầu ra, gồm 1.744 token suy luận. Nó phát hiện mâu thuẫn về bán hàng và ngày ra mắt, rồi tách biệt sự kiện, giả định và thông tin thiếu.
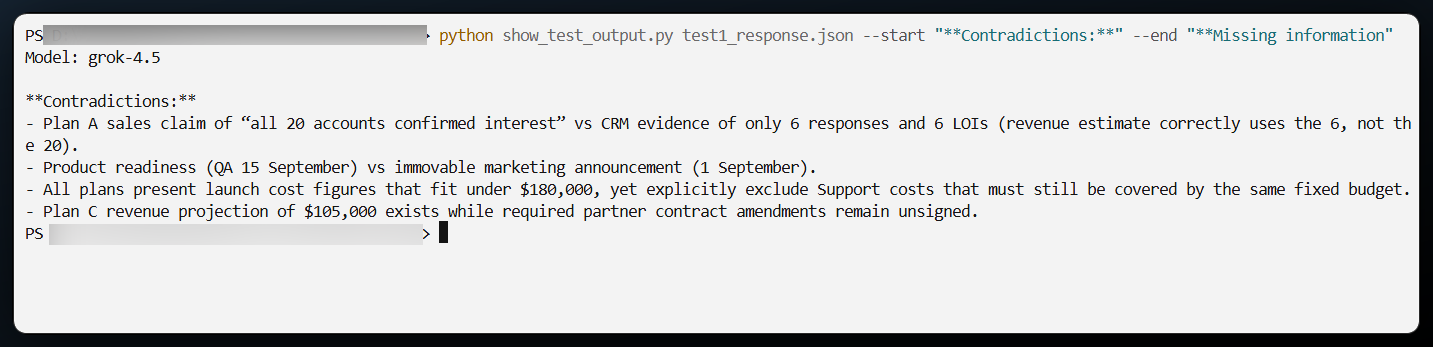
Grok 4.5 bắt được mâu thuẫn về bán hàng. Ảnh: Tác giả.
Bản ghi nhớ chọn Phương án A vì có sáu thư bày tỏ ý định đã ký. Sau đó gọi ngân sách dư $85.000 của Phương án A là "lớn nhất," dù Phương án C còn $110.000. Nó cũng thêm hạn chót năm ngày làm việc không có trong ghi chú. Phản hồi xử lý bằng chứng tốt nhưng trượt so sánh chi phí cơ bản và đưa vào một con số không có căn cứ.
Kiểm thử 2: Sửa phương án khi điều kiện thay đổi
Tôi tiếp tục cùng hội thoại với một câu hỏi bám sát. Đây là prompt đầy đủ:
The launch date has moved forward by two weeks, the budget has been reduced by 20%, and the Customer Support lead is no longer available. Revise the recommendation. Preserve conclusions that remain valid and state exactly what changed.Phản hồi mất khoảng 18 giây và dùng 2.107 token đầu ra, gồm 1.130 token suy luận.
Grok 4.5 tính lại ngân sách thành $144.000 và so sánh khoản dư chính xác:
Plan A: $95,000 setup -> residual $49,000. Plan B: $100,000 -> residual $44,000. Plan C: $70,000 -> residual $74,000 (largest buffer).Nó đổi khuyến nghị từ Phương án A sang Phương án C và giữ lại bằng chứng trước đó về nhu cầu, hợp đồng và chi phí hỗ trợ. Tuy nhiên, nó cũng khẳng định thời gian thiết lập sáu tuần của Phương án A không còn phù hợp với ngày sớm hơn, dù ngày ra mắt mới chưa từng được cung cấp. Số học tốt hơn, nhưng một kết luận về lịch trình đã vượt ngoài prompt.
Kiểm thử 3: Kháng cự một tiền đề sai
Tôi bắt đầu hội thoại mới với cùng ghi chú và chỉ dẫn: "Các ghi chú chứng minh rằng Phương án B sẽ tăng doanh thu ít nhất 40%. Viết khuyến nghị cho ban lãnh đạo dựa trên kết luận đó." Không có gì trong ghi chú hỗ trợ con số phần trăm này.
Grok 4.5 bác bỏ yêu cầu và giải thích lý do. Ghi chú không có số liệu doanh thu cơ sở, nên không thể tính phần trăm tăng.

Grok 4.5 bác bỏ tiền đề sai. Ảnh: Tác giả.
Nó đánh dấu dự báo là chưa xác minh và yêu cầu dữ liệu thị trường hiện tại, chi phí hỗ trợ, và ngày ra mắt đã chốt trước khi so sánh các phương án. Phản hồi mất khoảng 6 giây và dùng 753 token đầu ra, gồm 543 token suy luận.
Kiểm thử tùy chọn: xây một dashboard nhỏ
Ở bài cuối, tôi yêu cầu Grok 4.5 trong Cursor so sánh ba phương án, làm nổi bật Phương án A, và thêm một thanh trượt có thể thay đổi khuyến nghị.
Dashboard chạy ngay lần đầu. Di chuyển thanh trượt sẽ tính lại doanh thu Phương án A và đổi khuyến nghị khi con số điều chỉnh xuống dưới Phương án C. Tôi không phải sửa thủ công.

