

Khóa học
Lập trình với AI dành cho Developer
1 giờ 30 phút
11.3K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleUnsloth Studio đã có một nâng cấp lớn với Unsloth Desktop, cho phép bạn chạy mọi thứ cục bộ dưới dạng ứng dụng desktop. Điều này đặc biệt hữu ích nếu bạn không muốn tốn thời gian cài đặt gói, cấu hình nhiều công cụ, hoặc liên tục chạy lệnh trong terminal.
Về cơ bản, Unsloth Desktop là một giải pháp tất cả trong một cho quy trình AI cục bộ.
Bạn có thể chạy và fine-tune LLM, thử nghiệm các mô hình thị giác, tạo ảnh và video, huấn luyện mô hình ảnh, làm việc với âm thanh, dùng công cụ lập trình bằng AI, quản lý mô hình, và chạy API cục bộ — tất cả trong cùng một ứng dụng.
Trong hướng dẫn này, tôi sẽ chỉ bạn cách cài đặt Unsloth Desktop trên Linux, chạy LLM cục bộ, kết nối với OpenCode, và dùng một mô hình cục bộ để xây dựng dự án Python.
Chúng ta cũng sẽ khám phá một số tính năng khác và xem bạn có thể làm được bao nhiêu thứ cục bộ từ một ứng dụng duy nhất.
Trước khi cài đặt Unsloth Desktop, bạn nên kiểm tra nhanh xem GPU NVIDIA của bạn đã được nhận diện và CUDA hoạt động bình thường hay chưa.
Điều này sẽ giúp tránh lỗi về sau khi bạn bắt đầu chạy hoặc fine-tune mô hình cục bộ.
Đầu tiên, mở terminal và chạy:
nvidia-smi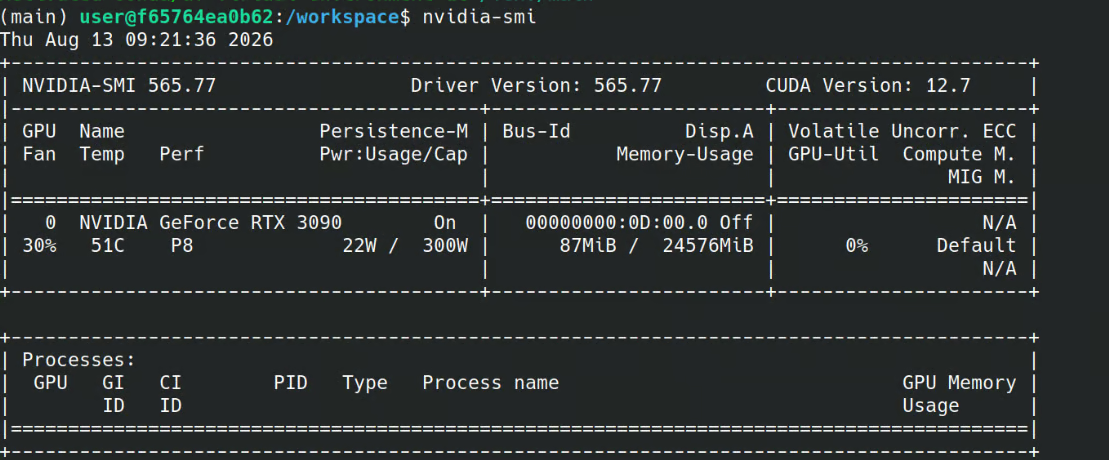
Lệnh này sẽ hiển thị GPU NVIDIA, phiên bản driver, bộ nhớ GPU còn trống, và thông tin tương thích CUDA của bạn.
Tiếp theo, kiểm tra trình biên dịch CUDA cài trên hệ thống:
nvcc --versionBạn sẽ thấy đầu ra tương tự như sau:
nvcc: NVIDIA (R) Cuda compiler driver
Copyright (c) 2005-2025 NVIDIA Corporation
Built on Tue_May_27_02:21:03_PDT_2025
Cuda compilation tools, release 12.9, V12.9.86
Build cuda_12.9.r12.9/compiler.36037853_0
Nếu cả hai lệnh đều chạy được và GPU được nhận đúng, hệ thống của bạn đã sẵn sàng cho Unsloth Desktop.
Tiếp theo, truy cập trang web Unsloth và tải Unsloth Desktop.
Hãy chọn đúng gói phù hợp với hệ điều hành của bạn.
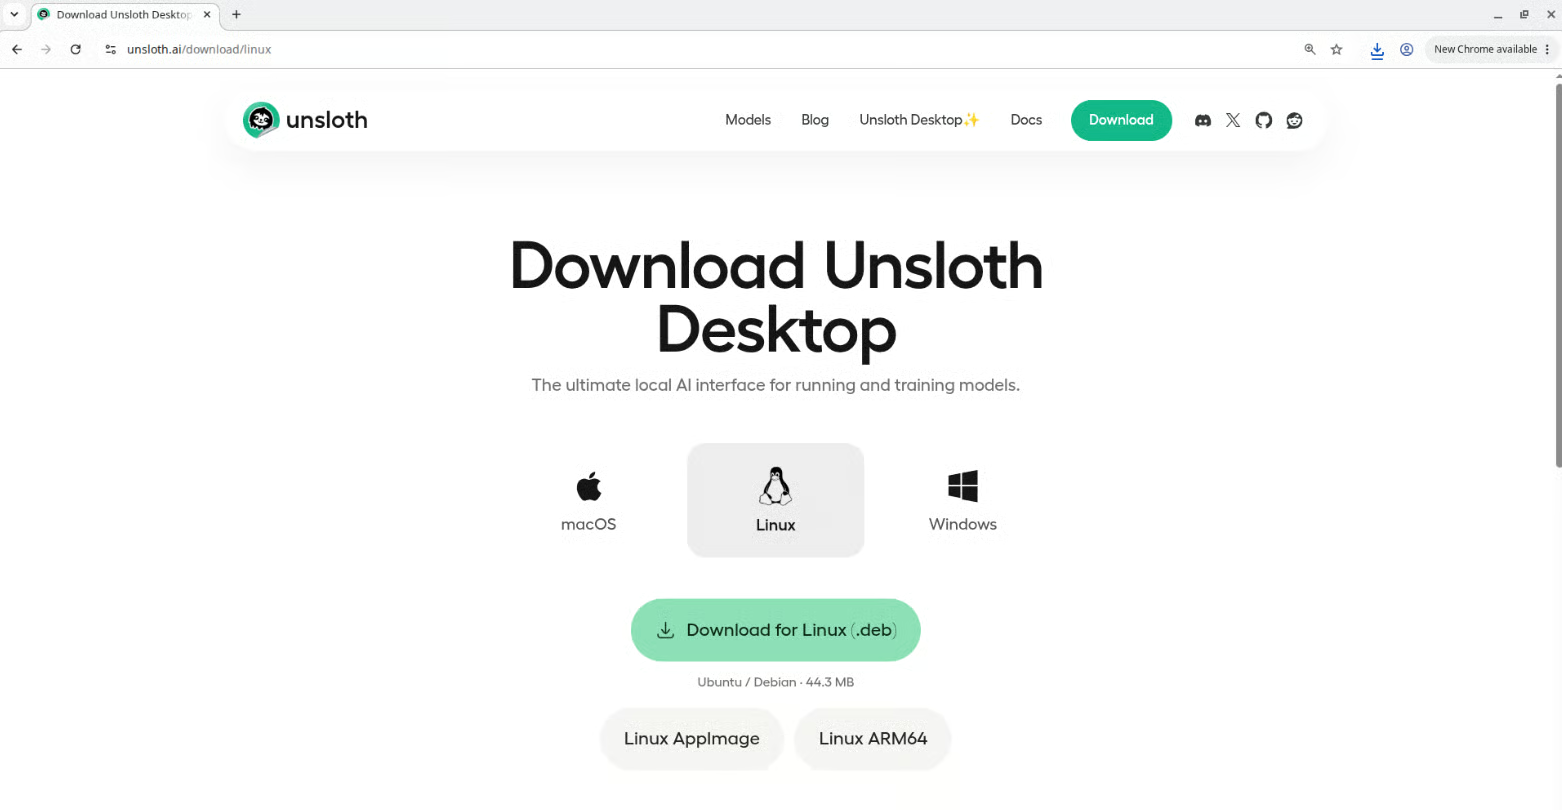
Nguồn: Tải Unsloth Desktop cho Linux
Sau khi tải xong, hãy cài đặt gói như với bất kỳ ứng dụng desktop nào khác.
Trên Linux, tùy bản phân phối, đây có thể là gói .deb.
Khi cài đặt xong, hãy khởi chạy Unsloth Desktop.
Ứng dụng sẽ tự động nhận diện phần cứng sẵn có và đưa bạn vào giao diện chính.
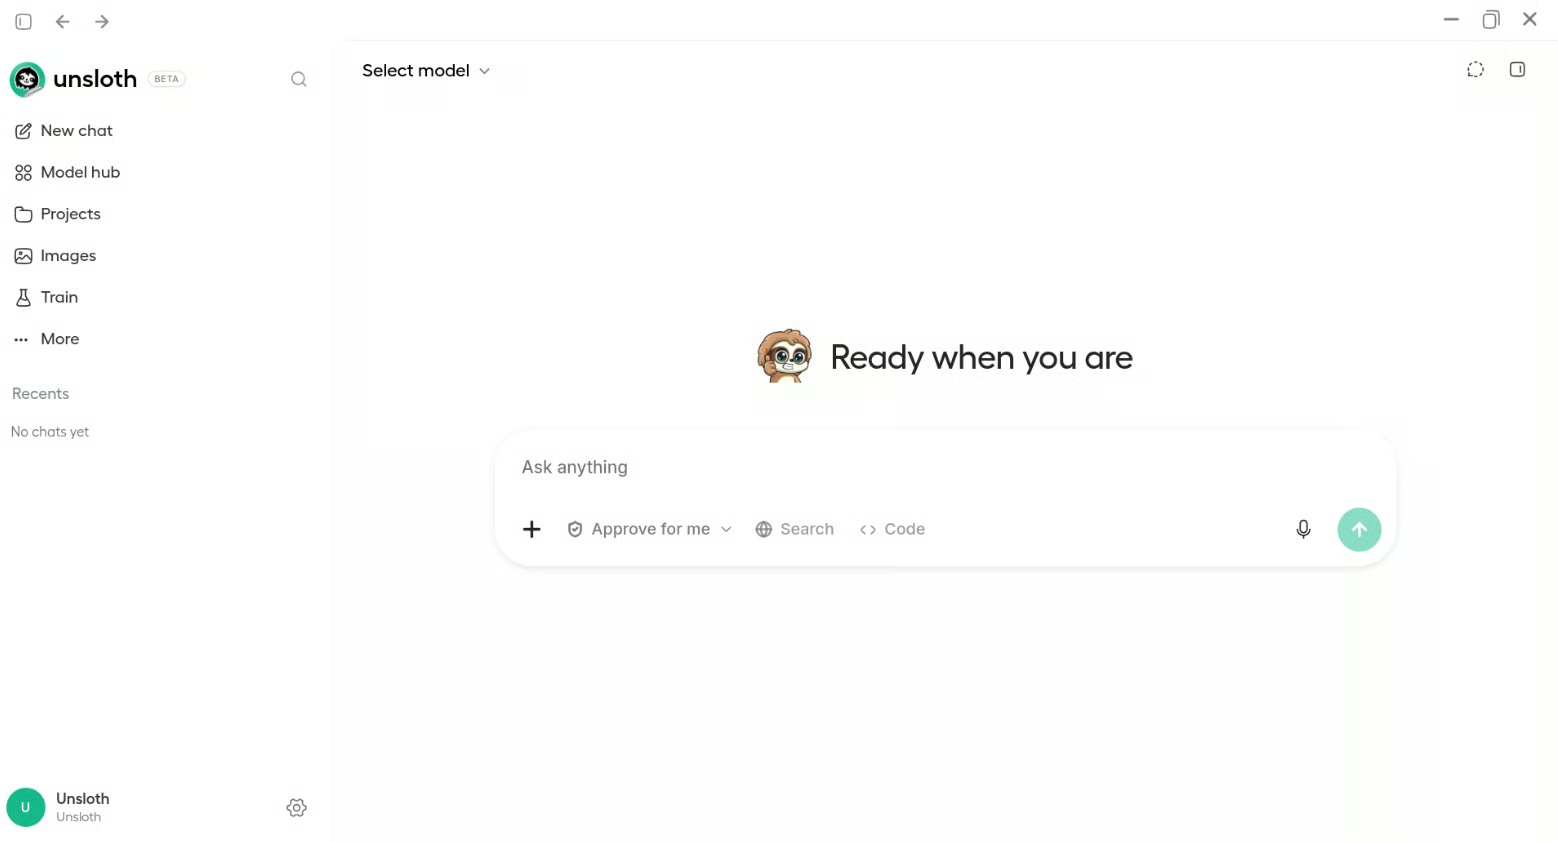
Tại đây, bạn có thể duyệt và tải mô hình, chạy LLM cục bộ, fine-tune mô hình, làm việc với ảnh và các modality khác, quản lý mô hình cục bộ, và truy cập các công cụ khác trong Unsloth Desktop.
Mở Model hub trong Unsloth Desktop và tìm mô hình bạn muốn chạy.
Trong thử nghiệm này, tôi dùng một trong những mô hình nhỏ yêu thích:
empero-ai/Qwythos-9B-Claude-Mythos-5-1M-GGUF · Hugging Face
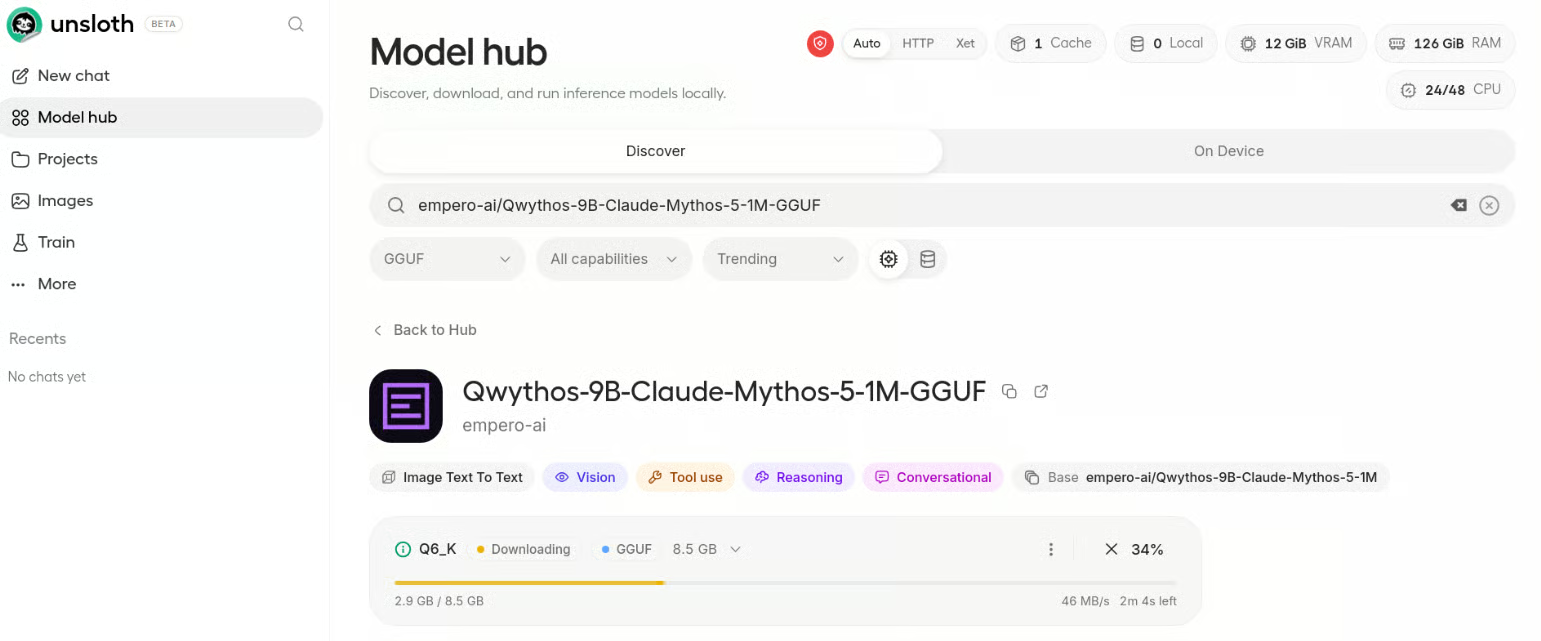
Sau khi tải mô hình, bạn có thể nạp và bắt đầu trò chuyện trực tiếp với nó trong Unsloth Desktop.
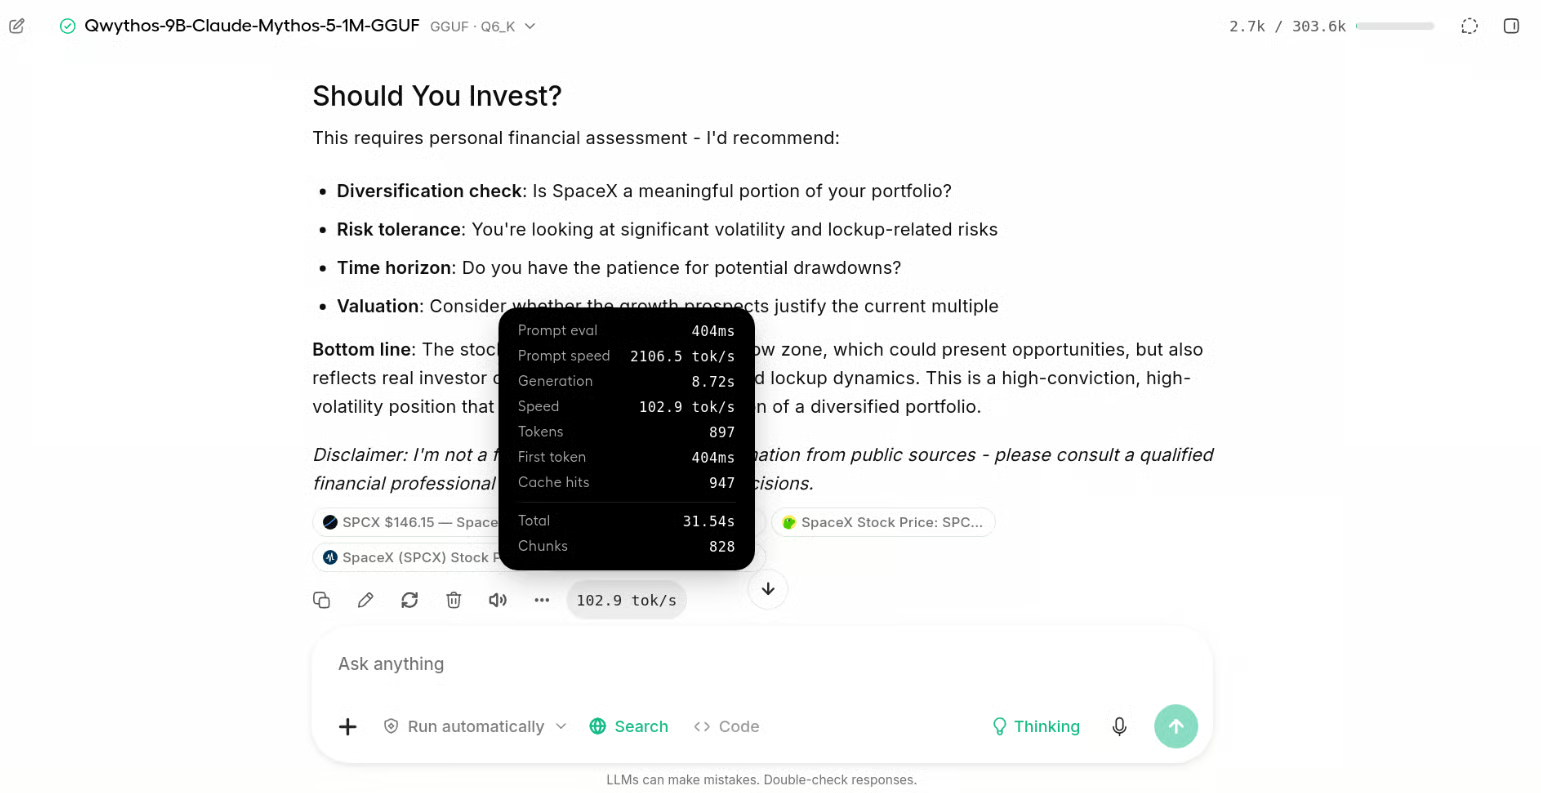
Trên hệ thống của tôi, tốc độ trung bình khoảng 102 token mỗi giây, tăng lên khoảng 125 token mỗi giây với một số truy vấn liên quan đến lập trình.
Tôi cũng bật truy cập web và hỏi mô hình về các tin tức mới nhất trên thị trường chứng khoán.
Điều này giúp trải nghiệm chat cục bộ hữu ích hơn nhiều khi bạn cần thông tin vượt ngoài kiến thức sẵn có bên trong mô hình.
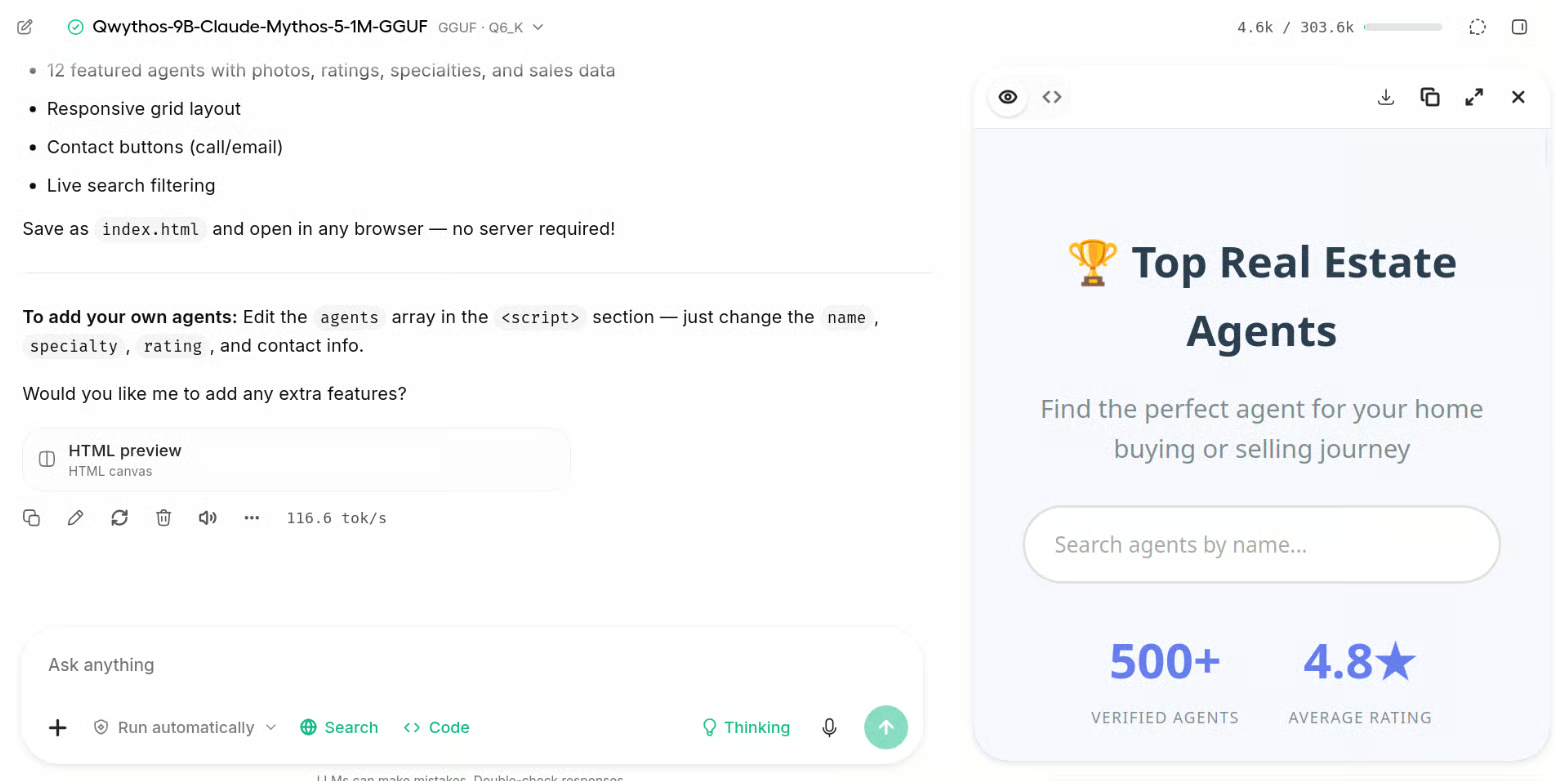
Tiếp theo, tôi muốn xem liệu nó có thể xây dựng thứ gì đó thay vì chỉ trả lời câu hỏi hay không.
Tôi yêu cầu nó tạo một trang web, và nó đã sinh mã rồi hiển thị trang web cạnh cửa sổ chat, giúp tôi dễ dàng xem kết quả trong khi tiếp tục thay đổi.
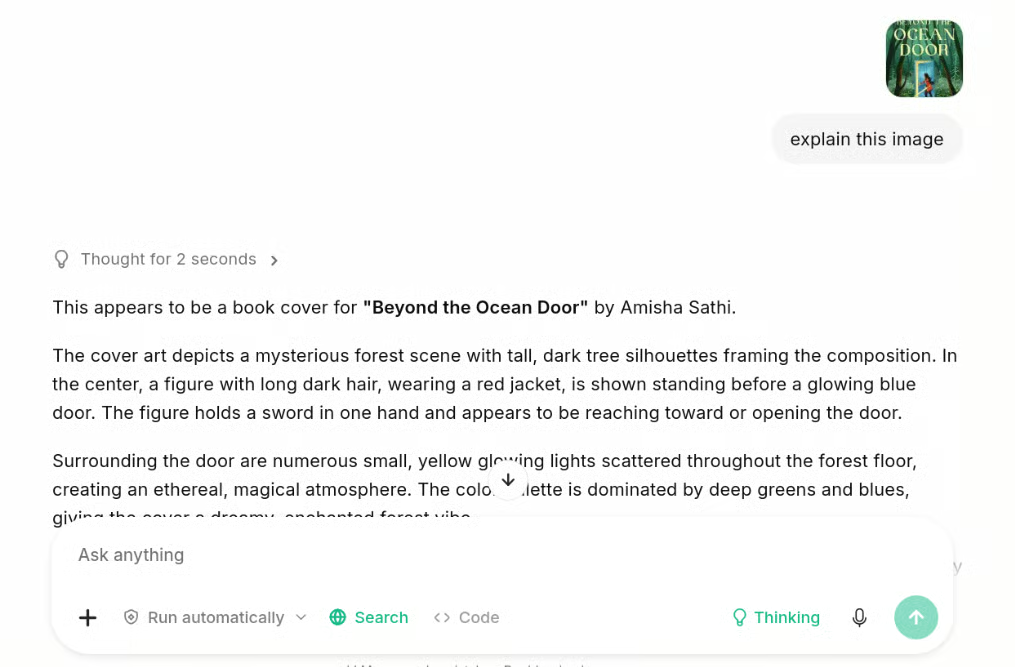
Unsloth Desktop cũng hỗ trợ mô hình ngôn ngữ–thị giác, vì vậy bạn có thể tải lên một ảnh trực tiếp vào cuộc chat và đặt câu hỏi về ảnh đó.
Trong bài thử của tôi, bộ mã hóa thị giác cần thiết đã được cài tự động khi tôi tải mô hình.
Tôi chỉ việc tải một ảnh lên, đặt câu hỏi về nó, và trong vài giây mô hình trả về câu trả lời rất chính xác.
Hỗ trợ thị giác đặc biệt hữu ích khi làm việc với tác nhân lập trình.
Ví dụ, bạn có thể tải ảnh chụp màn hình một website và chỉ ra vấn đề cần sửa, cho tác nhân xem mẫu thiết kế bạn muốn tái tạo, hoặc dùng một giao diện sẵn có làm tham chiếu thị giác khi xây dựng ứng dụng của riêng bạn.
Các mô hình nhỏ rất phù hợp để thử nghiệm và thậm chí một số tác vụ lập trình dạng tác nhân nhẹ.
Nhưng nếu bạn muốn một tác nhân lập trình cục bộ nghiêm túc có thể xử lý dự án lớn, bạn sẽ cần mô hình mạnh hơn nhưng vẫn vừa với VRAM của GPU.
Trường hợp của tôi dùng RTX 3090 với 24 GB VRAM, nên tôi tải phiên bản Q4 của Muse Glimmer 30B.
Mở thẻ Models trong Unsloth Desktop, tìm mô hình và tải phiên bản UD-Q4_K_XL.
Sau vài phút, mô hình sẽ được tải xuống và nạp trên hệ thống của bạn.
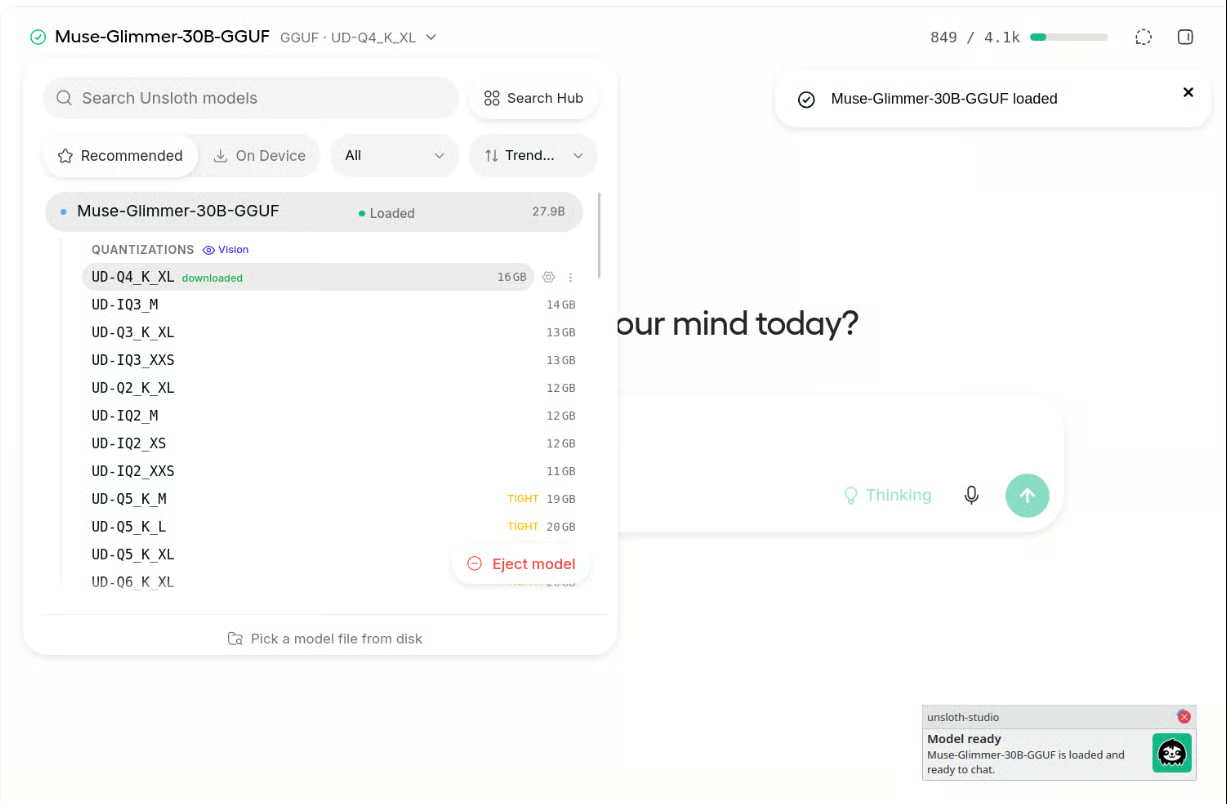
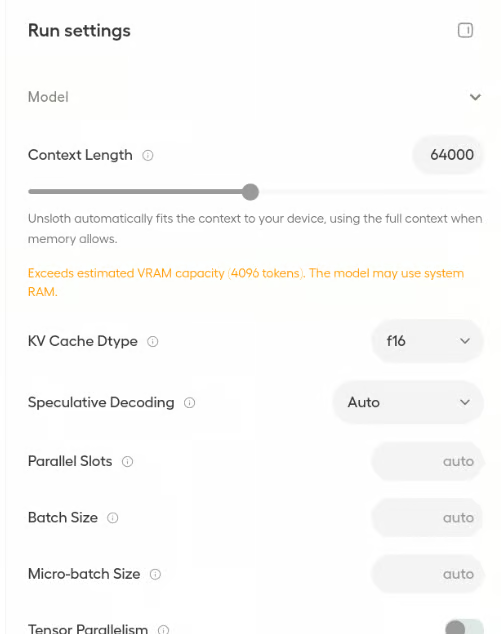
Mặc định, cửa sổ ngữ cảnh đặt khoảng 4K, quá nhỏ cho một tác nhân lập trình làm việc trên nhiều tệp.
Mở bảng bên phải trong Unsloth Desktop, đổi độ dài ngữ cảnh thành 64K, cuộn xuống và tải lại mô hình.
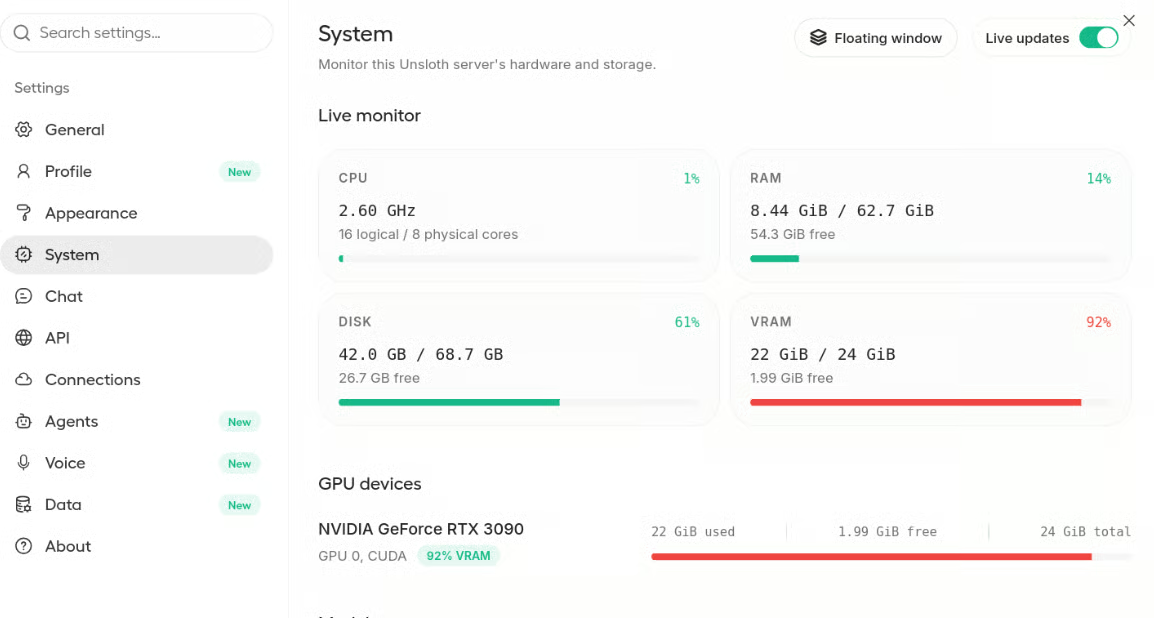
Sau khi mô hình được tải lại, vào Settings → System để kiểm tra mức sử dụng bộ nhớ GPU.
Trường hợp của tôi, mô hình dùng khoảng 22 GB VRAM, để lại khoảng 2 GB cho KV cache. Con số này đủ cho thử nghiệm của tôi, dù bộ nhớ khả dụng sẽ tùy thuộc vào GPU và khối lượng công việc.
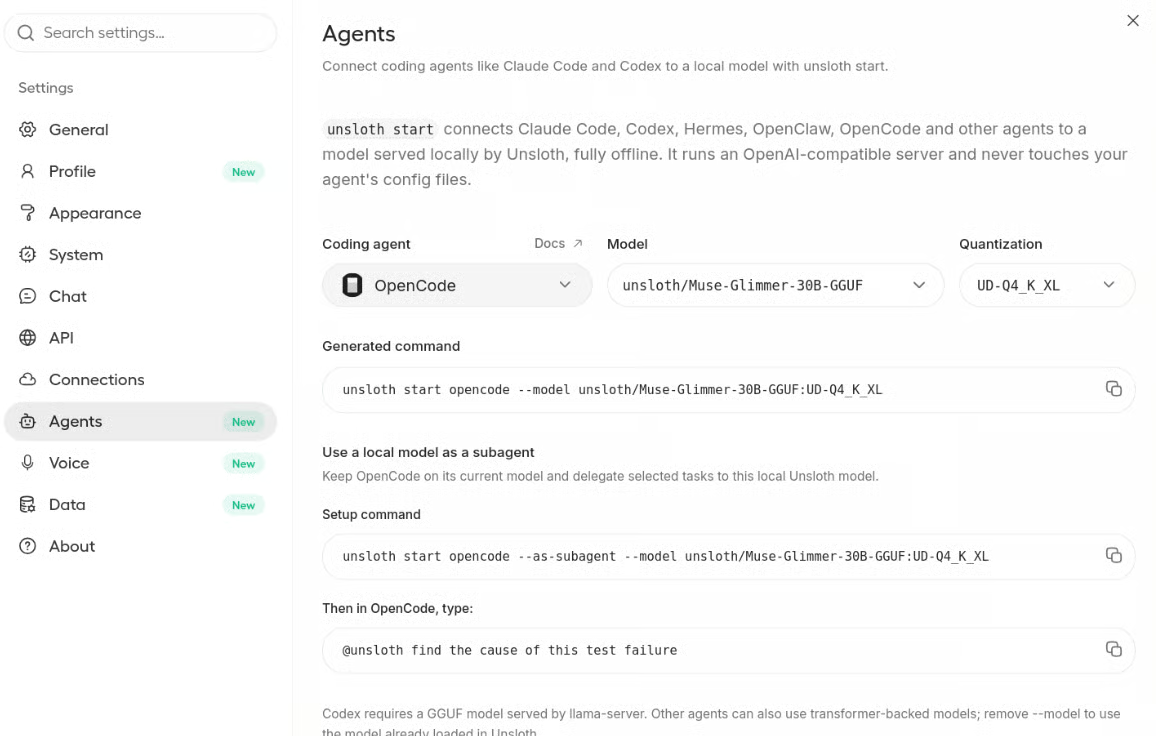
Tiếp theo, mở Settings → Agents và chọn OpenCode làm tác nhân lập trình.
Unsloth Desktop sẽ tự động tạo lệnh bạn cần để khởi chạy.
Trước tiên, tạo thư mục dự án bằng terminal:
mkdir unsloth-project
cd unsloth-project
Sau đó khởi chạy OpenCode:
unsloth start opencode \
  --model unsloth/Muse-Glimmer-30B-GGUF:UD-Q4_K_XL \
  --context-length 64000
Hãy chắc chắn bạn thêm độ dài ngữ cảnh trong lệnh.
Nếu không, OpenCode có thể khởi chạy với cửa sổ ngữ cảnh mặc định nhỏ hơn.
Lệnh sẽ cài đặt OpenCode nếu cần rồi khởi chạy giao diện terminal với mô hình Unsloth cục bộ sẵn sàng sử dụng.
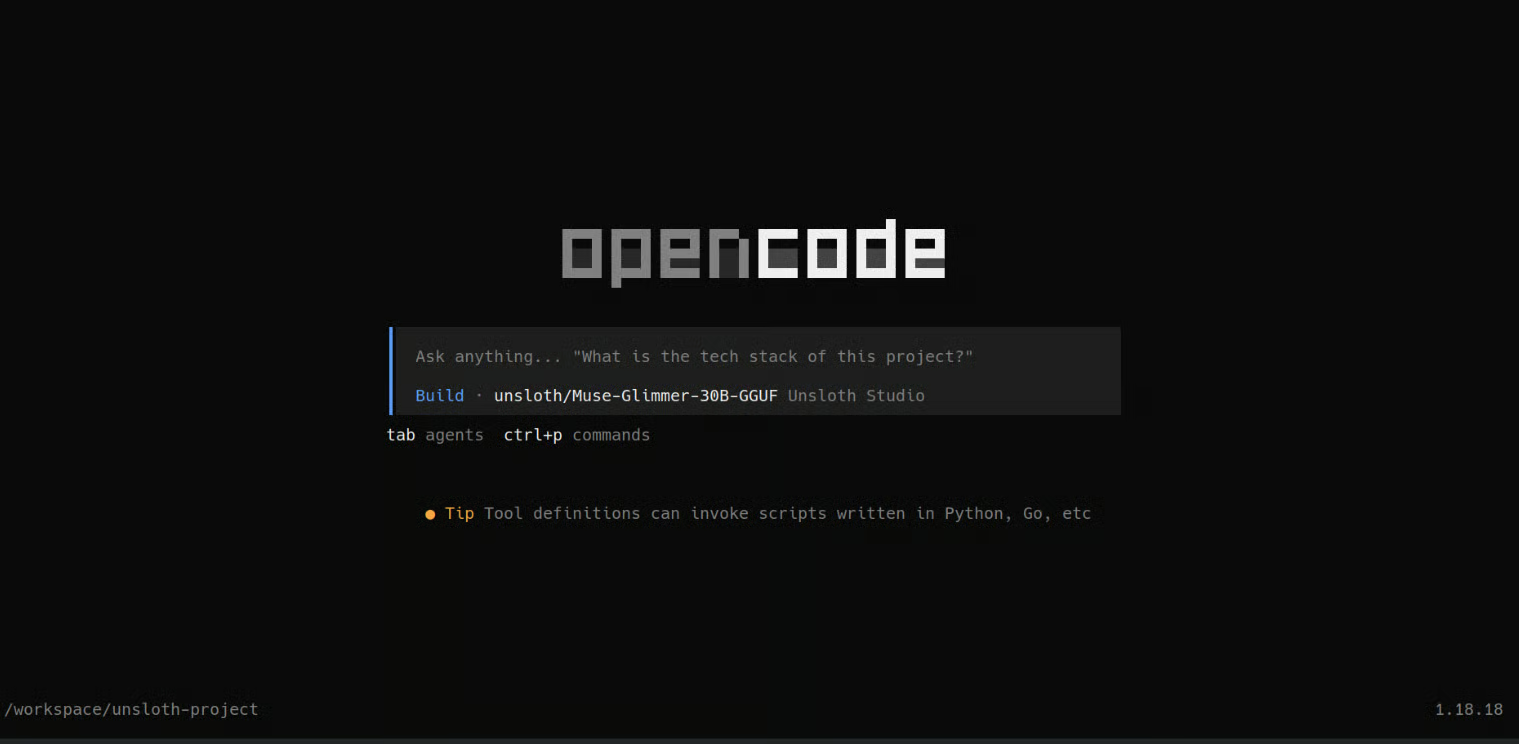
Giờ mọi thứ đã được kết nối, tôi muốn cho tác nhân lập trình cục bộ một bài kiểm tra đúng nghĩa.
Thay vì yêu cầu tạo một đoạn mã nhỏ, tôi bảo nó xây dựng hoàn chỉnh một trò chơi phong cách Mario bằng Python từ đầu.
Tôi dùng lời nhắc sau:
Create a simple Mario-style 2D platform game in Python using Pygame.
Add left/right movement, jumping, platforms, coins, enemies, a score counter, and a finish flag.
Use simple built-in shapes instead of external assets.
Create the files, install dependencies, test the game, and tell me how to run it.
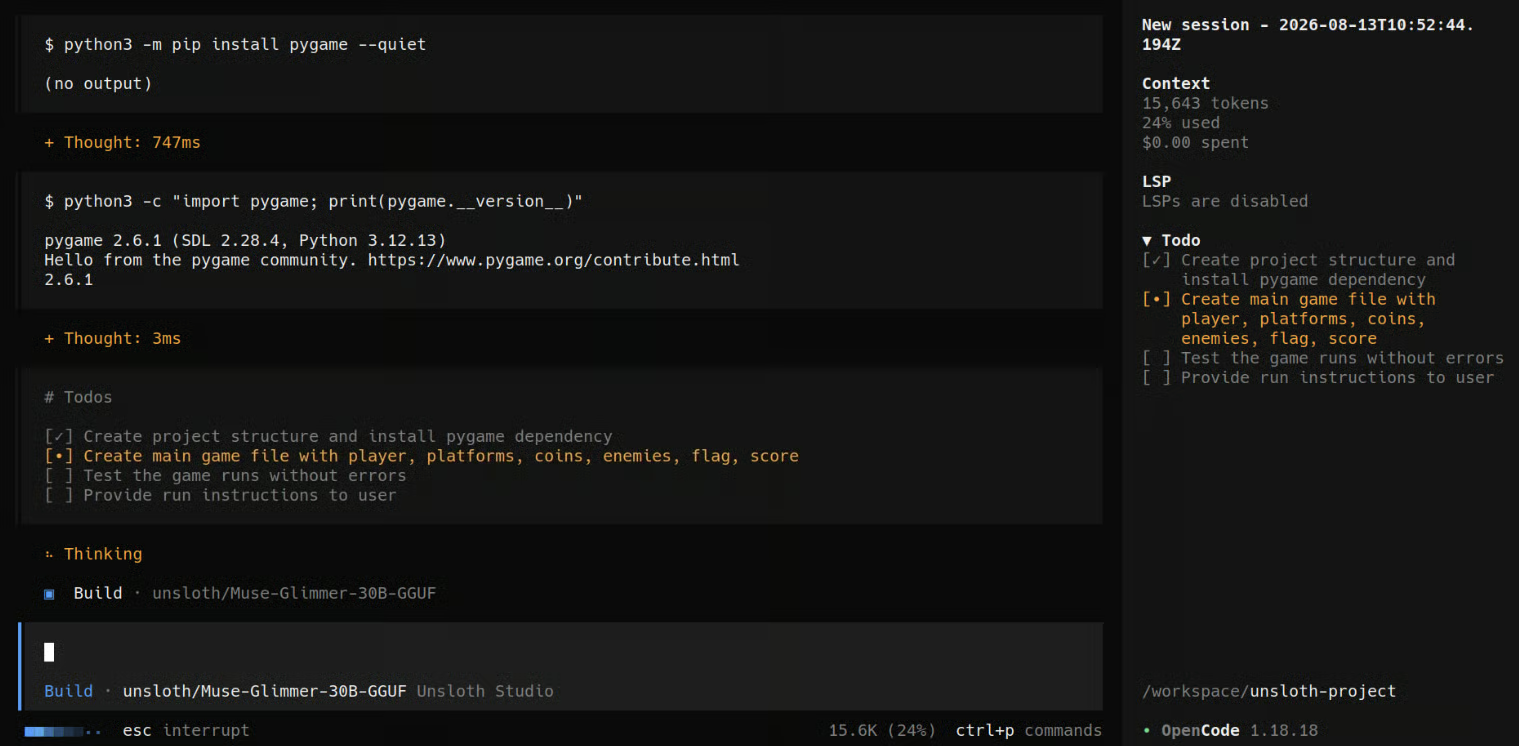
OpenCode trước tiên tạo danh sách việc cần làm rồi bắt đầu thực hiện dự án từng bước. Nó tạo tệp, viết logic game, xử lý phụ thuộc, và cuối cùng đưa tôi lệnh để chạy game.
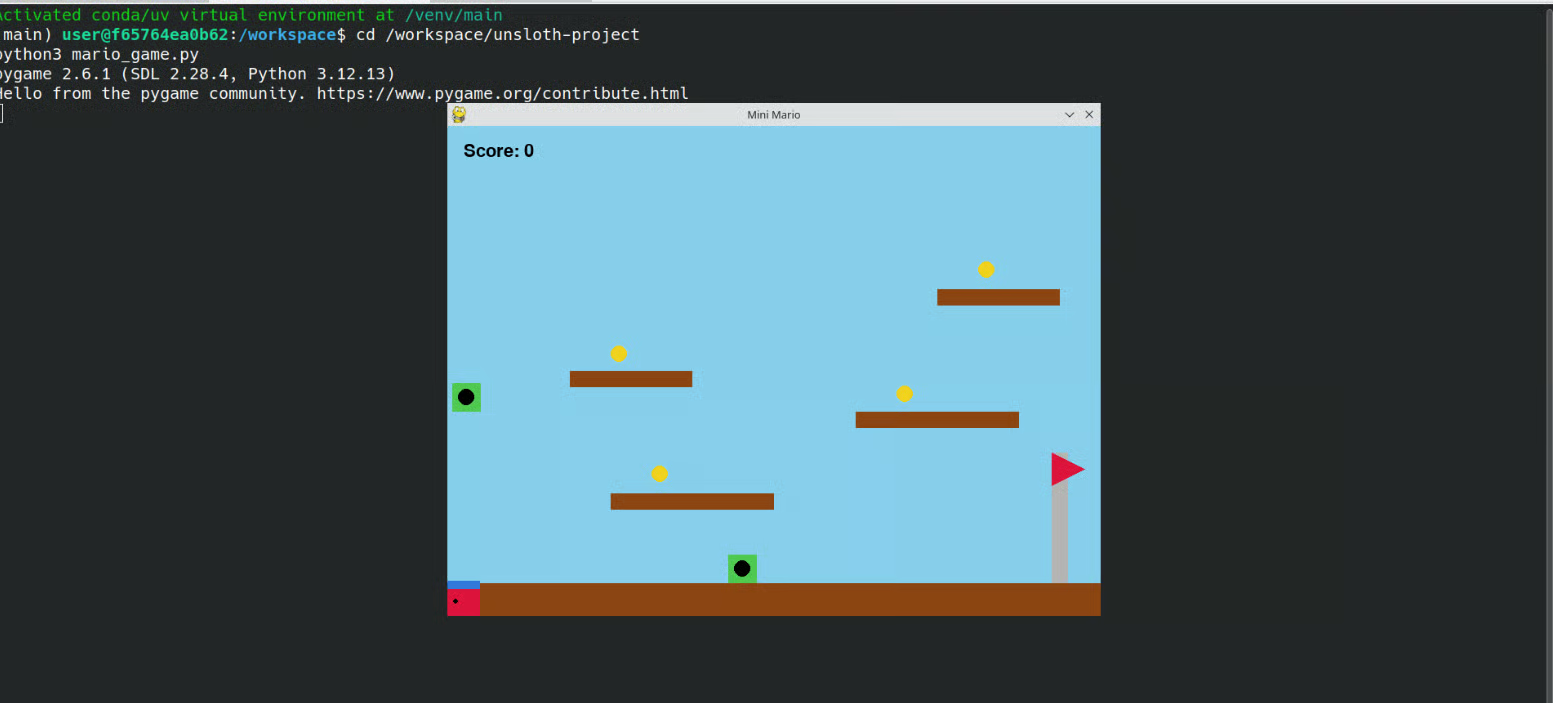
Trò chơi cuối cùng chạy được, dù vẫn còn hơi lỗi.
Phiên bản Q4 của Muse Glimmer không đạt hiệu năng như kỳ vọng cho tác vụ lập trình lớn này, nên nếu bạn có đủ VRAM, tôi khuyên thử phiên bản Q8 để có hiệu năng lập trình tốt hơn.
Cho đến giờ, chúng ta chủ yếu dùng Unsloth Desktop để chạy LLM và tác nhân lập trình, nhưng nó còn làm được nhiều hơn thế.
Ý tưởng là đưa hầu hết các quy trình AI cục bộ vào cùng một ứng dụng thay vì phải thiết lập công cụ riêng cho từng tác vụ.
Bạn có thể fine-tune LLM cục bộ bằng các phương pháp như LoRA và QLoRA.
Giao diện huấn luyện không cần code cũng giúp bạn dễ dàng chọn tập dữ liệu, cấu hình thiết lập huấn luyện, bắt đầu chạy và xuất mô hình cuối cùng mà không phải tự xây toàn bộ pipeline huấn luyện.
Bạn có thể tải các mô hình diffusion được hỗ trợ và tạo ảnh cục bộ từ prompt văn bản. Bạn cũng có thể tải ảnh sẵn có, mô tả thay đổi mong muốn và dùng các mô hình hỗ trợ để chỉnh sửa ảnh.
Nếu muốn đi xa hơn việc tạo ảnh, bạn cũng có thể huấn luyện LoRA cho ảnh trên tập dữ liệu của riêng mình.
Điều này hữu ích khi bạn muốn dạy mô hình về một chủ thể, nhân vật, sản phẩm, hoặc phong cách hình ảnh cụ thể rồi dùng LoRA đó cho những lần tạo sau.
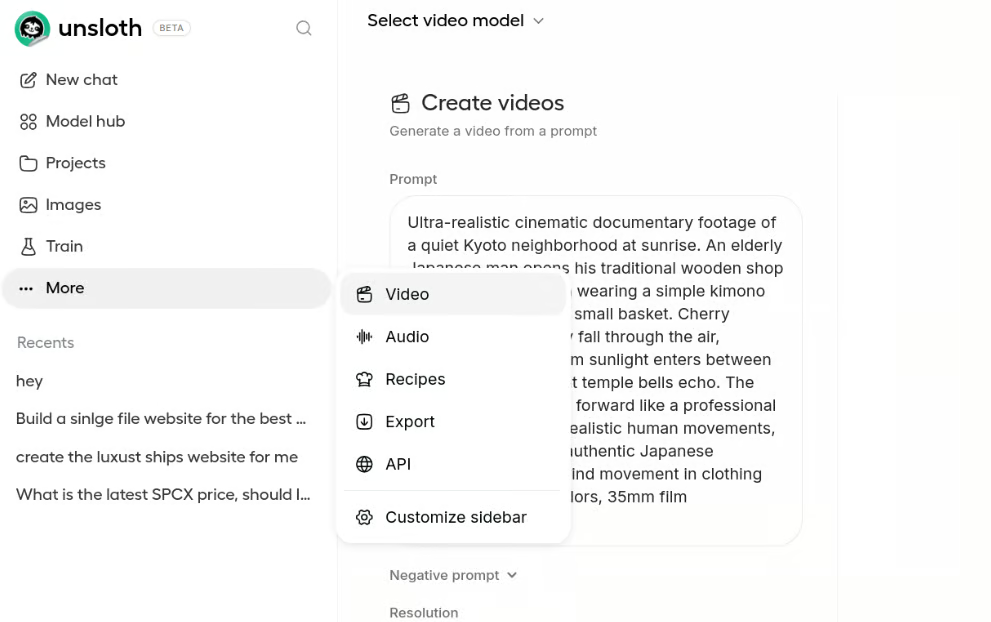
Unsloth Desktop cũng hỗ trợ quy trình tạo video cục bộ bằng các mô hình diffusion được hỗ trợ.
Điều này đồng nghĩa bạn có thể thử nghiệm cả tạo ảnh và video trong cùng một ứng dụng thay vì phải thiết lập môi trường riêng.
Bạn có thể làm việc với chuyển giọng nói thành văn bản, văn bản thành giọng nói, và các mô hình âm thanh được hỗ trợ khác.
Điều này cho phép bạn phiên âm âm thanh, tạo giọng nói và thử nghiệm các quy trình AI âm thanh khác nhau ngay trên máy.
Data recipes giúp chuyển các tệp như PDF và CSV thành dataset để bạn có thể kiểm tra, chỉnh sửa và chuẩn bị cho huấn luyện.
Điều này đặc biệt hữu ích khi bạn có dữ liệu riêng nhưng không muốn tự xây dựng dataset từ đầu một cách thủ công.
Khi bạn tải nhiều mô hình và bắt đầu huấn luyện mô hình của mình, việc quản lý mọi thứ có thể nhanh chóng trở nên lộn xộn.
Unsloth Desktop cung cấp một nơi để quản lý mô hình đã tải, dataset, adapter, các lượt huấn luyện, và tài nguyên cục bộ khác.
Unsloth Studio chính thức hỗ trợ xuất mô hình Safetensors/LoRA sang GGUF và các định dạng khác. llama.cpp được hỗ trợ rõ ràng để chạy các mô hình đã xuất.
Cuối cùng, Unsloth Desktop có thể cung cấp mô hình cục bộ của bạn qua API tương thích OpenAI. Điều này giúp bạn dễ dàng kết nối mô hình chạy cục bộ với các ứng dụng khác, công cụ lập trình, hoặc dự án AI mà không phụ thuộc vào API mô hình được host.
Unsloth Desktop đang đi theo một hướng rất đáng chú ý.
Việc có LLM, fine-tuning, tạo ảnh và video, tác nhân lập trình, dataset và API cục bộ trong một ứng dụng desktop giúp AI cục bộ dễ làm việc hơn nhiều, đặc biệt với những người không muốn cấu hình thủ công từng công cụ.
Tuy vậy, nó vẫn còn hơi thô ở một số chỗ.
Trên các GPU cũ hoặc hệ thống có driver CUDA lỗi thời, bạn có thể vẫn phải khắc phục phụ thuộc và cài đặt thủ công một số thứ trên Linux hoặc Windows.
Tôi cũng gặp vấn đề với tạo ảnh, thiết lập ngữ cảnh và tác nhân lập trình.
Ví dụ, nếu bạn tăng ngữ cảnh mô hình trong Unsloth Desktop, bạn cũng có thể cần đặt rõ cùng độ dài ngữ cảnh khi khởi chạy tác nhân lập trình. Một số quy trình tạo website và kiểu Canvas cũng không phải lúc nào hoạt động như mong đợi.
Unsloth đã bổ sung rất nhiều tính năng trong thời gian ngắn, nhưng chưa phải tất cả đều hoàn toàn ổn định. Tôi kỳ vọng nhiều vấn đề sẽ được cải thiện khi Desktop được tối ưu và trưởng thành hơn.
Hiện tại, nếu mục tiêu chính của tôi chỉ là phục vụ một LLM cục bộ cho tác nhân lập trình AI hoặc ứng dụng khác, tôi vẫn ưu tiên llama.cpp.
Nó cho tôi nhiều quyền kiểm soát hơn với mô hình, ngữ cảnh, offload GPU, sử dụng bộ nhớ và các thiết lập cấp thấp khác.
Unsloth Desktop dễ dùng hơn nhiều, trong khi llama.cpp vẫn là lựa chọn tốt hơn khi tôi muốn tinh chỉnh cấu hình và khai thác tối đa hiệu năng phần cứng.
Các khóa học hàng đầu trên DataCamp
Khóa học
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
