
Khóa học
Xử lý ảnh bằng Python
4 giờ
57.1K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleCốt lõi của vision language models là sự tích hợp giữa thị giác máy tính và xử lý ngôn ngữ tự nhiên.
Thị giác máy tính tập trung vào việc giúp máy móc diễn giải và phân tích dữ liệu trực quan, như hình ảnh và video, bằng cách nhận diện đối tượng, mẫu hình và các yếu tố thị giác khác.
Mặt khác, xử lý ngôn ngữ tự nhiên liên quan đến việc hiểu và tạo ra ngôn ngữ của con người, cho phép máy móc lĩnh hội, phân tích và sản xuất văn bản.
VLMs thu hẹp khoảng cách giữa hai lĩnh vực này bằng cách tạo ra các mô hình có thể đồng thời xử lý và hiểu đầu vào dạng hình ảnh và văn bản. Điều này đạt được nhờ các kiến trúc học sâu tiên tiến, đặc biệt là các mô hình transformer, vốn đóng vai trò then chốt trong thành công của các mô hình ngôn ngữ lớn như GPT-4o, Llama, Gemini và Gemma.
Những kiến trúc dựa trên transformer này đã được điều chỉnh để xử lý đầu vào đa phương thức, giúp VLMs nắm bắt được các mối quan hệ phức tạp giữa dữ liệu hình ảnh và ngôn ngữ.
Mô hình transformer, ban đầu được giới thiệu cho các tác vụ NLP, đã trở thành xương sống của nhiều hệ thống AI tiên tiến nhờ khả năng xử lý phụ thuộc dài hạn và nắm bắt quan hệ ngữ cảnh trong dữ liệu.
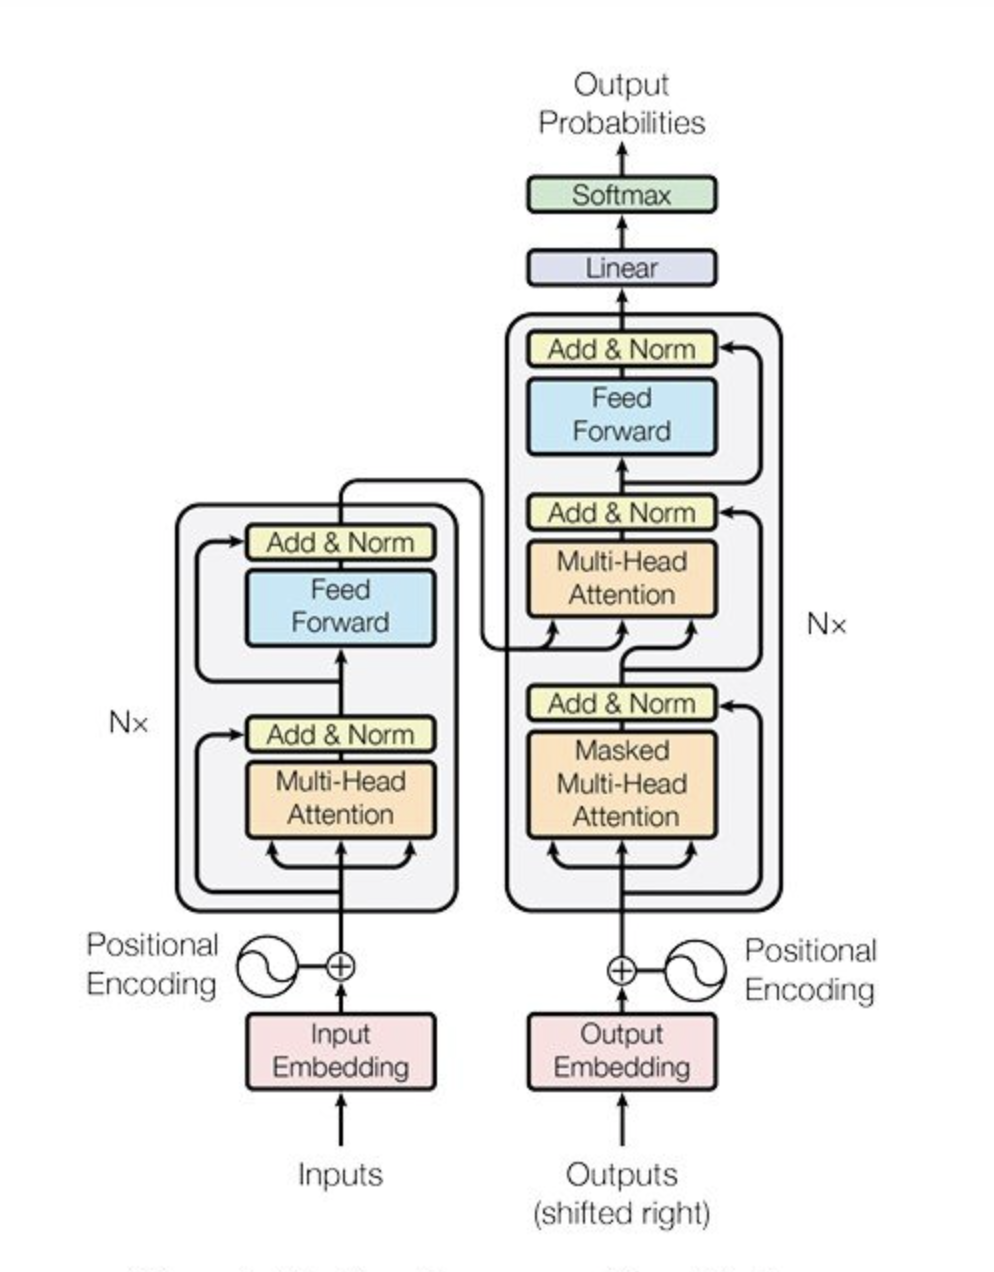
Nguồn: Vaswani et al., 2017
Trong bối cảnh VLMs, transformer đã được điều chỉnh để xử lý cả hình ảnh và văn bản, cho phép tích hợp liền mạch hai dạng dữ liệu này.
Một kiến trúc VLM điển hình gồm hai thành phần chính: bộ mã hóa hình ảnh và bộ giải mã văn bản:
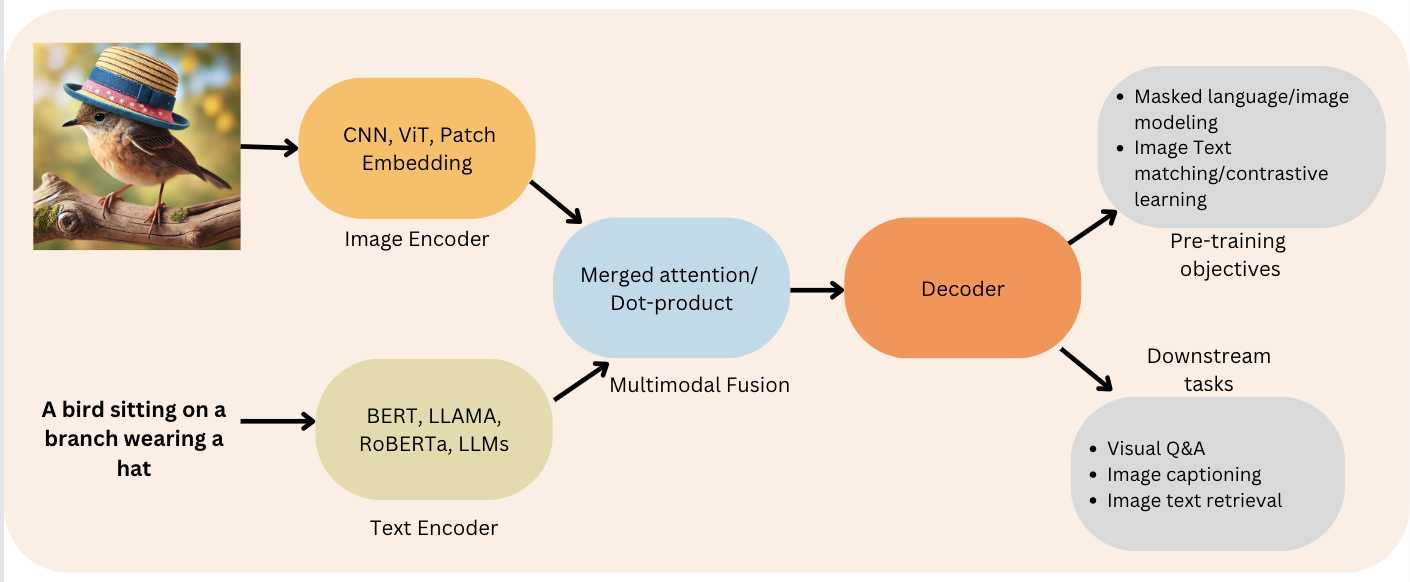
Hình 2: Chức năng Bộ mã hóa - Bộ giải mã (Nguồn: Viso.ai)
Bằng cách kết hợp hai phần này, VLMs có thể làm những việc ấn tượng như mô tả chi tiết hình ảnh, trả lời câu hỏi về những gì chúng thấy, và thậm chí sinh ảnh mới dựa trên mô tả văn bản! Quy trình VLMs thực hiện gồm các bước sau:
Phần lớn VLMs sử dụng Vision Transformer (ViT) làm bộ mã hóa hình ảnh, được tiền huấn luyện trên các bộ dữ liệu hình ảnh quy mô lớn để có thể nắm bắt hiệu quả các đặc trưng thị giác cần thiết cho các tác vụ đa phương thức.
Bộ giải mã văn bản dựa trên mô hình ngôn ngữ, đã được tinh chỉnh để xử lý những tinh tế của việc sinh ngôn ngữ trong bối cảnh dữ liệu hình ảnh. Sự kết hợp giữa năng lực xử lý thị giác và ngôn ngữ tiên tiến này tạo nên một VLM mạnh mẽ và linh hoạt.
Một trong những thách thức lớn nhất khi phát triển VLMs là nhu cầu về các bộ dữ liệu lớn và đa dạng chứa cả thông tin hình ảnh lẫn văn bản. Những bộ dữ liệu này rất cần thiết để huấn luyện mô hình hiểu và sinh nội dung đa phương thức.
Quy trình huấn luyện VLM bao gồm việc cung cấp cho mô hình các cặp ảnh và mô tả văn bản tương ứng, cho phép mô hình học được các mối quan hệ tinh vi giữa yếu tố thị giác và biểu đạt ngôn ngữ.
Để xử lý dữ liệu này, VLMs thường sử dụng các lớp embedding để biến đổi cả đầu vào hình ảnh lẫn văn bản vào một không gian chiều cao, nơi chúng có thể được so sánh và kết hợp.
Quy trình embedding này giúp mô hình hiểu được các mối liên hệ giữa hai phương thức và sinh ra đầu ra mạch lạc, phù hợp ngữ cảnh.
Bức tranh về vision language models (VLMs) rất rộng, với nhiều mô hình mã nguồn mở có sẵn trên Hugging Face Hub. Các mô hình này khác nhau về kích thước, năng lực và giấy phép, cung cấp cho người dùng nhiều lựa chọn phù hợp với các ứng dụng khác nhau. Dưới đây là tổng quan về một số VLM mã nguồn mở nổi bật nhất, nêu bật các đặc điểm chính của chúng:
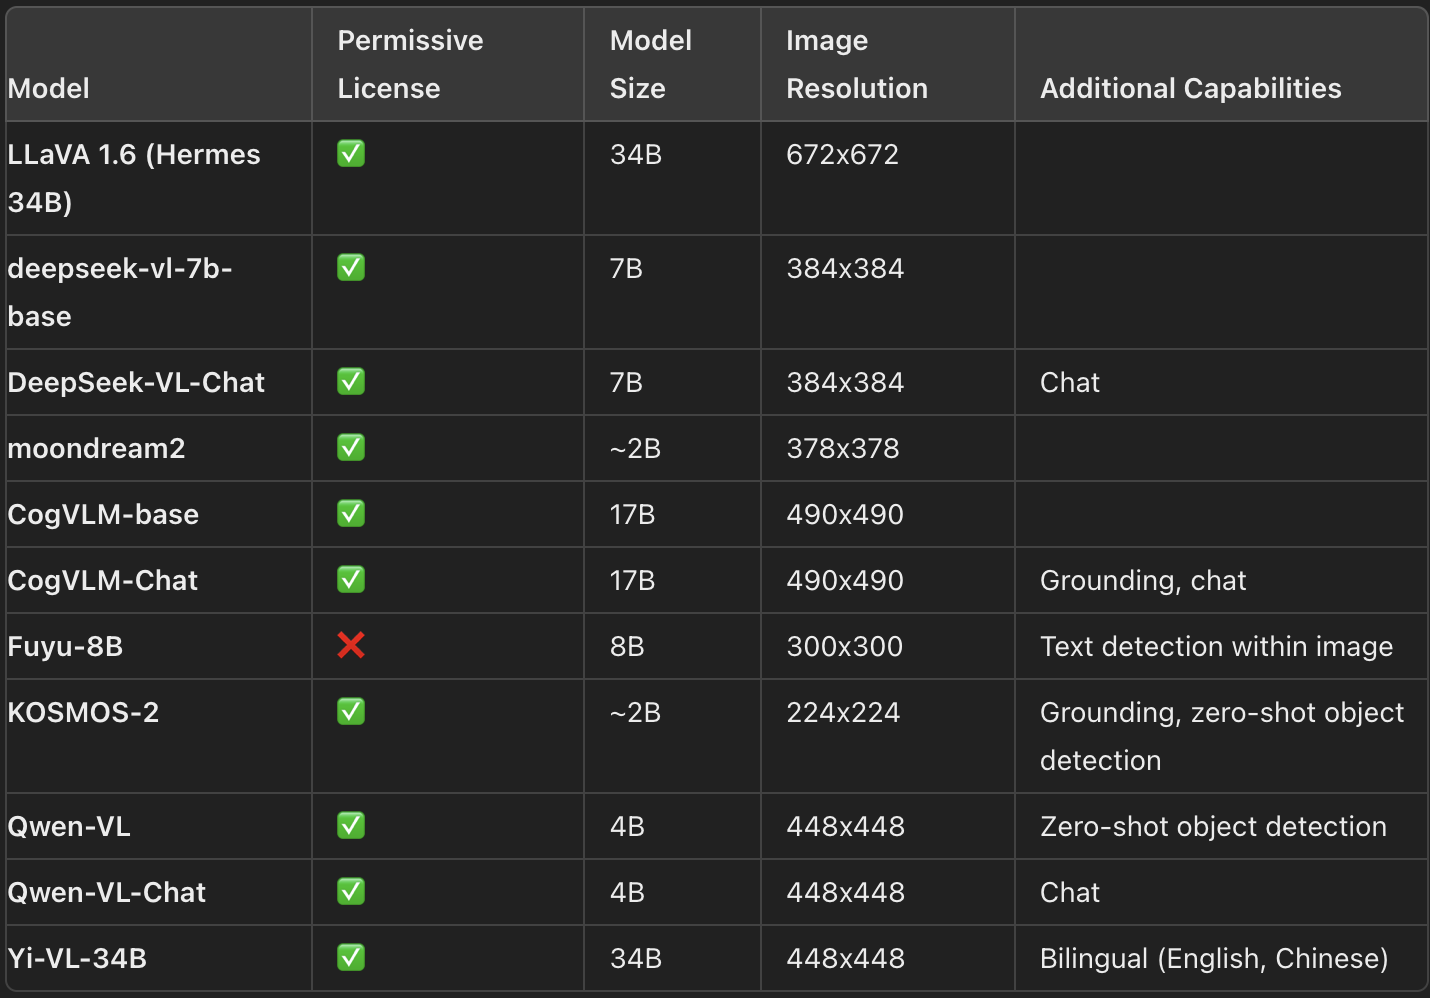
Các VLM mới nhất và đặc điểm chính (Nguồn: HuggingFace)
Việc chọn VLM phù hợp nhất cho trường hợp sử dụng cụ thể của bạn có thể là một thách thức, xét đến phạm vi lựa chọn hiện có. Một số công cụ và tài nguyên có thể hỗ trợ trong quá trình lựa chọn này:
Mặc dù cả Vision Arena và Open VLM Leaderboard đều mang lại thông tin giá trị, chúng bị giới hạn ở các mô hình đã được gửi lên và cần cập nhật thường xuyên để bao hàm các mô hình mới.
Một số benchmark thường được dùng để đánh giá hiệu năng của VLMs:
Tiền huấn luyện VLMs liên quan đến việc hợp nhất biểu diễn hình ảnh và văn bản để đưa vào bộ giải mã văn bản nhằm sinh nội dung. Cấu trúc thường gồm một bộ mã hóa hình ảnh, một bộ chiếu embedding để căn chỉnh biểu diễn hình ảnh và văn bản, và một bộ giải mã văn bản. Tuy nhiên, các mô hình khác nhau áp dụng các chiến lược tiền huấn luyện khác nhau.
Trong nhiều trường hợp, thậm chí không cần tiền huấn luyện VLM nếu bạn có thể tinh chỉnh các mô hình sẵn có cho trường hợp sử dụng cụ thể của mình. Các công cụ như Transformers và SFTTrainer đơn giản hóa quá trình tinh chỉnh mô hình cho các tác vụ cụ thể, giúp tiếp cận dễ dàng ngay cả với những ai có nguồn lực hạn chế.
Dưới đây là một triển khai trên HuggingFace để sử dụng miễn phí mô hình VLM mã nguồn mở LlavaNext trên Colab hoặc máy cục bộ của bạn với thư viện Transformers của HuggingFace.
from transformers import LlavaNextProcessor, LlavaNextForConditionalGeneration
import torch
device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
processor = LlavaNextProcessor.from_pretrained(
    "llava-hf/llava-v1.6-mistral-7b-hf"
)
model = LlavaNextForConditionalGeneration.from_pretrained(
    "llava-hf/llava-v1.6-mistral-7b-hf",
    torch_dtype=torch.float16,
    low_cpu_mem_usage=True
)
model.to(device)Năng lực của vision language models vượt xa việc tạo phụ đề ảnh. VLMs đã mở ra nhiều ứng dụng tận dụng khả năng kết nối giữa thông tin hình ảnh và văn bản. Hãy cùng khám phá một số ứng dụng có tác động lớn nhất của VLMs trên nhiều ngành.
Hỏi đáp dựa trên hình ảnh (VQA) là tác vụ trả lời các câu hỏi về nội dung của một bức ảnh.
Ứng dụng này yêu cầu mô hình hiểu cả các yếu tố thị giác trong ảnh và ngữ cảnh ngôn ngữ của câu hỏi. Ví dụ, với một ảnh quang cảnh thành phố nhộn nhịp, một VLM có thể trả lời các câu như "Tòa nhà cao nhất có màu gì?" hoặc "Có bao nhiêu người nhìn thấy trong ảnh?"
VQA có nhiều ứng dụng thực tế, đặc biệt trong các ngành nơi dữ liệu hình ảnh đóng vai trò quan trọng. Trong chăm sóc sức khỏe, chẳng hạn, VQA có thể được dùng để phân tích ảnh y khoa và cung cấp câu trả lời hỗ trợ chẩn đoán và lập kế hoạch điều trị. Trong bán lẻ, VQA có thể nâng cao trải nghiệm mua sắm bằng cách cho phép khách hàng tương tác với hình ảnh sản phẩm theo cách tự nhiên và trực quan hơn.
Một trong những khả năng thú vị nhất của VLMs là sinh ảnh từ văn bản. Tác vụ này liên quan đến việc tạo biểu diễn trực quan của một khung cảnh hoặc đối tượng dựa trên mô tả bằng văn bản. Ví dụ, một VLM có thể nhận prompt như "Hoàng hôn yên bình trên dãy núi với con sông chảy qua thung lũng" và tạo ra hình ảnh tương ứng.
Sinh ảnh từ văn bản có tiềm năng lớn trong các lĩnh vực sáng tạo như thiết kế và quảng cáo. Nhà thiết kế và nhà quảng cáo có thể dùng công nghệ này để nhanh chóng tạo ý tưởng trực quan dựa trên prompt văn bản. Khả năng này có thể tinh gọn quy trình tạo nội dung hình ảnh phù hợp với thông điệp tiếp thị cụ thể.
Truy xuất hình ảnh là quá trình tìm các ảnh phù hợp dựa trên truy vấn văn bản. VLMs vượt trội ở tác vụ này nhờ khả năng hiểu cả nội dung thị giác của ảnh và ngữ cảnh ngôn ngữ của truy vấn.
Khả năng này khiến công cụ tìm kiếm mạnh mẽ và chính xác hơn, cho phép người dùng tìm đúng hình ảnh mình cần một cách dễ dàng hơn.
Truy xuất hình ảnh có ứng dụng trong nhiều lĩnh vực, từ thương mại điện tử đến phân tích ảnh y khoa. Trong thương mại điện tử, truy xuất hình ảnh có thể giúp khách hàng tìm sản phẩm phù hợp với sở thích dựa trên mô tả hình ảnh và văn bản. Trong chăm sóc sức khỏe, truy xuất hình ảnh có thể hỗ trợ chuyên gia y tế tìm ảnh y khoa liên quan phục vụ nghiên cứu hoặc chẩn đoán.
Dù các ví dụ trên tập trung vào hình ảnh, VLMs cũng có thể được mở rộng để hiểu và tạo phụ đề cho video. Hiểu video bao gồm việc phân tích nội dung trực quan của video và tạo văn bản mô tả nêu bật bản chất của các cảnh được thể hiện.
Hiểu video có ứng dụng trong tìm kiếm video, tóm tắt và kiểm duyệt nội dung. Trong tìm kiếm video, VLMs có thể giúp người dùng tìm đoạn clip cụ thể dựa trên truy vấn văn bản. Trong tác vụ tóm tắt, VLMs có thể tạo bản tóm tắt ngắn gọn cho video dài, giúp người dùng nhanh chóng nắm nội dung. Trong kiểm duyệt, VLMs có thể hỗ trợ nhận diện nội dung không phù hợp hoặc gây hại trong video, đảm bảo nền tảng duy trì môi trường an toàn và thân thiện.
Hãy cùng xem xét các thách thức gắn với VLMs cũng như khía cạnh đạo đức.
Huấn luyện và triển khai VLMs đòi hỏi tài nguyên tính toán đáng kể, đặc biệt với các mô hình lớn như PaliGemma. Đây có thể là rào cản đối với các tổ chức hạn chế về hạ tầng tính toán hiệu năng cao.
Để giải quyết thách thức này, các nhà nghiên cứu đang khám phá cách làm VLMs hiệu quả hơn, như dùng kỹ thuật nén mô hình, tối ưu kiến trúc mô hình và tận dụng bộ gia tốc phần cứng như GPU và TPU.
Sự phát triển của VLMs đặt ra nhiều lo ngại về đạo đức, đặc biệt quanh khả năng thiên lệch trong đầu ra của mô hình. VLMs được huấn luyện trên dữ liệu ảnh-văn bản quy mô lớn từ thế giới thực có thể phản ánh thiên lệch văn hóa - xã hội tồn tại trong tài liệu huấn luyện. Những thiên lệch này có thể biểu hiện trong đầu ra của mô hình, dẫn đến nội dung gây hại hoặc xúc phạm.
Để giải quyết các lo ngại này, các nhà nghiên cứu áp dụng nhiều kỹ thuật giảm thiểu thiên lệch, như sử dụng bộ dữ liệu huấn luyện cân bằng, tích hợp thuật toán học chú trọng công bằng, và tiến hành đánh giá nghiêm ngặt đầu ra của mô hình để nhận diện và xử lý thiên lệch tiềm ẩn.
Ngoài ra, các tổ chức như Google đang triển khai bộ lọc an toàn nội dung để đảm bảo dữ liệu huấn luyện cho các mô hình như PaliGemma sạch và không chứa nội dung gây hại.
Một cân nhắc quan trọng khác trong phát triển VLMs là quyền riêng tư và bảo mật dữ liệu. VLMs thường cần truy cập lượng dữ liệu lớn, bao gồm cả thông tin nhạy cảm. Đảm bảo dữ liệu này được xử lý an toàn và tuân thủ quy định về quyền riêng tư là điều tối quan trọng để duy trì niềm tin của người dùng và các bên liên quan.
Để giải quyết mối lo ngại về quyền riêng tư, các nhà nghiên cứu đang khám phá các kỹ thuật như học liên kết (federated learning), cho phép huấn luyện mô hình trên dữ liệu phi tập trung mà không cần chuyển thông tin nhạy cảm về một máy chủ trung tâm.
Ngoài ra, các tổ chức như Google đang áp dụng các biện pháp trách nhiệm dữ liệu, như lọc thông tin cá nhân và dữ liệu nhạy cảm khỏi bộ dữ liệu huấn luyện, để bảo vệ quyền riêng tư của cá nhân.
Vision language models là một bước tiến đáng kể của trí tuệ nhân tạo, mang lại tiềm năng nâng cao nhiều ứng dụng nhờ khả năng xử lý cả dữ liệu hình ảnh và văn bản.
Khi nghiên cứu trong lĩnh vực này tiến triển, chúng ta có thể kỳ vọng sự ra đời của các VLM tinh vi hơn, có khả năng thực hiện các tác vụ phức tạp và cung cấp những insight giá trị.
Sự tích hợp giữa hiểu biết hình ảnh và văn bản mở ra những khả năng đổi mới mới, khiến VLMs trở thành một lĩnh vực nghiên cứu và phát triển đầy hứa hẹn.
Học AI với các khóa học này!
Khóa học
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
