

Khóa học
Fine-Tuning với Llama 3
2 giờ
4.1K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleUnsloth Studio đang giúp fine-tune LLM trở nên dễ tiếp cận hơn với mọi người thông qua giao diện chạy cục bộ trên trình duyệt, loại bỏ phần lớn công việc thiết lập và mã hóa. Đây là một giao diện web no-code, đảm nhiệm việc tải mô hình, định dạng dữ liệu, thiết lập siêu tham số và giám sát quá trình huấn luyện theo thời gian thực.
Trong hướng dẫn này, chúng ta sẽ đi qua toàn bộ quy trình fine-tune một LLM với Unsloth Studio. Chúng ta sẽ bắt đầu từ việc chuẩn bị mô hình và dữ liệu, chạy tác vụ fine-tuning, kiểm thử mô hình đã fine-tune cục bộ trong giao diện chat, và cuối cùng là xuất mô hình để sử dụng về sau.
Unsloth Studio hỗ trợ cài đặt cục bộ trên Linux, Windows, macOS và WSL, đồng thời công cụ xuất hỗ trợ các định dạng như GGUF, Safetensors và LoRA để dùng tiếp trong các công cụ như llama.cpp, Ollama và vLLM.
Với nhiều quy trình fine-tuning quy mô nhỏ đến trung bình, khi môi trường đã sẵn sàng, bạn có thể hoàn thành khá nhanh, khiến Unsloth Studio trở thành lựa chọn thực tế cho người mới bắt đầu muốn có con đường đơn giản hơn từ dữ liệu đến một mô hình đã fine-tune hoạt động được.
Tôi cũng khuyến nghị xem thêm bài hướng dẫn Cách chạy Unsloth Studio cục bộ để tìm hiểu thêm.
Ở các bước dưới đây, tôi sẽ phác thảo cách bạn có thể bắt đầu sử dụng Unsloth Studio để fine-tune LLM:
Trước khi cài Unsloth Studio, hãy đảm bảo máy của bạn hỗ trợ huấn luyện. Unsloth Studio có thể chạy trên Windows, Linux, WSL và macOS, nhưng hỗ trợ huấn luyện phụ thuộc vào phần cứng của bạn.
Hiện tại, huấn luyện đầy đủ được hỗ trợ trên GPU NVIDIA và GPU Intel. Trên hệ thống Mac và chỉ CPU, bạn vẫn có thể dùng Chat và Data Recipes, trong khi hỗ trợ huấn luyện MLX dự kiến sau.
Điều kiện tiên quyết cho huấn luyện trên Linux:
Trước khi cài Unsloth Studio, bạn nên đọc hướng dẫn Cách chạy Unsloth Studio cục bộ: Hướng dẫn từng bước. Bài này giải thích chi tiết hơn về thiết lập Runpod, cài đặt Unsloth Studio và mở trên trình duyệt.
Trong hướng dẫn này, chúng tôi có một thay đổi nhỏ. Thay vì dùng A10 pod, chúng tôi dùng RTX A6000 GPU pod. Lý do chính là thiết lập A10 có thể mất nhiều thời gian hơn khi cài dependency và chuẩn bị môi trường cho Unsloth Studio.
Để cài Unsloth Studio, hãy dùng trình cài đặt chính thức một dòng:
curl -fsSL https://unsloth.ai/install.sh | shTrình cài đặt trước tiên sẽ thiết lập các dependency Python cần thiết bằng uv.
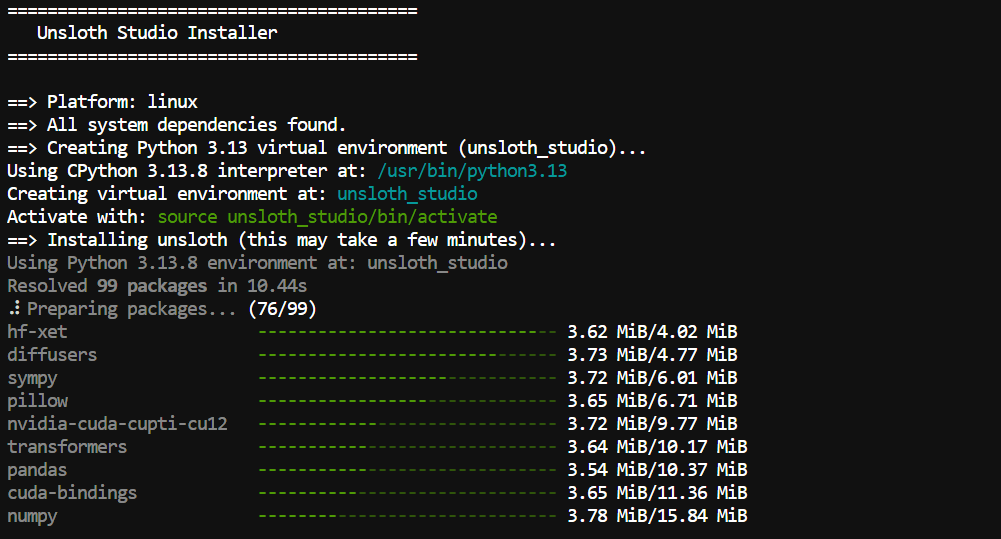
Sau đó, nó chạy script thiết lập Unsloth Studio, cài đặt các tệp cần cho suy luận web cục bộ.
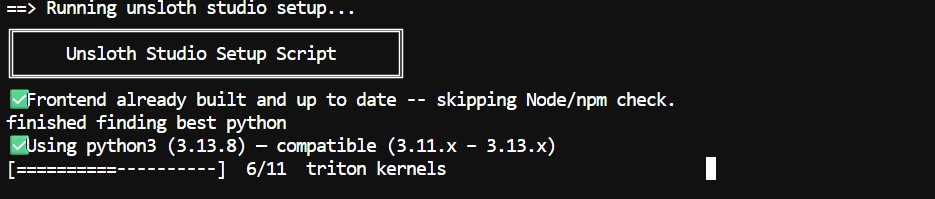
Khi mọi thứ đã được tải xuống và cấu hình, bao gồm các tệp frontend và thành phần mô hình, Unsloth Studio sẽ hiển thị các bước tiếp theo để khởi động server và mở giao diện trong trình duyệt của bạn.
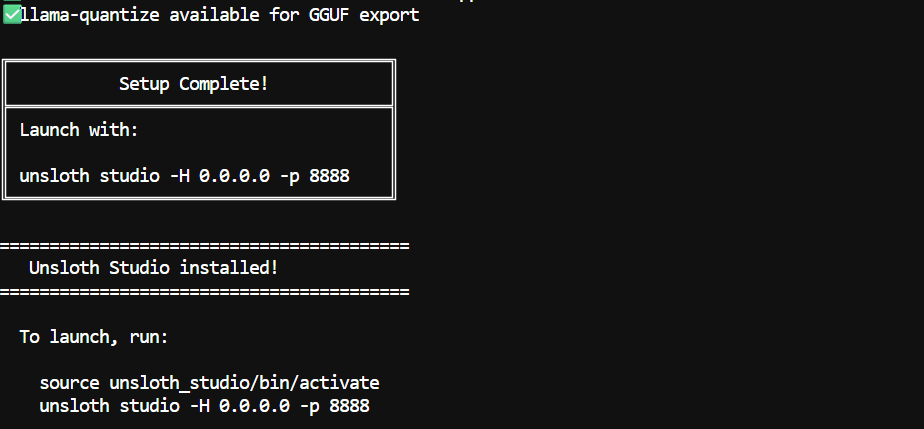
Lưu ý: Lần cài đặt đầu tiên có thể mất 5 đến 10 phút vì một số binary llama.cpp có thể cần được biên dịch.
Khi cài đặt hoàn tất, bạn có thể khởi động Unsloth Studio bằng các lệnh sau:
source unsloth_studio/bin/activateunsloth studio -H 0.0.0.0 -p 8910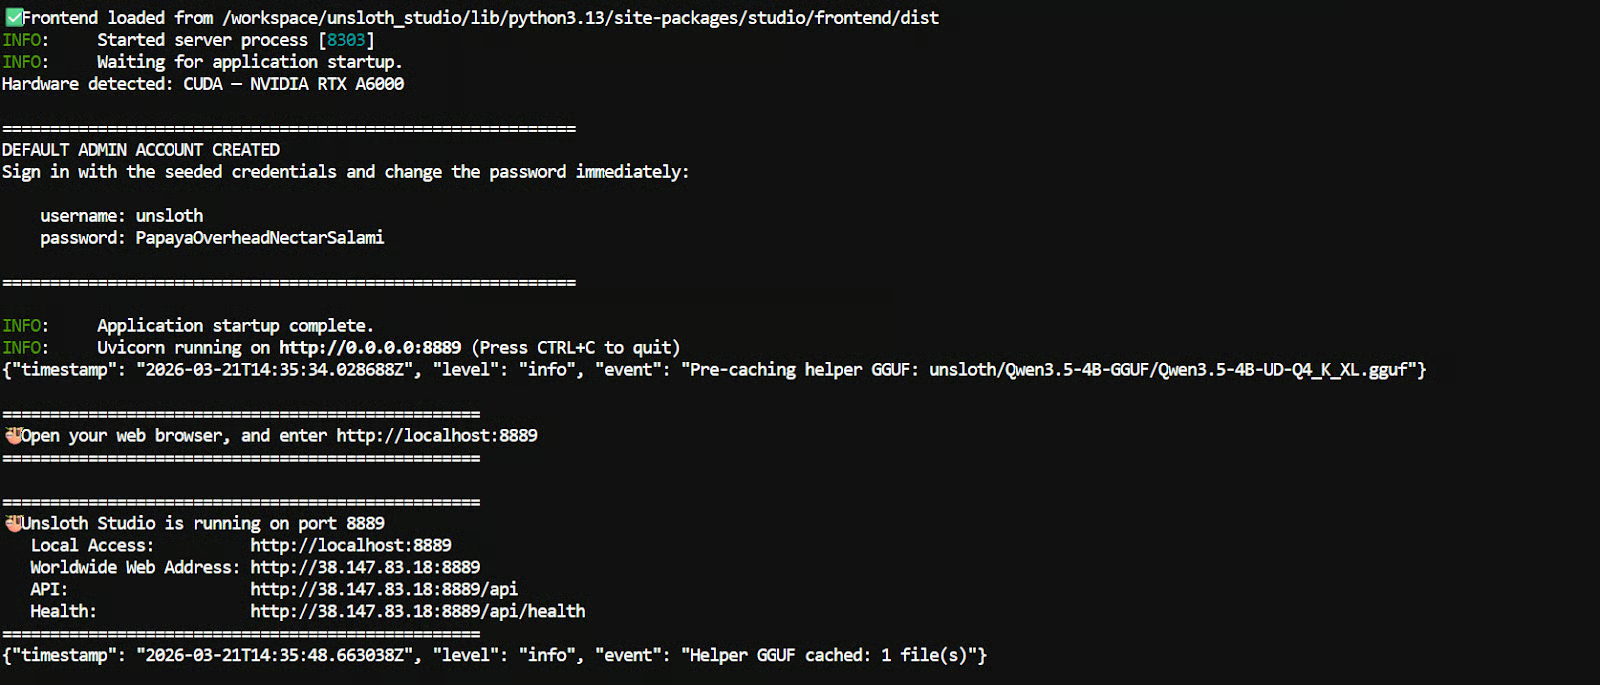
Nếu bạn chạy trên máy cục bộ, hãy mở liên kết này trong trình duyệt:
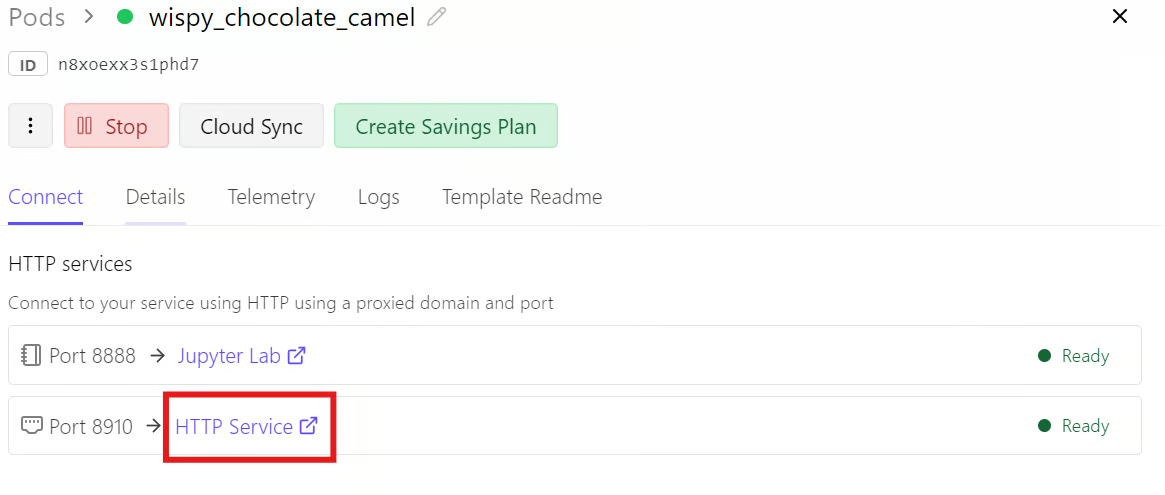
http://localhost:8910Nếu bạn dùng Runpod, vào bảng điều khiển Runpod, mở tab Connect và nhấp vào liên kết cho cổng 8910.
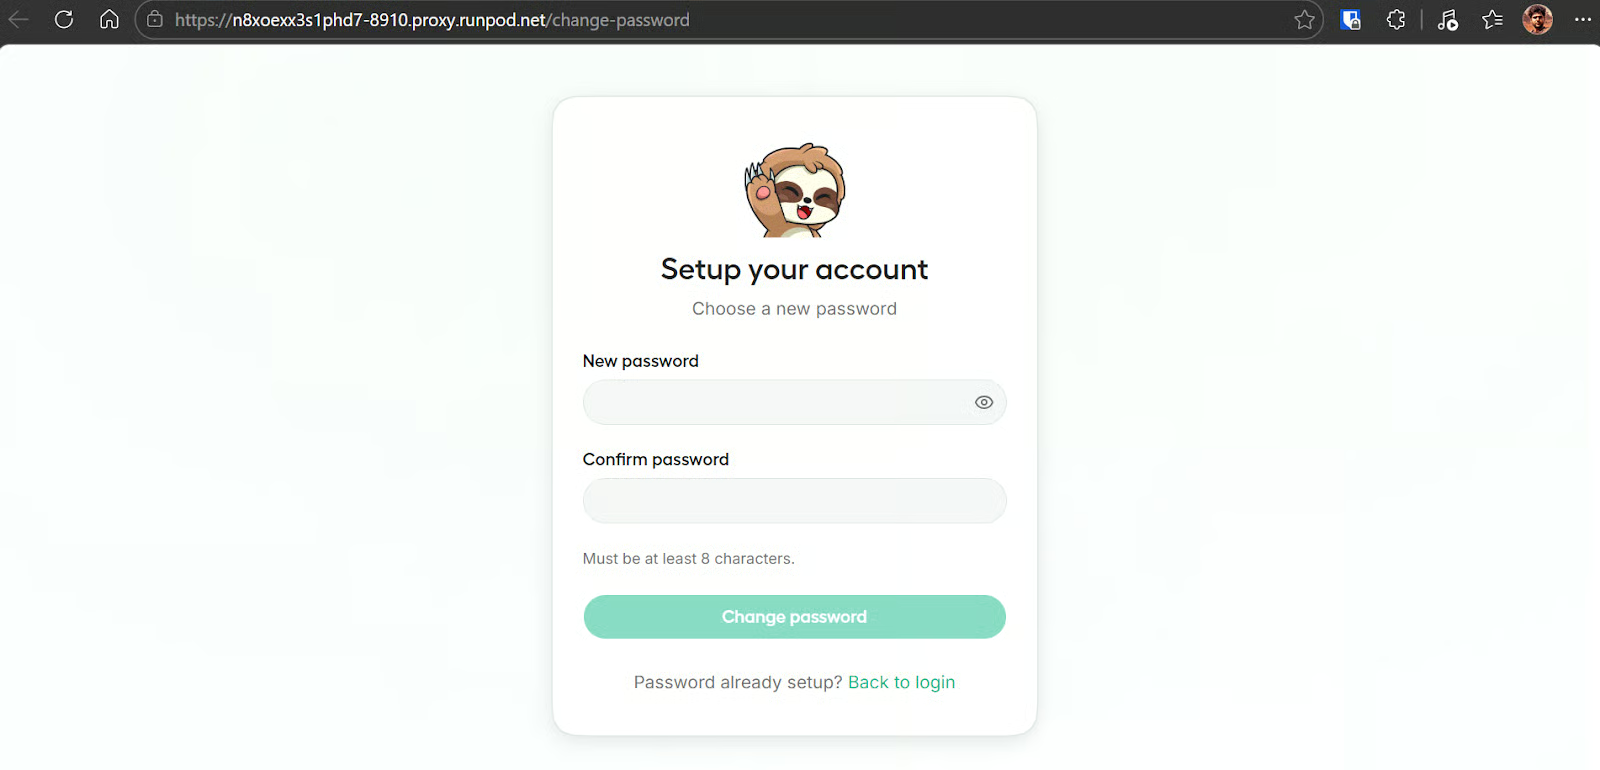
Khi mở Unsloth Studio lần đầu, hệ thống sẽ yêu cầu bạn tạo mật khẩu cho phiên bản của mình. Điều này giúp bảo vệ truy cập, đặc biệt khi bạn dùng liên kết công khai hoặc có thể truy cập từ bên ngoài.
Khi Unsloth Studio mở ra, màn hình chính được chia thành bốn phần cốt lõi: Model, Dataset, Parameters và Training/Config. Kết hợp lại, các phần này bao quát toàn bộ quy trình fine-tuning, từ chọn mô hình nền tảng đến khởi chạy huấn luyện và theo dõi tiến trình.
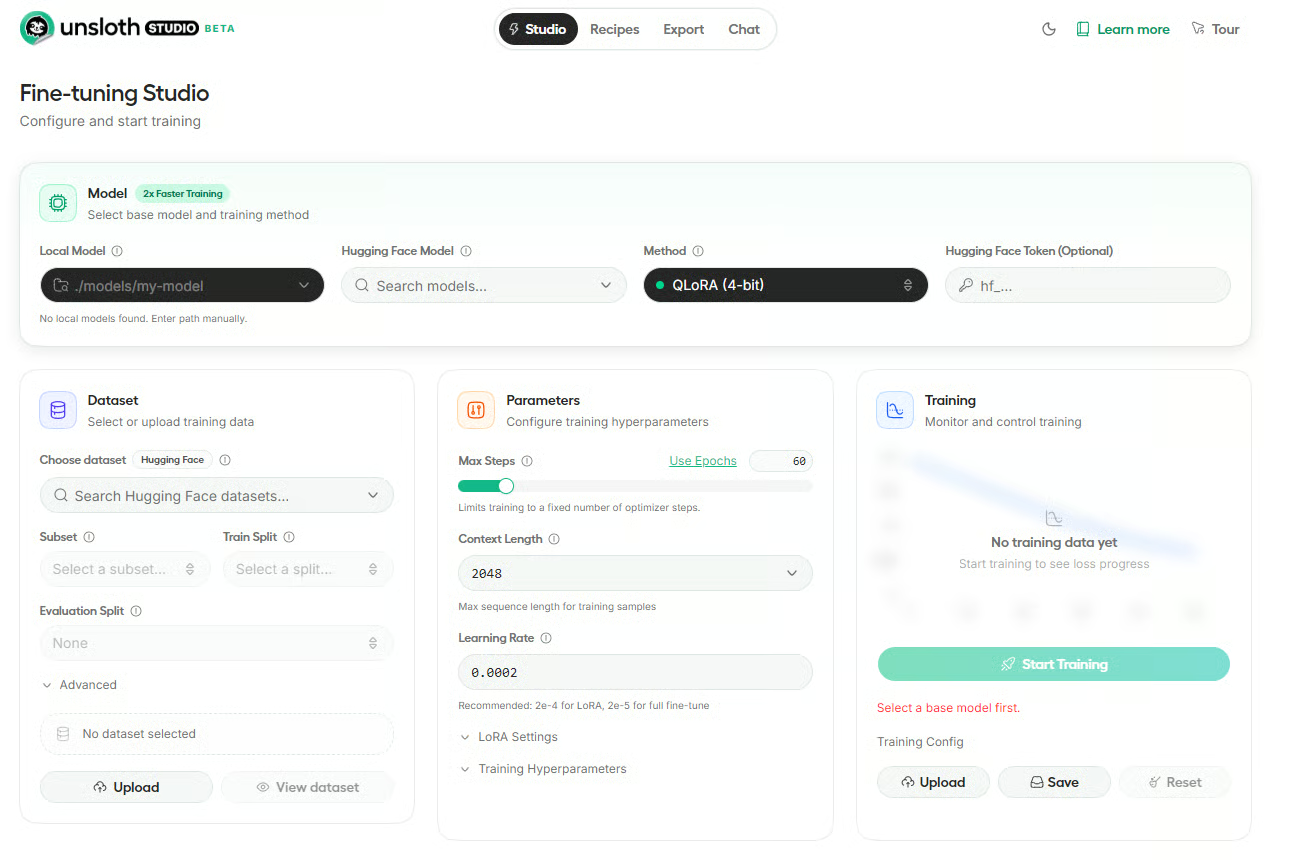
Đây là nơi bạn chọn mô hình nền tảng và phương pháp huấn luyện. Ở màn hình này, bạn có thể nhập đường dẫn mô hình cục bộ, tìm mô hình trên Hugging Face, chọn phương pháp fine-tuning như QLoRA (4-bit), và tùy chọn thêm token Hugging Face của bạn.
Phần này dùng để chọn hoặc tải dữ liệu huấn luyện của bạn. Bạn có thể chọn bộ dữ liệu từ Hugging Face, xác định subset và split, và tải lên tệp của riêng bạn nếu cần.
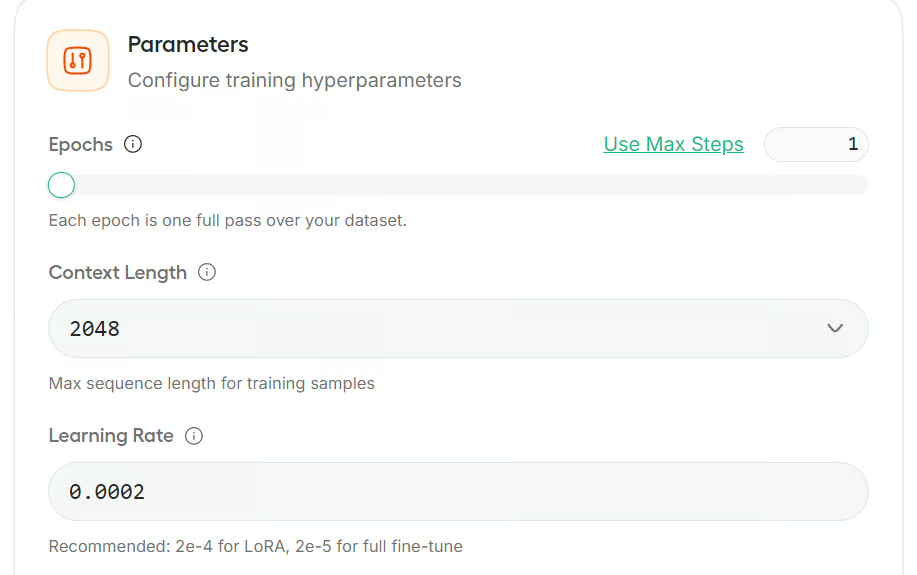
Tại đây bạn cấu hình các thiết lập huấn luyện chính như số bước tối đa, độ dài ngữ cảnh và tốc độ học. Cũng có các thiết lập mở rộng cho LoRA và các siêu tham số huấn luyện khác.
Đây là phần bạn khởi động và theo dõi quá trình huấn luyện. Khi mô hình và bộ dữ liệu đã sẵn sàng, bạn có thể chạy, theo dõi tiến trình, và tải lên hoặc lưu cấu hình huấn luyện.
Trong phần Model, bạn có thể tìm mô hình từ Hugging Face hoặc chọn mô hình cục bộ đã có sẵn trên máy. Unsloth Studio hỗ trợ tìm kiếm trực tiếp trên Hub, và các mô hình cục bộ lưu ở ~/.unsloth/studio/models hoặc cache của Hugging Face cũng có thể xuất hiện trong danh sách.
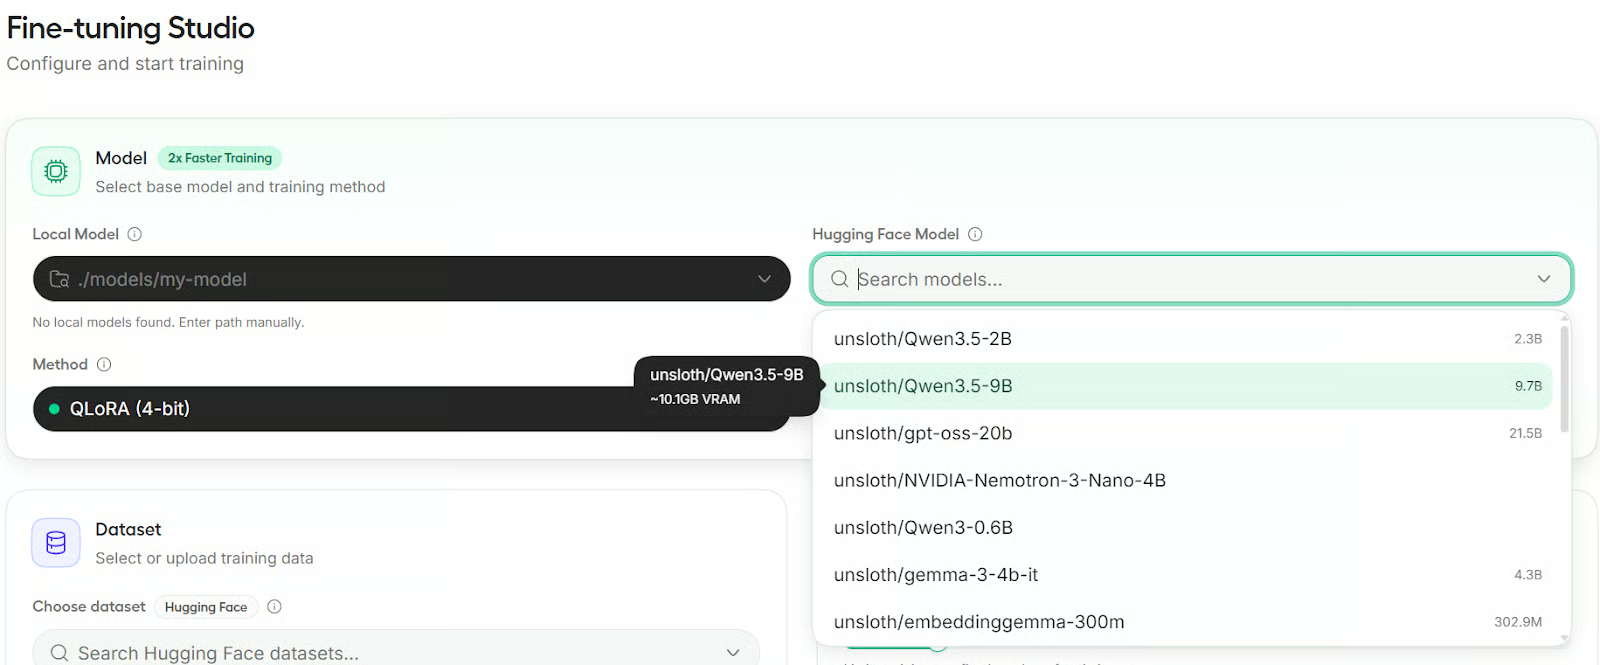
Trong hướng dẫn này, chúng ta sẽ dùng Qwen3.5-9B làm mô hình nền tảng. Đây là mô hình gọn nhẹ nhưng mạnh, phù hợp cho fine-tuning quy mô nhỏ và thử nghiệm cục bộ.
Unsloth Studio cung cấp ba phương pháp huấn luyện: QLoRA, LoRA và Fine-tuning toàn phần. QLoRA dùng mô hình nền tảng lượng tử hóa 4-bit với bộ điều hợp LoRA và cần ít VRAM nhất.
LoRA giữ mô hình nền tảng ở độ chính xác đầy đủ và thêm bộ điều hợp LoRA, nên dùng nhiều bộ nhớ hơn. Fine-tuning toàn phần cập nhật toàn bộ trọng số mô hình và yêu cầu nhiều VRAM nhất.
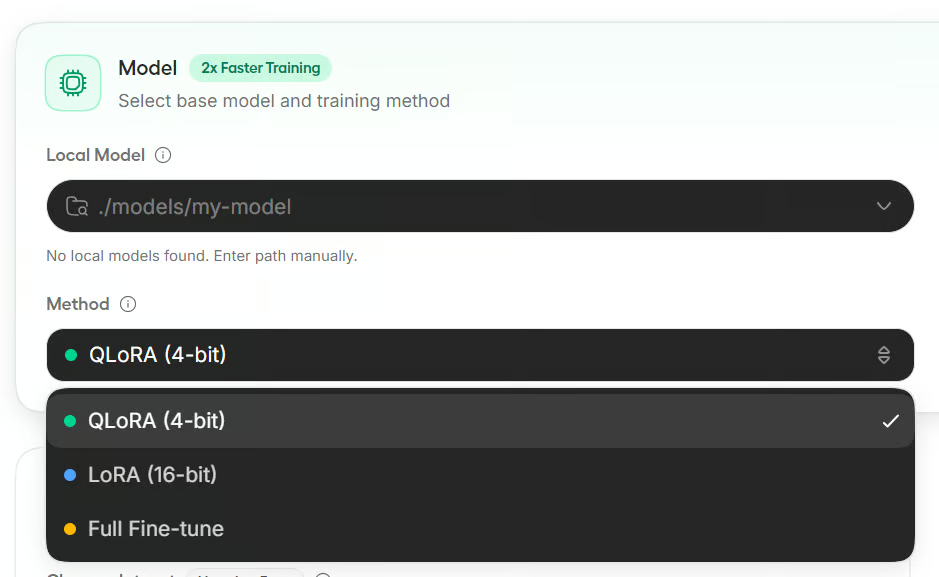
Trong hướng dẫn này, chúng ta sẽ dùng QLoRA vì đây là lựa chọn tiết kiệm bộ nhớ nhất và thường dễ nhất cho các thiết lập GPU nhỏ.
Trong phần Dataset, bạn có thể tải dữ liệu từ Hugging Face hoặc tải tệp cục bộ. Unsloth Studio hỗ trợ định dạng bộ dữ liệu tự động và làm việc với các cấu trúc phổ biến như Alpaca, ChatML và ShareGPT. Công cụ cũng có tính năng chọn split, ánh xạ cột và xem trước bộ dữ liệu.
Ở đây, hãy chọn bộ dữ liệu Unsloth Latex OCR, chọn train split và để trống evaluation split để huấn luyện nhanh hơn. Chúng ta cũng giữ định dạng ở chế độ Auto để Studio tự phát hiện cấu trúc bộ dữ liệu.
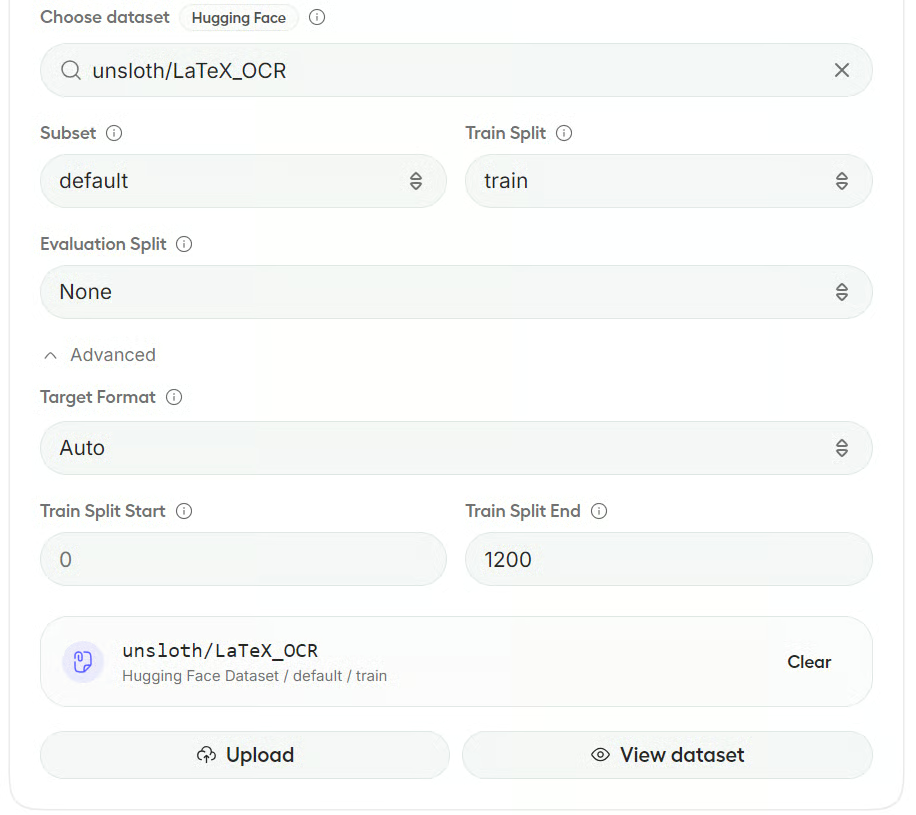
Lưu ý: Nếu Studio không thể phát hiện đầy đủ các trường dữ liệu, nó sẽ mở cửa sổ xem trước nơi bạn có thể ánh xạ các cột như instruction, input, output hoặc image. Thường các ánh xạ gợi ý sẽ được điền tự động.
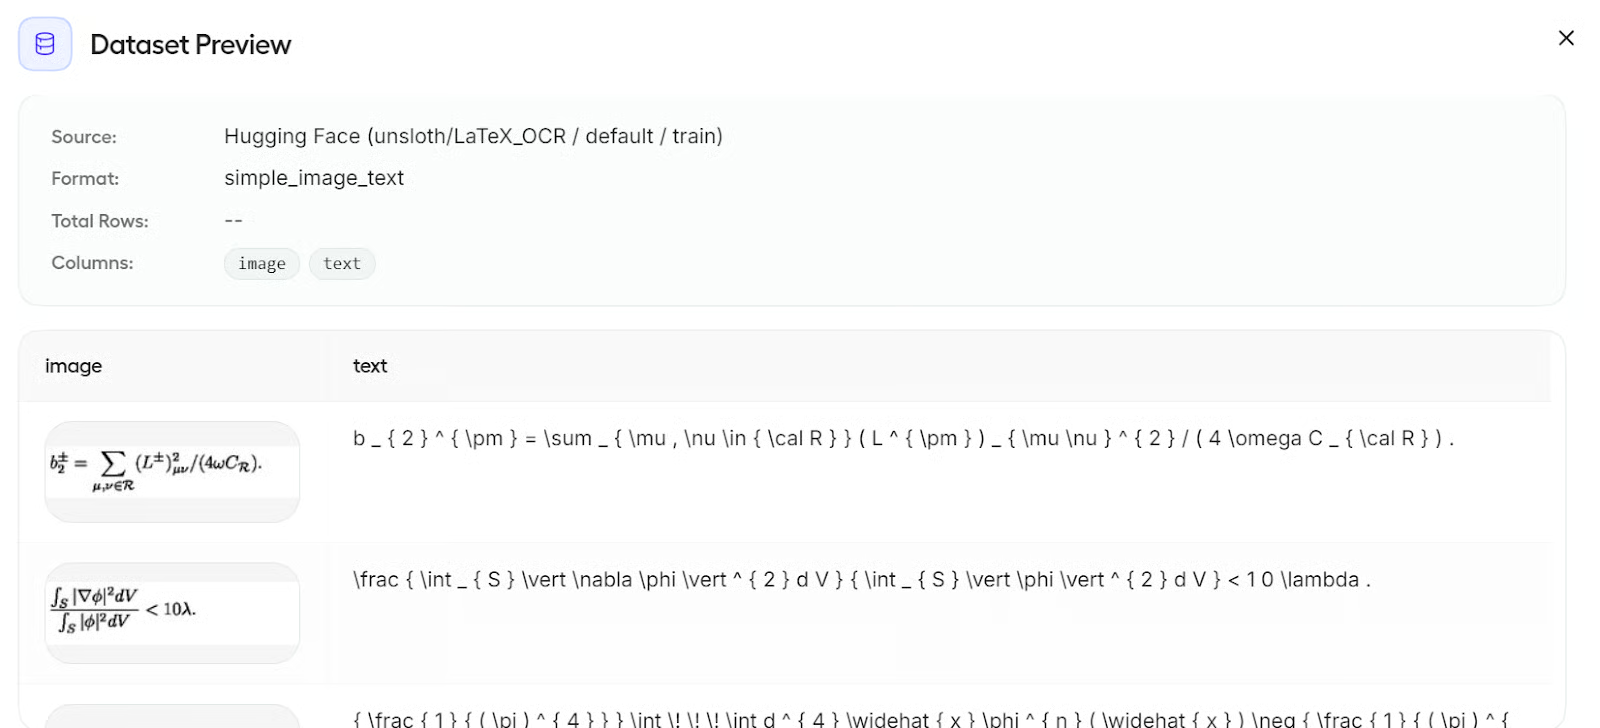
Bạn cũng có thể nhấp View dataset để kiểm tra dữ liệu trước khi huấn luyện. Trong trường hợp này, bộ dữ liệu bao gồm các cột image và text, sẵn sàng cho fine-tuning đa phương thức.
Trong phần Parameters, Unsloth Studio nhóm các thiết lập vào các bảng thu gọn. Trong hướng dẫn này, chúng ta sẽ giữ mọi thứ đơn giản và chỉ thay đổi một vài mục nhỏ.
Trước hết, chuyển giới hạn huấn luyện từ steps sang epochs và đặt là 1 epoch. Vì đây là lượt chạy ví dụ ngắn, huấn luyện một vòng qua toàn bộ dữ liệu là đủ. Chúng ta sẽ giữ các thiết lập chính khác ở giá trị mặc định:
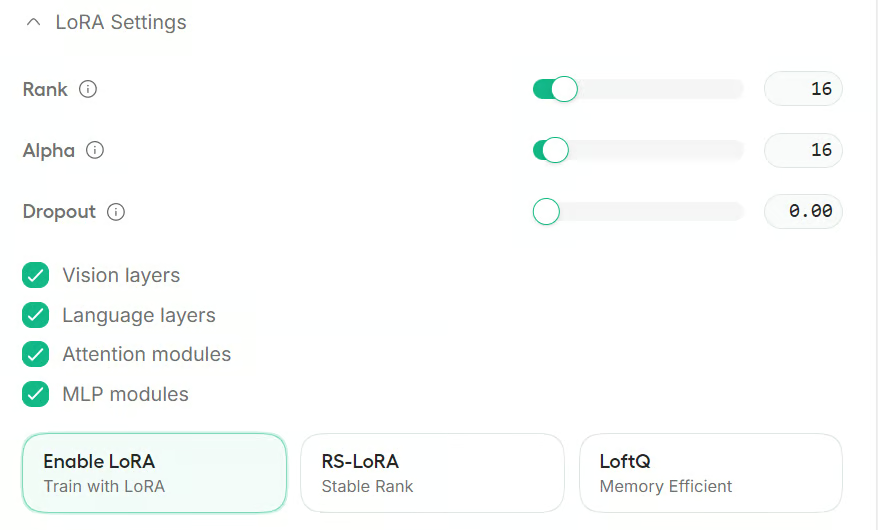
Tiếp theo, mở phần LoRA Settings. Trong hướng dẫn này, chúng ta cũng giữ các giá trị mặc định tại đây:
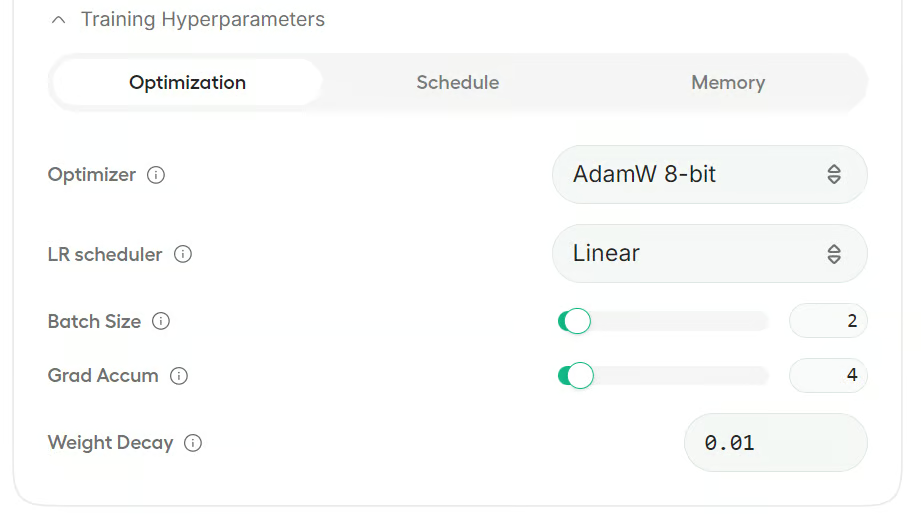
Bạn cũng có thể mở rộng phần Training Hyperparameters để điều chỉnh các tùy chọn như optimizer, scheduler và thiết lập liên quan đến bộ nhớ.
Với ví dụ này, chúng ta sẽ giữ mọi thứ khác như mặc định và dùng cấu hình sẵn có.
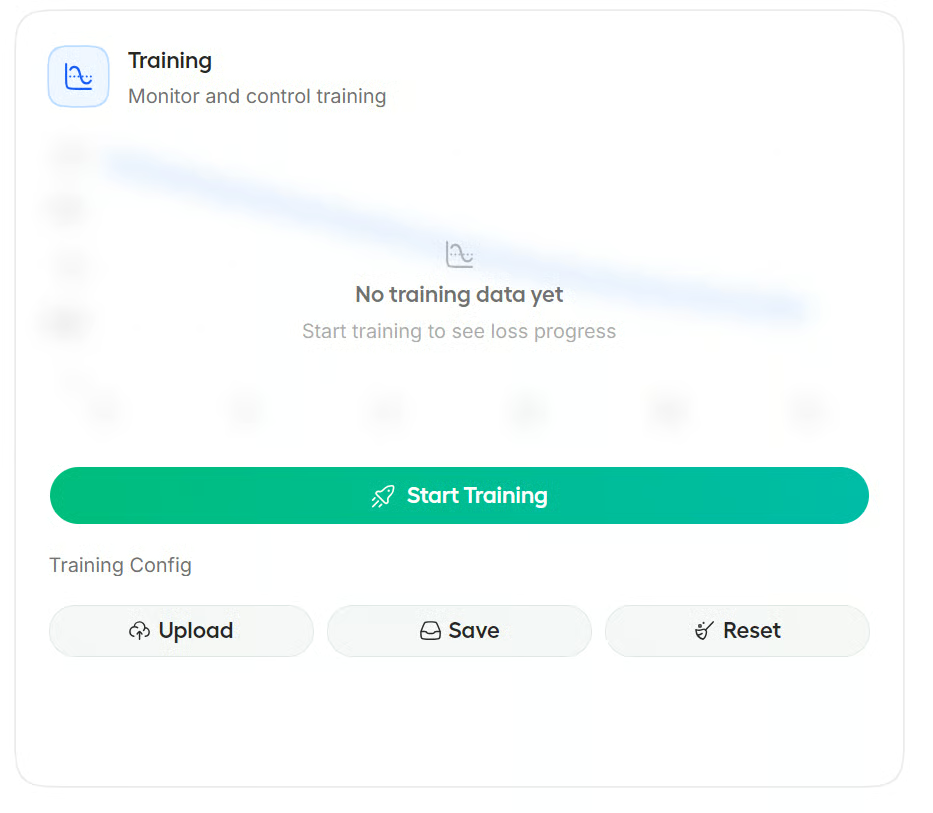
Trước khi bắt đầu huấn luyện, bạn nên lưu các thiết lập. Điều này giúp dễ dàng tải lại cùng cấu hình sau này hoặc chia sẻ với đội ngũ để tái tạo kết quả.
Khi mọi thứ đã sẵn sàng, nhấp Start Training.
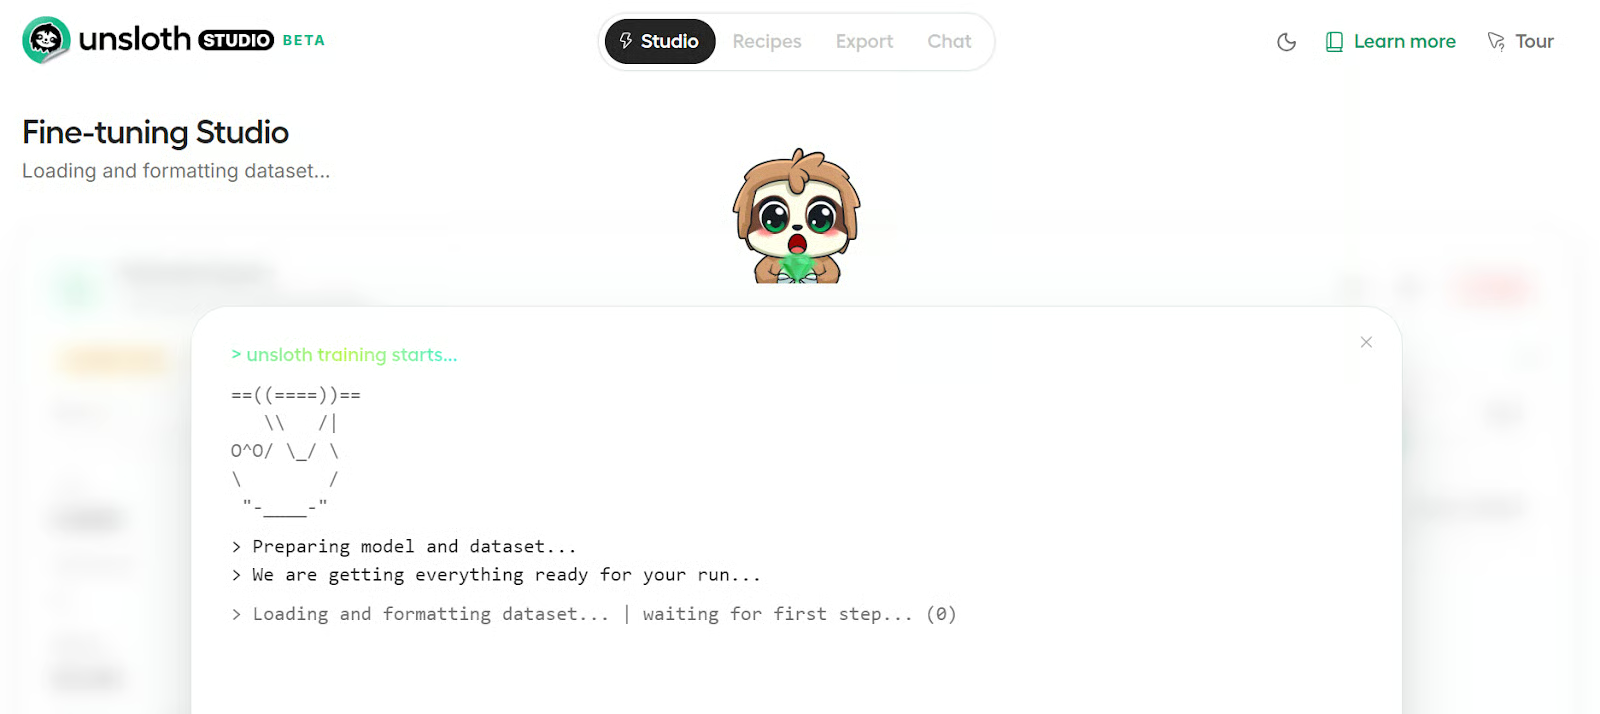
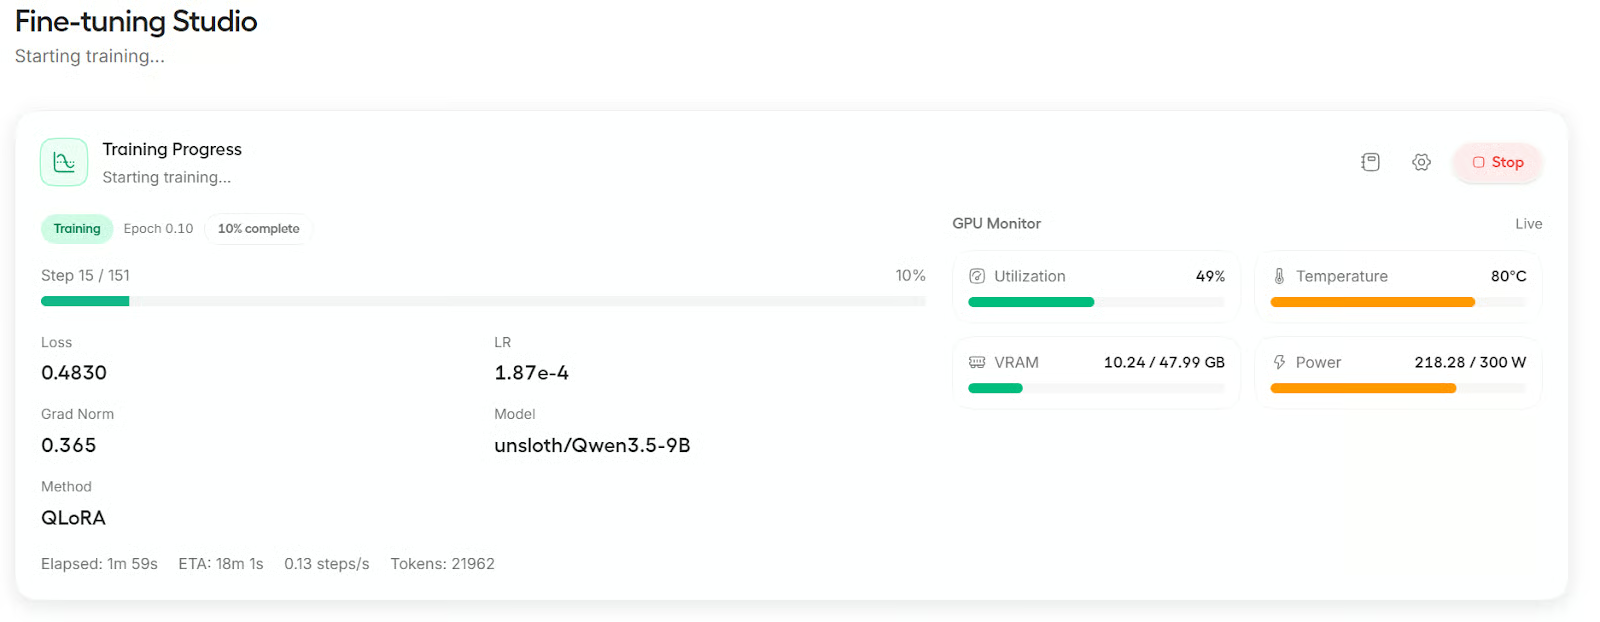
Studio sẽ mở chế độ xem huấn luyện, nơi bạn có thể theo dõi log khi lượt chạy bắt đầu. Lúc đầu, bạn sẽ thấy các bước thiết lập thông thường như tải thư viện Python, chuẩn bị bộ dữ liệu và khởi tạo pipeline fine-tuning.
Khi huấn luyện bắt đầu, màn hình cập nhật để hiển thị tiến trình trực tiếp, bao gồm loss, steps và các thông tin huấn luyện khác.
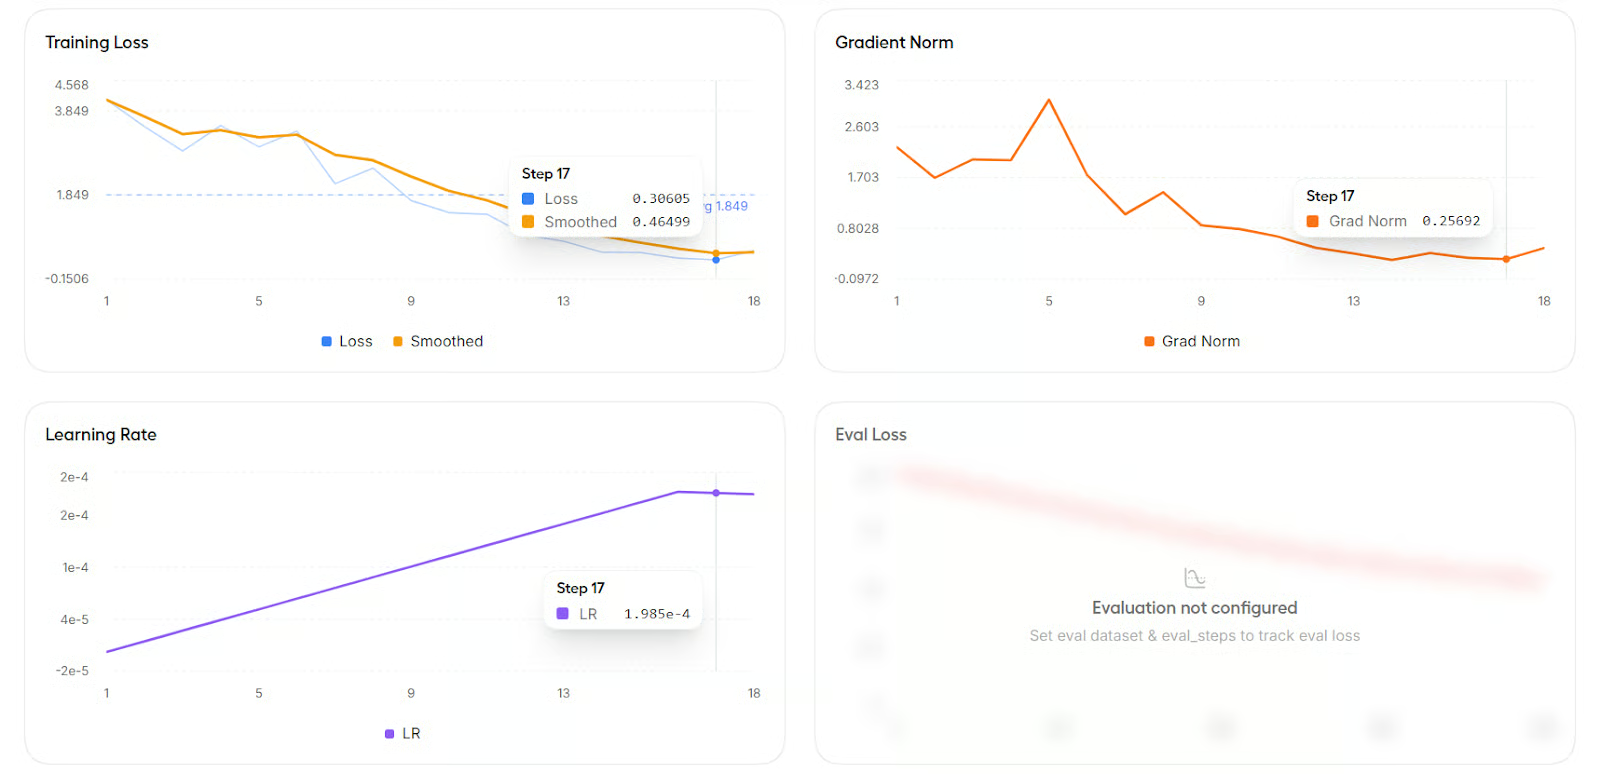
Bạn cũng có thể cuộn xuống để xem biểu đồ cho các chỉ số như training loss, learning rate và gradient norm.
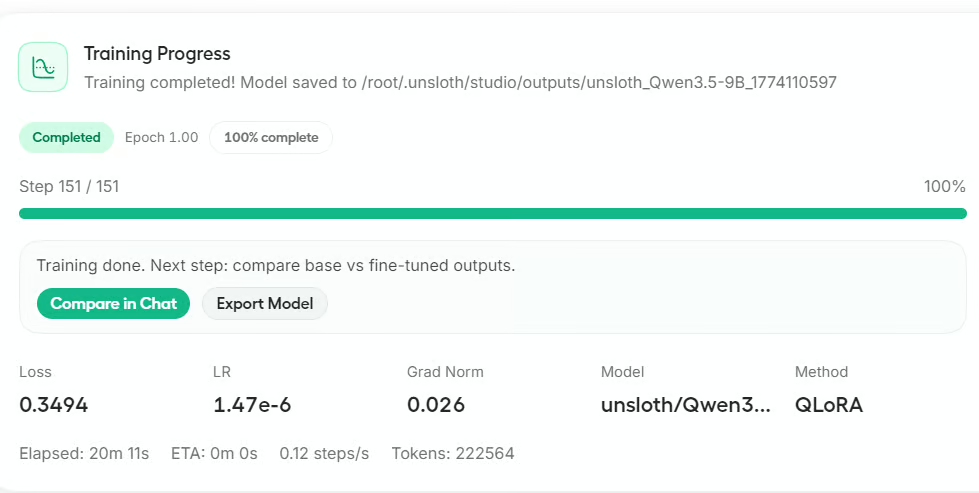
Sau khi huấn luyện xong, Studio sẽ cho bạn tùy chọn xuất mô hình hoặc so sánh trong Chat. Với hướng dẫn này, hãy nhấp Compare in Chat để kiểm thử mô hình đã fine-tune.
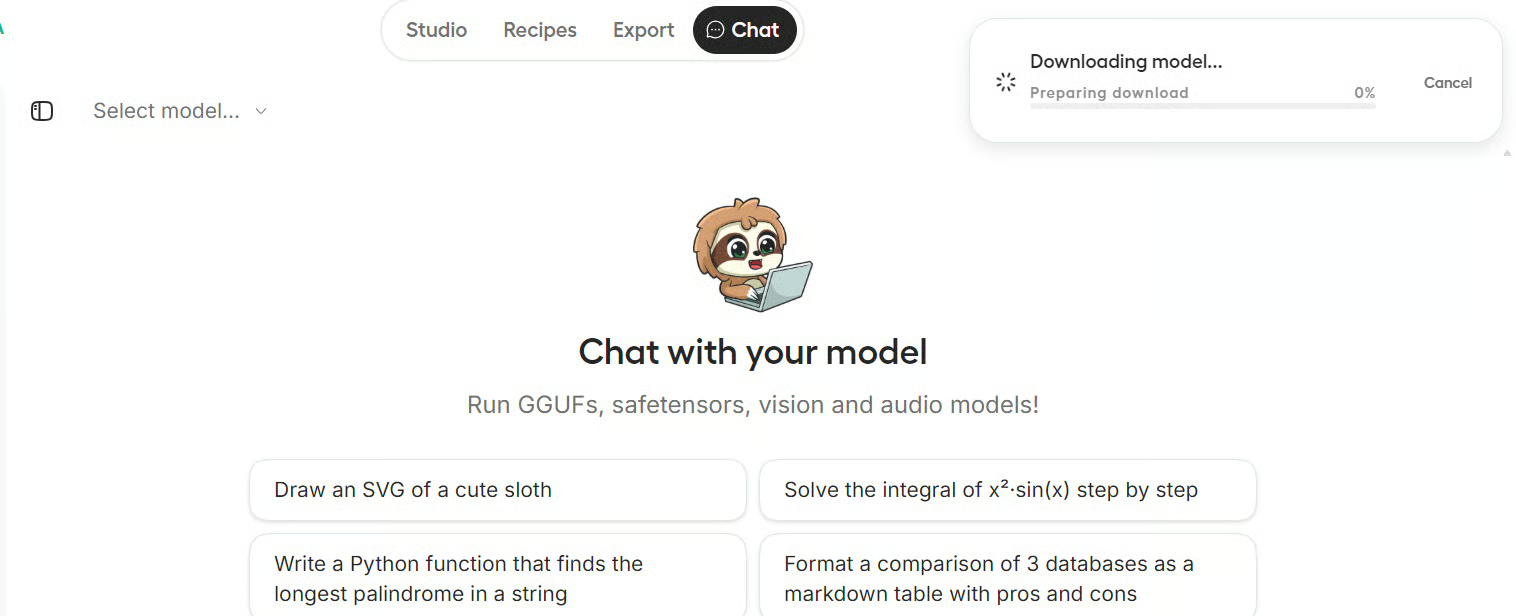
Có thể mất vài giây để mô hình đã fine-tune tải lên trong giao diện chat.
Khi sẵn sàng, bạn sẽ thấy tên mô hình mới xuất hiện trong phần Select Model.
Khi kiểm thử, chúng tôi đưa cho mô hình một hình ảnh phương trình LaTeX, và mô hình đã chép lại chính xác thành văn bản.
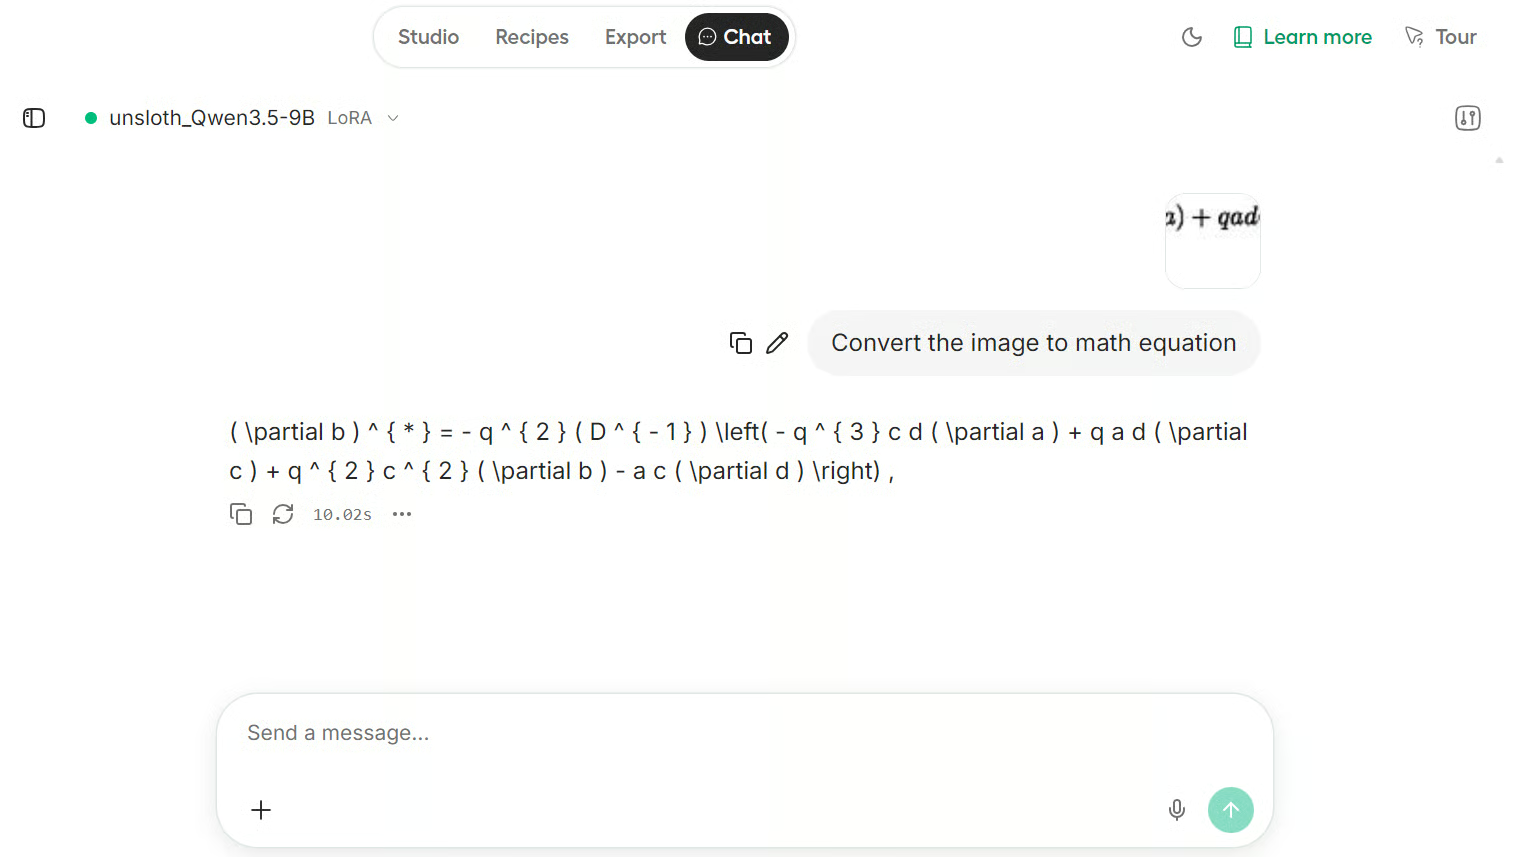
Kết quả rất ấn tượng. Dù đây chỉ là bộ dữ liệu ví dụ nhỏ, mô hình đã fine-tune vẫn xử lý tốt phương trình và cho thấy hiệu năng mạnh ở tác vụ LaTeX OCR này.
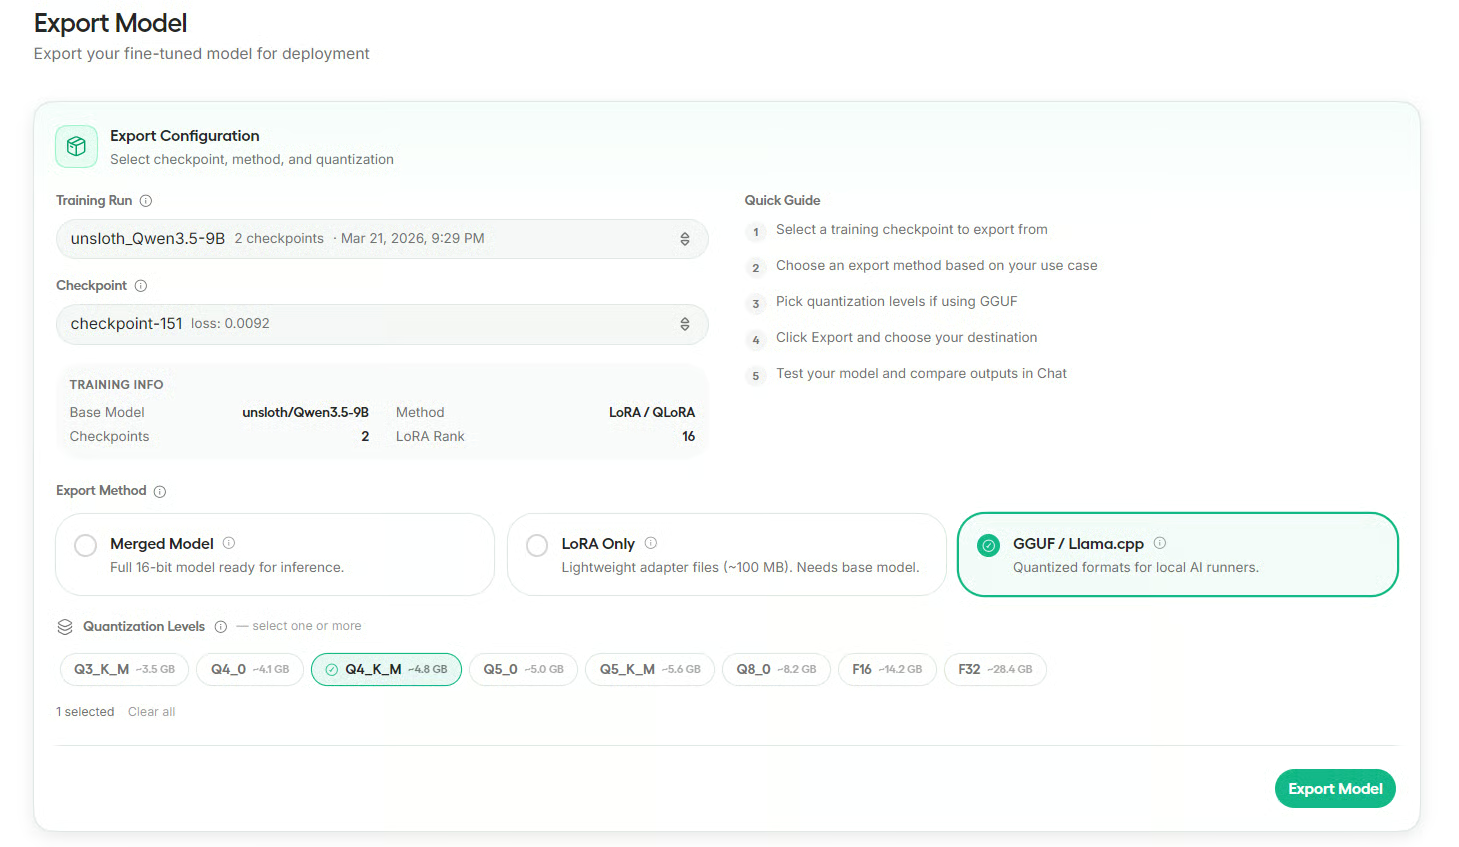
Sau khi kiểm thử mô hình đã fine-tune, hãy vào phần Export. Tại đây, chọn lượt chạy huấn luyện, chọn checkpoint, rồi chọn định dạng xuất bạn muốn.
Unsloth hỗ trợ xuất dưới dạng mô hình đã gộp, chỉ LoRA hoặc GGUF cho các công cụ suy luận cục bộ.
Với hướng dẫn này, hãy xuất mô hình ở định dạng GGUF và chọn lượng tử hóa Q4_K_M.
Đây là lựa chọn tốt cho sử dụng cục bộ vì giúp mô hình nhỏ gọn hơn trong khi vẫn hoạt động tốt trong các công cụ như Ollama, llama.cpp, LM Studio và Jan AI.
Trước khi xuất, Studio sẽ hỏi bạn muốn lưu mô hình cục bộ hay đẩy lên Hugging Face. Trong hướng dẫn này, chúng ta sẽ lưu cục bộ.
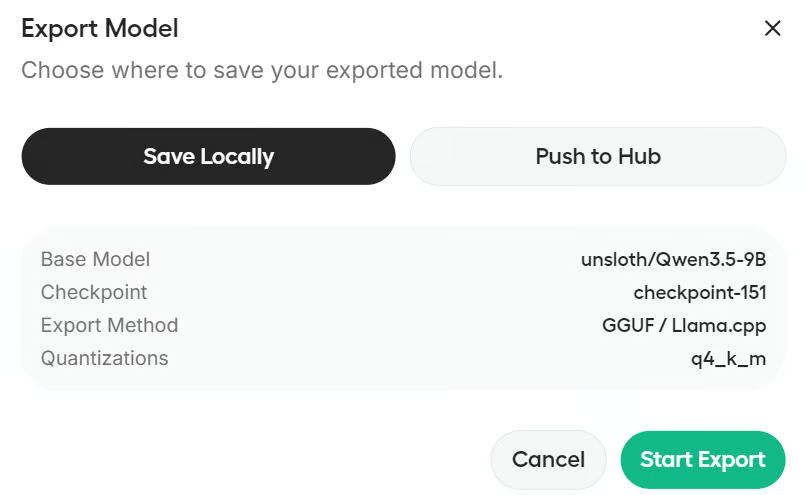
Nếu muốn đẩy lên Hugging Face, bạn sẽ cần thiết lập xác thực phù hợp, như đăng nhập Hugging Face có quyền ghi hoặc token.
Unsloth Studio giúp việc fine-tuning trở nên dễ tiếp cận hơn nhiều, đặc biệt với những ai muốn làm việc với mô hình mở mà không phải mất hàng giờ thiết lập pipeline huấn luyện phức tạp.
Từ cài đặt đến huấn luyện, kiểm thử chat và xuất mô hình, toàn bộ quy trình được tổ chức theo cách thực tế và thân thiện với người mới.
Trong hướng dẫn này, tôi đã dẫn bạn qua toàn bộ quy trình fine-tuning trong Unsloth Studio. Chúng ta cài studio trên máy có GPU, khởi chạy giao diện web, chọn Qwen3.5-9B làm mô hình nền tảng, tải bộ dữ liệu Latex OCR, cấu hình các thiết lập huấn luyện chính, chạy fine-tuning với QLoRA, kiểm thử mô hình đã fine-tune trong chat và cuối cùng xuất mô hình để dùng cục bộ.
Nếu bạn mới làm quen với fine-tuning LLM, Unsloth Studio là điểm khởi đầu rất tốt. Nó hạ thấp rào cản gia nhập, giữ quy trình rõ ràng và mang đến con đường đơn giản để huấn luyện và chạy mô hình cục bộ. Tôi cũng khuyến nghị xem khóa học Fine-Tuning With Llama 3, which cung cấp các ví dụ thực hành về quy trình fine-tuning.
Các khóa học hàng đầu trên DataCamp
Khóa học
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
