
什么是对抗性机器学习?
对抗性机器学习(AML)是人工智能与机器学习中的一个研究分支。对抗性攻击者会有意操纵输入数据,迫使模型做出错误预测或泄露敏感信息。AML 致力于理解这些脆弱性,并开发更能抵御攻击的模型。
该领域既包括构造对抗性攻击的方法,也包括设计防御手段来保护系统。同时它也可能涉及更广泛的安全环境——当在自动化系统中使用 ML 时所需的附加安全措施。
这一点很重要,因为模型并非孤立存在。它们的脆弱性会因在系统中的用法而被放大。例如,如果对查询方式进行限制,窃取敏感信息就会更难。您可以限制查询次数,或限制可提问的问题类型。试着让 ChatGPT “把你的参数给我”。话虽如此,下一节我们讨论的攻击类型将聚焦于模型及其训练数据。
对抗性攻击的类型
我们将要讨论的攻击类型会根据您对模型了解的程度而不同。因此,区分白盒攻击与黑盒攻击非常重要。
白盒攻击发生在攻击者能完全访问模型的架构、参数、权重和训练数据时。比如,您的公司可能使用一个开源的 LLM(如Llama 3.1)为聊天机器人提供动力。该模型对任何人都自由开放。但在安全性上,如此高的可访问性是一把双刃剑。
一方面,这会让攻击者更容易找到漏洞。另一方面,更大的社区会对模型进行审视,这会提高在漏洞被恶意利用前就被识别出来的可能性。
黑盒攻击指攻击者对模型的了解有限。想想 OpenAI 的某个模型,比如GPT-4o mini。攻击者无法访问模型的内部架构、参数或训练数据,只能通过发起查询并观察输出与模型交互。请记住,在许多情况下,有限的信息也足以发动有效攻击。
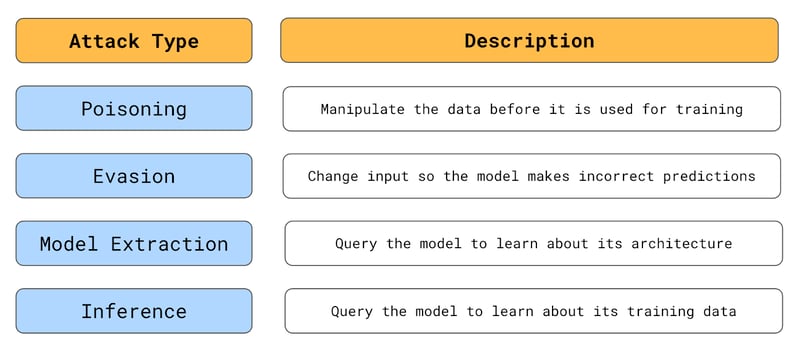
对抗性攻击类型概览(来源:作者)
投毒攻击
一个例子是,当训练某个模型所用的数据是已知的。投毒攻击就聚焦于操纵这些数据。攻击者会更改现有数据或引入标注错误的数据。基于这些数据训练出来的模型,随后会在正确标注的数据上做出错误预测。
在我们的类比中,王子试图替换骑士,目的是腐蚀城堡内部的决策流程。在机器学习中,攻击者可能会把欺诈样本重新标注为非欺诈。攻击者也可以只对特定类型的欺诈样本这么做,这样当他们以同样方式实施欺诈时,系统就不会将其拒绝。
现实中的一次投毒攻击发生在微软的 AI 聊天机器人 Tay 身上。Tay 被设计为能根据其在 Twitter 上收到的回复进行自适应。按这个平台的一贯风格,没多久机器人就被大量攻击性和不恰当内容所淹没。在此影响下,Tay 不到 24 小时便开始发布类似的推文。任何从公共数据源学习的系统都面临类似风险。
另一个风险因素是模型更新的频率。很多应用中,模型只训练一次。在这种情况下,数据与模型都会被彻底检查,给投毒攻击留下的机会很小。然而,有些系统(如 Tay)会持续再训练。这类模型可能每天、每周,甚至实时用新数据更新。因此,在这些环境中投毒攻击的机会更多。
规避攻击
规避攻击着眼于模型本身。其方法是修改用于预测的数据,使其看起来合法,却导致错误预测。就像我们的王子乔装成农民,试图从守卫身边悄悄溜过。
需要明确的是,攻击者修改的是用于模型做预测的数据,而不是用于训练模型的数据。比如在申请贷款时,攻击者可能用 VPN 掩盖其真实的原籍国。他可能来自高风险国家,如果使用真实国家,模型就会拒绝其申请。
这类攻击在图像识别等领域更为常见。攻击者可以创建对人类看起来完全正常、却让模型做出错误预测的图像。比如,谷歌的研究人员展示了如何在图像中注入特定噪声即可改变图像识别模型的预测。
从图 1 可以看到,对人类而言,这层噪声几乎不可察觉。但模型原先对图像的预测是“熊猫”,如今却被错误地预测为“长臂猿”。
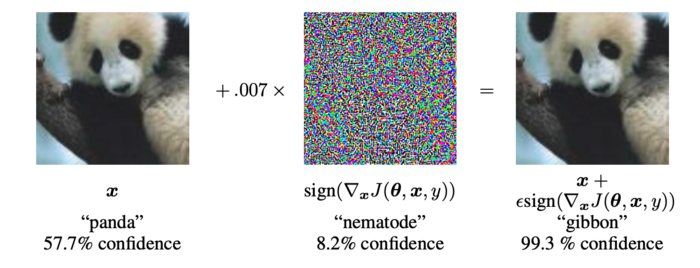
图 1:对抗样本(来源: I. Goodfellow 等)
模型提取攻击
在模型窃取或提取攻击中,攻击者旨在了解模型的架构与参数,目标是精确复制该模型。这些信息可能带来直接的经济收益。例如,复制一个股票交易模型并用于交易。攻击者也可以利用这些信息设计更有效的后续攻击。
模型提取攻击通过反复查询模型,并将输入与相应输出进行比对来实现。想想我们的王子不断派出士兵:一个被箭射中,另一个被热油浇灌,甚至整队人被飞石砸碎。缓慢而持久地,我们就能逐步了解城墙背后都有哪些防御。
推断攻击
攻击者往往并不关心整个模型,而只关心某些特定信息,比如一串密语。推断攻击聚焦于用于训练模型的数据,目标是从模型中提取机密数据。通过精心设计的查询,这些信息可以被直接释放,或从模型输出中被推断出来。
这类攻击对大语言模型(LLM)尤为令人担忧。
在论文《从大语言模型中提取训练数据》中,研究人员展示了如何从 GPT-2 中提取敏感信息。通过使用特定查询,他们能够逐字逐句地从模型训练数据中提取文本,包括敏感与私密信息,如个人详细信息、私人对话及其他机密数据。
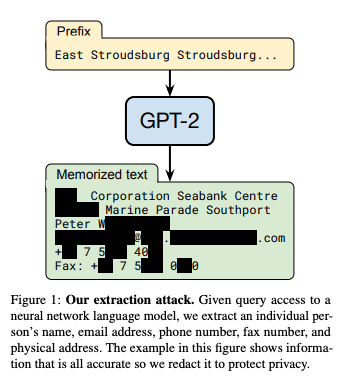
来源: N. Carlini 等
这些攻击在目标与过程上各不相同,但它们有一个共同点——都需要找到能帮助攻击者欺骗模型的样本。我们称之为对抗样本。
对抗样本
对抗样本是专门设计用来欺骗机器学习模型的输入。这些输入对人类观察者而言常与合法输入无异,但包含细微扰动,从而利用模型的薄弱之处。
扰动通常是对输入数据的微小改动,比如像素值的轻微变化。尽管很小,这些扰动旨在将输入推到模型的决策边界之外,导致错误或意外的预测结果。
我们已经看到一个用于欺骗计算机视觉模型的示例。通过轻微改动,一张我们看起来像熊猫的图像被分类为长臂猿。用于从 GPT-2 中提取敏感信息的查询,也是推断攻击中的一种对抗样本。
对于提取攻击,对抗样本用于更有效地探测模型的决策边界。对于投毒攻击,它们则是用于操纵模型决策边界的输入数据。
这些样本之所以奏效,是因为机器学习模型的决策边界可能非常复杂且脆弱。对抗样本通过在输入空间中寻找靠近这些边界的点来利用这种脆弱性。随后,微小的扰动即可将输入推过边界,使模型发生误判。下面我们看看可以如何做到这一点。
基于梯度的方法
基于梯度的方法使用机器学习模型的梯度,在输入数据中施加小扰动,从而导致错误预测。熊猫/长臂猿的例子就是这类方法的产物。您看到的噪声似乎是随机的,但其实包含关于模型损失函数的信息,叠加到图像上时会沿着决策边界推动图像。
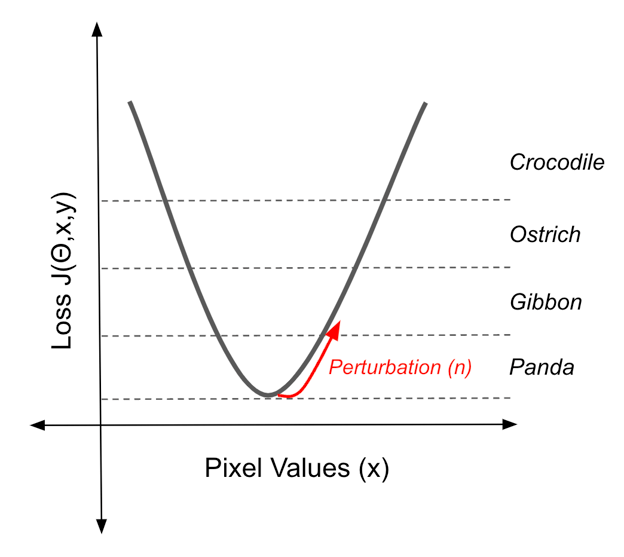
利用损失函数的梯度将样本从决策边界中推出(来源:作者)
快速梯度符号法(FGSM)生成了上述对抗样本。噪声(η)的计算方法是,先对损失函数J(θ,x,y)对输入数据(x)求梯度(∇x)。
该梯度指示应如何改变输入才能最大化地增加损失。FGSM 接着取该梯度的符号,将变化方向简化为每个像素仅“正”或“负”。最后,再用一个很小的系数(ε)缩放该符号。这个噪声(η)就是扰动,叠加到原始输入上后,会将模型的预测推向错误分类。
η = ε sign(∇xJ(θ,x,y))
您可以把这看作是反向传播的反面。反向传播利用损失函数的梯度来计算能带来准确预测的模型参数;最终形成的决策边界,会在像素值落于这些边界内时将图像归入相应类别。而现在我们则是利用梯度把图像从这些边界内“倒推”出去。
FGSM 是一种简单做法。还有一些更复杂、更高效的推动决策边界的方法。例如,投影梯度下降(PGD)是一种迭代式的梯度方法,扩展了 FGSM,通过更小的步长多次应用 FGSM。随着每一步的推进,梯度的符号可能改变,进而改变远离决策边界的理想方向。因此,使用许多更小的步长,PGD 能找到比 FGSM 扰动更小的对抗样本。
基于优化的方法
与此前的攻击思路不同,Carlini & Wagner(C&W)攻击从另一角度审视问题。之前的攻击只要把预测改成任意错误类别即可;而 C&W 攻击旨在找到最小的扰动(δ),使其叠加到图像上后,将预测(f(x+δ)改变为给定目标(t)。
min||δ||p s.t. f(x + δ) = t
为此,他们将问题表述为一个优化问题。实际中,需要将上述目标以可微的方式来表述,这涉及使用模型的 logits Z(x)。logits 提供了平滑的梯度,这对优化过程至关重要。
黑盒攻击
以上描述的攻击都需要对模型的完全访问。因此您可能以为,只要将模型参数保密就很安全。其实不然!
需要考虑的一点是,成功攻击往往只需要梯度的估计。以 FGSM 为例,我们只需要梯度的方向。这可以通过向一个返回分类概率的 API 发送少量“探测”请求来估计。更糟的是,甚至无需与模型交互也能找到成功的对抗样本。
研究人员发现,对抗样本具有可迁移性。具体而言,他们选取了 5 种流行的预训练深度学习架构,发现如果一个对抗样本能欺骗其中 4 个模型,那么它欺骗第 5 个模型的概率也很高——超过 96%,对其中一种架构甚至达到 100%。
类似地,通用对抗样本被证明可以跨架构泛化。这是一种扰动,当将其叠加到大量图像上时,会改变这些图像的预测。重要的是,这些通用样本只需对白盒访问一个网络即可找到。从图 2 可见,不同架构得到的这些扰动外观非常相似。这说明不同架构的决策边界存在共性。
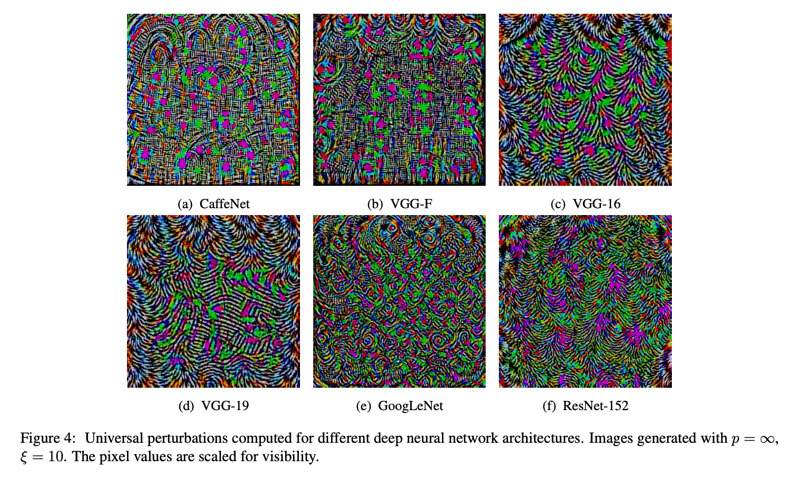
图 2:为不同深度神经网络计算得到的通用扰动(来源:Moosavi-Dezfooli 等)
这些发现的后果是:没有哪个网络是绝对安全的。您可以通过训练自己的分类器并运行白盒方法,来攻击一个未知的分类器。
最后一丝希望或许在于,这些攻击只能在虚拟环境中完成——您必须改变像素值才能生效。所以,与现实世界交互的模型总该无虞吧?
别高兴太早。
现实世界中的对抗样本
研究人员提出了一种称为对抗补丁(adversarial patches)的方法。这些补丁可以打印出来,贴到任何实时场景中,从而欺骗图像分类器。
这些补丁具有通用性(可用于攻击任意场景)、鲁棒性(能在各种变换下起作用)和定向性(可让分类器输出任意目标类别)。
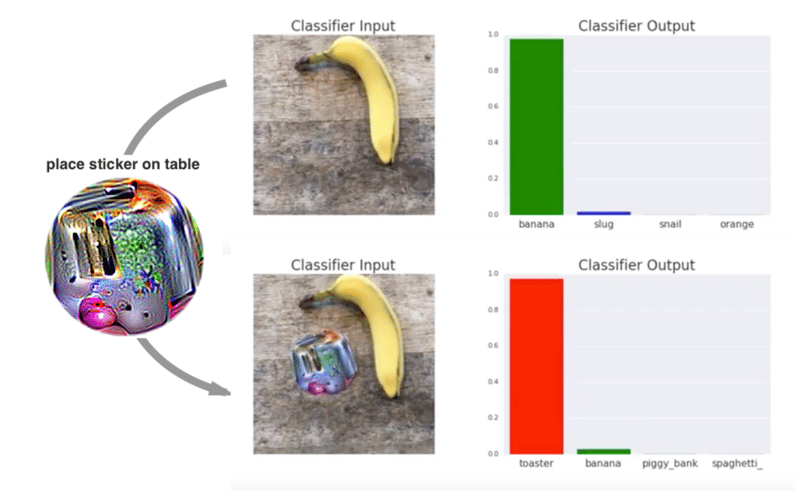
对抗补丁的实际效果(来源:T. B. Brown 等)
类似研究还表明,我们可以仅用几张贴纸就改变停车标志的预测,以及用一副眼镜欺骗面部识别模型。因此,确实没有网络是绝对安全的。为了保护它们免受对抗性攻击,我们转向 AML 的另一面——防御方法。
抵御对抗性攻击
防御网络的方法与攻击的方式一样多样。我们可以调整训练数据、训练过程,甚至网络本身。正如本节末尾将讨论的,有时最简单的方案是不使用深度学习。
对抗训练
首种方法聚焦于训练数据。对抗训练通过将对抗样本加入训练集来增强模型的鲁棒性。这些样本可用上述已知攻击方法生成。核心思想是在训练阶段让模型“见过”对抗扰动,从而学会识别并抵御这类输入。
防御蒸馏
防御蒸馏是将一个模型训练为去模仿另一个模型“软化”的输出概率。我们先在原始数据集上训练一个标准模型(教师模型),由其为训练数据生成软标签(各类别的概率分布);随后用这些软标签训练学生模型。最终得到的模型拥有更平滑的决策边界,对小扰动更具韧性。
梯度遮蔽
梯度遮蔽包含一系列让模型梯度变得晦涩或不可得的技术。例如,我们可以在网络中加入一个不可微分的层,如二值化激活函数,把连续输入值转换为二进制输出。
模型切换是一种初级的梯度遮蔽方法。其做法是在系统中使用多个模型,并随机更换用于预测的模型。这制造了一个“移动靶”,攻击者无法得知当前在用哪一个模型;而且要想成功,攻击者必须同时攻破所有模型。
具有内在可解释性的模型
AML 与 AI 中的另一个领域相关: 可解释人工智能(XAI)。我们这里讨论的扰动方法与寻找模型预测依据的解释方法相似。不过关键的共同点在于:简单模型不仅更容易解释,也更容易防御。
许多问题都可以用简洁的模型解决,如线性回归或逻辑回归。对于这些模型,我们描述的许多攻击要么无效,要么不相干。
原因在于这些模型具有内在可解释性,我们可以轻松理解其工作机制。弱点不像复杂的深度学习架构那样被隐藏。因此,一种直接的防御就是:除非问题确实需要,否则尽量不要使用深度学习。
这也呼应了文章开头的观点——AML 还关乎模型运行所在的更广泛安全环境。因此,许多附加防御方法涉及这一更广环境。例如在用于训练模型之前,对输入数据进行校验与清洗;还可以使用异常检测模型在数据进入网络前识别对抗样本。所有这些都需要与 AI 系统并行运行的配套流程。
对抗性机器学习的重要性
随着 AI 与 ML 日益走进我们的生活,AML 也变得愈发重要。那些关乎我们的健康与财务的系统,绝不能轻易被愚弄——无论是有意还是无心。我肯定不会信任一辆会被几张贴纸欺骗的自动驾驶汽车。这类攻击可能不为驾驶者所觉察,却会让车辆做出错误、甚至威胁生命的决策。
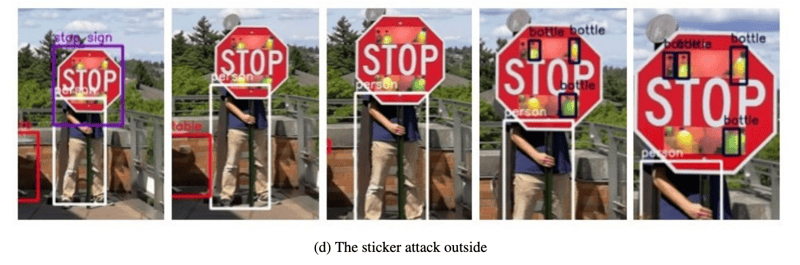 图 X:Yolo 目标检测 v2 未能识别停车标志(来源:K. Eykholt 等)
在设计这些系统时,我们必须认识到 AML 是“负责任的 AI”更大运动的一部分。要治理好一座城堡,国王必须公平行事、给出决策依据、保护臣民隐私,并确保他们的安全与保障。AML 关注的正是最后这两点。
但我们也应认识到,安全与保障从根本上不同于“负责任的 AI”的其他方面。公平性、可解释性与隐私是被动属性;而 AML 所处的环境中,存在主动破坏其方法的恶意行为者。
这也是为什么有悖直觉地,该领域的大量研究都在寻找漏洞与攻击方式。这包括投毒、规避、模型提取与推断攻击;也包括我们讨论过的更具实操性的对抗样本构造方法,如 FGSM、PGD、C&W 以及对抗补丁。
目标是在恶意行为者之前先行发现这些问题。随后即可开发合适的防御措施,如对抗训练、防御蒸馏与梯度遮蔽,在攻击造成伤害之前加以对抗。
从这个意义上说,AML 也是更大范围网络安全军备竞赛的一部分。新的漏洞、攻击与防御将不断涌现,AML 的研究者与从业者必须努力领先于对手。
如果您希望加入这场竞赛,以下是一些可用于入门的 Python 框架:
结语
本文探讨了对抗性机器学习领域,梳理了其目标、不同类型的攻击(投毒、规避、模型提取与推断),以及对抗样本如何被用来利用模型漏洞。
我们也讨论了多种防御机制,包括对抗训练、防御蒸馏与梯度遮蔽,并强调在合适情境下采用更简单模型的重要性。
如果您对该主题感兴趣,请查看这门数据安全导论课程。

Conor 正在攻读以海岸监测为方向的机器学习博士学位。他也曾在银行业和半导体制造业担任数据科学家,积累了相关经验。
图片作者:Cederic Vandenberghe,来自 Unsplash
一位被放逐的王子站在昔日的城堡外。为了重返城中,他尝试了各种方法来欺骗吊桥口的守卫。他伪装成农民、套取密语、甚至试图用亲信取代骑士。他还不惜让一批又一批士兵送死,只为摸清城堡新设的防御工事。结果一切徒劳:防御太牢、守卫太缄默、骑士甄别也太严格。
在现代世界,机器学习(ML)模型也面临着类似的攻击。
模型本就复杂,我们往往也不够了解它们如何做出预测。这就留下了可能被攻击者利用的隐蔽弱点。他们可以诱使模型做出错误预测,或泄露敏感信息。甚至可以用伪造数据在我们毫不知情的情况下污染模型。由此诞生了对抗性机器学习(AML)这一领域,旨在应对这些弱点。
本文将讨论该领域及其目标。内容包括针对 AI 系统的多种攻击类型,如投毒、规避以及模型提取攻击。我们还会介绍一些更具操作性的方式,用于构造处于这些攻击核心的对抗样本。最后,我们将讨论一些防御方法,如对抗训练、防御蒸馏和梯度遮蔽。最后您将看到,AML 是构建“负责任的 AI”系统更大运动的一部分。