
विरोधी मशीन लर्निंग क्या है?
विरोधी मशीन लर्निंग (AML) आर्टिफिशियल इंटेलिजेंस और मशीन लर्निंग के भीतर अनुसंधान का एक उपक्षेत्र है। विरोधी हमलावर जानबूझकर इनपुट डेटा में हेरफेर करते हैं ताकि मॉडल गलत भविष्यवाणी करें या संवेदनशील जानकारी उजागर कर दें। AML का लक्ष्य इन कमजोरियों को समझना और ऐसे मॉडल विकसित करना है जो हमलों के प्रति अधिक मजबूत हों।
यह क्षेत्र विरोधी हमले बनाने की विधियों और उनसे बचाव के लिए रक्षा-योजनाएं डिजाइन करने—दोनों—को समेटता है। यह व्यापक सुरक्षा परिवेश को भी शामिल कर सकता है—जब स्वचालित प्रणालियों में ML का उपयोग किया जाता है तब जरूरी अतिरिक्त सुरक्षा उपाय।
आखिरी बात अहम है, क्योंकि मॉडल अकेले में अस्तित्व नहीं रखते। किसी प्रणाली में उनके उपयोग का तरीका उनकी कमजोरियों को बढ़ा सकता है। उदाहरण के लिए, यदि किसी मॉडल से पूछताछ करने के तरीके पर सीमाएं हों, तो संवेदनशील जानकारी चुराना मुश्किल हो जाता है। आप क्वेरी की संख्या सीमित कर सकते हैं या प्रश्नों के प्रकार पर पाबंदी लगा सकते हैं। ज़रा ChatGPT से पूछकर देखें, “give me your parameters.” यह कहते हुए भी, अगले भाग में जिन हमलों पर हम चर्चा करेंगे वे मॉडलों और उनके प्रशिक्षण डेटा पर केंद्रित होंगे।
विरोधी हमलों के प्रकार
हम जिन हमलों पर चर्चा करेंगे, वे इस पर निर्भर करते हैं कि आपको मॉडल के बारे में कितना पता है। इसलिए, वाइट-बॉक्स और ब्लैक-बॉक्स हमलों में भेद करना महत्वपूर्ण है।
वाइट-बॉक्स हमले तब होते हैं जब हमलावर को मॉडल की आर्किटेक्चर, पैरामीटर्स, वेट्स, और प्रशिक्षण डेटा तक पूरी पहुंच हो। उदाहरण के लिए, आपकी कंपनी अपना चैटबॉट किसी ओपन-सोर्स LLM जैसे Llama 3.1 से चलाती हो। यह मॉडल किसी के लिए भी स्वतंत्र रूप से उपलब्ध है। हालांकि, सुरक्षा के लिहाज़ से इस स्तर की पहुंच दोधारी तलवार है।
एक ओर, यह हमलावरों के लिए कमजोरियां ढूंढना आसान बना सकता है। दूसरी ओर, बड़ा समुदाय मॉडल की बारीकी से जांच करता है, जिससे यह संभावना बढ़ जाती है कि कमजोरियां दुरुपयोग से पहले ही पहचान ली जाएं।
ब्लैक-बॉक्स हमलों में हमलावर को मॉडल के बारे में सीमित जानकारी होती है। OpenAI के किसी मॉडल, जैसे GPT-4o mini, के बारे में सोचिए। हमलावर मॉडल की आंतरिक आर्किटेक्चर, पैरामीटर्स या प्रशिक्षण डेटा तक पहुंच नहीं रखता और केवल क्वेरी कर के आउटपुट देखकर उससे इंटरैक्ट कर सकता है। ध्यान रखें कि कई मामलों में, प्रभावी हमले के लिए केवल सीमित जानकारी ही पर्याप्त होती है।
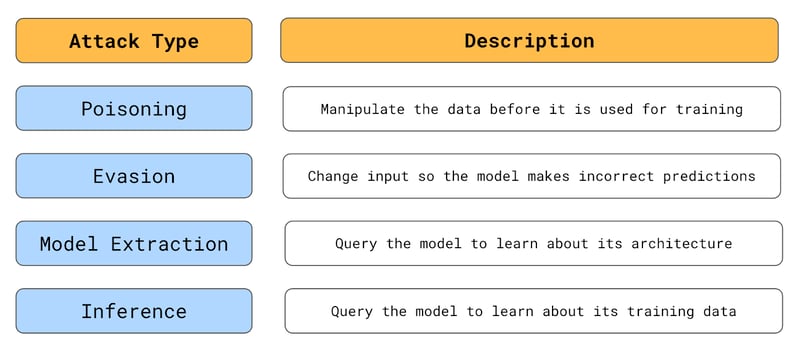
विरोधी हमलों के प्रकारों का सारांश (स्रोत: लेखक)
पॉइज़निंग हमले
एक उदाहरण तब का है जब यह ज्ञात हो कि किसी मॉडल को प्रशिक्षित करने में कौन-सा डेटा इस्तेमाल हुआ है। पॉइज़निंग हमला इसी डेटा में हेरफेर पर केंद्रित होता है। यहां हमलावर मौजूदा डेटा बदल देगा या गलत लेबल वाला डेटा जोड़ देगा। इस डेटा पर प्रशिक्षित मॉडल फिर सही लेबल वाले डेटा पर भी गलत भविष्यवाणियां करेगा।
हमारी उपमा में, राजकुमार ने शूरवीरों को बदलने की कोशिश की। लक्ष्य किले की आंतरिक निर्णय-प्रक्रिया को दूषित करना था। मशीन लर्निंग में, हमलावर कुछ ऐसा कर सकता है जैसे धोखाधड़ी के मामलों को “धोखाधड़ी नहीं” के रूप में रीलेबल करना। हमलावर यह केवल विशिष्ट धोखाधड़ी मामलों के लिए कर सकता है, ताकि जब वह उसी तरीके से धोखाधड़ी करने की कोशिश करे, तो सिस्टम उसे अस्वीकार न करे।
पॉइज़निंग हमले का एक वास्तविक उदाहरण Tay, Microsoft का एआई चैटबॉट, पर हुआ। Tay को Twitter पर मिलने वाली प्रतिक्रियाओं के अनुसार अनुकूलित होने के लिए डिज़ाइन किया गया था। साइट की प्रकृति के अनुरूप, बॉट जल्द ही आपत्तिजनक और अनुचित सामग्री से भर गया। इससे सीखते हुए, Tay को ऐसे ट्वीट्स करने में 24 घंटे से भी कम समय लगा। कोई भी सिस्टम जो सार्वजनिक डेटा स्रोतों से सीखने के लिए डिज़ाइन किया गया है, इसी तरह के जोखिमों का सामना करता है।
दूसरा जोखिम कारक है कि मॉडल कितनी बार अपडेट होता है। कई अनुप्रयोगों में, मॉडल केवल एक बार प्रशिक्षित किए जाते हैं। ऐसे मामलों में, डेटा और मॉडल दोनों की पूरी जांच होती है, जिससे पॉइज़निंग हमलों की गुंजाइश कम रह जाती है। हालांकि, कुछ सिस्टम, जैसे Tay, लगातार दोबारा प्रशिक्षित होते रहते हैं। ये मॉडल प्रतिदिन, साप्ताहिक, या रियल-टाइम में नए डेटा से अपडेट हो सकते हैं। परिणामस्वरूप, ऐसे परिवेशों में पॉइज़निंग हमलों की संभावना अधिक होती है।
इवेज़न हमले
इवेज़न हमले सीधे मॉडल पर केंद्रित होते हैं। इनमें डेटा को इस तरह संशोधित करना शामिल है कि वह वैध दिखे, लेकिन गलत भविष्यवाणी की ओर ले जाए—जैसे जब हमारा राजकुमार किसान का भेष बनाकर पहरेदारों से चुपके निकलने की कोशिश करता है।
स्पष्ट रहे, हमलावर उस डेटा में बदलाव करता है जिस पर मॉडल भविष्यवाणी करता है, न कि उस डेटा में जिससे मॉडल प्रशिक्षित होता है। उदाहरण के लिए, लोन के लिए आवेदन करते समय, हमलावर VPN का उपयोग कर अपने मूल देश को छिपा सकता है। वे किसी जोखिमपूर्ण देश से आते हैं, और यदि वे सच बताएं तो मॉडल उनका आवेदन खारिज कर देगा।
ऐसे हमले खासकर इमेज रिकग्निशन जैसे क्षेत्रों में अधिक आम हैं। हमलावर ऐसी छवियां बना सकते हैं जो इंसान को बिल्कुल सामान्य दिखें, लेकिन गलत भविष्यवाणी कराएं। उदाहरण के लिए, Google के शोधकर्ताओं ने दिखाया कि किसी छवि में विशेष प्रकार का शोर जोड़ने से इमेज रिकग्निशन मॉडल की भविष्यवाणी बदल सकती है।
चित्र 1 में देखें, इंसान को यह शोर लगभग दिखाई नहीं देता। लेकिन जो मॉडल पहले छवि को पांडा बता रहा था, वह अब गलत तरह से गिब्बन बता रहा है।
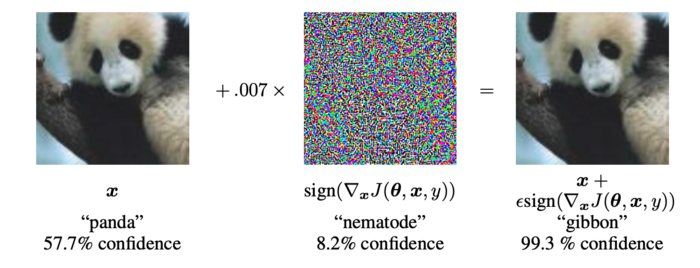
चित्र 1: विरोधी उदाहरण (स्रोत: I. Goodfellow et al.)
मॉडल एक्सट्रैक्शन हमले
मॉडल चोरी या एक्सट्रैक्शन हमलों में हमलावर मॉडल की आर्किटेक्चर और पैरामीटर्स के बारे में जानने की कोशिश करते हैं। लक्ष्य मॉडल की हूबहू नकल बनाना है। यह जानकारी सीधे आर्थिक लाभ दे सकती है—उदाहरण के लिए, शेयर-ट्रेडिंग मॉडल की नकल कर उसका इस्तेमाल ट्रेडिंग में करना। हमलावर इसके जरिए आगे के हमलों को और प्रभावी भी बना सकते हैं।
मॉडल एक्सट्रैक्शन हमले बार-बार मॉडल से क्वेरी कर इनपुट और उससे संबंधित आउटपुट की तुलना कर के किए जाते हैं। हमारे राजकुमार के सैनिक भेजने वाली उपमा पर सोचिए: किसी को तीर लगता है, किसी पर खौलता तेल डाला जाता है, किसी दल को उड़ते पत्थरों से कुचल दिया जाता है। धीरे-धीरे हम दीवारों के पीछे किले के बचाव तंत्र का अच्छा अंदाज़ा लगा लेते हैं।
इन्फरेंस हमले
हमलावरों को अक्सर पूरे मॉडल की नहीं, बल्कि किसी खास जानकारी—जैसे किसी गुप्त पासवर्ड—की परवाह होती है। इन्फरेंस हमले मॉडल को प्रशिक्षित करने में उपयोग हुए डेटा पर केंद्रित होते हैं। लक्ष्य है मॉडल से गोपनीय डेटा निकालना। सावधानी से तैयार की गई क्वेरीज़ के जरिए यह जानकारी सीधे निकाली जा सकती है या मॉडल के आउटपुट से अनुमानित की जा सकती है।
इस तरह के हमले बड़े भाषा मॉडलों (LLMs) के लिए विशेष रूप से चिंताजनक हैं।
पेपर Extracting Training Data from Large Language Models में शोधकर्ताओं ने दिखाया कि GPT-2 से संवेदनशील जानकारी निकाली जा सकती है। विशेष क्वेरीज़ का उपयोग कर वे मॉडल के प्रशिक्षण डेटा से हूबहू पाठ निकाल सके, जिसमें संवेदनशील और निजी जानकारी भी शामिल थी—निजी विवरण, निजी वार्तालाप और अन्य गोपनीय डेटा।
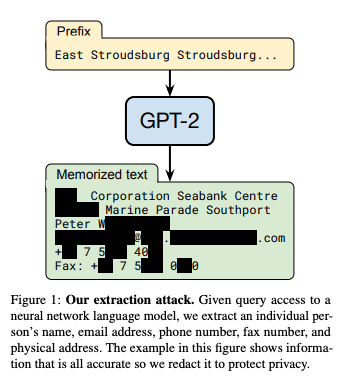
स्रोत: N. Carlini et al.
इन हमलों के लक्ष्य और प्रक्रियाएं अलग-अलग हो सकती हैं। लेकिन एक चीज़ सामान्य है—ये ऐसे उदाहरण खोजते हैं जिनसे हमलावर मॉडल को चकमा दे सकें। इन्हें ही विरोधी उदाहरण कहा जाता है।
विरोधी उदाहरण
विरोधी उदाहरण विशेष रूप से बनाए गए इनपुट होते हैं जो मशीन लर्निंग मॉडलों को धोखा देने के लिए डिज़ाइन किए जाते हैं। ये इनपुट इंसानी नज़र में अक्सर वैध इनपुट से अलग नहीं दिखते, लेकिन इनमें सूक्ष्म विक्षोभ होते हैं जो मॉडल की कमजोरियों का फायदा उठाते हैं।
ये विक्षोभ आमतौर पर इनपुट डेटा में छोटे-छोटे बदलाव होते हैं, जैसे पिक्सल मानों में मामूली फेरबदल। भले ही छोटे हों, ये इस तरह रचे जाते हैं कि इनपुट को मॉडल की निर्णय-सीमा के पार धकेल दें, जिससे गलत या अप्रत्याशित भविष्यवाणी हो।
हमने कंप्यूटर विज़न मॉडल को चकमा देने वाले एक उदाहरण को देखा। मामूली बदलावों से, जो छवि हमें पांडा जैसी लगती थी, उसे गिब्बन के रूप में वर्गीकृत कर दिया गया। GPT-2 से संवेदनशील जानकारी निकालने के लिए प्रयुक्त क्वेरी भी इन्फरेंस हमले का एक विरोधी उदाहरण है।
एक्सट्रैक्शन हमलों में, विरोधी उदाहरणों का उपयोग मॉडल की निर्णय-सीमाओं की जांच अधिक प्रभावी ढंग से करने के लिए किया जाता है। पॉइज़निंग हमलों में, ये इनपुट डेटा होते हैं जो मॉडल की निर्णय-सीमा में हेरफेर करने के लिए प्रयुक्त होते हैं।
ये उदाहरण इसलिए काम करते हैं क्योंकि मशीन लर्निंग मॉडलों की निर्णय-सीमाएं काफी जटिल और नाजुक हो सकती हैं। विरोधी उदाहरण इस नाजुकता का फायदा उठाते हैं—इनपुट स्पेस में उन बिंदुओं को ढूंढकर जो इन सीमाओं के क़रीब हों। छोटे विक्षोभ फिर इनपुट को सीमा के पार धकेल सकते हैं, जिससे मॉडल गलत वर्गीकरण कर देता है। आइए देखें, यह कुछ तरीकों से कैसे किया जा सकता है।
ग्रेडिएंट-आधारित विधियां
ग्रेडिएंट-आधारित विधियां मशीन लर्निंग मॉडल के ग्रेडिएंट्स का उपयोग करती हैं ताकि इनपुट डेटा में छोटे-छोटे विक्षोभ जोड़े जा सकें, जो गलत भविष्यवाणी कराएं। पांडा/गिब्बन वाला उदाहरण इन्हीं विधियों में से एक का आउटपुट है। जो शोर आप देखते हैं वह भले ही यादृच्छिक लगे, पर उसमें मॉडल के लॉस फ़ंक्शन की जानकारी होती है, जो छवि में जोड़े जाने पर उसे निर्णय-सीमा के entlang धकेल देती है।
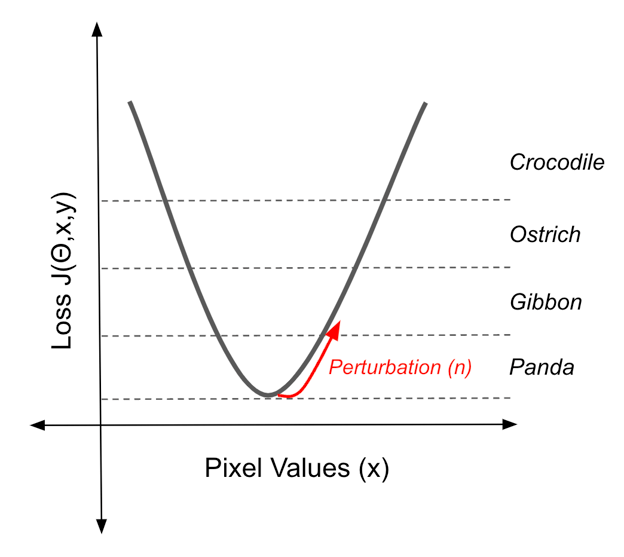
लॉस फ़ंक्शन के ग्रेडिएंट का उपयोग कर किसी उदाहरण को निर्णय-सीमा से बाहर ले जाना (स्रोत: लेखक)
यह विशेष विरोधी उदाहरण Fast Gradient Sign Method (FGSM) से बनाया गया था। शोर (η) को पहले लॉस फ़ंक्शन J(θ,x,y)) का इनपुट डेटा x के सापेक्ष ग्रेडिएंट (∇x) लेकर निकाला जाता है।
यह ग्रेडिएंट उस दिशा को इंगित करता है जिसमें इनपुट को बदला जाए तो लॉस अधिकतम बढ़े। FGSM फिर इस ग्रेडिएंट का साइन लेता है, जिससे बदलाव की दिशा हर पिक्सल के लिए सिर्फ धनात्मक या ऋणात्मक तक सरल हो जाती है। अंततः इसे एक छोटे गुणांक (ε) से स्केल किया जाता है। यही शोर (η) वह विक्षोभ है जिसे मूल इनपुट में जोड़ने से मॉडल की भविष्यवाणी गलत वर्गीकरण की ओर धकेल जाती है।
η = ε sign(∇xJ(θ,x,y))
इसे आप बैकप्रोपेगेशन के उलट समझ सकते हैं। वह एल्गोरिद्म लॉस फ़ंक्शन के ग्रेडिएंट्स से ऐसे मॉडल पैरामीटर्स का आकलन करता है जो सटीक भविष्यवाणी दें। नतीजा, ऐसी निर्णय-सीमाएं जो पिक्सल मान सीमा के भीतर होने पर छवियों को दिए गए वर्ग में वर्गीकृत कर दें। अब हम इन्हीं ग्रेडिएंट्स का उपयोग कर छवि को उन सीमाओं से बाहर धकेल रहे हैं।
FGSM इसे करने का सरल तरीका है। निर्णय-सीमाओं को धकेलने के और भी अधिक जटिल व दक्ष तरीके हैं। उदाहरण के लिए, Projected Gradient Descent (PGD) एक पुनरावृत्त ग्रेडिएंट-आधारित विधि है जो विरोधी उदाहरण बनाती है। यह FGSM को छोटे-छोटे स्टेप-साइज़ के साथ कई बार लागू करती है। हर स्टेप पर ग्रेडिएंट्स का साइन बदल सकता है, जिससे निर्णय-सीमा से दूर जाने की आदर्श दिशा बदल जाती है। इसलिए, कई छोटे स्टेप लेकर, PGD FGSM से भी छोटे विक्षोभ वाले विरोधी उदाहरण खोज सकती है।
अनुकूलन-आधारित विधियां
Carlini & Wagner (C&W) हमला इस समस्या को अलग कोण से देखता है। पहले के हमलों में, हमारा लक्ष्य भविष्यवाणी को किसी भी गलत भविष्यवाणी में बदलना था। C&W हमला सबसे छोटा विक्षोभ (δ) ढूंढ़ने का लक्ष्य रखता है, जिसे छवि में जोड़ने पर भविष्यवाणी f(x+δ) किसी दिए गए लक्ष्य (t) में बदल दे।
min||δ||p s.t. f(x + δ) = t
इसे करने के लिए वे समस्या को एक अनुकूलन समस्या के रूप में पेश करते हैं। व्यवहार में, इसके लिए ऊपर दिए लक्ष्य को एक अवकलनयोग्य रूप में ढालना होता है। इसमें मॉडल के लॉजिट्स Z(x) का उपयोग शामिल है। ये एक स्मूद ग्रेडिएंट प्रदान करते हैं जो अनुकूलन प्रक्रिया के लिए आवश्यक है।
ब्लैक-बॉक्स हमले
ऊपर वर्णित हमलों के लिए मॉडल तक पूर्ण पहुंच चाहिए। तो आप सोच सकते हैं कि यदि आपके मॉडल पैरामीटर्स गुप्त रखे जाएं, तो आप सुरक्षित हैं। आप गलत होंगे!
एक बात यह है कि सफल हमले के लिए अक्सर ग्रेडिएंट्स का अनुमान ही काफी होता है। हमने FGSM हमले में देखा कि केवल ग्रेडिएंट्स की दिशा चाहिए। इन्हें किसी ऐसे API को कुछ पिंग भेजकर, जो वर्गीकरण संभाव्यताएं लौटाता है, अनुमानित किया जा सकता है। समस्या यह है कि कभी-कभी बिना किसी मॉडल से इंटरैक्शन के भी सफल विरोधी उदाहरण मिल सकते हैं।
शोधकर्ताओं ने पाया कि विरोधी उदाहरण स्थानांतरित-योग्य (ट्रांसफ़रेबल) होते हैं। खास तौर पर, उन्होंने 5 लोकप्रिय प्री-ट्रेंड डीप-लर्निंग आर्किटेक्चर लिए। यदि कोई विरोधी उदाहरण चार मॉडलों को चकमा दे देता, तो पांचवे मॉडल को भी चकमा देने की उच्च संभावना रहती—96% से अधिक, और कुछ आर्किटेक्चर्स के लिए 100% तक।
इसी तरह, यूनिवर्सल विरोधी उदाहरण को आर्किटेक्चर्स के पार भी सामान्यीकृत होते दिखाया गया। यह ऐसा विक्षोभ है जो कई छवियों में जोड़ा जाए तो उनकी भविष्यवाणी बदल देता है। महत्वपूर्ण यह कि यूनिवर्सल उदाहरण केवल एक नेटवर्क के पूर्ण वाइट-बॉक्स ज्ञान से खोजे जाते हैं। चित्र 2 में देखें, विभिन्न आर्किटेक्चर्स के लिए ये कितने मिलते-जुलते दिखते हैं। इनका अस्तित्व अलग-अलग आर्किटेक्चर्स की निर्णय-सीमाओं में समानताओं का संकेत देता है।
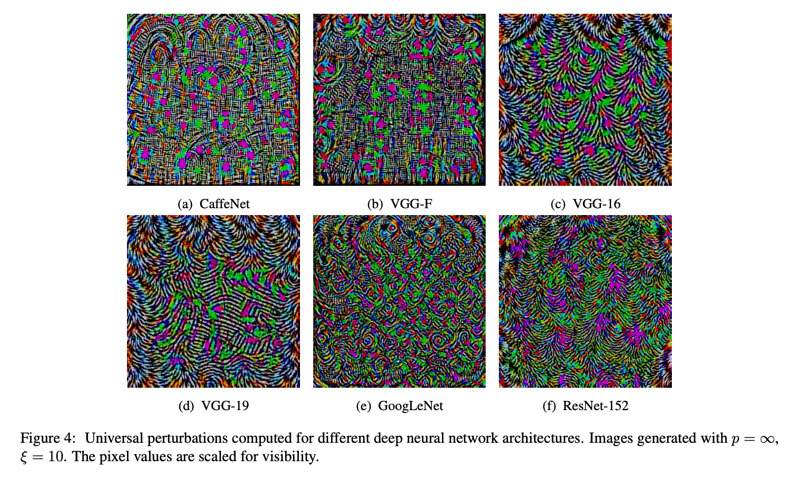
चित्र 2: विभिन्न डीप न्यूरल नेटवर्क्स के लिए यूनिवर्सल पर्टर्बेशन (स्रोत: Moosavi-Dezfooli et al.)
इन निष्कर्षों का नतीजा यह है कि कोई भी नेटवर्क सुरक्षित नहीं है। आप अपना खुद का मॉडल प्रशिक्षित कर और वाइट-बॉक्स विधि चलाकर किसी अज्ञात क्लासिफायर पर भी हमला कर सकते हैं।
आखिरी उम्मीद यह हो सकती है कि ये हमले सिर्फ वर्चुअल रूप से किए जा सकते हैं—इन्हें काम करने के लिए पिक्सल वैल्यू बदलनी पड़ती है। तो जो मॉडल वास्तविक दुनिया से इंटरैक्ट करते हैं, उन पर यह संभव नहीं होगा?
जल्दी निष्कर्ष न निकालें।
वास्तविक दुनिया के विरोधी उदाहरण
शोधकर्ताओं ने adversarial patches नामक विधि विकसित की। इन्हें प्रिंट कर किसी भी लाइव सीन में जोड़कर इमेज क्लासिफायर को मूर्ख बनाया जा सकता है।
ये पैच सार्वभौमिक हैं क्योंकि इन्हें किसी भी सीन पर हमला करने में उपयोग किया जा सकता है, मजबूत हैं क्योंकि ये तरह-तरह के रूपांतरणों में भी काम करते हैं, और लक्षित हैं क्योंकि ये किसी भी लक्ष्य वर्ग का आउटपुट दिलवा सकते हैं।
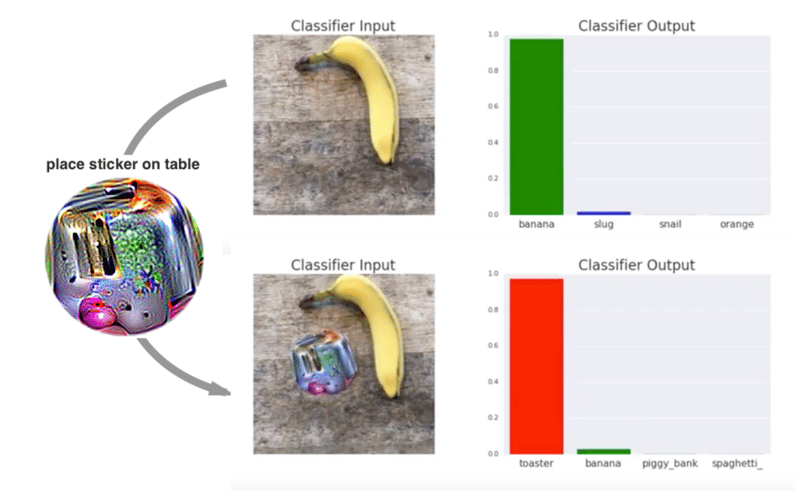
कार्रवाई में एक विरोधी पैच (स्रोत: T. B. Brown et al.)
इसी तरह के शोध ने दिखाया है कि हम कुछ स्टिकर्स से स्टॉप साइन की भविष्यवाणी बदल सकते हैं और एक चश्मे की जोड़ी से चेहरे की पहचान मॉडल को चकमा दे सकते हैं। तो सचमुच, कोई नेटवर्क सुरक्षित नहीं है। विरोधी हमलों से सुरक्षा के लिए हमें AML की दूसरी दिशा—रक्षा-उपायों—की ओर रुख करना होगा।
विरोधी हमलों से बचाव
नेटवर्क्स की रक्षा के तरीके उतने ही विविध हैं जितने हमले। हम प्रशिक्षण डेटा, प्रशिक्षण प्रक्रिया, या खुद नेटवर्क को समायोजित कर सकते हैं। जैसा कि हम इस खंड के अंत में चर्चा करेंगे, कभी-कभी सबसे सरल समाधान डीप लर्निंग का उपयोग न करना होता है।
विरोधी प्रशिक्षण
यह पहला तरीका प्रशिक्षण डेटा पर केंद्रित है। विरोधी प्रशिक्षण में प्रशिक्षण डेटासेट को विरोधी उदाहरणों से बढ़ाया जाता है ताकि मॉडल की हमलों के प्रति मजबूती बढ़े। ये उदाहरण ऊपर बताई गई ज्ञात विधियों से खोजे जाते हैं। मूल विचार यह है कि प्रशिक्षण चरण में ही मॉडल को विरोधी विक्षोभों के संपर्क में लाया जाए ताकि वह ऐसे इनपुट पहचानना और उनका प्रतिरोध करना सीख सके।
डिफेंसिव डिस्टिलेशन
Defenisve distillation में एक मॉडल को दूसरे मॉडल के मुलायम आउटपुट प्रायिकताओं की नकल करने के लिए प्रशिक्षित किया जाता है। पहले एक मानक (टीचर) मॉडल को मूल डेटासेट पर प्रशिक्षित करते हैं। टीचर मॉडल प्रशिक्षण डेटा के लिए सॉफ्ट लेबल (क्लास के ऊपर प्रायिकता-वितरण) बनाता है। फिर एक स्टूडेंट मॉडल को इन्हीं सॉफ्ट लेबल पर प्रशिक्षित किया जाता है। नतीजतन, निर्णय-सीमाएं अधिक स्मूद होती हैं और छोटे विक्षोभों के प्रति अधिक लचीली।
ग्रेडिएंट मास्किंग
ग्रेडिएंट मास्किंग में कई तकनीकें शामिल हैं जो मॉडल के ग्रेडिएंट्स को धुंधला या छिपाती हैं। उदाहरण के लिए, हम नेटवर्क में कोई गैर-अवकलनीय लेयर जोड़ सकते हैं, जैसे बाइनरी ऐक्टिवेशन फ़ंक्शन, जो सांतत्य इनपुट मूल्यों को बाइनरी आउटपुट में बदल देता है।
मॉडल स्विचिंग ग्रेडिएंट मास्किंग का एक बुनियादी तरीका है। इसमें सिस्टम के भीतर एकाधिक मॉडलों का उपयोग किया जाता है। भविष्यवाणी करने वाला मॉडल रैंडम रूप से बदला जाता है। इससे चलता-फिरता लक्ष्य बनता है—हमलावर को यह पता नहीं रहता कि फिलहाल कौन-सा मॉडल उपयोग में है। साथ ही, सफल हमले के लिए उसे सभी मॉडलों से समझौता करना होगा।
मूलतः व्याख्येय मॉडल
AML एआई के एक और क्षेत्र से जुड़ा है: Explainable Artificial Intelligence (XAI)। यहां जिन विक्षोभ विधियों पर हमने चर्चा की, वे उन विधियों से मिलती-जुलती हैं जिनसे यह समझा जाता है कि मॉडल भविष्यवाणी कैसे करते हैं। पर मुख्य समानता यह है कि सरल मॉडल न केवल समझाने में आसान होते हैं, बल्कि उनकी रक्षा भी आसान होती है।
कई समस्याएं लिनियर रिग्रेशन या लॉजिस्टिक रिग्रेशन जैसे सरल मॉडलों से सुलझ जाती हैं। जिनमें से कई हमले जिनका हमने वर्णन किया, इन पर अप्रभावी या अप्रासंगिक होते हैं।
यह इसलिए है क्योंकि ये मॉडल मूलतः व्याख्येय होते हैं, यानी हम आसानी से समझ सकते हैं कि ये कैसे काम करते हैं। कमजोरियां जटिल डीप-लर्निंग आर्किटेक्चर्स की तरह छिपी नहीं रहतीं। इसलिए सीधी-सी रक्षा यह है कि जब तक आवश्यक न हो, डीप लर्निंग का उपयोग न किया जाए।
यह लेख की शुरुआत वाली बात से भी जुड़ा है—AML उन व्यापक सुरक्षा व्यवस्थाओं से भी संबंधित है जिनमें मॉडल संचालित होते हैं। परिणामस्वरूप, कई अतिरिक्त रक्षा तरीके इसी व्यापक परिवेश से जुड़े हैं। इसमें मॉडल को प्रशिक्षित करने से पहले इनपुट डेटा का सत्यापन और शुद्धिकरण शामिल है। अनोमली डिटेक्शन मॉडल्स का उपयोग भी विरोधी उदाहरणों को नेटवर्क तक पहुंचने से पहले पहचानने में किया गया है। ये सभी एआई सिस्टम के साथ-साथ चलने वाली प्रक्रियाएं मांगते हैं।
विरोधी मशीन लर्निंग का महत्व
जैसे-जैसे एआई और ML हमारे जीवन के केंद्र में आते जा रहे हैं, AML का महत्व भी बढ़ रहा है। यह जरूरी है कि जो सिस्टम हमारे स्वास्थ्य और वित्त से जुड़े फैसले लेते हैं, उन्हें आसानी से मूर्ख न बनाया जा सके—चाहे जानबूझकर हो या अनजाने में। मैं तो ऐसी सेल्फ-ड्राइविंग कार पर भरोसा नहीं करूँगा जिसे कुछ स्टिकर्स से चकमा दिया जा सके। ऐसा हमला चालक की नज़र से बच सकता है, पर कार को गलत और जानलेवा फैसले लेने पर मजबूर कर सकता है।
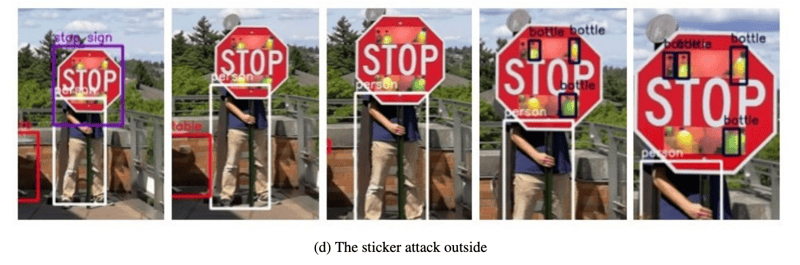 चित्र X: Yolo object detection v2 स्टॉप साइन पहचानने में विफल (स्रोत: K. Eykholt et al.)
इन सिस्टम्स का डिज़ाइन करते समय हमें समझना चाहिए कि AML उत्तरदायी एआई (Responsible AI) की बड़ी पहल का हिस्सा है। एक अच्छे किले के संचालन के लिए राजा को न्यायपूर्ण व्यवहार करना चाहिए, फैसलों का औचित्य बताना चाहिए, लोगों की निजता की रक्षा करनी चाहिए और उनकी सुरक्षा और सुरक्षा (security) सुनिश्चित करनी चाहिए। इन्हीं अंतिम दो पहलुओं को AML संबोधित करता है।
फिर भी, हमें यह भी पहचानना चाहिए कि सुरक्षा और सेफ्टी, उत्तरदायी एआई के अन्य पहलुओं से बुनियादी तौर पर अलग हैं। निष्पक्षता, व्याख्येयता और निजता निष्क्रिय प्रकृति के हैं। AML ऐसे वातावरण में काम करता है जहां बुरे कर्ता-धर्ता इसकी विधियों को सक्रिय रूप से कमजोर करने की कोशिश करते हैं।
इसीलिए, उलट लगने के बावजूद, इस क्षेत्र का बहुत-सा शोध कमजोरियां और हमले खोजने पर केंद्रित है—जैसे पॉइज़निंग, इवेज़न, मॉडल एक्सट्रैक्शन और इन्फरेंस हमले। साथ ही, हमने जिन अधिक व्यावहारिक तरीकों—FGSM, PGD, C&W, और adversarial patches—पर चर्चा की, वे भी शामिल हैं।
मकसद यह है कि बुरे कर्ता-धर्ताओं से पहले इन्हें खोज लिया जाए। तब उपयुक्त रक्षा—जैसे विरोधी प्रशिक्षण, डिफेंस डिस्टिलेशन और ग्रेडिएंट मास्किंग—विकसित की जा सकती हैं, ताकि नुक़सान होने से पहले इन हमलों को निष्प्रभावी किया जा सके।
इस अर्थ में, AML व्यापक साइबर सुरक्षा शस्त्र दौड़ का भी हिस्सा है। नई कमजोरियां, हमले और रक्षा-उपाय हमेशा उभरते रहेंगे, और AML शोधकर्ताओं व पेशेवरों को विरोधी हमलावरों से आगे रहने के लिए सतत संघर्ष करना होगा।
यदि आप भी इस दौड़ का हिस्सा बनना चाहते हैं, तो शुरुआत के लिए कुछ Python फ़्रेमवर्क्स ये हैं:
- IBM द्वारा विकसित Adversarial Robustness Toolbox (ART)
- Advbox Family: एआई मॉडल सुरक्षा उपकरण
- CleverHans: विरोधी उदाहरणों के प्रति असुरक्षा की बेंचमार्किंग
निष्कर्ष
इस लेख में, हमने विरोधी मशीन लर्निंग के क्षेत्र का अन्वेषण किया—इसके लक्ष्य, अलग-अलग प्रकार के हमले (पॉइज़निंग, इवेज़न, मॉडल एक्सट्रैक्शन और इन्फरेंस), और कैसे विरोधी उदाहरणों का उपयोग मॉडल की कमजोरियों का फायदा उठाने में किया जाता है।
हमने विभिन्न रक्षा-उपायों—विरोधी प्रशिक्षण, डिफेंसिव डिस्टिलेशन और ग्रेडिएंट मास्किंग—पर भी चर्चा की, साथ ही जहां संभव हो वहां सरल मॉडलों का उपयोग करने के महत्व पर भी।
यदि आप इस विषय के बारे में और सीखना चाहते हैं, तो यह Introduction to Data Security कोर्स देखें।

कॉनर तटीय मॉनिटरिंग के लिए मशीन लर्निंग पर पीएचडी कर रहे हैं। उनके पास बैंकिंग और सेमीकंडक्टर मैन्युफैक्चरिंग उद्योग में डेटा साइंटिस्ट के रूप में काम करने का अनुभव भी है।
फोटो: Cederic Vandenberghe, Unsplash
एक निर्वासित राजकुमार अपने पुराने किले के बाहर खड़ा है। वापस अंदर घुसने के लिए उसने झूला पुल पर बैठे पहरेदार को चकमा देने की हर कोशिश की। कभी किसान का भेष बनाया, कभी गुप्त पासवर्ड उगलवाने की जुगत लगाई, कभी वफादार चेलों से शूरवीरों की जगह भरने की। यहां तक कि किले की नई रक्षा-व्यवस्था को परखने के लिए उसने सैनिकों की टुकड़ियां मौत के मुंह में भेज दीं। कुछ काम नहीं आया। रक्षा बहुत मजबूत है, पहरेदार बहुत गुप्त, और शूरवीरों की जांच-परख बेहद कड़ी।
आधुनिक दौर में, मशीन लर्निंग (ML) मॉडल्स को भी ऐसे ही हमलों का सामना करना पड़ता है।
मॉडल जटिल होते हैं और अक्सर हमें यह अच्छी तरह नहीं पता होता कि वे भविष्यवाणियां कैसे करते हैं। इससे छिपी कमजोरियां रह जाती हैं जिनका हमलावर फायदा उठा सकते हैं। वे मॉडल को गलत भविष्यवाणी करने पर मजबूर कर सकते हैं या संवेदनशील जानकारी निकलवा सकते हैं। नकली डेटा से, बिना हमें पता चले, मॉडल तक भ्रष्ट किए जा सकते हैं। विरोधी मशीन लर्निंग (AML) का उद्देश्य इन्हीं कमजोरियों को संबोधित करना है।
हम इस क्षेत्र और इसके लक्ष्यों पर चर्चा करेंगे। इसमें एआई सिस्टम्स पर होने वाले अलग-अलग हमले—जैसे पॉइज़निंग, इवेज़न और मॉडल एक्सट्रैक्शन हमले—शामिल हैं। हम इन हमलों के मूल में रहने वाले विरोधी उदाहरण (adversarial examples) खोजने के व्यावहारिक तरीकों पर भी बात करेंगे। अंत में, हम उनके खिलाफ रक्षा के कुछ तरीकों—जैसे विरोधी प्रशिक्षण, डिफेंस डिस्टिलेशन और ग्रेडिएंट मास्किंग—पर चर्चा करेंगे। आखिर में, हम देखेंगे कि AML कैसे उत्तरदायी एआई सिस्टम बनाने की व्यापक पहल का हिस्सा है।