Kurs
Vorverarbeitung für Machine Learning in Python
4 Std.
68.3K
Foto von Cederic Vandenberghe auf Unsplash
Ein verbannter Prinz steht vor seinem ehemaligen Schloss. Um wieder hineinzukommen, hat er alles versucht, um den Wächter an der Zugbrücke auszutricksen. Er verkleidete sich als Bauer, versuchte, das geheime Passwort zu ergattern, und wollte die Ritter durch seine treuen Kumpane ersetzen. Er schickte sogar Scharen von Soldaten in den Tod, nur um die neuen Verteidigungsanlagen des Schlosses zu verstehen. Nichts hat funktioniert. Die Verteidigung ist zu stark, die Wachen zu verschwiegen, und die Prüfung der Ritter zu gründlich.
Moderne Machine-Learning-Modelle (ML) sind ähnlichen Angriffen ausgesetzt.
Modelle sind komplex, und oft verstehen wir nur unzureichend, wie sie Vorhersagen treffen. Das lässt verborgene Schwachstellen, die Angreifer ausnutzen können. Sie könnten das Modell zu falschen Vorhersagen verleiten oder sensible Informationen preisgeben. Sogar gefälschte Daten könnten Modelle unbemerkt korrumpieren. Das Feld des Adversarial Machine Learning (AML) will diese Schwachstellen adressieren.
Wir schauen uns dieses Feld und seine Ziele an. Dazu zählen verschiedene Angriffsarten auf KI-Systeme wie Poisoning, Evasion sowie Model-Extraction- und Inference-Angriffe. Außerdem betrachten wir praktische Wege, adversarielle Beispiele zu erzeugen, die vielen dieser Angriffe zugrunde liegen. Abschließend gehen wir auf Abwehrmethoden wie adversariales Training, Defensive Distillation und Gradient Masking ein. Am Ende wird klar, wie AML Teil einer größeren Bewegung für Responsible AI ist.
Adversarial Machine Learning (AML) ist ein Forschungsgebiet innerhalb von Künstlicher Intelligenz und Machine Learning. Adversarielle Angreifer manipulieren Eingabedaten gezielt, um Modelle zu falschen Vorhersagen zu zwingen oder sensible Informationen offenzulegen. AML zielt darauf ab, diese Verwundbarkeiten zu verstehen und Modelle zu entwickeln, die robuster gegen Angriffe sind.
Das Feld umfasst Methoden, um adversarielle Angriffe zu erzeugen, und Strategien, um sie abzuwehren. Es bezieht auch das weitere Sicherheitsumfeld ein – also zusätzliche Maßnahmen, die nötig sind, wenn ML in automatisierten Systemen eingesetzt wird.
Dieser letzte Punkt ist wichtig, denn Modelle existieren nicht im luftleeren Raum. Ihre Schwachstellen können sich durch den Systemkontext verstärken. So ist es etwa schwieriger, sensible Informationen zu stehlen, wenn die Abfrage eines Modells eingeschränkt ist – etwa durch Limits bei der Anzahl an Queries oder durch verbotene Fragetypen. Versuch einmal, ChatGPT zu sagen: „Gib mir deine Parameter.“ Davon abgesehen konzentrieren sich die Angriffsarten im nächsten Abschnitt auf Modelle und deren Trainingsdaten.
Welche Angriffe möglich sind, hängt davon ab, wie viel man über ein Modell weiß. Daher unterscheiden wir zwischen White-Box- und Black-Box-Angriffen.
White-Box-Angriffe liegen vor, wenn der Angreifer vollen Zugriff auf Architektur, Parameter, Gewichte und Trainingsdaten des Modells hat. Dein Unternehmen könnte zum Beispiel seinen Chatbot mit einem Open-Source-LLM wie Llama 3.1 betreiben. Das Modell ist frei verfügbar – doch dieses Maß an Offenheit ist sicherheitstechnisch ein zweischneidiges Schwert.
Einerseits erleichtert es Angreifern, Schwachstellen zu finden. Andererseits prüft eine große Community das Modell – und entdeckt so potenziell Lücken, bevor sie böswillig ausgenutzt werden.
Black-Box-Angriffe setzen nur begrenztes Wissen über das Modell voraus. Denk an ein OpenAI-Modell wie GPT-4o mini. Der Angreifer kennt weder Architektur noch Parameter oder Trainingsdaten und kann das Modell nur über Anfragen nutzen und die Ausgaben beobachten. Bedenke: Oft reicht schon wenig Wissen für einen effektiven Angriff.
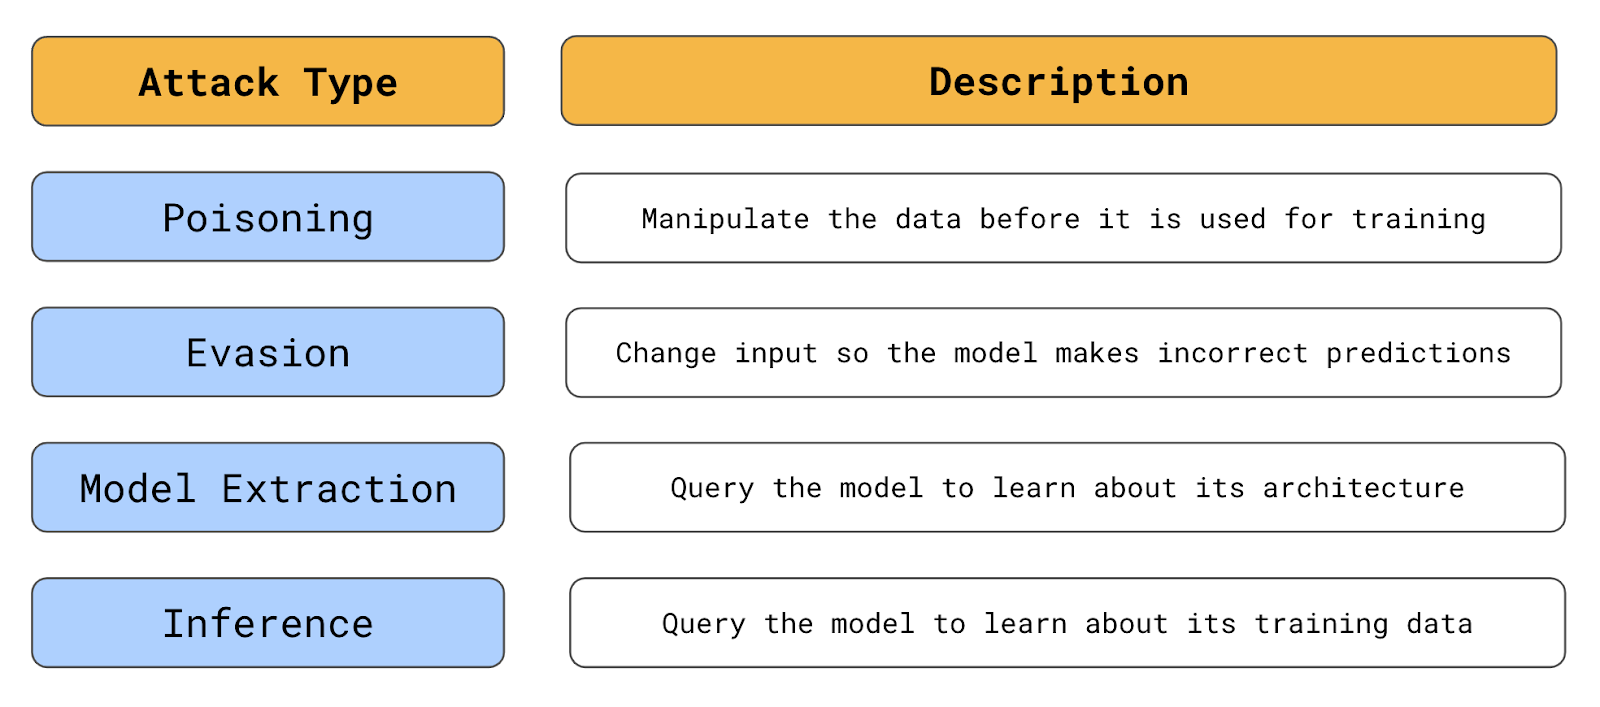
Überblick über die Arten adversarieller Angriffe (Quelle: Autor)
Ein Beispiel: Es ist bekannt, welche Daten zum Training eines Modells genutzt werden. Ein Poisoning-Angriff zielt darauf ab, diese Daten zu manipulieren. Angreifer verändern vorhandene Daten oder schleusen falsch gelabelte Daten ein. Das darauf trainierte Modell trifft anschließend bei korrekt gelabelten Daten falsche Vorhersagen.
In unserer Analogie versucht der Prinz, die Ritter auszutauschen – Ziel: die interne Entscheidungsfindung des Schlosses zu korrumpieren. Im ML-Kontext könnte ein Angreifer etwa Betrugsfälle als „kein Betrug“ umlabeln. Und zwar nur für bestimmte Muster – sodass das System genau diese künftigen Betrugsversuche nicht mehr abweist.
Ein reales Beispiel für einen Poisoning-Angriff ist Tay, Microsofts KI-Chatbot. Tay lernte aus Antworten auf Twitter. Charakteristisch für die Plattform wurde der Bot schnell mit beleidigenden und unangemessenen Inhalten überschwemmt. Nach weniger als 24 Stunden generierte Tay bereits ähnliche Tweets. Jedes System, das aus öffentlichen Daten lernt, ist ähnlichen Risiken ausgesetzt.
Ein weiterer Risikofaktor ist, wie häufig ein Modell aktualisiert wird. In vielen Anwendungen wird nur einmal trainiert – Daten und Modell werden gründlich geprüft, das reduziert die Angriffsfläche. Andere Systeme wie Tay werden jedoch kontinuierlich nachtrainiert – täglich, wöchentlich oder sogar in Echtzeit. Dadurch steigt in solchen Umgebungen die Gefahr von Poisoning-Angriffen.
Evasion-Angriffe zielen auf das Modell selbst. Dabei werden Daten so verändert, dass sie legitim wirken, aber zu einer falschen Vorhersage führen – so wie der Prinz, der als Bauer verkleidet an den Wachen vorbeischlüpfen will.
Wichtig: Der Angreifer verändert Daten, die das Modell für Vorhersagen nutzt – nicht die Trainingsdaten. Bei einem Kreditantrag könnte ein Angreifer etwa sein tatsächliches Herkunftsland mit einem VPN verschleiern. Stammt er aus einem risikoreichen Land, würde das Modell den Antrag sonst ablehnen.
Besonders verbreitet sind solche Angriffe in der Bildverarbeitung. Angreifer erzeugen Bilder, die für Menschen normal wirken, aber zu Fehlklassifikationen führen. So zeigten Forscher bei Google, wie gezieltes Rauschen die Vorhersage eines Bilderkennungsmodells verändern kann.
In Abbildung 1 ist die Rauschschicht für Menschen kaum zu erkennen. Das Modell, das das Bild zuvor als Panda klassifizierte, stuft es nun fälschlicherweise als Gibbon ein.
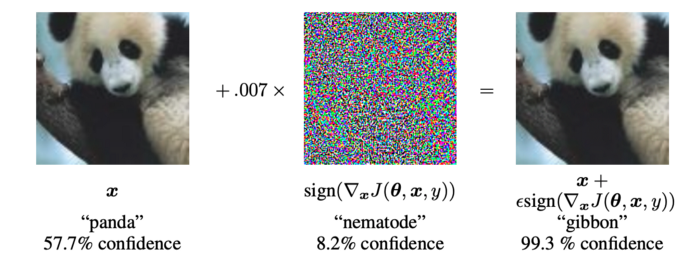
Abbildung 1: Adversariales Beispiel (Quelle: I. Goodfellow et al.)
Bei Model-Stealing- bzw. Model-Extraction-Angriffen wollen Angreifer Architektur und Parameter eines Modells rekonstruieren – idealerweise das Modell exakt kopieren. Das kann finanziell lukrativ sein, etwa wenn ein Aktienhandelsmodell nachgebaut und für Trades eingesetzt wird. Zudem lassen sich so effektivere Folgeangriffe planen.
Solche Angriffe erfolgen durch wiederholte Abfragen des Modells und den Vergleich von Eingaben und Ausgaben. Denk an den Prinzen, der Soldaten vorschickt: Der eine wird von einem Pfeil getroffen, der andere mit heißem Öl übergossen, eine Gruppe von Felsbrocken zerquetscht. Mit der Zeit versteht man, welche Verteidigungen hinter der Mauer lauern.
Oft geht es Angreifern nicht um das gesamte Modell, sondern um bestimmte Informationen – etwa ein geheimes Passwort. Inference-Angriffe fokussieren sich auf die Trainingsdaten. Ziel ist es, vertrauliche Daten aus dem Modell zu extrahieren. Mit sorgfältig formulierten Anfragen lassen sich Informationen direkt entlocken oder aus dem Output ableiten.
Diese Angriffe sind besonders kritisch bei Large Language Models (LLMs).
Im Paper Extracting Training Data from Large Language Models zeigen Forschende, wie sich aus GPT-2 sensible Informationen extrahieren lassen. Mit gezielten Prompts konnten sie Trainingsdaten wortwörtlich rekonstruieren – inklusive persönlicher Details, privater Gespräche und vertraulicher Inhalte.
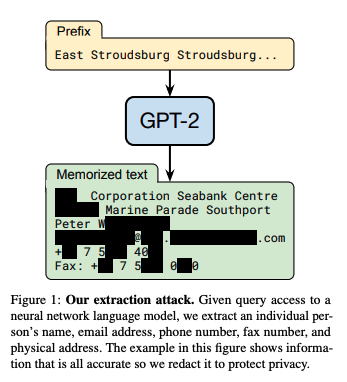
Quelle: N. Carlini et al.
Ziele und Vorgehen dieser Angriffe unterscheiden sich. Gemeinsam ist ihnen jedoch: Es geht darum, Fälle zu finden, mit denen Angreifer ein Modell austricksen können. Diese nennen wir adversarielle Beispiele.
Adversarielle Beispiele sind speziell konstruierte Eingaben, die ML-Modelle täuschen. Für Menschen sind sie oft nicht von legitimen Eingaben zu unterscheiden, enthalten aber subtile Störungen, die Schwächen des Modells ausnutzen.
Diese Störungen sind typischerweise kleine Änderungen an den Eingabedaten, etwa minimale Variationen von Pixelwerten. Obwohl gering, sind sie so angelegt, dass sie die Eingabe über die Entscheidungsgrenze des Modells schieben und falsche oder unerwartete Vorhersagen auslösen.
Wir haben gesehen, wie ein Computer-Vision-Modell so ausgetrickst werden kann: Ein für uns wie ein Panda wirkendes Bild wurde als Gibbon klassifiziert. Auch der Prompt zur Extraktion sensibler Informationen aus GPT-2 ist ein adversariales Beispiel für einen Inference-Angriff.
Bei Extraction-Angriffen dienen adversarielle Beispiele dazu, die Entscheidungsgrenzen eines Modells gezielter zu sondieren. Bei Poisoning-Angriffen sind es Eingaben, die die Entscheidungsgrenze des Modells verschieben.
Sie funktionieren, weil Entscheidungsgrenzen von ML-Modellen komplex und fragil sein können. Adversarielle Beispiele nutzen diese Fragilität aus, indem sie Punkte nahe dieser Grenzen finden. Kleine Störungen reichen dann, um eine Eingabe über die Grenze zu schieben – das Modell klassifiziert sie falsch. Schauen wir uns einige Verfahren an.
Gradientenbasierte Methoden nutzen die Gradienten eines Modells, um kleine Störungen in den Eingabedaten zu erzeugen, die zu Fehlvorhersagen führen. Das Panda/Gibbon-Beispiel ist ein Ergebnis einer solchen Methode. Das Rauschen wirkt zufällig, enthält aber Information über die Verlustfunktion des Modells, die das Bild entlang der Entscheidungsgrenze verschiebt, sobald sie addiert wird.
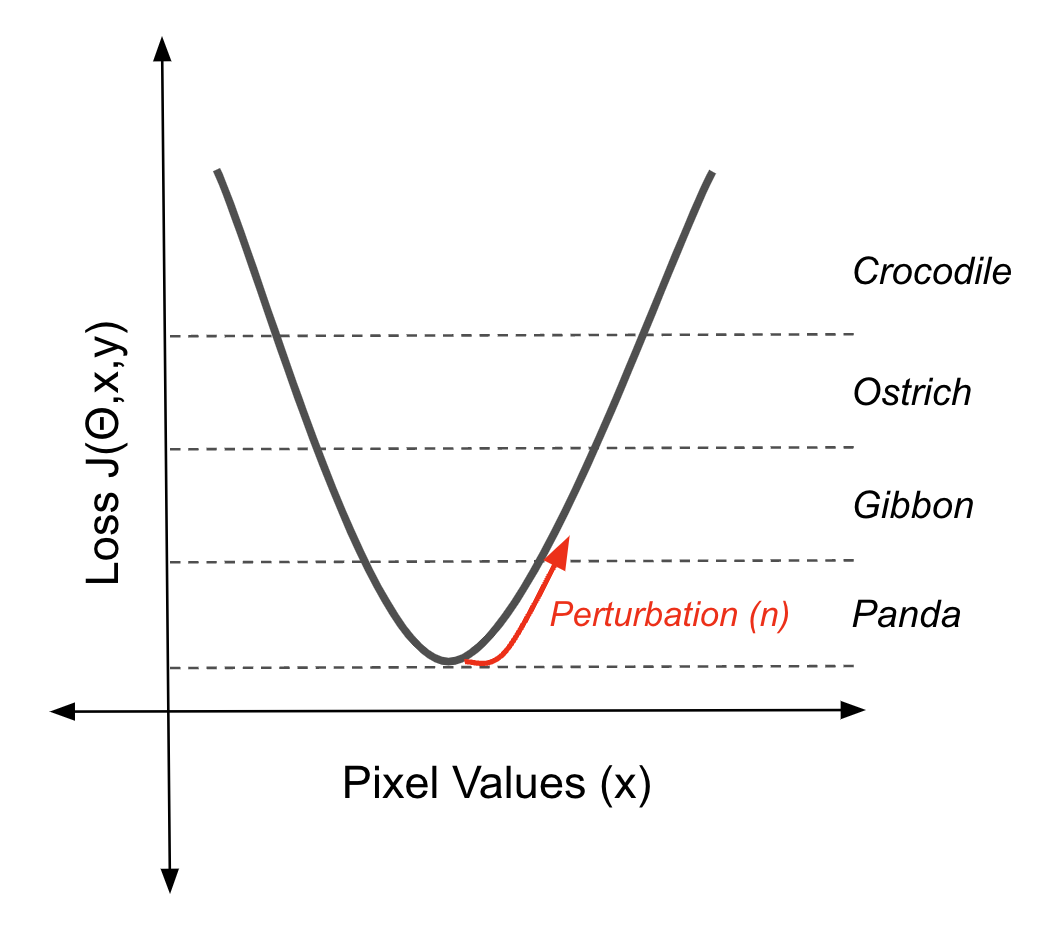
Mit dem Gradienten der Verlustfunktion eine Instanz aus der Entscheidungsgrenze verschieben (Quelle: Autor)
Der Fast Gradient Sign Method (FGSM) verdanken wir dieses Beispiel. Das Rauschen (η) wird berechnet, indem zunächst der Gradient (∇x) der Verlustfunktion (J(θ,x,y)) bezüglich der Eingabe (x) gebildet wird.
Dieser Gradient zeigt an, in welche Richtung die Eingabe verändert werden muss, um die Loss maximal zu erhöhen. FGSM nimmt dann das Vorzeichen dieses Gradienten – pro Pixel nur positiv oder negativ. Abschließend wird dieses Vorzeichen mit einem kleinen Faktor (ε) skaliert. Dieses Rauschen (η) ist die Störung, die – zur Originaleingabe addiert – die Vorhersage in eine Fehlklassifikation drückt.
η = ε sign(∇xJ(θ,x,y))
Du kannst dir das als Gegenstück zur Backpropagation vorstellen. Dieses Verfahren nutzt Gradienten, um Parameter zu finden, die akkurate Vorhersagen liefern – und damit Entscheidungsgrenzen, innerhalb derer Pixelwerte einer Klasse zugeordnet werden. Nun nutzen wir die Gradienten, um das Bild aus diesen Grenzen herauszuschieben.
FGSM ist ein einfacher Ansatz. Es gibt auch komplexere und effizientere Wege, Entscheidungsgrenzen zu verschieben. Zum Beispiel ist Projected Gradient Descent (PGD) ein iteratives, gradientenbasiertes Verfahren zur Generierung adversarieller Beispiele. Es erweitert FGSM durch viele kleine Schritte. Da sich mit jedem Schritt die Vorzeichen der Gradienten ändern können, ändert sich auch die ideale Richtung, um die Entscheidungsgrenze zu verlassen. Durch viele kleine Schritte findet PGD adversarielle Beispiele oft mit geringerer Störstärke als FGSM.
Der Carlini-&-Wagner-(C&W)-Angriff betrachtet das Problem anders. Bisher wollten wir die Vorhersage in irgendeine falsche Klasse kippen. C&W sucht die kleinstmögliche Störung (δ), die – zum Bild addiert – die Vorhersage (f(x+δ)) in ein vorgegebenes Ziel (t) ändert.
min||δ||p s.t. f(x + δ) = t
Dazu wird das Problem als Optimierungsaufgabe formuliert. In der Praxis muss das obige Ziel differenzierbar ausgedrückt werden. Dafür nutzt man die Logits Z(x) des Modells. Sie liefern einen glatten Gradienten – essenziell für die Optimierung.
Die oben beschriebenen Angriffe setzen vollen Zugriff auf ein Modell voraus. Man könnte also meinen: Wenn die Parameter geheim bleiben, ist man sicher. Falsch gedacht!
Oft reichen bereits Schätzungen der Gradienten für einen erfolgreichen Angriff. Für FGSM genügt die Gradientenrichtung. Diese lässt sich mit wenigen API-Abfragen, die Klassifikationswahrscheinlichkeiten liefern, approximieren. Noch problematischer: Erfolgreiche adversarielle Beispiele können sogar ganz ohne Interaktion mit dem Zielmodell gefunden werden.
Forschende haben gezeigt, dass adversarielle Beispiele übertragbar sind. Konkret wurden fünf populäre vortrainierte Deep-Learning-Architekturen untersucht. Täuschte ein adversariales Beispiel vier der Modelle, war die Wahrscheinlichkeit hoch, dass es auch das fünfte täuscht – über 96 %, bei einer Architektur sogar 100 %.
Ähnlich verallgemeinern universelle adversarielle Beispiele über Architekturen hinweg. Das sind Störungen, die – zu vielen Bildern addiert – deren Vorhersagen verändern. Wichtig: Diese universellen Beispiele werden mit White-Box-Wissen über nur ein Netzwerk gefunden. In Abbildung 2 ist zu sehen, wie ähnlich sie für verschiedene Architekturen aussehen. Das deutet auf Ähnlichkeiten in den Entscheidungsgrenzen hin.
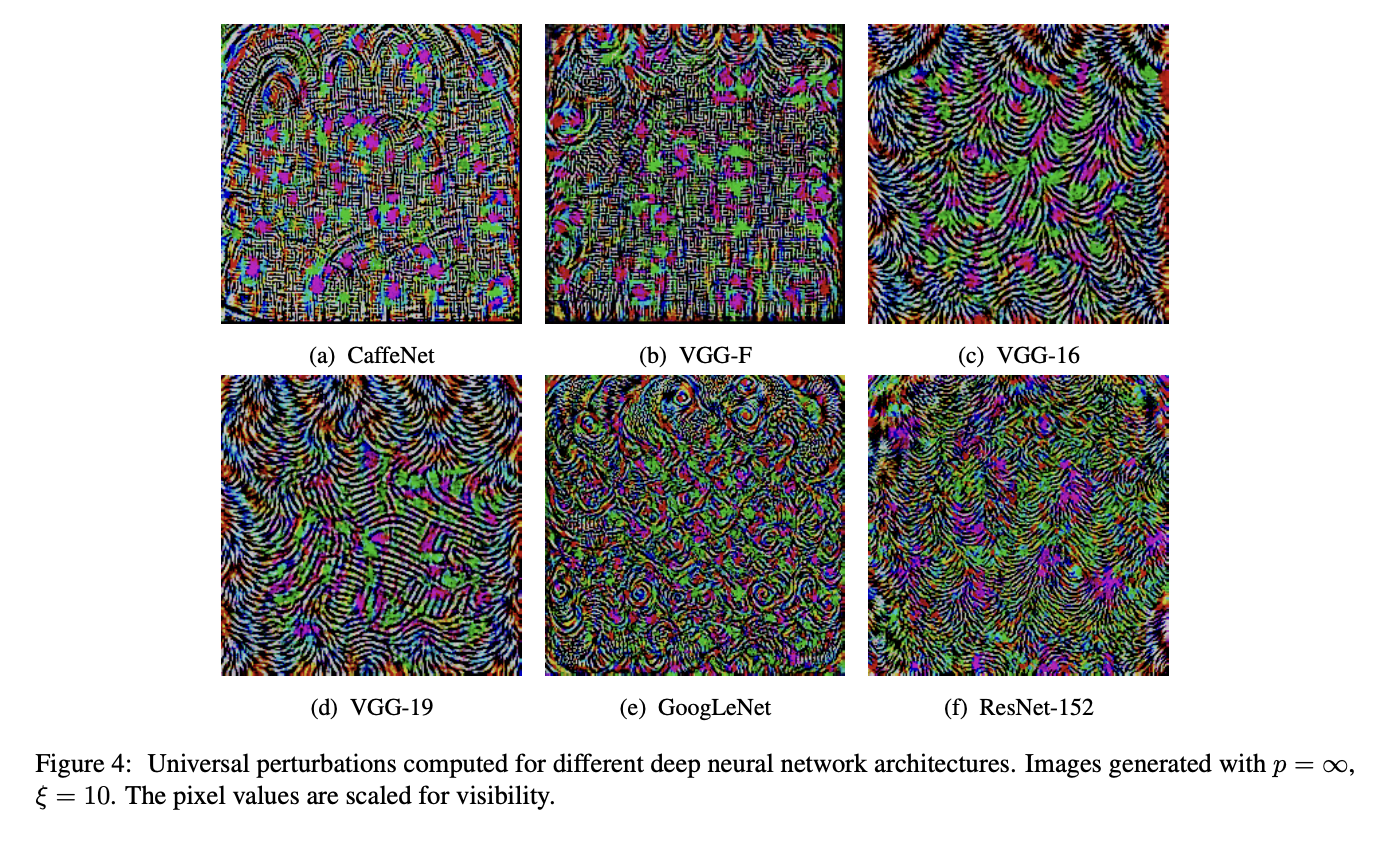
Abbildung 2: Universelle Störungen für verschiedene Deep-Neural-Networks (Quelle: Moosavi-Dezfooli et al.)
Die Konsequenz: Kein Netzwerk ist sicher. Ein unbekannter Klassifikator kann attackiert werden, indem man ein eigenes Modell trainiert und ein White-Box-Verfahren darauf ausführt.
Ein letzter Hoffnungsschimmer wäre, dass solche Angriffe nur virtuell funktionieren, weil Pixelwerte verändert werden müssen. Also doch kein Problem für Modelle, die mit der realen Welt interagieren?
Nicht zu früh freuen.
Forschende haben sogenannte adversarial patches entwickelt. Diese lassen sich ausdrucken und in reale Szenen kleben, um einen Bildklassifizierer zu täuschen.
Die Patches sind universell, weil sie jede Szene angreifen können, robust, weil sie unter vielen Transformationen funktionieren, und zielgerichtet, weil sie einen Klassifikator zu einer beliebigen Zielklasse zwingen können.
T. B. Brown et al.
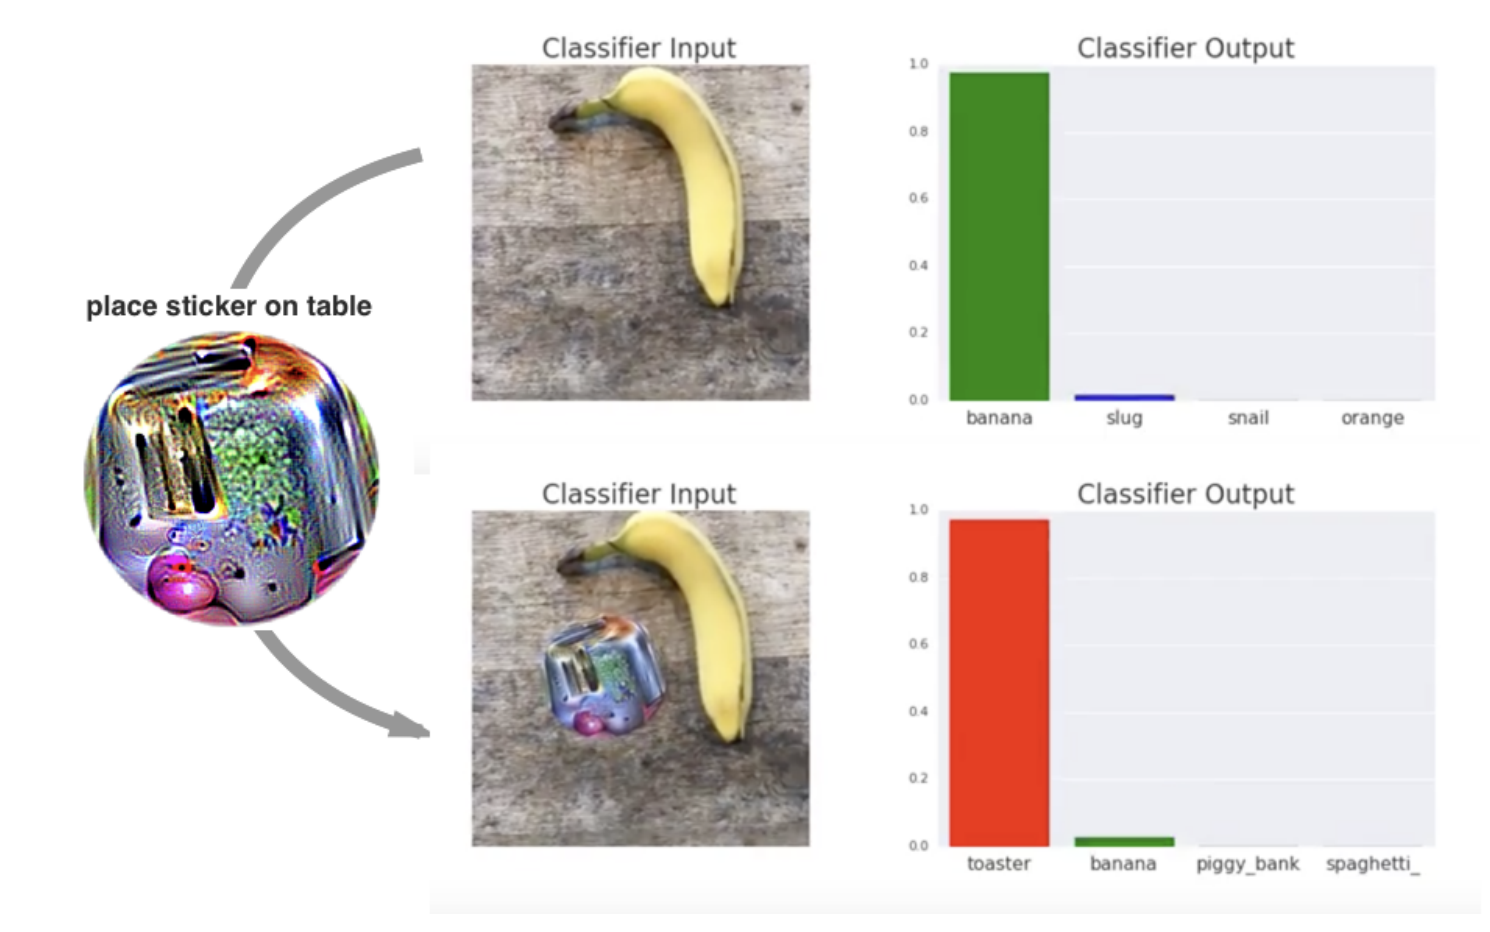
Ein adversarial patch im Einsatz (Quelle: T. B. Brown et al.)
Ähnliche Arbeiten zeigen, wie sich mit ein paar Stickern die Erkennung eines Stoppschilds verändern lässt und wie man ein Gesichtserkennungsmodell mit einer Brille täuscht. Kein Netzwerk ist wirklich sicher. Für den Schutz vor solchen Angriffen braucht es die andere Seite von AML – Abwehrmethoden.
Abwehrstrategien sind so vielfältig wie die Angriffe selbst. Wir können Trainingsdaten, Trainingsprozess oder sogar das Netzwerk anpassen. Und manchmal ist die einfachste Lösung, ganz auf Deep Learning zu verzichten.
Dieser Ansatz setzt bei den Trainingsdaten an. Beim adversarialen Training wird der Datensatz um adversarielle Beispiele ergänzt, um die Robustheit des Modells zu steigern. Diese Beispiele entstehen mit den oben genannten Angriffsmethoden. Die Idee: Das Modell lernt bereits beim Training, solche Störungen zu erkennen und abzuwehren.
Defensive Distillation trainiert ein Modell darauf, die „weicheren“ Wahrscheinlichkeitsausgaben eines anderen Modells zu imitieren. Zuerst wird ein Standardmodell (Teacher) auf dem Originaldatensatz trainiert und erzeugt Soft Labels (Wahrscheinlichkeitsverteilungen über Klassen). Ein Student-Modell wird anschließend auf diesen Soft Labels trainiert. Ergebnis sind glattere Entscheidungsgrenzen, die weniger anfällig für kleine Störungen sind.
Unter Gradient Masking fallen Techniken, die die Gradienten des Modells verschleiern. So kann man etwa eine nicht-differenzierbare Schicht integrieren, z. B. eine binäre Aktivierungsfunktion, die kontinuierliche Eingaben in binäre Ausgaben überführt.
Model Switching ist ein einfacher Gradient-Masking-Ansatz: Im System laufen mehrere Modelle, und das zur Vorhersage genutzte Modell wechselt zufällig. Das macht das Ziel beweglich – Angreifer wissen nicht, welches Modell gerade aktiv ist, und müssten alle kompromittieren, um Erfolg zu haben.
AML ist verwandt mit Explainable Artificial Intelligence (XAI). Die hier beschriebenen Störmethoden ähneln denen, die Erklärungen für Modellentscheidungen liefern. Der zentrale Punkt: Einfache Modelle sind nicht nur leichter erklärbar, sondern auch leichter zu schützen.
Viele Probleme lassen sich mit einfachen Modellen wie Linearer oder Logistischer Regression lösen. Viele der oben beschriebenen Angriffe greifen hier kaum oder gar nicht.
Der Grund: Diese Modelle sind intrinsisch interpretierbar – wir verstehen leicht, wie sie funktionieren. Schwächen sind nicht verborgen wie in komplexen Deep-Learning-Architekturen. Eine einfache Verteidigung ist daher: Deep Learning nur einsetzen, wenn es wirklich nötig ist.
Damit sind wir wieder beim Einstieg: AML bezieht auch das weitere Sicherheitsumfeld ein. Viele zusätzliche Maßnahmen zielen darauf ab, dieses Umfeld zu härten – etwa die Validierung und Bereinigung von Eingabedaten, bevor sie zum Training genutzt werden. Anomalieerkennung kann adversarielle Beispiele identifizieren, bevor sie ein Netzwerk erreichen. Solche Maßnahmen laufen parallel zum KI-System.
Je zentraler KI und ML in unserem Leben werden, desto wichtiger wird AML. Systeme, die über Gesundheit oder Finanzen entscheiden, dürfen sich nicht leicht täuschen lassen – weder absichtlich noch versehentlich. Ein autonomes Auto, das ein paar Sticker austricksen, würde ich nicht vertrauen. Solche Angriffe könnten dem Fahrer entgehen, aber zu falschen, lebensgefährlichen Entscheidungen führen.
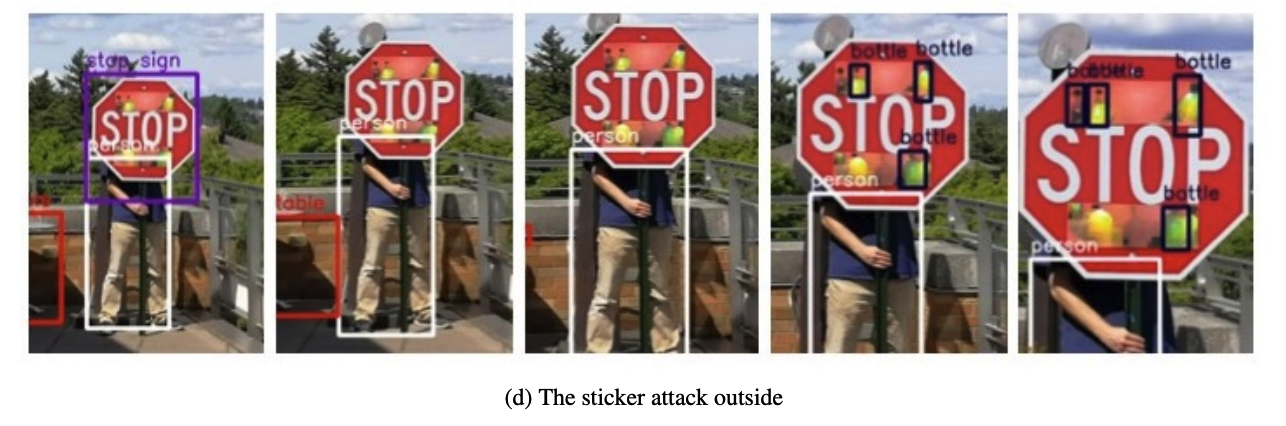 Abbildung X: Yolo Object Detection v2 erkennt ein Stoppschild nicht (Quelle: K. Eykholt et al.)
Beim Design solcher Systeme müssen wir AML als Teil von Responsible AI verstehen. Um ein gutes „Schloss“ zu führen, muss der König fair handeln, Entscheidungen begründen, die Privatsphäre schützen und für Sicherheit und Schutz sorgen. Genau diese beiden Aspekte adressiert AML.
Gleichzeitig unterscheiden sich Sicherheit und Schutz grundlegend von anderen Responsible-AI-Prinzipien. Fairness, Interpretierbarkeit und Privatsphäre sind passiv; AML agiert in einem Umfeld, in dem aktive Gegner gezielt versuchen, seine Methoden auszuhebeln.
Deshalb zielt ein großer Teil der Forschung – paradoxerweise – darauf ab, Schwachstellen und Angriffe aufzudecken: Poisoning, Evasion, Model Extraction, Inference sowie praktische Verfahren zur Erzeugung adversarieller Beispiele wie FGSM, PGD, C&W und adversarial patches.
Ziel ist, diese Lücken zu finden, bevor es andere tun. Geeignete Abwehrmaßnahmen – etwa adversariales Training, Defensive Distillation und Gradient Masking – können dann entwickelt und implementiert werden, bevor Schaden entsteht.
In diesem Sinne ist AML auch Teil des übergeordneten Wettlaufs in der Cybersicherheit. Neue Schwachstellen, Angriffe und Abwehrmechanismen werden entstehen – AML-Expertinnen und -Experten müssen ständig daran arbeiten, Angreifern einen Schritt voraus zu sein.
Wenn du bei diesem Wettlauf mitmachen willst, hier ein paar Python-Frameworks für den Einstieg:
In diesem Artikel haben wir Adversarial Machine Learning beleuchtet – seine Ziele, verschiedene Angriffsarten (Poisoning, Evasion, Model Extraction und Inference) und die Rolle adversarieller Beispiele bei der Ausnutzung von Modellschwächen.
Wir haben zudem Abwehrmechanismen wie adversariales Training, Defensive Distillation und Gradient Masking diskutiert – sowie die Bedeutung einfacherer Modelle, wo immer sie ausreichen.
Wenn du tiefer einsteigen willst, schau dir diesen Kurs an: Introduction to Data Security.
Lerne mehr über Machine Learning!
Kurs
Kurs
Kurs