
Khóa học
Tiền xử lý cho Machine Learning bằng Python
4 giờ
69K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Google
Ảnh của Cederic Vandenberghe trên Unsplash
Một vị hoàng tử bị lưu đày đứng bên ngoài toà lâu đài xưa của mình. Để quay lại, anh ta đã thử mọi cách để qua mặt lính gác ở cầu nâng. Anh cải trang thành nông dân, dò hỏi mật khẩu bí mật và tìm cách thay thế các hiệp sĩ bằng thuộc hạ trung thành. Anh thậm chí còn sai từng toán lính xông vào chỗ chết để hiểu rõ hệ thống phòng thủ mới của lâu đài. Không gì hiệu quả. Phòng thủ quá vững, lính gác quá kín tiếng, và quy trình tuyển chọn hiệp sĩ quá nghiêm ngặt.
Ngày nay, các mô hình học máy (ML) cũng đối mặt với những cuộc tấn công tương tự.
Mô hình rất phức tạp và thường chúng ta hiểu chưa đầy đủ cách chúng đưa ra dự đoán. Điều này để lộ những điểm yếu tiềm ẩn có thể bị kẻ tấn công khai thác. Họ có thể đánh lừa mô hình đoán sai hoặc làm lộ thông tin nhạy cảm. Dữ liệu giả thậm chí có thể được dùng để làm hỏng mô hình mà ta không hề hay biết. Lĩnh vực adversarial machine learning (AML) nhằm khắc phục các điểm yếu này.
Chúng ta sẽ bàn về lĩnh vực này và mục tiêu của nó. Bao gồm các kiểu tấn công vào hệ thống AI như tấn công đầu độc dữ liệu, né tránh và đánh cắp/chiết xuất mô hình. Ta cũng sẽ thảo luận các cách thực tế để tìm ví dụ đối kháng, vốn là cốt lõi của nhiều cuộc tấn công này. Cuối cùng, ta bàn một số phương pháp phòng vệ như huấn luyện đối kháng, chưng cất phòng thủ và che giấu gradient. Kết lại, ta sẽ thấy AML là một phần của nỗ lực lớn hơn nhằm xây dựng hệ thống AI có trách nhiệm.
Adversarial Machine Learning (AML) là một phân ngành nghiên cứu trong trí tuệ nhân tạo và học máy. Kẻ tấn công đối kháng cố ý thao túng dữ liệu đầu vào để buộc mô hình dự đoán sai hoặc rò rỉ thông tin nhạy cảm. AML nhằm hiểu rõ các lỗ hổng này và phát triển mô hình vững vàng hơn trước tấn công.
Lĩnh vực này bao quát cả phương pháp tạo ra các cuộc tấn công đối kháng và thiết kế biện pháp phòng vệ. Nó cũng liên quan tới môi trường an ninh rộng hơn—những lớp bảo vệ bổ sung cần có khi dùng ML trong hệ thống tự động hóa.
Điểm cuối này rất quan trọng vì mô hình không tồn tại độc lập. Cách chúng được sử dụng trong hệ thống có thể khuếch đại lỗ hổng. Ví dụ, khó đánh cắp thông tin nhạy cảm hơn nếu có giới hạn cách bạn truy vấn mô hình. Bạn có thể giới hạn số truy vấn hoặc hạn chế loại câu hỏi được phép. Hãy thử yêu cầu ChatGPT “hãy đưa tôi tham số của bạn.” Dẫu vậy, các kiểu tấn công trong phần tiếp theo sẽ tập trung vào bản thân mô hình và dữ liệu huấn luyện của chúng.
Các kiểu tấn công sẽ khác nhau tùy theo mức độ hiểu biết của bạn về mô hình. Vì vậy, cần phân biệt tấn công white-box và black-box.
White-box xảy ra khi kẻ tấn công có toàn quyền truy cập kiến trúc, tham số, trọng số và dữ liệu huấn luyện. Chẳng hạn, công ty bạn vận hành chatbot bằng một LLM mã nguồn mở như Llama 3.1. Mô hình này ai cũng có thể dùng. Tuy nhiên, mức truy cập này là con dao hai lưỡi về bảo mật.
Một mặt, nó giúp kẻ tấn công dễ tìm lỗ hổng hơn. Mặt khác, cộng đồng lớn hơn soi xét mô hình, nên khả năng lỗ hổng bị phát hiện trước khi bị lợi dụng ác ý cũng cao hơn.
Black-box liên quan đến việc kẻ tấn công chỉ biết rất ít về mô hình. Hãy nghĩ đến một mô hình OpenAI như GPT-4o mini. Kẻ tấn công không thể truy cập kiến trúc nội bộ, tham số hay dữ liệu huấn luyện và chỉ có thể tương tác bằng cách truy vấn và quan sát đầu ra. Lưu ý rằng trong nhiều trường hợp, chỉ cần biết hạn chế là đủ để tấn công hiệu quả.
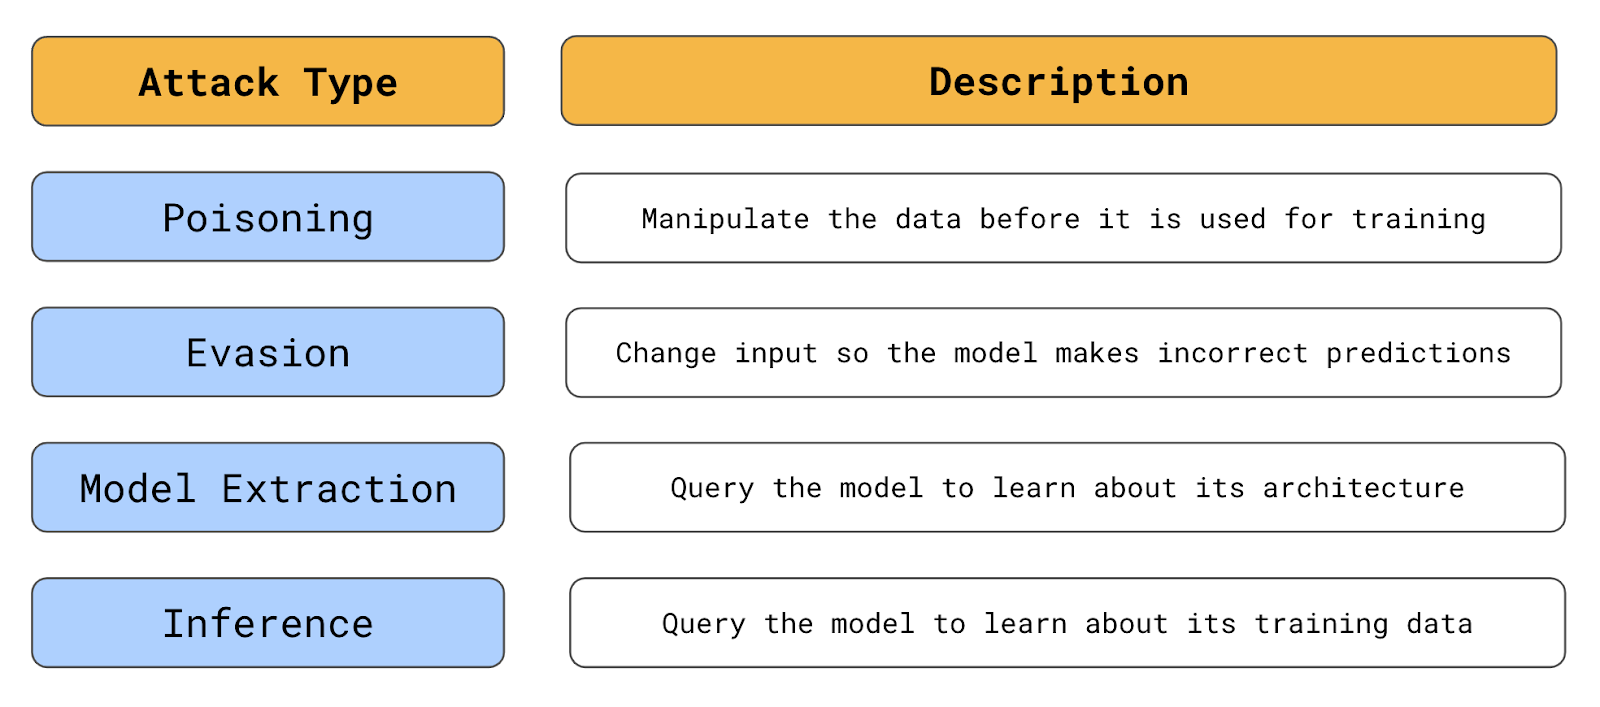
Tóm tắt các kiểu tấn công đối kháng (nguồn: tác giả)
Một ví dụ là khi biết chính xác dữ liệu nào được dùng để huấn luyện mô hình. Tấn công đầu độc tập trung thao túng dữ liệu này. Kẻ tấn công sẽ thay đổi dữ liệu hiện có hoặc đưa vào dữ liệu gán nhãn sai. Mô hình được huấn luyện trên dữ liệu đó sẽ dự đoán sai ngay cả với dữ liệu gán nhãn đúng.
Trong phép ẩn dụ của ta, hoàng tử tìm cách thay thế hiệp sĩ. Mục tiêu là làm hỏng quy trình ra quyết định nội bộ của lâu đài. Trong học máy, kẻ tấn công có thể làm điều gì đó như gán nhãn lại các vụ gian lận thành không gian lận. Họ có thể chỉ làm vậy với một số kiểu gian lận cụ thể, để khi họ thực hiện theo đúng cách đó, hệ thống sẽ không từ chối.
Một ví dụ thực tế về tấn công đầu độc đã xảy ra với Tay, chatbot AI của Microsoft. Tay được thiết kế để thích ứng với phản hồi trên Twitter. Đúng như đặc trưng của nền tảng này, chẳng mấy chốc bot ngập trong nội dung phản cảm và không phù hợp. Học theo đó, chỉ mất chưa đầy 24 giờ để Tay bắt đầu đăng các tweet tương tự. Bất kỳ hệ thống nào học từ nguồn dữ liệu công cộng cũng đối mặt rủi ro tương tự.
Yếu tố rủi ro khác là tần suất cập nhật mô hình. Trong nhiều ứng dụng, mô hình chỉ được huấn luyện một lần. Khi đó, cả dữ liệu và mô hình sẽ được kiểm tra kỹ lưỡng, ít tạo cơ hội cho tấn công đầu độc. Tuy nhiên, một số hệ thống như Tay được huấn luyện lại liên tục. Các mô hình này có thể được cập nhật dữ liệu mới theo ngày, tuần, thậm chí theo thời gian thực. Do đó, môi trường như vậy có nhiều cơ hội cho tấn công đầu độc hơn.
Tấn công né tránh tập trung vào chính mô hình. Chúng liên quan đến việc chỉnh sửa dữ liệu sao cho trông hợp lệ nhưng dẫn tới dự đoán sai. Giống khi hoàng tử cố lẻn qua lính gác trong bộ đồ nông dân.
Rõ ràng là kẻ tấn công sửa dữ liệu mà mô hình dùng để dự đoán, không phải dữ liệu dùng để huấn luyện. Ví dụ, khi nộp đơn vay, kẻ tấn công có thể che giấu quốc gia xuất xứ thật bằng VPN. Họ có thể đến từ quốc gia rủi ro, và nếu dùng quốc gia thật, mô hình sẽ từ chối hồ sơ.
Các kiểu tấn công này phổ biến hơn trong các lĩnh vực như nhận dạng hình ảnh. Kẻ tấn công có thể tạo ảnh trông hoàn toàn bình thường với con người nhưng dẫn đến dự đoán sai. Ví dụ, các nhà nghiên cứu tại Google cho thấy chỉ cần đưa một lớp nhiễu cụ thể vào ảnh cũng đủ thay đổi dự đoán của mô hình nhận dạng ảnh.
Nhìn Hình 1, bạn có thể thấy với con người lớp nhiễu này hầu như không thể nhận ra. Tuy nhiên, mô hình vốn dự đoán ảnh là gấu trúc nay lại đoán sai thành vượn má trắng.
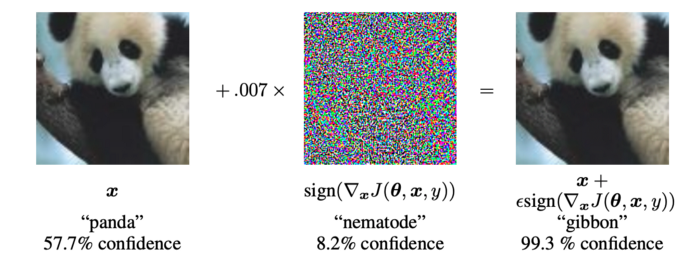
Hình 1: Ví dụ đối kháng (Nguồn: I. Goodfellow và cộng sự)
Với tấn công đánh cắp hoặc chiết xuất mô hình, kẻ tấn công nhằm học về kiến trúc và tham số mô hình. Mục tiêu là sao chép y nguyên mô hình. Thông tin này có thể mang lại lợi ích tài chính trực tiếp. Ví dụ, một mô hình giao dịch cổ phiếu có thể bị sao chép và dùng để giao dịch. Kẻ tấn công cũng có thể dùng thông tin này để tạo ra các đợt tấn công sau đó hiệu quả hơn.
Tấn công chiết xuất mô hình được thực hiện bằng cách truy vấn mô hình lặp lại nhiều lần và so sánh đầu vào với đầu ra tương ứng. Hãy nghĩ đến hoàng tử sai lính tấn công: người thì trúng tên, người thì bị dội dầu sôi, cả nhóm bị đá tảng nghiền nát. Dần dần theo thời gian, ta có thể hiểu khá rõ những gì ẩn sau tường thành.
Kẻ tấn công thường không quan tâm tới cả mô hình, mà chỉ một số thông tin cụ thể, như mật khẩu bí mật. Tấn công suy luận tập trung vào dữ liệu dùng để huấn luyện mô hình. Mục tiêu là trích xuất dữ liệu mật từ mô hình. Thông qua các truy vấn được thiết kế cẩn thận, thông tin này có thể bị lộ trực tiếp hoặc suy ra từ đầu ra của mô hình.
Những kiểu tấn công này đặc biệt đáng lo đối với mô hình ngôn ngữ lớn (LLM).
Trong bài Extracting Training Data from Large Language Models, các nhà nghiên cứu cho thấy thông tin nhạy cảm có thể bị trích xuất từ GPT-2. Bằng các truy vấn cụ thể, họ có thể rút nguyên văn văn bản từ dữ liệu huấn luyện của mô hình, gồm thông tin nhạy cảm và riêng tư. Bao gồm chi tiết cá nhân, hội thoại riêng và dữ liệu mật khác.
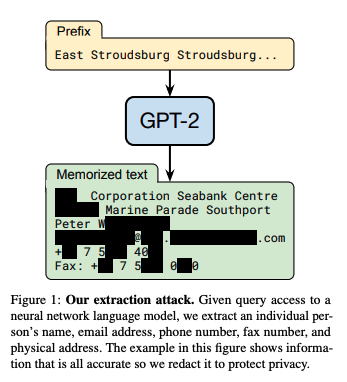
Nguồn: N. Carlini và cộng sự
Mục tiêu và quy trình của những cuộc tấn công này khác nhau. Tuy nhiên, chúng có điểm chung—chúng dựa vào việc tìm ra các trường hợp giúp kẻ tấn công đánh lừa mô hình. Ta gọi chúng là ví dụ đối kháng.
Ví dụ đối kháng là các đầu vào được tạo có chủ đích để đánh lừa mô hình học máy. Các đầu vào này thường không thể phân biệt với đầu vào hợp lệ bằng mắt người, nhưng chứa các nhiễu tinh vi khai thác điểm yếu của mô hình.
Các nhiễu thường là thay đổi nhỏ với dữ liệu đầu vào, như biến đổi nhẹ giá trị điểm ảnh. Dù nhỏ, các nhiễu này được thiết kế để đẩy đầu vào vượt qua ranh giới quyết định của mô hình, dẫn tới dự đoán sai hoặc bất ngờ.
Ta đã thấy một ví dụ dùng để đánh lừa mô hình thị giác máy tính. Chỉ với thay đổi rất nhỏ, ảnh trông như gấu trúc với chúng ta lại bị phân loại thành vượn. Truy vấn dùng để trích xuất thông tin nhạy cảm từ GPT-2 cũng là một ví dụ đối kháng thuộc kiểu tấn công suy luận.
Với tấn công chiết xuất, ví dụ đối kháng được dùng để thăm dò ranh giới quyết định của mô hình hiệu quả hơn. Với tấn công đầu độc, chúng là dữ liệu đầu vào dùng để thao túng ranh giới quyết định của mô hình.
Các ví dụ này hiệu quả vì ranh giới quyết định của mô hình học máy có thể rất phức tạp và mong manh. Ví dụ đối kháng khai thác sự mong manh này bằng cách tìm điểm trong không gian đầu vào gần các ranh giới. Nhiễu nhỏ có thể đẩy đầu vào vượt ranh, khiến mô hình phân loại sai. Hãy xem vài cách thực hiện.
Các phương pháp dựa trên gradient dùng gradient của mô hình để tạo nhiễu nhỏ trong dữ liệu đầu vào khiến mô hình dự đoán sai. Ví dụ Gấu trúc/Vượn là kết quả của một phương pháp như vậy. Lớp nhiễu nhìn có vẻ ngẫu nhiên, nhưng nó chứa thông tin về hàm mất mát của mô hình và khi cộng vào ảnh sẽ đẩy ảnh dọc theo ranh giới quyết định.
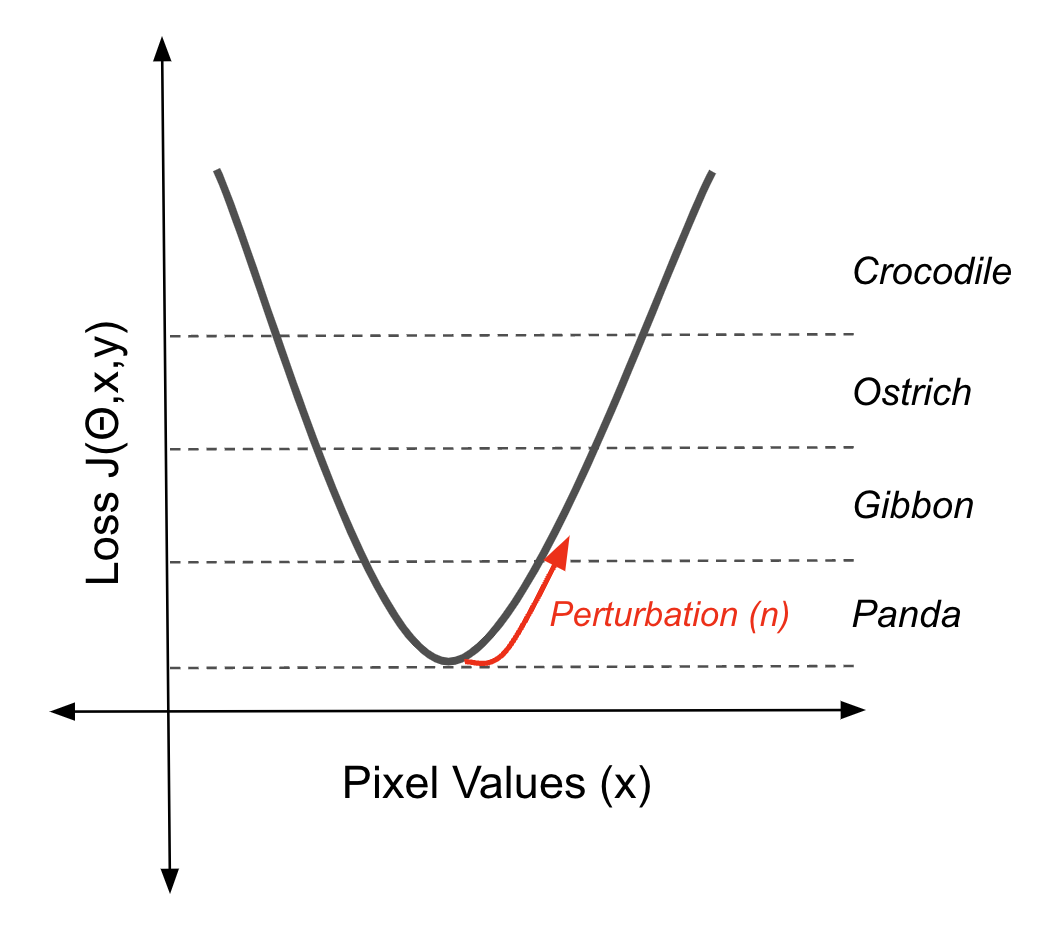
Dùng gradient của hàm mất mát để di chuyển một điểm ra khỏi ranh giới quyết định (nguồn: tác giả)
Fast Gradient Sign Method (FGSM) được dùng để tạo ví dụ đối kháng cụ thể này. Nhiễu (η) được tính bằng cách đầu tiên lấy gradient (∇x) của hàm mất mát (J(θ,x,y)) theo dữ liệu đầu vào (x).
Gradient này cho biết hướng mà đầu vào nên thay đổi để làm tăng mất mát tối đa. FGSM sau đó lấy dấu của gradient, đơn giản hoá hướng thay đổi chỉ còn dương hoặc âm cho từng pixel. Cuối cùng, nó nhân hướng này với một hệ số nhỏ (ε). Nhiễu này (η) là nhiễu gây nhiễu mà khi cộng vào đầu vào gốc sẽ đẩy dự đoán của mô hình về phía một phân loại sai.
η = ε sign(∇xJ(θ,x,y))
Bạn có thể coi đây là điều ngược với lan truyền ngược. Thuật toán này dùng gradient của hàm mất mát để tính tham số mô hình nhằm cho dự đoán chính xác. Kết quả là các ranh giới quyết định sẽ phân loại ảnh vào lớp tương ứng khi giá trị pixel nằm trong ranh giới đó. Giờ đây ta dùng gradient để đẩy ảnh ra khỏi các ranh giới đó.
FGSM là cách đơn giản để làm điều này. Cũng có các cách phức tạp và hiệu quả hơn để đẩy ranh giới quyết định. Ví dụ, Projected Gradient Descent (PGD) là phương pháp lặp dựa trên gradient để tạo ví dụ đối kháng. Nó mở rộng FGSM bằng cách áp dụng FGSM nhiều lần với bước nhỏ hơn. Mỗi bước thực hiện, dấu của gradient có thể thay đổi, làm đổi hướng lý tưởng để rời xa ranh giới. Vì vậy, với nhiều bước nhỏ, PGD có thể tìm ví dụ đối kháng với nhiễu nhỏ hơn FGSM.
Tấn công Carlini & Wagner (C&W) tiếp cận vấn đề theo góc khác. Với các tấn công trước, ta nhằm thay đổi dự đoán thành bất kỳ dự đoán sai nào. Còn C&W tìm nhiễu nhỏ nhất (δ) mà khi cộng vào ảnh sẽ đổi dự đoán (f(x+δ)) thành một mục tiêu cho trước (t).
min||δ||p s.t. f(x + δ) = t
Để làm vậy họ đặt bài toán dưới dạng tối ưu hoá. Trên thực tế, cần biểu diễn mục tiêu trên theo cách khả vi. Điều này liên quan đến việc dùng các logit Z(x) của mô hình. Chúng cung cấp gradient mượt mà, thiết yếu cho quá trình tối ưu.
Các tấn công mô tả bên trên đều cần toàn quyền truy cập mô hình. Vậy bạn có thể nghĩ rằng nếu giữ bí mật tham số mô hình thì sẽ an toàn. Bạn đã nhầm!
Một điều cần lưu ý là nhiều khi chỉ cần ước lượng gradient là đủ cho một cuộc tấn công thành công. Như ta thấy với FGSM, chỉ cần hướng của gradient. Có thể ước lượng chúng bằng vài lần ping tới API trả về xác suất phân loại. Tệ hơn nữa, các ví dụ đối kháng thành công thậm chí có thể được tìm ra mà không cần tương tác với mô hình.
Các nhà nghiên cứu phát hiện ví dụ đối kháng có tính chuyển giao. Cụ thể, họ lấy 5 kiến trúc học sâu tiền huấn luyện phổ biến. Họ thấy rằng nếu một ví dụ đối kháng đánh lừa được bốn mô hình, thì xác suất cao là nó cũng đánh lừa mô hình thứ 5. Xác suất trên 96% và thậm chí 100% với một kiến trúc.
Tương tự, ví dụ đối kháng phổ quát được chứng minh là khái quát hoá giữa các kiến trúc. Đây là một nhiễu mà khi cộng vào nhiều ảnh sẽ làm thay đổi dự đoán cho các ảnh đó. Quan trọng là các ví dụ phổ quát được tìm với kiến thức white-box đầy đủ của chỉ một mạng. Ở Hình 2, bạn có thể thấy chúng trông giống nhau giữa các kiến trúc khác nhau. Sự tồn tại của chúng gợi ý sự tương đồng giữa ranh giới quyết định của các kiến trúc khác nhau.
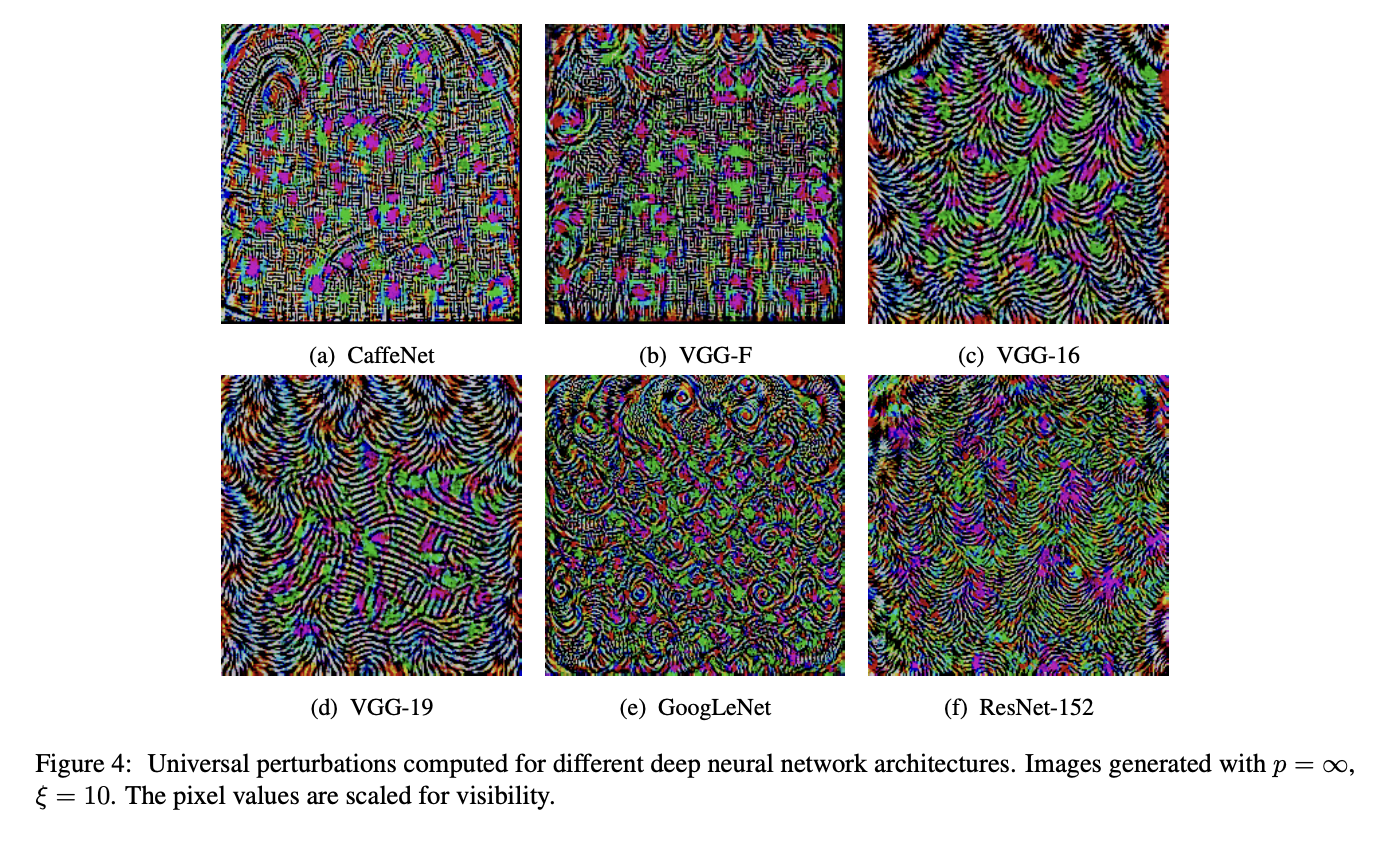
Hình 2: các nhiễu phổ quát được tính toán cho các mạng nơ-ron sâu khác nhau (nguồn: Moosavi-Dezfooli và cộng sự)
Hệ quả của các phát hiện này là không mạng nào an toàn. Bạn có thể tấn công một bộ phân loại không biết trước bằng cách tự huấn luyện mô hình của mình và chạy phương pháp white-box.
Hy vọng cuối cùng là các tấn công này chỉ làm được trong môi trường số. Bạn cần đổi giá trị pixel để chúng hoạt động. Vậy chắc chắn là không thể làm điều này với các mô hình tương tác thế giới thực?
Đừng vội kết luận.
Các nhà nghiên cứu đã phát triển một phương pháp gọi là adversarial patches. Chúng có thể được in ra và đặt vào bất kỳ khung cảnh thời gian thực nào để đánh lừa bộ phân loại ảnh.
Các miếng dán này mang tính phổ quát vì có thể dùng để tấn công bất kỳ khung cảnh nào, bền vững vì hoạt động dưới nhiều biến đổi khác nhau, và có mục tiêu vì có thể khiến bộ phân loại xuất ra bất kỳ lớp mục tiêu nào.
T. B. Brown et al.
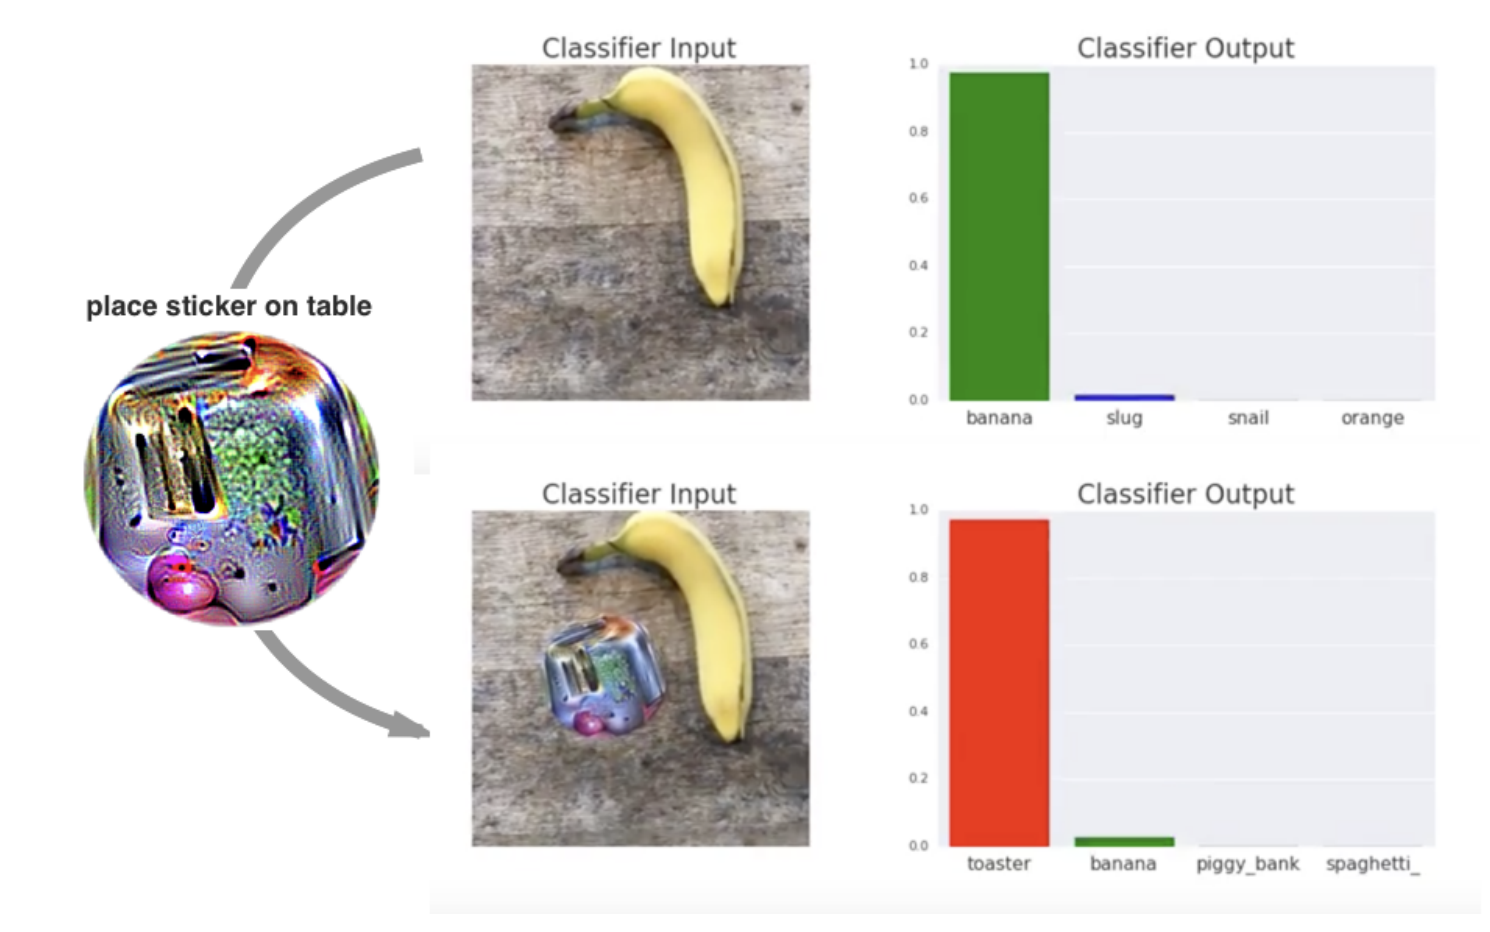
Một miếng dán đối kháng đang phát huy tác dụng (nguồn: T. B. Brown và cộng sự)
Nghiên cứu tương tự cho thấy chúng ta có thể thay đổi dự đoán của biển báo dừng chỉ với vài hình dán và đánh lừa mô hình nhận diện khuôn mặt bằng một cặp kính. Vậy nên, thực sự là không mạng nào an toàn. Để bảo vệ trước tấn công đối kháng, ta chuyển sang nửa còn lại của AML—các phương pháp phòng vệ.
Các cách bảo vệ mạng đa dạng như chính các cách tấn công. Ta có thể điều chỉnh dữ liệu huấn luyện, quy trình huấn luyện, hoặc bản thân mạng. Như sẽ bàn ở cuối phần này, đôi khi giải pháp đơn giản nhất là không dùng học sâu.
Cách đầu tiên tập trung vào dữ liệu huấn luyện. Huấn luyện đối kháng bao gồm bổ sung ví dụ đối kháng vào bộ dữ liệu huấn luyện để cải thiện độ vững của mô hình trước tấn công. Các ví dụ này được tìm bằng các kỹ thuật tấn công đã nêu. Ý tưởng cốt lõi là cho mô hình “làm quen” với nhiễu đối kháng trong giai đoạn huấn luyện để học cách nhận biết và kháng cự các đầu vào như vậy.
Defenisve distillation liên quan đến việc huấn luyện một mô hình để bắt chước các xác suất đầu ra “mềm” của mô hình khác. Trước tiên huấn luyện một mô hình chuẩn (mô hình thầy) trên dữ liệu gốc. Mô hình thầy tạo nhãn mềm (phân phối xác suất trên các lớp) cho dữ liệu huấn luyện. Sau đó huấn luyện mô hình học trò trên các nhãn mềm này. Kết quả là mô hình có ranh giới quyết định mượt hơn và bền vững hơn trước nhiễu nhỏ.
Che giấu gradient bao gồm nhiều kỹ thuật làm mờ hoặc ẩn gradient của mô hình. Ví dụ, ta có thể thêm một tầng phi khả vi vào mạng, như hàm kích hoạt nhị phân. Điều này biến giá trị đầu vào liên tục thành đầu ra nhị phân.
Chuyển đổi mô hình là một cách che giấu gradient sơ khai. Điều này bao gồm dùng nhiều mô hình trong hệ thống. Mô hình dùng để dự đoán được thay đổi ngẫu nhiên. Nó tạo ra “mục tiêu di động”, vì kẻ tấn công không biết mô hình nào đang được dùng. Họ cũng sẽ phải xâm phạm tất cả mô hình để tấn công thành công.
AML có liên quan đến một lĩnh vực khác trong AI: Trí tuệ nhân tạo có thể giải thích (XAI). Các phương pháp nhiễu mà ta đã bàn tương tự với những cách dùng để tìm lời giải thích cho cách mô hình dự đoán. Tuy nhiên, điểm tương đồng chủ chốt là mô hình đơn giản không chỉ dễ giải thích mà còn dễ phòng vệ hơn.
Nhiều vấn đề có thể được giải bằng các mô hình đơn giản như hồi quy tuyến tính hoặc logistic. Nhiều cuộc tấn công ta mô tả không hiệu quả hoặc không liên quan với các mô hình này.
Lý do là các mô hình này có khả năng diễn giải nội tại, nghĩa là ta có thể dễ dàng hiểu chúng hoạt động ra sao. Điểm yếu không bị che giấu như trong các kiến trúc học sâu phức tạp. Vì vậy, phòng vệ trực diện là chỉ dùng học sâu khi thật sự cần thiết cho bài toán.
Điều này liên quan đến điểm đã nêu ở đầu bài—AML cũng liên quan đến môi trường an ninh rộng hơn nơi mô hình vận hành. Do đó, nhiều biện pháp phòng vệ bổ sung gắn với môi trường rộng hơn này. Bao gồm việc kiểm tra và làm sạch dữ liệu đầu vào trước khi dùng để huấn luyện mô hình. Các mô hình phát hiện bất thường cũng được dùng để nhận diện ví dụ đối kháng trước khi chuyển vào mạng. Tất cả những điều này đòi hỏi các quy trình vận hành song song với hệ thống AI.
Khi AI và ML ngày càng trở nên trung tâm trong cuộc sống, AML càng trở nên quan trọng. Điều tối quan trọng là các hệ thống đưa ra quyết định về sức khoẻ và tài chính của chúng ta không thể dễ bị đánh lừa. Dù là cố ý hay vô tình. Chắc chắn tôi sẽ không tin một chiếc xe tự hành có thể bị vài hình dán đánh lừa. Một cuộc tấn công như vậy có thể qua mắt tài xế nhưng khiến xe đưa ra quyết định sai và nguy hiểm đến tính mạng.
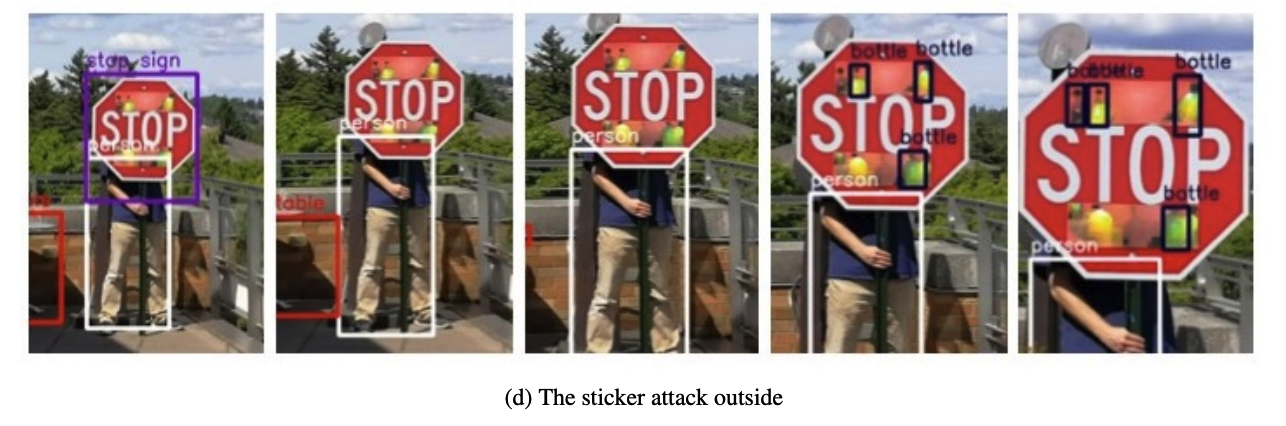 Hình X: Yolo object detection v2 không nhận ra biển báo dừng (nguồn: K. Eykholt và cộng sự)
Khi thiết kế các hệ thống này, ta phải nhận ra AML là một phần của phong trào AI có trách nhiệm lớn hơn. Để cai trị một lâu đài tốt, nhà vua phải hành xử công bằng, biện minh cho các quyết định, bảo vệ quyền riêng tư của dân, và đảm bảo an toàn và an ninh cho họ. AML hướng đến chính hai khía cạnh sau cùng này.
Dù vậy, ta cũng nên nhận thấy an toàn và an ninh về bản chất khác với các khía cạnh khác của AI có trách nhiệm. Công bằng, khả năng diễn giải và quyền riêng tư là thụ động. AML hoạt động trong môi trường nơi các tác nhân xấu chủ động tìm cách phá hoại phương pháp của nó.
Đó là lý do, có phần trái ngược, phần lớn nghiên cứu trong lĩnh vực này nhằm tìm lỗ hổng và các kiểu tấn công. Bao gồm tấn công đầu độc, né tránh, đánh cắp mô hình và suy luận. Cũng bao gồm các phương pháp thực tế hơn để tìm ví dụ đối kháng như FGSM, PGD, C&W và miếng dán đối kháng như ta đã thảo luận.
Mục tiêu là phát hiện chúng trước kẻ xấu. Khi đó có thể phát triển các biện pháp phòng vệ phù hợp như huấn luyện đối kháng, chưng cất phòng thủ và che giấu gradient để vô hiệu hoá các cuộc tấn công trước khi chúng gây hại.
Theo nghĩa này, AML cũng là một phần của cuộc chạy đua vũ trang an ninh mạng lớn hơn. Các lỗ hổng, tấn công và phòng vệ mới sẽ luôn xuất hiện, và các nhà nghiên cứu, chuyên gia AML sẽ cần nỗ lực để đi trước kẻ tấn công đối kháng.
Nếu bạn muốn tham gia cuộc đua này, dưới đây là vài framework Python để bắt đầu:
Trong bài viết này, chúng ta đã tìm hiểu lĩnh vực adversarial machine learning, mục tiêu của nó, các kiểu tấn công khác nhau (đầu độc, né tránh, chiết xuất mô hình và suy luận), và cách các ví dụ đối kháng được dùng để khai thác lỗ hổng mô hình.
Chúng ta cũng đã thảo luận các cơ chế phòng vệ, gồm huấn luyện đối kháng, chưng cất phòng thủ và che giấu gradient, cũng như tầm quan trọng của việc dùng mô hình đơn giản khi phù hợp.
Nếu bạn muốn tìm hiểu thêm về chủ đề này, hãy xem khoá học Giới thiệu về Bảo mật Dữ liệu này.
Tìm hiểu thêm về học máy!
Khóa học
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
