Cours
Prétraitement pour le Machine Learning en Python
4 h
68.3K
Photo par Cederic Vandenberghe sur Unsplash
Un prince banni se tient devant son ancien château. Pour y rentrer, il a tout essayé pour tromper le garde au pont-levis. Il s'est déguisé en paysan, a tenté d'obtenir le mot de passe secret et a voulu remplacer les chevaliers par ses hommes de main. Il a même envoyé vague après vague de soldats à la mort pour comprendre les nouvelles défenses du château. Rien n'a fonctionné. Les défenses sont trop solides, les gardes trop discrets et le processus de vérification des chevaliers trop rigoureux.
Aujourd'hui, les modèles d'apprentissage automatique (ML) font face à des attaques similaires.
Les modèles sont complexes et, bien souvent, nous comprenons mal comment ils produisent leurs prédictions. Cela laisse des failles cachées que des attaquants peuvent exploiter. Ils peuvent amener le modèle à se tromper ou à divulguer des informations sensibles. Des données falsifiées peuvent même corrompre des modèles à notre insu. Le domaine de l'apprentissage automatique adversarial (AML) vise à répondre à ces faiblesses.
Nous allons présenter ce champ et ses objectifs. Cela inclut divers types d'attaques sur les systèmes d'IA, comme l'empoisonnement, l'évasion et l'extraction de modèle. Nous verrons aussi des méthodes pratiques pour générer des exemples adversariaux, au cœur de nombre de ces attaques. Enfin, nous aborderons des stratégies de défense comme l'entraînement adversarial, la distillation défensive et le masquage de gradient. Nous verrons en conclusion comment l'AML s'inscrit dans un mouvement plus large visant à construire des systèmes d'IA responsables.
L'apprentissage automatique adversarial (AML) est un sous-domaine de l'intelligence artificielle et du machine learning. Des attaquants adversariaux manipulent volontairement les données d'entrée pour forcer les modèles à produire des prédictions erronées ou à divulguer des informations sensibles. L'AML vise à comprendre ces vulnérabilités et à développer des modèles plus robustes face aux attaques.
Le domaine couvre à la fois les méthodes de création d'attaques adversariales et la conception de défenses pour s'en prémunir. Il englobe aussi l'environnement de sécurité au sens large — les mesures complémentaires nécessaires lorsque l'on utilise le ML dans des systèmes automatisés.
Ce dernier point est clé car les modèles n'opèrent pas en vase clos. Leurs vulnérabilités peuvent être amplifiées par la façon dont ils sont intégrés au système. Par exemple, il est plus difficile de voler des informations sensibles si les requêtes au modèle sont limitées. Vous pouvez plafonner le nombre de requêtes ou restreindre les types de questions autorisées. Essayez de demander à ChatGPT « donnez-moi vos paramètres ». Cela étant, les attaques décrites dans la section suivante se concentrent sur les modèles et leurs données d'entraînement.
Les attaques varient selon le degré de connaissance que vous avez du modèle. Il est donc important de distinguer les attaques en boîte blanche et en boîte noire.
Boîte blanche : l'attaquant a un accès complet à l'architecture, aux paramètres, aux poids et aux données d'entraînement du modèle. Par exemple, votre entreprise peut propulser son chatbot avec un LLM open source comme Llama 3.1. Ce modèle est librement accessible. Mais ce niveau d'accès est à double tranchant côté sécurité.
D'un côté, il est plus simple pour un attaquant d'identifier des failles. De l'autre, une large communauté scrute le modèle, ce qui augmente les chances de détecter des vulnérabilités avant leur exploitation malveillante.
Boîte noire : l'attaquant a une connaissance limitée du modèle. Pensez à un modèle OpenAI comme GPT-4o mini. L'attaquant ne peut pas accéder à l'architecture interne, aux paramètres ou aux données d'entraînement, et ne peut qu'interagir via des requêtes et observer les sorties. Gardez à l'esprit que, souvent, une connaissance limitée suffit pour une attaque efficace.
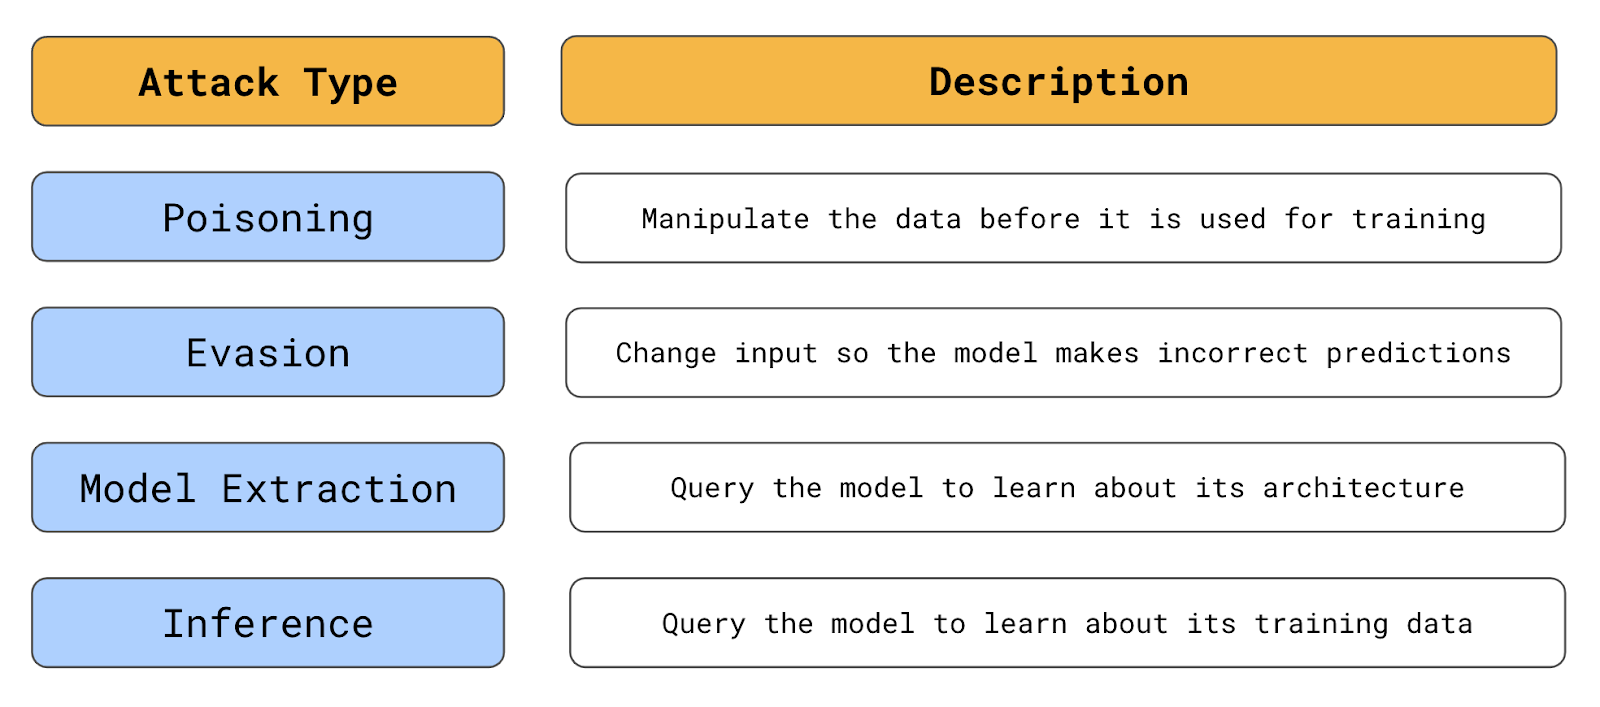
Résumé des types d'attaques adversariales (source : auteur)
Exemple typique : lorsque l'on sait quelles données servent à entraîner un modèle, une attaque par empoisonnement cherche à manipuler ces données. L'attaquant modifie des enregistrements existants ou introduit des étiquettes erronées. Le modèle entraîné sur ces données se trompera ensuite sur des données pourtant correctement étiquetées.
Dans notre analogie, le prince tente de remplacer des chevaliers pour corrompre le processus décisionnel interne du château. En machine learning, un attaquant pourrait, par exemple, réétiqueter des cas de fraude en non-fraude. Il peut cibler des schémas précis, de sorte que lorsqu'il commettra la fraude de la même manière, le système ne la rejettera pas.
Un cas réel d'empoisonnement a touché Tay, le chatbot IA de Microsoft. Conçu pour s'adapter aux réponses reçues sur Twitter, il a très vite été inondé de contenus offensants et inappropriés. En apprenant de ces échanges, il n'a fallu que 24 heures à Tay pour produire des tweets similaires. Tout système s'entraînant à partir de sources publiques court des risques analogues.
Autre facteur de risque : la fréquence de mise à jour du modèle. Dans de nombreuses applications, les modèles ne sont entraînés qu'une fois et sont alors longuement audités, réduisant les opportunités d'empoisonnement. À l'inverse, certains systèmes, comme Tay, sont réentraînés en continu — quotidiennement, hebdomadairement, voire en temps réel — multipliant les occasions d'attaque.
Les attaques par évasion ciblent le modèle lui-même. Elles consistent à modifier des données pour qu'elles paraissent légitimes mais conduisent à une mauvaise prédiction. Comme lorsque notre prince tente de passer pour un paysan devant les gardes.
Précision importante : l'attaquant modifie les données d'entrée utilisées pour prédire, et non les données d'entraînement. Par exemple, lors d'une demande de prêt, un attaquant pourrait masquer son pays d'origine via un VPN. S'il vient d'un pays jugé risqué, la véritable information entraînerait un rejet par le modèle.
Ces attaques sont fréquentes en vision par ordinateur. Des images qui paraissent normales à l'œil humain peuvent induire des erreurs. Par exemple, des chercheurs de Google ont montré qu'un bruit soigneusement choisi pouvait faire basculer la prédiction d'un modèle de classification d'images.
Sur la figure 1, on voit que ce bruit est imperceptible pour un humain. Pourtant, le modèle, qui prédisait initialement « panda », indique désormais à tort « gibbon ».
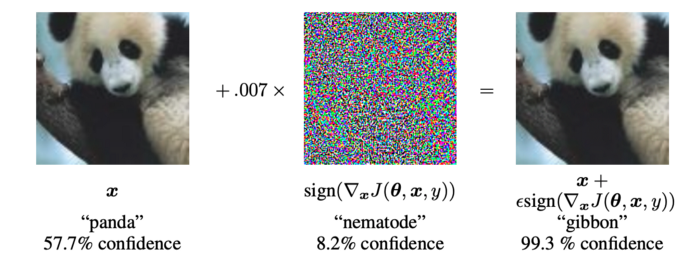
Figure 1 : exemple adversarial (Source : I. Goodfellow et al.)
Dans les attaques de vol/extraction de modèle, l'attaquant cherche à inférer l'architecture et les paramètres du modèle pour le répliquer à l'identique. Cet objectif peut procurer un gain financier direct — par exemple, copier un modèle de trading pour l'exploiter — ou servir à préparer des attaques ultérieures plus efficaces.
L'extraction se fait en interrogeant massivement le modèle et en reliant entrées et sorties. Songez au prince envoyant des soldats : l'un est touché par une flèche, un autre ébouillanté, un groupe écrasé par des rochers. Peu à peu, on comprend les défenses cachées derrière les remparts.
Souvent, l'attaquant ne s'intéresse pas au modèle entier, mais à une information précise, comme un mot de passe. Les attaques par inférence ciblent les données d'entraînement pour extraire des informations confidentielles, soit directement via des requêtes soigneusement formulées, soit par déduction à partir des sorties du modèle.
Ces attaques inquiètent particulièrement les grands modèles de langage (LLM).
Dans l'article Extracting Training Data from Large Language Models, des chercheurs ont montré comment extraire des informations sensibles de GPT-2. À l'aide de requêtes spécifiques, ils ont pu récupérer textuellement des passages des données d'entraînement, y compris des informations privées : données personnelles, conversations, et autres contenus confidentiels.
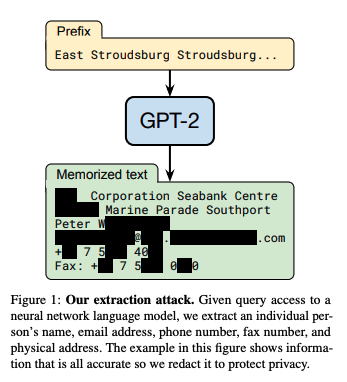
Source : N. Carlini et al.
Les objectifs et procédés diffèrent selon l'attaque, mais un point commun demeure : il faut trouver des cas permettant de piéger le modèle. On parle d'exemples adversariaux.
Les exemples adversariaux sont des entrées spécialement conçues pour tromper les modèles de machine learning. Indiscernables d'entrées légitimes pour un humain, elles contiennent de subtiles perturbations exploitant les failles du modèle.
Ces perturbations sont souvent de petits changements sur les données d'entrée, comme de légères variations de pixels. Bien que minimes, elles poussent l'entrée au-delà de la frontière de décision du modèle, provoquant des prédictions erronées ou inattendues.
Nous avons vu comment un modèle de vision peut être dupé : une image perçue comme un panda par un humain devient un gibbon pour le modèle. La requête ayant extrait des informations sensibles de GPT-2 est aussi un exemple adversarial d'attaque par inférence.
Pour l'extraction, les exemples adversariaux servent à sonder plus finement les frontières de décision. Pour l'empoisonnement, ils sont des données d'entrée destinées à déplacer ces frontières.
Ces exemples fonctionnent car les frontières de décision des modèles peuvent être complexes et fragiles. Les exemples adversariaux exploitent cette fragilité en se plaçant près de ces frontières. De petites perturbations suffisent alors à les franchir et à provoquer une mauvaise classification. Voyons quelques méthodes pour y parvenir.
Ces méthodes utilisent les gradients du modèle pour créer de faibles perturbations menant à des erreurs. L'exemple Panda/Gibbon en est issu. Le bruit semble aléatoire, mais il encode des informations sur la fonction de perte afin de pousser l'image le long d'une frontière de décision lorsqu'on l'ajoute à l'image.
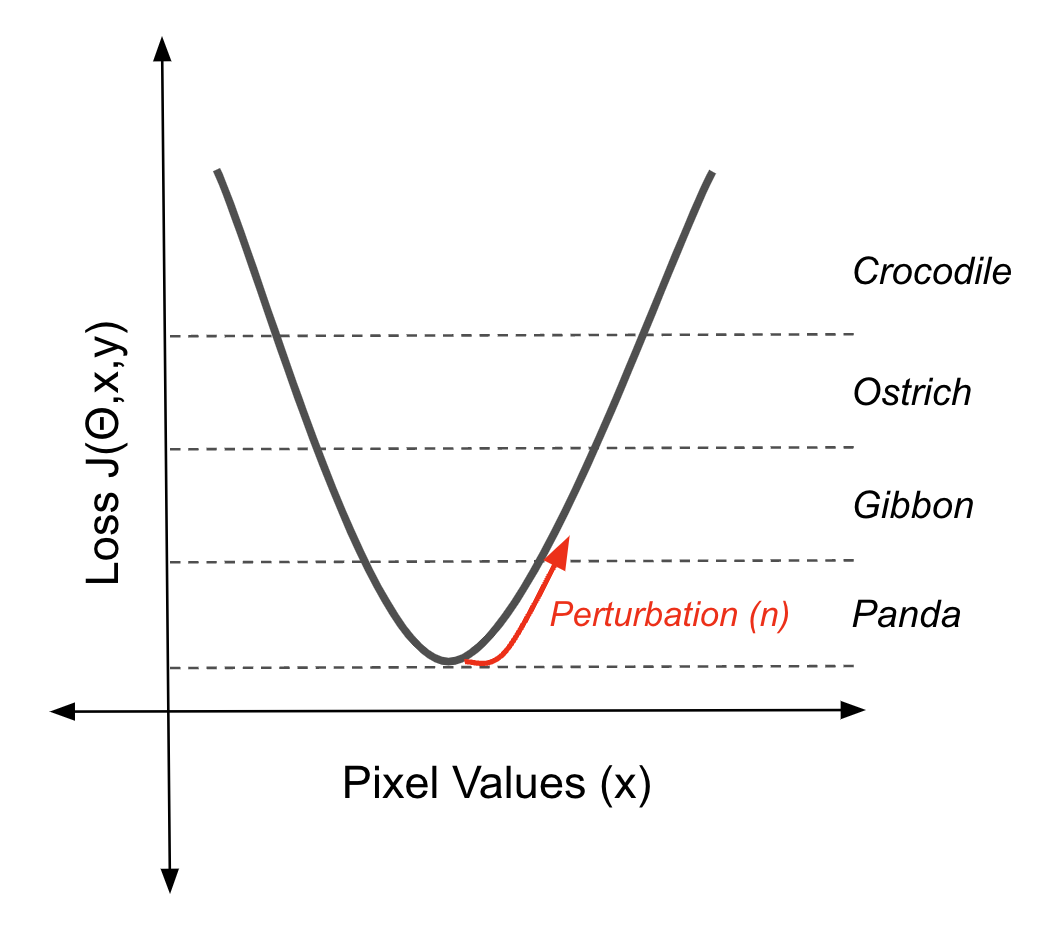
Utiliser le gradient de la fonction de perte pour sortir un point de la frontière de décision (source : auteur)
Cet exemple a été généré avec la Fast Gradient Sign Method (FGSM). Le bruit (η) est calculé en prenant le gradient (∇x) de la fonction de perte (J(θ,x,y)) par rapport aux données d'entrée (x).
Ce gradient indique la direction qui augmente au maximum la perte. FGSM en prend le signe, ce qui ramène la direction à positive ou négative pour chaque pixel, puis la multiplie par un petit facteur (ε). Ce bruit (η) est la perturbation qui, ajoutée à l'entrée d'origine, pousse la prédiction vers une mauvaise classe.
η = ε sign(∇xJ(θ,x,y))
Voyez cela comme l'inverse de la rétropropagation. Cet algorithme exploite les gradients de la perte pour calculer des paramètres menant à des prédictions justes, définissant ainsi des frontières qui classent correctement une image selon ses valeurs de pixels. Ici, nous utilisons les gradients pour faire sortir l'image de ces frontières.
FGSM est une approche simple. D'autres méthodes plus fines existent, comme Projected Gradient Descent (PGD), une méthode itérative qui applique FGSM plusieurs fois avec de petits pas. À chaque itération, le signe des gradients peut changer, modifiant la meilleure direction pour s'éloigner de la frontière. En multipliant les petits pas, PGD trouve des exemples adversariaux avec des perturbations plus faibles que FGSM.
L'attaque de Carlini & Wagner (C&W) aborde le problème autrement. Les attaques précédentes visent n'importe quelle mauvaise classe. C&W cherche la plus petite perturbation (δ) qui, ajoutée à une image, change la prédiction (f(x+δ)) vers une classe cible (t).
min||δ||p s.t. f(x + δ) = t
Pour cela, le problème est formulé en optimisation. En pratique, l'objectif doit être différentiable, d'où l'usage des logits Z(x) du modèle, qui fournissent un gradient lisse indispensable à l'optimisation.
Les attaques ci-dessus supposent un accès complet au modèle. On pourrait croire qu'en gardant secrets les paramètres, on est protégé. Erreur !
Souvent, des estimations de gradients suffisent. Pour FGSM, seule la direction du gradient est nécessaire. Elle peut être estimée via quelques appels à une API renvoyant des probabilités de classes. Pire encore, on peut trouver des exemples adversariaux sans interagir avec le modèle ciblé.
Des chercheurs ont montré que les exemples adversariaux sont transférables. En testant 5 architectures profondes populaires préentraînées, ils ont trouvé que si un exemple trompait quatre modèles, il avait une très forte probabilité — plus de 96 % et jusqu'à 100 % selon l'architecture — de tromper le cinquième.
De même, des exemples adversariaux universels généralisent entre architectures : une perturbation ajoutée à de nombreuses images altère leur prédiction. Surtout, ces perturbations « universelles » sont trouvées en boîte blanche sur un seul réseau. La figure 2 montre leur similarité entre architectures, suggérant des frontières de décision voisines.
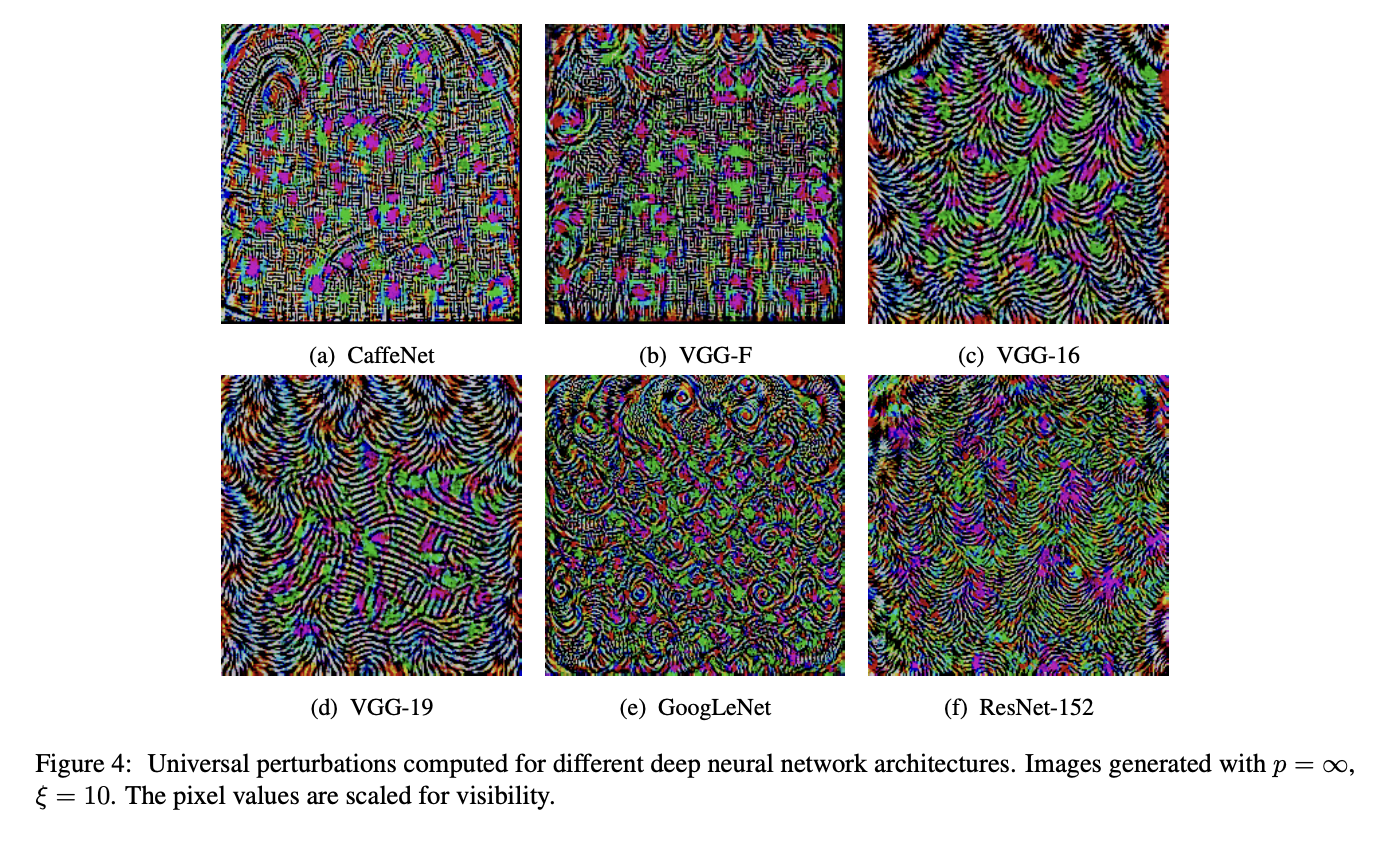
Figure 2 : perturbations universelles calculées pour différents réseaux profonds (source : Moosavi-Dezfooli et al.)
Conséquence : aucun réseau n'est vraiment à l'abri. On peut attaquer un classifieur inconnu en entraînant le sien et en appliquant une méthode boîte blanche.
Dernier espoir : ces attaques ne seraient possibles que virtuellement, en modifiant des pixels. Elles seraient donc inapplicables aux modèles interagissant avec le monde réel ?
Ne vous réjouissez pas trop vite.
Des chercheurs ont mis au point les adversarial patches : des motifs imprimables à apposer dans une scène pour tromper un classifieur d'images.
Ces patchs sont universels, car ils permettent d'attaquer n'importe quelle scène, robustes, car ils résistent à une grande variété de transformations, et ciblés, car ils peuvent forcer le classifieur à produire une classe cible au choix.
T. B. Brown et al.
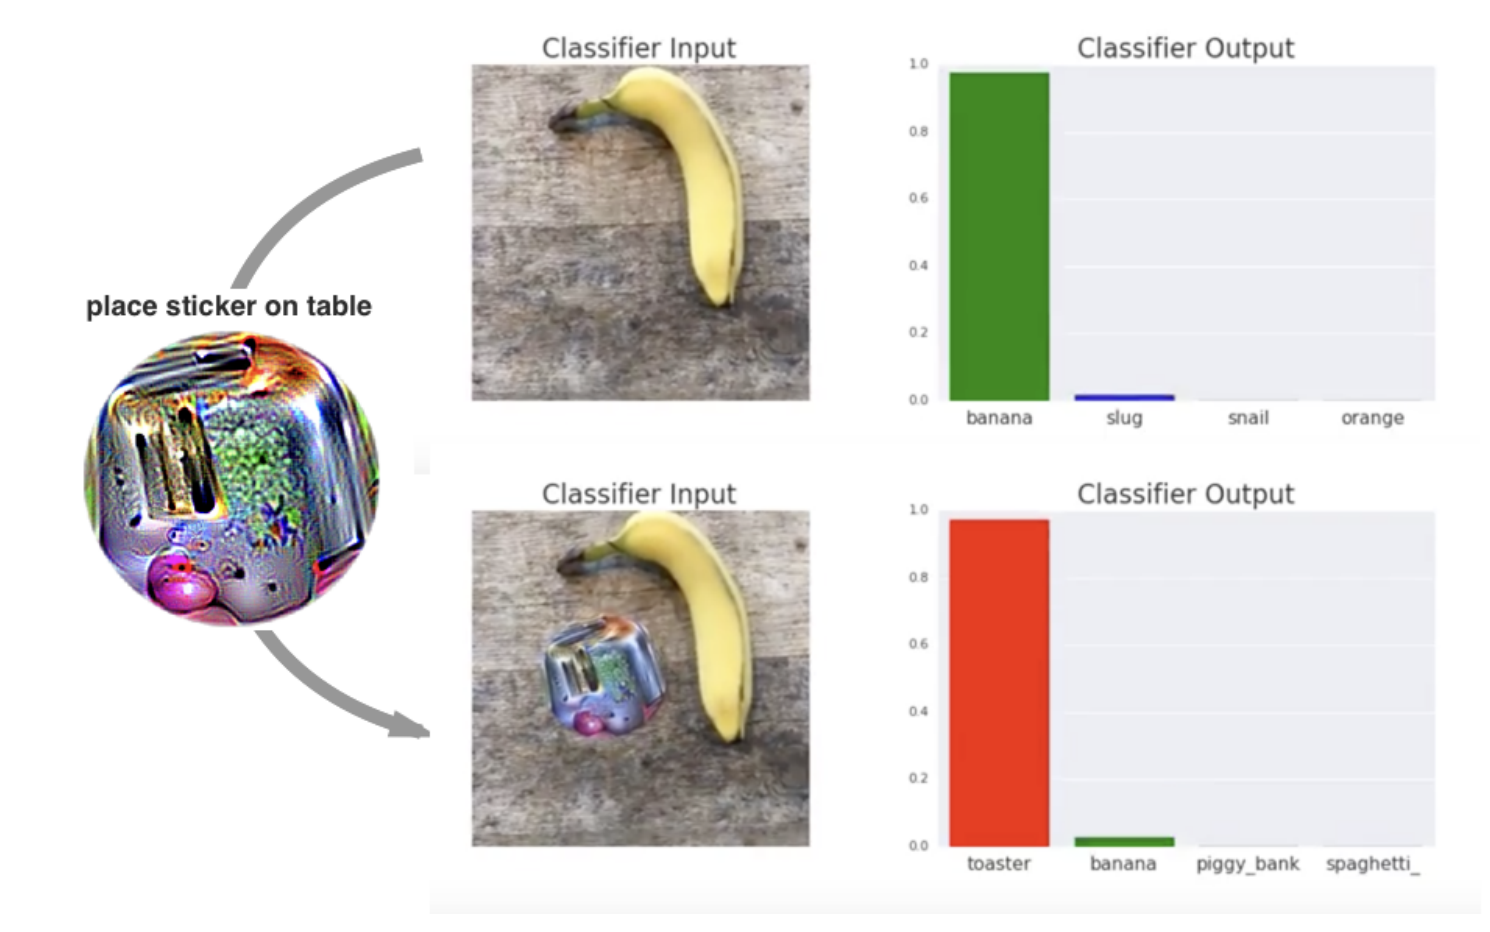
Un adversarial patch en action (source : T. B. Brown et al.)
Des travaux proches ont montré qu'on peut détourner la reconnaissance d'un panneau stop avec quelques autocollants, et leurrer un système de reconnaissance faciale avec une paire de lunettes. Bref, aucun réseau n'est réellement sûr. Pour s'en protéger, passons à l'autre versant de l'AML : les méthodes de défense.
Les défenses sont aussi variées que les attaques. On peut agir sur les données d'entraînement, le processus d'apprentissage, ou l'architecture elle-même. Et parfois, la solution la plus simple est de ne pas utiliser du deep learning du tout.
Cette approche agit sur les données. Elle consiste à enrichir le jeu d'entraînement avec des exemples adversariaux afin d'accroître la robustesse du modèle. Ces exemples sont générés à l'aide des attaques connues. L'idée clé est d'exposer le modèle à ces perturbations dès l'apprentissage pour qu'il apprenne à les reconnaître et y résister.
La distillation défensive consiste à entraîner un modèle à imiter les probabilités « adoucies » d'un autre modèle. On entraîne d'abord un modèle enseignant sur les données d'origine, qui produit des étiquettes souples (distributions de probabilité). Un modèle élève est ensuite entraîné sur ces étiquettes, ce qui lisse ses frontières de décision et le rend plus résilient aux petites perturbations.
Le masquage de gradient regroupe des techniques qui rendent les gradients difficilement exploitables. Par exemple, on peut ajouter une couche non différentiable, telle qu'une fonction d'activation binaire, convertissant des valeurs continues en sorties binaires.
La commutation de modèles est une forme rudimentaire de masquage : utiliser plusieurs modèles et en changer aléatoirement pour la prédiction. La cible devient mouvante, l'attaquant ne sachant pas quel modèle est actif et devant en compromettre plusieurs pour réussir.
L'AML est lié à un autre champ de l'IA : l'intelligence artificielle explicable (XAI). Les techniques de perturbation que nous avons vues sont proches de celles employées pour expliquer les prédictions. Surtout, les modèles simples sont non seulement plus explicables, mais aussi plus faciles à défendre.
Beaucoup de problèmes se résolvent avec des modèles simples comme la régression linéaire ou logistique, face auxquels plusieurs attaques décrites sont inefficaces ou hors sujet.
Ces modèles sont intrinsèquement interprétables : on comprend aisément leur fonctionnement, les faiblesses ne sont pas cachées comme dans des architectures profondes complexes. Une défense évidente est donc de n'utiliser le deep learning que lorsqu'il est réellement nécessaire.
Cela rejoint le point évoqué en introduction : l'AML concerne aussi l'environnement de sécurité dans lequel les modèles opèrent. De nombreuses défenses portent sur cet environnement : valider et assainir les données avant entraînement, ou recourir à des modèles de détection d'anomalies pour identifier des entrées adversariales avant qu'elles n'atteignent le réseau. Ces mesures exigent des processus adjacents au système d'IA.
À mesure que l'IA et le ML gagnent en importance, l'AML devient crucial. Les systèmes qui prennent des décisions touchant notre santé ou nos finances ne doivent pas être faciles à duper, intentionnellement ou non. Je ne ferais certainement pas confiance à une voiture autonome que quelques autocollants suffisent à tromper — une attaque imperceptible pour un conducteur, mais pouvant conduire à des décisions erronées et dangereuses.
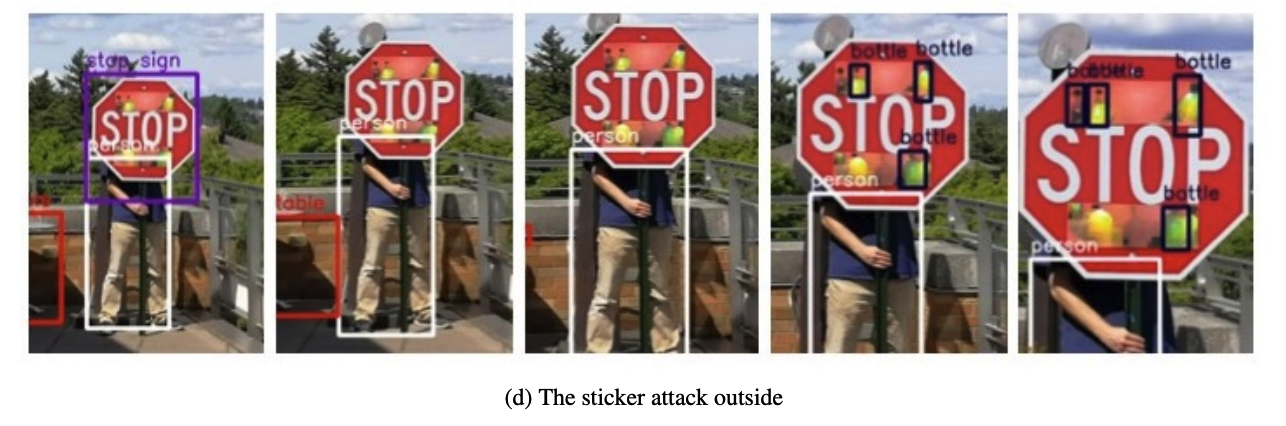 Figure X : Yolo v2 en détection d'objets échoue à reconnaître un panneau stop (source : K. Eykholt et al.)
Dans la conception de ces systèmes, rappelons que l'AML fait partie d'un mouvement plus vaste pour une IA responsable. Pour bien gouverner un château, un roi doit agir équitablement, justifier ses décisions, protéger la vie privée de son peuple et garantir sa sûreté et sa sécurité. Ce sont précisément ces deux derniers aspects que l'AML cherche à adresser.
Notons toutefois que la sûreté et la sécurité diffèrent fondamentalement d'autres dimensions de l'IA responsable. L'équité, l'interprétabilité et la confidentialité sont passives. L'AML, lui, évolue dans un contexte où des acteurs malveillants cherchent activement à le contourner.
C'est pourquoi, paradoxalement, une large part de la recherche vise à découvrir des vulnérabilités et des attaques — empoisonnement, évasion, extraction de modèle et inférence — et des méthodes pratiques pour générer des exemples adversariaux comme FGSM, PGD, C&W ou les adversarial patches dont nous avons parlé.
Le but est de les identifier avant les attaquants. On peut alors développer des défenses adaptées — entraînement adversarial, distillation défensive, masquage de gradient — pour contrer ces attaques avant qu'elles ne nuisent.
En ce sens, l'AML s'inscrit aussi dans la course aux armements de la cybersécurité. Nouvelles failles, attaques et défenses émergeront sans cesse, et les experts AML devront lutter pour garder une longueur d'avance sur les attaquants.
Si vous souhaitez vous lancer, voici quelques frameworks Python pour débuter :
Dans cet article, nous avons exploré l'AML, ses objectifs, les différents types d'attaques (empoisonnement, évasion, extraction et inférence) et l'usage d'exemples adversariaux pour exploiter les vulnérabilités des modèles.
Nous avons également présenté plusieurs mécanismes de défense — entraînement adversarial, distillation défensive, masquage de gradient — ainsi que l'intérêt de recourir à des modèles plus simples lorsque c'est pertinent.
Pour aller plus loin, découvrez ce cours Introduction to Data Security.
Allez plus loin en machine learning !
Cours
Cours
Cours