
课程
Apache Kafka 入门
2 小时
12.1K
实时处理数据会带来巨大的机遇。如果银行检测到我们信用卡的可疑消费,他们可以立刻拦截交易。 或者,当我们搜索产品时,网站在浏览过程中就能弹出相关推荐。 这种速度意味着更好的决策、更满意的客户和更高效的业务。
Apache Kafka 是一个高吞吐量的分布式数据存储,针对实时收集、处理、存储和分析流式数据进行了优化。它允许不同应用发布和订阅数据流,使其能够在事件发生时进行通信并作出响应。
由于能高效管理数据流,Kafka 已经非常流行,应用于从在线购物和社交媒体到银行和医疗等各类系统中。
在应对实时数据流挑战的数据从业者中,Apache Kafka 尤其受欢迎。其流行可以由以下关键因素解释:
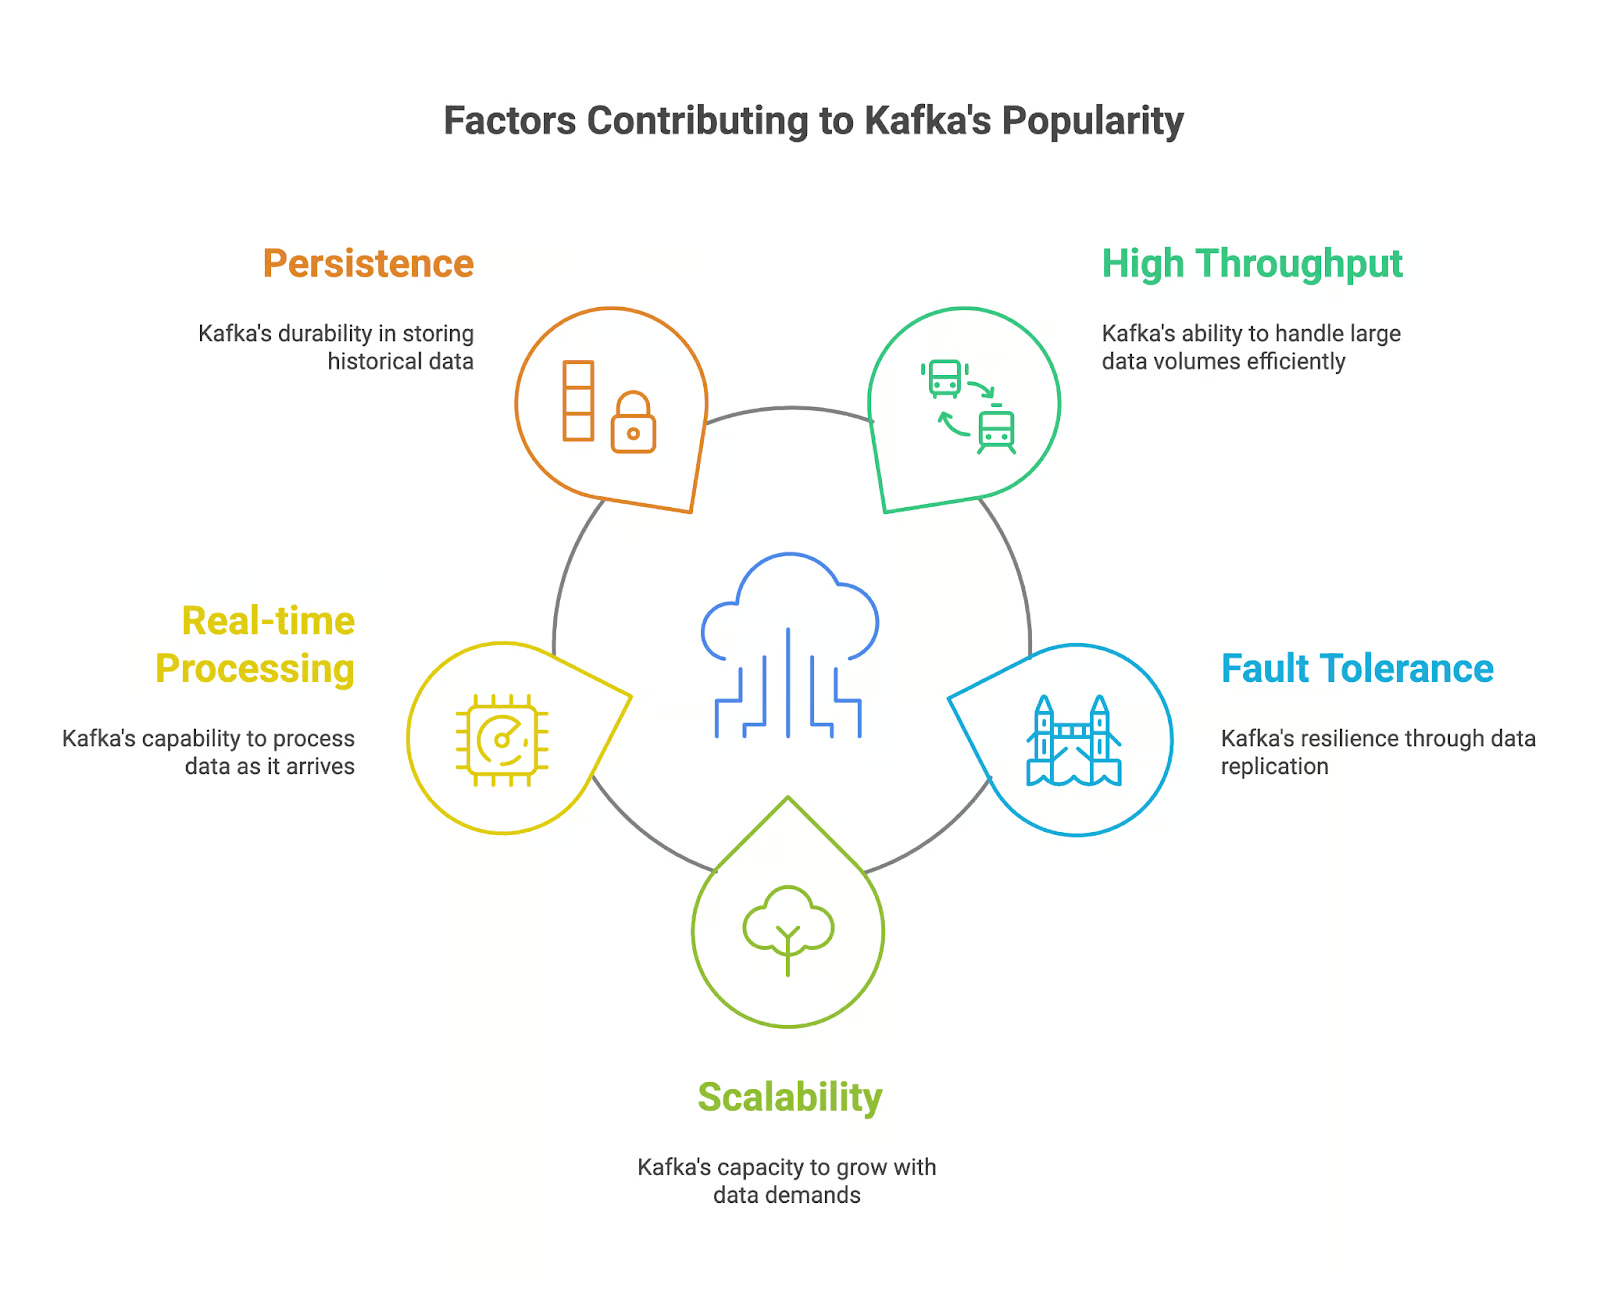
Apache Kafka 目前用于需要实时处理与分析数据的应用。那么,是什么特性让它成为处理流数据的强大工具?我们来看一看:
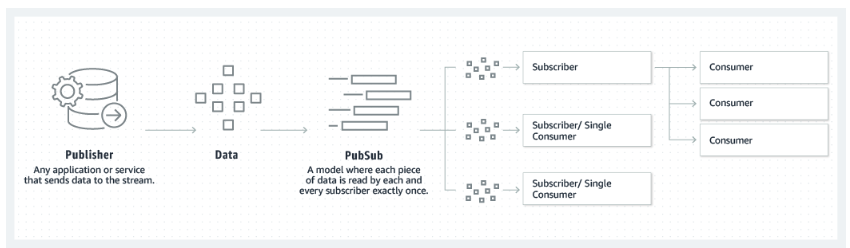
Kafka 依赖的发布-订阅模型。来源: Amazon
学习 Apache Kafka 能让您在那些高频产生与处理数据的雇主与公司中脱颖而出。凭借强大的特性与广泛的应用,Apache Kafka 已成为构建 现代数据架构与应用的关键工具。
我已提到 Kafka 近年来非常流行。据估计,Apache Kafka 目前被《财富》100 强中超过 80%的公司使用。
Kafka 在各行业的使用不断增加,并在实现实时数据解决方案方面发挥作用,使 Kafka 技能在就业市场上价值极高。根据 PayScale 与 ZipRecruiter 数据,截至 2024 年 11 月,在美国具备 Kafka 技能的工程师平均年薪为 100,000 美元。
我们已提到 Apache Kafka 的优势,但让我们看看一些可以应用这些优势的具体场景:
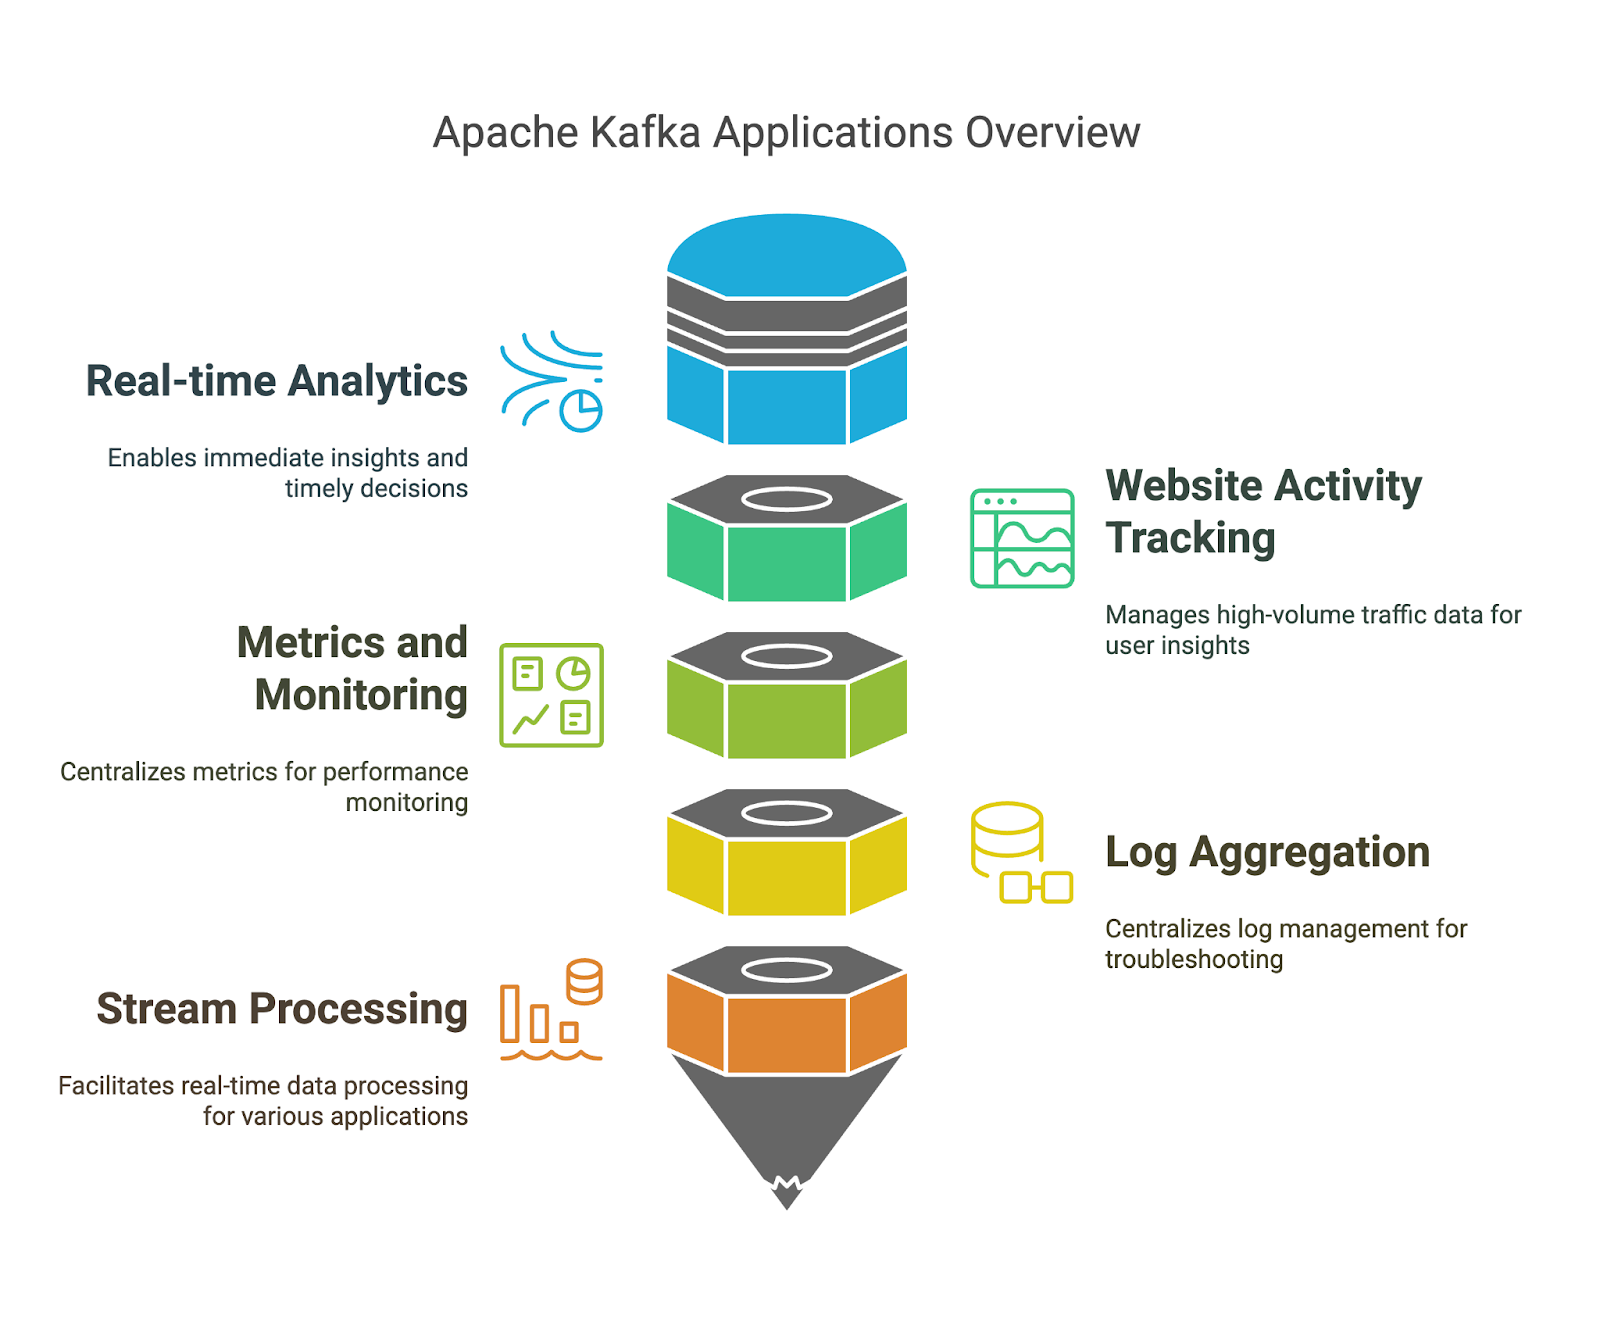
如果以系统的方法学习 Apache Kafka,成功的概率更高。让我们聚焦于学习过程中可遵循的几个原则。
在了解技术细节之前,先明确您学习 Apache Kafka 的动机。自问:
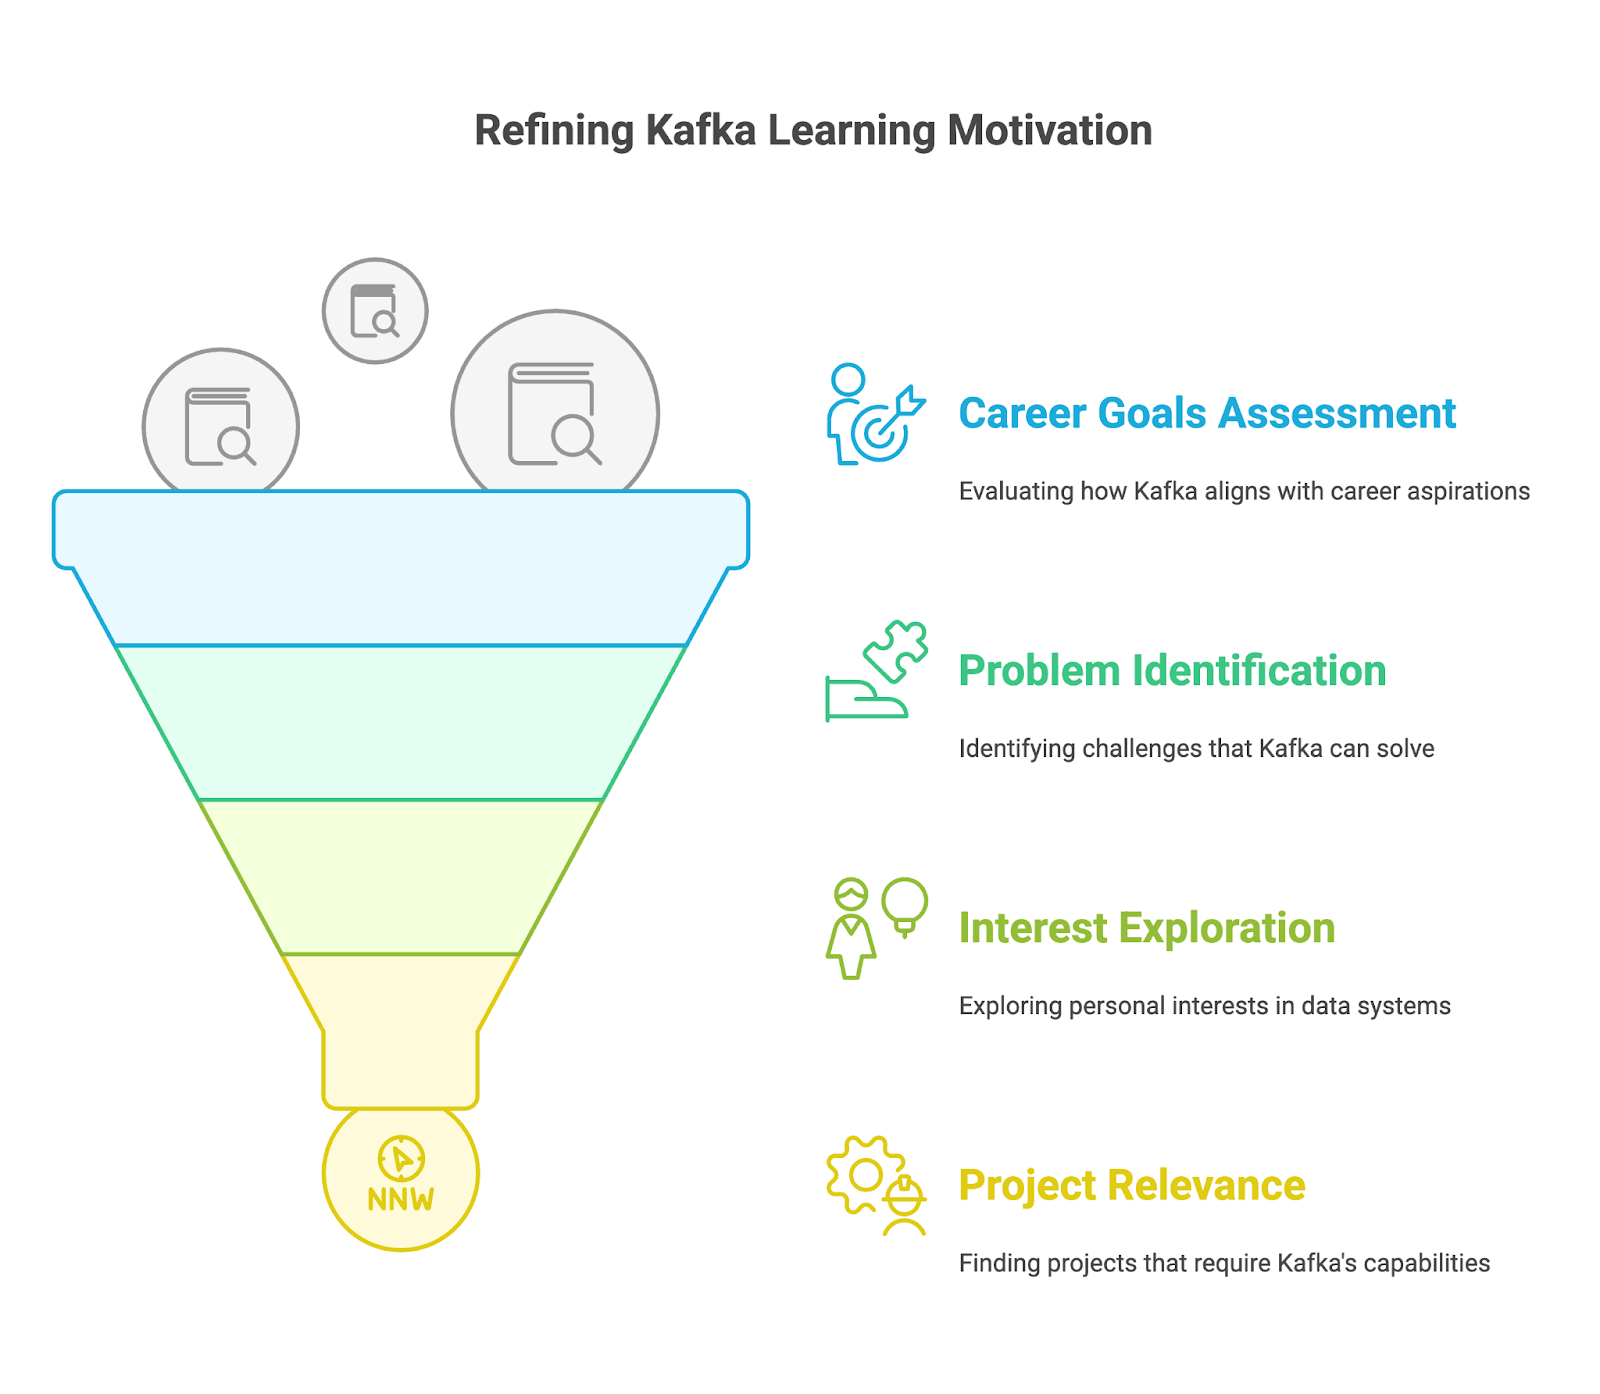
确定目标后,掌握 Kafka 的基础并理解其运作方式。
要学习 Apache Kafka,我们首先需要在本地安装它。由于 Kafka 使用 Java 开发,因此需要确保已安装 Java。接着,从 官网下载 Kafka 二进制文件并解压。
然后先启动 ZooKeeper,再使用提供的脚本启动 Kafka 服务器。最后,我们可以使用命令行工具创建主题,并尝试生产与消费一些消息,以掌握基础。DataCamp 的 Apache Kafka 新手指南 文章可帮助您快速上手。
我们首先应当学习 Kafka 的发布-订阅模型。这是 Apache Kafka 高效处理流数据的关键原因之一。理解生产者如何发布消息、消费者如何订阅这些主题,并只接收与其兴趣相关的消息。
DataCamp 的 Apache Kafka 入门 课程提供介绍,并包含交互式练习与实践示例。
在描述发布-订阅模型时,我们提到了 Kafka 的一些关键组件:生产者与消费者。但还应系统学习所有核心组件。了解 Kafka 如何将数据组织为主题与分区,并理解分区如何促进可扩展性与容错。
还应理解代理如何组成集群以提供高可用性与容错。
查看 DataCamp 的 Apache Kafka 入门 课程以及 Apache Kafka 新手指南文章,以便对这些主题有清晰的认识。
当您对基础已驾轻就熟,就该探索 Apache Kafka 的中级技能了。
Apache Kafka 的关键特性之一是处理大量流数据的能力。Kafka Connect 是 Apache Kafka 的开源免费组件,可简化与文件系统、数据库、搜索索引以及键值存储之间的数据集成。
学习使用 Connect 能帮助我们为分析、应用集成以及构建稳健可扩展的数据架构解锁高效数据流。详见我们的 Apache Kafka 新手指南文章。
Kafka 的另一项高级功能是 Streams。我们应学习如何借助 Streams 在 Kafka 内直接构建流处理应用。它提供 API 与高级领域特定语言,便于处理、转换和评估连续数据流。更多细节请参阅 Apache Kafka 新手指南文章。
如同任何技术,跟踪其性能始终重要。为此,我们应学习如何监控 Kafka 集群的健康状况与性能。探索监控关键指标、管理主题与分区以及确保最佳性能的工具与技术。
参加 Apache Kafka 课程是熟悉该技术的极佳方式。然而,要真正熟练掌握 Kafka,您需要解决具有挑战性、能提升技能的问题,就像在真实项目中会遇到的那样。
您可以先从简单的数据流任务入手,如生产与消费消息,然后逐步增加复杂度,探索如分区、容错,以及使用 Kafka Connect 与外部系统集成等主题。
以下是练习技能的一些方式:
在学习 Apache Kafka 的过程中,您会完成不同的项目。为向潜在雇主展示您的 Kafka 技能与经验,您应将其整理为作品集。该作品集应反映您的技能与兴趣,并针对您所关注的职业或行业进行定制。
尽量让项目具有原创性,展现您的问题解决能力。包含能体现 Kafka 不同方面熟练度的项目,例如使用 Kafka Connect 构建数据管道、使用 Kafka Streams 开发流应用,或运维 Kafka 集群。详尽记录项目的背景、方法、代码与结果。您可以使用 GitHub 托管代码,使用 Confluent Cloud 作为托管 Kafka 环境。
学习 Kafka 是一段持续旅程。技术不断演进,新特性与新应用层出不穷,Kafka 也不例外。
当您掌握了基础后,可以寻找更具挑战性的任务与项目,如高吞吐系统的性能调优、使用 Kafka Streams 实现高级流处理。聚焦于您的目标,在与职业目标和兴趣相关的领域进行专攻。
紧跟最新进展,如新特性或 KIP 提案,并学习如何将其应用到您的项目中。坚持练习,主动寻找新挑战与机会,并以从错误中学习的心态前行。
尽管每个人都有自己的学习方式,但在学习新工具时,拥有一份计划或指南总是明智的。如果您刚开始学习 Apache Kafka,我为您制定了一份潜在的学习计划,概述了应将时间与精力集中在哪些方面。
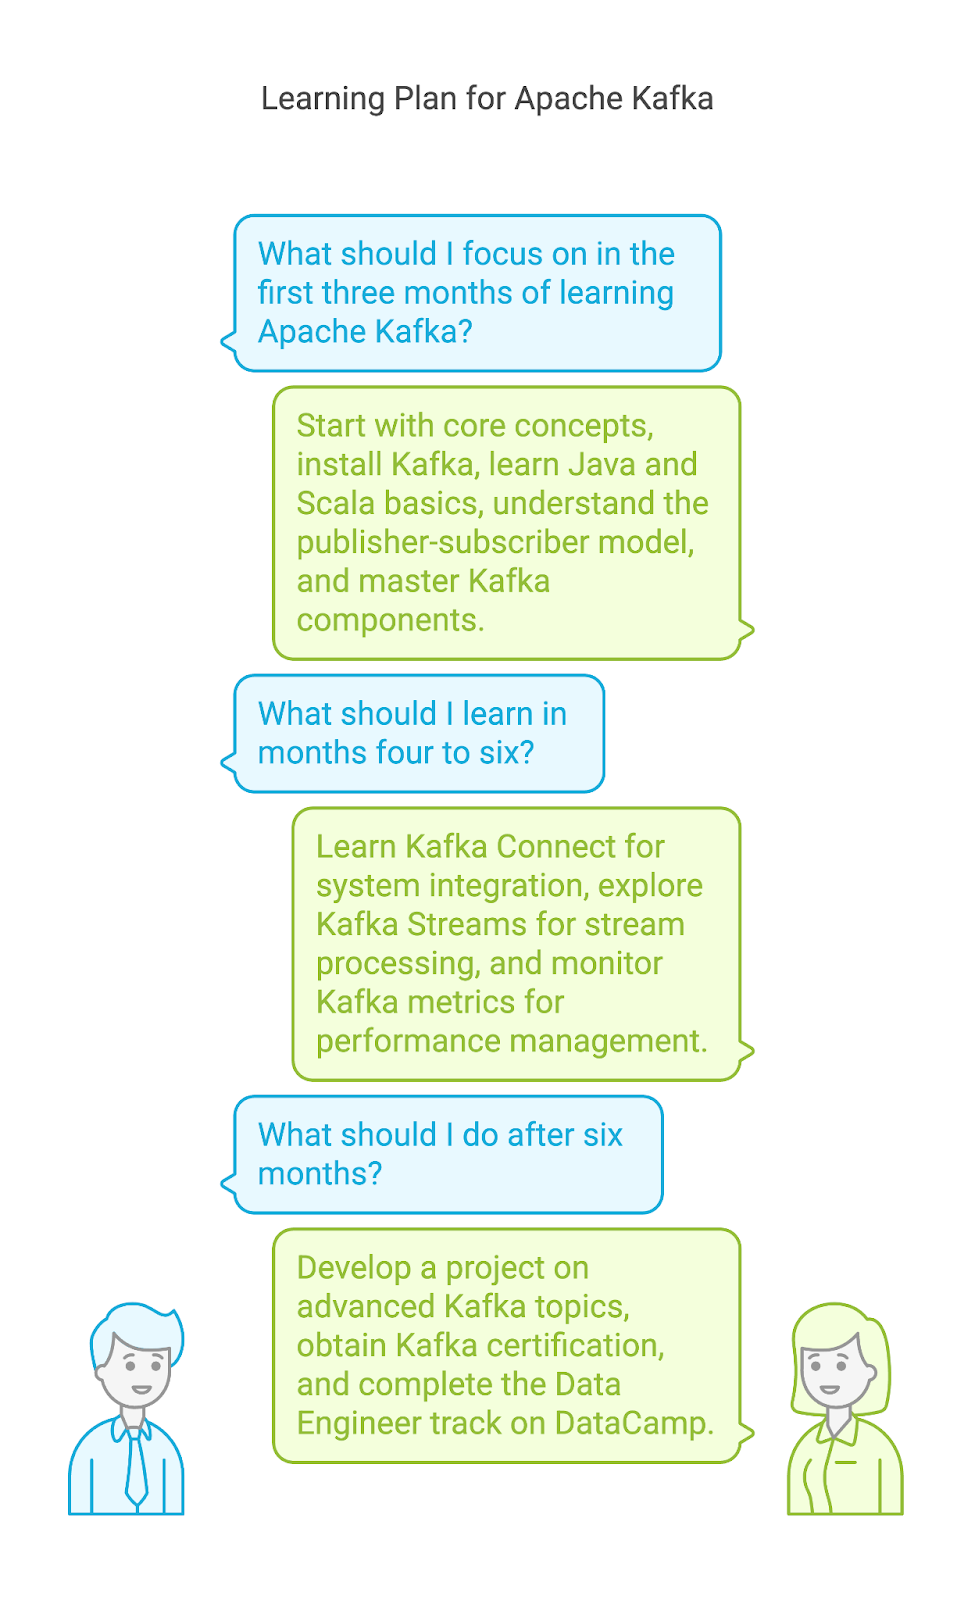
我想您此刻已准备好投入学习 Kafka,并上手大数据集来实践新技能。但在此之前,请先看看这些建议,它们将帮助您更顺利地迈向 Apache Kafka 熟练之路。
Kafka 是一款多面手工具,应用广泛。您应明确自己在 Kafka 生态中的具体目标与兴趣点。Kafka 哪个方面最吸引您?是数据工程、流处理还是 Kafka 运维管理?聚焦能帮助您获取与自身兴趣最相关的知识与要点。
坚持是掌握任何新技能的关键。为 Kafka 学习预留固定时间,即使每天只花短时间也可。无需每天攻克复杂概念,可以多做动手练习、完成教程并尝试不同的 Kafka 功能。练得越多,对平台就越熟悉。
这是最关键的建议之一,本文将多次提及。做练习有助于建立信心,但将 Kafka 技能应用于真实项目,才能让您脱颖而出。
从简单的项目与问题入手,再逐步挑战更复杂的内容。比如先搭建一个简单的生产者-消费者应用,再进阶到用 Kafka Connect 构建实时数据管道,甚至用 Kafka Streams 设计具备容错的流式应用。关键在于不断挑战自我、扩展实践技能。
协作式学习往往更有效。分享经验并向他人学习能加速您的进步并带来宝贵见解。
为交流知识、想法和问题,您可以加入 Apache Kafka 相关的群组,参加线下聚会与大会。您可以加入诸如 Confluent Slack 频道 或 Confluent 论坛,与其他 Kafka 爱好者互动。您还可以参加线上或线下的 聚会(由 Kafka 专家分享)或如 ApacheCon 等大会。
与其他技术一样,学习 Apache Kafka 是一个迭代过程。从错误中学习是其中的重要部分。不要害怕试验、尝试不同方法并从失误中总结。
尝试为 Kafka 生产者与消费者配置不同参数,探索多种数据序列化方式(JSON、Avro、Protobuf),并尝试不同的分区策略。用高消息量将 Kafka 集群“压测到极限”,观察其如何承载负载。分析消费者滞后、微调配置并理解优化对性能的影响。
花时间真正掌握主题、分区、消费者组与 ZooKeeper 角色等核心概念。现在打下坚实基础,将更容易理解高级主题并高效排障。将学习拆解为小步骤,留足时间消化信息。循序渐进往往能带来更深刻的理解与掌握。
我们来介绍几种高效学习 Apache Kafka 的方法。
在线课程让您可以按自己的节奏学习 Apache Kafka。DataCamp 提供一门 Kafka 中级课程。该课程涵盖 Kafka 的核心概念,包括发布-订阅模型、主题与分区、代理与集群、生产者与消费者。
教程是学习 Apache Kafka 的另一种好方式,尤其适合新手。教程包含如何执行特定任务或理解某些概念的分步指导。入门可参考以下教程:
要更深入了解 Apache Kafka 的优势,您还应理解其与其他技术的关键异同。您可以阅读 Kafka 与其他工具对比的文章,例如:
书籍是学习 Apache Kafka 的绝佳资源。它们提供专家的深入知识与见解,配有代码片段与解释。以下是几本最受欢迎的 Kafka 书籍:
随着 Apache Kafka 的采用持续增长,拥有 Kafka 技能的专业人士也迎来更多职业机会,从专职 Kafka 工程师到软件工程师。如果您在评估自己的 Kafka 技能适配度,可考虑以下角色:
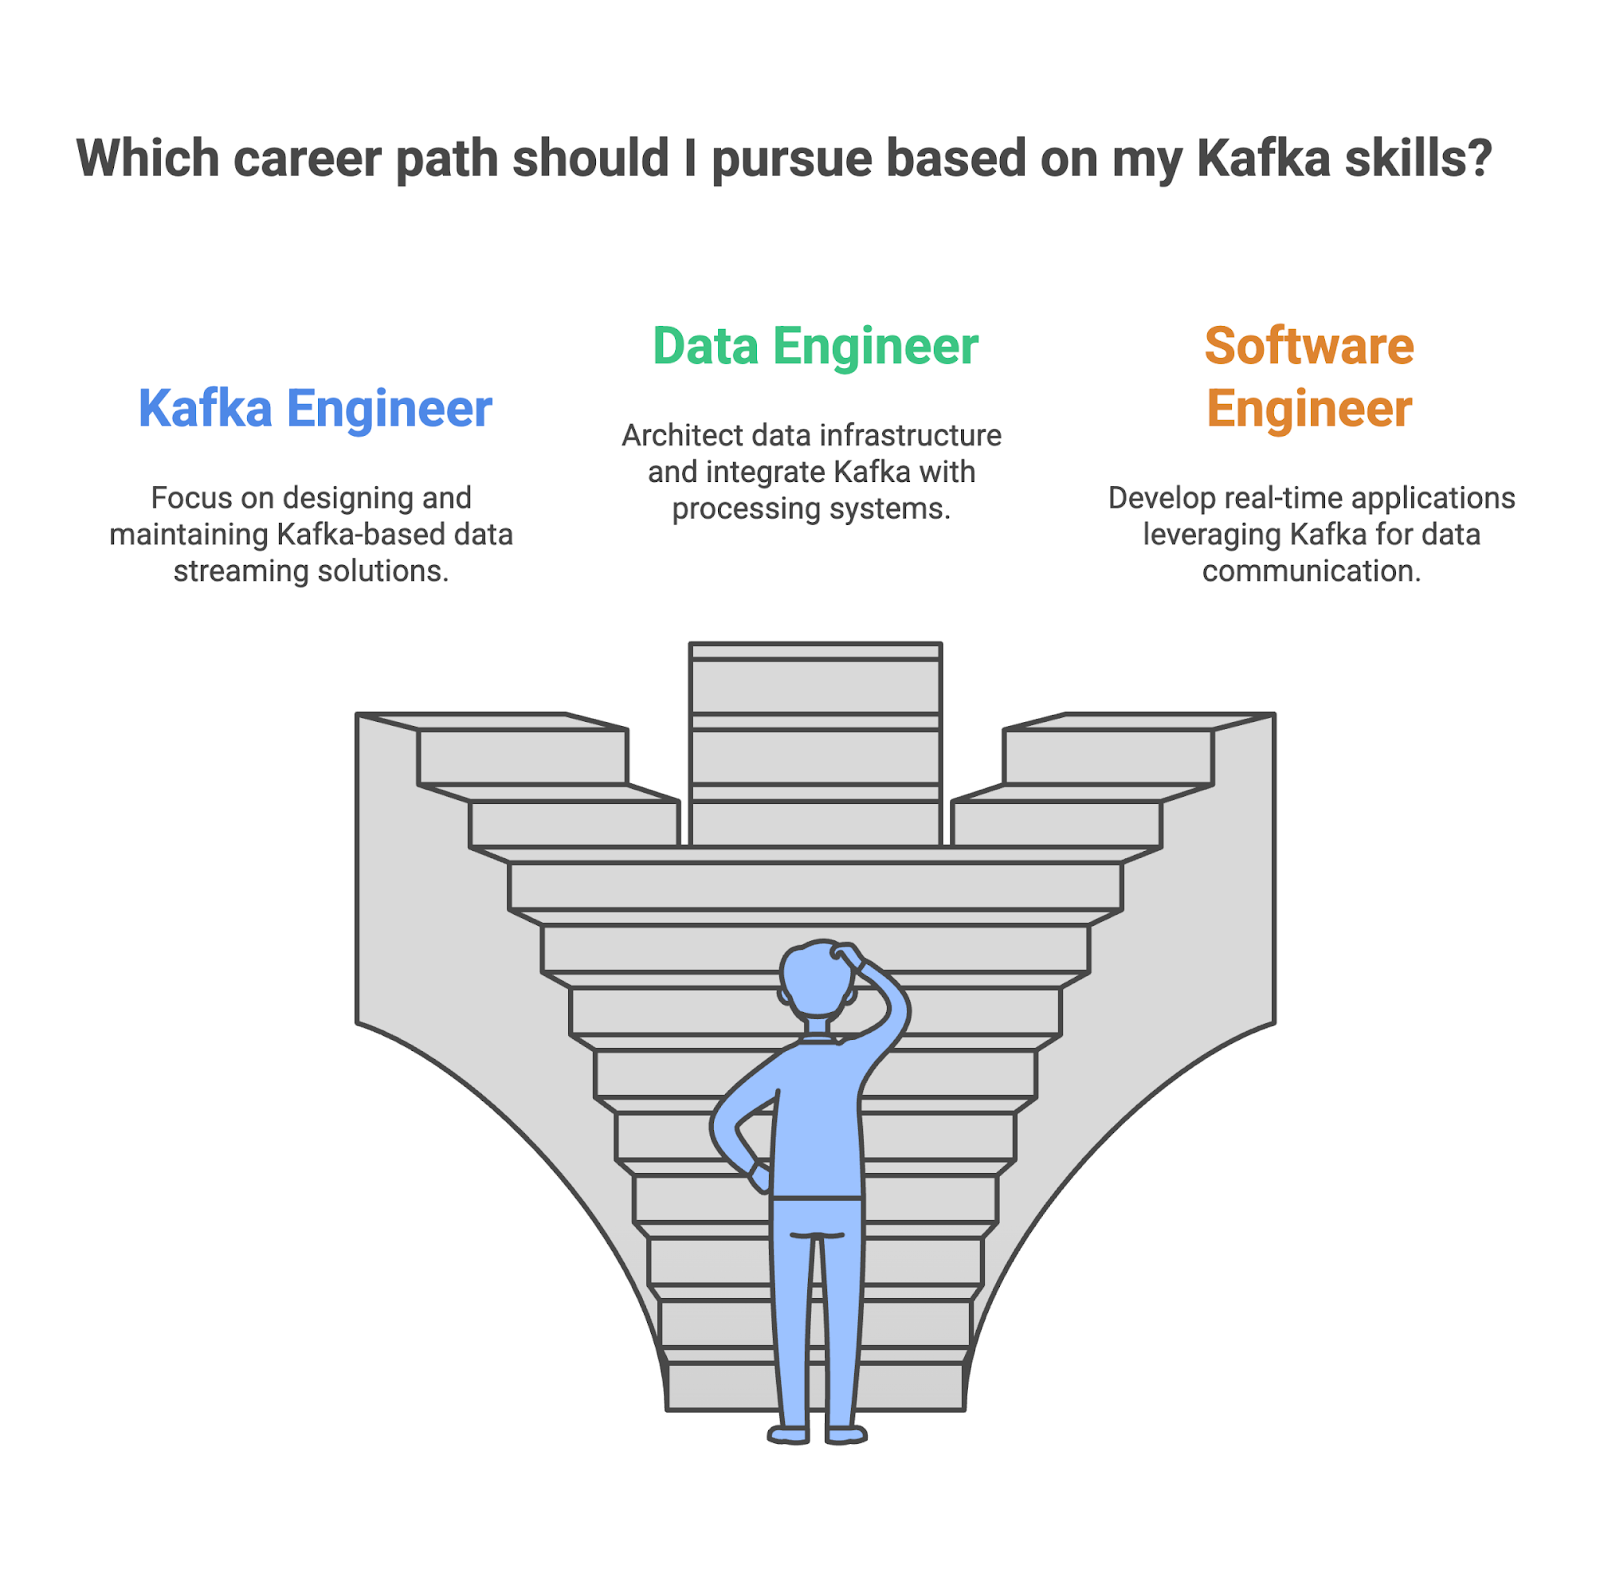
作为 Kafka 工程师,您负责设计、构建并维护具备高可用与可扩展性的基于 Kafka 的数据流解决方案。您需要确保公司内部数据流的可靠与高效,同时监控并优化 Kafka 性能,以确保最佳吞吐与低延迟。
作为数据工程师,您是数据基础设施的架构师,负责设计并构建处理公司数据的系统。Kafka 常在这些数据管道中扮演重要角色,实现不同系统之间高效、可扩展的实时数据流。您需要确保 Kafka 能与其他组件无缝集成。
作为软件工程师,您将使用 Kafka 构建实时应用,如聊天平台和网络游戏。您需要将其集成到应用代码中,通过连接各类消息系统与 API,确保数据流畅通。您还将优化这些应用的可扩展性与性能,使其能够处理大量实时数据。
|
角色 |
工作内容 |
关键技能 |
使用工具 |
|
Kafka 工程师 |
设计并实施具备高可用与可扩展性的 Kafka 集群。 |
Kafka 架构、组件, 管理与配置,流处理概念。 |
Apache Kafka, Kafka Connect, Kafka Streams, ZooKeeper |
|
数据工程师 |
设计并实施数据仓库与数据湖,将 Kafka 与其他数据处理与存储系统集成 |
熟练掌握数据处理工具、具备云平台经验,并了解 Kafka。 |
Apache Kafka, Apache Spark, Hadoop, Hive, 云平台 |
|
软件工程师 |
设计并开发利用 Kafka 实现实时数据通信的应用。 |
编程技能、分布式系统与应用、Kafka 发布-订阅知识。 |
Apache Kafka, Java、Python、Scala, RabbitMQ、ActiveMQ, 开发工具与框架。 |
虽然在从事使用 Apache Kafka 的数据相关岗位时,学历可能很有价值,但这并非成功的唯一途径。越来越多来自不同背景与经验的人开始从事数据相关工作。只要有投入、持续学习与积极主动的态度,您就能获得使用 Apache Kafka 的理想工作。
紧跟 Kafka 的最新发展。在社交媒体上关注参与 Apache Kafka 的意见领袖,阅读 Kafka 相关博客,并收听相关播客。
关注业界人物,例如 Neha Narkhede,她是 Kafka 的共同创建者,也是 Confluent 的 CTO。您将获得有关热门话题、新兴技术与 Apache Kafka 未来方向的洞见。您 还 可以阅读 Confluent 博客,其中提供了从架构与运维到用例与最佳实践等广泛主题的深度文章与教程。
您还应关注行业活动,例如 Confluent 的网络研讨会或年度 Kafka 峰会。
您需要在候选人中脱颖而出。一个有效的方法是建立强有力的作品集,展示您的技能与完成的项目。
作品集应包含能展示您在构建数据管道、实现流处理应用以及将 Kafka 与其他系统集成方面熟练度的项目。
招聘经理需要审阅成百上千份简历,并从中识别优秀候选人。此外,很多时候您的简历会先经过 ATS(候选人追踪系统)的筛选,该自动化系统会淘汰不符合特定标准的简历。因此,您应打造一份优秀简历,并撰写一封 有说服力的求职信,以同时打动 ATS 与招聘人员。
吸引招聘经理的注意
如果您成功引起招聘经理注意,或您的高效简历通过初筛,接下来应准备技术面试。为此,您可以查看这篇关于 数据工程师的 20 道 Kafka 面试题 的文章。
学习 Apache Kafka 能为您打开更好的机会与职业前景。学习 Kafka 的路径是有收获的,但需要坚持与动手实践。通过使用此工具不断尝试并解决问题,可以加速学习过程,并为您在求职时展示实践能力提供真实案例。
通过这些课程学习数据工程!
课程
课程
学习路径