
Cursus
Introductie tot Apache Kafka
2 uur
12.1K
Realtime gegevens verwerken biedt enorme kansen. Als een bank een vreemde aankoop met onze creditcard detecteert, kunnen ze de transactie onmiddellijk stopzetten. Of als we naar een product zoeken, kunnen er tijdens het browsen meteen productaanbevelingen verschijnen. Die snelheid leidt tot betere beslissingen, blijere klanten en een efficiënter bedrijf.
Apache Kafka is een gedistribueerde datastore met hoge doorvoer, geoptimaliseerd voor het verzamelen, verwerken, opslaan en analyseren van streamingdata in realtime. Het stelt verschillende applicaties in staat om datastromen te publiceren en te abonneren, zodat ze kunnen communiceren en reageren op gebeurtenissen terwijl die plaatsvinden.
Doordat het datastreams efficiënt beheert, is Kafka erg populair geworden. Het wordt gebruikt in uiteenlopende systemen, van online shoppen en sociale media tot bankwezen en zorg.
Apache Kafka is populair geworden onder dataprofessionals die de uitdagingen van realtime datastreams moeten tackelen. We kunnen die populariteit verklaren aan de hand van een paar kernfactoren:
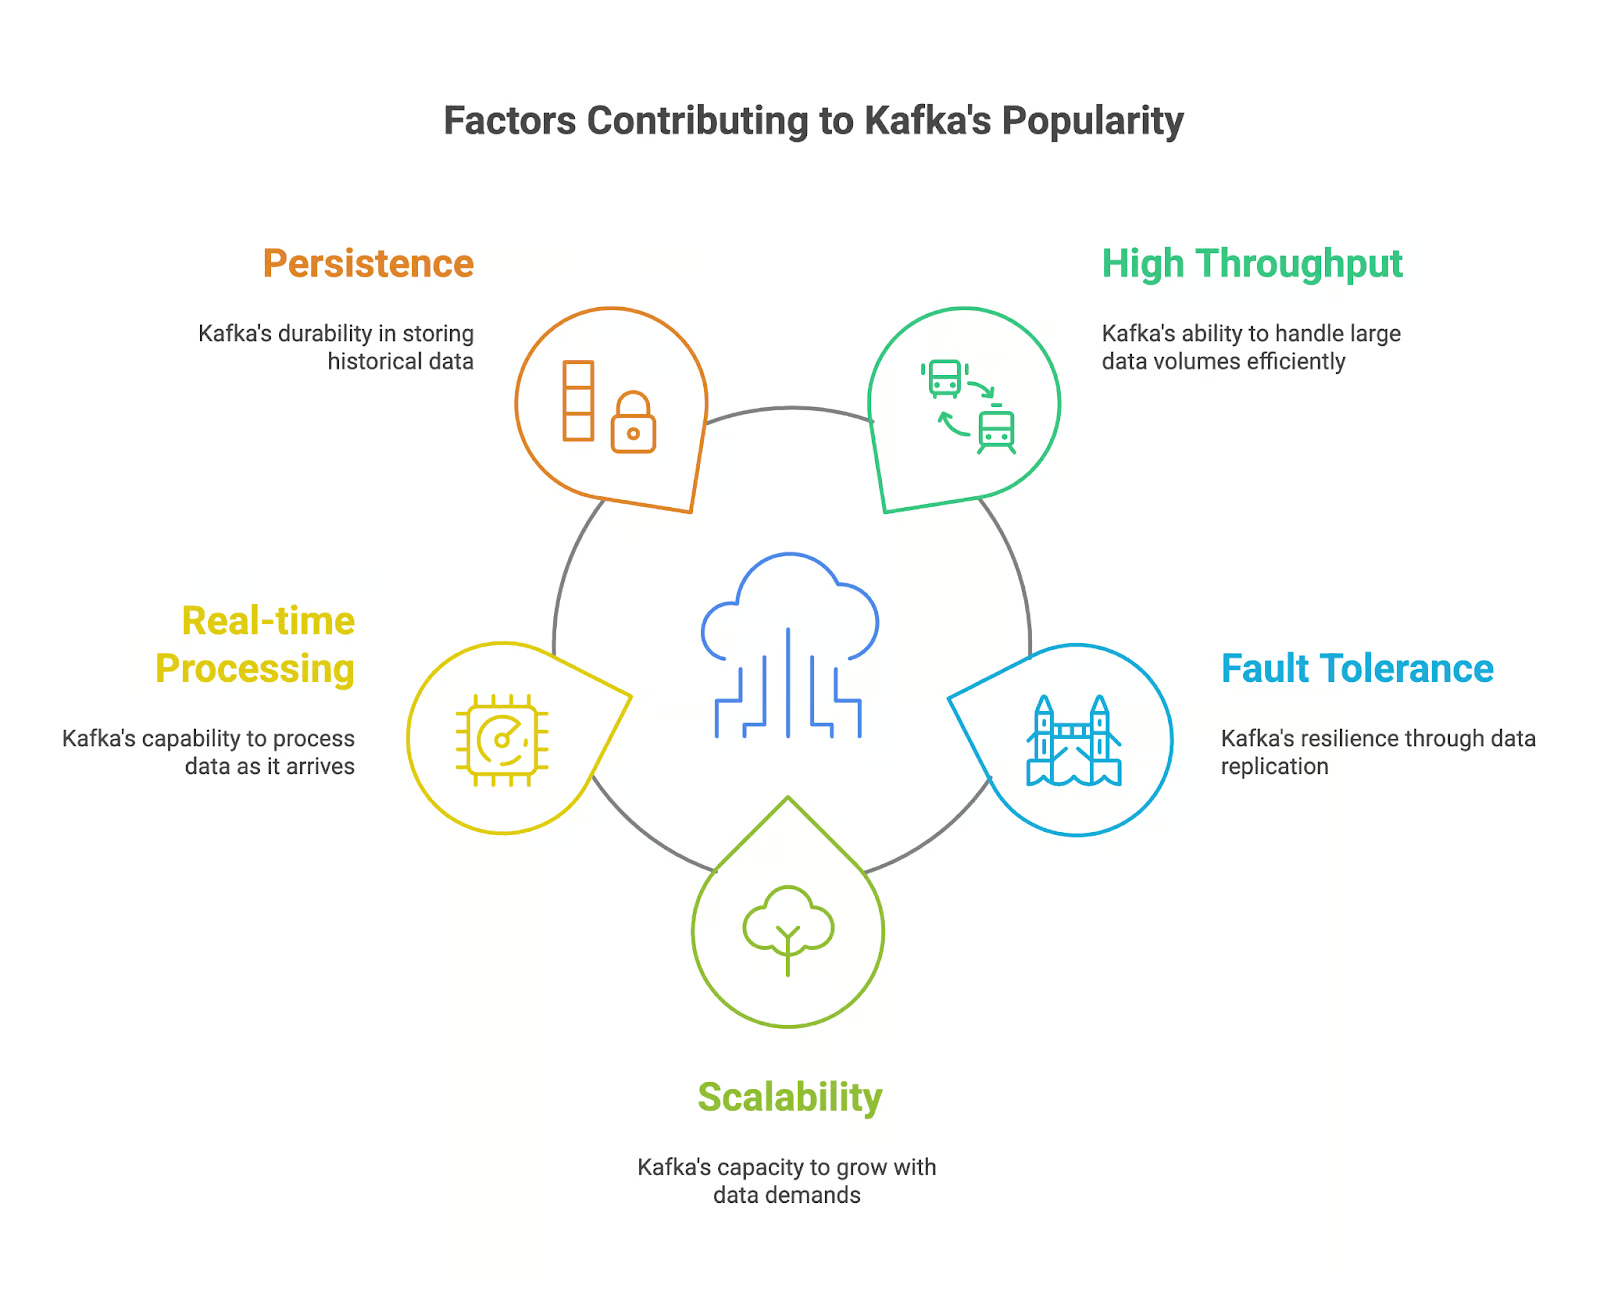
Apache Kafka wordt momenteel gebruikt in applicaties die realtime verwerking en analyse van data vereisen. Maar welke eigenschappen maken het zo krachtig voor het afhandelen van streamingdata? Laten we ze bekijken:
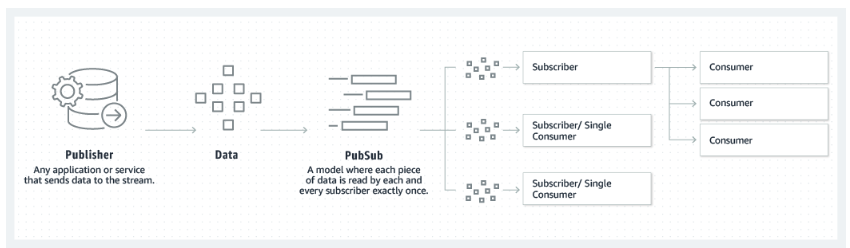
Het publish-subscribe-model waarop Kafka steunt. Bron: Amazon
Apache Kafka leren maakt je een waardevolle kandidaat voor werkgevers en bedrijven die op hoge snelheid data genereren en verwerken. Apache Kafka, met zijn krachtige features en brede inzet, is uitgegroeid tot een sleuteltool voor het bouwen van moderne data-architecturen en applicaties.
Ik noemde al dat Kafka de afgelopen jaren erg populair is geworden. Naar schatting wordt Apache Kafka momenteel gebruikt door meer dan 80% van de Fortune 100-bedrijven.
De toenemende inzet van Kafka in verschillende sectoren, plus de rol bij het mogelijk maken van realtime datasolutions, maakt Kafka-vaardigheden zeer waardevol op de arbeidsmarkt. Volgens PayScale en ZipRecruiter bedraagt in de Verenigde Staten per november 2024 het gemiddelde jaarsalaris van een engineer met Kafka-vaardigheden $100.000.
We hebben de sterke punten van Apache Kafka al genoemd, maar laten we naar een paar concrete voorbeelden kijken waar je ze kunt inzetten:
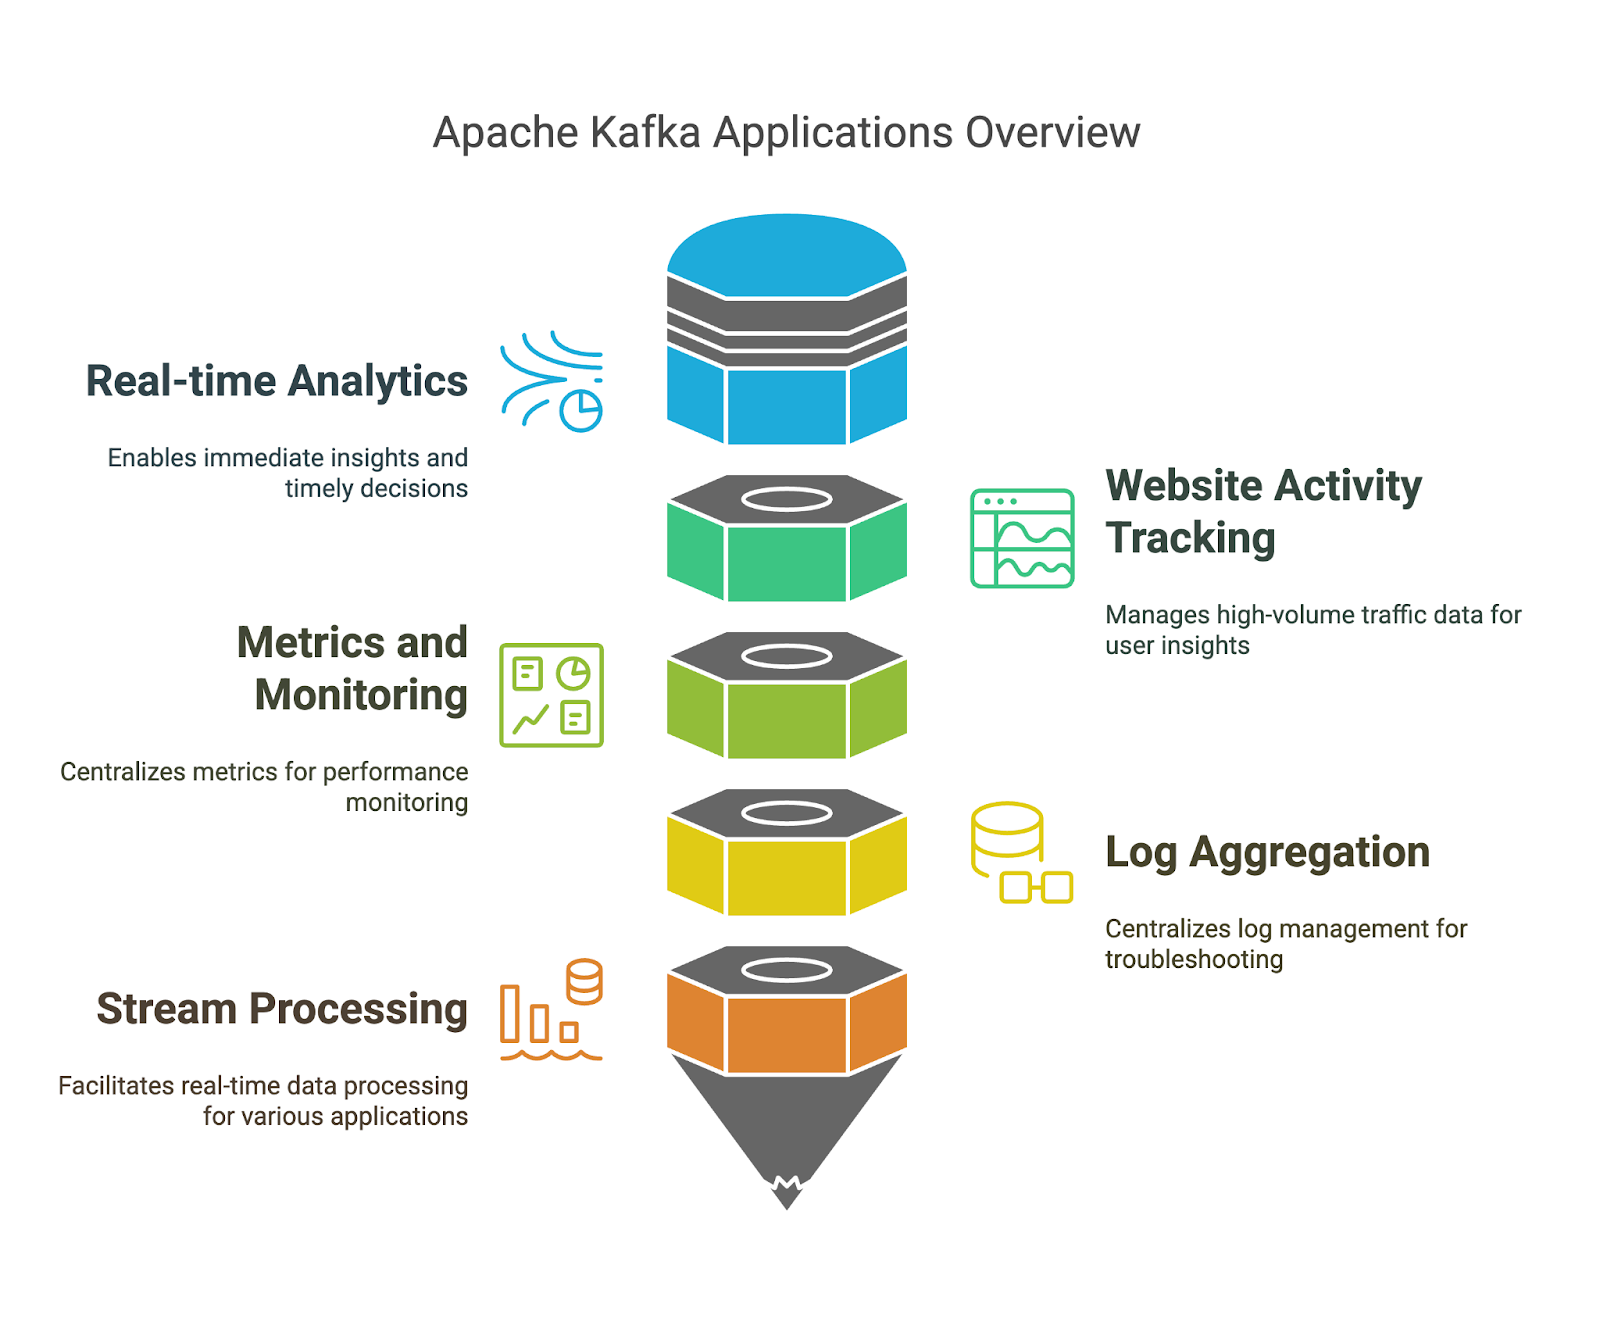
Als je Apache Kafka methodisch leert, vergroot je je kans op succes. Laten we focussen op een paar principes die je kunt gebruiken tijdens je leertraject.
Voordat je de technische details induikt, bepaal je motivatie om Apache Kafka te leren. Vraag jezelf af:
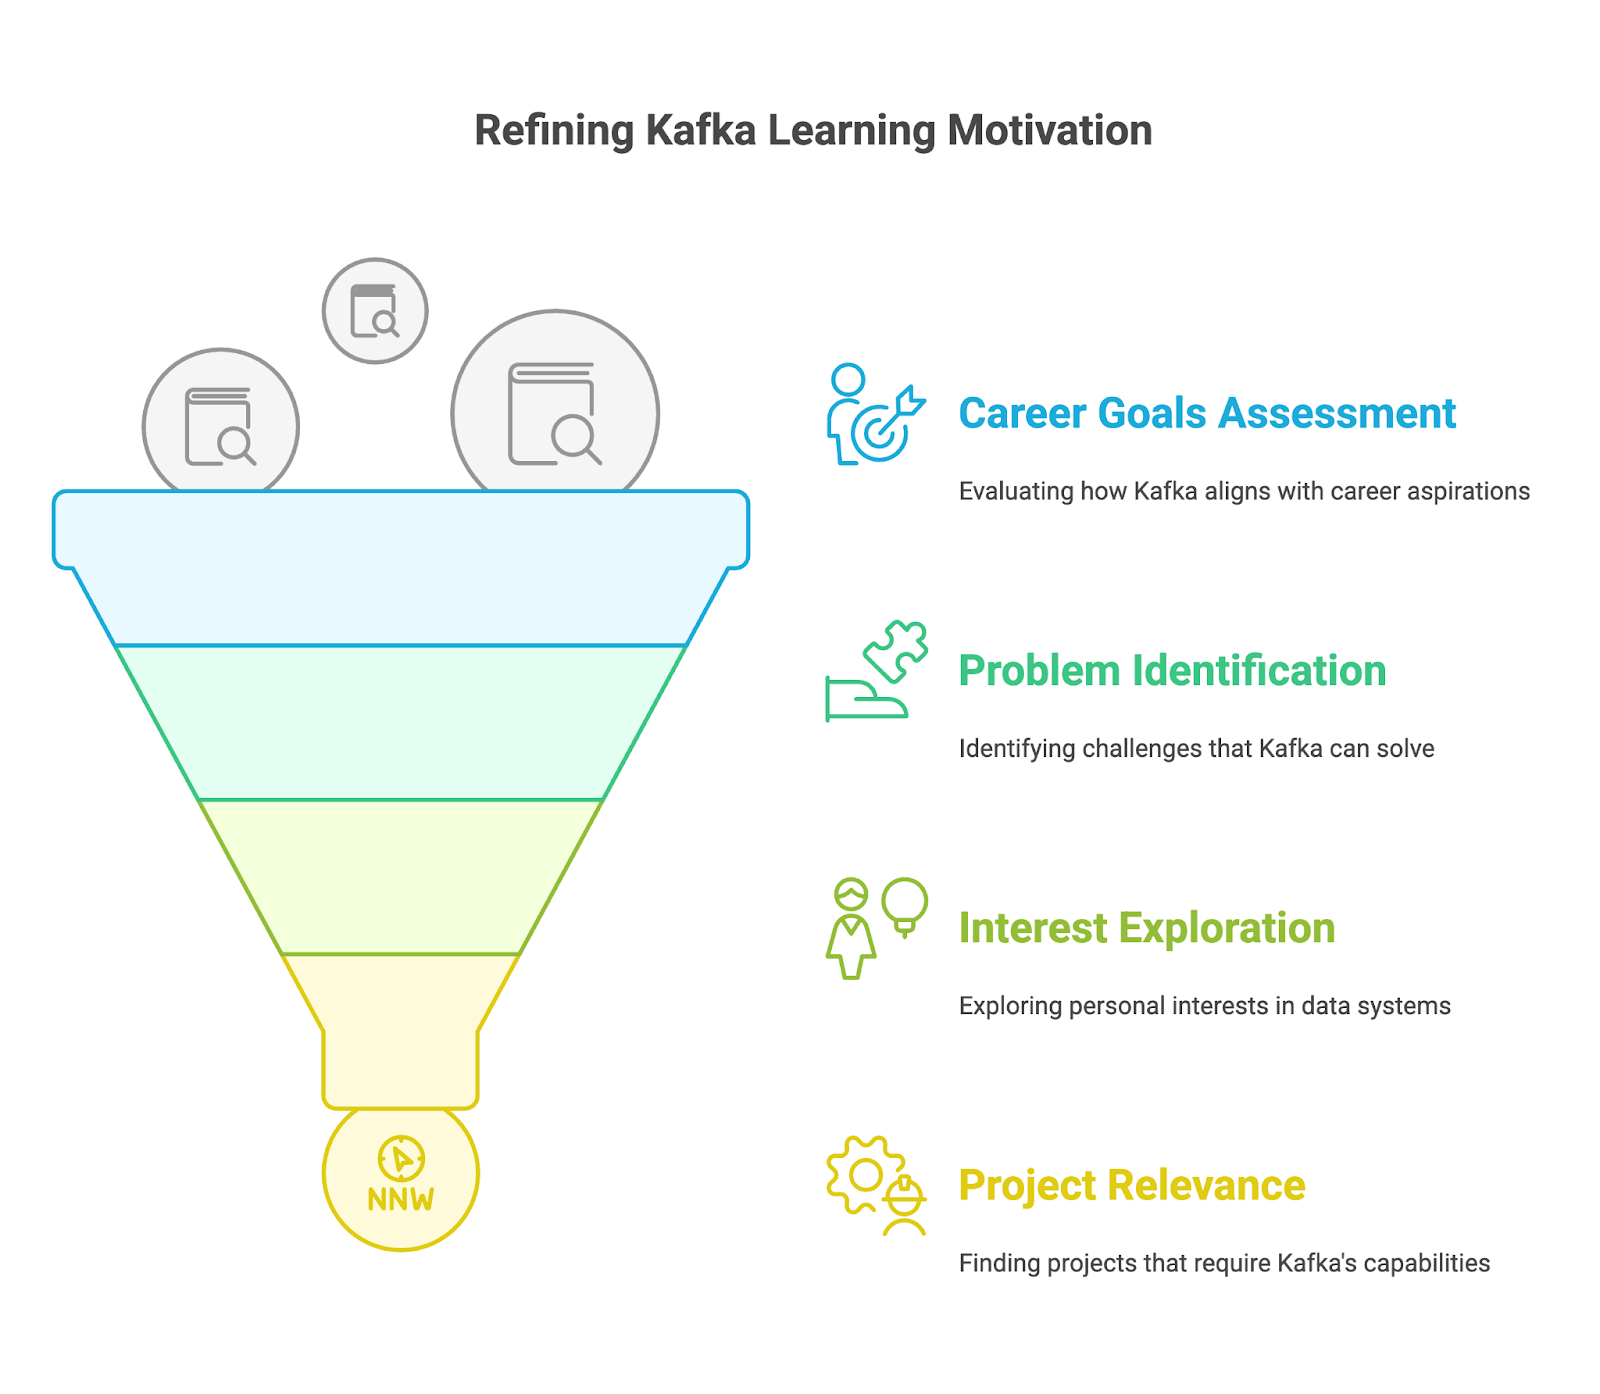
Nadat je je doelen hebt bepaald, beheers je de basis van Kafka en begrijp je hoe die werken.
Om Apache Kafka te leren, moeten we het eerst op onze lokale machine zetten. Omdat Kafka is ontwikkeld met Java, moeten we zorgen dat Java is geïnstalleerd. Vervolgens downloaden we de Kafka-binaries van de officiële website en pakken we ze uit.
We starten nu ZooKeeper en daarna de Kafka-server met de meegeleverde scripts. Tot slot kunnen we met de commandoregeltools topics aanmaken en wat berichten produceren en consumeren om de basis onder de knie te krijgen. Het DataCamp-artikel Apache Kafka for Beginners helpt je snel op weg.
Het eerste concept dat we moeten leren is het publish-subscribe-model in Kafka. Dit is een van de belangrijkste redenen waarom Apache Kafka streamingdata efficiënt kan verwerken. Begrijp hoe producers berichten publiceren en consumers zich op die topics abonneren en alleen berichten ontvangen die voor hen relevant zijn.
De DataCamp-cursus Introduction to Apache Kafka biedt een inleiding met interactieve oefeningen en praktische voorbeelden.
Bij het beschrijven van het publish-subscribe-model noemden we al enkele belangrijke Kafka-componenten: Producer en Consumer. We moeten echter alle kerncomponenten verkennen. Leer hoe Kafka data organiseert in topics en partitions, en begrijp hoe partitions bijdragen aan schaalbaarheid en fouttolerantie.
Begrijp ook hoe brokers samen een cluster vormen voor hoge beschikbaarheid en fouttolerantie.
Bekijk de DataCamp-cursus Introduction to Apache Kafka en het Apache Kafka for Beginners-artikel voor een helder overzicht van deze onderwerpen.
Ben je vertrouwd met de basis, dan is het tijd voor intermediate Apache Kafka-vaardigheden.
Een van de kernfeatures van Apache Kafka is het kunnen verwerken van grote volumes streamingdata. Kafka Connect is een open-source, gratis component van Apache Kafka die dataintegratie tussen bestandssystemen, databases, zoekindexen en keyvaluestores vereenvoudigt.
Leren werken met Connect helpt ons een efficiënte dataflow te realiseren voor analytics, applicatie-integratie en het bouwen van een robuuste, schaalbare data-architectuur. Bekijk ons Apache Kafka for Beginners-artikel voor meer details.
Een andere geavanceerde feature van Kafka is Streams. We moeten leren hoe we met Streams direct binnen Kafka streamverwerkingsapplicaties bouwen. Het biedt API's en een high-level domeinspecifieke taal om continue datastromen te verwerken, transformeren en evalueren. Lees meer in het Apache Kafka for Beginners-artikel.
Zoals bij elke technologie is het goed om de prestaties bij te houden. Leer daarom hoe je de gezondheid en prestaties van je Kafka-cluster monitort. Verken tools en technieken om kernmetrics te volgen, topics en partitions te beheren en optimale performance te waarborgen.
Cursussen over Apache Kafka zijn een uitstekende manier om met de technologie vertrouwd te raken. Maar om echt vaardig te worden in Kafka, moet je uitdagende, vaardigheidsopbouwende problemen oplossen, zoals je die in projecten in de echte wereld tegenkomt.
Begin met eenvoudige streamingtaken, zoals berichten produceren en consumeren, en verhoog geleidelijk de complexiteit door onderwerpen te verkennen als partitioning, fouttolerantie en integratie met externe systemen via Kafka Connect.
Hier zijn manieren om te oefenen:
Tijdens je Apache Kafka-leertraject rond je verschillende projecten af. Om je Kafka-vaardigheden en -ervaring aan potentiële werkgevers te tonen, bundel je die in een portfolio. Dit portfolio moet je vaardigheden en interesses weerspiegelen en aansluiten bij de carrière of sector waarin je actief wilt zijn.
Probeer originele projecten te maken en laat je probleemoplossend vermogen zien. Neem projecten op die je vaardigheid met verschillende aspecten van Kafka aantonen, zoals datapijplijnen bouwen met Kafka Connect, streamingapplicaties ontwikkelen met Kafka Streams of werken met Kafka-clusters. Documenteer je projecten grondig met context, methodologie, code en resultaten. Gebruik platforms zoals GitHub om je code te hosten en Confluent Cloud voor een beheerde Kafka-omgeving.
Kafka leren is een continu proces. Technologie ontwikkelt zich voortdurend, en er komen regelmatig nieuwe features en toepassingen bij. Kafka is daarop geen uitzondering.
Heb je de basis onder de knie, zoek dan uitdagendere taken en projecten, zoals performance tuning voor systemen met hoge doorvoer en geavanceerde streamverwerking met Kafka Streams. Focus op je doelen en specialiseer in gebieden die passen bij je carrièredoelen en interesses.
Blijf op de hoogte van nieuwe ontwikkelingen, zoals nieuwe features of KIP-voorstellen, en leer hoe je die in je projecten toepast. Blijf oefenen, zoek nieuwe uitdagingen en kansen op, en omarm fouten maken als manier om te leren.
Ook al leert iedereen op zijn eigen manier, het is altijd verstandig om een plan of leidraad te hebben voor het leren van een nieuwe tool. Ik heb een mogelijk leerplan opgesteld dat uitlijnt waar je je tijd en energie op kunt richten als je net met Apache Kafka begint.
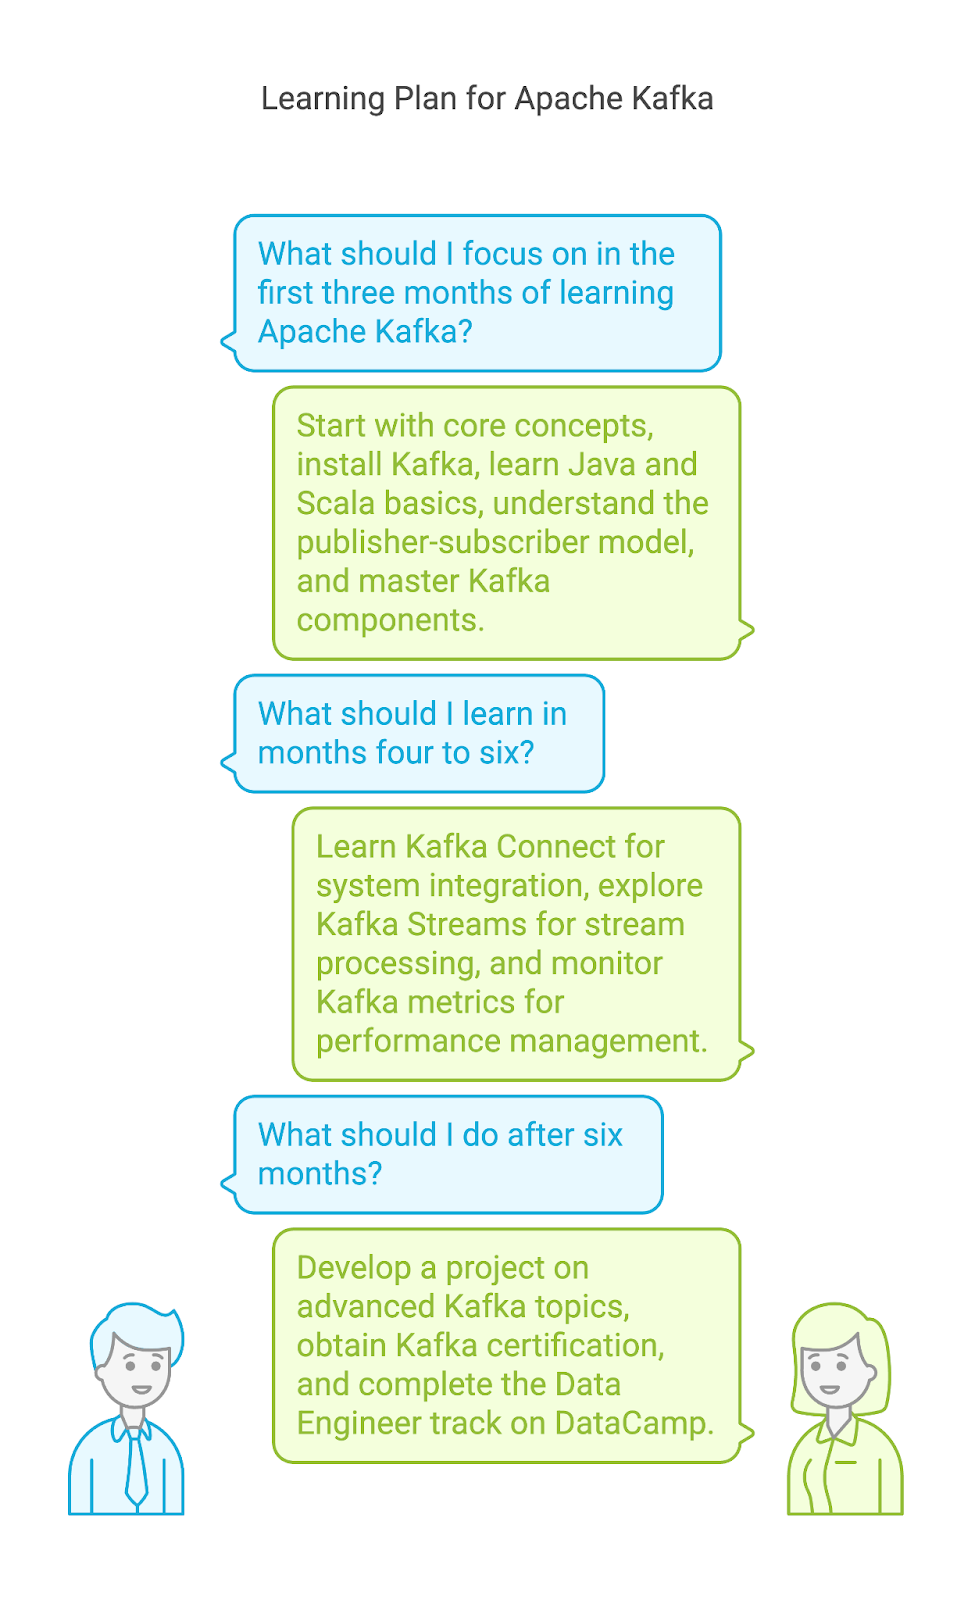
Ik kan me voorstellen dat je inmiddels klaar bent om in Kafka te duiken en met een grote dataset aan de slag te gaan om je nieuwe vaardigheid te oefenen. Maar voordat je dat doet, wil ik deze tips uitlichten die je helpen op weg naar vaardigheid in Apache Kafka.
Kafka is een veelzijdige tool die je op veel manieren kunt gebruiken. Bepaal je specifieke doelen en interesses binnen het Kafka-ecosysteem. Welk aspect van Kafka spreekt je het meest aan? Ben je geïnteresseerd in data engineering, streamverwerking of Kafka-beheer? Een gerichte aanpak helpt je de meest relevante aspecten en kennis van Apache Kafka op te doen die aansluiten bij jouw interesses.
Consistentie is de sleutel tot het beheersen van elke nieuwe vaardigheid. Plan vaste tijd in om met Kafka te oefenen. Al is het maar even elke dag. Je hoeft niet elke dag complexe concepten aan te pakken. Doe praktische oefeningen, werk tutorials door en experimenteer met verschillende Kafka-functies. Hoe meer je oefent, hoe vertrouwder je met het platform wordt.
Dit is een van de belangrijkste tips, en je zult hem meerdere keren in deze gids tegenkomen. Oefeningen doen is prima om vertrouwen op te bouwen. Maar je Kafka-vaardigheden toepassen op realistische projecten is wat je echt laat uitblinken.
Begin met eenvoudige projecten en vragen en pak geleidelijk complexere aan. Dit kan inhouden dat je een eenvoudige producer-consumerapplicatie opzet, vervolgens doorgroeit naar het bouwen van een realtime datapijplijn met Kafka Connect, of zelfs een fouttolerante streamingapplicatie ontwerpt met Kafka Streams. Het belangrijkste is dat je jezelf blijft uitdagen en je praktische Kafka-vaardigheden uitbreidt.
Leren is vaak effectiever wanneer je het samen doet. Ervaringen delen en van anderen leren kan je voortgang versnellen en waardevolle inzichten opleveren.
Om kennis, ideeën en vragen uit te wisselen, kun je je aansluiten bij groepen rond Apache Kafka en meet-ups en conferenties bijwonen. Je kunt je aansluiten bij online communities zoals het Confluent Slack-kanaal of het Confluent Forum, waar je met andere Kafka-liefhebbers kunt praten. Je kunt ook virtuele of fysieke meet-ups bijwonen, met talks door Kafka-experts, of conferenties, zoals ApacheCon.
Zoals bij elke andere technologie is het leren van Apache Kafka een iteratief proces. Leren van je fouten is daar een essentieel onderdeel van. Wees niet bang om te experimenteren, verschillende benaderingen te proberen en te leren van je vergissingen.
Probeer verschillende configuraties voor je Kafka-producers en -consumers, verken diverse methoden voor dataserialisatie (JSON, Avro, Protobuf) en experimenteer met verschillende partitioneringsstrategieën. Drijf je Kafka-cluster tot het uiterste met hoge berichtvolumes en observeer hoe het de belasting aan kan. Analyseer consumer lag, stel configuraties fijn af en begrijp hoe je optimalisaties de prestaties beïnvloeden.
Neem de tijd om kernconcepten echt te begrijpen, zoals topics, partitions, consumergroepen en de rol van ZooKeeper. Als je nu een solide basis legt, wordt het makkelijker om meer geavanceerde onderwerpen te begrijpen en problemen effectief op te lossen. Hak het leerproces in kleinere stappen en gun jezelf tijd om de informatie te laten landen. Een langzame en gestage aanpak leidt vaak tot dieper begrip en beheersing.
Laten we een paar efficiënte methoden behandelen om Apache Kafka te leren.
Online cursussen zijn een uitstekende manier om Apache Kafka in je eigen tempo te leren. DataCamp biedt een intermediate cursus Kafka. Deze cursus behandelt kernconcepten van Kafka, waaronder het publisher-subscriber-model, topics en partitions, brokers en clusters, producers en consumers.
Tutorials zijn een andere geweldige manier om Apache Kafka te leren, vooral als je nieuw bent met de technologie. Ze bevatten stapsgewijze instructies om specifieke taken uit te voeren of bepaalde concepten te begrijpen. Overweeg om te beginnen met deze tutorials:
Om dieper inzicht te krijgen in de voordelen van Apache Kafka, moet je ook begrijpen wat de belangrijkste overeenkomsten en verschillen met andere technologieën zijn. Je kunt artikelen lezen over hoe Kafka zich verhoudt tot andere tools, zoals de volgende:
Boeken zijn een uitstekende bron om Apache Kafka te leren. Ze bieden diepgaande kennis en inzichten van experts, samen met codefragmenten en uitleg. Dit zijn enkele van de populairste boeken over Kafka:
Omdat de adoptie van Apache Kafka blijft groeien, nemen ook de carrièremogelijkheden toe voor professionals met Kafka-vaardigheden, van specifieke Kafka-engineers tot software engineers. Als je wilt bepalen welke rol bij jouw Kafka-vaardigheden past, overweeg dan deze functies:
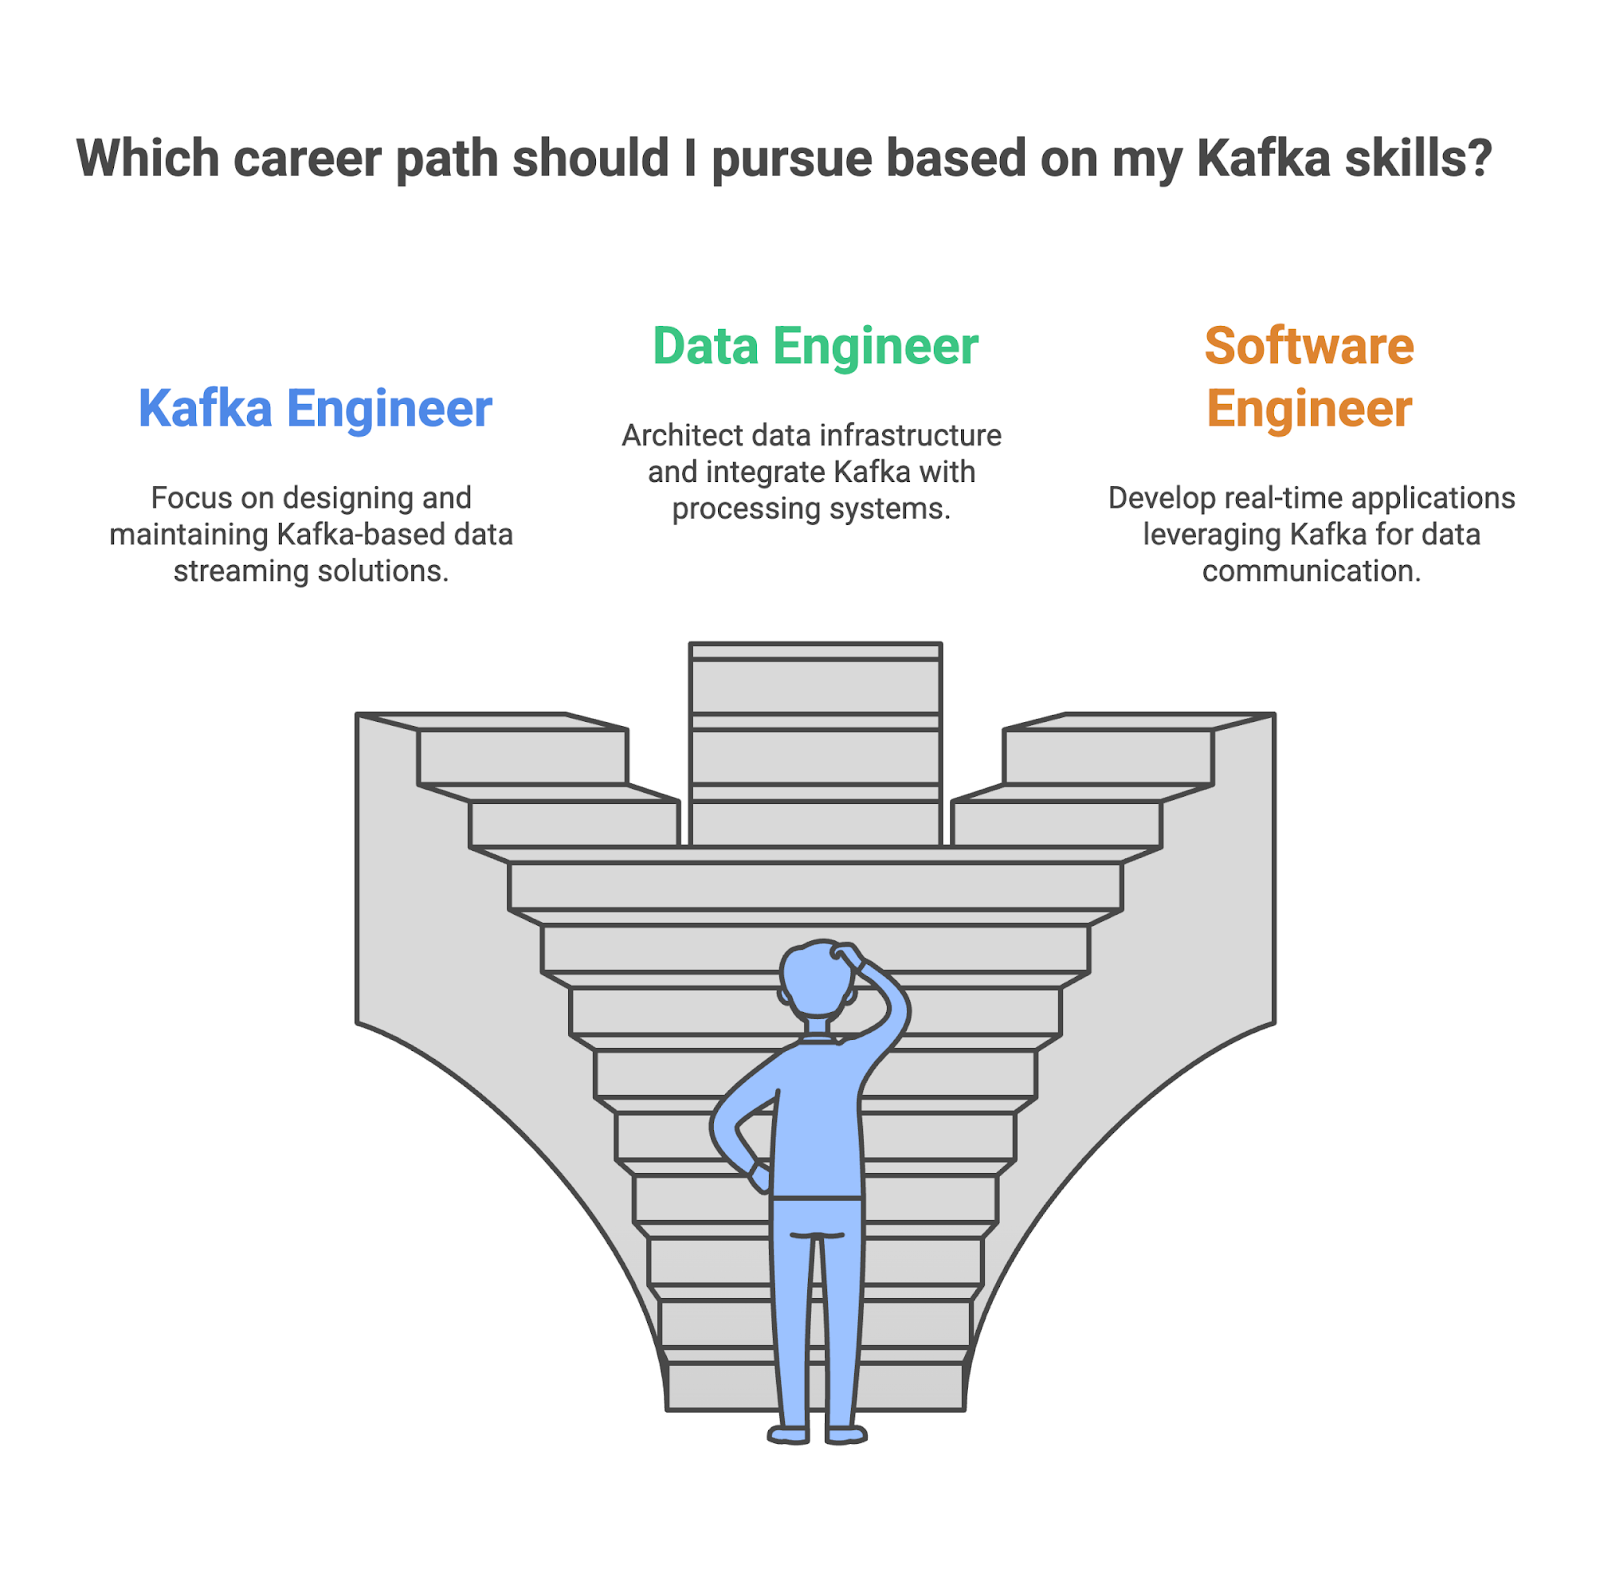
Als Kafka-engineer ben je verantwoordelijk voor het ontwerpen, bouwen en onderhouden van Kafka-gebaseerde datastreamingoplossingen met hoge beschikbaarheid en schaalbaarheid. Je moet zorgen voor een betrouwbare en efficiënte datastroom binnen het bedrijf, en de prestaties van Kafka monitoren en optimaliseren om optimale throughput en latency te garanderen.
Als data engineer ben je de architect van de datainfrastructuur, verantwoordelijk voor het ontwerpen en bouwen van de systemen die de data van een bedrijf verwerken. Kafka speelt vaak een belangrijke rol in deze datapijplijnen en maakt efficiënte en schaalbare realtime datastreaming tussen verschillende systemen mogelijk. Je moet ervoor zorgen dat Kafka naadloos integreert met andere componenten.
Als software engineer gebruik je Kafka om realtime applicaties te bouwen, zoals chatplatforms en online games. Je integreert het in de applicatiecode om een soepele datastroom te garanderen door te koppelen met verschillende berichtensystemen en API’s. Je optimaliseert deze applicaties ook voor schaalbaarheid en prestaties, zodat ze grote hoeveelheden realtime data aankunnen.
|
Rol |
Wat je doet |
Jouw kernvaardigheden |
Tools die je gebruikt |
|
Kafka Engineer |
Ontwerp en implementeer Kafka-clusters voor hoge beschikbaarheid en schaalbaarheid. |
Kafka-architectuur, componenten, beheer en configuratie, concepten van streamverwerking. |
Apache Kafka, Kafka Connect, Kafka Streams, ZooKeeper |
|
Data Engineer |
Ontwerp en implementeer datawarehouses en datalakes, integreer Kafka met andere systemen voor dataverwerking en -opslag |
Vaardigheid met dataverwerkingstools, ervaring met cloudplatforms en kennis van Kafka. |
Apache Kafka, Apache Spark, Hadoop, Hive, Cloudplatforms |
|
Software Engineer |
Ontwerp en ontwikkel applicaties die Kafka benutten voor realtime datacommunicatie. |
Programmeervaardigheden, gedistribueerde systemen en applicaties, kennis van het publisher-subscriber-principe in Kafka. |
Apache Kafka, Java, Python, Scala, RabbitMQ, ActiveMQ, Ontwikkeltools en -frameworks. |
Hoewel een diploma heel waardevol kan zijn als je een carrière nastreeft in een datagerelateerde rol waarin Apache Kafka wordt gebruikt, is het niet de enige weg naar succes. Steeds meer mensen met diverse achtergronden en verschillende ervaringen gaan in datagerelateerde functies werken. Met toewijding, consistent leren en een proactieve aanpak kun je je droombaan vinden waarbij Apache Kafka wordt gebruikt.
Blijf op de hoogte van de laatste ontwikkelingen in Kafka. Volg invloedrijke professionals die betrokken zijn bij Apache Kafka op sociale media, lees blogs over Apache Kafka en luister naar Kafka-gerelateerde podcasts.
Ga in gesprek met invloedrijke figuren, zoals Neha Narkhede, die Kafka mee heeft ontwikkeld en ook CTO is van Confluent. Je krijgt inzicht in trending onderwerpen, opkomende technologieën en de toekomstige richting van Apache Kafka. Je kunt ook de Confluent-blog lezen, met diepgaande artikelen en tutorials over een breed scala aan Kafka-onderwerpen, van architectuur en beheer tot use-cases en best practices.
Bekijk ook branche-evenementen, zoals webinars bij Confluent of de jaarlijkse Kafka Summit.
Je moet opvallen tussen andere kandidaten. Een goede manier om dat te doen is een sterk portfolio op te bouwen dat je vaardigheden en afgeronde projecten laat zien.
Je portfolio moet projecten bevatten die je vaardigheid aantonen in het bouwen van datapijplijnen, het implementeren van streamverwerkingsapplicaties en het integreren van Kafka met andere systemen.
Hiring managers moeten honderden cv’s doornemen en sterke kandidaten onderscheiden. Bovendien worden cv’s vaak door Applicant Tracking Systems (ATS) gehaald, geautomatiseerde systemen die veel bedrijven gebruiken om cv’s te screenen en af te wijzen als ze niet aan specifieke criteria voldoen. Bouw dus een sterk cv en schrijf een indrukwekkende sollicitatiebrief om zowel ATS als je recruiters te imponeren.
Val op bij een hiring manager
Als je in het oog springt bij de hiring manager of je sterke cv door de selectie komt, moet je je vervolgens voorbereiden op een technisch interview. Om klaar te zijn, kun je dit artikel bekijken over 20 Kafka-interviewvragen voor data engineers.
Het leren van Apache Kafka kan deuren openen naar betere kansen en carrièremogelijkheden. Het pad om Kafka te leren is de moeite waard, maar vereist consistentie en praktijkervaring. Experimenteren en uitdagingen oplossen met deze tool kan je leerproces versnellen en je realistische voorbeelden geven om je praktische vaardigheden te laten zien wanneer je naar banen solliciteert.
Leer data engineering met deze cursussen!
Cursus
Cursus
Leerpad
blog
Adel Nehme
15 min

