
Khóa học
Giới thiệu về Apache Kafka
2 giờ
12.3K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleXử lý dữ liệu theo thời gian thực mang lại cho chúng ta nhiều cơ hội. Nếu một ngân hàng phát hiện giao dịch bất thường bằng thẻ tín dụng của chúng ta, họ có thể dừng giao dịch ngay lập tức. Hoặc nếu chúng ta đang tìm kiếm một sản phẩm, gợi ý sản phẩm có thể hiện ra ngay khi duyệt website. Tốc độ này đồng nghĩa với quyết định tốt hơn, khách hàng hài lòng hơn, và doanh nghiệp vận hành hiệu quả hơn.
Apache Kafka là một kho dữ liệu phân tán, thông lượng cao, được tối ưu để thu thập, xử lý, lưu trữ và phân tích dữ liệu truyền theo thời gian thực. Nó cho phép các ứng dụng khác nhau xuất bản và đăng ký (publish/subscribe) các luồng dữ liệu, giúp chúng giao tiếp và phản ứng với sự kiện ngay khi xảy ra.
Vì quản lý luồng dữ liệu hiệu quả, Kafka đã trở nên rất phổ biến. Nó được dùng trong nhiều hệ thống, từ thương mại điện tử và mạng xã hội đến ngân hàng và y tế.
Apache Kafka trở nên phổ biến trong giới làm dữ liệu khi phải xử lý các luồng dữ liệu thời gian thực. Ta có thể lý giải sự phổ biến này bằng một số yếu tố then chốt:
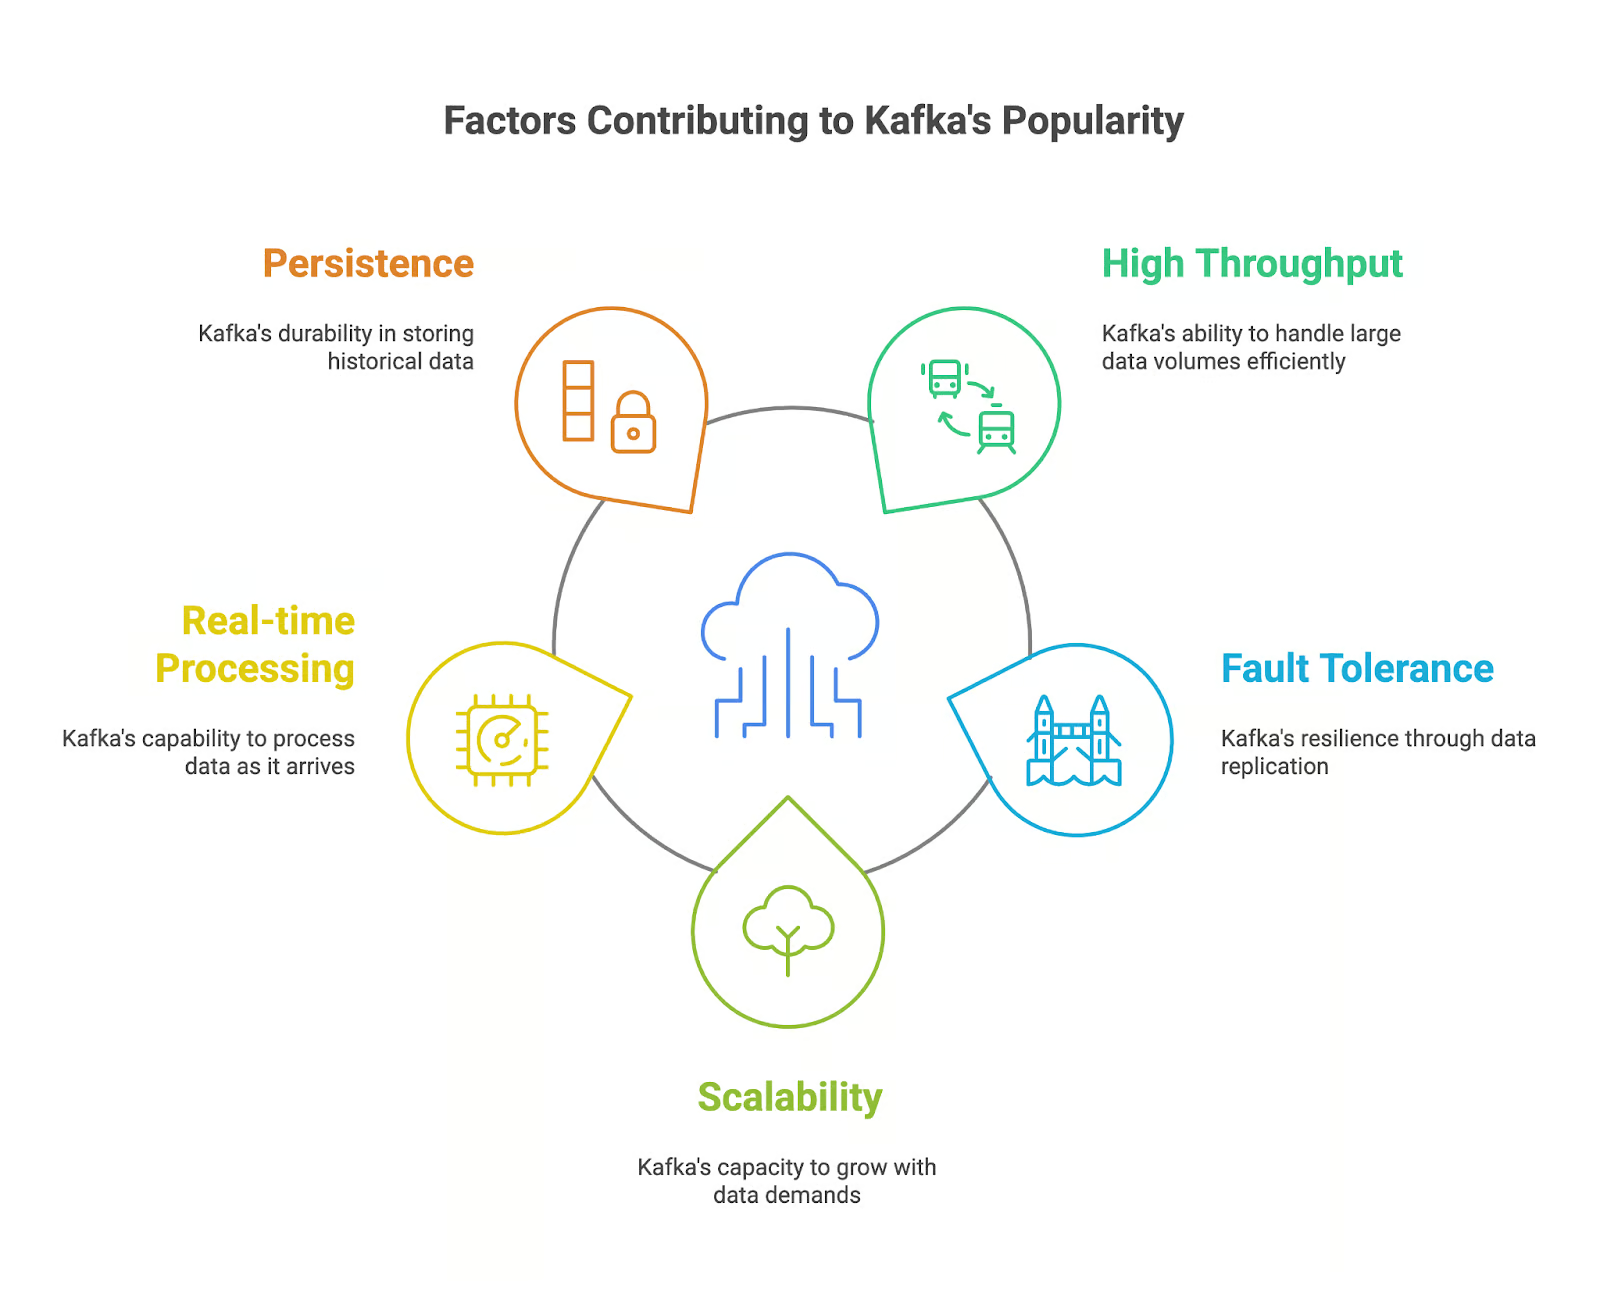
Apache Kafka hiện được dùng trong các ứng dụng cần xử lý và phân tích dữ liệu theo thời gian thực. Nhưng những tính năng nào khiến nó trở thành công cụ mạnh mẽ để xử lý dữ liệu truyền? Hãy cùng điểm qua:
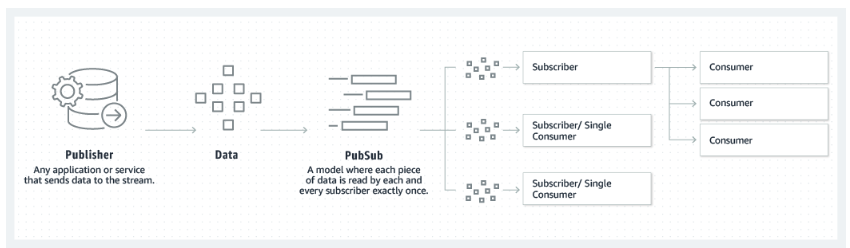
Mô hình xuất bản-đăng ký mà Kafka dựa vào. Nguồn: Amazon
Học Apache Kafka giúp bạn trở thành ứng viên giá trị đối với các nhà tuyển dụng và công ty tạo ra và xử lý dữ liệu với tốc độ cao. Với các tính năng mạnh mẽ và mức độ ứng dụng rộng rãi, Apache Kafka đã trở thành công cụ then chốt để xây dựng kiến trúc dữ liệu hiện đại và ứng dụng.
Tôi đã đề cập Kafka trở nên rất phổ biến trong những năm gần đây. Ước tính hiện Apache Kafka được sử dụng bởi hơn 80% công ty thuộc Fortune 100.
Việc Kafka được dùng ngày càng nhiều trong nhiều ngành cùng vai trò của nó trong việc hiện thực hóa giải pháp dữ liệu thời gian thực khiến kỹ năng Kafka rất giá trị trên thị trường lao động. Theo PayScale và ZipRecruiter, tính đến tháng 11/2024, mức lương trung bình của kỹ sư có kỹ năng Kafka tại Hoa Kỳ là 100.000 USD/năm.
Chúng ta đã nhắc đến các điểm mạnh của Apache Kafka, nhưng hãy xem một vài ví dụ cụ thể về nơi bạn có thể ứng dụng chúng:
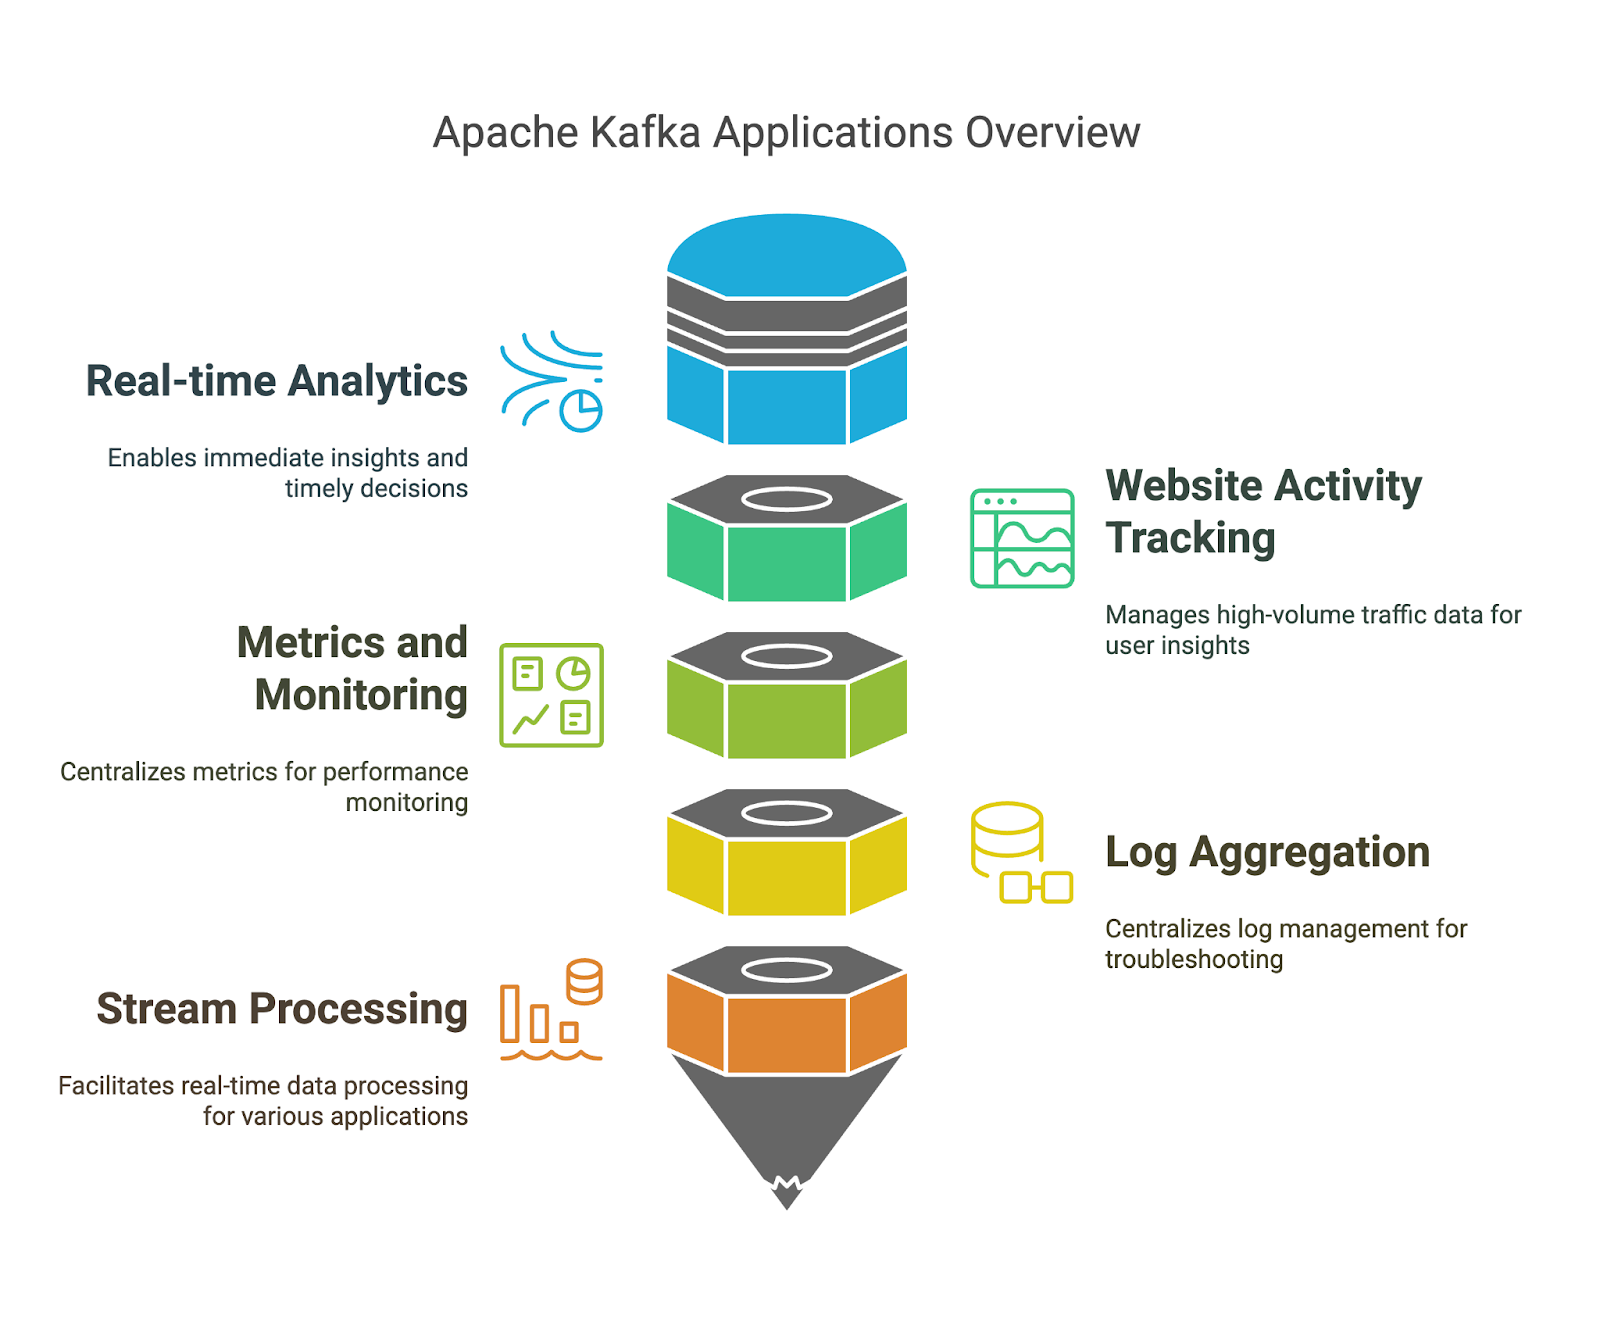
Nếu học Apache Kafka một cách có phương pháp, bạn sẽ có nhiều cơ hội thành công hơn. Hãy tập trung vào một vài nguyên tắc bạn có thể áp dụng trong hành trình học tập.
Trước khi vào chi tiết kỹ thuật, hãy xác định động lực học Apache Kafka. Tự hỏi bản thân:
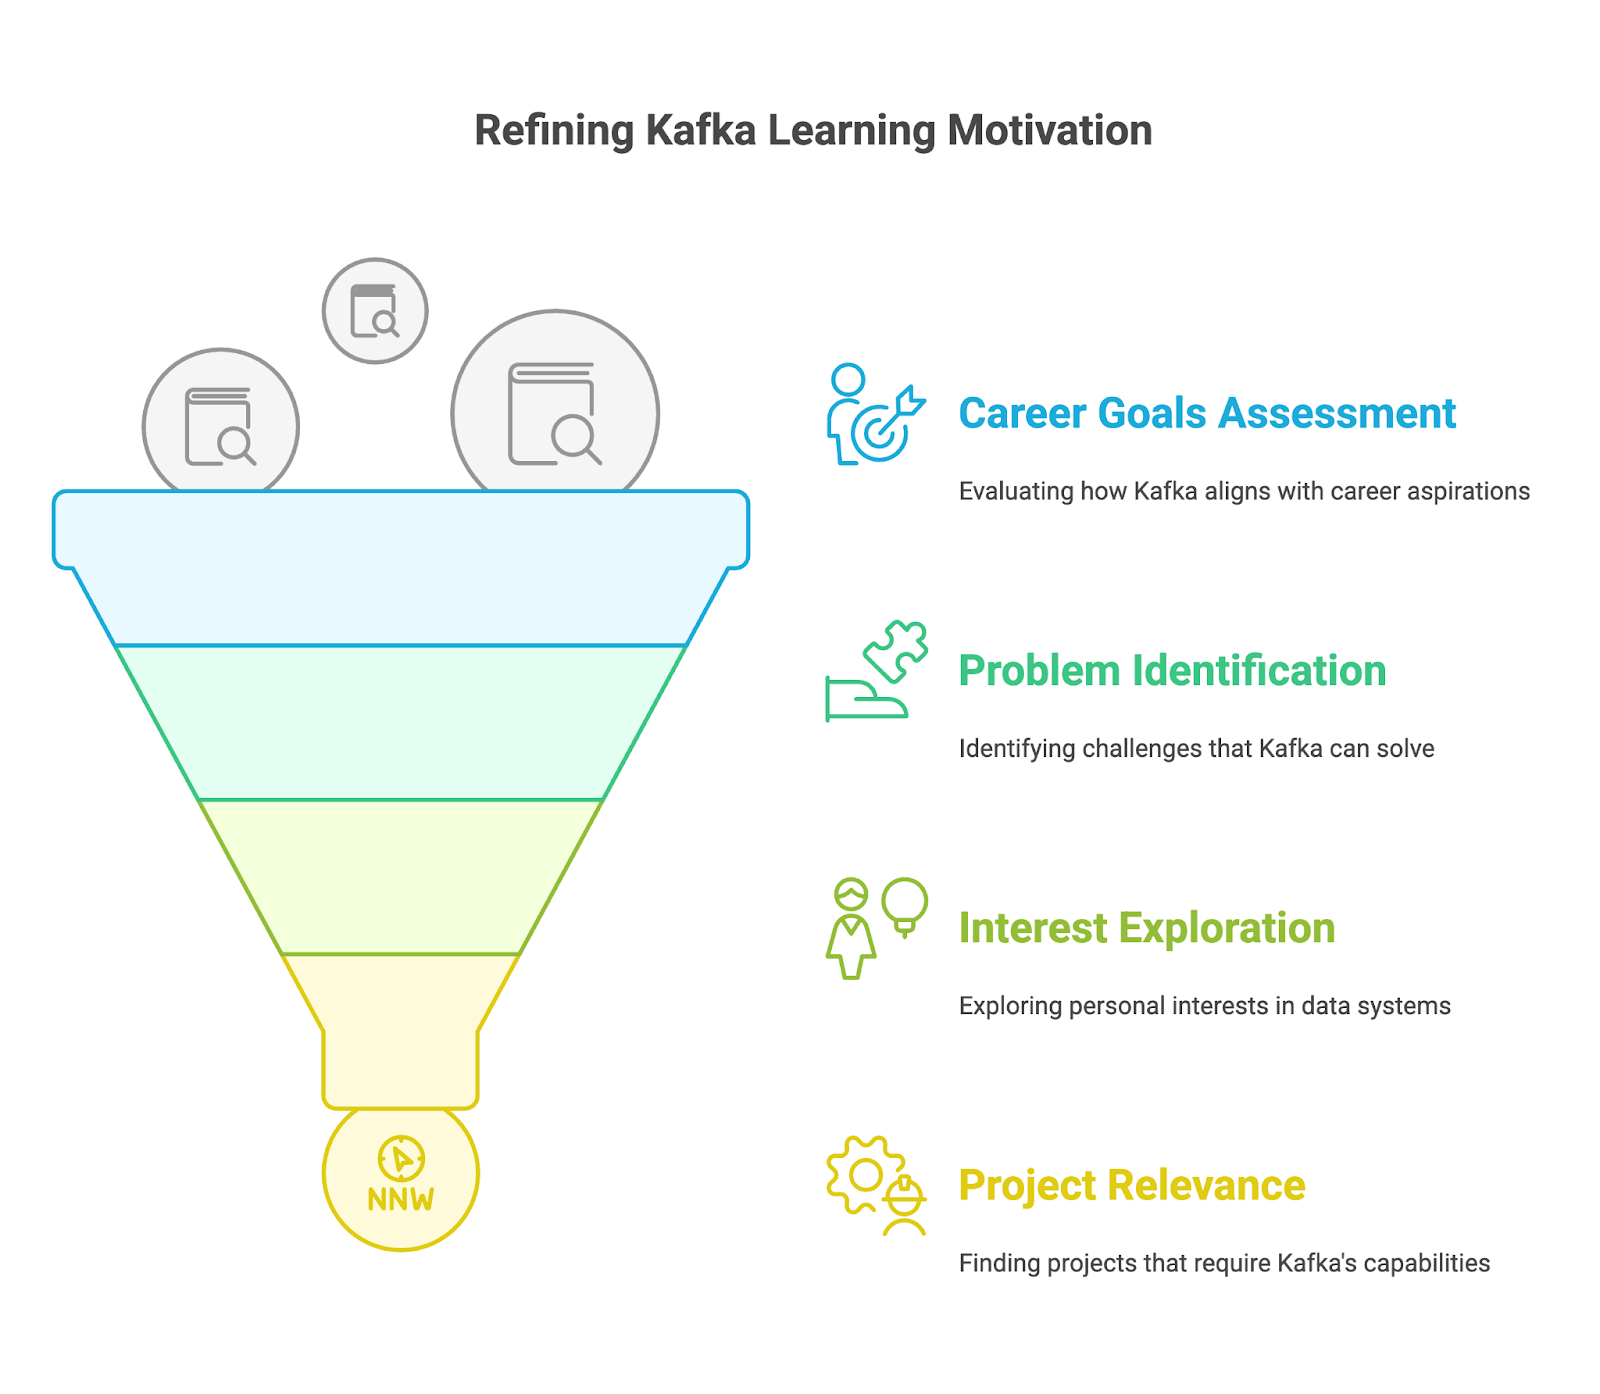
Sau khi xác định mục tiêu, hãy nắm vững những điều cơ bản của Kafka và hiểu cách nó hoạt động.
Để học Apache Kafka, trước tiên ta cần cài trên máy cục bộ. Vì Kafka được phát triển bằng Java, ta nên đảm bảo đã cài Java. Sau đó tải gói nhị phân Kafka từ trang chính thức và giải nén.
Tiếp theo, khởi động ZooKeeper rồi đến máy chủ Kafka bằng các script đi kèm. Cuối cùng, bạn có thể dùng công cụ dòng lệnh để tạo topic và thử sản xuất/tiêu thụ một số thông điệp để nắm bắt cơ bản. Bài viết Apache Kafka cho người mới bắt đầu của DataCamp có thể giúp bạn bắt nhịp nhanh chóng.
Khái niệm đầu tiên nên học là mô hình publisher-subscriber trong Kafka. Đây là một trong những lý do then chốt giúp Apache Kafka xử lý dữ liệu truyền hiệu quả. Hãy hiểu cách producer xuất bản thông điệp và consumer đăng ký các topic để chỉ nhận những thông điệp liên quan đến nhu cầu của họ.
Khóa học Giới thiệu về Apache Kafka của DataCamp cung cấp phần mở đầu với bài tập tương tác và ví dụ thực tiễn.
Khi mô tả mô hình xuất bản-đăng ký, chúng ta đã nhắc đến một số thành phần chính: Producer và Consumer. Tuy nhiên, chúng ta nên khám phá toàn bộ các thành phần cốt lõi. Hãy tìm hiểu cách Kafka tổ chức dữ liệu theo topic và partition, và hiểu partition đóng góp thế nào cho khả năng mở rộng và chịu lỗi.
Chúng ta cũng nên hiểu cách các broker tạo thành một cluster để cung cấp tính sẵn sàng cao và chịu lỗi.
Xem khóa học Giới thiệu về Apache Kafka của DataCamp cũng như bài viết Apache Kafka cho người mới bắt đầu để có cái nhìn rõ ràng về các chủ đề này.
Khi đã thoải mái với phần cơ bản, đã đến lúc khám phá các kỹ năng Apache Kafka ở mức trung cấp.
Một trong những tính năng then chốt của Apache Kafka là khả năng xử lý khối lượng lớn dữ liệu truyền. Kafka Connect là một thành phần mã nguồn mở, miễn phí của Apache Kafka, giúp đơn giản hóa tích hợp dữ liệu giữa hệ thống tệp, cơ sở dữ liệu, chỉ mục tìm kiếm và kho key-value.
Học cách dùng Connect có thể giúp chúng ta mở khóa luồng dữ liệu hiệu quả cho phân tích, tích hợp ứng dụng, và xây dựng kiến trúc dữ liệu vững chắc, có khả năng mở rộng. Xem thêm chi tiết trong bài viết Apache Kafka cho người mới bắt đầu của chúng tôi.
Một tính năng nâng cao khác của Kafka là Streams. Chúng ta nên học cách xây dựng ứng dụng xử lý luồng trực tiếp trong Kafka với Streams. Nó cung cấp API và ngôn ngữ miền chuyên biệt cấp cao để xử lý, chuyển đổi và đánh giá các luồng dữ liệu liên tục. Tìm hiểu thêm trong bài viết Apache Kafka cho người mới bắt đầu.
Như bất kỳ công nghệ nào khác, việc theo dõi hiệu năng luôn quan trọng. Để làm điều đó, ta nên học cách giám sát sức khỏe và hiệu suất cụm Kafka. Khám phá công cụ và kỹ thuật để theo dõi chỉ số chính, quản lý topic và partition, và đảm bảo hiệu năng tối ưu.
Tham gia các khóa học về Apache Kafka là cách tuyệt vời để làm quen công nghệ. Tuy nhiên, để thành thạo Kafka, bạn cần giải quyết các vấn đề thách thức và rèn kỹ năng giống như trong dự án thực tế.
Bạn có thể bắt đầu bằng việc thử nghiệm các tác vụ truyền dữ liệu đơn giản, như sản xuất và tiêu thụ thông điệp, rồi dần tăng độ phức tạp bằng cách khám phá các chủ đề như phân vùng (partitioning), chịu lỗi, và tích hợp với hệ thống bên ngoài bằng Kafka Connect.
Dưới đây là vài cách để luyện tập kỹ năng:
Bạn sẽ hoàn thành các dự án khác nhau khi tiến bước trong hành trình học Apache Kafka. Để thể hiện kỹ năng và kinh nghiệm của bạn với Apache Kafka trước nhà tuyển dụng, bạn nên tổng hợp chúng thành một danh mục dự án. Danh mục này nên phản ánh kỹ năng và sở thích của bạn, đồng thời được điều chỉnh phù hợp với ngành hoặc con đường sự nghiệp bạn theo đuổi.
Cố gắng làm dự án có tính nguyên bản và thể hiện khả năng giải quyết vấn đề. Bao gồm các dự án cho thấy năng lực ở các khía cạnh khác nhau của Kafka, như xây dựng pipeline dữ liệu với Kafka Connect, phát triển ứng dụng xử lý luồng với Kafka Streams, hoặc làm việc với cluster Kafka. Ghi chép dự án chi tiết, cung cấp bối cảnh, phương pháp, mã và kết quả. Bạn có thể dùng các nền tảng như GitHub để lưu trữ mã và Confluent Cloud cho môi trường Kafka được quản lý.
Học Kafka là một hành trình liên tục. Công nghệ luôn tiến hóa và các tính năng, ứng dụng mới liên tục được phát triển. Kafka cũng không ngoại lệ.
Khi đã làm chủ nền tảng, bạn có thể tìm các nhiệm vụ và dự án thử thách hơn như tinh chỉnh hiệu năng cho hệ thống thông lượng cao, và triển khai xử lý luồng nâng cao với Kafka Streams. Tập trung vào mục tiêu và chuyên sâu ở các lĩnh vực phù hợp với sự nghiệp và sở thích của bạn.
Cập nhật các phát triển mới như tính năng mới hoặc đề xuất KIP, và học cách áp dụng chúng vào dự án của bạn. Tiếp tục luyện tập, tìm kiếm thử thách và cơ hội mới, và chấp nhận sai lầm như một cách để học hỏi.
Dù mỗi người có cách học riêng, việc có một kế hoạch hoặc lộ trình để theo khi học công cụ mới luôn là ý hay. Tôi đã lập một kế hoạch học tiềm năng, phác thảo nơi bạn nên tập trung thời gian và công sức nếu mới bắt đầu với Apache Kafka.
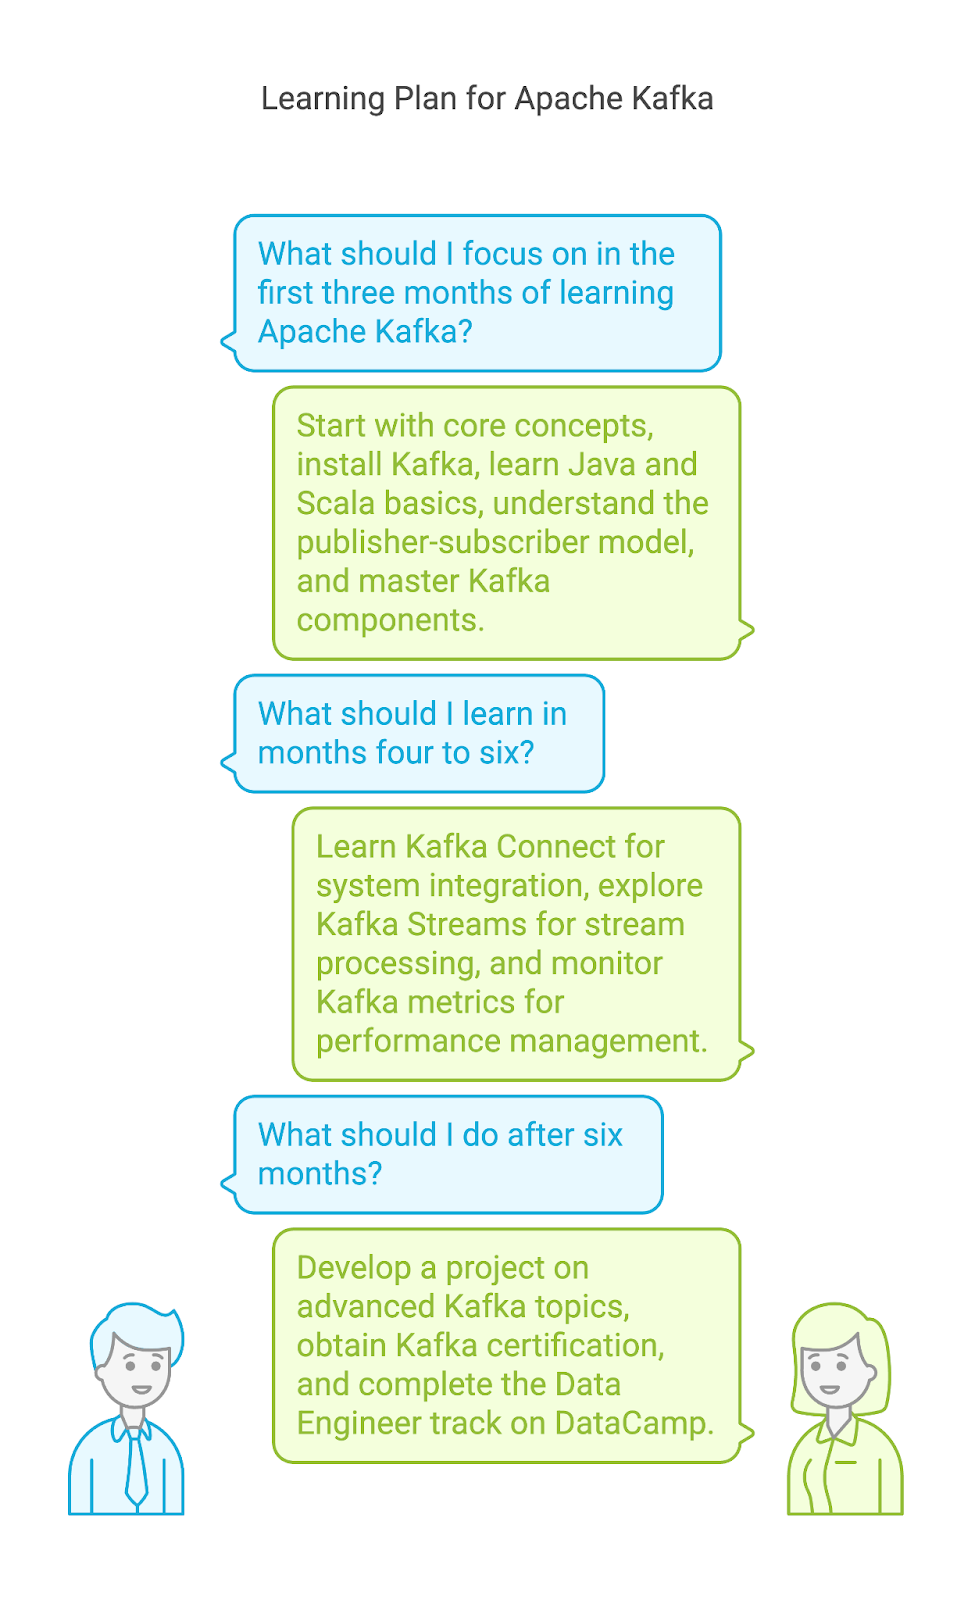
Tôi hình dung lúc này bạn đã sẵn sàng bắt đầu học Kafka và muốn thực hành với bộ dữ liệu lớn để rèn kỹ năng. Nhưng trước đó, hãy lưu ý các mẹo sau sẽ giúp bạn đi đúng hướng để thành thạo Apache Kafka.
Kafka là công cụ linh hoạt có thể dùng theo nhiều cách. Bạn nên xác định mục tiêu và mối quan tâm cụ thể trong hệ sinh thái Kafka. Khía cạnh nào của Kafka hấp dẫn bạn nhất? Bạn quan tâm kỹ thuật dữ liệu, xử lý luồng, hay quản trị Kafka? Cách tiếp cận tập trung sẽ giúp bạn nắm được những nội dung phù hợp nhất với mối quan tâm của mình.
Tính đều đặn là chìa khóa để làm chủ kỹ năng mới. Bạn nên dành thời gian cố định để luyện Kafka. Chỉ cần một khoảng ngắn mỗi ngày cũng đủ. Không cần ngày nào cũng tackle khái niệm phức tạp. Hãy làm bài tập thực hành, theo các hướng dẫn, và thử nghiệm các tính năng Kafka khác nhau. Bạn càng luyện, bạn sẽ càng thoải mái với nền tảng.
Đây là một mẹo then chốt, và bạn sẽ thấy lặp lại vài lần trong hướng dẫn này. Bài tập giúp bạn tự tin hơn. Tuy nhiên, áp dụng kỹ năng Kafka vào dự án thực tế mới là điều giúp bạn vượt trội.
Bắt đầu với các dự án và câu hỏi đơn giản rồi dần đảm nhận những dự án phức tạp hơn. Có thể bắt đầu bằng ứng dụng producer-consumer đơn giản, sau đó xây dựng pipeline dữ liệu thời gian thực với Kafka Connect, hoặc thiết kế ứng dụng xử lý luồng chịu lỗi với Kafka Streams. Mấu chốt là liên tục thử thách bản thân và mở rộng kỹ năng thực hành với Kafka.
Học tập thường hiệu quả hơn khi có cộng đồng. Chia sẻ trải nghiệm và học hỏi từ người khác có thể tăng tốc tiến bộ và mang lại insight giá trị.
Để trao đổi kiến thức, ý tưởng và câu hỏi, bạn có thể tham gia các nhóm liên quan đến Apache Kafka, tham dự meetup và hội thảo. Bạn có thể tham gia cộng đồng trực tuyến như kênh Slack của Confluent hoặc Diễn đàn Confluent để tương tác với những người đam mê Kafka khác. Bạn cũng có thể tham gia meetup trực tuyến hoặc trực tiếp, với các bài nói chuyện từ chuyên gia Kafka, hay các hội nghị như ApacheCon.
Như các công nghệ khác, học Apache Kafka là quá trình lặp. Học từ sai lầm là phần thiết yếu của quá trình này. Đừng ngại thử nghiệm, thử cách tiếp cận khác nhau, và học từ lỗi của bạn.
Hãy thử các cấu hình khác nhau cho producer và consumer của Kafka, khám phá các phương pháp tuần tự hóa dữ liệu (JSON, Avro, Protobuf), và thử nghiệm các chiến lược phân vùng khác nhau. Đẩy cụm Kafka đến giới hạn với khối lượng thông điệp lớn và quan sát cách nó xử lý tải. Phân tích consumer lag, tinh chỉnh cấu hình, và hiểu tác động của tối ưu hóa lên hiệu năng.
Hãy dành thời gian để thực sự nắm vững các khái niệm cốt lõi như topic, partition, nhóm consumer, và vai trò của ZooKeeper. Nếu bạn xây nền tảng vững chắc ngay bây giờ, sẽ dễ hiểu các chủ đề nâng cao hơn và xử lý sự cố hiệu quả. Chia nhỏ quá trình học thành các bước nhỏ và cho mình thời gian để hiểu. Tiếp cận chậm mà chắc thường dẫn đến hiểu biết sâu và làm chủ.
Hãy điểm qua một vài phương pháp hiệu quả để học Apache Kafka.
Các khóa trực tuyến là cách tuyệt vời để học Apache Kafka theo nhịp độ của bạn. DataCamp cung cấp khóa Kafka ở mức trung cấp. Khóa này bao quát các khái niệm cốt lõi của Kafka, gồm mô hình xuất bản-đăng ký, topic và partition, broker và cluster, producer và consumer.
Các tutorial cũng là cách hay để học Apache Kafka, nhất là khi bạn mới tiếp cận công nghệ. Chúng có hướng dẫn từng bước để thực hiện tác vụ cụ thể hoặc hiểu khái niệm nhất định. Khởi đầu, hãy cân nhắc các bài sau:
Để hiểu sâu hơn về ưu điểm của Apache Kafka, bạn cũng nên nắm các điểm tương đồng và khác biệt với công nghệ khác. Bạn có thể đọc các bài so sánh Kafka với công cụ khác như sau:
Sách là nguồn tài nguyên tuyệt vời để học Apache Kafka. Chúng cung cấp kiến thức chuyên sâu và góc nhìn từ các chuyên gia kèm đoạn mã và giải thích. Dưới đây là một số sách phổ biến về Kafka:
Khi việc áp dụng Apache Kafka tiếp tục tăng, cơ hội nghề nghiệp cho các chuyên gia sở hữu kỹ năng Kafka cũng nhiều lên, từ kỹ sư Kafka chuyên trách đến kỹ sư phần mềm. Nếu bạn đang đánh giá mức độ phù hợp của kỹ năng Kafka, hãy cân nhắc các vai trò sau:
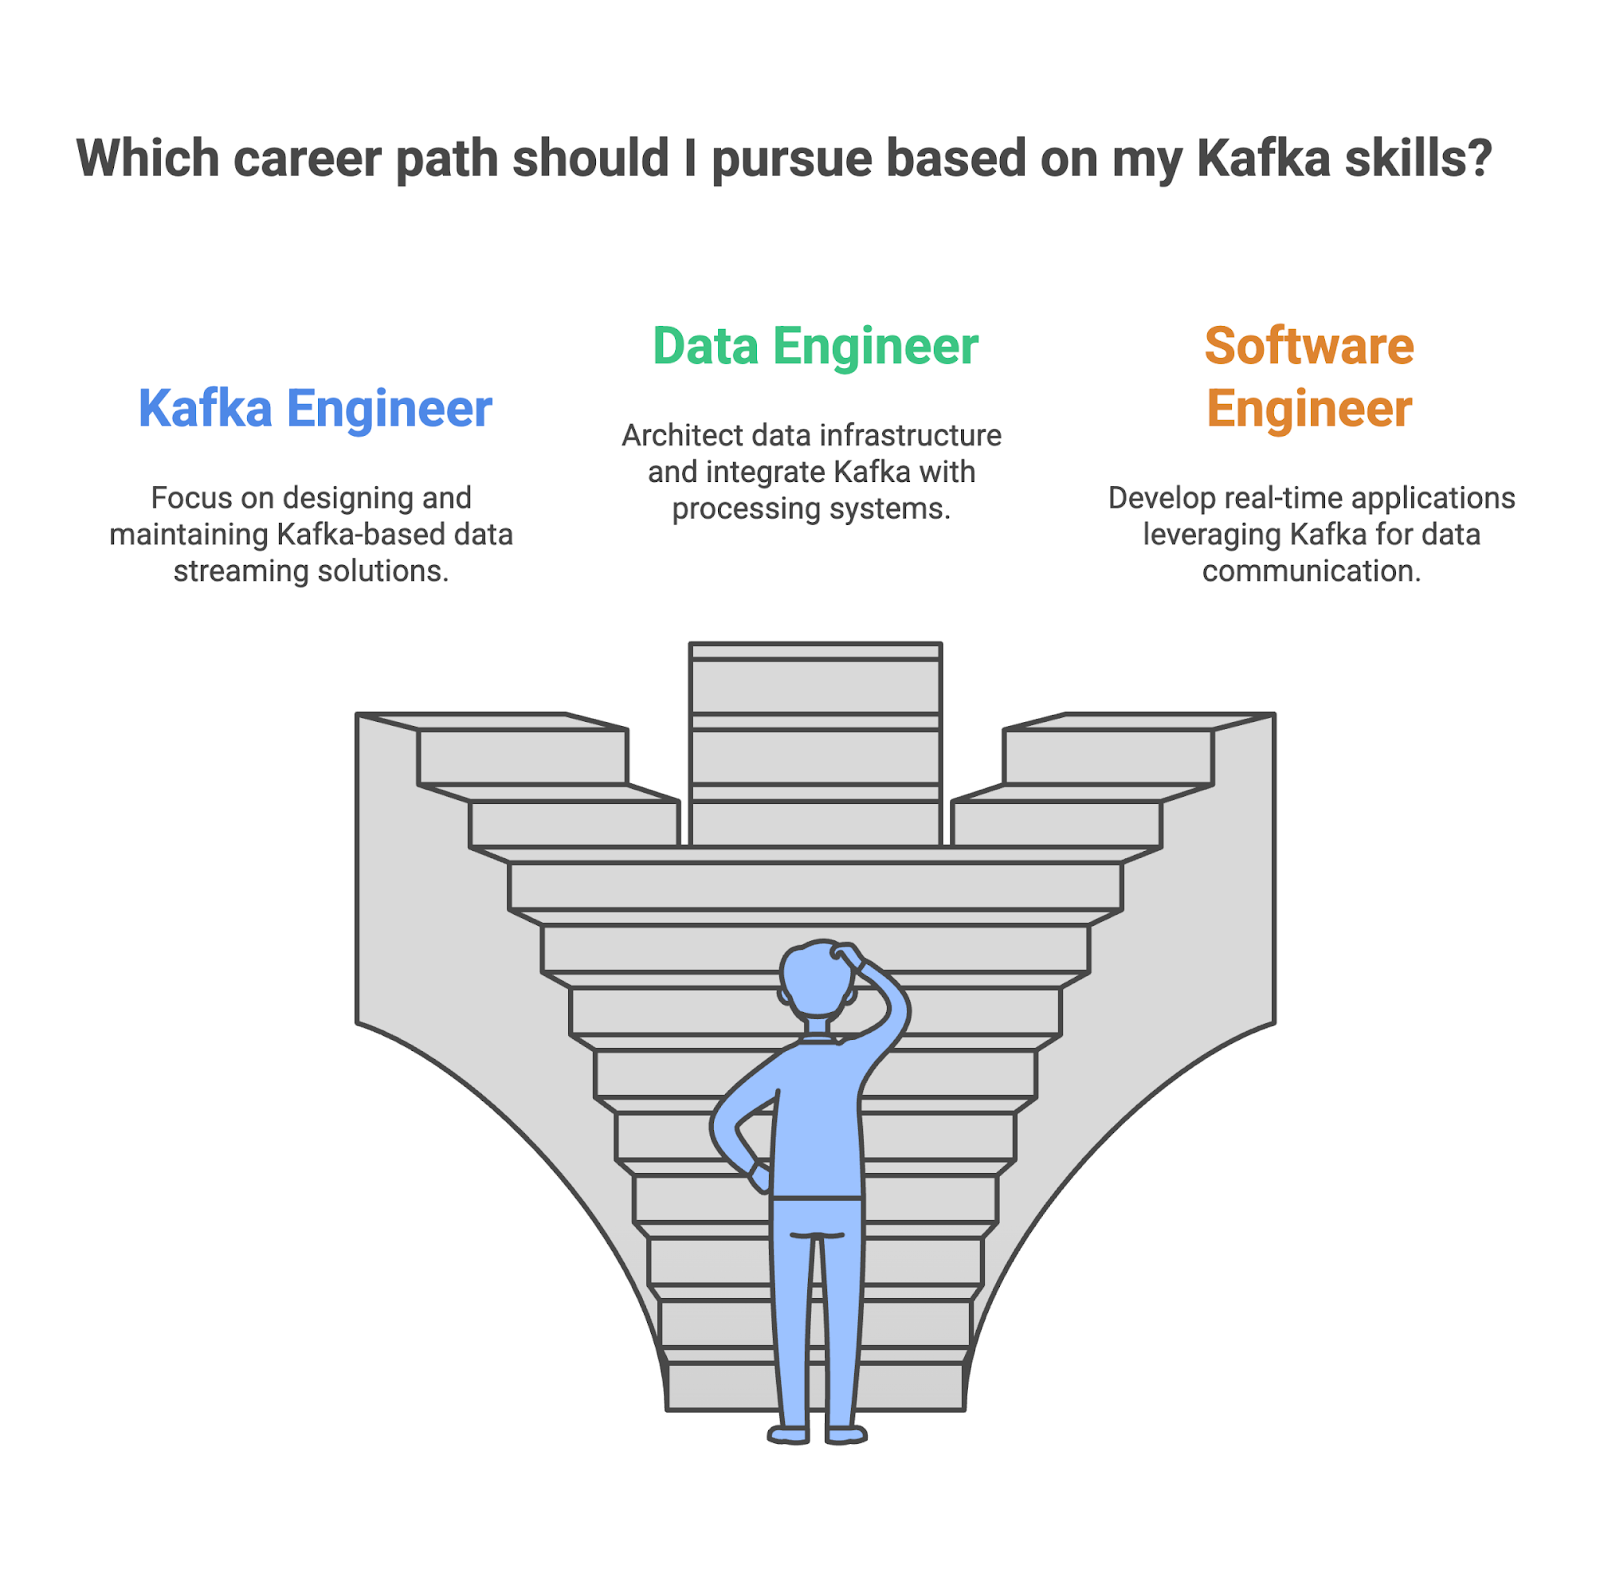
Là kỹ sư Kafka, bạn chịu trách nhiệm thiết kế, xây dựng và duy trì các giải pháp truyền dữ liệu dựa trên Kafka với tính sẵn sàng và khả năng mở rộng cao. Bạn sẽ cần đảm bảo luồng dữ liệu tin cậy và hiệu quả trong công ty, đồng thời giám sát và tối ưu hiệu năng Kafka để đảm bảo thông lượng và độ trễ tối ưu.
Là kỹ sư dữ liệu, bạn là kiến trúc sư hạ tầng dữ liệu, chịu trách nhiệm thiết kế và xây dựng hệ thống xử lý dữ liệu cho công ty. Kafka thường đóng vai trò quan trọng trong các pipeline dữ liệu này, cho phép truyền dữ liệu thời gian thực hiệu quả và có khả năng mở rộng giữa các hệ thống. Bạn sẽ cần đảm bảo Kafka tích hợp trơn tru với các thành phần khác.
Là kỹ sư phần mềm, bạn sẽ dùng Kafka để xây dựng ứng dụng thời gian thực như nền tảng chat và trò chơi trực tuyến. Bạn sẽ tích hợp Kafka vào mã ứng dụng để đảm bảo luồng dữ liệu mượt mà bằng cách kết nối với các hệ thống nhắn tin và API. Bạn cũng sẽ tối ưu các ứng dụng này về khả năng mở rộng và hiệu năng, giúp chúng xử lý lượng lớn dữ liệu thời gian thực.
|
Vai trò |
Bạn làm gì |
Kỹ năng chính |
Công cụ sử dụng |
|
Kỹ sư Kafka |
Thiết kế và triển khai cụm Kafka với tính sẵn sàng và khả năng mở rộng cao. |
Kiến trúc, thành phần Kafka, quản trị và cấu hình, khái niệm xử lý luồng. |
Apache Kafka, Kafka Connect, Kafka Streams, ZooKeeper |
|
Kỹ sư dữ liệu |
Thiết kế và triển khai data warehouse và data lake, tích hợp Kafka với các hệ thống xử lý và lưu trữ dữ liệu khác |
Thành thạo công cụ xử lý dữ liệu, kinh nghiệm với nền tảng đám mây, và kiến thức về Kafka. |
Apache Kafka, Apache Spark, Hadoop, Hive, Nền tảng đám mây |
|
Kỹ sư phần mềm |
Thiết kế và phát triển ứng dụng tận dụng Kafka để truyền thông dữ liệu thời gian thực. |
Kỹ năng lập trình, hệ thống và ứng dụng phân tán, kiến thức publisher-subscriber của Kafka. |
Apache Kafka, Java, Python, Scala, RabbitMQ, ActiveMQ, Công cụ và framework phát triển. |
Bằng cấp có thể rất giá trị khi theo đuổi sự nghiệp ở vai trò liên quan dữ liệu sử dụng Apache Kafka, nhưng không phải con đường duy nhất để thành công. Ngày càng nhiều người từ các nền tảng và kinh nghiệm đa dạng bắt đầu làm việc trong các vai trò liên quan dữ liệu. Với sự tận tâm, học tập đều đặn và cách tiếp cận chủ động, bạn có thể đạt được công việc mơ ước sử dụng Apache Kafka.
Cập nhật những phát triển mới nhất của Kafka. Theo dõi các chuyên gia có ảnh hưởng đang tham gia vào Apache Kafka trên mạng xã hội, đọc blog liên quan Kafka, và nghe podcast về Kafka.
Tương tác với những nhân vật có ảnh hưởng, như Neha Narkhede, đồng sáng tạo Kafka và cũng là CTO của Confluent. Bạn sẽ có được góc nhìn về chủ đề thịnh hành, công nghệ mới nổi, và định hướng tương lai của Apache Kafka. Bạn cũng có thể đọc blog Confluent, nơi cung cấp các bài viết và hướng dẫn chuyên sâu về nhiều chủ đề Kafka, từ kiến trúc, quản trị đến trường hợp sử dụng và thực hành tốt.
Bạn cũng nên theo dõi các sự kiện trong ngành như webinar tại Confluent hoặc hội nghị thường niên Kafka Summit.
Bạn cần nổi bật so với các ứng viên khác. Một cách hay để làm điều đó là xây dựng danh mục dự án mạnh mẽ thể hiện kỹ năng và các dự án bạn đã hoàn thành.
Danh mục của bạn nên bao gồm các dự án thể hiện năng lực xây dựng pipeline dữ liệu, triển khai ứng dụng xử lý luồng, và tích hợp Kafka với hệ thống khác.
Nhà tuyển dụng phải xem hàng trăm CV và phân biệt ứng viên xuất sắc. Ngoài ra, nhiều khi CV của bạn sẽ đi qua hệ thống lọc hồ sơ (ATS), phần mềm tự động được nhiều công ty dùng để sàng lọc CV và loại bỏ những hồ sơ không đáp ứng tiêu chí. Vì vậy, bạn nên viết một CV thật tốt và soạn thư xin việc ấn tượng để gây ấn tượng với cả ATS lẫn nhà tuyển dụng.
Được nhà tuyển dụng chú ý
Nếu bạn được chú ý hoặc CV hiệu quả vượt qua vòng sàng lọc, bước tiếp theo là chuẩn bị phỏng vấn kỹ thuật. Để sẵn sàng, bạn có thể xem bài viết 20 câu hỏi phỏng vấn Kafka cho kỹ sư dữ liệu.
Học Apache Kafka có thể mở ra cơ hội và kết quả nghề nghiệp tốt hơn. Con đường học Kafka nhiều phần thưởng nhưng đòi hỏi tính kiên trì và thực hành. Việc thử nghiệm và giải quyết thách thức bằng công cụ này có thể tăng tốc quá trình học và cung cấp ví dụ thực tế để bạn thể hiện kỹ năng khi tìm việc.
Học kỹ sư dữ liệu với các khóa học này!
Khóa học
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
