
Corso
Introduzione ad Apache Kafka
2 ore
12.1K
Elaborare i dati in tempo reale ci offre grandi opportunità. Se una banca rileva un acquisto anomalo con la nostra carta di credito, può bloccare la transazione immediatamente. Oppure, se stiamo cercando un prodotto, i suggerimenti possono comparire mentre navighiamo sul sito. Questa velocità significa decisioni migliori, clienti più soddisfatti e un business più efficiente.
Apache Kafka è un data store distribuito ad alto throughput, ottimizzato per raccogliere, elaborare, archiviare e analizzare dati in streaming in tempo reale. Consente a diverse applicazioni di pubblicare e sottoscrivere flussi di dati, permettendo loro di comunicare e reagire agli eventi mentre accadono.
Poiché gestisce i flussi di dati in modo efficiente, Kafka è diventato molto popolare. È usato in diversi sistemi, dall’e-commerce e i social media alla banca e alla sanità.
Apache Kafka è diventato popolare tra i professionisti dei dati che affrontano le sfide della gestione di flussi di dati in tempo reale. Possiamo spiegarne la popolarità con alcuni fattori chiave:
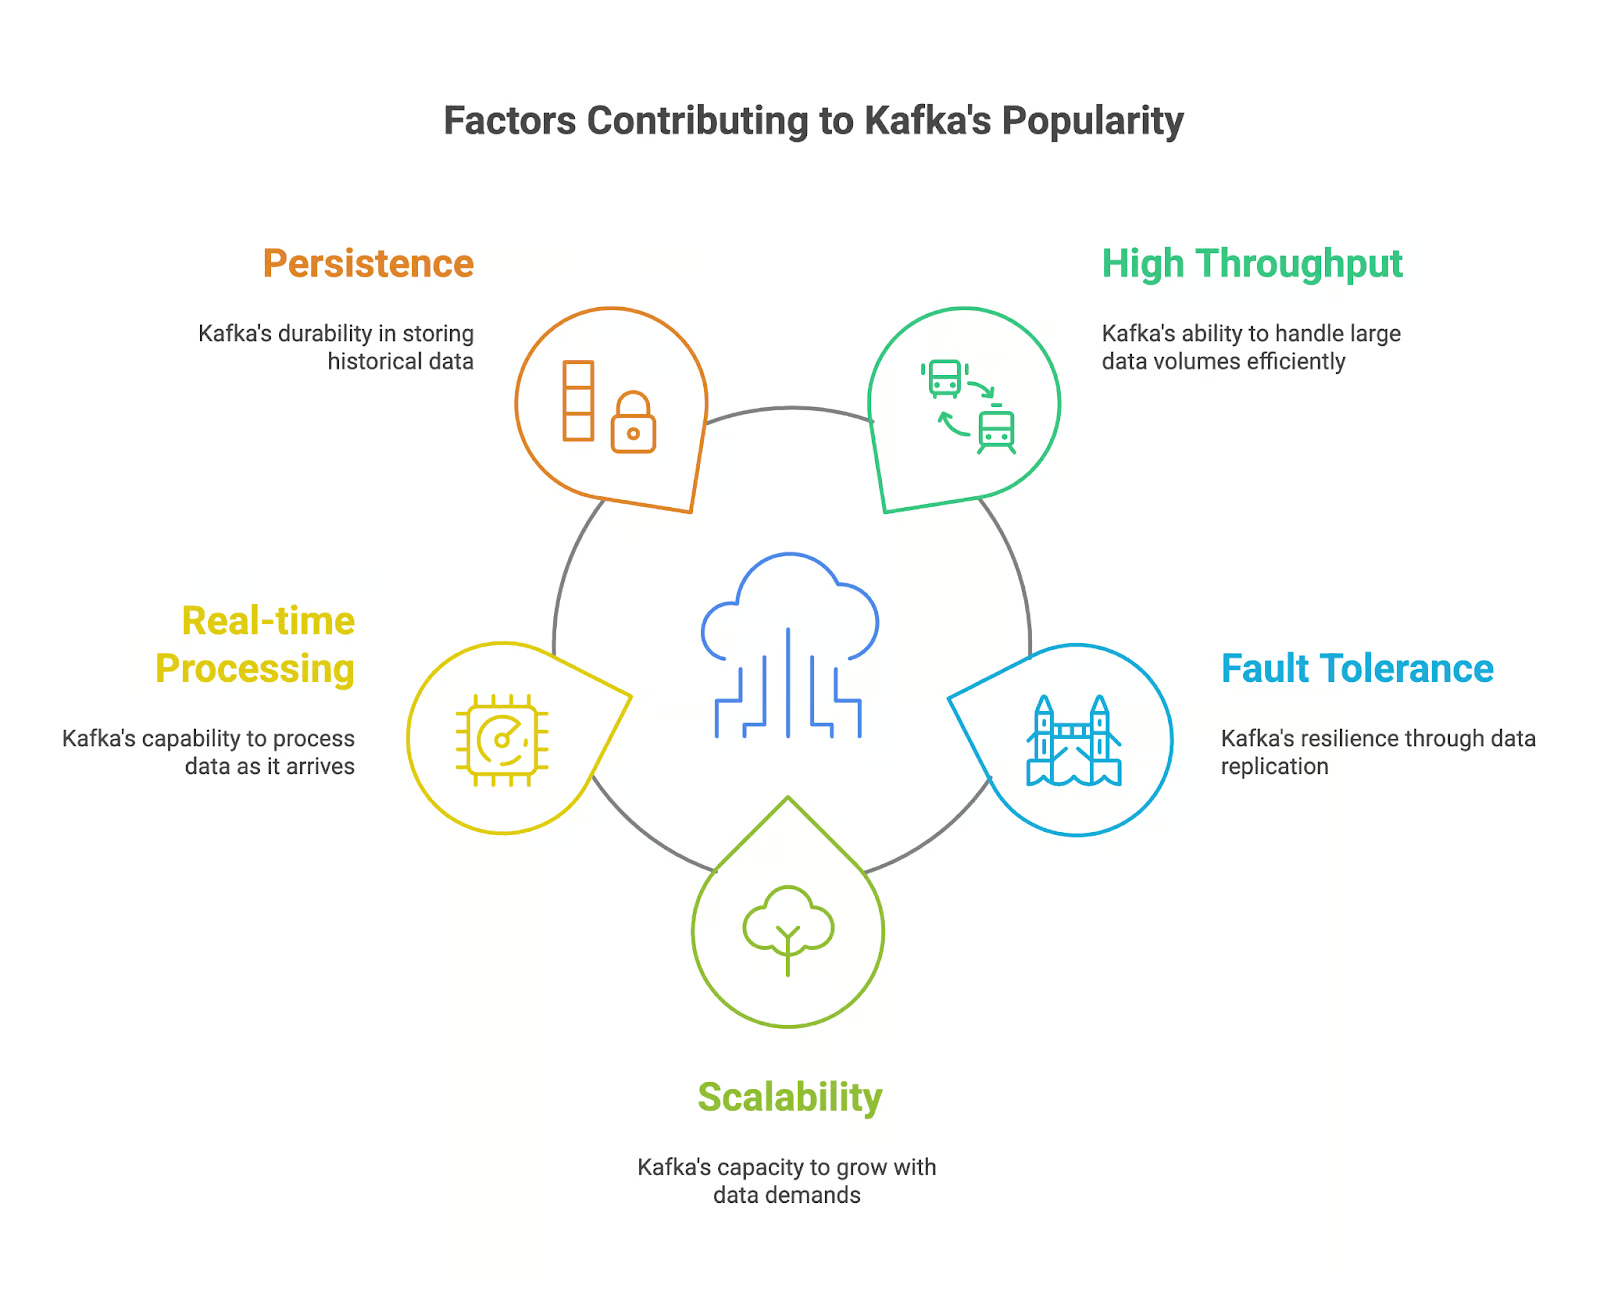
Apache Kafka è attualmente utilizzato in applicazioni che richiedono l’elaborazione e l’analisi dei dati in tempo reale. Ma quali caratteristiche lo rendono uno strumento potente per gestire dati in streaming? Diamo un’occhiata:
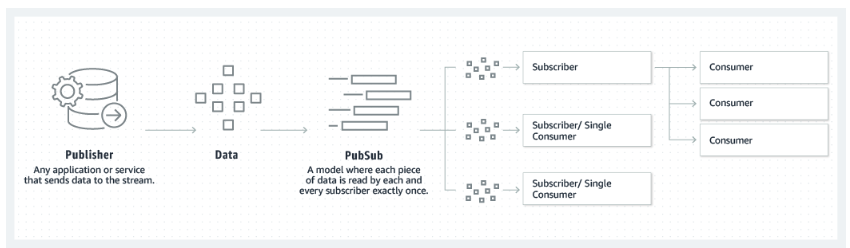
Il modello publisher-subscriber su cui si basa Kafka. Fonte: Amazon
Imparare Apache Kafka ti rende un candidato prezioso per datori di lavoro e aziende che generano ed elaborano dati ad alti volumi. Apache Kafka, con le sue potenti funzionalità e l’ampia diffusione, è diventato uno strumento chiave per costruire architetture dati moderne e applicazioni.
Ho già menzionato che Kafka è diventato molto popolare negli ultimi anni. Si stima che Apache Kafka sia attualmente utilizzato da oltre l’80% delle aziende Fortune 100.
La crescente adozione di Kafka in vari settori, insieme al suo ruolo nell’abilitare soluzioni dati in tempo reale, rende le competenze su Kafka molto richieste nel mercato del lavoro. Secondo PayScale e ZipRecruiter, a novembre 2024 lo stipendio medio di un ingegnere con competenze Kafka negli Stati Uniti è di 100.000 $ all’anno.
Abbiamo già menzionato i punti di forza di Apache Kafka, ma vediamo alcuni esempi specifici di dove puoi utilizzarli:
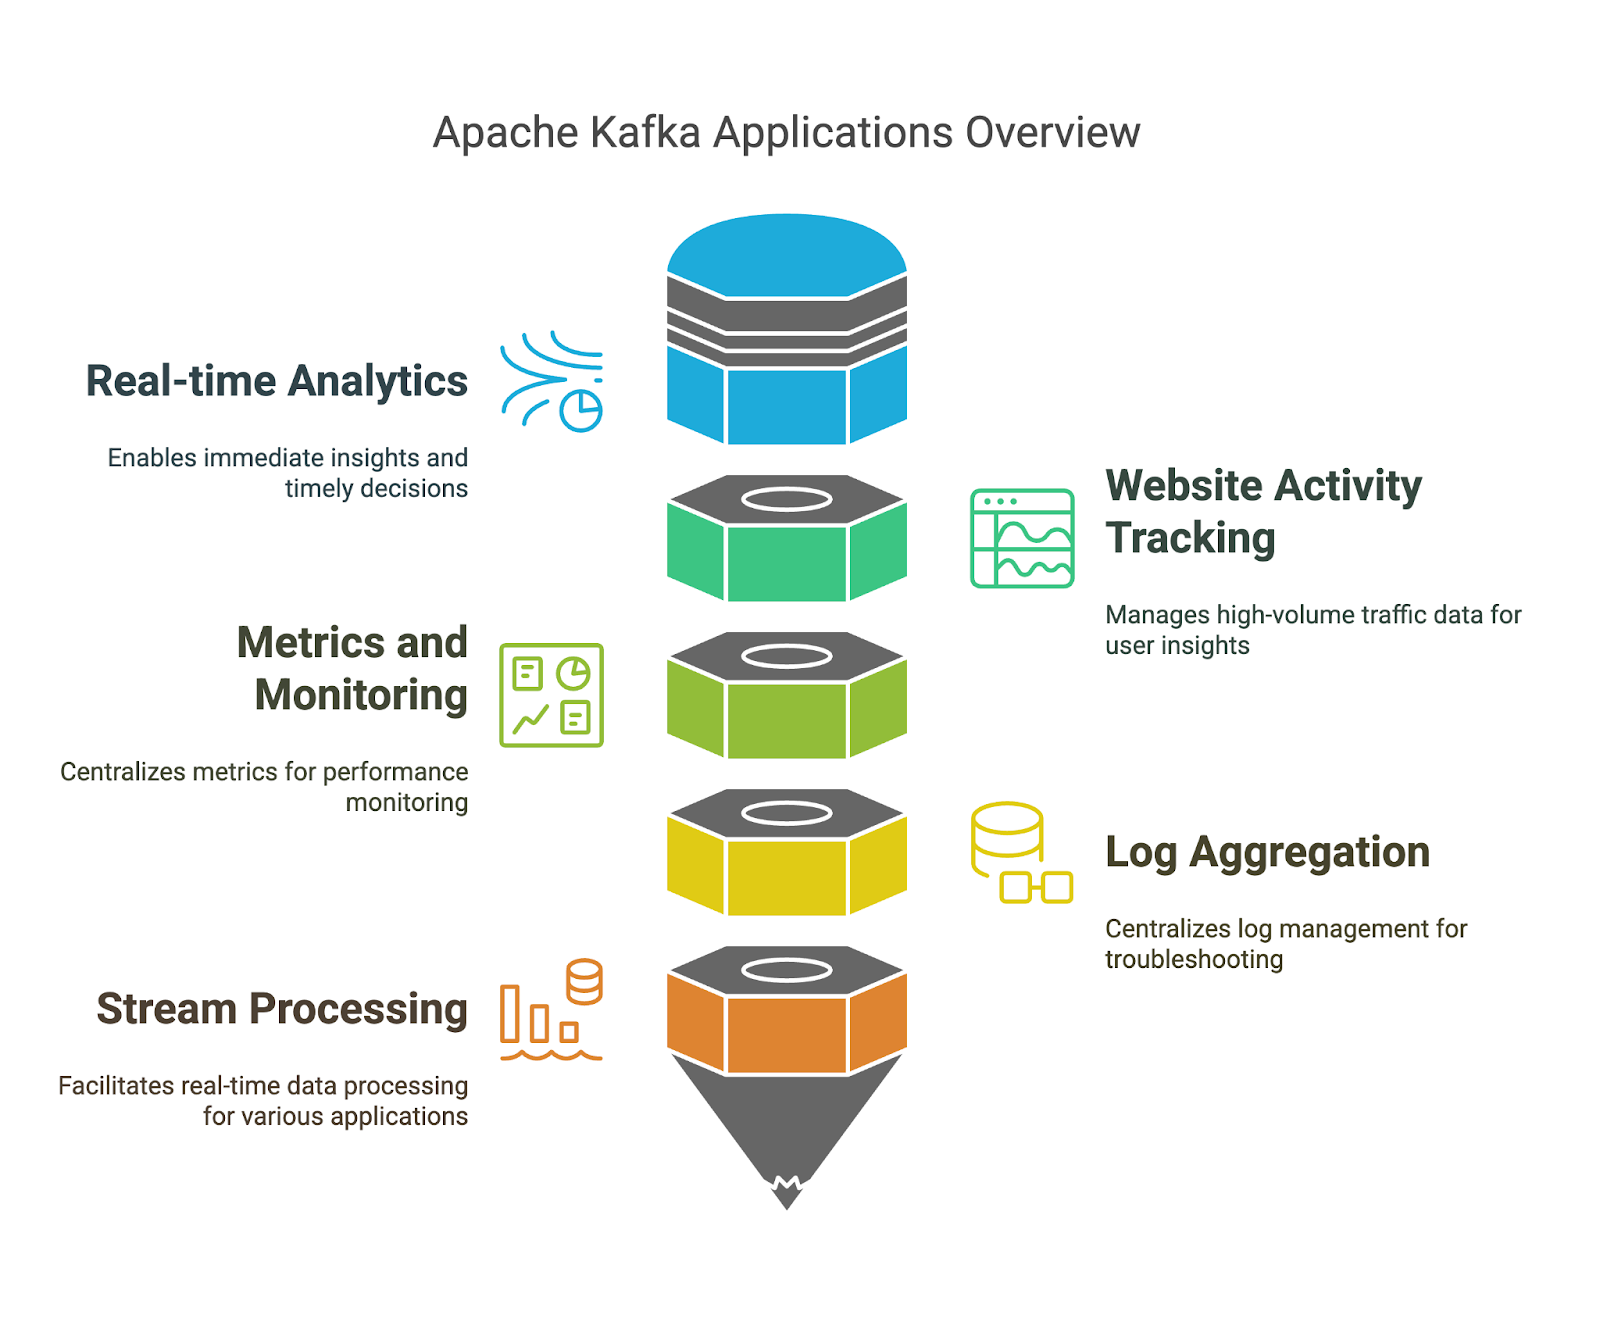
Se impari Apache Kafka in modo metodico, hai più possibilità di successo. Concentrati su alcuni principi che puoi usare nel tuo percorso di apprendimento.
Prima di entrare nei dettagli tecnici, definisci la tua motivazione per imparare Apache Kafka. Chiediti:
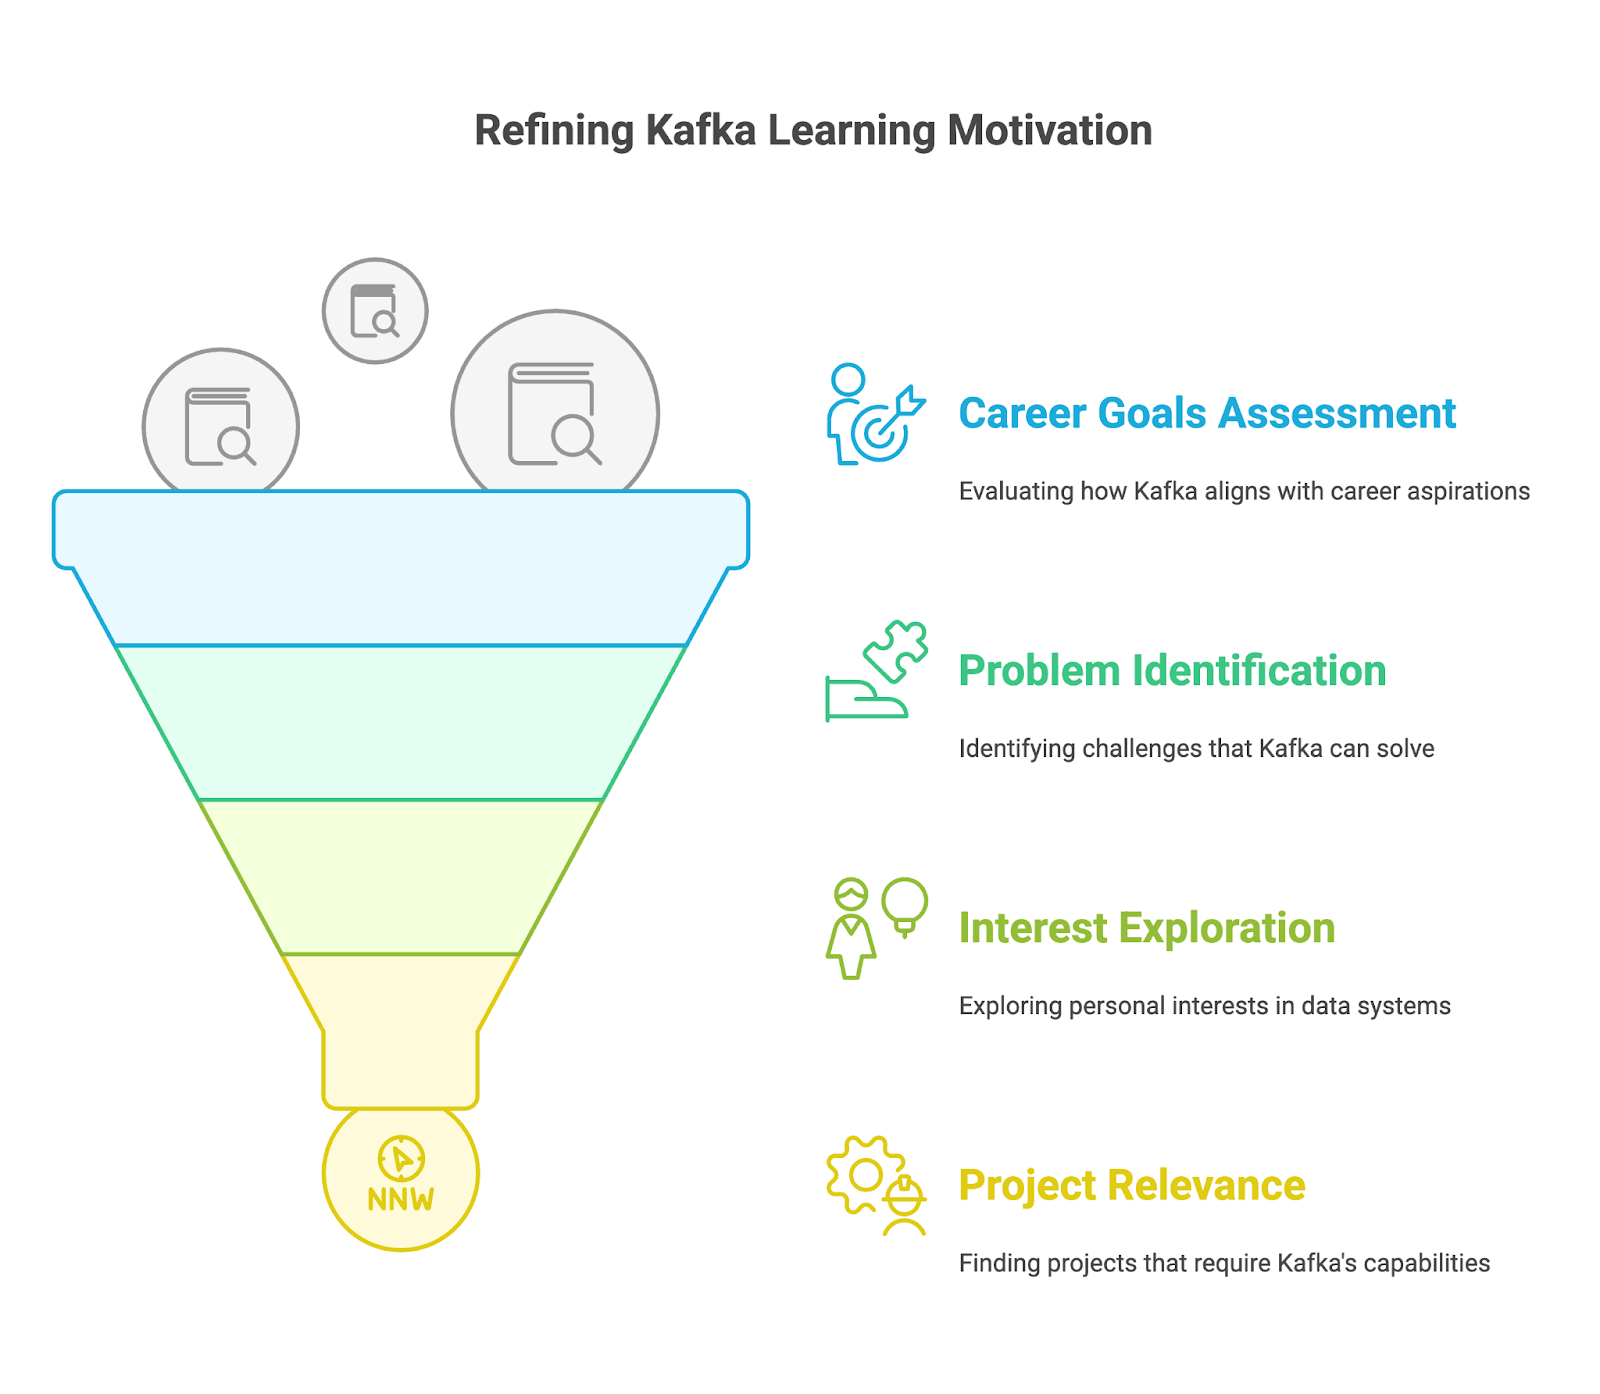
Dopo aver identificato i tuoi obiettivi, padroneggia le basi di Kafka e capisci come funzionano.
Per imparare Apache Kafka, dobbiamo prima installarlo sulla nostra macchina locale. Poiché Kafka è sviluppato in Java, dobbiamo assicurarci di avere Java installato. Poi, dobbiamo scaricare i binari di Kafka dal sito ufficiale ed estrarli.
Ora avviamo ZooKeeper, seguito dal server Kafka, usando gli script forniti. Infine, possiamo usare gli strumenti da riga di comando per creare topic e provare a produrre e consumare alcuni messaggi per afferrare le basi. L’articolo di DataCamp Apache Kafka for Beginners può aiutarti a metterti in pari.
Il primo concetto da imparare è il modello publisher-subscriber in Kafka. È uno dei motivi chiave per cui Apache Kafka può gestire in modo efficiente dati in streaming. Comprendi come i producer pubblicano messaggi e i consumer si iscrivono a questi topic, ricevendo solo i messaggi rilevanti per i loro interessi.
Il corso di DataCamp Introduction to Apache Kafka fornisce un’introduzione con esercizi interattivi ed esempi pratici.
Descrivendo il modello publisher-subscriber, abbiamo menzionato alcuni componenti chiave di Kafka: Producer e Consumer. Tuttavia, dovremmo esplorare tutti i componenti core. Dovremmo imparare come Kafka organizza i dati in topic e partition e capire come le partition contribuiscono a scalabilità e tolleranza ai guasti.
Dovremmo anche capire come i broker formano un cluster per fornire alta disponibilità e tolleranza ai guasti.
Consulta il corso di DataCamp Introduction to Apache Kafka e l’articolo Apache Kafka for Beginners per avere un quadro chiaro di questi argomenti.
Una volta che ti senti a tuo agio con le basi, è il momento di esplorare competenze intermedie su Apache Kafka.
Una delle funzionalità chiave di Apache Kafka è la sua capacità di gestire grandi volumi di dati in streaming. Kafka Connect è un componente open-source e gratuito di Apache Kafka che semplifica l’integrazione dei dati tra file system, database, motori di ricerca e key-value store.
Imparare a usare Connect può aiutarci a sbloccare flussi di dati efficienti per analytics, integrazione applicativa e la costruzione di un’architettura dati robusta e scalabile. Consulta il nostro articolo Apache Kafka for Beginners per maggiori dettagli.
Un’altra funzionalità avanzata di Kafka è Streams. Dovremmo imparare a costruire applicazioni di stream processing direttamente in Kafka grazie a Streams. Offre API e un Domain-Specific Language di alto livello per gestire, trasformare e valutare flussi continui di dati. Scopri più dettagli nell’articolo Apache Kafka for Beginners.
Come per qualsiasi altra tecnologia, è sempre bene tenere traccia delle prestazioni. Per farlo, dovremmo imparare a monitorare lo stato di salute e le performance del nostro cluster Kafka. Possiamo esplorare strumenti e tecniche per monitorare metriche chiave, gestire topic e partition e garantire prestazioni ottimali.
Seguire corsi su Apache Kafka è un ottimo modo per familiarizzare con la tecnologia. Tuttavia, per diventare davvero competente in Kafka, devi risolvere problemi impegnativi e formativi, come quelli che affronterai in progetti reali.
Puoi iniziare sperimentando semplici attività di data streaming, come produrre e consumare messaggi, quindi aumentare gradualmente la complessità esplorando temi come partitioning, tolleranza ai guasti e integrazione con sistemi esterni tramite Kafka Connect.
Ecco alcuni modi per esercitare le tue competenze:
Completerai diversi progetti man mano che avanzi nel tuo percorso di apprendimento su Apache Kafka. Per mostrare le tue competenze ed esperienze a potenziali datori di lavoro, dovresti raccoglierli in un portfolio. Questo portfolio dovrebbe riflettere le tue abilità e i tuoi interessi ed essere allineato alla carriera o al settore che ti interessa.
Cerca di rendere i tuoi progetti originali e di mostrare le tue capacità di problem-solving. Includi progetti che dimostrino la tua padronanza di diversi aspetti di Kafka, come la costruzione di pipeline dati con Kafka Connect, lo sviluppo di applicazioni di streaming con Kafka Streams o il lavoro con cluster Kafka. Documenta accuratamente i tuoi progetti, fornendo contesto, metodologia, codice e risultati. Puoi usare piattaforme come GitHub per ospitare il tuo codice e Confluent Cloud per un ambiente Kafka gestito.
Imparare Kafka è un percorso continuo. La tecnologia evolve costantemente e vengono sviluppate regolarmente nuove funzionalità e applicazioni. Kafka non fa eccezione.
Una volta padroneggiate le basi, puoi cercare attività e progetti più impegnativi, come il tuning delle performance per sistemi ad alto throughput e l’implementazione di stream processing avanzato con Kafka Streams. Concentrati sui tuoi obiettivi e specializzati nelle aree più rilevanti per la tua carriera e i tuoi interessi.
Rimani aggiornato sugli sviluppi, come nuove funzionalità o proposte KIP, e impara come applicarle ai tuoi progetti. Continua a esercitarti, cerca nuove sfide e opportunità e abbraccia l’idea di imparare dagli errori.
Anche se ognuno ha il proprio modo di imparare, è sempre una buona idea avere un piano o una guida da seguire per apprendere un nuovo strumento. Ho creato un possibile piano di apprendimento che indica dove concentrare tempo ed energie se stai iniziando con Apache Kafka.
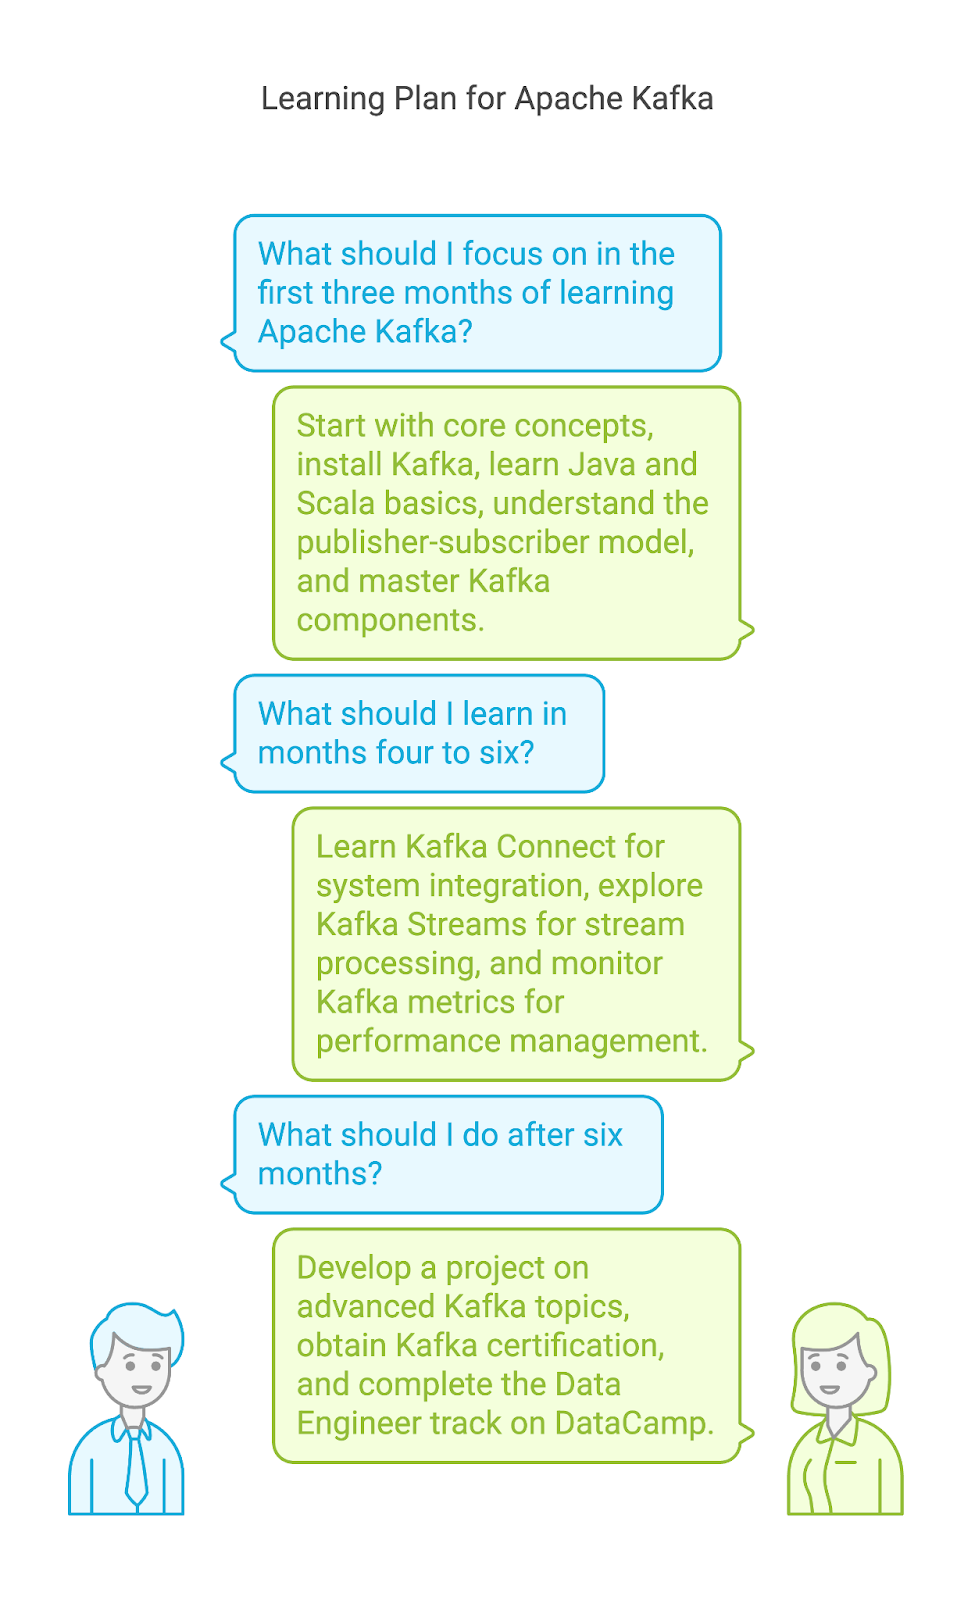
Immagino che ormai tu sia pronto a tuffarti nello studio di Kafka e a mettere le mani su un grande dataset per esercitare la nuova skill. Ma prima, lascia che evidenzi questi consigli che ti aiuteranno a percorrere la strada verso la padronanza di Apache Kafka.
Kafka è uno strumento versatile che può essere usato in molti modi. Dovresti identificare i tuoi obiettivi e interessi specifici nell’ecosistema Kafka. Quale aspetto ti attrae di più? Ti interessano il data engineering, lo stream processing o l’amministrazione di Kafka? Un approccio mirato ti aiuta a ottenere gli aspetti e le conoscenze più rilevanti di Apache Kafka per i tuoi interessi.
La costanza è fondamentale per padroneggiare qualsiasi nuova competenza. Dovresti dedicare del tempo fisso per esercitarti con Kafka. Anche poco ogni giorno va bene. Non devi affrontare concetti complessi quotidianamente. Puoi fare esercizi pratici, seguire tutorial ed esplorare le varie funzionalità di Kafka. Più ti eserciti, più ti sentirai a tuo agio con la piattaforma.
Questo è uno dei consigli chiave e lo leggerai più volte in questa guida. Fare esercizi è ottimo per acquisire fiducia. Tuttavia, applicare le tue competenze Kafka a progetti reali è ciò che ti farà eccellere.
Inizia con progetti e domande semplici e passa gradualmente a quelli più complessi. Potrebbe trattarsi di impostare una semplice applicazione producer-consumer, poi passare alla costruzione di una pipeline dati in tempo reale con Kafka Connect o persino progettare un’app di streaming tollerante ai guasti con Kafka Streams. La chiave è sfidarti continuamente ed espandere le tue competenze pratiche su Kafka.
Imparare è spesso più efficace quando fatto in modo collaborativo. Condividere esperienze e imparare dagli altri può accelerare i progressi e fornire insight preziosi.
Per scambiare conoscenze, idee e domande, puoi unirti a gruppi relativi ad Apache Kafka e partecipare a meet-up e conferenze. puoi iscriverti a community online come il canale Slack di Confluent o il Confluent Forum dove puoi interagire con altri appassionati di Kafka. Puoi anche partecipare a meet-up virtuali o in presenza, con talk di esperti Kafka, o a conferenze come ApacheCon.
Come per qualsiasi altra tecnologia, imparare Apache Kafka è un processo iterativo. Imparare dai propri errori è una parte essenziale di questo processo. Non temere di sperimentare, provare approcci diversi e imparare dagli errori.
Prova diverse configurazioni per i tuoi producer e consumer Kafka, esplora vari metodi di serializzazione dei dati (JSON, Avro, Protobuf) e sperimenta differenti strategie di partitioning. Metti alla prova il tuo cluster Kafka con volumi elevati di messaggi e osserva come gestisce il carico. Analizza il consumer lag, affina le configurazioni e capisci come le tue ottimizzazioni impattano sulle performance.
Prenditi il tempo per comprendere davvero concetti chiave come topic, partition, gruppi di consumer e il ruolo di ZooKeeper. Se costruisci ora fondamenta solide, ti sarà più facile capire argomenti avanzati e risolvere problemi in modo efficace. Suddividi il processo di apprendimento in passi più piccoli e concediti il tempo di assimilare le informazioni. Un approccio lento e costante spesso porta a una comprensione più profonda e alla padronanza.
Vediamo alcuni metodi efficaci per imparare Apache Kafka.
I corsi online offrono un ottimo modo per imparare Apache Kafka ai tuoi ritmi. DataCamp offre un corso intermedio su Kafka. Questo corso copre i concetti core di Kafka, incluso il modello publisher-subscriber, topic e partition, broker e cluster, producer e consumer.
I tutorial sono un altro ottimo modo per imparare Apache Kafka, specialmente se sei alle prime armi con la tecnologia. Contengono istruzioni passo passo su come svolgere attività specifiche o capire certi concetti. Per iniziare, considera questi tutorial:
Per avere una conoscenza più profonda dei vantaggi di Apache Kafka, dovresti anche capire quali sono le principali somiglianze e differenze con altre tecnologie. Puoi leggere articoli su come Kafka si confronta con altri strumenti, come i seguenti:
I libri sono un’ottima risorsa per imparare Apache Kafka. Offrono conoscenze approfondite e insight da esperti, insieme a snippet di codice e spiegazioni. Ecco alcuni dei libri più popolari su Kafka:
Poiché l’adozione di Apache Kafka continua a crescere, aumentano anche le opportunità di carriera per i professionisti con competenze su Kafka, dagli ingegneri specifici Kafka ai software engineer. Se stai valutando l’allineamento delle tue competenze Kafka, considera questi ruoli:
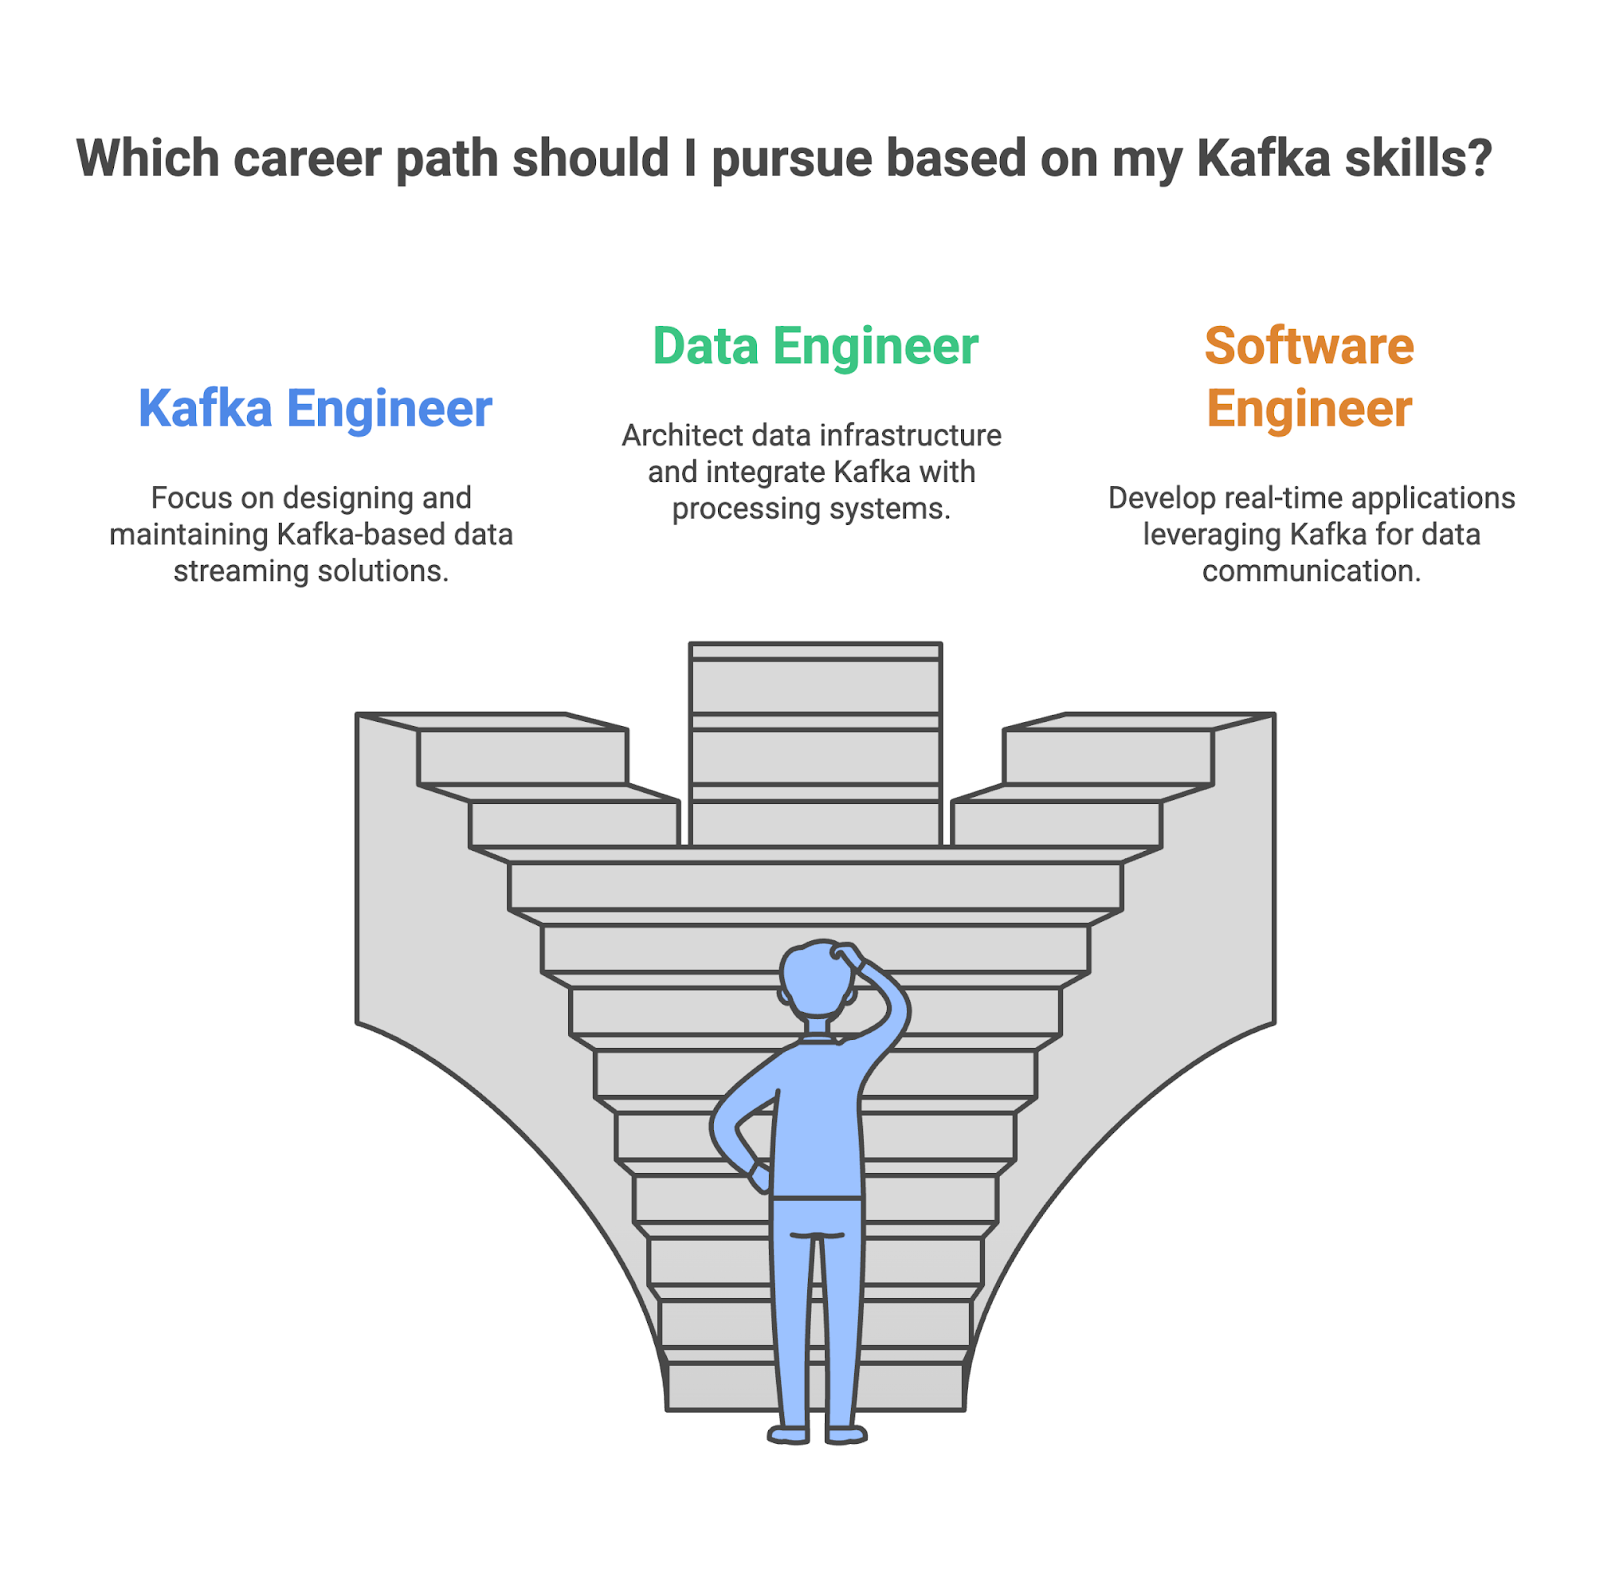
Come Kafka engineer, sei responsabile di progettare, costruire e mantenere soluzioni di data streaming basate su Kafka con alta disponibilità e scalabilità. Dovrai garantire un flusso di dati affidabile ed efficiente all’interno dell’azienda, oltre a monitorare e ottimizzare le prestazioni di Kafka per assicurare throughput e latenza ottimali.
Come data engineer, sei l’architetto dell’infrastruttura dati, responsabile di progettare e costruire i sistemi che gestiscono i dati di un’azienda. Kafka spesso gioca un ruolo importante in queste pipeline, abilitando uno streaming dati in tempo reale efficiente e scalabile tra i diversi sistemi. Dovrai assicurarti che Kafka si integri senza problemi con gli altri componenti.
Come software engineer, userai Kafka per creare applicazioni real-time come piattaforme di chat e giochi online. Dovrai integrarlo nel codice applicativo per garantire un flusso dati fluido collegandoti a vari sistemi di messaggistica e API. Ottimizzerai inoltre queste applicazioni per scalabilità e prestazioni, consentendo loro di gestire grandi quantità di dati in tempo reale.
|
Ruolo |
Cosa fai |
Le tue competenze chiave |
Strumenti che usi |
|
Kafka Engineer |
Progetta e implementa cluster Kafka per alta disponibilità e scalabilità. |
Architettura e componenti Kafka, amministrazione e configurazione, concetti di stream processing. |
Apache Kafka, Kafka Connect, Kafka Streams, ZooKeeper |
|
Data Engineer |
Progetta e implementa data warehouse e data lake, integra Kafka con altri sistemi di elaborazione e archiviazione dei dati |
Competenza in strumenti di data processing, esperienza con piattaforme cloud e conoscenza di Kafka. |
Apache Kafka, Apache Spark, Hadoop, Hive, Piattaforme cloud |
|
Software Engineer |
Progetta e sviluppa applicazioni che sfruttano Kafka per la comunicazione dati in tempo reale. |
Competenze di programmazione, sistemi e applicazioni distribuite, conoscenza del modello publisher-subscriber di Kafka. |
Apache Kafka, Java, Python, Scala, RabbitMQ, ActiveMQ, Strumenti e framework di sviluppo. |
Avere una laurea può essere molto utile per intraprendere una carriera in un ruolo legato ai dati che utilizza Apache Kafka, ma non è l’unica strada per avere successo. Sempre più persone con background ed esperienze diverse iniziano a lavorare in ruoli data-related. Con dedizione, apprendimento costante e un approccio proattivo, puoi ottenere il lavoro dei tuoi sogni che usa Apache Kafka.
Rimani aggiornato con gli ultimi sviluppi su Kafka. Segui sui social professionisti influenti coinvolti in Apache Kafka, leggi blog dedicati e ascolta podcast su Kafka.
Interagisci con figure influenti, come Neha Narkhede, che ha co-creato Kafka ed è anche CTO di Confluent. Otterrai insight su temi di tendenza, tecnologie emergenti e sulla direzione futura di Apache Kafka. Puoi anche leggere il blog di Confluent, che offre articoli e tutorial approfonditi su un’ampia gamma di argomenti Kafka, dall’architettura e l’amministrazione ai casi d’uso e alle best practice.
Dovresti anche dare un’occhiata agli eventi del settore, come i webinar su Confluent o il Kafka Summit annuale.
Devi distinguerti dagli altri candidati. Un buon modo è costruire un portfolio solido che mostri le tue competenze e i progetti completati.
Il tuo portfolio dovrebbe contenere progetti che dimostrino la tua competenza nella costruzione di pipeline dati, nell’implementazione di applicazioni di stream processing e nell’integrazione di Kafka con altri sistemi.
I recruiter devono esaminare centinaia di curriculum e distinguere i candidati migliori. Inoltre, spesso il tuo CV passa attraverso sistemi di tracciamento delle candidature (ATS), software automatici usati da molte aziende per esaminare i CV e scartare quelli che non soddisfano criteri specifici. Quindi, dovresti costruire un ottimo CV e scrivere una cover letter efficace per impressionare sia l’ATS sia i recruiter.
Fatti notare da un hiring manager
Se vieni notato dall’hiring manager o il tuo CV efficace supera la selezione, dovresti poi prepararti per un colloquio tecnico. Per essere pronto, puoi consultare questo articolo su 20 domande di colloquio su Kafka per data engineer.
Imparare Apache Kafka può aprirti le porte a opportunità e sviluppi di carriera migliori. Il percorso per imparare Kafka è gratificante ma richiede costanza e pratica hands-on. Sperimentare e risolvere sfide usando questo strumento può accelerare il tuo apprendimento e fornirti esempi reali per dimostrare le tue competenze pratiche quando cerchi lavoro.
Impara il data engineering con questi corsi!
Corso
Corso
Programma
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min



