
कोर्स
Apache Kafka परिचय
2 घंटा
12.1K
रीयल-टाइम में डेटा प्रोसेस करना हमें बेहतरीन अवसर देता है। अगर कोई बैंक हमारे क्रेडिट कार्ड से संदिग्ध खरीदारी का पता लगाता है, तो वे लेन-देन को तुरंत रोक सकते हैं। या, अगर हम किसी प्रोडक्ट की तलाश कर रहे हैं, तो वेबसाइट ब्राउज़ करते समय उत्पाद सुझाव पॉप-अप हो सकते हैं। यह गति बेहतर फैसलों, संतुष्ट ग्राहकों, और अधिक कुशल व्यवसाय का मतलब है।
Apache Kafka उच्च थ्रूपुट वाला, वितरित डेटा स्टोर है जो रीयल-टाइम में स्ट्रीमिंग डेटा को एकत्रित करने, प्रोसेस करने, संग्रहीत करने, और विश्लेषण करने के लिए अनुकूलित है। यह अलग-अलग एप्लिकेशनों को डेटा स्ट्रीम प्रकाशित करने और सब्सक्राइब करने देता है, जिससे वे जैसे ही इवेंट घटित हों, संवाद कर सकें और प्रतिक्रिया दे सकें।
क्योंकि यह डेटा स्ट्रीम्स को कुशलतापूर्वक मैनेज करता है, Kafka बहुत लोकप्रिय हो गया है। इसका उपयोग ऑनलाइन शॉपिंग और सोशल मीडिया से लेकर बैंकिंग और हेल्थकेयर तक विभिन्न सिस्टम्स में किया जाता है।
Apache Kafka रीयल-टाइम डेटा स्ट्रीम्स को संभालने की चुनौतियों का सामना करने वाले डेटा प्रैक्टिशनर्स के बीच लोकप्रिय हो गया है। इसकी लोकप्रियता को कई प्रमुख कारणों से समझाया जा सकता है:
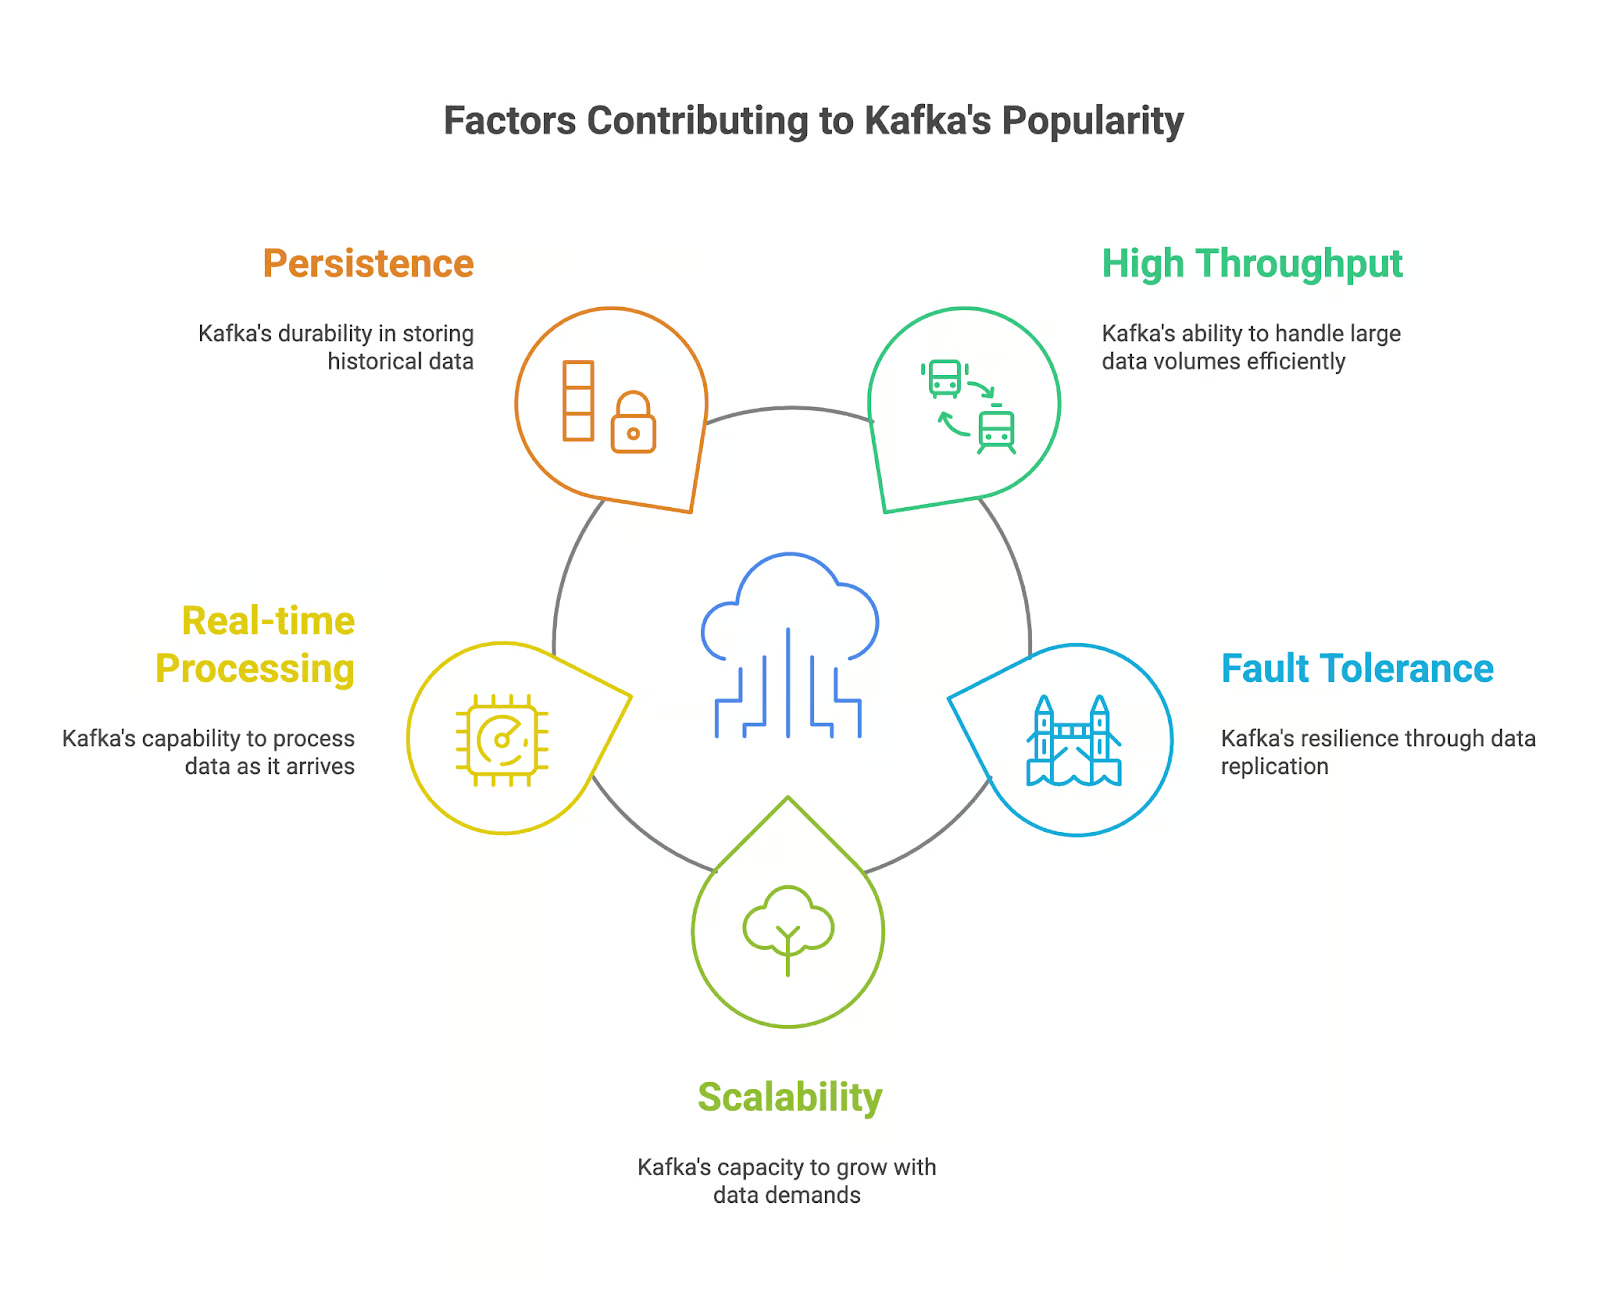
Apache Kafka का इस्तेमाल वर्तमान में उन एप्लिकेशनों में होता है जिन्हें रीयल-टाइम में डेटा प्रोसेस और विश्लेषण करना होता है। लेकिन कौन-सी विशेषताएँ इसे स्ट्रीमिंग डेटा संभालने के लिए शक्तिशाली टूल बनाती हैं? आइए उन्हें देखें:
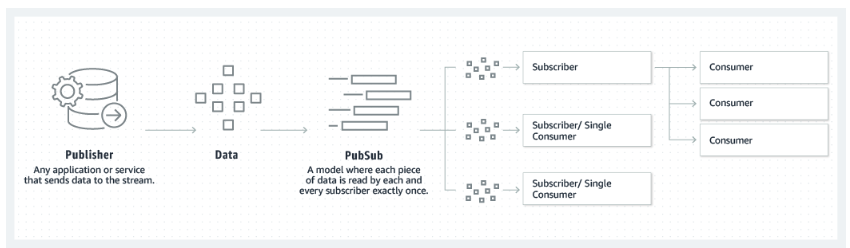
वह पब्लिशर-सब्सक्राइबर मॉडल जिस पर Kafka निर्भर करता है। स्रोत: Amazon
Apache Kafka सीखने से आप उन नियोक्ताओं और कंपनियों के लिए मूल्यवान उम्मीदवार बन जाते हैं जो तेज़ी से डेटा जनरेट और प्रोसेस करती हैं। अपनी शक्तिशाली विशेषताओं और व्यापक उपयोग के साथ, Apache Kafka आधुनिक डेटा आर्किटेक्चर और एप्लिकेशनों के निर्माण का एक प्रमुख टूल बन गया है।
मैंने बताया है कि हाल के वर्षों में Kafka बहुत लोकप्रिय हुआ है। अनुमान है कि वर्तमान में Apache Kafka का उपयोग Fortune 100 की 80% कंपनियाँ कर रही हैं।
विभिन्न उद्योगों में Kafka का बढ़ता उपयोग, और रीयल-टाइम डेटा समाधानों को सक्षम करने में इसकी भूमिका, नौकरी के बाजार में Kafka कौशल को अत्यधिक मूल्यवान बनाती है। PayScale और ZipRecruiter के अनुसार, नवंबर 2024 तक, संयुक्त राज्य अमेरिका में Kafka कौशल वाले इंजीनियर का औसत वेतन $100,000 प्रति वर्ष है।
हम पहले ही Apache Kafka की खूबियों का उल्लेख कर चुके हैं, लेकिन आइए कुछ विशिष्ट उदाहरण देखें जहाँ आप इनका उपयोग कर सकते हैं:
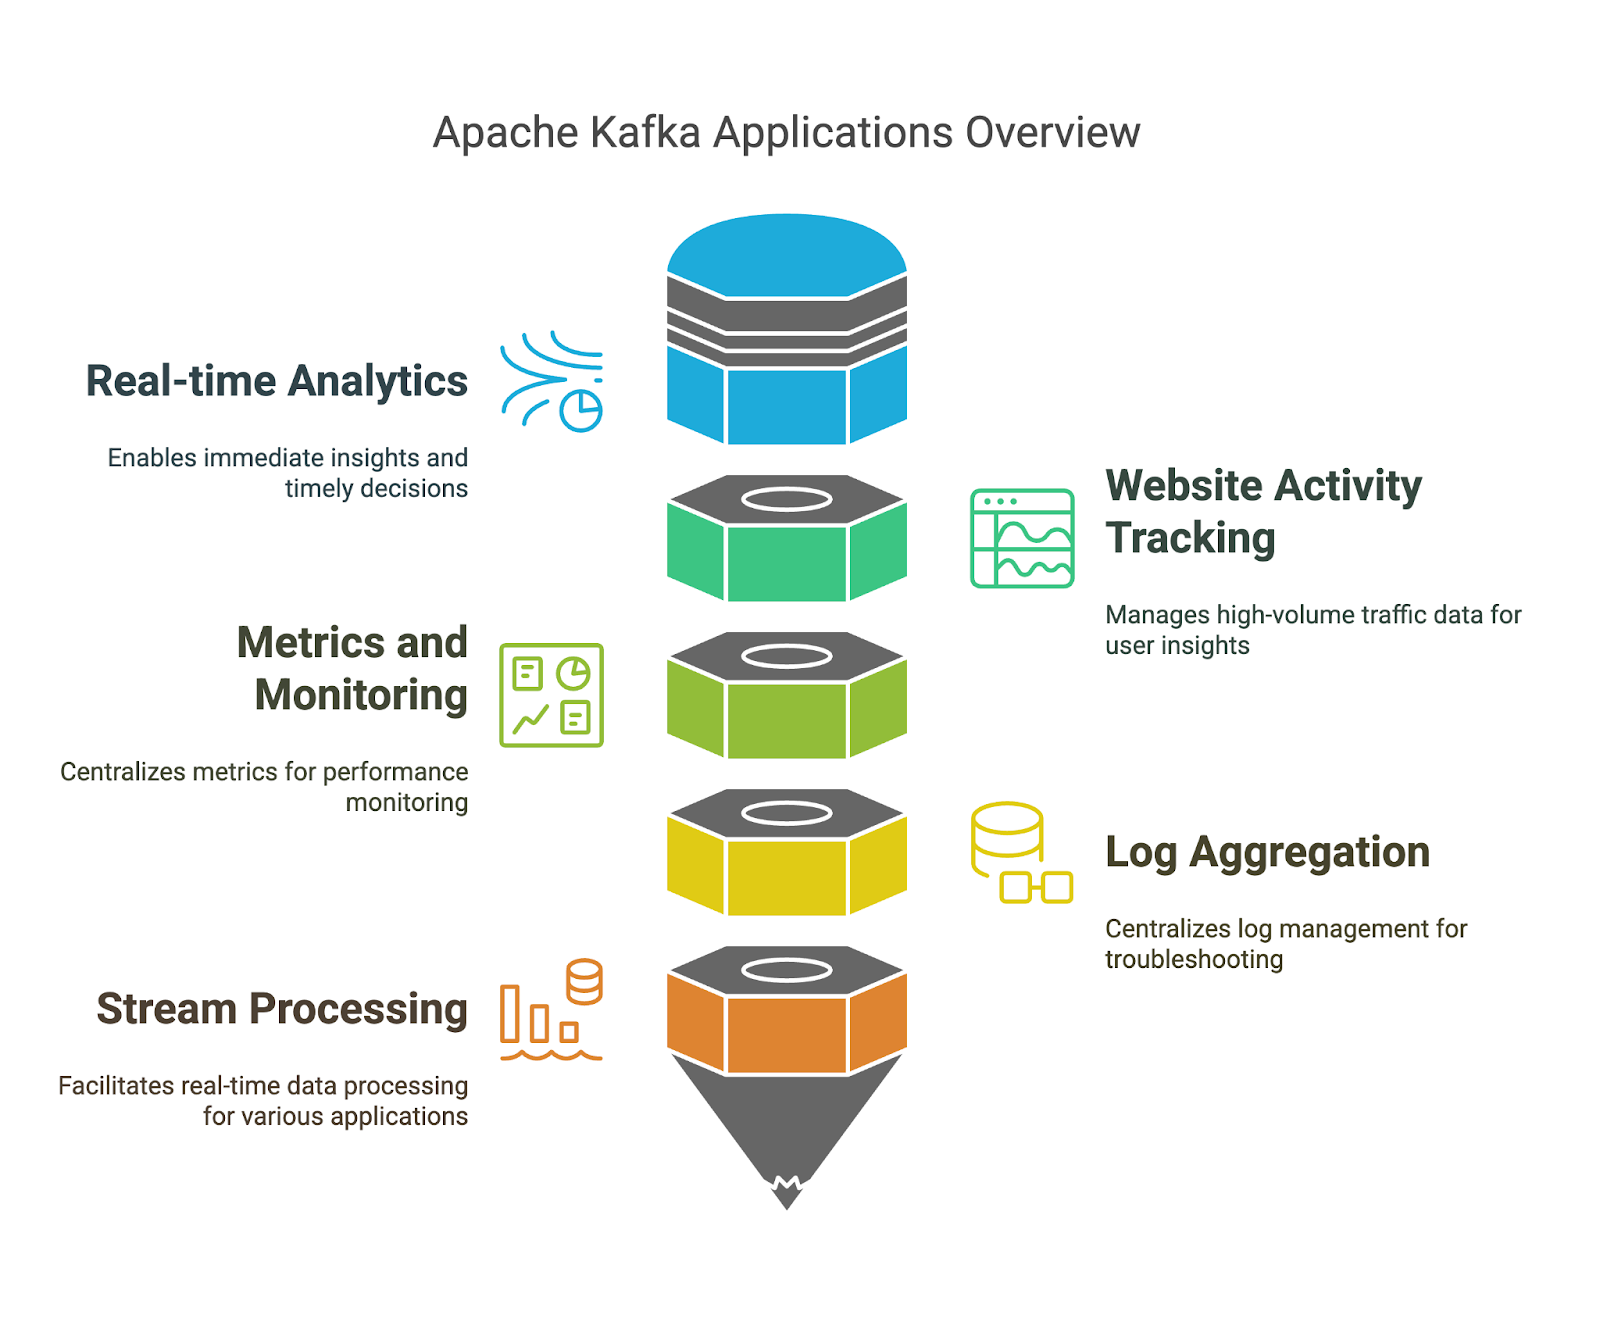
यदि आप Apache Kafka को विधिवत सीखते हैं, तो सफलता की संभावनाएँ बढ़ती हैं। आइए कुछ सिद्धांतों पर ध्यान दें जिनका उपयोग आप अपनी सीखने की यात्रा में कर सकते हैं।
तकनीकी विवरण सीखने से पहले, Apache Kafka सीखने की अपनी प्रेरणा स्पष्ट करें। खुद से पूछें:
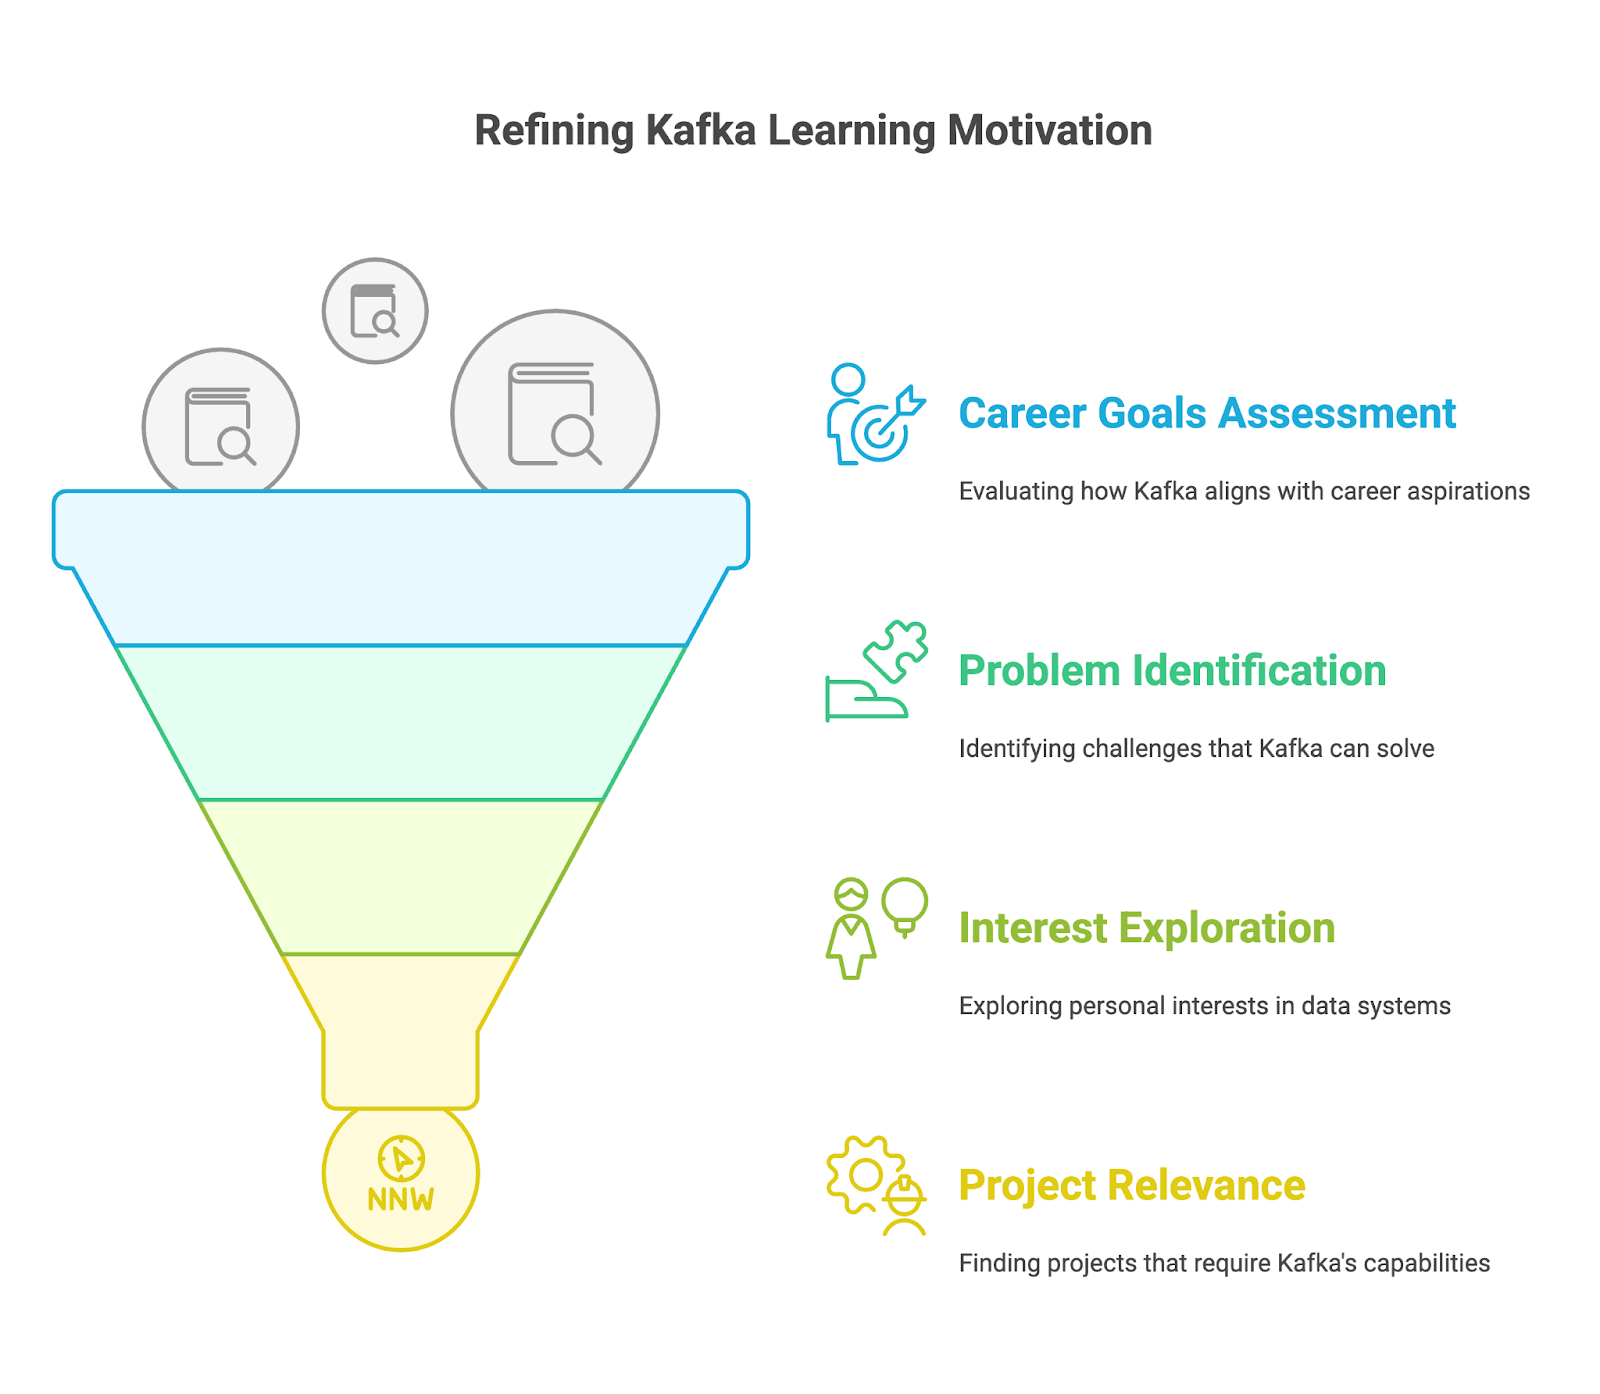
लक्ष्यों की पहचान करने के बाद, Kafka की बुनियादी अवधारणाएँ सीखें और समझें कि वे कैसे काम करती हैं।
Apache Kafka सीखने के लिए, हमें पहले इसे अपनी लोकल मशीन पर लेना होगा। क्योंकि Kafka Java में विकसित है, हमें सुनिश्चित करना चाहिए कि Java इंस्टॉल हो। उसके बाद, हमें आधिकारिक वेबसाइट से Kafka बाइनरीज़ डाउनलोड करके उन्हें एक्सट्रैक्ट करना होगा।
अब हम दिए गए स्क्रिप्ट्स से पहले ZooKeeper, फिर Kafka सर्वर शुरू करते हैं। अंत में, कमांड-लाइन टूल्स का उपयोग करके टॉपिक्स बनाएँ और कुछ संदेश प्रोड्यूस- consume करके मूल बातें समझें। DataCamp का Apache Kafka for Beginners लेख आपको तेजी से गति पकड़ने में मदद कर सकता है।
सबसे पहले हमें Kafka में पब्लिशर-सब्सक्राइबर मॉडल सीखना चाहिए। यही वह प्रमुख कारणों में से एक है जिसके चलते Apache Kafka स्ट्रीमिंग डेटा को कुशलता से संभाल पाता है। समझें कि प्रोड्यूसर्स कैसे संदेश प्रकाशित करते हैं और कंज़्यूमर्स कैसे इन टॉपिक्स को सब्सक्राइब करते हैं, जिससे उन्हें केवल अपने हित से संबंधित संदेश मिलते हैं।
DataCamp का Introduction to Apache Kafka कोर्स एक परिचय प्रदान करता है, जिसमें इंटरएक्टिव अभ्यास और व्यावहारिक उदाहरण शामिल हैं।
पब्लिशर-सब्सक्राइबर मॉडल का वर्णन करते समय, हमने कुछ प्रमुख Kafka कॉम्पोनेन्ट्स का उल्लेख किया है: Producer और Consumer। हालाँकि, हमें सभी कोर कॉम्पोनेन्ट्स का विस्तार से अध्ययन करना चाहिए। सीखें कि Kafka डेटा को टॉपिक्स और पार्टिशनों में कैसे व्यवस्थित करता है, और समझें कि पार्टिशन स्केलेबिलिटी और फॉल्ट टॉलरेंस में कैसे योगदान देते हैं।
यह भी समझना चाहिए कि ब्रोकर्स उच्च उपलब्धता और फॉल्ट टॉलरेंस प्रदान करने के लिए क्लस्टर कैसे बनाते हैं।
DataCamp के Introduction to Apache Kafka कोर्स के साथ-साथ Apache Kafka for Beginners लेख भी देखें ताकि इन विषयों की स्पष्ट तस्वीर मिले।
जब आप बुनियादी बातों में सहज हो जाएँ, तो अब मध्यम-स्तर के Apache Kafka कौशलों को एक्सप्लोर करने का समय है।
Apache Kafka की प्रमुख विशेषताओं में से एक है स्ट्रीमिंग डेटा की बड़ी मात्राओं को संभालना। Kafka Connect, Apache Kafka का एक ओपन-सोर्स, मुफ़्त कॉम्पोनेन्ट है जो फ़ाइल सिस्टम्स, डेटाबेस, सर्च इंडेक्सेज़, और की-वैल्यू स्टोर्स के बीच डेटा इंटीग्रेशन को सरल बनाता है।
Connect का उपयोग करना सीखना हमें एनालिटिक्स, एप्लिकेशन इंटीग्रेशन, और मज़बूत, स्केलेबल डेटा आर्किटेक्चर बनाने के लिए कुशल डेटा फ़्लो अनलॉक करने में मदद कर सकता है। अधिक विवरण के लिए हमारा Apache Kafka for Beginners लेख देखें।
Kafka की एक और उन्नत विशेषता Streams है। हमें Streams की मदद से सीधे Kafka के भीतर स्ट्रीम प्रोसेसिंग एप्लिकेशन बनाना सीखना चाहिए। यह निरंतर डेटा स्ट्रीम्स को हैंडल, कन्वर्ट और इवैल्यूएट करने के लिए APIs और एक हाई-लेवल डोमेन-स्पेसिफिक लैंग्वेज प्रदान करता है। अधिक जानकारी के लिए Apache Kafka for Beginners लेख देखें।
किसी भी तकनीक की तरह, इसके प्रदर्शन पर नज़र रखना अच्छा होता है। इसके लिए, हमें अपने Kafka क्लस्टर के स्वास्थ्य और प्रदर्शन की मॉनिटरिंग करना सीखना चाहिए। प्रमुख मेट्रिक्स की मॉनिटरिंग, टॉपिक्स और पार्टिशन मैनेज करने, और इष्टतम प्रदर्शन सुनिश्चित करने के लिए टूल्स और तकनीकों का पता लगा सकते हैं।
Apache Kafka पर कोर्स करना तकनीक से परिचित होने का बढ़िया तरीका है। हालाँकि, Kafka में दक्ष बनना है तो आपको चुनौतीपूर्ण और कौशल-निर्माण समस्याएँ हल करनी होंगी, जैसे वास्तविक प्रोजेक्ट्स में आती हैं।
आप सरल डेटा स्ट्रीमिंग कार्यों से शुरू कर सकते हैं, जैसे संदेश प्रोड्यूस और कंज़्यूम करना, फिर धीरे-धीरे जटिलता बढ़ाएँ—जैसे पार्टिशनिंग, फॉल्ट टॉलरेंस, और Kafka Connect का उपयोग करके बाहरी सिस्टम्स के साथ इंटीग्रेशन।
अपने कौशल का अभ्यास करने के कुछ तरीके:
Apache Kafka सीखने की यात्रा में आप विभिन्न प्रोजेक्ट्स पूरा करेंगे। अपनी Apache Kafka कौशल और अनुभव संभावित नियोक्ताओं को दिखाने के लिए, आपको इन्हें एक पोर्टफोलियो में संकलित करना चाहिए। यह पोर्टफोलियो आपके कौशल और रुचियों को दर्शाए और आपके करियर या उद्योग लक्ष्यों के अनुरूप हो।
अपने प्रोजेक्ट्स को मौलिक बनाने का प्रयास करें और अपनी समस्या-समाधान क्षमता प्रदर्शित करें। ऐसे प्रोजेक्ट्स शामिल करें जो Kafka के विभिन्न पहलुओं में आपकी दक्षता दिखाएँ, जैसे Kafka Connect के साथ डेटा पाइपलाइंस बनाना, Kafka Streams के साथ स्ट्रीमिंग एप्लिकेशन विकसित करना, या Kafka क्लस्टर्स के साथ काम करना। अपने प्रोजेक्ट्स का समुचित दस्तावेज़ीकरण करें—प्रसंग, कार्यप्रणाली, कोड, और परिणाम दें। आप GitHub जैसे प्लेटफ़ॉर्म पर कोड होस्ट कर सकते हैं और मैनेज्ड Kafka वातावरण के लिए Confluent Cloud का उपयोग कर सकते हैं।
Kafka सीखना एक सतत यात्रा है। तकनीक लगातार विकसित होती रहती है, और नए फीचर्स व एप्लिकेशन नियमित रूप से विकसित होते रहते हैं। Kafka भी इसका अपवाद नहीं है।
एक बार आप मूलभूत बातों में निपुण हो जाएँ, तो अधिक चुनौतीपूर्ण कार्यों और प्रोजेक्ट्स की तलाश करें, जैसे उच्च थ्रूपुट सिस्टम्स के लिए परफॉर्मेंस ट्यूनिंग, और Kafka Streams के साथ उन्नत स्ट्रीम प्रोसेसिंग लागू करना। अपने लक्ष्यों पर फोकस करें और अपने करियर लक्ष्यों और रुचियों से संबंधित क्षेत्रों में विशेषज्ञता विकसित करें।
नए विकास—जैसे नए फीचर्स या KIP प्रपोजल्स—से अपडेट रहें, और जानें कि उन्हें अपने प्रोजेक्ट्स में कैसे लागू करें। अभ्यास करते रहें, नए चैलेंज और अवसर खोजें, और गलतियों से सीखने की सोच अपनाएँ।
भले ही हर व्यक्ति का सीखने का अपना तरीका हो, किसी नए टूल को सीखने के लिए एक योजना या मार्गदर्शिका होना हमेशा अच्छा विचार है। यदि आप Apache Kafka के साथ अभी शुरुआत कर रहे हैं, तो मैंने आपके समय और प्रयास केंद्रित करने के लिए एक संभावित सीखने की योजना तैयार की है।
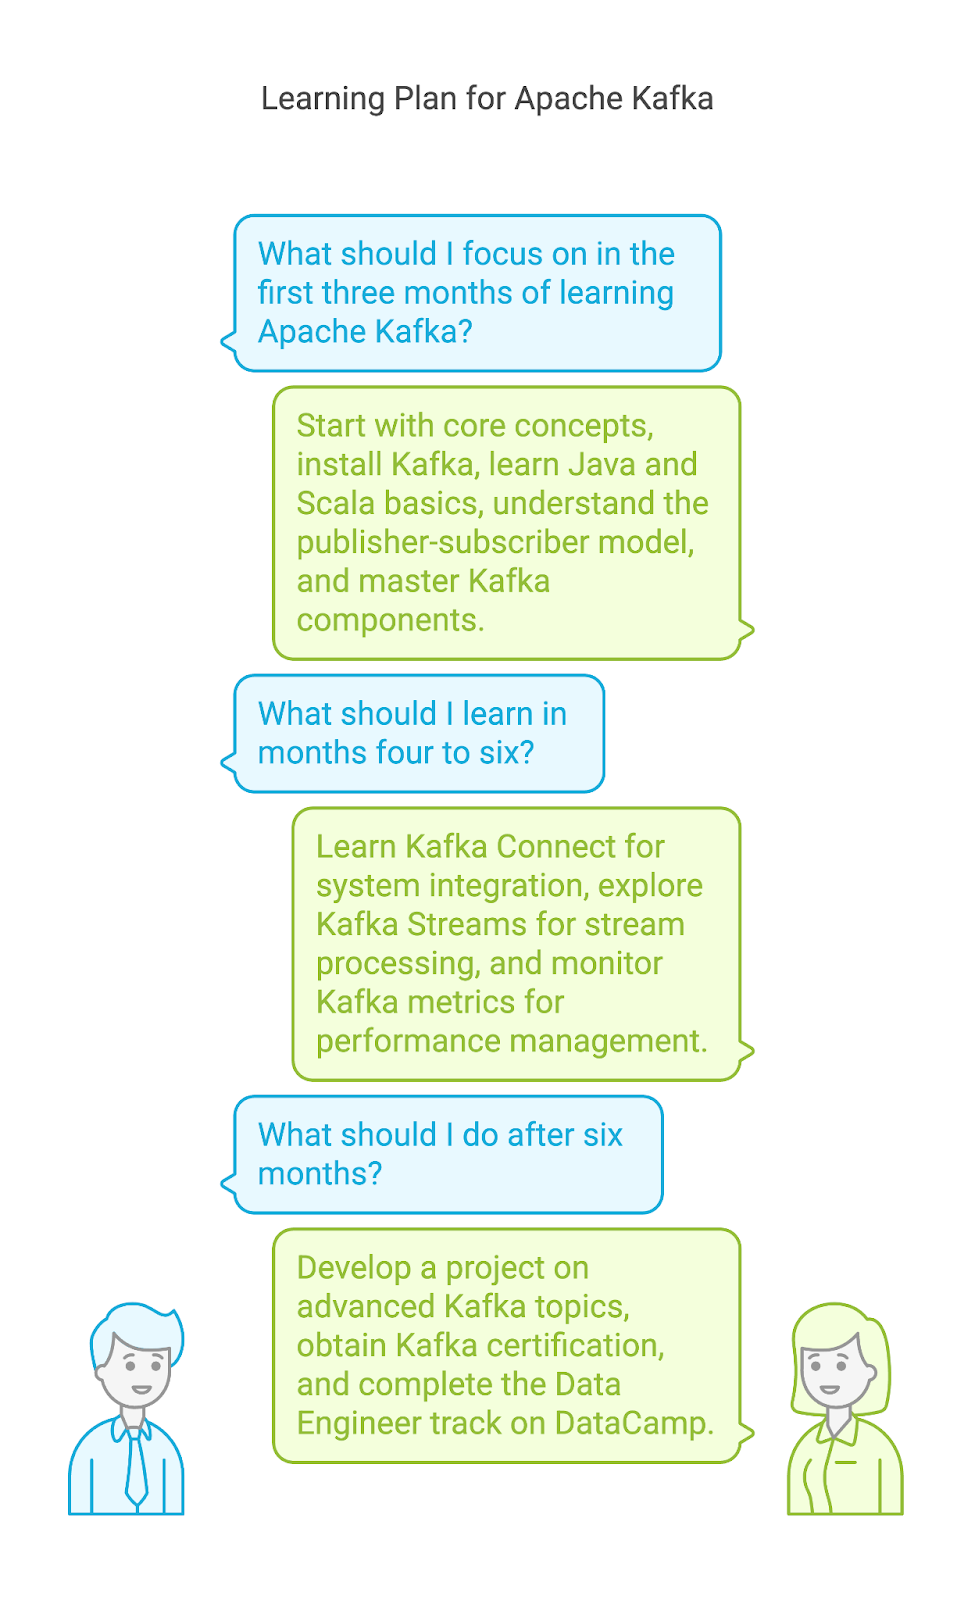
मुझे लगता है कि अब आप Kafka सीखने के लिए तैयार हैं और अपने नए कौशल का अभ्यास करने के लिए बड़े डेटा सेट पर हाथ आज़माना चाहते हैं। लेकिन उससे पहले, मैं कुछ सुझावों पर प्रकाश डालना चाहता हूँ जो आपको Apache Kafka में दक्षता हासिल करने के मार्ग पर मदद करेंगे।
Kafka एक बहुमुखी टूल है जिसका कई तरीकों से उपयोग किया जा सकता है। आपको Kafka इकोसिस्टम में अपने विशिष्ट लक्ष्य और रुचियाँ पहचाननी चाहिए। Kafka के किस पहलू की ओर आपका सबसे अधिक झुकाव है? क्या आप डेटा इंजीनियरिंग, स्ट्रीम प्रोसेसिंग, या Kafka प्रशासन में रुचि रखते हैं? केंद्रित दृष्टिकोण आपको Apache Kafka के सबसे प्रासंगिक पहलुओं और ज्ञान को प्राप्त करने में मदद करेगा।
किसी भी नए कौशल में महारत हासिल करने की कुंजी निरंतरता है। आपको Kafka का अभ्यास करने के लिए समर्पित समय निर्धारित करना चाहिए। हर दिन थोड़ा-सा समय ही पर्याप्त है। आपको रोज़ जटिल अवधारणाओं से नहीं जूझना। आप हैंड्स-ऑन अभ्यास कर सकते हैं, ट्यूटोरियल्स पर काम कर सकते हैं, और Kafka की विभिन्न विशेषताओं के साथ प्रयोग कर सकते हैं। जितना अधिक आप अभ्यास करेंगे, प्लेटफ़ॉर्म के साथ उतने ही सहज होंगे।
यह एक प्रमुख सुझाव है, और आप इसे इस गाइड में कई बार पढ़ेंगे। अभ्यास प्रश्न आत्मविश्वास बढ़ाने के लिए अच्छे हैं। हालाँकि, अपनी Kafka स्किल्स को वास्तविक प्रोजेक्ट्स में लागू करना ही आपको उत्कृष्ट बनाएगा।
सरल प्रोजेक्ट्स और प्रश्नों से शुरुआत करें और धीरे-धीरे अधिक जटिल कार्य लें। इसमें एक सरल प्रोड्यूसर-कंज़्यूमर एप्लिकेशन सेट अप करना शामिल हो सकता है, फिर Kafka Connect के साथ रीयल-टाइम डेटा पाइपलाइन बनाना, या Kafka Streams के साथ फॉल्ट-टॉलरेंट स्ट्रीमिंग एप्लिकेशन डिज़ाइन करना। कुंजी यह है कि लगातार खुद को चुनौती दें और व्यावहारिक Kafka कौशल का विस्तार करें।
अक्सर सहयोगात्मक रूप से सीखना अधिक प्रभावी होता है। अपने अनुभव साझा करना और दूसरों से सीखना आपकी प्रगति को तेज कर सकता है और मूल्यवान अंतर्दृष्टि प्रदान कर सकता है।
ज्ञान, विचारों और प्रश्नों का आदान-प्रदान करने के लिए आप Apache Kafka से संबंधित कुछ समूहों में शामिल हो सकते हैं, और मीट-अप्स व कॉन्फ़्रेंस में भाग ले सकते हैं। आप ऑनलाइन समुदायों जैसे Confluent Slack चैनल या Confluent फ़ोरम से जुड़ सकते हैं जहाँ आप अन्य Kafka उत्साही लोगों के साथ संवाद कर सकते हैं। आप वर्चुअल या इन-पर्सन मीट-अप्स, जिनमें Kafka विशेषज्ञों के टॉक्स होते हैं, या ApacheCon जैसी कॉन्फ़्रेंस में भी शामिल हो सकते हैं।
किसी भी तकनीक की तरह, Apache Kafka सीखना एक आवर्ती प्रक्रिया है। अपनी गलतियों से सीखना इस प्रक्रिया का आवश्यक हिस्सा है। प्रयोग करने, अलग-अलग तरीकों को आज़माने, और त्रुटियों से सीखने से न डरें।
अपने Kafka प्रोड्यूसर्स और कंज़्यूमर्स के लिए अलग-अलग कॉन्फ़िगरेशन आज़माएँ, विभिन्न डेटा सीरियलाइज़ेशन विधियों (JSON, Avro, Protobuf) को एक्सप्लोर करें, और अलग-अलग पार्टिशनिंग रणनीतियों के साथ प्रयोग करें। अपने Kafka क्लस्टर को उच्च संदेश वॉल्यूम्स के साथ सीमा तक धकेलें, और देखें कि वह लोड कैसे संभालता है। कंज़्यूमर लैग का विश्लेषण करें, कॉन्फ़िगरेशन फाइन-ट्यून करें, और समझें कि आपके अनुकूलन प्रदर्शन को कैसे प्रभावित करते हैं।
टॉपिक्स, पार्टिशन, कंज़्यूमर ग्रुप्स, और ZooKeeper की भूमिका जैसे मूल कॉन्सेप्ट्स को वास्तव में समझने के लिए समय लें। यदि आप अभी एक ठोस नींव बनाते हैं, तो आपके लिए उन्नत विषयों को समझना और समस्याओं का प्रभावी समाधान करना आसान होगा। सीखने की प्रक्रिया को छोटे-छोटे चरणों में बाँटें, और जानकारी को आत्मसात करने के लिए खुद को समय दें। धीमी और स्थिर गति अक्सर गहन समझ और महारत की ओर ले जाती है।
आइए Apache Kafka सीखने के कुछ प्रभावी तरीकों को कवर करें।
ऑनलाइन कोर्स आपको अपनी गति से Apache Kafka सीखने का उत्कृष्ट तरीका प्रदान करते हैं। DataCamp एक Kafka इंटरमीडिएट कोर्स प्रदान करता है। यह कोर्स Kafka के कोर कॉन्सेप्ट्स को कवर करता है, जिनमें पब्लिशर-सब्सक्राइबर मॉडल, टॉपिक्स और पार्टिशन, ब्रोकर्स और क्लस्टर्स, प्रोड्यूसर्स, और कंज़्यूमर्स शामिल हैं।
ट्यूटोरियल्स Apache Kafka सीखने का एक और बढ़िया तरीका हैं, खासकर अगर आप इस तकनीक में नए हैं। इनमें विशिष्ट कार्य करने या किसी अवधारणा को समझने के चरण-दर-चरण निर्देश होते हैं। शुरुआत के लिए, इन ट्यूटोरियल्स पर विचार करें:
Apache Kafka के फायदों की गहरी समझ के लिए, आपको अन्य तकनीकों के साथ इसकी मुख्य समानताएँ और भिन्नताएँ भी समझनी चाहिए। आप ऐसे लेख पढ़ सकते हैं जिनमें Kafka की तुलना अन्य टूल्स से की गई है, जैसे:
पुस्तकें Apache Kafka सीखने का उत्कृष्ट स्रोत हैं। वे विशेषज्ञों की गहन जानकारी और अंतर्दृष्टि प्रदान करती हैं, साथ ही कोड स्निपेट्स और व्याख्याएँ भी। Kafka पर कुछ लोकप्रिय पुस्तकें इस प्रकार हैं:
क्योंकि Apache Kafka का अपनाव बढ़ता जा रहा है, वैसे ही Kafka कौशल वाले पेशेवरों के लिए करियर अवसर भी—विशिष्ट Kafka इंजीनियरों से लेकर सॉफ़्टवेयर इंजीनियरों तक—बढ़ रहे हैं। यदि आप अपने Kafka कौशल की उपयुक्तता का मूल्यांकन कर रहे हैं, तो इन भूमिकाओं पर विचार करें:
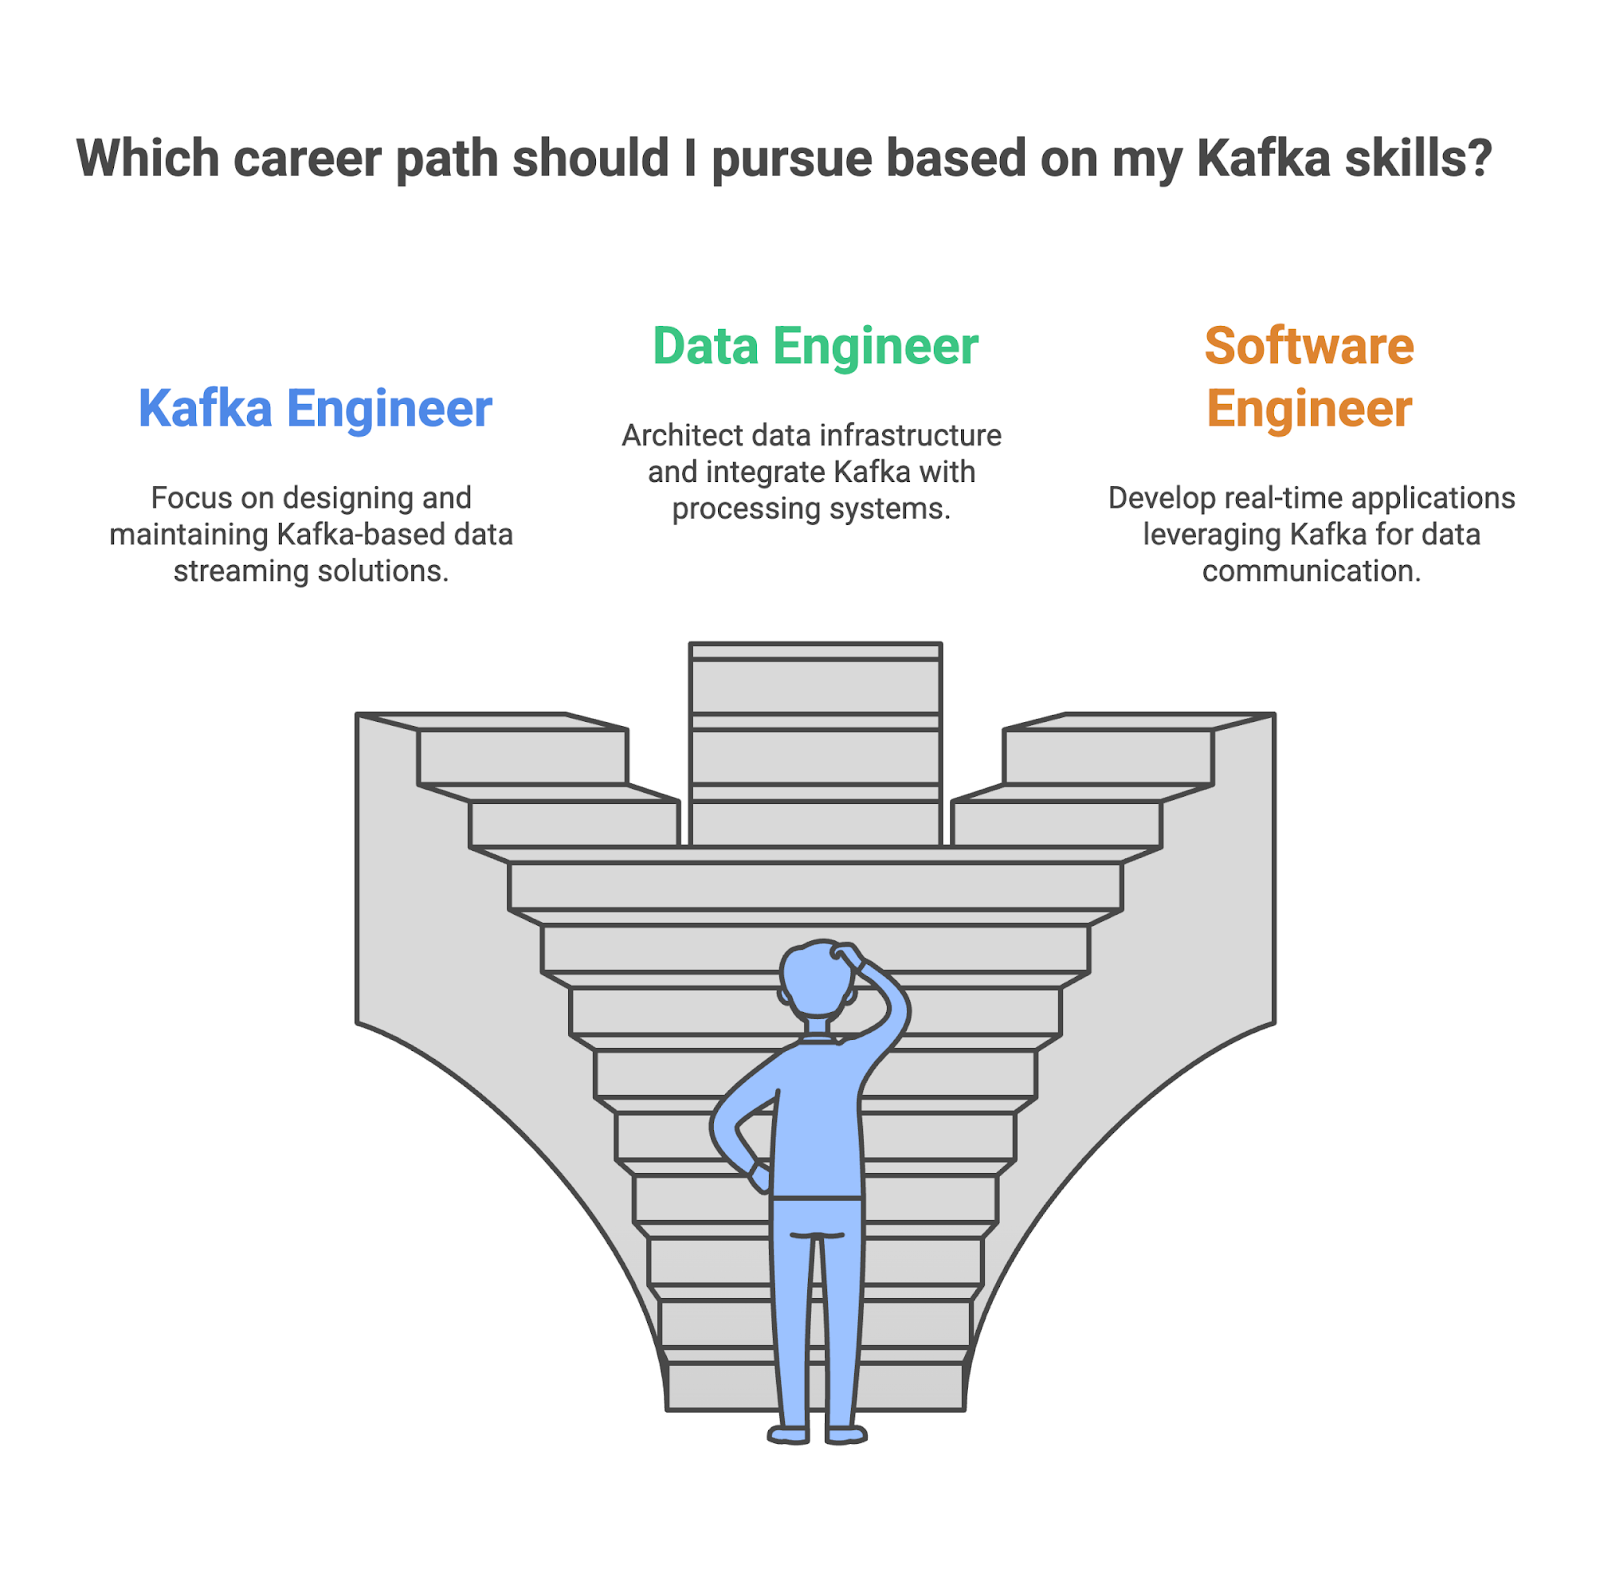
Kafka इंजीनियर के रूप में, आप उच्च उपलब्धता और स्केलेबिलिटी वाले Kafka-आधारित डेटा स्ट्रीमिंग समाधानों को डिज़ाइन, निर्माण, और बनाए रखने के लिए ज़िम्मेदार होते हैं। आपको कंपनी के भीतर डेटा के विश्वसनीय और कुशल प्रवाह को सुनिश्चित करना होगा, साथ ही इष्टतम थ्रूपुट और लेटेंसी सुनिश्चित करने के लिए Kafka के प्रदर्शन की मॉनिटरिंग और ऑप्टिमाइज़ेशन करना होगा।
डेटा इंजीनियर के रूप में, आप डेटा इन्फ्रास्ट्रक्चर के आर्किटेक्ट होते हैं, जो कंपनी के डेटा को संभालने वाले सिस्टम्स को डिज़ाइन और बनाते हैं। इन डेटा पाइपलाइंस में Kafka अक्सर एक महत्वपूर्ण भूमिका निभाता है, जो विभिन्न सिस्टम्स के बीच कुशल और स्केलेबल रीयल-टाइम डेटा स्ट्रीमिंग को सक्षम करता है। आपको सुनिश्चित करना होगा कि Kafka अन्य कॉम्पोनेन्ट्स के साथ निर्बाध रूप से इंटीग्रेट हो।
सॉफ़्टवेयर इंजीनियर के रूप में, आप Kafka का उपयोग चैट प्लेटफ़ॉर्म्स और ऑनलाइन गेम्स जैसी रीयल-टाइम एप्लिकेशन बनाने के लिए करेंगे। आपको एप्लिकेशन कोड में इसे इंटीग्रेट करना होगा ताकि विभिन्न मैसेजिंग सिस्टम्स और APIs से कनेक्ट करके डेटा प्रवाह सुचारू रहे। आप इन एप्लिकेशनों को स्केलेबिलिटी और प्रदर्शन के लिए ऑप्टिमाइज़ भी करेंगे ताकि वे रीयल-टाइम डेटा की बड़ी मात्रा को संभाल सकें।
|
भूमिका |
आप क्या करते हैं |
आपके मुख्य कौशल |
आप जिन टूल्स का उपयोग करते हैं |
|
Kafka Engineer |
उच्च उपलब्धता और स्केलेबिलिटी के लिए Kafka क्लस्टर्स डिज़ाइन और इम्प्लीमेंट करें। |
Kafka आर्किटेक्चर, कॉम्पोनेन्ट्स, एडमिनिस्ट्रेशन और कॉन्फ़िगरेशन, स्ट्रीम प्रोसेसिंग कॉन्सेप्ट्स। |
Apache Kafka, Kafka Connect, Kafka Streams, ZooKeeper |
|
Data Engineer |
डेटा वेयरहाउस और डेटा लेक्स डिज़ाइन व इम्प्लीमेंट करें, Kafka को अन्य डेटा प्रोसेसिंग और स्टोरेज सिस्टम्स से इंटीग्रेट करें |
डेटा प्रोसेसिंग टूल्स में प्रवीणता, क्लाउड प्लेटफ़ॉर्म्स का अनुभव, और Kafka का ज्ञान। |
Apache Kafka, Apache Spark, Hadoop, Hive, क्लाउड प्लेटफ़ॉर्म्स |
|
Software Engineer |
ऐसी एप्लिकेशन डिज़ाइन और विकसित करें जो रीयल-टाइम डेटा संचार के लिए Kafka का लाभ उठाएँ। |
प्रोग्रामिंग स्किल्स, वितरित सिस्टम्स और एप्लिकेशंस, Kafka पब्लिशर-सब्सक्राइबर ज्ञान. |
Apache Kafka, Java, Python, Scala, RabbitMQ, ActiveMQ, डेवलपमेंट टूल्स और फ़्रेमवर्क्स। |
हालाँकि डेटा-संबंधित भूमिका के लिए डिग्री होना बहुत मूल्यवान हो सकता है, जो Apache Kafka का उपयोग करती है, यह सफलता का एकमात्र रास्ता नहीं है। अलग-अलग पृष्ठभूमियों और अनुभवों वाले अधिक से अधिक लोग डेटा-संबंधित भूमिकाओं में काम करना शुरू कर रहे हैं। समर्पण, निरंतर सीखने, और सक्रिय दृष्टिकोण के साथ, आप Apache Kafka का उपयोग करने वाली अपनी सपनों की नौकरी पा सकते हैं।
Kafka में नवीनतम विकास से अपडेट रहें। सोशल मीडिया पर Apache Kafka से जुड़े प्रभावशाली प्रोफेशनल्स को फॉलो करें, Kafka-संबंधित ब्लॉग पढ़ें, और Kafka से संबंधित पॉडकास्ट सुनें।
प्रभावशाली हस्तियों से जुड़ें, जैसे Neha Narkhede, जिन्होंने Kafka का सह-निर्माण किया और Confluent की CTO भी हैं। आपको ट्रेंडिंग विषयों, उभरती तकनीकों, और Apache Kafka की भविष्य दिशा पर अंतर्दृष्टि मिलेगी। आप यह भी पढ़ Confluent ब्लॉग सकते हैं, जो आर्किटेक्चर और प्रशासन से लेकर यूज़ केस और बेस्ट प्रैक्टिसेज़ तक Kafka के व्यापक विषयों पर गहन लेख और ट्यूटोरियल्स प्रदान करता है।
आप उद्योग आयोजनों की भी जाँच करें, जैसे Confluent पर वेबिनार या वार्षिक Kafka Summit।
आपको अन्य उम्मीदवारों से अलग दिखना होगा। ऐसा करने का एक अच्छा तरीका है एक मजबूत पोर्टफोलियो बनाना जो आपके कौशल और पूर्ण प्रोजेक्ट्स को प्रदर्शित करे।
आपके पोर्टफोलियो में ऐसे प्रोजेक्ट्स होने चाहिए जो डेटा पाइपलाइंस बनाने, स्ट्रीम प्रोसेसिंग एप्लिकेशन लागू करने, और Kafka को अन्य सिस्टम्स के साथ इंटीग्रेट करने में आपकी दक्षता दिखाएँ।
हायरिंग मैनेजर्स को सैकड़ों रेज़्यूमे की समीक्षा करनी होती है और बेहतरीन उम्मीदवारों को अलग करना होता है। साथ ही, कई बार आपका रेज़्यूमे Applicant Tracking Systems (ATS) से होकर गुजरता है—स्वचालित सॉफ़्टवेयर सिस्टम्स जो विशिष्ट मानदंडों पर खरे न उतरने वाले रेज़्यूमे को छाँट देते हैं। इसलिए, आपको एक बेहतरीन रेज़्यूमे बनाना चाहिए और प्रभावशाली कवर लेटर तैयार करना चाहिए ताकि ATS और रिक्रूटर्स—दोनों प्रभावित हों।
हायरिंग मैनेजर की नज़र में आएँ
यदि आप हायरिंग मैनेजर की नज़र में आ जाते हैं या आपका प्रभावी रेज़्यूमे चयन प्रक्रिया से गुज़र जाता है, तो अगला कदम तकनीकी इंटरव्यू की तैयारी है। तैयार रहने के लिए, आप यह लेख देख सकते हैं— डेटा इंजीनियर्स के लिए 20 Kafka इंटरव्यू प्रश्न।
Apache Kafka सीखना बेहतर अवसरों और करियर परिणामों के दरवाज़े खोल सकता है। Kafka सीखने का मार्ग फलदायी है, लेकिन निरंतरता और हैंड्स-ऑन अभ्यास की आवश्यकता होती है। इस टूल का उपयोग करके प्रयोग करना और चुनौतियों का समाधान करना आपके सीखने की प्रक्रिया को तेज कर सकता है और नौकरी खोजते समय आपकी व्यावहारिक स्किल्स दिखाने के लिए वास्तविक उदाहरण प्रदान कर सकता है।
इन कोर्सेज़ के साथ डेटा इंजीनियरिंग सीखें!
कोर्स
कोर्स
लर्निंग पाथ