
Kursus
Pengantar Apache Kafka
2 jam
12.1K
Memproses data secara real time memberi kita peluang besar. Jika bank mendeteksi pembelian mencurigakan dengan kartu kredit kita, mereka dapat menghentikan transaksi seketika. Atau, jika kita mencari produk, saran produk dapat muncul saat kita menelusuri situs web. Kecepatan ini berarti keputusan yang lebih baik, pelanggan lebih puas, dan bisnis yang lebih efisien.
Apache Kafka adalah penyimpanan data terdistribusi dengan throughput tinggi yang dioptimalkan untuk mengumpulkan, memproses, menyimpan, dan menganalisis data streaming secara real time. Ini memungkinkan berbagai aplikasi untuk memublikasikan dan berlangganan aliran data, sehingga mereka dapat berkomunikasi dan bereaksi terhadap peristiwa saat terjadi.
Karena mampu mengelola aliran data secara efisien, Kafka menjadi sangat populer. Teknologi ini digunakan di berbagai sistem, dari belanja online dan media sosial hingga perbankan dan layanan kesehatan.
Apache Kafka menjadi populer di kalangan praktisi data yang menghadapi tantangan penanganan aliran data real time. Kita dapat menjelaskan popularitasnya melalui beberapa faktor kunci berikut:
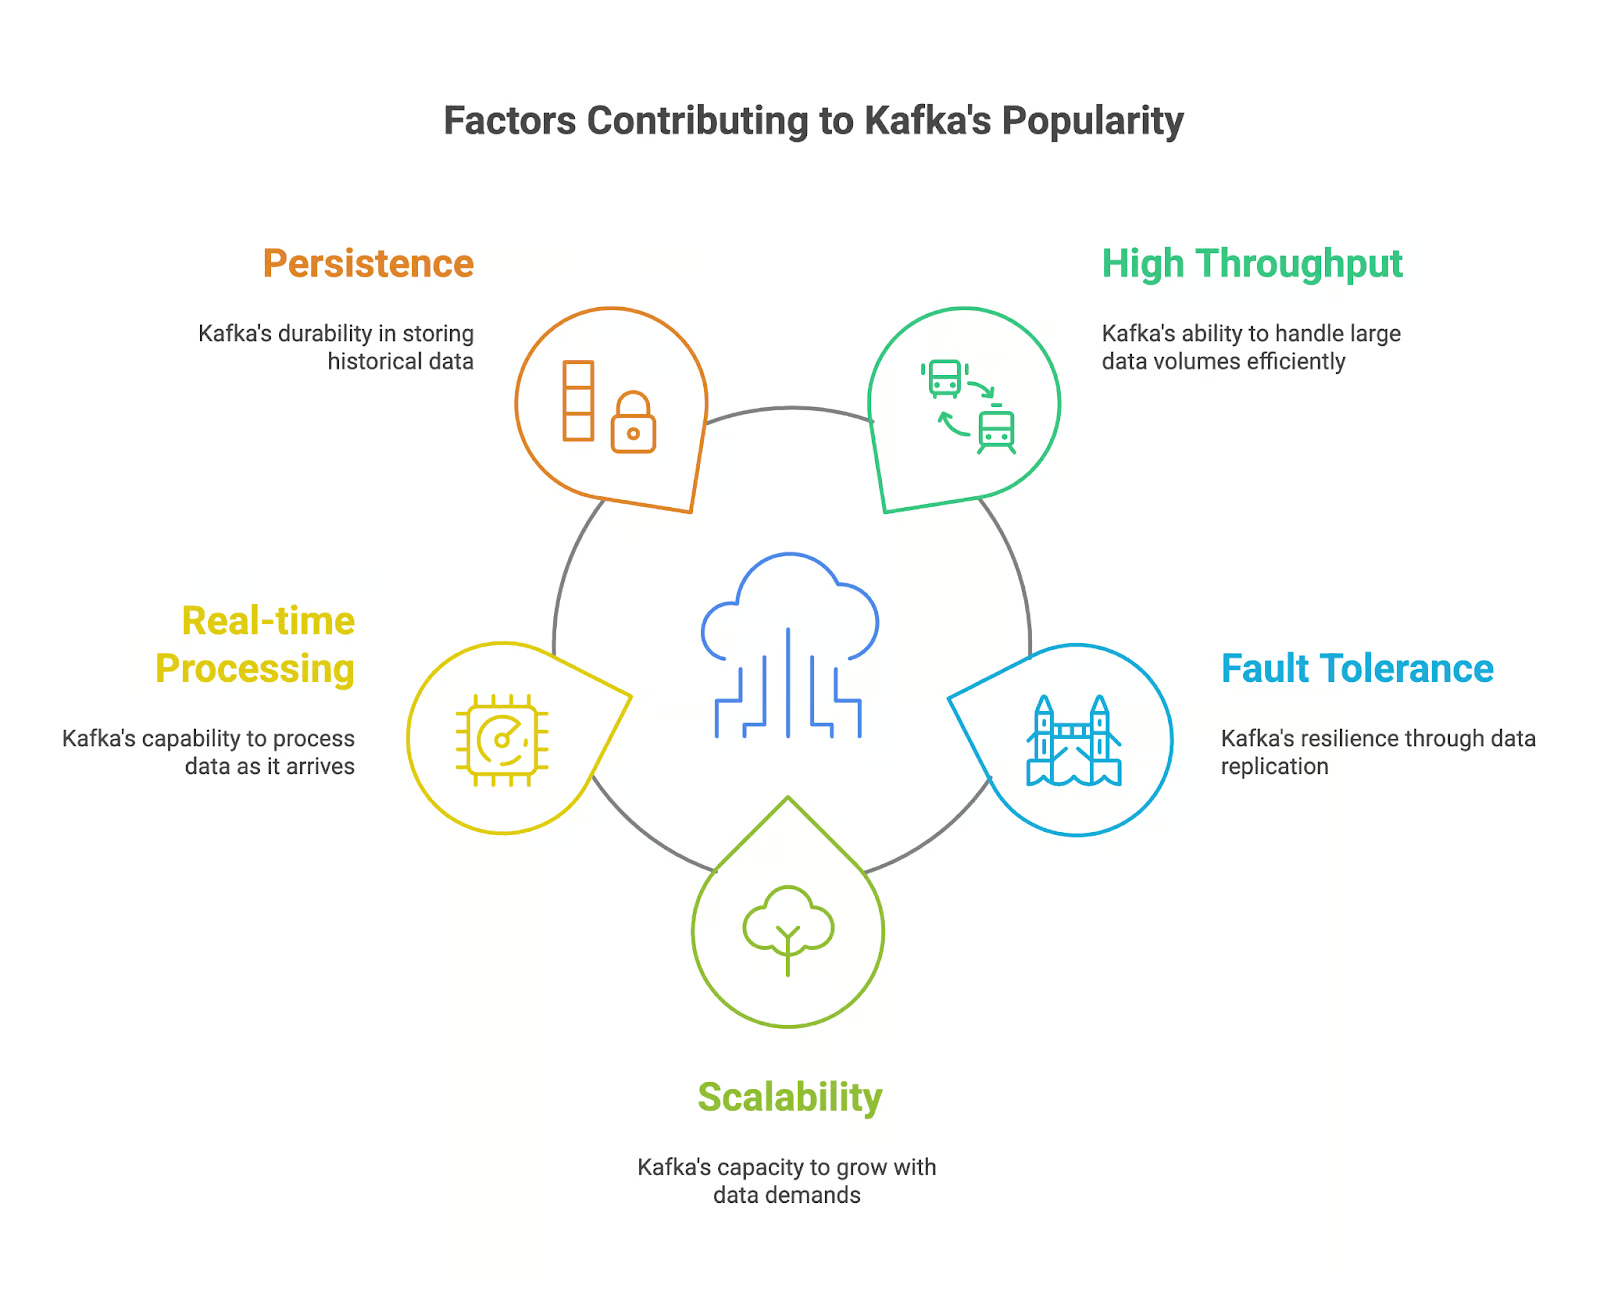
Apache Kafka saat ini digunakan pada aplikasi yang memerlukan pemrosesan dan analisis data secara real time. Namun fitur apa yang membuatnya menjadi alat andal untuk menangani data streaming? Mari kita lihat:
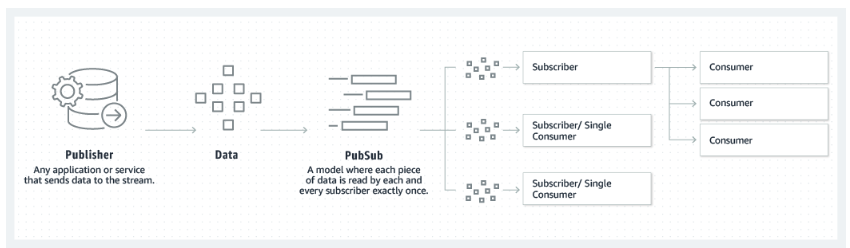
Model publisher-subscriber yang menjadi dasar Kafka. Sumber: Amazon
Mempelajari Apache Kafka membuat Anda menjadi kandidat berharga bagi pemberi kerja dan perusahaan yang menghasilkan serta memproses data dengan laju tinggi. Apache Kafka, dengan fitur andal dan penggunaannya yang luas, telah menjadi alat kunci untuk membangun arsitektur data modern dan aplikasi.
Saya telah menyebutkan bahwa Kafka menjadi sangat populer dalam beberapa tahun terakhir. Diperkirakan Apache Kafka saat ini digunakan oleh lebih dari 80% perusahaan Fortune 100.
Meningkatnya penggunaan Kafka di berbagai industri, beserta perannya dalam memungkinkan solusi data real time, membuat keterampilan Kafka sangat bernilai di pasar kerja. Menurut PayScale dan ZipRecruiter, per November 2024, gaji rata-rata insinyur dengan keterampilan Kafka di Amerika Serikat adalah $100.000 per tahun.
Kita sudah menyebutkan kekuatan Apache Kafka, tetapi mari lihat beberapa contoh spesifik di mana Anda dapat menggunakannya:
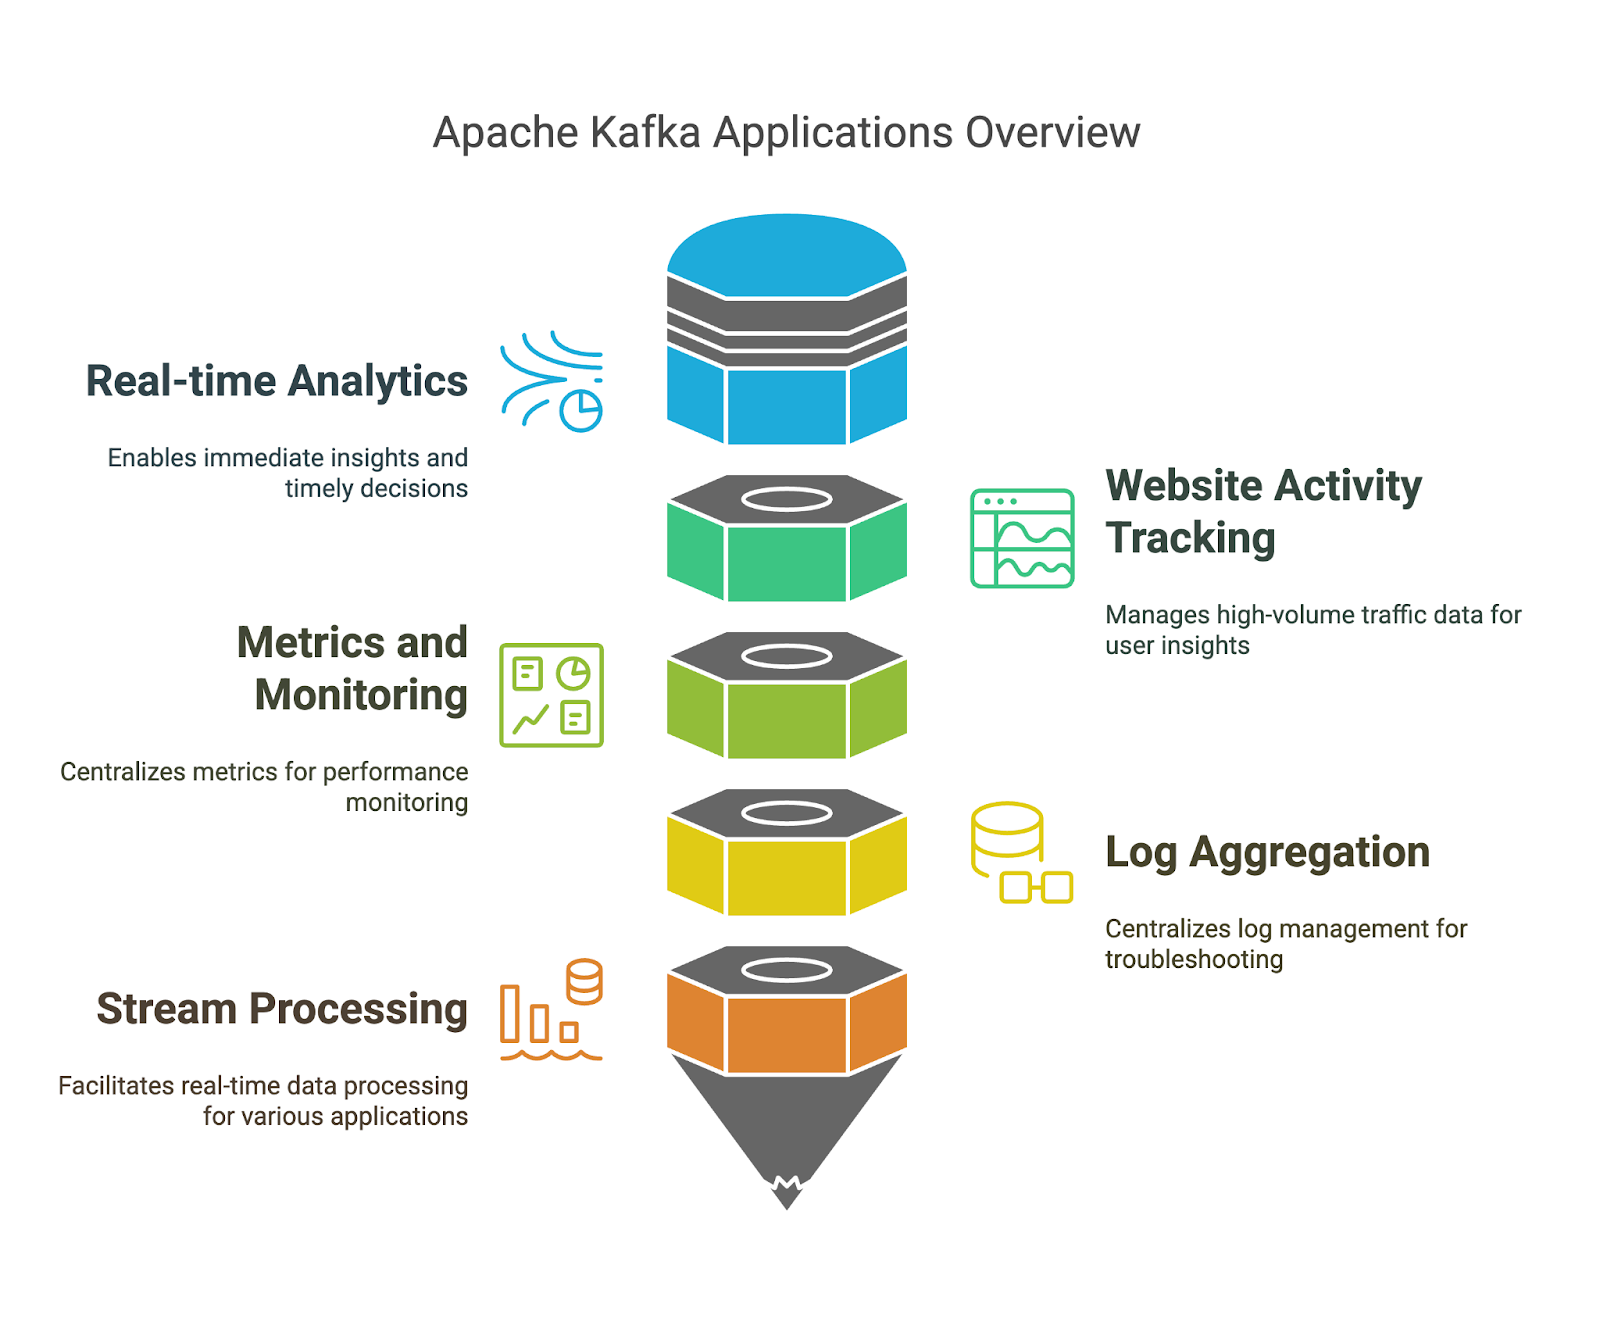
Jika Anda mempelajari Apache Kafka secara metodis, peluang keberhasilan Anda lebih besar. Mari fokus pada beberapa prinsip yang dapat Anda gunakan dalam perjalanan belajar.
Sebelum mempelajari detail teknis, tetapkan motivasi Anda mempelajari Apache Kafka. Tanyakan pada diri sendiri:
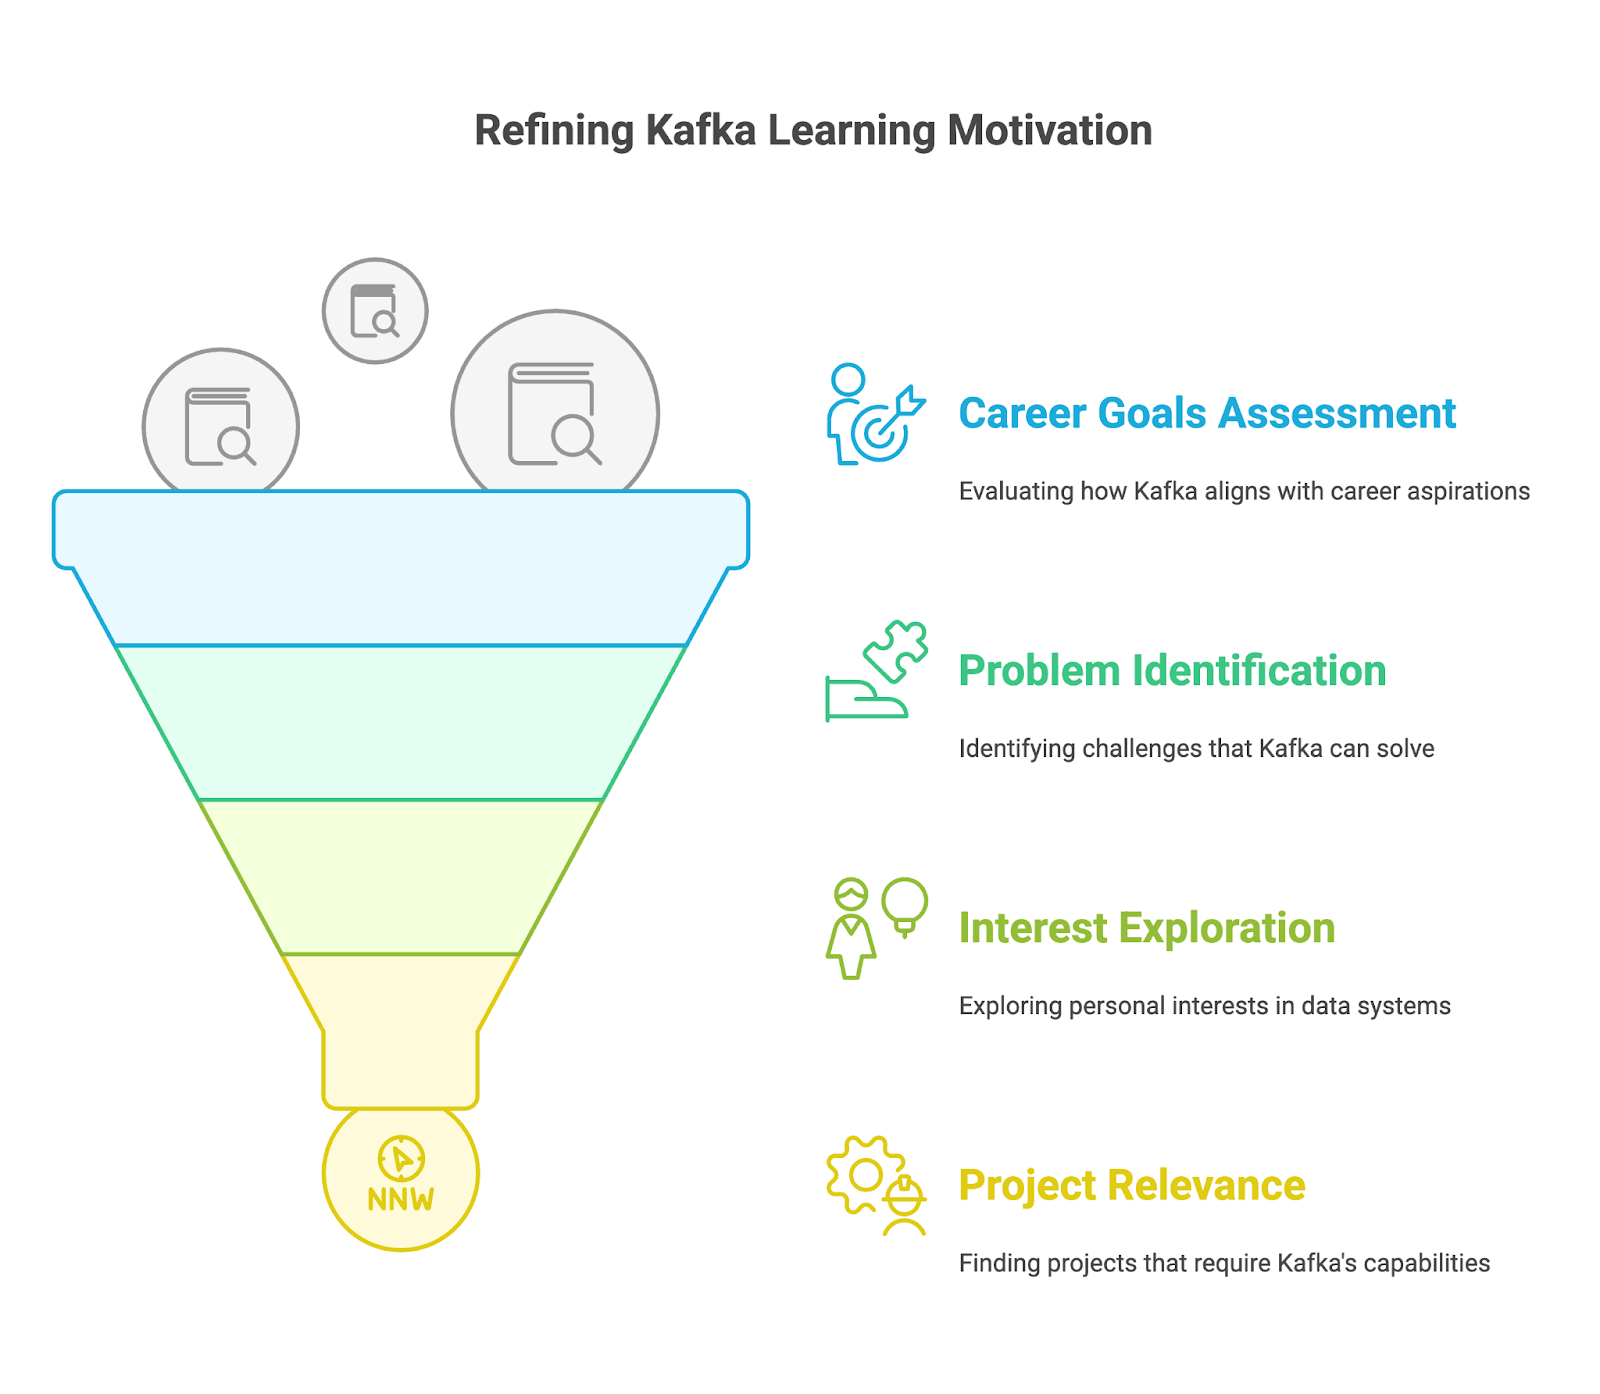
Setelah Anda mengidentifikasi tujuan, kuasai dasar-dasar Kafka dan pahami cara kerjanya.
Untuk belajar Apache Kafka, pertama kita perlu memasangnya di mesin lokal. Karena Kafka dikembangkan menggunakan Java, kita harus memastikan Java sudah terpasang. Lalu, kita perlu mengunduh binary Kafka dari situs resmi dan mengekstraknya.
Selanjutnya kita menjalankan ZooKeeper, diikuti server Kafka, menggunakan skrip yang disediakan. Terakhir, kita dapat menggunakan alat baris perintah untuk membuat topik dan mencoba memproduksi serta mengonsumsi beberapa pesan untuk memahami dasar-dasarnya. Artikel DataCamp Apache Kafka untuk Pemula dapat membantu Anda cepat memahami.
Konsep pertama yang harus kita pelajari adalah model publisher-subscriber di Kafka. Ini adalah salah satu alasan utama mengapa Apache Kafka dapat menangani data streaming secara efisien. Pahami bagaimana produsen memublikasikan pesan dan konsumen berlangganan topik tersebut, menerima hanya pesan yang relevan dengan ketertarikan mereka.
Kursus Introduction to Apache Kafka dari DataCamp memberikan pengantar, dengan latihan interaktif dan contoh praktis.
Saat menjelaskan model publisher-subscriber, kita telah menyebutkan beberapa komponen kunci Kafka: Producer dan Consumer. Namun, kita harus menelusuri semua komponen inti. Kita perlu mempelajari bagaimana Kafka mengorganisasi data ke dalam topik dan partisi, serta memahami bagaimana partisi berkontribusi pada skalabilitas dan toleransi kesalahan.
Kita juga perlu memahami bagaimana broker membentuk kluster untuk menyediakan ketersediaan tinggi dan toleransi kesalahan.
Lihat kursus Introduction to Apache Kafka dari DataCamp serta artikel Apache Kafka untuk Pemula untuk mendapatkan gambaran jelas tentang topik-topik ini.
Setelah Anda nyaman dengan dasar-dasarnya, saatnya mengeksplorasi keterampilan Apache Kafka tingkat menengah.
Salah satu fitur kunci Apache Kafka adalah kemampuannya menangani volume besar data streaming. Kafka Connect adalah komponen open-source, gratis dari Apache Kafka yang menyederhanakan integrasi data antara sistem berkas, basis data, indeks pencarian, dan key-value store.
Mempelajari cara menggunakan Connect dapat membantu kita membuka aliran data yang efisien untuk analitik, integrasi aplikasi, dan membangun arsitektur data yang tangguh serta skalabel. Lihat artikel Apache Kafka untuk Pemula kami untuk detail lebih lanjut.
Fitur lanjutan lain dari Kafka adalah Streams. Kita harus mempelajari cara membangun aplikasi pemrosesan stream langsung di dalam Kafka dengan bantuan Streams. Ini menawarkan API dan Domain-Specific Language tingkat tinggi untuk menangani, mengonversi, dan mengevaluasi aliran data berkelanjutan. Pelajari detail lebih lanjut di artikel Apache Kafka untuk Pemula.
Seperti teknologi lain, selalu baik untuk melacak performanya. Untuk itu, kita perlu mempelajari cara memantau kesehatan dan performa kluster Kafka kita. Kita dapat mengeksplorasi alat dan teknik untuk memantau metrik kunci, mengelola topik dan partisi, serta memastikan performa optimal.
Mengikuti kursus tentang Apache Kafka adalah cara yang sangat baik untuk mengenal teknologinya. Namun, untuk mahir dalam Kafka, Anda perlu menyelesaikan masalah yang menantang dan membangun keterampilan, seperti yang akan Anda hadapi pada proyek nyata.
Anda dapat mulai dengan bereksperimen pada tugas data streaming sederhana, seperti memproduksi dan mengonsumsi pesan, lalu secara bertahap meningkatkan kompleksitas dengan mengeksplorasi topik seperti partisi, toleransi kesalahan, dan integrasi dengan sistem eksternal menggunakan Kafka Connect.
Berikut beberapa cara untuk mempraktikkan keterampilan Anda:
Anda akan menyelesaikan berbagai proyek seiring kemajuan dalam perjalanan belajar Apache Kafka. Untuk menampilkan keterampilan dan pengalaman Apache Kafka kepada calon pemberi kerja, Anda harus menyusunnya menjadi portofolio. Portofolio ini harus mencerminkan keterampilan dan minat Anda serta disesuaikan dengan karier atau industri yang Anda minati.
Usahakan proyek Anda orisinal dan menunjukkan kemampuan pemecahan masalah. Sertakan proyek yang menunjukkan kemahiran Anda dalam berbagai aspek Kafka, seperti membangun pipeline data dengan Kafka Connect, mengembangkan aplikasi streaming dengan Kafka Streams, atau bekerja dengan kluster Kafka. Dokumentasikan proyek Anda secara menyeluruh, memberikan konteks, metodologi, kode, dan hasil. Anda dapat menggunakan platform seperti GitHub untuk meng-host kode dan Confluent Cloud untuk lingkungan Kafka terkelola.
Belajar Kafka adalah perjalanan berkelanjutan. Teknologi terus berkembang, dan fitur serta aplikasi baru dikembangkan secara rutin. Kafka bukan pengecualian.
Setelah Anda menguasai dasar-dasarnya, Anda dapat mencari tugas dan proyek yang lebih menantang seperti penyetelan performa untuk sistem ber-throughput tinggi, dan menerapkan pemrosesan stream tingkat lanjut dengan Kafka Streams. Fokus pada tujuan Anda dan spesialisasi pada area yang relevan dengan tujuan karier dan minat Anda.
Ikuti perkembangan terbaru, seperti fitur baru atau proposal KIP, dan pelajari cara menerapkannya pada proyek Anda. Terus berlatih, cari tantangan dan peluang baru, serta terimalah gagasan untuk membuat kesalahan sebagai cara belajar.
Meski setiap orang memiliki cara belajar masing-masing, selalu merupakan ide bagus untuk memiliki rencana atau panduan saat mempelajari alat baru. Saya telah membuat rencana belajar potensial yang menguraikan area fokus waktu dan upaya Anda jika Anda baru memulai dengan Apache Kafka.
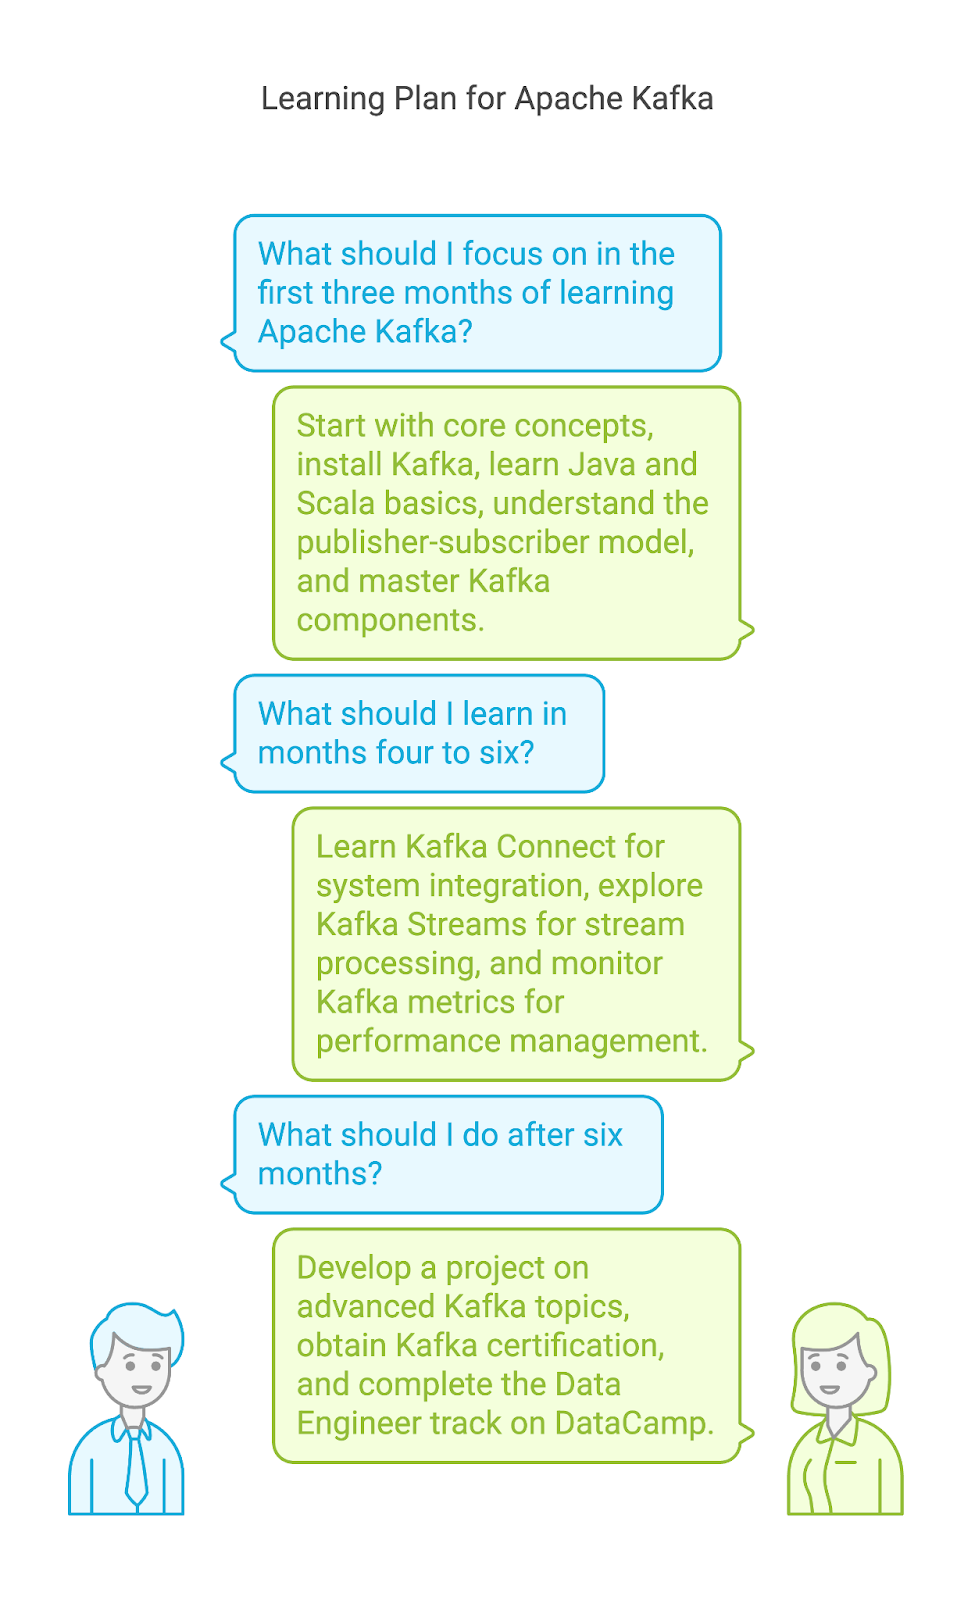
Saya membayangkan saat ini Anda siap untuk mulai belajar Kafka dan mencoba dataset besar untuk mempraktikkan keterampilan baru Anda. Namun sebelum itu, izinkan saya menyoroti kiat-kiat ini yang akan membantu Anda menavigasi jalan menuju kemahiran Apache Kafka.
Kafka adalah alat serbaguna yang dapat digunakan dengan banyak cara. Anda harus mengidentifikasi tujuan dan minat spesifik dalam ekosistem Kafka. Aspek Kafka apa yang paling menarik bagi Anda? Apakah Anda tertarik pada rekayasa data, pemrosesan stream, atau administrasi Kafka? Pendekatan terfokus dapat membantu Anda memperoleh aspek dan pengetahuan paling relevan dari Apache Kafka untuk memenuhi minat Anda.
Konsistensi adalah kunci untuk menguasai keterampilan baru. Anda harus menyediakan waktu khusus untuk berlatih Kafka. Sedikit waktu setiap hari sudah cukup. Anda tidak perlu menangani konsep kompleks setiap hari. Anda dapat melakukan latihan praktis, mengikuti tutorial, dan bereksperimen dengan berbagai fitur Kafka. Semakin sering berlatih, semakin nyaman Anda dengan platform ini.
Ini adalah salah satu kiat utama, dan Anda akan membacanya beberapa kali dalam panduan ini. Mengerjakan latihan sangat baik untuk membangun kepercayaan diri. Namun, menerapkan keterampilan Kafka Anda pada proyek nyata adalah yang akan membuat Anda unggul.
Mulailah dari proyek dan pertanyaan sederhana dan secara bertahap ambil yang lebih kompleks. Ini bisa berupa menyiapkan aplikasi producer-consumer sederhana, lalu meningkat ke membangun pipeline data real time dengan Kafka Connect, atau bahkan merancang aplikasi streaming yang toleran kesalahan dengan Kafka Streams. Kuncinya adalah terus menantang diri sendiri dan memperluas keterampilan Kafka praktis Anda.
Belajar sering kali lebih efektif saat dilakukan secara kolaboratif. Berbagi pengalaman dan belajar dari orang lain dapat mempercepat kemajuan Anda dan memberikan wawasan berharga.
Untuk bertukar pengetahuan, ide, dan pertanyaan, Anda dapat bergabung dengan beberapa grup terkait Apache Kafka, serta menghadiri meet-up dan konferensi. Anda dapat bergabung dengan komunitas online seperti saluran Slack Confluent atau Forum Confluent untuk berinteraksi dengan para penggemar Kafka lainnya. Anda juga dapat bergabung dengan meet-up virtual atau tatap muka yang menampilkan sesi dari pakar Kafka, atau konferensi seperti ApacheCon.
Seperti teknologi lainnya, belajar Apache Kafka adalah proses iteratif. Belajar dari kesalahan adalah bagian penting dari proses ini. Jangan takut bereksperimen, mencoba pendekatan berbeda, dan belajar dari kekeliruan Anda.
Cobalah berbagai konfigurasi untuk produsen dan konsumen Kafka Anda, jelajahi berbagai metode serialisasi data (JSON, Avro, Protobuf), dan bereksperimenlah dengan strategi partisi yang berbeda. Dorong kluster Kafka Anda hingga batasnya dengan volume pesan tinggi, dan amati bagaimana ia menangani beban. Analisis consumer lag, haluskan konfigurasi, dan pahami bagaimana optimasi Anda berdampak pada performa.
Luangkan waktu untuk benar-benar memahami konsep inti seperti topik, partisi, kelompok konsumen, dan peran ZooKeeper. Jika Anda membangun fondasi yang kuat sekarang, akan lebih mudah bagi Anda untuk memahami topik yang lebih maju dan memecahkan masalah secara efektif. Pecah proses belajar menjadi langkah-langkah kecil, dan beri diri Anda waktu untuk memahami informasi. Pendekatan perlahan dan stabil sering kali menghasilkan pemahaman yang lebih dalam dan kemahiran.
Mari bahas beberapa metode efisien untuk belajar Apache Kafka.
Kursus online menawarkan cara yang sangat baik untuk belajar Apache Kafka sesuai kecepatan Anda. DataCamp menawarkan kursus Kafka tingkat menengah. Kursus ini membahas konsep inti Kafka, termasuk model publisher-subscriber, topik dan partisi, broker dan kluster, produsen, dan konsumen.
Tutorial adalah cara hebat lain untuk belajar Apache Kafka, terutama jika Anda baru mengenal teknologi ini. Tutorial berisi panduan langkah demi langkah tentang cara melakukan tugas tertentu atau memahami konsep tertentu. Untuk memulai, pertimbangkan tutorial berikut:
Untuk memiliki pengetahuan lebih dalam tentang keunggulan Apache Kafka, Anda juga perlu memahami persamaan dan perbedaan kunci dengan teknologi lain. Anda dapat membaca artikel tentang bagaimana Kafka dibandingkan dengan alat lain seperti berikut ini:
Buku adalah sumber yang sangat baik untuk belajar Apache Kafka. Buku menawarkan pengetahuan mendalam dan wawasan dari para ahli beserta potongan kode dan penjelasan. Berikut beberapa buku paling populer tentang Kafka:
Seiring meningkatnya adopsi Apache Kafka, peluang karier bagi profesional dengan keterampilan Kafka pun bertambah, mulai dari insinyur Kafka khusus hingga software engineer. Jika Anda menilai kecocokan keterampilan Kafka Anda, pertimbangkan peran berikut:
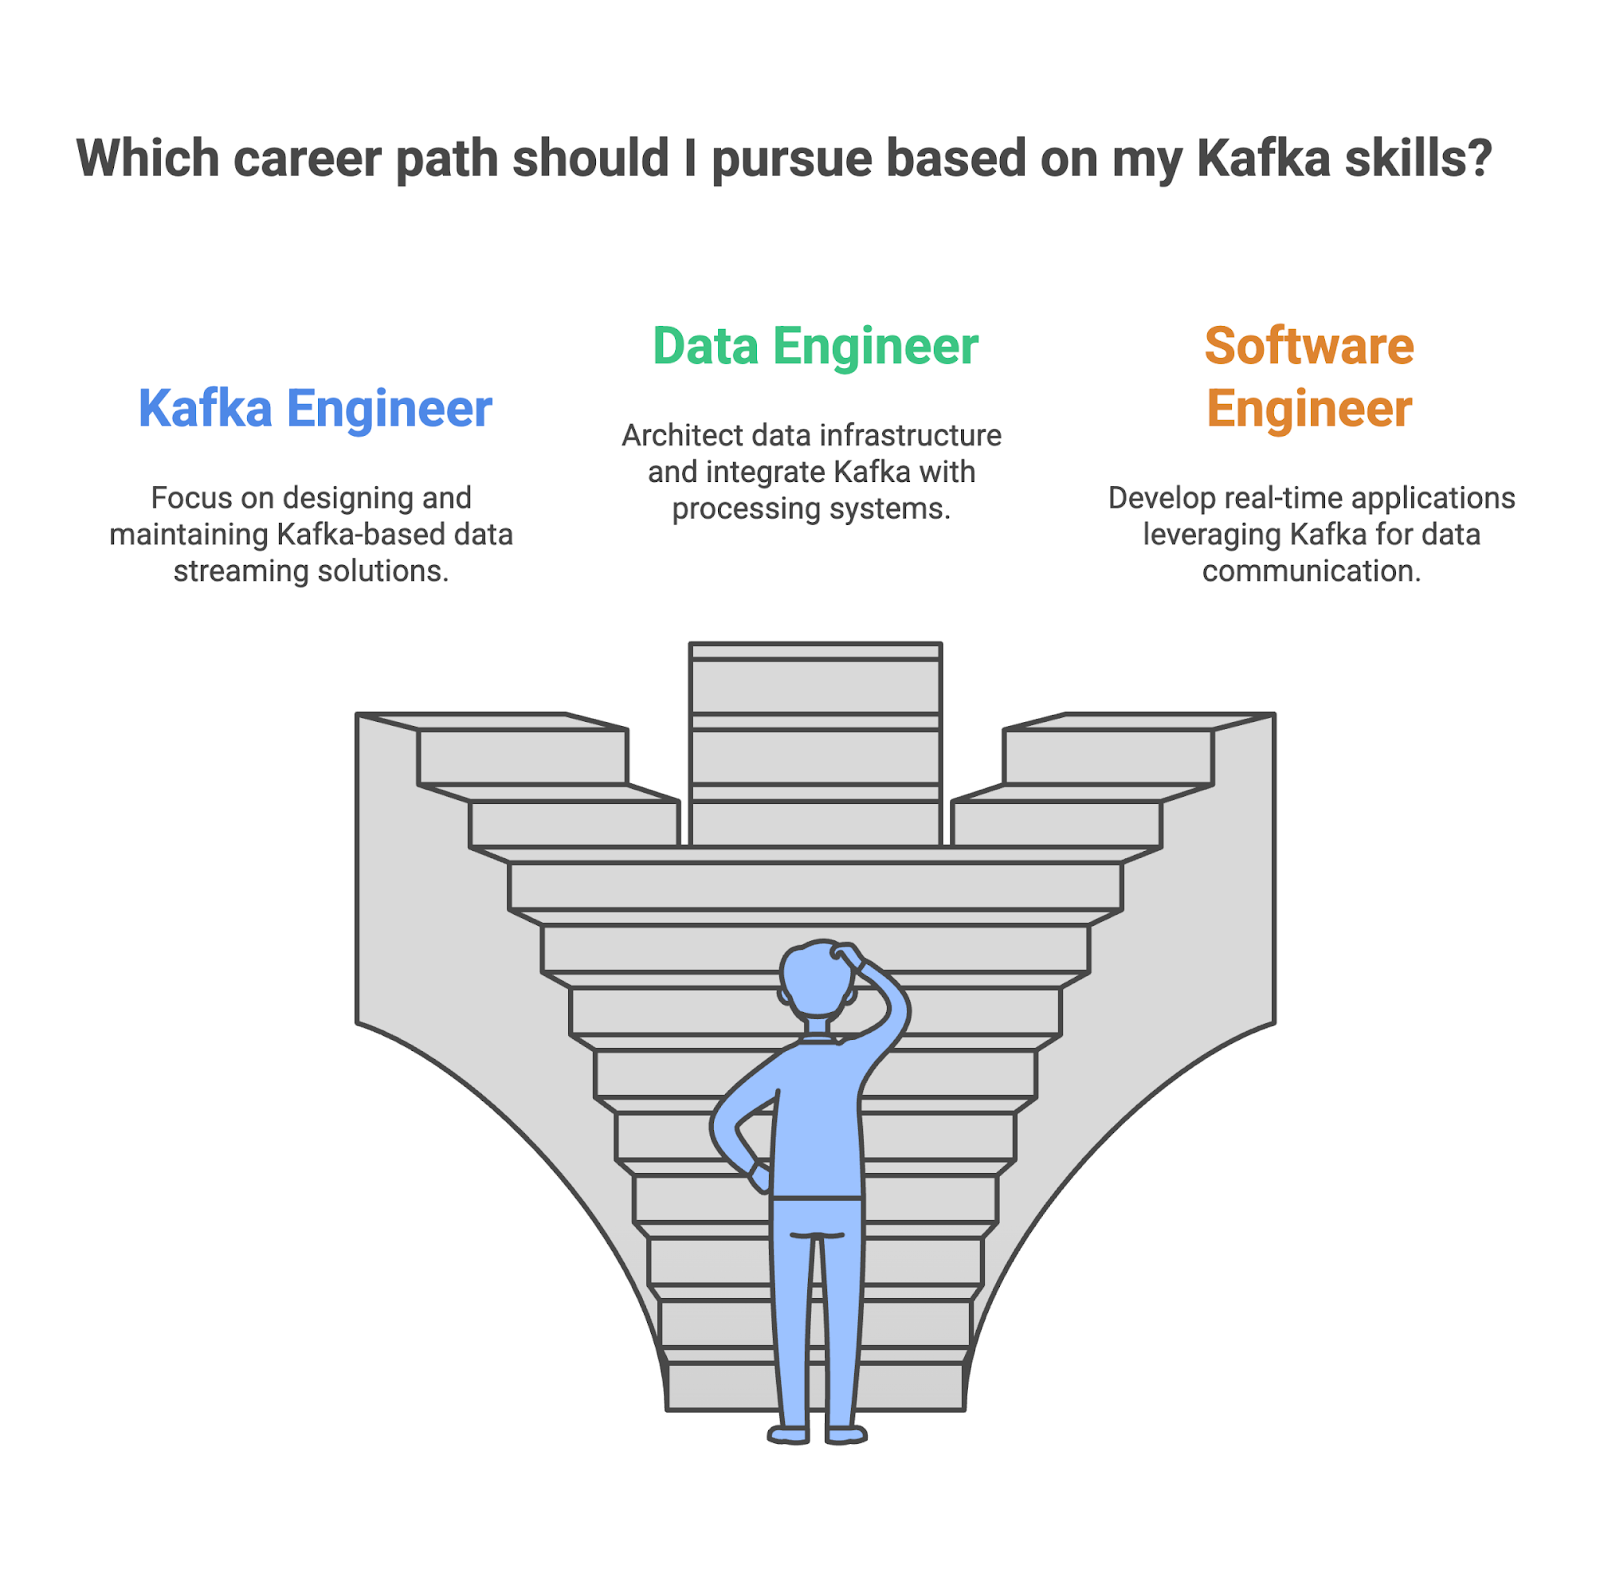
Sebagai Kafka engineer, Anda bertanggung jawab untuk merancang, membangun, dan memelihara solusi data streaming berbasis Kafka dengan ketersediaan dan skalabilitas tinggi. Anda perlu memastikan aliran data yang andal dan efisien di dalam perusahaan, serta memantau dan mengoptimalkan performa Kafka untuk memastikan throughput dan latensi optimal.
Sebagai data engineer, Anda adalah arsitek infrastruktur data, bertanggung jawab merancang dan membangun sistem yang menangani data perusahaan. Kafka sering berperan penting dalam pipeline data ini, memungkinkan data streaming real time yang efisien dan skalabel antar berbagai sistem. Anda perlu memastikan bahwa Kafka terintegrasi mulus dengan komponen lain.
Sebagai software engineer, Anda akan menggunakan Kafka untuk membangun aplikasi real time seperti platform chat dan gim daring. Anda perlu mengintegrasikannya ke dalam kode aplikasi untuk memastikan aliran data yang lancar dengan menghubungkan berbagai sistem messaging dan API. Anda juga akan mengoptimalkan aplikasi ini agar skalabel dan berperforma baik, sehingga mampu menangani sejumlah besar data real time.
|
Peran |
Apa yang Anda lakukan |
Keterampilan kunci Anda |
Alat yang Anda gunakan |
|
Kafka Engineer |
Merancang dan menerapkan kluster Kafka untuk ketersediaan dan skalabilitas tinggi. |
Arsitektur Kafka, komponen, administrasi dan konfigurasi, konsep pemrosesan stream. |
Apache Kafka, Kafka Connect, Kafka Streams, ZooKeeper |
|
Data Engineer |
Merancang dan menerapkan data warehouse dan data lake, mengintegrasikan Kafka dengan sistem pemrosesan dan penyimpanan data lainnya |
Kemahiran dalam alat pemrosesan data, pengalaman dengan platform cloud, dan pengetahuan tentang Kafka. |
Apache Kafka, Apache Spark, Hadoop, Hive, Platform cloud |
|
Software Engineer |
Merancang dan mengembangkan aplikasi yang memanfaatkan Kafka untuk komunikasi data real time. |
Keterampilan pemrograman, sistem dan aplikasi terdistribusi, pengetahuan publisher-subscriber Kafka. |
Apache Kafka, Java, Python, Scala, RabbitMQ, ActiveMQ, Alat dan framework pengembangan. |
Meskipun memiliki gelar dapat sangat berharga saat mengejar karier pada peran terkait data yang menggunakan Apache Kafka, itu bukan satu-satunya jalan untuk berhasil. Semakin banyak orang dari latar belakang beragam dan pengalaman berbeda mulai bekerja di peran terkait data. Dengan dedikasi, pembelajaran konsisten, dan pendekatan proaktif, Anda dapat meraih pekerjaan impian yang menggunakan Apache Kafka.
Tetap ikuti perkembangan terbaru di Kafka. Ikuti para profesional berpengaruh yang terlibat dengan Apache Kafka di media sosial, baca blog terkait Apache Kafka, dan dengarkan podcast terkait Kafka.
Berinteraksilah dengan tokoh berpengaruh, seperti Neha Narkhede, yang ikut menciptakan Kafka dan juga CTO Confluent. Anda akan mendapatkan wawasan tentang topik yang sedang tren, teknologi yang muncul, dan arah masa depan Apache Kafka. Anda juga dapat membaca blog Confluent, yang menawarkan artikel dan tutorial mendalam tentang berbagai topik Kafka, dari arsitektur dan administrasi hingga use case dan praktik terbaik.
Anda juga harus melihat acara industri, seperti webinar di Confluent atau Kafka Summit tahunan.
Anda perlu menonjol dari kandidat lain. Salah satu cara yang baik adalah membangun portofolio kuat yang menampilkan keterampilan dan proyek yang telah diselesaikan.
Portofolio Anda harus memuat proyek yang menunjukkan kemahiran Anda dalam membangun pipeline data, menerapkan aplikasi pemrosesan stream, dan mengintegrasikan Kafka dengan sistem lain.
Hiring manager harus meninjau ratusan resume dan membedakan kandidat hebat. Selain itu, sering kali resume Anda diproses oleh Applicant Tracking Systems (ATS), perangkat lunak otomatis yang digunakan banyak perusahaan untuk meninjau resume dan menyaring yang tidak memenuhi kriteria tertentu. Jadi, Anda harus membuat resume yang hebat dan menyusun surat lamaran yang mengesankan untuk memukau ATS dan perekrut Anda.
Diperhatikan oleh hiring manager
Jika Anda menarik perhatian hiring manager atau resume efektif Anda lolos proses seleksi, tahap selanjutnya Anda harus menyiapkan wawancara teknis. Untuk siap, Anda dapat melihat artikel ini tentang 20 Pertanyaan Wawancara Kafka untuk Data Engineer.
Mempelajari Apache Kafka dapat membuka pintu untuk peluang dan hasil karier yang lebih baik. Jalan untuk belajar Kafka itu bermanfaat namun memerlukan konsistensi dan praktik langsung. Bereksperimen dan memecahkan tantangan menggunakan alat ini dapat mempercepat proses belajar Anda dan memberi contoh nyata untuk menunjukkan keterampilan praktis saat Anda mencari pekerjaan.
Pelajari data engineering dengan kursus-kursus ini!
Kursus
Kursus
Program
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt




