
course
Claude मॉडलों का परिचय
3 घंटा
14.5K
Anthropic ने 30 जून, 2026 को Claude Sonnet 5 जारी किया, और संदेश सीधा है: यह अब तक का सबसे एजेंटिक Sonnet मॉडल है। यह योजनाएँ बना सकता है, ब्राउज़र्स और टर्मिनल जैसे टूल चला सकता है, और इतनी स्वायत्तता से काम कर सकता है जो हाल तक केवल बड़े Opus-क्लास मॉडलों की ताकत थी।
मुख्य दावा यह है कि Sonnet 5 तर्क, टूल उपयोग, कोडिंग, और नॉलेज वर्क में Opus 4.8 के क़रीब प्रदर्शन करता है, लेकिन कम कीमत पर। Anthropic द्वारा प्रकाशित एजेंटिक कोडिंग बेंचमार्क पर, Sonnet 5 ने 63.2% स्कोर किया, जबकि Opus 4.8 ने 69.2% और Sonnet 4.6 ने 58.1%। एक नॉलेज वर्क बेंचमार्क पर, Sonnet 5 वास्तव में Opus 4.8 से थोड़ा आगे निकलता है।
इस लेख में, मैं Claude Sonnet 5 की सभी नई चीज़ों को कवर करूँगा—नए फीचर्स, बेंचमार्क्स, और इसकी लागत। यदि आप Anthropic के बारे में और संदर्भ चाहते हैं, तो हमारा हालिया गाइड Claude Code स्लैश कमांड्स और हमारा Claude Tag पर लेख देखें।
Claude Sonnet 5, Anthropic का मिड-टियर मॉडल है जो Opus लाइन से नीचे बैठता है और ऐसे एजेंटिक काम के लिए बनाया गया है जिन्हें पहले महंगे Opus मॉडलों की ज़रूरत होती थी। यह फरवरी 2026 में लॉन्च हुए Sonnet 4.6 को रिप्लेस करता है और एक अपडेटेड टोकनाइज़र का उपयोग करता है जो मॉडल के टेक्स्ट प्रोसेस करने के तरीके को बदलता है।
कई डेवलपर्स के लिए, एजेंटिक युग Sonnet-क्लास मॉडलों—जैसे Claude Sonnet 3.5, 3.6, और 3.7—से शुरू हुआ, जिन्होंने कोडिंग और टूल उपयोग में वास्तविक क्षमता दिखाई। हाल में, सबसे स्पष्ट एजेंटिक बढ़त Opus-क्लास मॉडलों में दिख रही थी, और Sonnet 5 Anthropic का प्रयास है कि मिड-टियर को फिर से फ्रंटियर के क़रीब लाया जाए।
स्रोत: Anthropic
सबसे महत्वपूर्ण संख्या है लागत-बनाम-प्रदर्शन का चित्र। Anthropic के अपने चार्ट दिखाते हैं कि BrowseComp एजेंटिक सर्च और OSWorld-Verified कंप्यूटर-उपयोग मूल्यांकन पर Sonnet 4.6, Opus 4.8 से काफ़ी पीछे था। अब Sonnet 5 और Opus 4.8 एक ही रेंज को कवर करते हैं—Sonnet 5 कम लागत देता है, जबकि Opus 4.8 अधिक कीमत पर उच्च सटीकता देता है।
Sonnet 5 में सुधार एक ही थीम के इर्द-गिर्द सिमटे हैं: एजेंटिक कार्यों को बिना बीच में रुके अंत तक पूरा करना। यहाँ इसकी प्रमुख क्षमताएँ हैं।
Sonnet 5 का सबसे व्यावहारिक बदलाव है टास्क फॉलो-थ्रू। Anthropic के अर्ली-एक्सेस टेस्टर्स ने रिपोर्ट किया कि मॉडल जटिल कार्यों को पूरा कर देता है जहाँ पहले के Sonnet संस्करण बीच में अटक जाते थे, और यह बिना कहे अपने आउटपुट की खुद जाँच भी करता है।
इसे अपने काम में सोचें: मॉडल को ऐसा काम दें जो दो सिस्टम्स में फैला हो—किसी CI रन से फेल हो रहे टेस्ट रिज़ल्ट निकालें, फिर एक फिक्स के साथ पुल रिक्वेस्ट खोलें। पहले के Sonnet मॉडल अक्सर पहले हिस्से के बाद रुक जाते थे। Anthropic का अपना उदाहरण Salesforce अकाउंट टियर अपडेट करने और एंटरप्राइज़ कॉन्टैक्ट्स को लॉन्च अनाउंसमेंट भेजने का था—वह भी एक ही पास में—एक वर्कफ़्लो जो, एक Zapier इंजीनियर के अनुसार, पहले बीच में अटक जाता था।
जो कोई भी एजेंट बना रहे हैं, उनके लिए यह फ़र्क है एक ऐसे मॉडल में जो योजना बनाता है और एक ऐसे में जो उसे अमल में भी लाता है। इससे वह बार-बार की मानवीय दख़ल घटती है जो एजेंट को आगे बढ़ाने के लिए करनी पड़ती थी।
Sonnet 5 समायोज्य प्रयास स्तर सपोर्ट करता है, ताकि आप कार्य और बजट के अनुसार तर्क की गहराई ऊपर-नीचे कर सकें। Anthropic इसे Sonnet 5 और Opus 4.8 के बीच सही बिंदु खोजने का तरीका मानता है, बजाय एक मॉडल चुनकर उसी पर टिके रहने के।
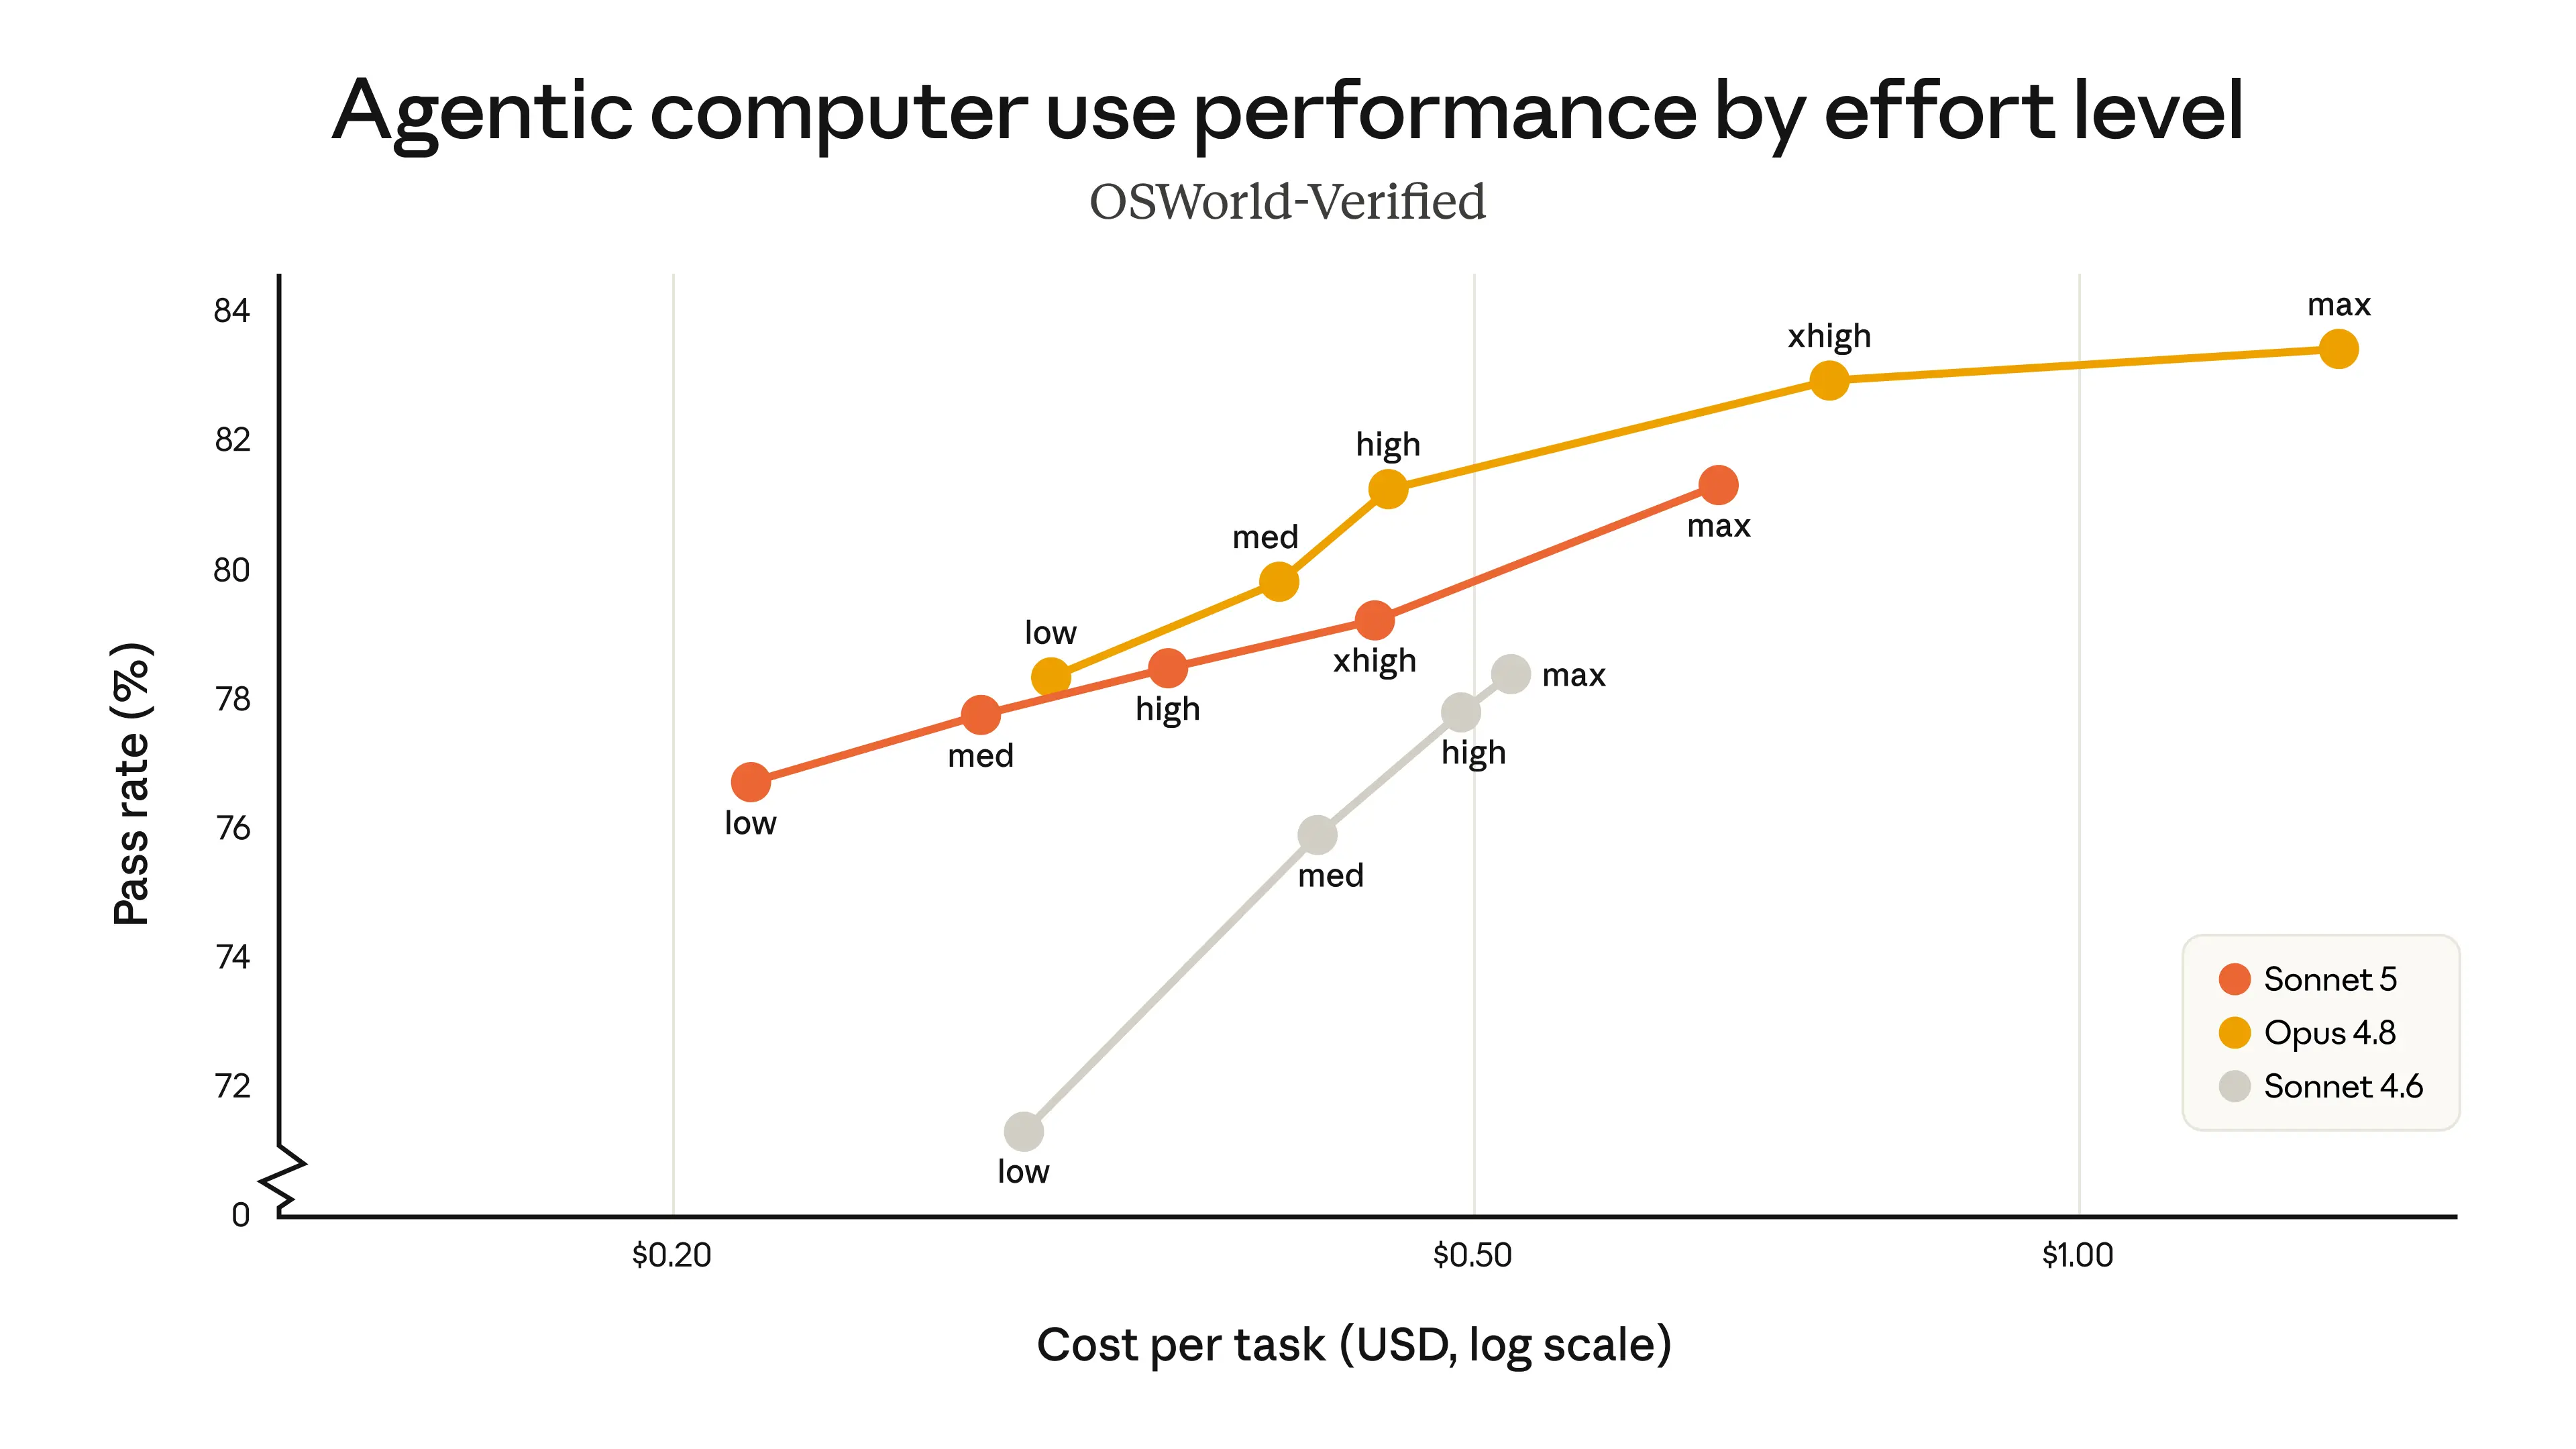
अपनी अधिकतम Extra High रीजनिंग लेवल पर, Sonnet 5, OSWorld-Verified और BrowseComp पर लगभग Opus 4.8 के मीडियम-टू-हाई सेटिंग के बराबर प्रदर्शन करता है। पेच यह है कि Sonnet 5 को उस स्तर पर चलाना, तुलनात्मक रीजनिंग सेटिंग पर Opus 4.8 से ज़्यादा महँगा पड़ सकता है, इसलिए कुछ उच्च-सटीकता कार्यों के लिए Opus 4.8 अभी भी बेहतर विकल्प रहता है।
यदि आप पहले से Claude Code इस्तेमाल करते हैं, तो प्रयास स्तर आपके लिए परिचित होंगे। हम अपने Claude Code स्लैश कमांड्स ट्यूटोरियल में /effort कमांड और उसके स्तर कवर करते हैं।
Sonnet 5, Sonnet 4.6 की तुलना में मापनीय सुरक्षा सुधारों के साथ आता है, जो तब मायने रखता है जब कोई एजेंट लाइव सिस्टम्स को स्पर्श कर रहा हो। Anthropic के प्री-डिप्लॉयमेंट मूल्यांकनों में पाया गया कि यह प्रॉम्प्ट इंजेक्शन हमलों में दुष्ट अनुरोधों को ठुकराने और हाइजैक प्रयासों का प्रतिरोध करने में बेहतर है।
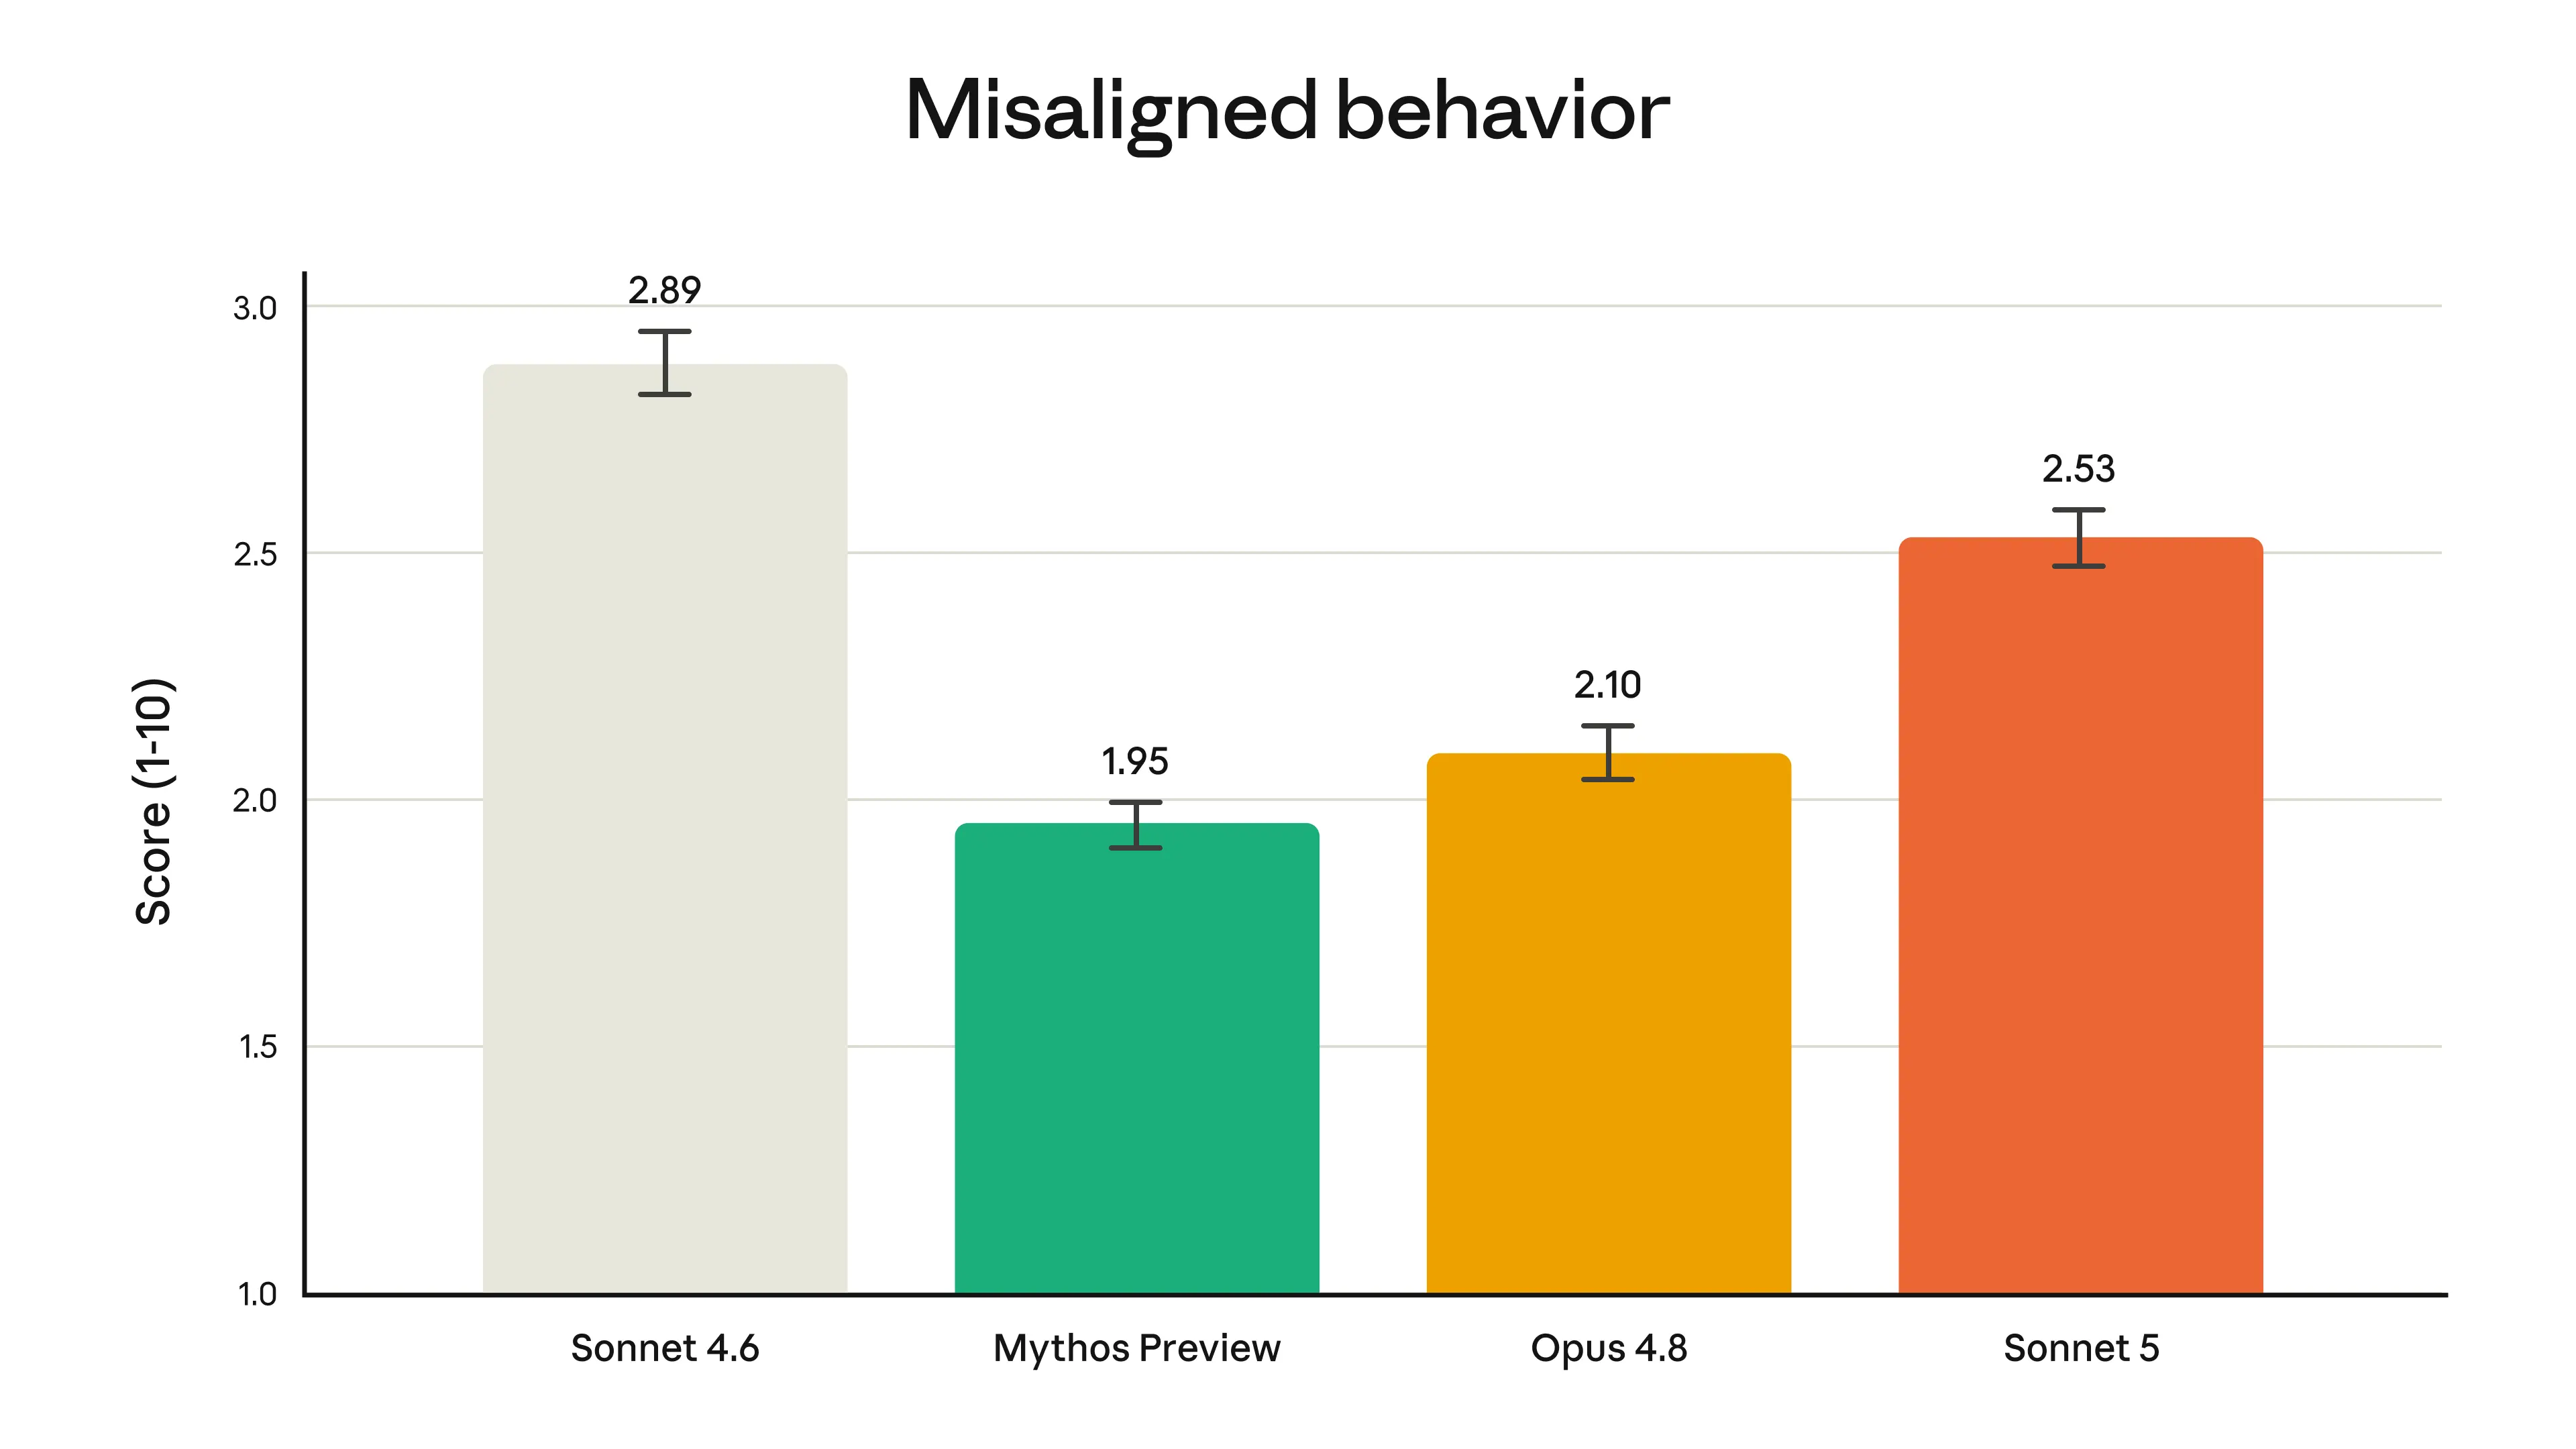
मॉडल में Sonnet 4.6 की तुलना में भ्रम (हैलुसिनेशन) और चापलूसी (साइकोफेंसी) की दरें भी कम दिखीं, और Anthropic के स्वचालित व्यवहार ऑडिट में—जिसमें दुरुपयोग में सहयोग और धोखाधड़ी जैसे मिसअलाइंड बिहेवियर्स शामिल हैं—यह कम (अधिक सुरक्षित) स्कोर पर आया। Lovable के सह-संस्थापक ने बात साफ़ कही: जो मॉडल यह जानता है कि कब “ना” कहना है, वह उतना ही महत्वपूर्ण है जितना वह जो बनाना जानता है।
ध्यान देने वाली बात यह है कि Sonnet 5 में अभी भी Opus 4.8 और Claude Mythos प्रिव्यू जैसे अधिक सक्षम मॉडलों की तुलना में मिसअलाइंड व्यवहार की दरें अधिक हैं, इसलिए यह अपने पूर्ववर्ती से सुरक्षित तो है, पर Anthropic की लाइनअप में सबसे सुरक्षित नहीं।
स्रोत: Anthropic
Sonnet 5 रियल-टाइम साइबर सेफगार्ड्स के साथ लॉन्च होता है, वही जो Claude Opus 4.7 और 4.8 में मौजूद हैं। ये खतरनाक साइबर उपयोग का होते ही पता लगाते और ब्लॉक करते हैं।
Anthropic के मूल्यांकनों पर, Sonnet 5 की डेंजरस-साइबर क्षमताएँ Opus 4.8 और Mythos 5 की तुलना में काफ़ी कमज़ोर हैं। Mozilla के साथ बनाए गए एक टेस्ट में, जिसका उद्देश्य Firefox 147 की कमजोरियों के लिए एक्स्प्लॉइट विकसित करना था, न Sonnet 5 और न ही Sonnet 4.6 कोई काम करता एक्स्प्लॉइट बना पाए (दोनों का स्कोर 0.0%), हालाँकि Sonnet 5 ने आंशिक-सफलता दर थोड़ी अधिक दिखाई, जिसे Anthropic साइबर ट्रेनिंग की बजाय सामान्य बुद्धिमत्ता में वृद्धि से जोड़ता है।
जिन सुरक्षा शोधकर्ताओं को कम गार्डरेल्स चाहिए, उनके लिए Anthropic Opus 4.8 की सिफ़ारिश करता है। Sonnet 5 के सेफगार्ड्स Fable 5 के साथ शिप हुए से कम सख्त हैं, जो साइबरसिक्योरिटी कार्यों की व्यापक रेंज को ब्लॉक करते थे।
Sonnet 5 के लिए Anthropic की बेंचमार्क कहानी सुसंगत है: यह Sonnet 4.6 पर सख्त सुधार है और अब तक प्रकाशित आकलनों में Opus 4.8 से थोड़ा नीचे बैठता है। नीचे के आँकड़े Anthropic की लॉन्च सामग्री से हैं। एक सावधानी: थर्ड-पार्टी समीक्षकों ने उन्हीं बेंचमार्क्स के लिए अलग आंकड़े रिपोर्ट किए हैं, संभवतः अलग डेटासेट, कॉन्टेक्स्ट सेटिंग्स, या एजेंट स्कैफ़ोल्ड्स के कारण, इसलिए हेडलाइन नंबरों को कॉन्फ़िगरेशन-निर्भर मानें।
| Sonnet 5 | Sonnet 4.6 | Opus 4.8 संदर्भ हेतु |
|
|---|---|---|---|
| एजेंटिक कोडिंग SWE-bench Pro |
63.2% | 58.1% | 69.2% |
| एजेंटिक कोडिंग Terminal-Bench 2.1 |
80.4% | 67.0% | 82.7% |
| बहुविषयी तर्क Humanity's Last Exam |
43.2% बिना टूल्स 57.4% टूल्स के साथ |
34.6% बिना टूल्स 46.8% टूल्स के साथ |
49.8% बिना टूल्स 57.9% टूल्स के साथ |
| कंप्यूटर उपयोग OSWorld-Verified |
81.2% | 78.5% | 83.4% |
| नॉलेज वर्क GDPval-AA v2 |
1618 | 1395 | 1615 |
Anthropic द्वारा प्रकाशित एजेंटिक कोडिंग बेंचमार्क पर Sonnet 5 का स्कोर 63.2% है, जबकि Opus 4.8 का 69.2% और Sonnet 4.6 का 58.1%। यह बेंचमार्क मापता है कि कोई मॉडल एक ही स्निपेट देने के बजाय कई चरणों में कोड लिख, चला, और ठीक कर सकता है या नहीं।
Opus 4.8 से अंतर लगभग 6 अंक है, जबकि Sonnet 4.6 पर बढ़त लगभग 5 अंकों की है। डेवलपर्स के लिए, इसका मतलब है कि Sonnet 5 पिछली मिड-टियर पीढ़ी पर साफ़ अपग्रेड है, भले ही यह फ़्लैगशिप स्तर तक न पहुँचे।
स्रोत: Anthropic
OSWorld-Verified कंप्यूटर उपयोग क्षमता को मापता है—एक डेस्कटॉप को नियंत्रित कर वास्तविक कार्य पूरे करना—और BrowseComp एजेंटिक वेब सर्च को। Anthropic ने OSWorld-Verified की कार्यप्रणाली अपडेट की और अब संशोधित सेटअप पर Sonnet 4.6 के 78.5% रिपोर्ट करता है।
दोनों मूल्यांकनों में, हर प्रयास स्तर पर Sonnet 5, Sonnet 4.6 पर सख्त सुधार है, जबकि Opus 4.8 अभी भी उच्च-सटीकता विकल्प बना रहता है। Extra High प्रयास पर, Sonnet 5 लगभग Opus 4.8 के मीडियम-टू-हाई प्रदर्शन तक पहुँचता है, लेकिन उस बिंदु पर लागत लाभ घटता है—इसीलिए Anthropic इन दोनों मॉडलों को एक ही लागत-सटीकता रेंज के रूप में प्रस्तुत करता है, न कि सीधा अपग्रेड।
TechCrunch की रिपोर्टिंग के अनुसार, एक नॉलेज वर्क बेंचमार्क पर Sonnet 5, Opus 4.8 से थोड़ा बेहतर प्रदर्शन करता है। यह उल्लेखनीय है क्योंकि Opus 4.8 अक्सर सबसे कठिन जजमेंट कॉल और गहरी रिसर्च से जुड़ा मॉडल माना जाता है।
Anthropic ने Humanity's Last Exam के लिए अपने ग्रेडर को भी अपडेट किया है और अब Sonnet 4.6 को 34.6% (बिना टूल्स) और 46.8% (टूल्स के साथ) रिपोर्ट करता है—यही कारण है कि ये आंकड़े मूल Sonnet 4.6 लॉन्च से अलग हैं। व्यवहार में, नॉलेज-वर्क का नतीजा संकेत देता है कि विश्लेषण और रिसर्च जैसे कार्यों के लिए Sonnet 5, जिनके लिए पहले Opus की ज़रूरत महसूस होती थी, अब कारगर है।
Sonnet टियर कहाँ बैठता है, इस पर व्यापक संदर्भ के लिए हमारा Sakana Fugu बनाम Claude Fable 5 कवरेज उपयोगी है। उस तुलना में, उच्च-टियर Claude Fable 5 ने SWE-Bench Pro पर 80.3% और Humanity's Last Exam (बिना टूल्स) पर 59.0% स्कोर किया—जो यहाँ के मिड-टियर आंकड़ों से काफी ऊपर है।
यही फैलाव उद्देश्य है। Anthropic की लाइनअप एजेंटिक, कम-लागत Sonnet 5 से लेकर Opus 4.8 और Mythos व Fable क्लासेस तक जाती है, जहाँ हर टियर सबसे कठिन समस्याओं पर सटीकता के लिए लागत का लेन-देन करता है।
Claude Sonnet 5 लॉन्च डे से हर जगह उपलब्ध है। यह Free और Pro प्लान्स के लिए डिफ़ॉल्ट मॉडल है, और Max, Team, तथा Enterprise उपयोगकर्ताओं के लिए भी, साथ ही Claude Code और Claude Platform पर उपलब्ध है।
डेवलपर्स इसे Claude API के माध्यम से मॉडल ID claude-sonnet-5 का उपयोग कर कॉल कर सकते हैं। प्राइसिंग दो चरणों में काम करती है:
बजट के लिए एक विवरण: Sonnet 5 एक अपडेटेड टोकनाइज़र का उपयोग करता है, इसलिए वही इनपुट पहले से अधिक टोकनों में मैप हो सकता है—सामग्री के प्रकार पर निर्भर करते हुए लगभग 1.0 से 1.35 गुना तक। Anthropic ने प्रारंभिक प्राइसिंग इस तरह सेट की है कि Sonnet 4.6 से ट्रांज़िशन लगभग लागत-न्यूट्रल रहे। कंपनी ने Chat, Cowork, Claude Code, और Claude Platform में रेट लिमिट्स भी बढ़ा दी हैं ताकि उच्च प्रयास स्तरों से आने वाली भारी टोकन उपयोग को संभाला जा सके।
तेज़ तुलना चाहने वाले पाठकों के लिए, Anthropic द्वारा प्रकाशित आंकड़ों पर तीनों मॉडलों की यह लाइनअप देखें।
| मॉडल | एजेंटिक कोडिंग | OSWorld-Verified | इनपुट / आउटपुट कीमत (प्रति 1M टोकन) |
|---|---|---|---|
| Sonnet 5 | 63.2% | हर प्रयास स्तर पर 4.6 से बेहतर | $2 / $10 (इंट्रो), फिर $3 / $15 |
| Sonnet 4.6 | 58.1% | 78.5% (संशोधित) | $3 / $15 |
| Opus 4.8 | 69.2% | उच्च-सटीकता विकल्प | $5 / $25 |
Sonnet 5 Anthropic का अब तक का सबसे स्पष्ट संकेत है कि एजेंटिक क्षमता अब हर प्राइस टियर पर बेसलाइन अपेक्षा है—सिर्फ़ फ़्लैगशिप की विशेषता नहीं। फ़र्क अब यह नहीं कि एजेंटिक काम कौन सबसे अच्छा करता है, बल्कि यह कि कौन इसे सस्ते और भरोसेमंद तरीके से बिना मानवीय निगरानी के कर सकता है।
मेरे लिए सबसे दिलचस्प चीज़ प्रारंभिक प्राइसिंग है। Anthropic लगता है कि ग्राहकों को माइग्रेशन विंडो के दौरान सबसे कम संभव लागत पर वास्तविक वर्कलोड्स के खिलाफ Sonnet 5 को टेस्ट करना चाहिए—यह एक सोची-समझी पहल लगती है ताकि लोग रूटीन एजेंटिक वर्क के लिए Opus 4.8 से हटें और उसकी क्षमता खाली हो। यह OpenAI के GPT-5.5 और Google के Gemini 3.1 Pro की तुलना में कीमत पर भी कम बैठता है, हालाँकि Gemini 3.5 Flash अभी भी सस्ता है।
यदि आप ऐसे एजेंट बना रहे हैं जो लगातार, मल्टी-स्टेप कार्य चलाते हैं, तो Sonnet 5 अब नया डिफ़ॉल्ट लगता है—और केवल तब Opus 4.8 पर जाएँ जब किसी कार्य को सचमुच अतिरिक्त सटीकता की ज़रूरत हो। ईमानदार चेतावनी यह है कि कुछ थर्ड-पार्टी समीक्षक कहते हैं Sonnet 5, कोडिंग स्पीड के लिए रीजनिंग डेप्थ का ट्रेड-ऑफ़ करता है, इसलिए PhD-स्तरीय विज्ञान या ब्राउज़िंग-हेवी काम के लिए Opus 4.8 अभी भी अधिक सुरक्षित विकल्प हो सकता है।
यदि आप उस तरह के ऑटोमेशन के साथ हाथ आज़माना चाहते हैं जिसके लिए Sonnet 5 बना है, तो मैं हमारा Claude Code Routines ट्यूटोरियल सुझाऊँगा, जो क्लाउड में शेड्यूल पर एक कोडिंग एजेंट चलाना सिखाता है।
शीर्ष DataCamp पाठ्यक्रम
course
course
course