
Last chance! 50% off DataCamp Premium
Sale ends in
Anthropic, 30 Haziran 2026’da Claude Sonnet 5’i yayınladı ve mesaj net: bu, şirketin şimdiye kadar sunduğu en ajan odaklı Sonnet modeli. Plan yapabiliyor, tarayıcılar ve terminaller gibi araçları kullanabiliyor ve kısa bir süre öncesine kadar yalnızca daha büyük Opus sınıfı modellerin erişebildiği düzeyde otonom çalışabiliyor.
Başlıca iddia, Sonnet 5’in akıl yürütme, araç kullanımı, kodlama ve bilgi işlerinde Opus 4.8’e yakın performans gösterdiği ancak daha düşük fiyatlı olduğu. Anthropic’in yayımladığı ajan odaklı kodlama karşılaştırmasında, Sonnet 5 %63,2 puan alırken Opus 4.8 %69,2 ve Sonnet 4.6 %58,1 puan aldı. Bir bilgi işi karşılaştırmasında ise Sonnet 5, Opus 4.8’i az farkla geride bırakıyor.
Bu yazıda, Claude Sonnet 5 ile gelen yeniliklerin tamamını ele alacak, yeni özelliklere bakacak, karşılaştırmaları inceleyecek ve maliyetine değineceğim. Daha fazla Anthropic bağlamı için, yakın zamanda yayımladığımız Claude Code slash komutları rehberimize ve Claude Tag incelememize göz atın.
Claude Sonnet 5, Anthropic’in orta seviye modeli olup Opus serisinin altında konumlanır ve daha önce yalnızca daha pahalı Opus modellerinin üstesinden gelebildiği ajan odaklı işleri karşılamak üzere tasarlanmıştır. Şubat 2026’da çıkan Sonnet 4.6’nın yerini alır ve modelin metni işlemesini değiştiren güncellenmiş bir belirteçleyici (tokenizer) kullanır.
Pek çok geliştirici için ajan çağı, kodlama ve araç kullanımında gerçek beceri sergileyen Claude Sonnet 3.5, 3.6 ve 3.7 gibi Sonnet sınıfı modellerle başladı. Son dönemde en belirgin ajan kazanımları Opus sınıfına kaymıştı ve Sonnet 5, Anthropic’in orta seviyeyi yeniden zirveye yaklaştırma girişimi.
Kaynak: Anthropic
En çarpıcı veri maliyet-performans tablosu. Anthropic’in grafikleri, Sonnet 4.6’nın BrowseComp ajan araması ve OSWorld-Verified bilgisayar kullanımı değerlendirmelerinde Opus 4.8’in epey gerisinde kaldığını gösteriyordu. Artık Sonnet 5 ve Opus 4.8 aynı aralığı kapsıyor; Sonnet 5 daha düşük maliyet sunarken, Opus 4.8 daha yüksek doğruluğu daha yüksek bir fiyatla sağlıyor.
Sonnet 5’teki iyileştirmeler tek bir temada toplanıyor: ajan görevlerini yarıda bırakmadan tamamlamak. Öne çıkan yetenekler şunlar.
Sonnet 5’in en büyük pratik değişimi, görevi sonuna kadar götürmesi. Anthropic’in erken erişim test kullanıcıları, modelin önceki Sonnet sürümlerinin yarıda takıldığı karmaşık işleri tamamladığını ve talep edilmeden kendi çıktısını kontrol ettiğini bildirdi.
Kendi işinizde bunu canlandırmak için iki sistemi kapsayan bir görevi düşünün: bir CI çalıştırmasından başarısız test sonuçlarını çekmek, ardından bir düzeltmeyle pull request açmak. Önceki Sonnet modelleri genelde ilk yarıda duruyordu. Anthropic’in kendi örneği, tek seferde Salesforce hesap kademelerini güncellemeyi ve kurumsal kişilere lansman duyurusu göndermeyi içeriyordu; bir Zapier mühendisine göre bu iş akışı eskiden yolun yarısında takılıyordu.
Aracı (agent) geliştirenler için bu, plan taslağı çıkaran bir modelle onu gerçekten uygulayan bir model arasındaki fark. Bir insanın ajanı ileri itmek için müdahale etmesi gereken sayıyı azaltıyor.
Sonnet 5, ayarlanabilir çaba seviyelerini destekler; böylece göreve ve bütçeye göre akıl yürütme derinliğini artırıp azaltabilirsiniz. Anthropic, bunu Sonnet 5 ile Opus 4.8 arasında tek bir doğru nokta bulma yolu olarak konumluyor; tek bir modeli seçip onunla yaşamak yerine.
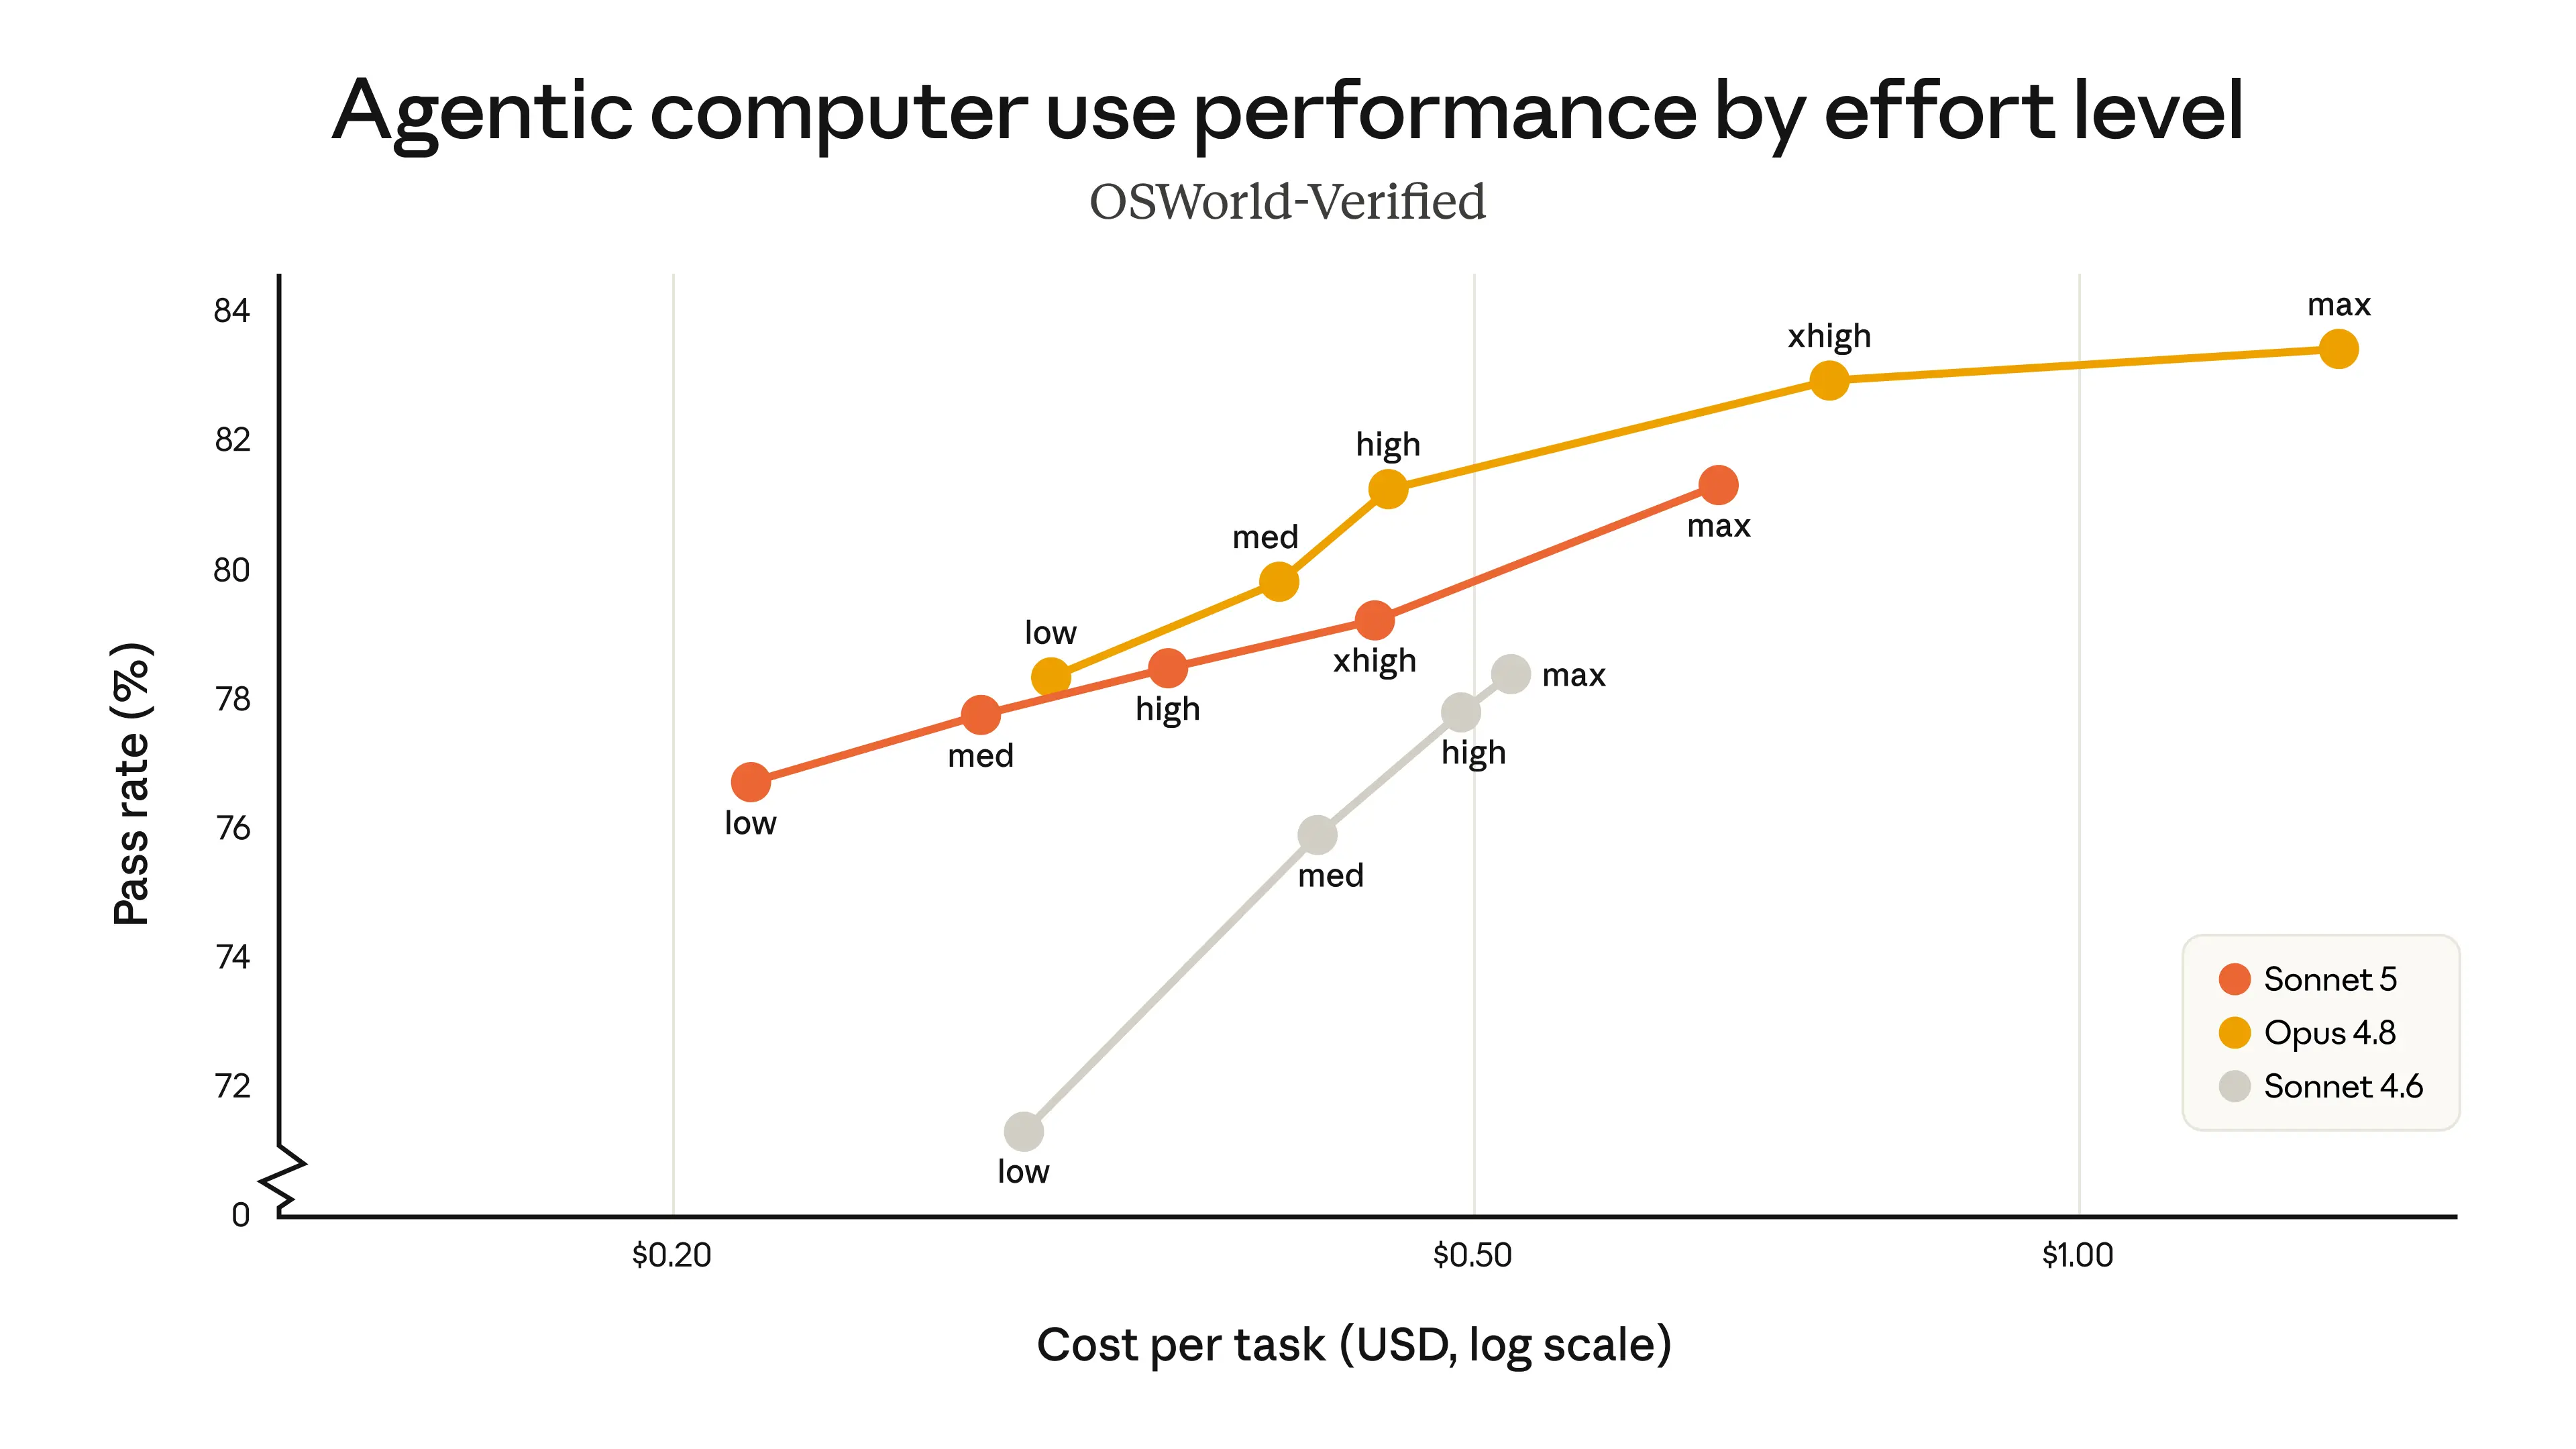
En yüksek Extra High akıl yürütme seviyesinde Sonnet 5, OSWorld-Verified ve BrowseComp’ta yaklaşık olarak Opus 4.8’in orta-üst ayarına denk geliyor. Ancak Sonnet 5’i bu seviyede çalıştırmak, benzer bir akıl yürütme ayarında Opus 4.8’den daha pahalıya mal olabiliyor; bu nedenle bazı yüksek doğruluk gerektiren görevler için Opus 4.8 daha iyi seçenek olmaya devam ediyor.
Zaten Claude Code kullanıyorsanız, çaba seviyeleri tanıdık gelecektir. /effort komutunu ve seviyelerini Claude Code slash komutları rehberimizde ele alıyoruz.
Sonnet 5, canlı sistemlere dokunulduğunda önem taşıyan, Sonnet 4.6’ya kıyasla ölçülebilir güvenlik iyileştirmeleriyle geliyor. Anthropic’in dağıtım öncesi değerlendirmeleri, kötü niyetli istekleri reddetmede ve istem enjeksiyonu saldırılarında ele geçirilmelere direnmede daha iyi olduğunu buldu.
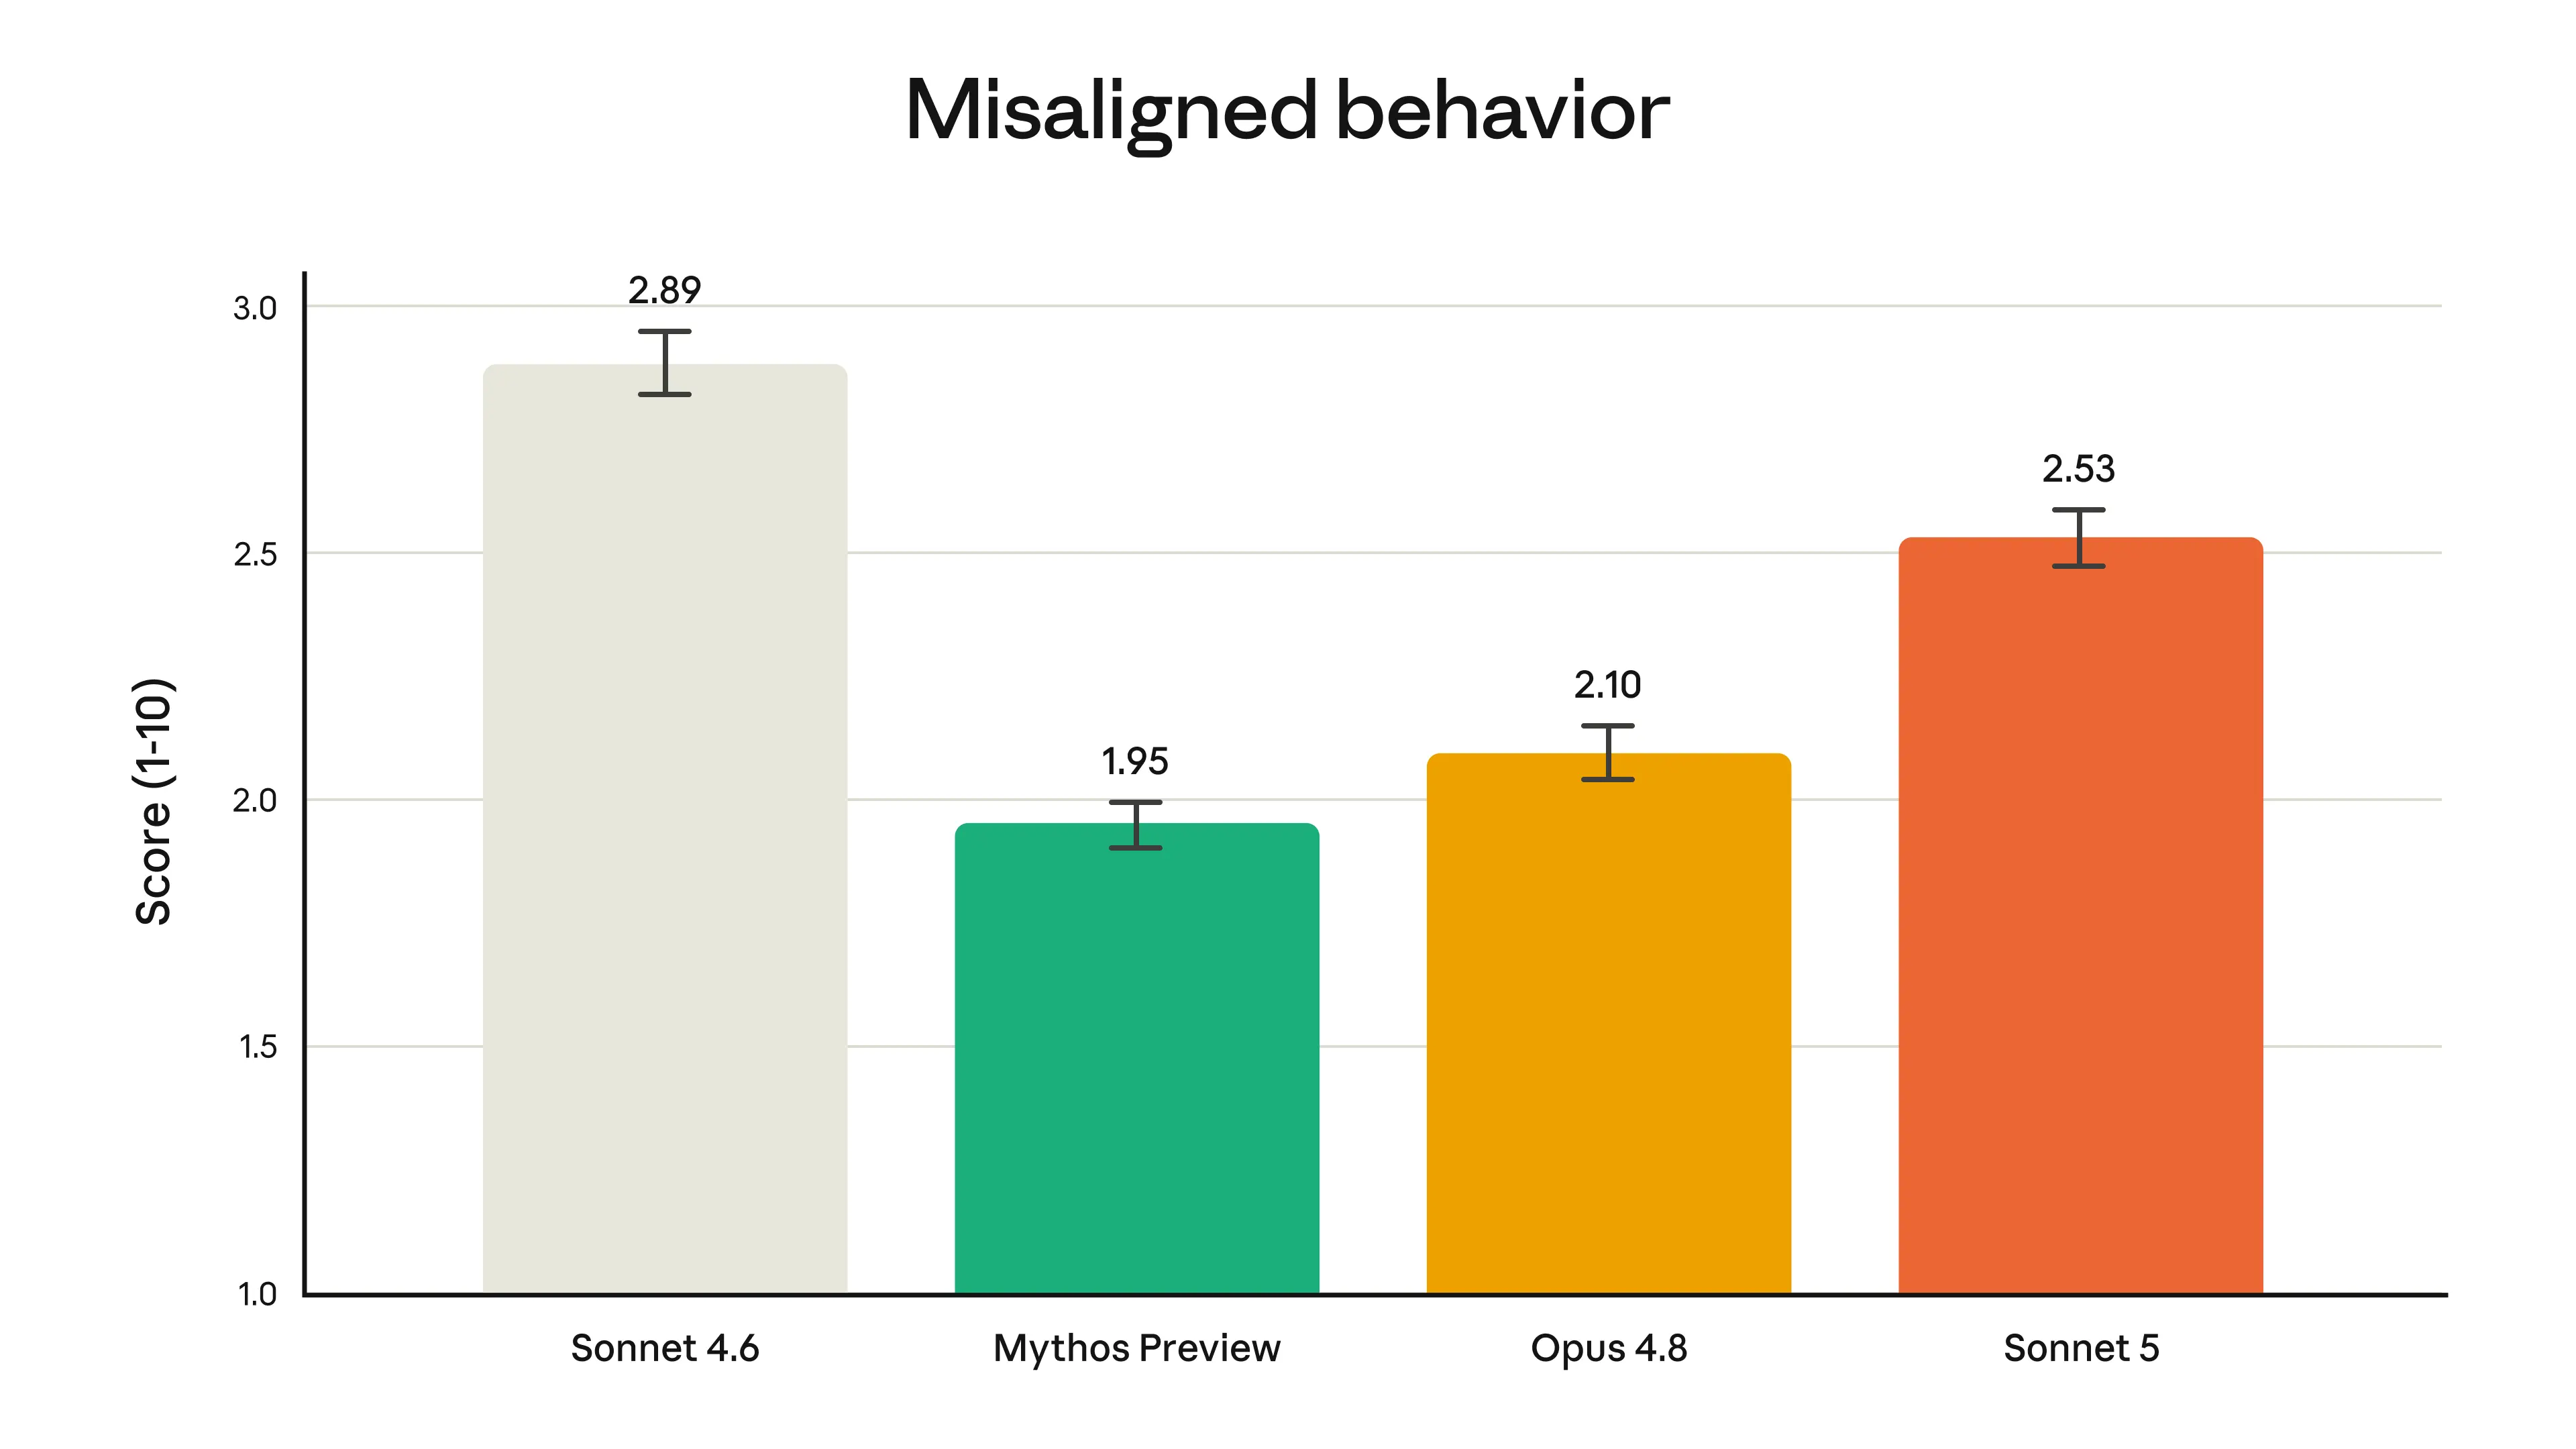
Model ayrıca Sonnet 4.6’ya kıyasla daha düşük halüsinasyon ve dalkavukluk oranları sergiliyor ve kötüye kullanımla iş birliği veya aldatma gibi uyumsuz davranışları kapsayan Anthropic’in otomatik davranış denetiminde daha düşük (daha güvenli) puan aldı. Lovable’ın kurucu ortağı değeri net ifade etti: ne zaman hayır diyeceğini bilen bir model, nasıl inşa edeceğini bilen kadar önemlidir.
Ancak Sonnet 5, daha yetkin Opus 4.8 ve Claude Mythos Önizleme’ye kıyasla hâlâ daha yüksek uyumsuz davranış oranları gösteriyor; yani selefinden daha güvenli olsa da Anthropic’in ürün ailesindeki en güvenli model değil.
Kaynak: Anthropic
Sonnet 5, Claude Opus 4.7 ve 4.8’de de bulunan gerçek zamanlı siber korumalar açık şekilde sunuluyor. Bunlar, tehlikeli siber kullanımı gerçekleştiği anda algılar ve engeller.
Anthropic’in değerlendirmelerinde Sonnet 5, tehlikeli siber yeteneklerde Opus 4.8 ve Mythos 5’e kıyasla belirgin şekilde daha zayıf. Mozilla ile birlikte Firefox 147’deki güvenlik açıkları için istismarlar geliştirmek üzere hazırlanan bir testte, ne Sonnet 5 ne de Sonnet 4.6 çalışır durumda bir istismar üretti (ikisi de %0,0 puan aldı); ancak Sonnet 5 biraz daha yüksek kısmi başarı oranı gösterdi ki Anthropic bunu siber eğitimden ziyade genel zekâ kazanımlarına bağlıyor.
Daha az sınırlandırma isteyen güvenlik araştırmacıları için Anthropic bunun yerine Opus 4.8’i öneriyor. Sonnet 5’teki korumalar, daha geniş bir siber güvenlik görev yelpazesini engelleyen Fable 5 ile sunulanlardan daha az katı.
Anthropic’in Sonnet 5 için sunduğu karşılaştırma tablosu tutarlı: Sonnet 4.6’ya göre net bir iyileşme ve şu ana kadar yayımlanan değerlendirmelerde Opus 4.8’in hemen altında yer alıyor. Aşağıdaki rakamlar Anthropic’in lansman materyallerinden alınmıştır. Bir uyarı notu: üçüncü taraf incelemeciler, muhtemelen farklı veri setleri, bağlam ayarları veya ajan iskeleleri nedeniyle aynı karşılaştırmalar için farklı rakamlar bildirdi; dolayısıyla öne çıkan sayıları yapılandırmaya bağlı düşünün.
| Sonnet 5 | Sonnet 4.6 | Opus 4.8 Referans için |
|
|---|---|---|---|
| Ajan odaklı kodlama SWE-bench Pro |
%63,2 | %58,1 | %69,2 |
| Ajan odaklı kodlama Terminal-Bench 2.1 |
%80,4 | %67,0 | %82,7 |
| Çok disiplinli akıl yürütme Humanity's Last Exam |
%43,2 araçsız %57,4 araçlarla |
%34,6 araçsız %46,8 araçlarla |
%49,8 araçsız %57,9 araçlarla |
| Bilgisayar kullanımı OSWorld-Verified |
%81,2 | %78,5 | %83,4 |
| Bilgi işi GDPval-AA v2 |
1618 | 1395 | 1615 |
Anthropic’in yayımladığı ajan odaklı kodlama karşılaştırmasında Sonnet 5 %63,2 puan alıyor; Opus 4.8 %69,2 ve Sonnet 4.6 %58,1. Bu karşılaştırma, bir modelin tek bir parça üretmek yerine çoklu adımlarda kod yazıp çalıştırıp düzeltip düzeltemediğini ölçüyor.
Opus 4.8 ile fark yaklaşık 6 puan, Sonnet 4.6’ya kıyasla artış ise yaklaşık 5 puan. Geliştiriciler için bu, Sonnet 5’in önceki orta seviye modele göre net bir yükseltme olduğu, ancak amiral gemisine tam olarak yetişmediği anlamına gelir.
Kaynak: Anthropic
OSWorld-Verified, gerçek görevleri tamamlamak için bir masaüstünü kontrol etmeye dayalı bilgisayar kullanım becerisini ölçerken, BrowseComp ajan odaklı web aramasını ölçer. Anthropic, OSWorld-Verified metodolojisini güncelledi ve Sonnet 4.6’yı revize edilmiş düzende %78,5 olarak rapor ediyor.
Her iki değerlendirmede de Sonnet 5, her çaba seviyesinde Sonnet 4.6’ya göre net bir iyileşme sağlıyor; Opus 4.8 ise daha yüksek doğruluk tercihi olmaya devam ediyor. Extra High çabada Sonnet 5, yaklaşık olarak Opus 4.8’in orta-üst performansına ulaşıyor; ancak bu noktada maliyet avantajı daralıyor. Bu yüzden Anthropic, iki modeli düz bir yükseltme yerine tek bir maliyet-doğruluk aralığının parçaları olarak konumluyor.
Bir bilgi işi karşılaştırmasında Sonnet 5, TechCrunch’ın haberine göre Opus 4.8’i az farkla geride bırakıyor. Bu önemli; çünkü en zorlu yargılar ve derin araştırmalar genelde Opus 4.8 ile ilişkilendirilir.
Anthropic ayrıca Humanity's Last Exam için değerlendiricisini güncelledi ve artık Sonnet 4.6’yı %34,6 (araçsız) ve %46,8 (araçlarla) olarak rapor ediyor; bu nedenle bu rakamlar ilk Sonnet 4.6 lansmanından farklı. Uygulayıcılar için bu bilgi işi sonucu, Sonnet 5’in önceden Opus’un alanı gibi görünen analiz ve araştırma görevleri için uygun olduğunu gösteriyor.
Sonnet katmanının nerede konumlandığına dair daha geniş bir bağlam için Sakana Fugu vs Claude Fable 5 içeriğimiz faydalı. Bu karşılaştırmada, daha üst seviye Claude Fable 5, SWE-Bench Pro’da %80,3 ve Humanity's Last Exam’de (araçsız) %59,0 puan aldı; burada yer alan orta seviye rakamların oldukça üzerinde.
Bu fark zaten amaçlanan şey. Anthropic’in ürün yelpazesi, ajan odaklı ve daha düşük maliyetli Sonnet 5’ten başlayıp Opus 4.8 ile Mythos ve Fable sınıflarına uzanıyor; her katman en zor problemler için maliyeti doğrulukla takas ediyor.
Claude Sonnet 5, lansman gününden itibaren her yerde kullanılabilir. Ücretsiz ve Pro planlarının varsayılan modeli olup Max, Team ve Enterprise kullanıcılarına; ayrıca Claude Code ve Claude Platform’da mevcuttur.
Geliştiriciler, Claude API üzerinden claude-sonnet-5 model kimliğiyle çağırabilir. Fiyatlandırma iki aşamada işler:
Bütçeleme için bir ayrıntı: Sonnet 5 güncellenmiş bir belirteçleyici kullanıyor; bu nedenle aynı girdi, içerik türüne bağlı olarak önceye göre yaklaşık 1,0 ila 1,35 kat daha fazla belirtece karşılık gelebilir. Anthropic, Sonnet 4.6’dan geçişin yaklaşık olarak maliyet nötr olmasını sağlamak için tanıtım fiyatlandırmasını bu şekilde ayarladı. Şirket ayrıca daha yüksek çaba seviyelerinin getirdiği daha ağır belirteç kullanımını karşılamak için Chat, Cowork, Claude Code ve Claude Platform genelinde hız limitlerini artırdı.
Hızlı karşılaştırma isteyenler için, Anthropic’in yayımladığı rakamlar temelinde üç modelin dizilimi şöyle.
| Model | Ajan odaklı kodlama | OSWorld-Verified | Girdi / çıktı fiyatı (1M belirteç başına) |
|---|---|---|---|
| Sonnet 5 | %63,2 | Tüm çaba seviyelerinde 4.6’ya göre iyileşme | $2 / $10 (tanıtım), ardından $3 / $15 |
| Sonnet 4.6 | %58,1 | %78,5 (revize) | $3 / $15 |
| Opus 4.8 | %69,2 | Daha yüksek doğruluk tercihi | $5 / $25 |
Sonnet 5, Anthropic’in ajan yeteneğinin artık her fiyat katmanında temel beklenti olduğu, yalnızca amiral gemisine özgü bir özellik olmadığı yönündeki en net ifadesi. Fark yaratan artık kimin ajan işini en iyi yaptığı değil; kimin bunu insan gözetimi olmadan ucuz ve güvenilir şekilde yapabildiği.
Bana en ilginç gelen, tanıtım fiyatlandırması. Anthropic, geçiş penceresinde mümkün olan en düşük maliyetle müşterilerin Sonnet 5’i gerçek iş yüklerine karşı test etmesini istiyor gibi görünüyor; bu da rutin ajan işleri için insanları Opus 4.8’den uzaklaştırıp o kapasiteyi serbest bırakmaya yönelik bilinçli bir hamle gibi okunuyor. Ayrıca OpenAI’nin GPT-5.5’i ve Google’ın Gemini 3.1 Pro’sunu fiyatla alt ediyor; yine de Gemini 3.5 Flash daha ucuz kalıyor.
Uzun soluklu, çok adımlı görevleri çalıştıran ajanlar geliştiriyorsanız, Sonnet 5 ilk başvurulacak yeni varsayılan gibi görünüyor; yalnızca bir görev gerçekten ekstra doğruluğa ihtiyaç duyduğunda Opus 4.8’e çıkmak mantıklı. Dürüst uyarı: bazı üçüncü taraf incelemeciler, Sonnet 5’in akıl yürütme derinliğini kodlama hızıyla takas ettiğini gözlemliyor; bu nedenle doktora düzeyinde bilimsel akıl yürütme veya yoğun tarama gerektiren işlerde Opus 4.8 hâlâ daha güvenli tercih olabilir.
Sonnet 5’in tasarlandığı türde otomasyonla bizzat çalışmak isterseniz, bulutta bir kodlama ajanını zamanlı çalıştırmayı adım adım gösteren Claude Code Routines rehberimizi öneririm.
Öne Çıkan DataCamp Kursları
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.





