
Last chance! 50% off DataCamp Premium
Sale ends in
Anthropic bracht Claude Sonnet 5 uit op 30 juni 2026, met een duidelijke pitch: dit is het meest agentische Sonnet-model dat het bedrijf tot nu toe heeft geleverd. Het kan plannen maken, tools als browsers en terminals aansturen en autonoom draaien op een niveau dat tot voor kort alleen haalbaar was voor grotere Opus-klasse modellen.
De kernclaim is dat Sonnet 5 dicht in de buurt komt van Opus 4.8 op het gebied van redeneren, toolgebruik, coderen en kenniswerk, maar dan tegen een lagere prijs. Op de agentische coding-benchmark die Anthropic publiceerde, scoort Sonnet 5 63,2% tegenover Opus 4.8’s 69,2% en Sonnet 4.6’s 58,1%. Op één kenniswerk-benchmark gaat Sonnet 5 zelfs nipt voorbij Opus 4.8.
In dit artikel bespreek ik alles wat nieuw is in Claude Sonnet 5: de nieuwe functies, de benchmarks en wat het kost. Wil je meer context over Anthropic, bekijk dan onze recente gids over Claude Code slash-commando’s en ons stuk over Claude Tag.
Claude Sonnet 5 is het mid-tier model van Anthropic, onder de Opus-lijn, en bedoeld om agentisch werk aan te kunnen dat voorheen de duurdere Opus-modellen vereiste. Het vervangt Sonnet 4.6, dat in februari 2026 werd gelanceerd, en gebruikt een bijgewerkte tokenizer die verandert hoe het model tekst verwerkt.
Voor veel ontwikkelaars begon het agentische tijdperk met Sonnet-klasse modellen zoals Claude Sonnet 3.5, 3.6 en 3.7, de eerste Claude-releases die echt vaardig bleken in coderen en toolgebruik. Recentelijk lagen de duidelijkste agentische vooruitgangen bij Opus-klasse modellen, en Sonnet 5 is Anthropics poging om het middensegment weer dichter naar de voorhoede te trekken.
Bron: Anthropic
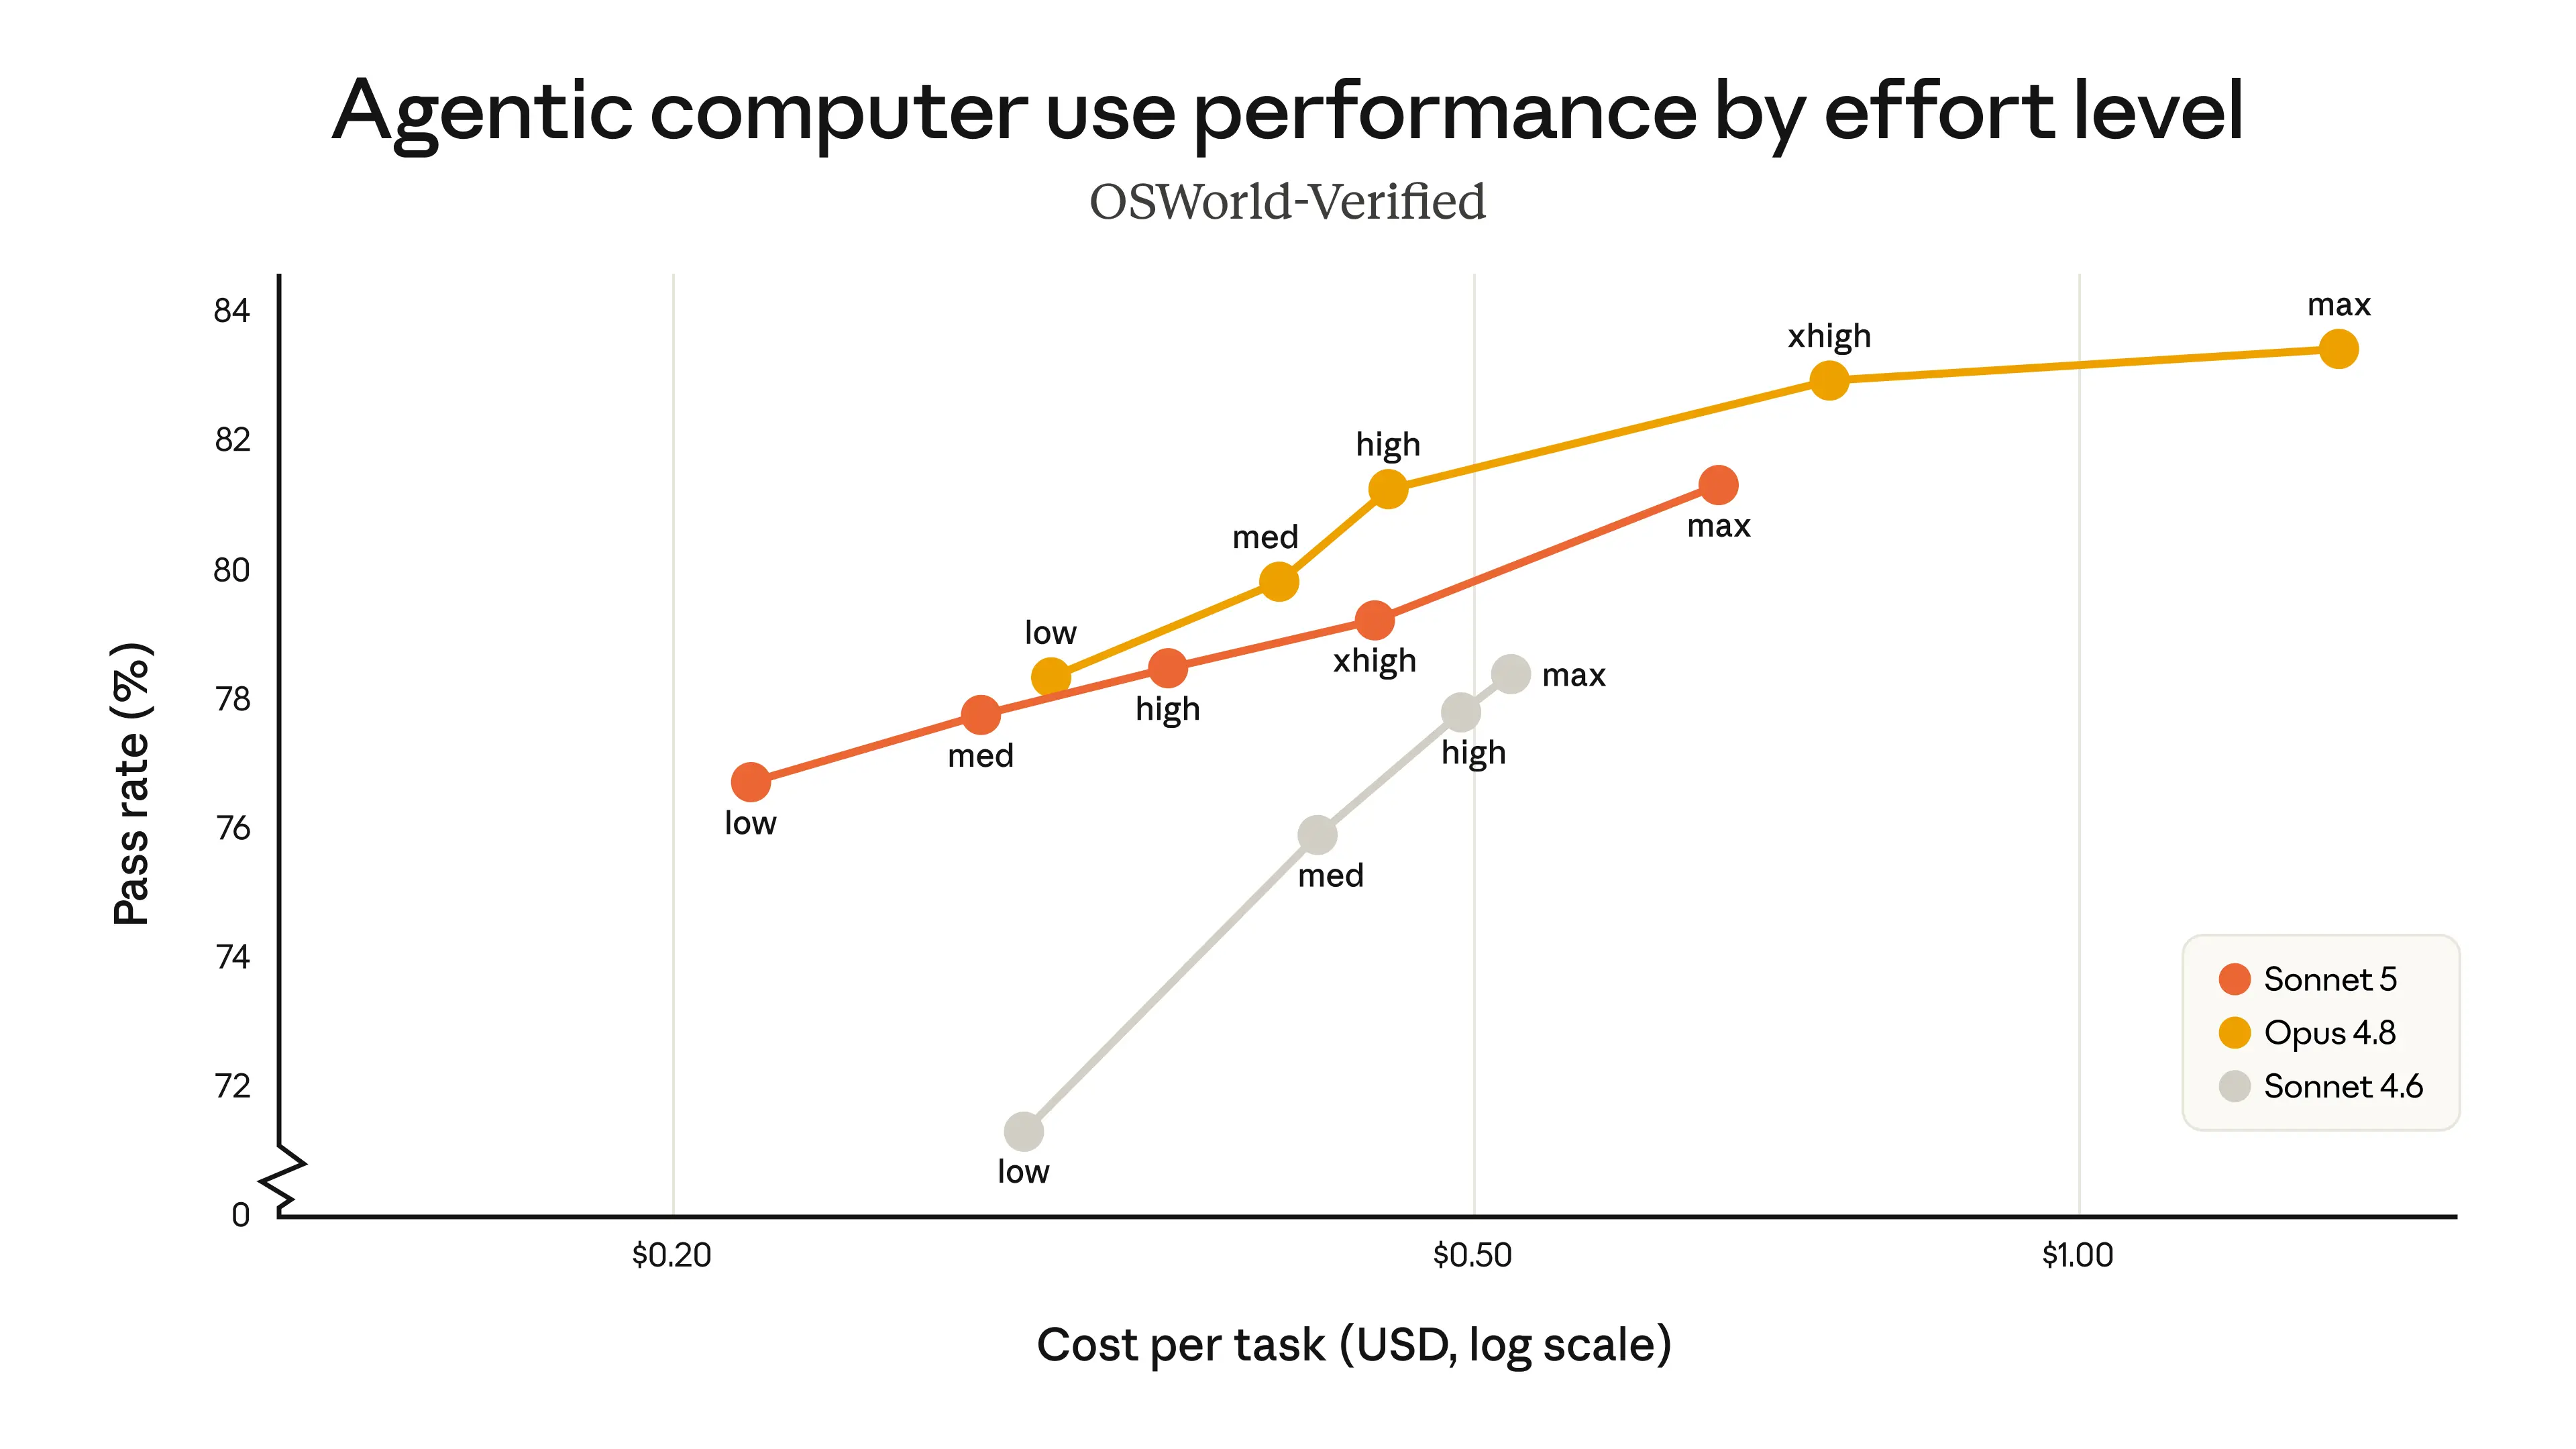
Het meest veelzeggende cijfer is het kosten-prestatieplaatje. Anthropics eigen grafieken laten zien dat Sonnet 4.6 duidelijk achterbleef bij Opus 4.8 op de BrowseComp agentische zoek- en OSWorld-Verified computergebruik-evaluaties. Sonnet 5 en Opus 4.8 vallen nu binnen één bereik, waarbij Sonnet 5 lagere kosten biedt en Opus 4.8 hogere nauwkeurigheid tegen een hogere prijs.
De verbeteringen in Sonnet 5 draaien om één thema: agentische taken afmaken zonder halverwege te stoppen. Dit zijn de opvallendste capaciteiten.
De grootste praktische verandering in Sonnet 5 is het doorpakken op taken. Early-access testers van Anthropic meldden dat het model complexe taken afrondt waar eerdere Sonnet-versies halverwege bleven steken, en dat het zijn eigen output controleert zonder dat daarom wordt gevraagd.
Om dit voor je eigen werk te visualiseren: geef het model een opdracht die twee systemen beslaat—haal mislukte testresultaten uit een CI-run en open vervolgens een pull request met een fix. Eerdere Sonnet-modellen stopten vaak na de eerste helft. Anthropics eigen voorbeeld betrof het updaten van Salesforce-accounttiers en het versturen van een lanceringsaankondiging naar enterprise-contacten in één keer, een workflow waarvan een Zapier-engineer zei dat die eerder halverwege stokte.
Voor iedereen die agents bouwt is dit het verschil tussen een model dat een plan opstelt en een model dat het uitvoert. Het vermindert het aantal keren dat een mens moet ingrijpen om de agent een duwtje te geven.
Sonnet 5 ondersteunt instelbare inspanningsniveaus, zodat je de diepte van redeneren kunt opschalen of afschalen afhankelijk van de taak en het budget. Anthropic positioneert dit als een manier om het juiste punt te vinden tussen Sonnet 5 en Opus 4.8 in plaats van één model te kiezen en het daarbij te laten.
Op het maximaal opgevoerde Extra High-niveau presteert Sonnet 5 ongeveer gelijk aan Opus 4.8’s medium-tot-hoog instelling op OSWorld-Verified en BrowseComp. Het addertje is dat Sonnet 5 op dat niveau draaien meer kan kosten dan Opus 4.8 bij een vergelijkbare instelling, dus voor sommige hoge-nauwkeurigheidstaken blijft Opus 4.8 de betere keuze.
Als je al Claude Code gebruikt, zijn inspanningsniveaus bekend. We behandelen het /effort-commando en de niveaus in onze Claude Code slash-commando’s tutorial.
Sonnet 5 wordt geleverd met meetbare veiligheidsverbeteringen ten opzichte van Sonnet 4.6, wat belangrijk is wanneer een agent live systemen aanraakt. Anthropics pre-deployment evaluaties laten zien dat het beter is in het weigeren van kwaadaardige verzoeken en het weerstaan van kaping bij prompt-injectie aanvallen.
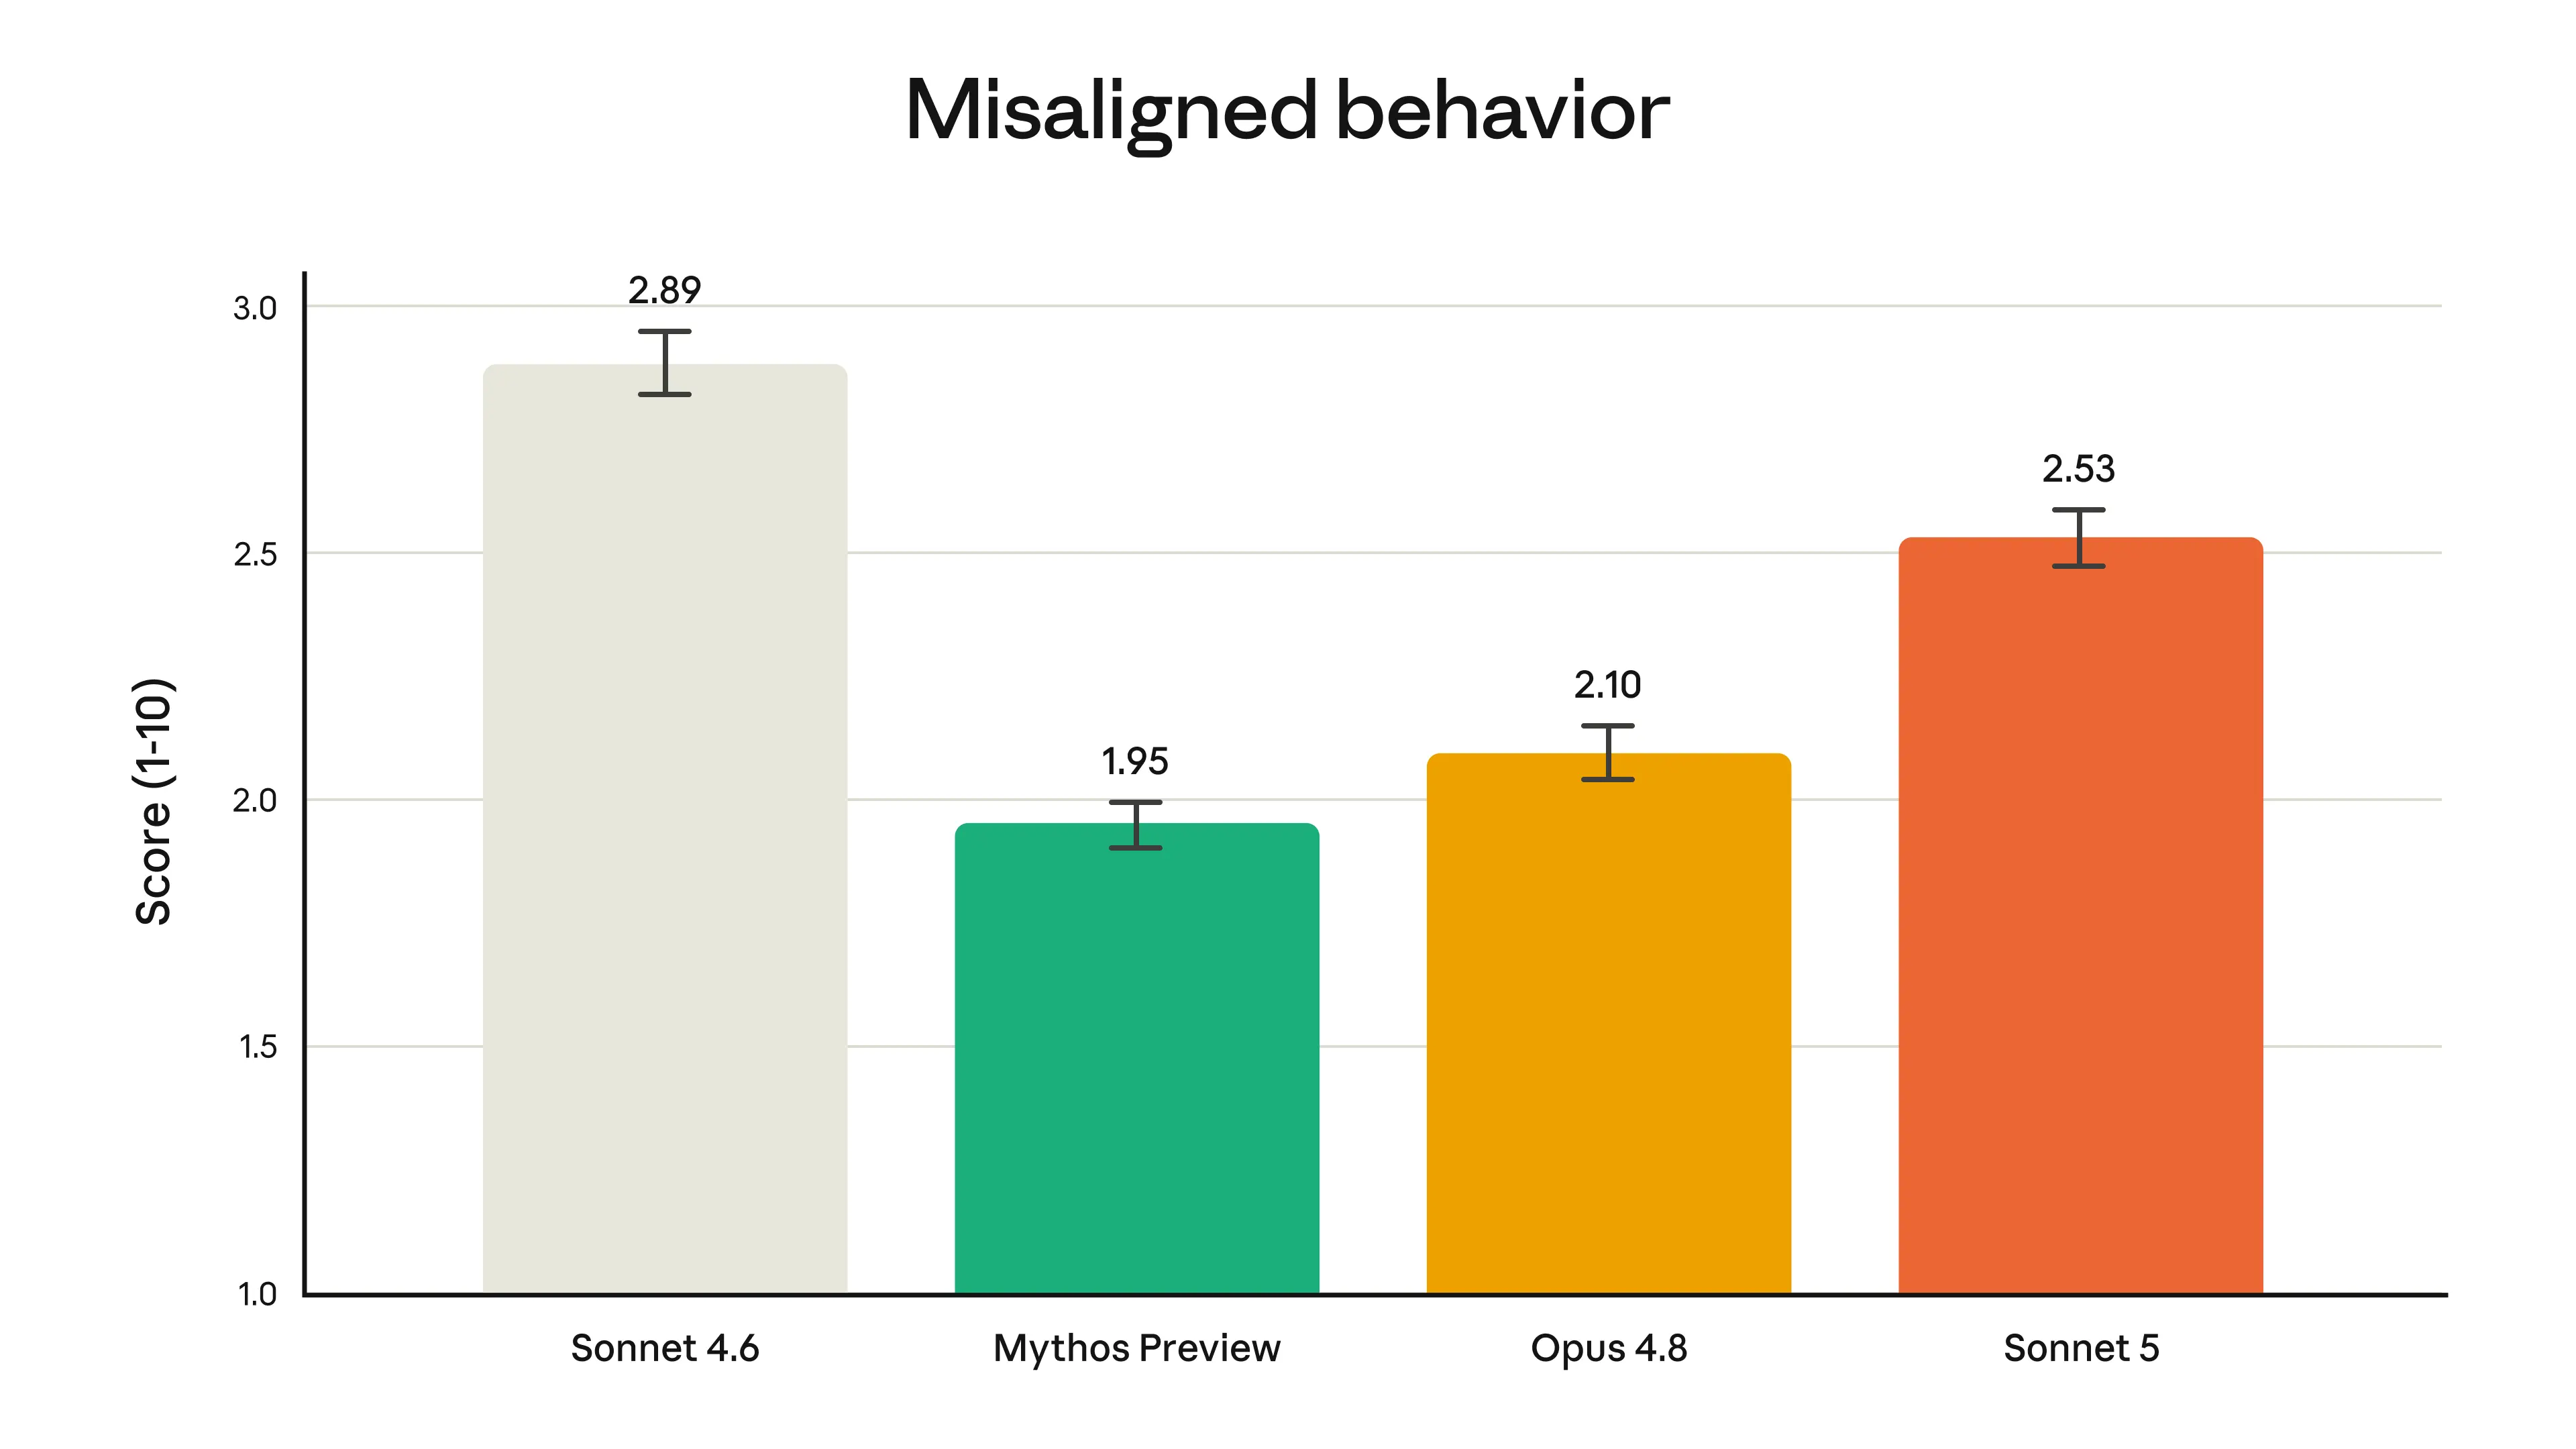
Het model vertoont ook lagere percentages hallucinaties en jaknikkergedrag dan Sonnet 4.6, en scoorde lager (veiliger) op Anthropics geautomatiseerde gedragsaudit die niet-uitgelijnde gedragingen als medewerking aan misbruik en misleiding dekt. De medeoprichter van Lovable vatte de waarde treffend samen: een model dat weet wanneer het nee moet zeggen is net zo belangrijk als een model dat weet hoe het moet bouwen.
De kanttekening is dat Sonnet 5 nog steeds hogere percentages niet-uitgelijnd gedrag vertoont dan het capabelere Opus 4.8 en de Claude Mythos Preview, dus het is veiliger dan zijn voorganger maar niet het veiligste model in Anthropics line-up.
Bron: Anthropic
Sonnet 5 wordt gelanceerd met realtime cyberbescherming ingeschakeld, dezelfde als in Claude Opus 4.7 en 4.8. Deze detecteren en blokkeren gevaarlijk cybergebruik terwijl het gebeurt.
In Anthropics evaluaties heeft Sonnet 5 aanzienlijk zwakkere gevaarlijke-cybervaardigheden dan Opus 4.8 en Mythos 5. In een test gebouwd met Mozilla om exploits te ontwikkelen voor kwetsbaarheden in Firefox 147 produceerden noch Sonnet 5 noch Sonnet 4.6 een werkende exploit (beiden scoorden 0,0%), al liet Sonnet 5 een iets hogere gedeeltelijke-succesratio zien, wat Anthropic toeschrijft aan algemene intelligentiewinst in plaats van cybertraining.
Voor security-onderzoekers die minder strikte vangrails nodig hebben, raadt Anthropic in plaats daarvan Opus 4.8 aan. De waarborgen op Sonnet 5 zijn minder streng dan die welke werden meegeleverd met Fable 5, dat een breder scala aan cybersecuritytaken blokkeerde.
Anthropics benchmarkverhaal voor Sonnet 5 is consistent: het is een duidelijke verbetering ten opzichte van Sonnet 4.6 en zit net onder Opus 4.8 op de tot nu toe gepubliceerde evaluaties. De onderstaande cijfers komen uit Anthropics lanceringsmateriaal. Een kanttekening: externe reviewers hebben andere cijfers gerapporteerd voor dezelfde benchmarks, waarschijnlijk door verschillen in datasets, contextinstellingen of agent-structuren. Zie headline-cijfers dus als configuratieafhankelijk.
| Sonnet 5 | Sonnet 4.6 | Opus 4.8 Ter referentie |
|
|---|---|---|---|
| Agentisch coderen SWE-bench Pro |
63,2% | 58,1% | 69,2% |
| Agentisch coderen Terminal-Bench 2.1 |
80,4% | 67,0% | 82,7% |
| Multidisciplinaire redenering Humanity's Last Exam |
43,2% zonder tools 57,4% met tools |
34,6% zonder tools 46,8% met tools |
49,8% zonder tools 57,9% met tools |
| Computergebruik OSWorld-Verified |
81,2% | 78,5% | 83,4% |
| Kenniswerk GDPval-AA v2 |
1618 | 1395 | 1615 |
Op de agentische coding-benchmark die Anthropic publiceerde, scoort Sonnet 5 63,2%, vergeleken met Opus 4.8’s 69,2% en Sonnet 4.6’s 58,1%. Deze benchmark meet of een model code kan schrijven, draaien en repareren over meerdere stappen, in plaats van slechts één snippet te produceren.
De achterstand op Opus 4.8 is circa 6 punten, terwijl de sprong ten opzichte van Sonnet 4.6 ongeveer 5 punten is. Voor ontwikkelaars betekent dit dat Sonnet 5 een duidelijke upgrade is ten opzichte van het vorige mid-tier model, zonder helemaal te tippen aan het vlaggenschip.
Bron: Anthropic
OSWorld-Verified meet computergebruiksvaardigheid—het bedienen van een desktop om echte taken te voltooien—en BrowseComp meet agentische webzoekvaardigheid. Anthropic heeft de OSWorld-Verified-methodologie bijgewerkt en rapporteert Sonnet 4.6 nu op 78,5% in de herziene opzet.
Over beide evaluaties heen is Sonnet 5 op elk inspanningsniveau een duidelijke verbetering ten opzichte van Sonnet 4.6, terwijl Opus 4.8 de keuze met hogere nauwkeurigheid blijft. Op Extra High-inspanning haalt Sonnet 5 ongeveer de medium-tot-hoge prestaties van Opus 4.8, maar op dat punt wordt het kostenvoordeel kleiner. Daarom presenteert Anthropic de twee modellen als één kosten-nauwkeurigheidsbereik in plaats van een rechte upgrade.
Op een kenniswerk-benchmark presteert Sonnet 5 volgens TechCrunch net iets beter dan Opus 4.8. Dat is opvallend, omdat Opus 4.8 meestal wordt geassocieerd met de zwaarste oordeelsvorming en diepgaand onderzoek.
Anthropic heeft ook zijn beoordelaar voor Humanity's Last Exam geüpdatet en rapporteert Sonnet 4.6 nu op 34,6% (zonder tools) en 46,8% (met tools), wat verklaart waarom die cijfers afwijken van de oorspronkelijke Sonnet 4.6-lancering. Voor praktijkmensen suggereert het kenniswerkresultaat dat Sonnet 5 geschikt is voor analyse- en onderzoekstaken die eerder als Opus-terrein voelden.
Voor bredere context over waar de Sonnet-tier zit, is onze bespreking van Sakana Fugu vs Claude Fable 5 nuttig. In die vergelijking scoorde het hoger geplaatste Claude Fable 5 80,3% op SWE-Bench Pro en 59,0% op Humanity's Last Exam (zonder tools), ruim boven de mid-tier cijfers hier.
Dat verschil is precies de bedoeling. Anthropics line-up loopt van het agentische, voordeligere Sonnet 5 omhoog via Opus 4.8 en de Mythos- en Fable-klassen, waarbij elke tier kosten inruilt voor nauwkeurigheid op de moeilijkste problemen.
Claude Sonnet 5 is vanaf de lanceringsdag overal beschikbaar. Het is het standaardmodel voor Free- en Pro-abonnementen en is beschikbaar voor Max-, Team- en Enterprise-gebruikers, evenals in Claude Code en op het Claude Platform.
Ontwikkelaars kunnen het aanroepen via de Claude API met het model-ID claude-sonnet-5. De prijs werkt in twee fasen:
Eén begrotingsdetail: Sonnet 5 gebruikt een bijgewerkte tokenizer, waardoor dezelfde input naar meer tokens kan worden gemapt dan voorheen—ongeveer 1,0 tot 1,35 keer, afhankelijk van het contenttype. Anthropic heeft de introductieprijs zo ingesteld dat de overgang van Sonnet 4.6 ongeveer kostenneutraal is. Het bedrijf heeft ook de snelheidslimieten verhoogd in Chat, Cowork, Claude Code en het Claude Platform om het zwaardere tokengebruik op te vangen dat hogere inspanningsniveaus met zich meebrengen.
Voor lezers die de snelle vergelijking willen: zo komen de drie modellen uit op de cijfers die Anthropic publiceerde.
| Model | Agentisch coderen | OSWorld-Verified | Input-/outputprijs (per 1M tokens) |
|---|---|---|---|
| Sonnet 5 | 63,2% | Verbetert 4.6 op alle inspanningsniveaus | $2 / $10 (intro), daarna $3 / $15 |
| Sonnet 4.6 | 58,1% | 78,5% (herzien) | $3 / $15 |
| Opus 4.8 | 69,2% | Keuze met hogere nauwkeurigheid | $5 / $25 |
Sonnet 5 is Anthropics duidelijkste signaal tot nu toe dat agentische capaciteiten nu de basisverwachting zijn op elk prijsniveau, niet alleen een vlaggenschipfunctie. Het onderscheid zit niet langer in wie het best agentisch werk kan doen, maar wie het goedkoop en betrouwbaar kan doen zonder menselijke supervisie.
Wat ik het meest interessant vind, is de introductieprijs. Het lijkt erop dat Anthropic klanten wil laten testen tegen echte workloads tegen de laagst mogelijke kosten tijdens het migratievenster, wat aanvoelt als een bewuste zet om mensen voor routinematig agentisch werk van Opus 4.8 af te halen en die capaciteit vrij te maken. Het onderbiedt ook OpenAI’s GPT-5.5 en Google’s Gemini 3.1 Pro qua prijs, al blijft Gemini 3.5 Flash goedkoper.
Als je agents bouwt die langdurige, meertraps taken draaien, lijkt Sonnet 5 de nieuwe standaard om als eerste naar te grijpen, en pas op te schakelen naar Opus 4.8 wanneer een taak écht de extra nauwkeurigheid nodig heeft. De eerlijke kanttekening is dat sommige externe reviewers zien dat Sonnet 5 redeneerverdieping inruilt voor codeersnelheid, dus voor wetenschap op PhD-niveau of browsen-intensief werk kan Opus 4.8 nog steeds de veiligere keuze zijn.
Wil je hands-on aan de slag met het soort automatisering waarvoor Sonnet 5 is gebouwd, dan raad ik onze Claude Code Routines-tutorial aan, die stap voor stap laat zien hoe je een coding-agent op schema in de cloud draait.
Topcursussen op DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min


