Cours
Introduction aux modèles Claude
3 h
14.5K
Anthropic a lancé Claude Sonnet 5 le 30 juin 2026, avec une promesse simple : c’est le modèle Sonnet le plus agentique publié à ce jour. Il peut établir des plans, piloter des outils comme des navigateurs et des terminaux, et fonctionner en autonomie à un niveau qui, jusqu’à récemment, n’était accessible qu’aux modèles plus volumineux de la classe Opus.
La promesse centrale : Sonnet 5 se situe très près d’Opus 4.8 en raisonnement, utilisation d’outils, codage et tâches de connaissance, mais à un prix plus bas. Sur le benchmark agentique de codage publié par Anthropic, Sonnet 5 atteint 63,2 % contre 69,2 % pour Opus 4.8 et 58,1 % pour Sonnet 4.6. Sur un benchmark de travail de connaissance, Sonnet 5 dépasse même légèrement Opus 4.8.
Dans cet article, nous passons en revue tout ce qui change avec Claude Sonnet 5 : nouvelles fonctionnalités, analyse des benchmarks et structure tarifaire. Pour plus de contexte sur Anthropic, consultez notre guide récent sur les commandes slash de Claude Code et notre décryptage de Claude Tag.
Claude Sonnet 5 est le modèle milieu de gamme d’Anthropic, positionné sous la ligne Opus et conçu pour gérer des travaux agentiques qui exigeaient jusque-là les modèles Opus, plus coûteux. Il remplace Sonnet 4.6, lancé en février 2026, et utilise un tokenizer mis à jour qui modifie la façon dont le modèle traite le texte.
Pour de nombreux développeurs, l’ère agentique a commencé avec les modèles Sonnet comme Claude Sonnet 3.5, 3.6 et 3.7, premières versions de Claude à montrer une réelle maîtrise du code et de l’usage d’outils. Plus récemment, les gains les plus nets s’étaient déplacés vers les modèles de classe Opus, et Sonnet 5 est la tentative d’Anthropic de ramener le milieu de gamme au plus près de l’état de l’art.
Source : Anthropic
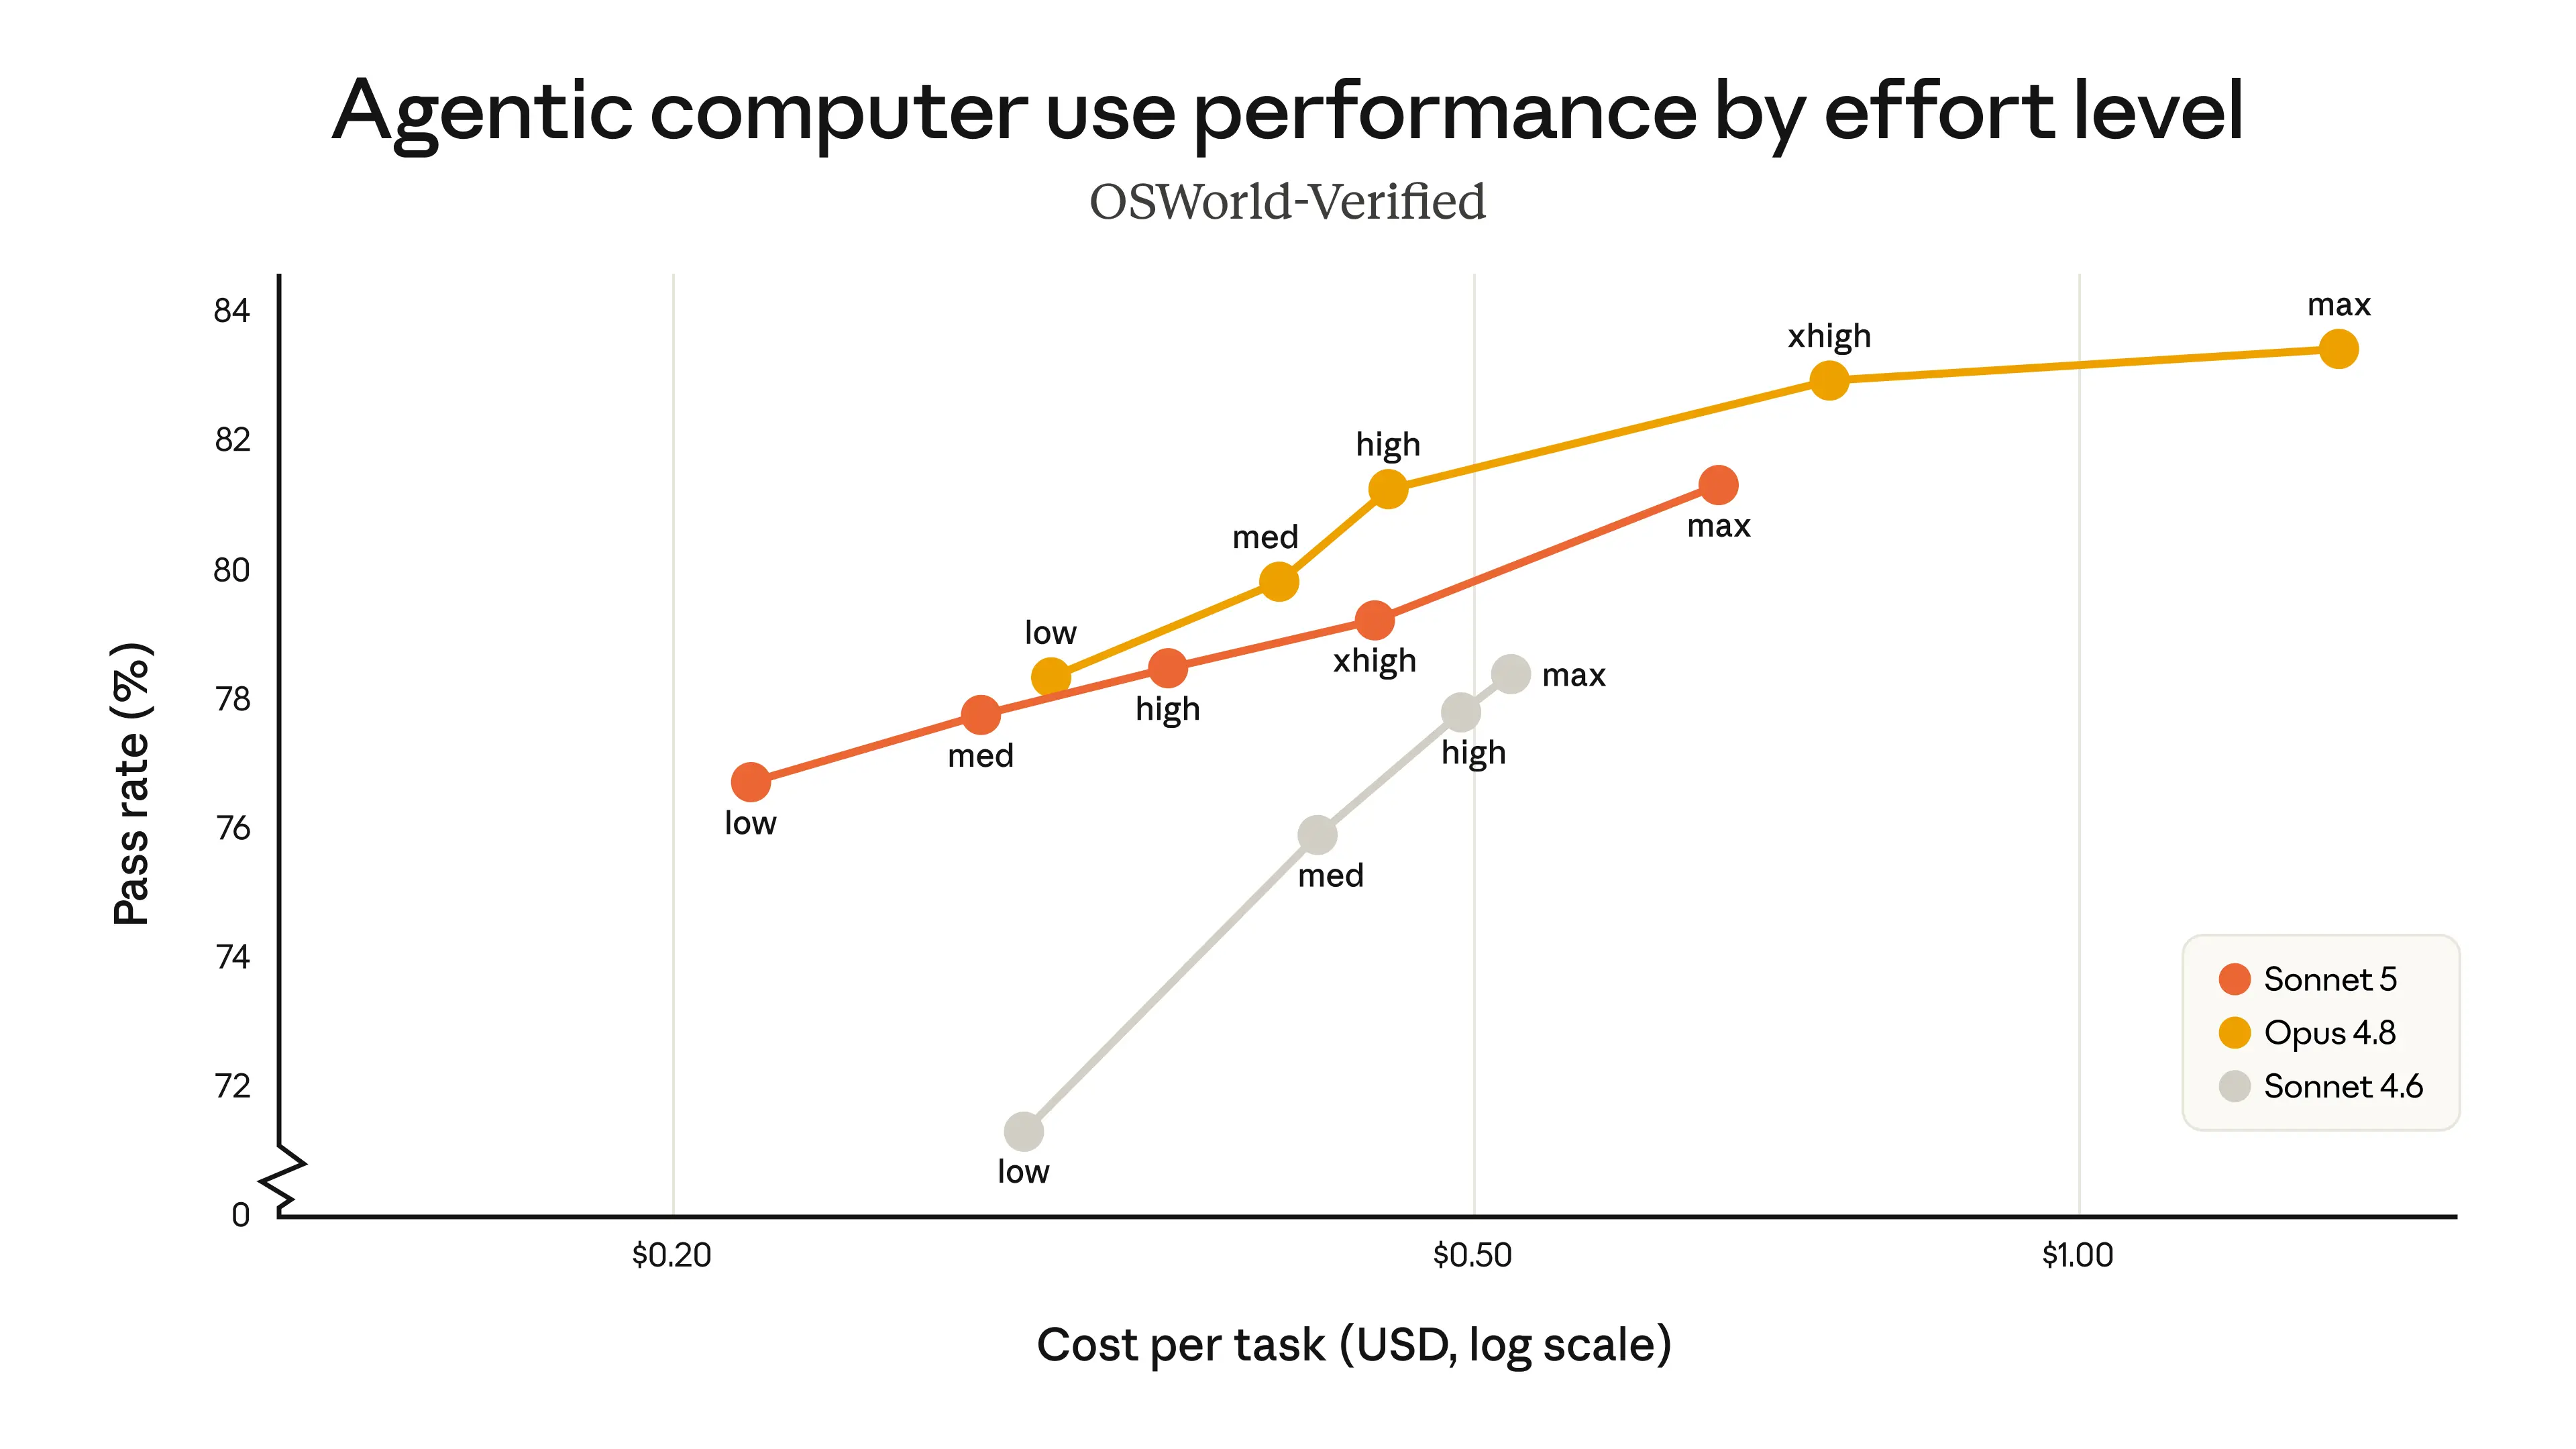
Le chiffre le plus parlant tient au rapport coût‑performance. Les graphiques d’Anthropic montrent que Sonnet 4.6 restait nettement derrière Opus 4.8 sur BrowseComp (recherche agentique) et OSWorld‑Verified (utilisation de l’ordinateur). Sonnet 5 et Opus 4.8 se recouvrent désormais sur une même plage : Sonnet 5 offre un coût plus bas et Opus 4.8 une précision plus élevée à un prix supérieur.
Les améliorations de Sonnet 5 s’articulent autour d’un thème : mener à bien les tâches agentiques de bout en bout, sans s’arrêter en cours de route. Voici les capacités qui ressortent.
Le changement le plus tangible de Sonnet 5 est sa capacité à aller au bout des tâches. Les testeurs en accès anticipé ont rapporté que le modèle termine des tâches complexes là où les versions précédentes de Sonnet bloquaient à mi‑parcours, et qu’il vérifie spontanément sa propre sortie.
Pour vous le représenter, imaginez confier au modèle une mission couvrant deux systèmes : extraire les tests en échec d’une exécution CI, puis ouvrir une pull request avec un correctif. Les modèles Sonnet antérieurs avaient tendance à s’arrêter après la première moitié. L’exemple d’Anthropic évoquait la mise à jour des niveaux de comptes Salesforce et l’envoi d’une annonce de lancement à des contacts Entreprise en un seul passage, un flux de travail qui, selon un ingénieur de Zapier, avait l’habitude de caler à mi‑chemin.
Pour quiconque construit des agents, c’est la différence entre un modèle qui rédige un plan et un modèle qui l’exécute. Cela réduit le nombre d’interventions humaines nécessaires pour relancer l’agent.
Sonnet 5 prend en charge des niveaux d’effort réglables : vous pouvez augmenter ou réduire la profondeur de raisonnement selon la tâche et le budget. Anthropic présente cela comme un moyen de trouver le bon point entre Sonnet 5 et Opus 4.8 plutôt que de choisir un seul modèle et s’y tenir.
Au niveau de raisonnement Extra High (au maximum), Sonnet 5 se situe à peu près au niveau moyen‑à‑élevé d’Opus 4.8 sur OSWorld‑Verified et BrowseComp. Attention toutefois : faire tourner Sonnet 5 à ce niveau peut coûter plus cher qu’Opus 4.8 à un réglage comparable, si bien qu’Opus 4.8 reste le meilleur choix pour certaines tâches exigeant une très grande précision.
Si vous utilisez déjà Claude Code, ces niveaux d’effort vous sembleront familiers. Nous détaillons la commande /effort et ses niveaux dans notre tutoriel sur les commandes slash de Claude Code.
Sonnet 5 arrive avec des améliorations mesurables de sécurité par rapport à Sonnet 4.6, ce qui compte lorsque l’agent touche des systèmes en production. Les évaluations pré‑déploiement d’Anthropic montrent qu’il refuse mieux les requêtes malveillantes et résiste davantage aux tentatives de détournement lors d’attaques par injection de prompt.
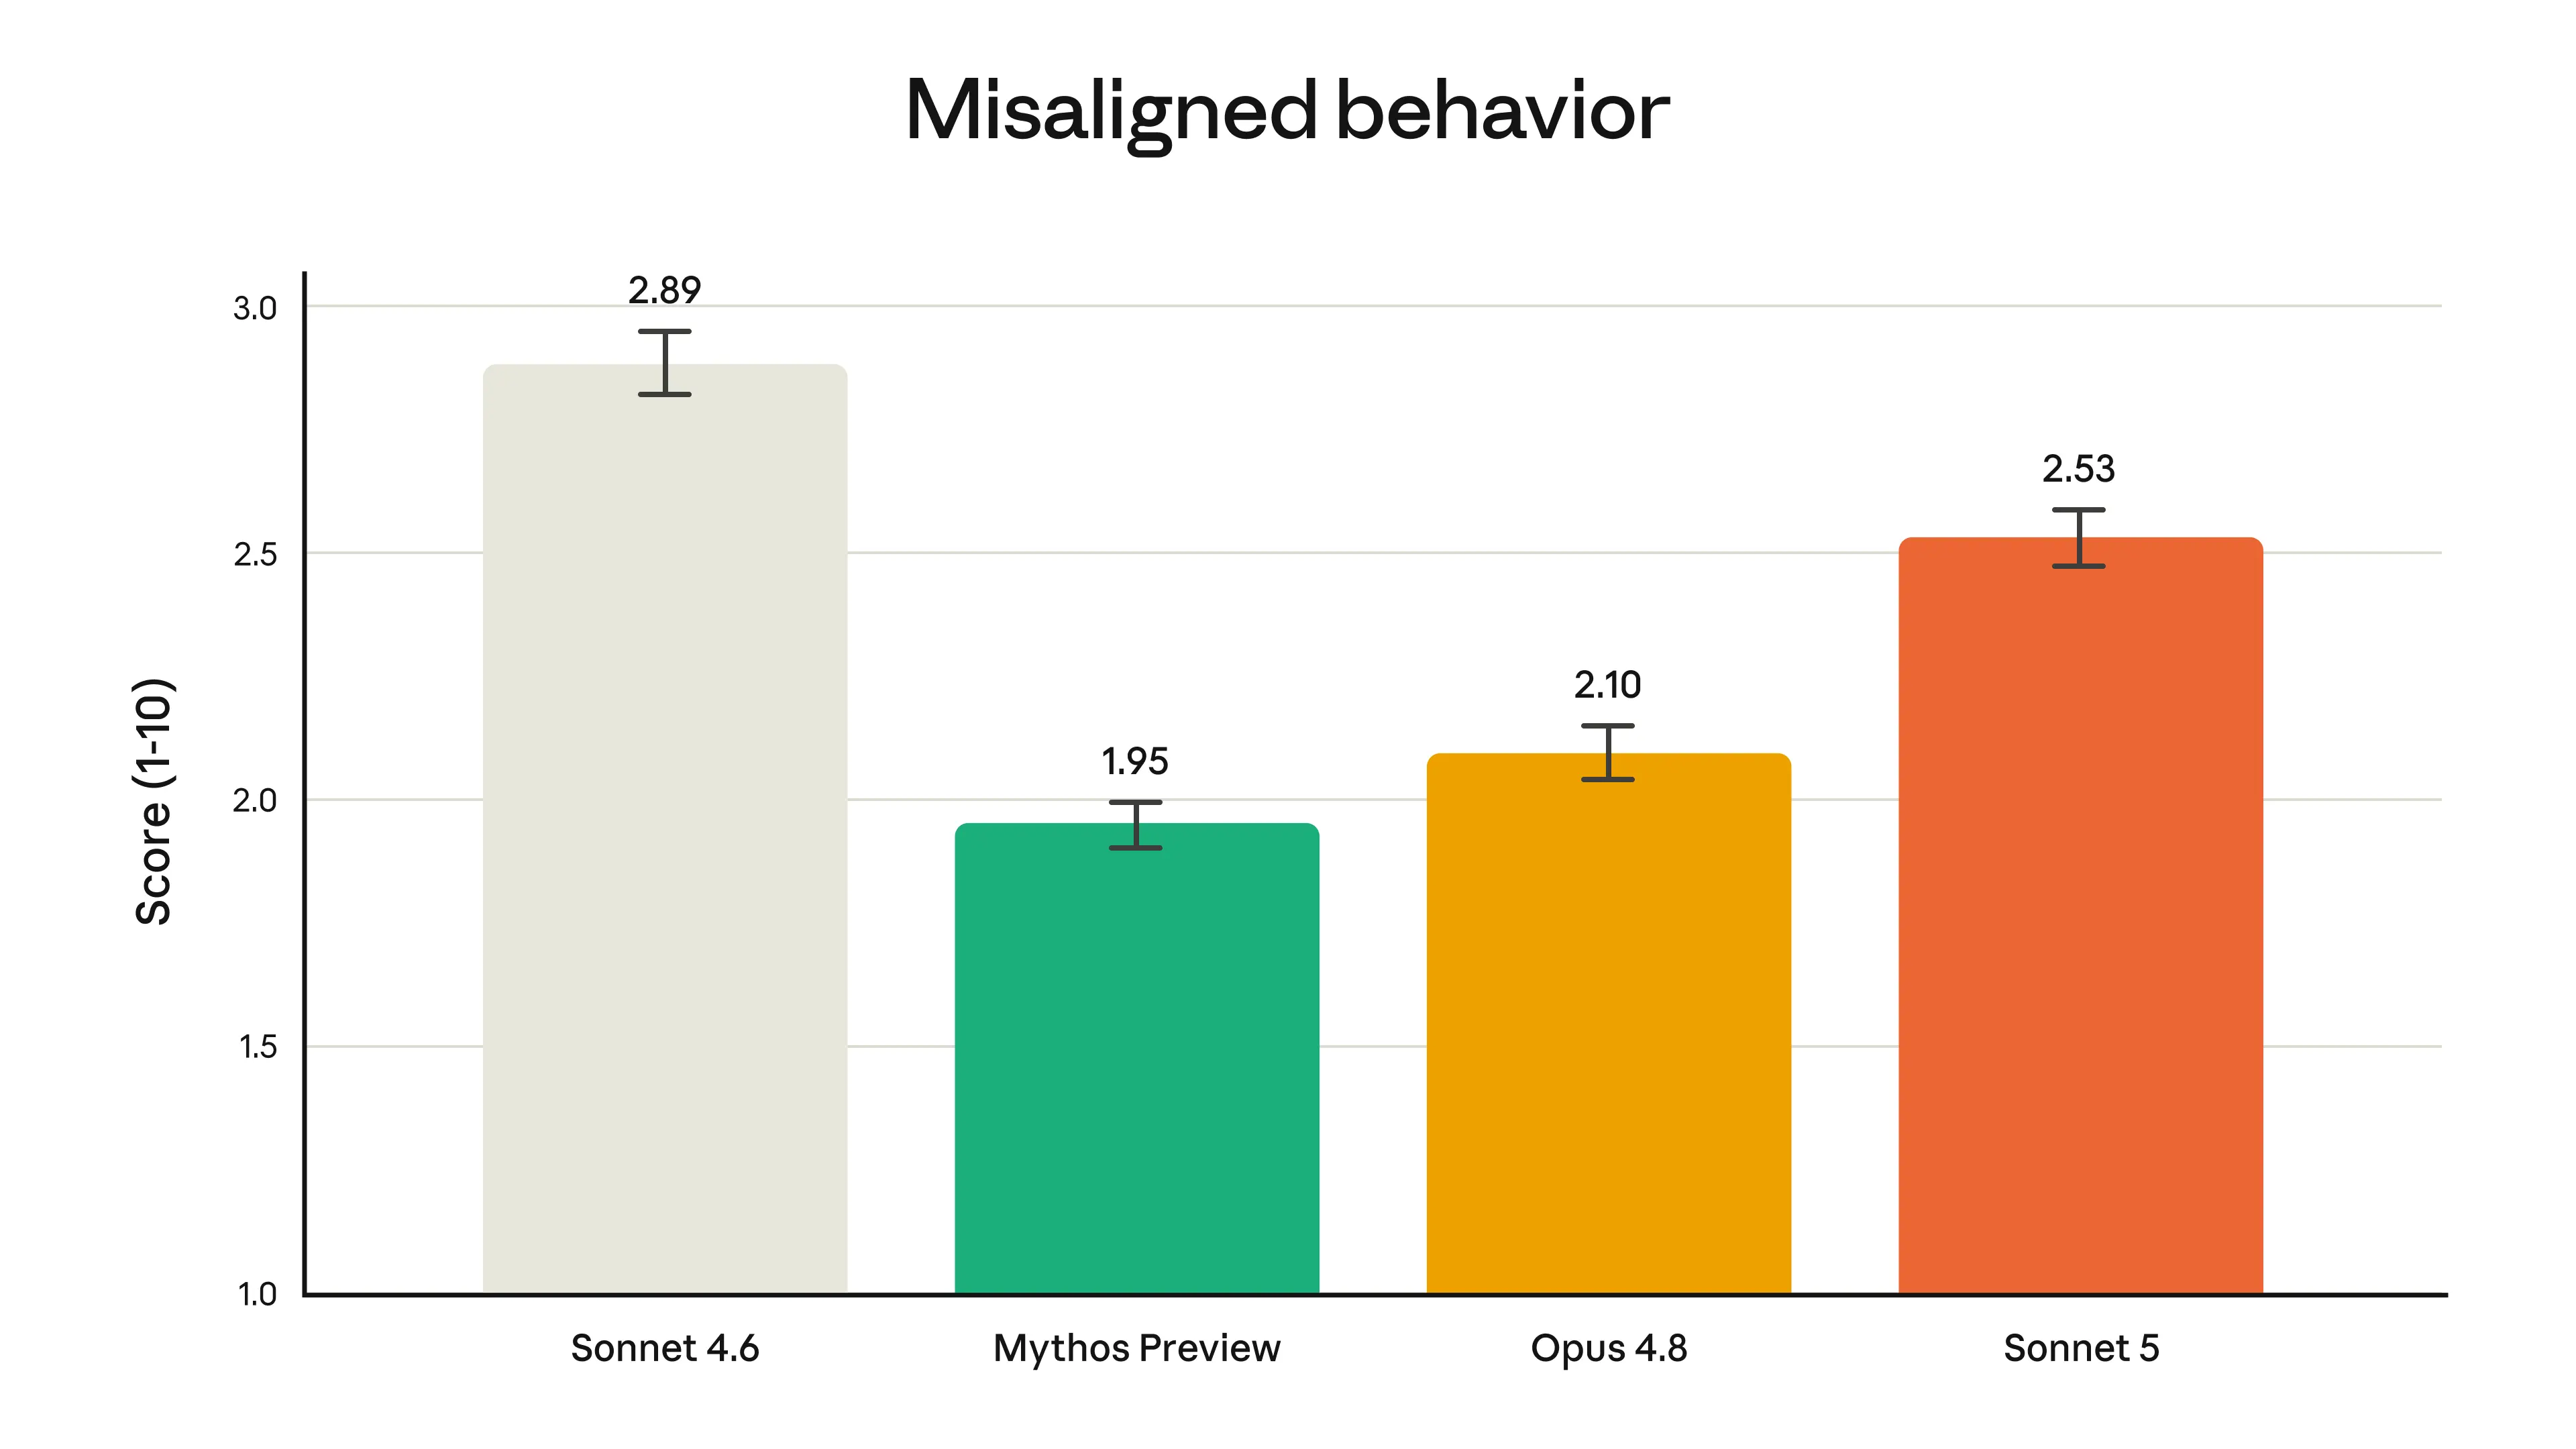
Le modèle présente aussi des taux plus faibles d’hallucinations et de flagornerie que Sonnet 4.6, et obtient un score plus bas (donc plus sûr) à l’audit comportemental automatisé d’Anthropic couvrant des comportements non alignés comme la coopération à un mésusage ou la tromperie. Un cofondateur de Lovable a résumé la valeur ainsi : un modèle qui sait dire non est aussi important qu’un modèle qui sait construire.
La réserve, c’est que Sonnet 5 affiche encore des taux de comportements non alignés plus élevés que l’Opus 4.8, plus performant, et que l’aperçu de Claude Mythos. Il est donc plus sûr que son prédécesseur, sans être le plus sûr de la gamme Anthropic.
Source : Anthropic
Sonnet 5 est livré avec des garde‑fous cyber en temps réel activés par défaut, les mêmes que dans Claude Opus 4.7 et 4.8. Ils détectent et bloquent les usages dangereux au moment où ils se produisent.
Sur les évaluations d’Anthropic, Sonnet 5 possède des « compétences cyber dangereuses » sensiblement plus faibles qu’Opus 4.8 et Mythos 5. Dans un test élaboré avec Mozilla pour développer des exploits de failles dans Firefox 147, ni Sonnet 5 ni Sonnet 4.6 n’ont produit d’exploit fonctionnel (tous deux à 0,0 %), même si Sonnet 5 a montré un taux de réussite partielle légèrement supérieur, qu’Anthropic attribue à des gains d’intelligence générale plutôt qu’à un entraînement cyber spécifique.
Pour les chercheurs en sécurité qui ont besoin de garde‑fous allégés, Anthropic recommande plutôt Opus 4.8. Les protections de Sonnet 5 sont moins strictes que celles livrées avec Fable 5, qui bloquait un éventail plus large de tâches de cybersécurité.
Le récit des benchmarks d’Anthropic pour Sonnet 5 est cohérent : c’est une amélioration nette par rapport à Sonnet 4.6 et il se place juste en dessous d’Opus 4.8 sur les évaluations publiées à ce jour. Les chiffres ci‑dessous proviennent des supports de lancement d’Anthropic. Note de prudence : des évaluateurs tiers ont rapporté des chiffres différents sur les mêmes benchmarks, probablement en raison de jeux de données, de contextes ou d’échafaudages d’agents distincts ; considérez donc les chiffres de tête d’affiche comme dépendants de la configuration.
| Sonnet 5 | Sonnet 4.6 | Opus 4.8 Pour référence |
|
|---|---|---|---|
| Codage agentique SWE‑bench Pro |
63,2 % | 58,1 % | 69,2 % |
| Codage agentique Terminal‑Bench 2.1 |
80,4 % | 67,0 % | 82,7 % |
| Raisonnement pluridisciplinaire Humanity’s Last Exam |
43,2 % sans outils 57,4 % avec outils |
34,6 % sans outils 46,8 % avec outils |
49,8 % sans outils 57,9 % avec outils |
| Utilisation de l’ordinateur OSWorld‑Verified |
81,2 % | 78,5 % | 83,4 % |
| Travail de connaissance GDPval‑AA v2 |
1618 | 1395 | 1615 |
Sur le benchmark de codage agentique publié par Anthropic, Sonnet 5 atteint 63,2 %, contre 69,2 % pour Opus 4.8 et 58,1 % pour Sonnet 4.6. Ce benchmark évalue la capacité d’un modèle à écrire, exécuter et corriger du code en plusieurs étapes, plutôt que de produire un simple extrait.
L’écart avec Opus 4.8 est d’environ 6 points, tandis que le gain par rapport à Sonnet 4.6 est d’environ 5 points. Pour les développeurs, Sonnet 5 représente donc une mise à niveau claire du milieu de gamme précédent, sans égaler totalement le vaisseau amiral.
Source : Anthropic
OSWorld‑Verified mesure la capacité à utiliser un ordinateur, en contrôlant un poste de travail pour accomplir des tâches réelles, et BrowseComp mesure la recherche web agentique. Anthropic a mis à jour sa méthodologie OSWorld‑Verified et rapporte désormais Sonnet 4.6 à 78,5 % dans la configuration révisée.
Sur les deux évaluations, Sonnet 5 améliore systématiquement Sonnet 4.6 à tous les niveaux d’effort, tandis qu’Opus 4.8 reste le choix le plus précis. Au niveau Extra High, Sonnet 5 atteint à peu près la performance moyenne‑à‑élevée d’Opus 4.8, mais à ce stade l’avantage de coût se réduit, d’où le positionnement d’Anthropic : deux modèles formant une même plage coût‑précision plutôt qu’une montée en gamme linéaire.
Sur un benchmark de travail de connaissance, Sonnet 5 surpasse légèrement Opus 4.8, d’après TechCrunch. C’est notable, car Opus 4.8 est généralement associé aux jugements les plus difficiles et à la recherche approfondie.
Anthropic a également mis à jour son barème pour Humanity’s Last Exam et rapporte maintenant Sonnet 4.6 à 34,6 % (sans outils) et 46,8 % (avec outils), ce qui explique la différence avec les chiffres du lancement initial de Sonnet 4.6. Pour les praticiens, ce résultat suggère que Sonnet 5 est pertinent pour des tâches d’analyse et de recherche qui semblaient auparavant réservées à Opus.
Pour situer plus largement la place de la gamme Sonnet, notre analyse Sakana Fugu vs Claude Fable 5 est éclairante. Dans cette comparaison, le modèle de gamme supérieure Claude Fable 5 a obtenu 80,3 % sur SWE‑Bench Pro et 59,0 % sur Humanity’s Last Exam (sans outils), bien au‑dessus des chiffres du milieu de gamme présentés ici.
C’est tout l’enjeu : la gamme Anthropic s’étend de Sonnet 5, agentique et économique, jusqu’à Opus 4.8 et aux classes Mythos et Fable, chaque palier échangeant coût contre précision sur les problèmes les plus ardus.
Claude Sonnet 5 est disponible partout dès son lancement. Il est le modèle par défaut des offres Free et Pro, et accessible aux utilisateurs Max, Team et Enterprise, ainsi que dans Claude Code et sur la Claude Platform.
Les développeurs peuvent l’appeler via l’API Claude avec l’identifiant de modèle claude-sonnet-5. La tarification se déroule en deux phases :
Un point budgétaire à anticiper : Sonnet 5 utilise un tokenizer mis à jour, si bien qu’une même entrée peut se découper en davantage de tokens qu’auparavant, de ~1,0 à 1,35 fois selon le type de contenu. Anthropic a fixé le tarif de lancement pour que la transition depuis Sonnet 4.6 soit globalement neutre en coût. L’entreprise a aussi relevé les limites de débit sur Chat, Cowork, Claude Code et la Claude Platform afin d’absorber l’usage de tokens plus élevé induit par les niveaux d’effort supérieurs.
Pour une comparaison rapide, voici comment les trois modèles se positionnent sur les chiffres publiés par Anthropic.
| Modèle | Codage agentique | OSWorld‑Verified | Prix entrée / sortie (par 1 M de tokens) |
|---|---|---|---|
| Sonnet 5 | 63,2 % | Améliore 4.6 à tous les niveaux d’effort | 2 $ / 10 $ (lancement), puis 3 $ / 15 $ |
| Sonnet 4.6 | 58,1 % | 78,5 % (révisé) | 3 $ / 15 $ |
| Opus 4.8 | 69,2 % | Choix le plus précis | 5 $ / 25 $ |
Sonnet 5 est, chez Anthropic, l’affirmation la plus nette que les capacités agentiques sont désormais une attente de base à tous les niveaux de prix, et non plus une exclusivité des modèles phares. La différence se joue moins sur « qui fait de l’agentique » que sur « qui le fait de façon économique et fiable, sans supervision humaine ».
Ce qui retient surtout l’attention, ce sont les tarifs de lancement. Anthropic semble vouloir que les clients testent Sonnet 5 sur des charges réelles au coût le plus bas pendant la fenêtre de migration, ce qui ressemble à un geste délibéré pour déplacer les usages routiniers d’Opus 4.8 et libérer sa capacité. C’est aussi plus agressif que les prix de GPT‑5.5 d’OpenAI et de Gemini 3.1 Pro de Google, même si Gemini 3.5 Flash reste moins cher.
Si vous construisez des agents qui exécutent des tâches soutenues et multi‑étapes, Sonnet 5 apparaît comme le nouveau choix par défaut, avec montée vers Opus 4.8 uniquement lorsque la tâche requiert réellement un surcroît de précision. Signalons honnêtement que certains évaluateurs tiers estiment que Sonnet 5 échange un peu de profondeur de raisonnement contre de la vitesse en codage ; pour des travaux scientifiques de niveau doctorat ou très centrés sur la navigation web, Opus 4.8 peut rester l’option la plus sûre.
Pour mettre en pratique l’automatisation pour laquelle Sonnet 5 a été pensé, nous vous recommandons notre tutoriel Claude Code Routines, qui explique comment faire tourner un agent de codage sur un planning dans le cloud.
Les meilleurs cours DataCamp
Cours
Cours
Cours
blog
Kurtis Pykes
15 min
blog
blog
Lynn Heidmann
blog
Zoumana Keita
15 min
Tutoriel
Tutoriel
Samuel Shaibu
9 min