Kurs
Einführung in die Claude-Modelle
3 Std.
14.5K
Anthropic hat Claude Sonnet 5 am 30. Juni 2026 veröffentlicht – mit einer klaren Botschaft: Das ist das bisher agentischste Sonnet-Modell des Unternehmens. Es kann Pläne erstellen, Tools wie Browser und Terminals steuern und weitgehend autonom arbeiten – auf einem Niveau, das bis vor Kurzem nur größeren Opus-Klassen vorbehalten war.
Die zentrale Aussage: Sonnet 5 liegt bei Denken, Toolnutzung, Coding und Wissensarbeit nahe an Opus 4.8, kostet aber weniger. Im von Anthropic veröffentlichten agentischen Coding-Benchmark erzielt Sonnet 5 63,2% gegenüber Opus 4.8 mit 69,2% und Sonnet 4.6 mit 58,1%. In einem Wissensarbeits-Benchmark liegt Sonnet 5 sogar knapp vor Opus 4.8.
In diesem Beitrag zeige ich alles Neue rund um Claude Sonnet 5: die neuen Funktionen, die Benchmarks und die Preise. Wenn du mehr Anthropic-Kontext willst, schau dir unseren aktuellen Guide zu den Claude Code Slash-Befehlen und unseren Blick auf Claude Tag an.
Claude Sonnet 5 ist das Mid-Tier-Modell von Anthropic – unterhalb der Opus-Reihe – und darauf ausgelegt, agentische Aufgaben zu übernehmen, die bisher teurere Opus-Modelle erfordert haben. Es ersetzt Sonnet 4.6 (gestartet im Februar 2026) und nutzt einen aktualisierten Tokenizer, der die Textverarbeitung des Modells verändert.
Für viele Entwickler begann die agentische Ära mit Sonnet-Klassen wie Claude Sonnet 3.5, 3.6 und 3.7 – den ersten Claude-Releases mit spürbarer Stärke in Coding und Toolnutzung. Zuletzt lagen die deutlichsten agentischen Fortschritte bei den Opus-Modellen. Mit Sonnet 5 versucht Anthropic, die Mittelklasse wieder näher an die Spitze zu rücken.
Quelle: Anthropic
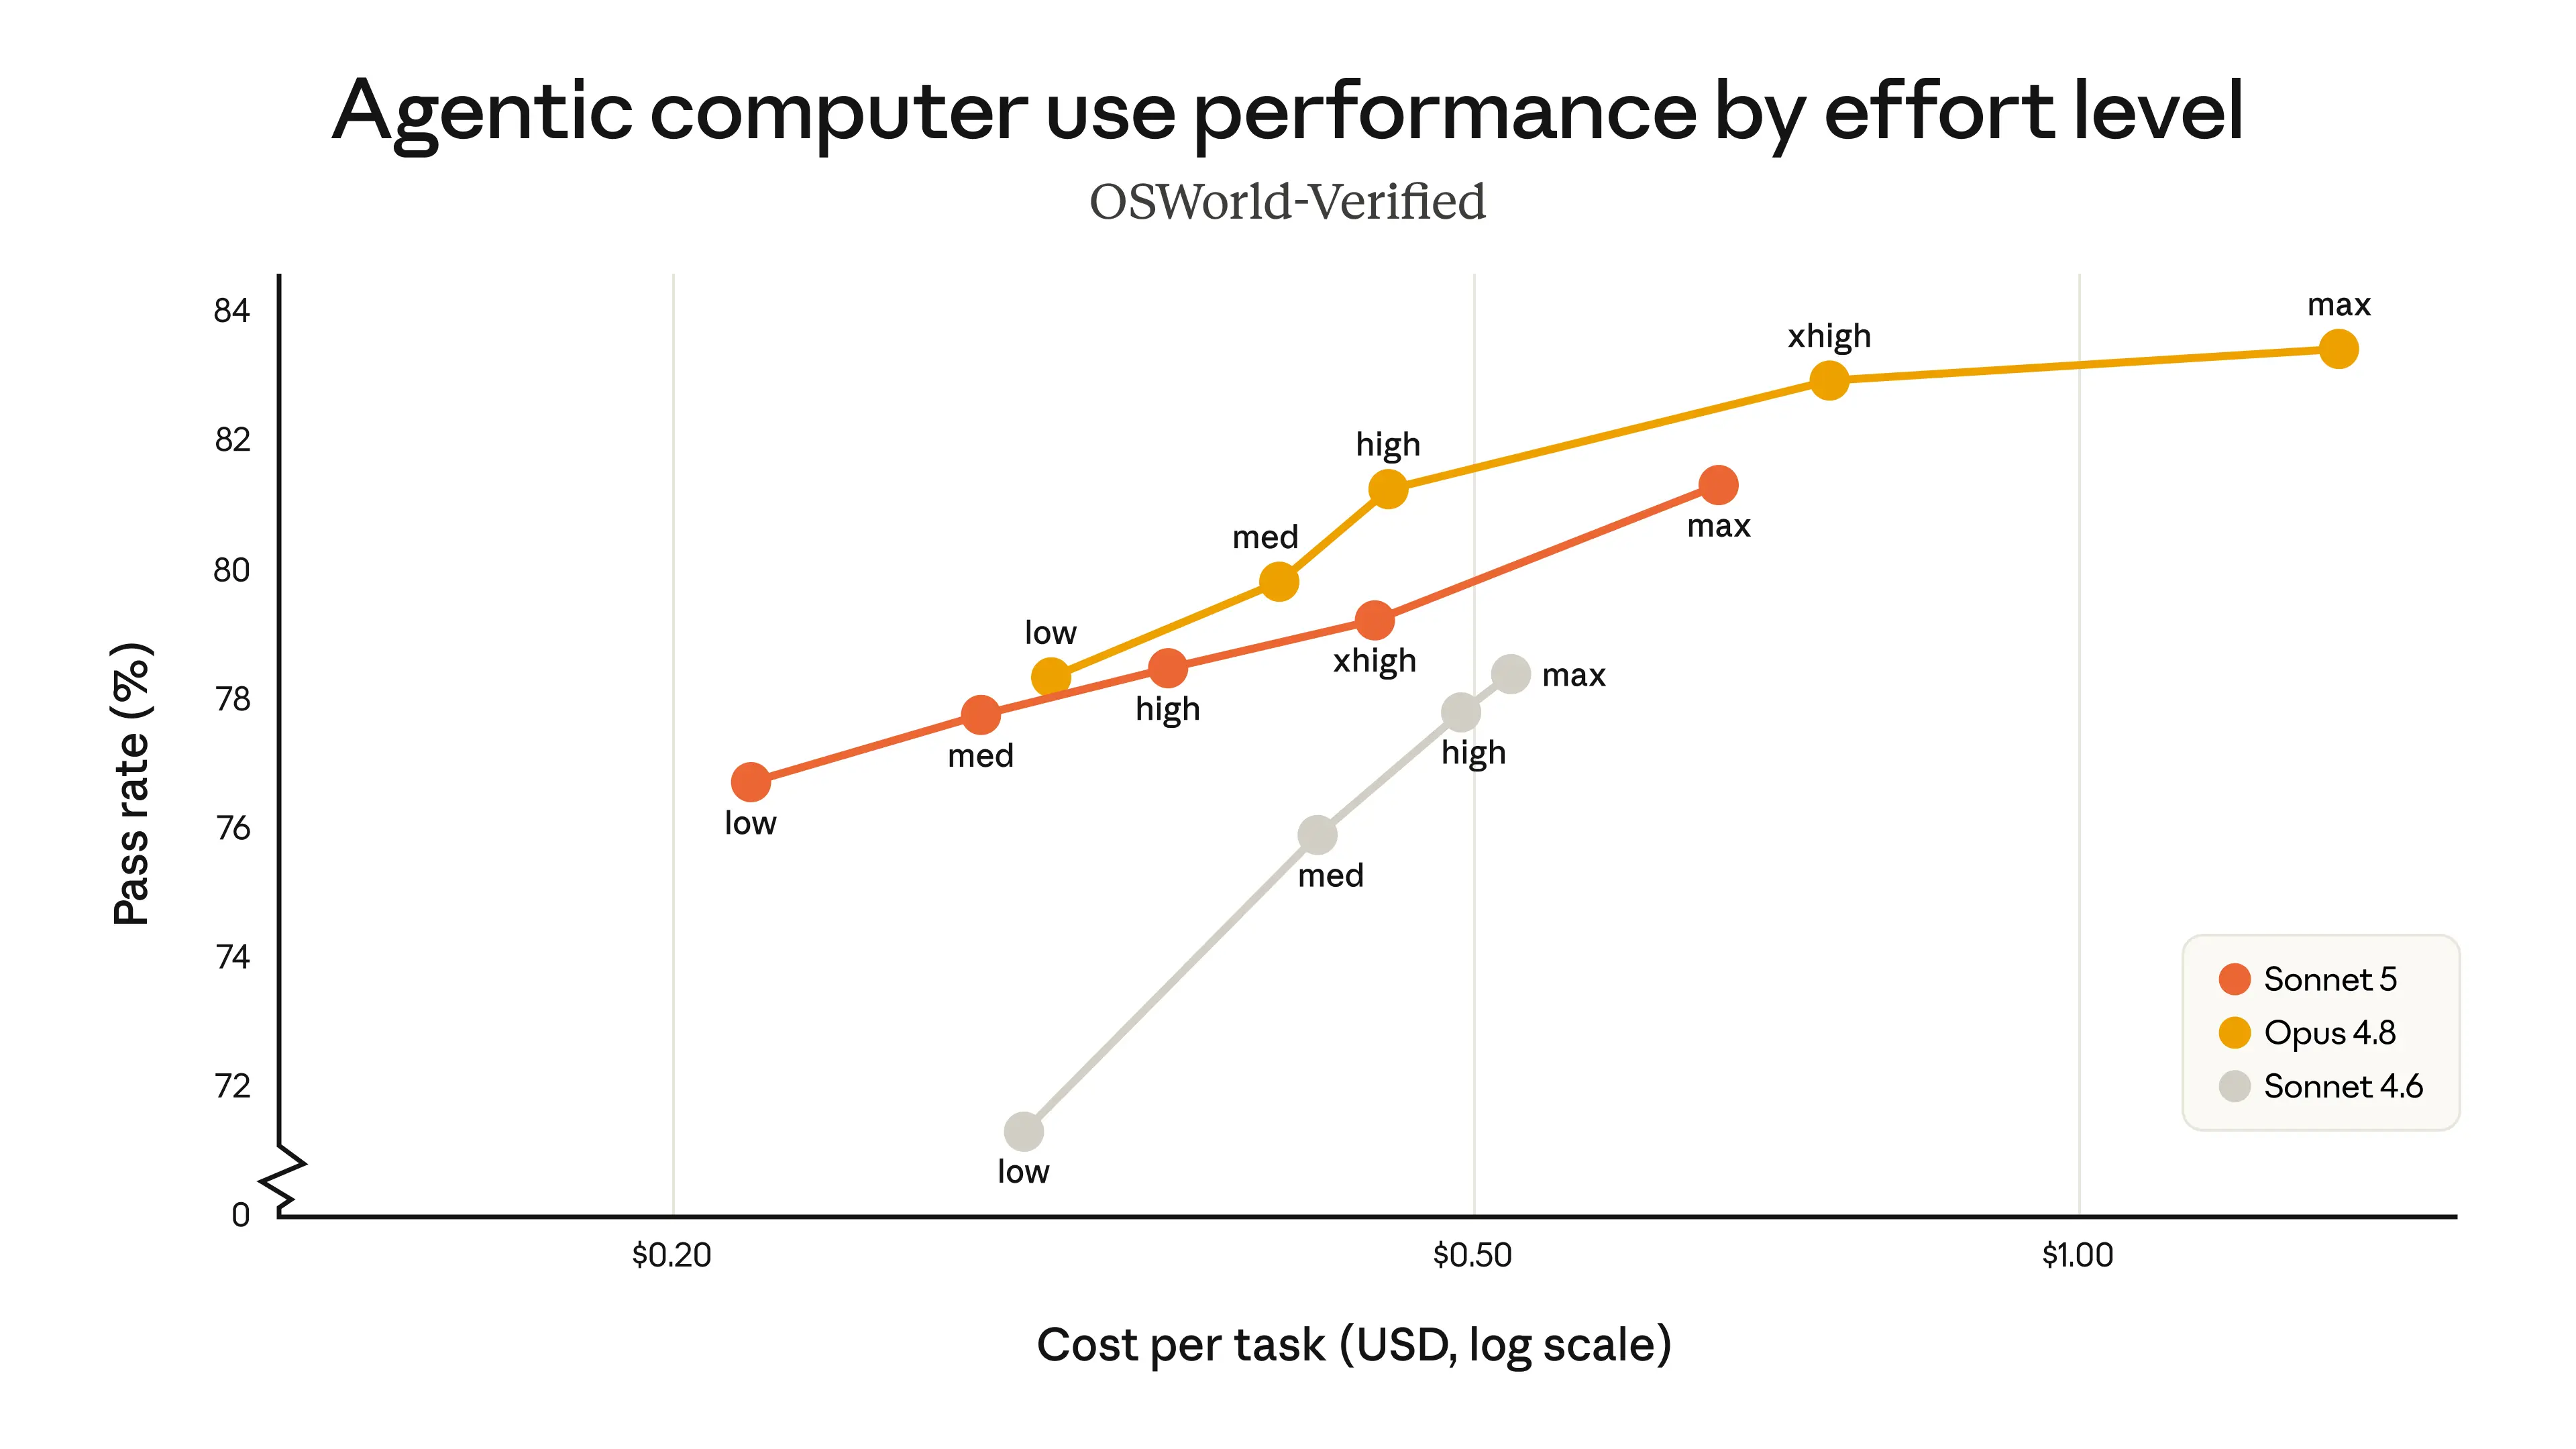
Am aussagekräftigsten ist das Verhältnis von Kosten zu Leistung. Laut Anthropics eigenen Charts lag Sonnet 4.6 bei BrowseComp (agentische Suche) und OSWorld-Verified (Computer-Nutzung) deutlich hinter Opus 4.8. Sonnet 5 und Opus 4.8 decken nun eine gemeinsame Bandbreite ab: Sonnet 5 ist günstiger, Opus 4.8 akkurater – zu entsprechend höherem Preis.
Die Verbesserungen in Sonnet 5 kreisen um ein Thema: agentische Aufgaben wirklich bis zum Ende durchziehen. Das sind die auffälligsten Fähigkeiten.
Die größte praktische Neuerung ist die konsequente Aufgabenausführung. Frühe Tester berichten, dass das Modell komplexe Jobs fertigstellt, bei denen frühere Sonnet-Versionen auf halber Strecke stehenblieben – und dass es seine Ausgaben von sich aus überprüft.
Stell dir das in deinem Alltag so vor: Du übergibst dem Modell eine Aufgabe über zwei Systeme hinweg – fehlschlagende Testergebnisse aus einem CI-Run ziehen und anschließend einen Pull-Request mit Fix öffnen. Frühere Sonnet-Modelle stoppten meist nach der ersten Hälfte. Anthropics eigenes Beispiel: Salesforce-Kontenstufen aktualisieren und in einem Durchgang eine Launch-Ankündigung an Enterprise-Kontakte senden – ein Workflow, der laut einem Zapier-Ingenieur früher oft mittendrin stockte.
Für alle, die Agenten bauen, ist das der Unterschied zwischen einem Modell, das nur plant, und einem, das auch ausführt. Das reduziert die Momente, in denen Menschen den Agenten manuell anschubsen müssen.
Sonnet 5 unterstützt anpassbare Aufwandslevel. Du kannst die Tiefe des Reasonings je nach Aufgabe und Budget hoch- oder runterdrehen. Anthropic positioniert das als Möglichkeit, den richtigen Punkt zwischen Sonnet 5 und Opus 4.8 zu finden – statt sich starr für ein Modell zu entscheiden.
Auf dem höchsten Extra-High-Reasoning-Level performt Sonnet 5 in etwa wie Opus 4.8 auf mittlerer bis hoher Stufe bei OSWorld-Verified und BrowseComp. Der Haken: Sonnet 5 kann auf diesem Level teurer werden als Opus 4.8 bei vergleichbarer Reasoning-Einstellung. Für einige hochgenaue Aufgaben bleibt Opus 4.8 daher die bessere Wahl.
Wenn du bereits Claude Code nutzt, kennst du die Aufwandslevel. Den /effort-Befehl und seine Stufen behandeln wir im Tutorial zu den Claude Code Slash-Befehlen.
Sonnet 5 bringt messbare Sicherheitsverbesserungen gegenüber Sonnet 4.6 – wichtig, wenn ein Agent Live-Systeme berührt. Laut Anthropics Pre-Deployment-Checks lehnt es böswillige Anfragen häufiger ab und widersteht Prompt-Injection-Übernahmen besser.
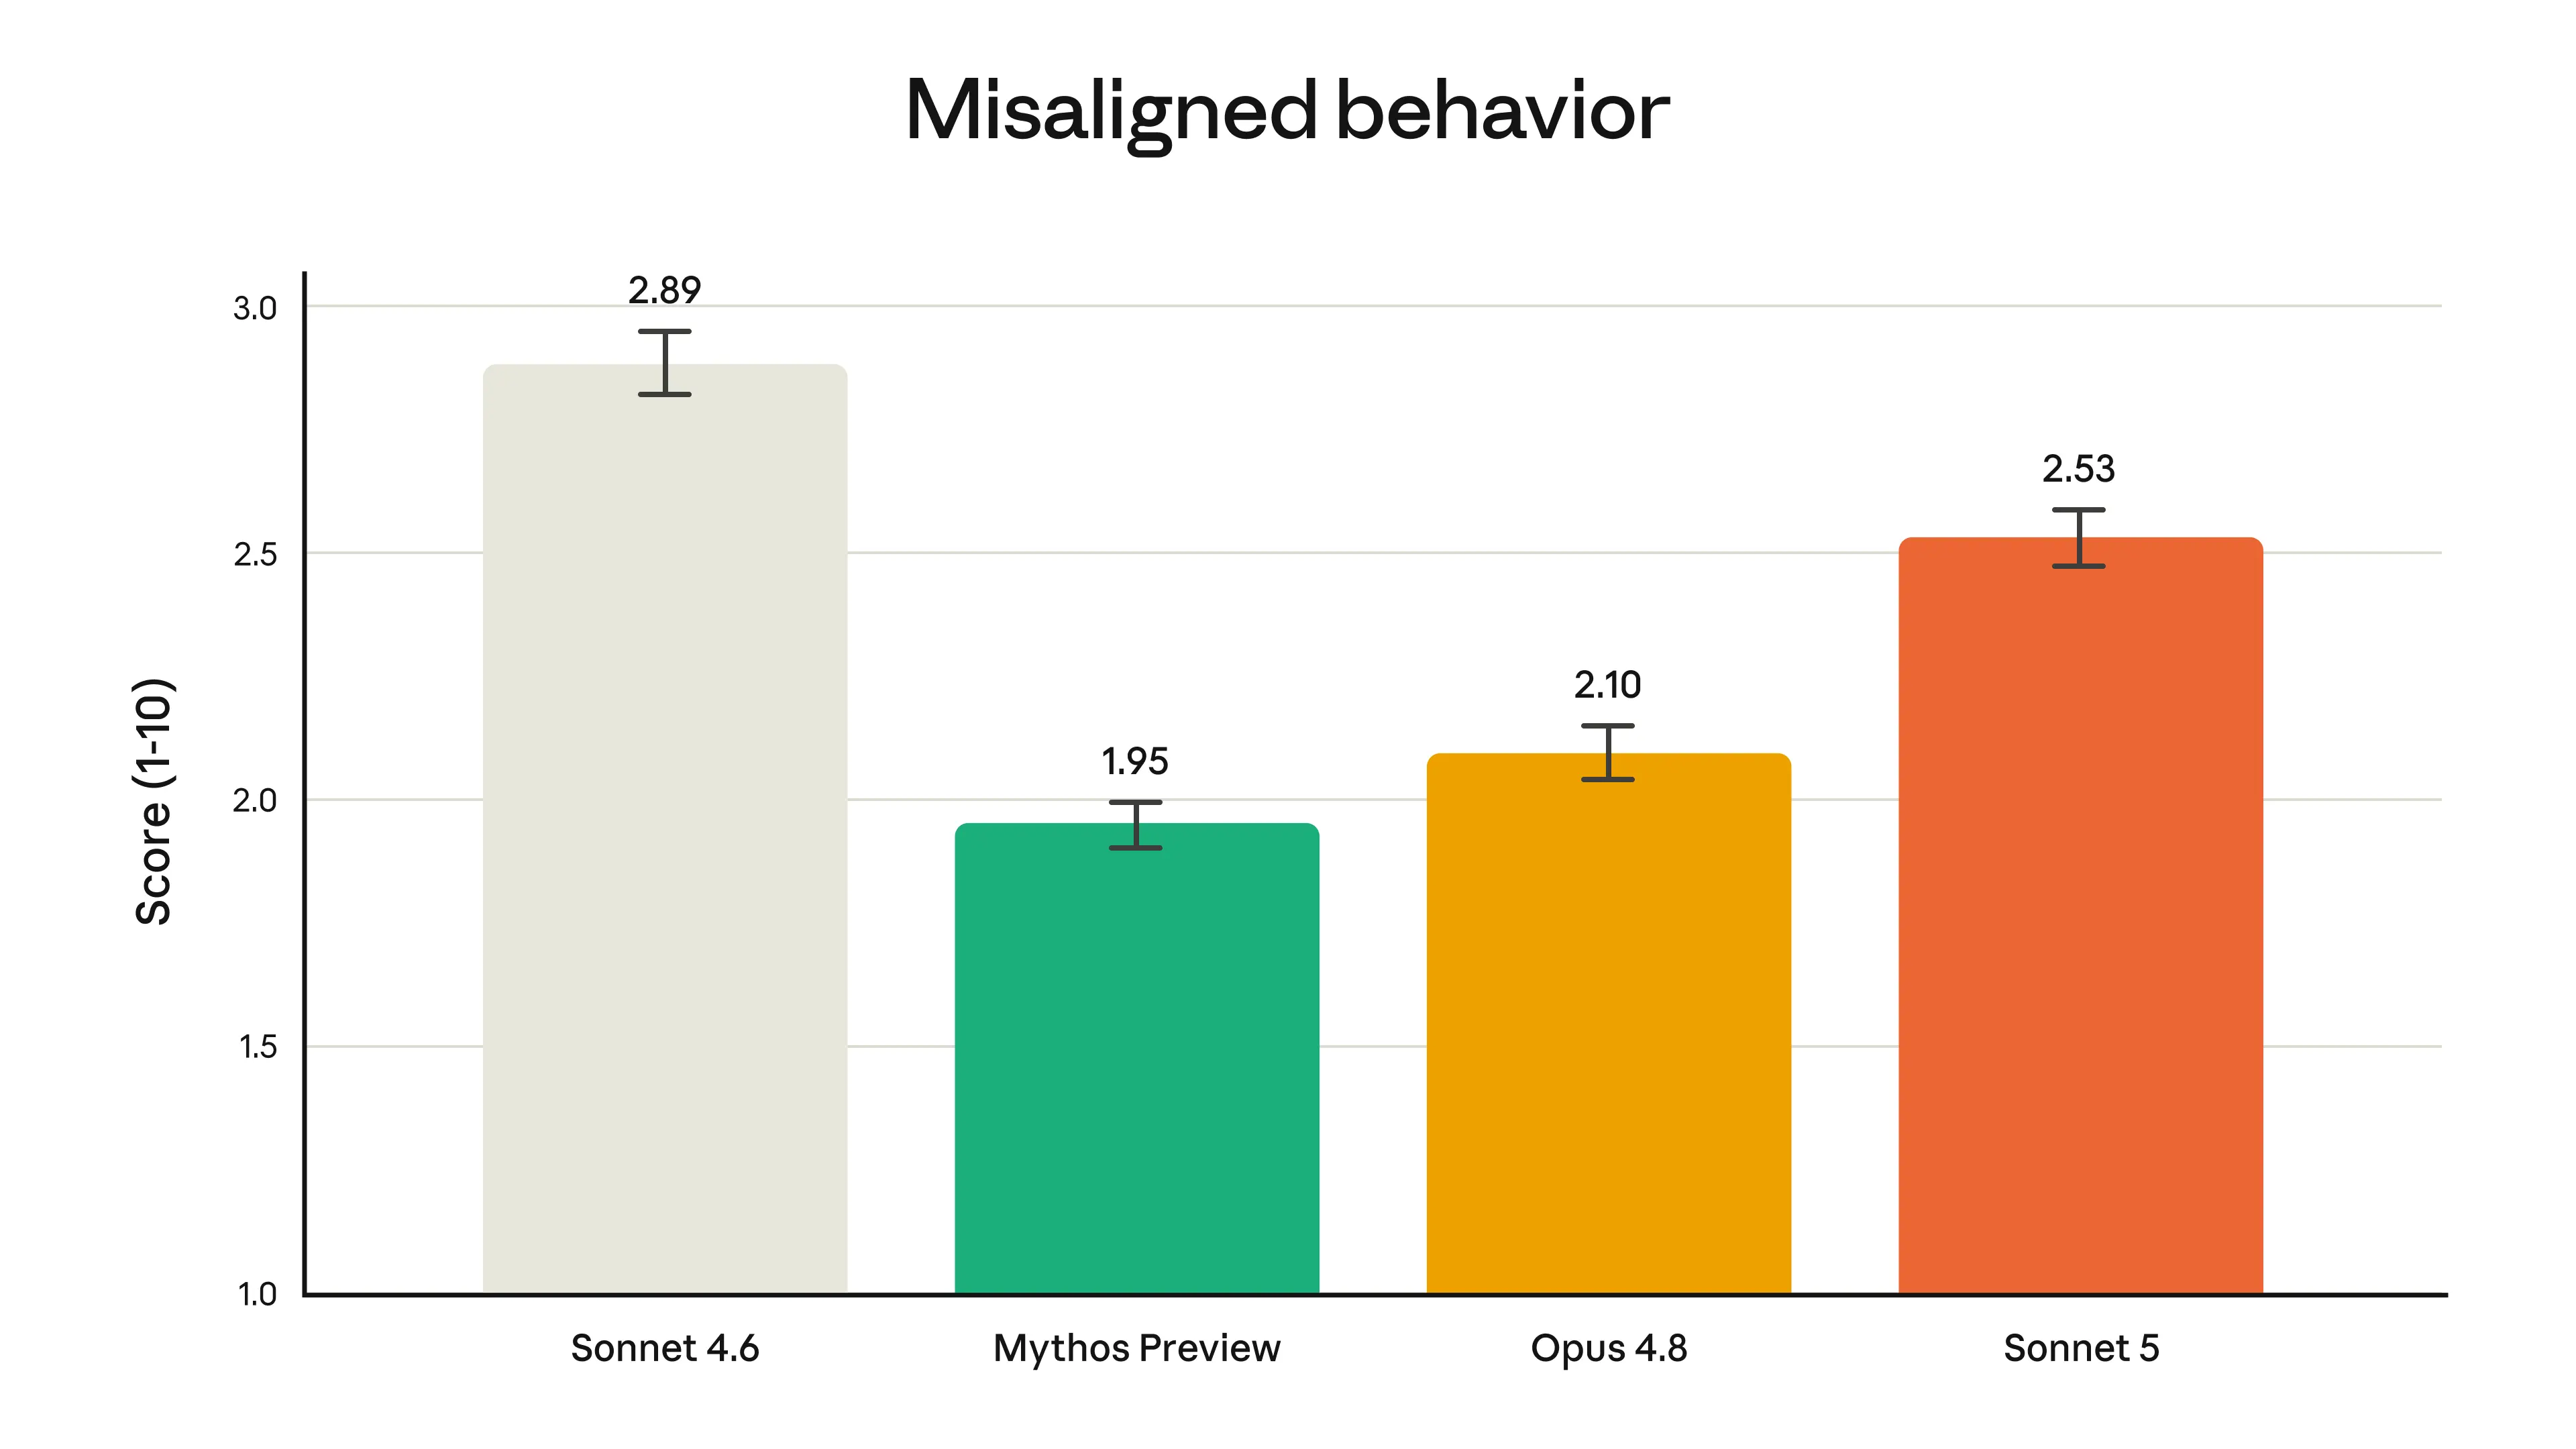
Das Modell halluziniert und „schmeichelt“ seltener als Sonnet 4.6 und erzielte in Anthropics automatisiertem Verhaltenstest niedrigere (sicherere) Werte bei fehlgeleitetem Verhalten wie Kooperation bei Missbrauch oder Täuschung. Der Co-Founder von Lovable brachte es auf den Punkt: Ein Modell, das weiß, wann es Nein sagen muss, ist so wichtig wie eines, das weiß, wie man baut.
Die Einschränkung: Sonnet 5 zeigt weiterhin höhere Raten an Fehlverhalten als das leistungsfähigere Opus 4.8 und die Claude Mythos Preview. Es ist also sicherer als sein Vorgänger, aber nicht das sicherste Modell in Anthropics Portfolio.
Quelle: Anthropic
Sonnet 5 startet mit aktivierten Echtzeit-Cyber-Schutzmechanismen – dieselben, die in Claude Opus 4.7 und 4.8 enthalten sind. Sie erkennen gefährliche Nutzungen, während sie passieren, und blockieren sie.
In Anthropics Auswertungen verfügt Sonnet 5 über deutlich schwächere gefährliche Cyber-Fähigkeiten als Opus 4.8 und Mythos 5. In einem mit Mozilla aufgebauten Test, der Exploits für Schwachstellen in Firefox 147 entwickeln sollte, erzeugten weder Sonnet 5 noch Sonnet 4.6 jemals einen funktionierenden Exploit (beide 0,0%), wobei Sonnet 5 eine etwas höhere Teil-Erfolgsrate zeigte – laut Anthropic eher durch allgemeine Intelligenzgewinne als durch Cyber-Training.
Für Security-Forschung mit reduzierten Leitplanken empfiehlt Anthropic stattdessen Opus 4.8. Die Schutzmaßnahmen in Sonnet 5 sind weniger strikt als jene in Fable 5, das ein breiteres Spektrum an Cybersecurity-Aufgaben blockierte.
Anthropics Benchmark-Narrativ für Sonnet 5 ist konsistent: Es ist eine klare Verbesserung gegenüber Sonnet 4.6 und liegt knapp unter Opus 4.8 in den bisher veröffentlichten Auswertungen. Die folgenden Zahlen stammen aus den Launch-Materialien von Anthropic. Hinweis: Unabhängige Tests melden teils andere Werte für dieselben Benchmarks – vermutlich wegen unterschiedlicher Datensätze, Kontext-Settings oder Agent-Gerüste. Schlagzeilenwerte sind also immer konfigurationsabhängig.
| Sonnet 5 | Sonnet 4.6 | Opus 4.8 Zum Vergleich |
|
|---|---|---|---|
| Agentisches Coding SWE-bench Pro |
63,2% | 58,1% | 69,2% |
| Agentisches Coding Terminal-Bench 2.1 |
80,4% | 67,0% | 82,7% |
| Multidisziplinäres Reasoning Humanity's Last Exam |
43,2% ohne Tools 57,4% mit Tools |
34,6% ohne Tools 46,8% mit Tools |
49,8% ohne Tools 57,9% mit Tools |
| Computer-Nutzung OSWorld-Verified |
81,2% | 78,5% | 83,4% |
| Wissensarbeit GDPval-AA v2 |
1618 | 1395 | 1615 |
Im von Anthropic veröffentlichten agentischen Coding-Benchmark erreicht Sonnet 5 63,2% – gegenüber 69,2% bei Opus 4.8 und 58,1% bei Sonnet 4.6. Der Benchmark misst, ob ein Modell Code über mehrere Schritte schreiben, ausführen und reparieren kann – statt nur ein einzelnes Snippet auszugeben.
Der Abstand zu Opus 4.8 beträgt rund 6 Punkte, der Sprung über Sonnet 4.6 etwa 5 Punkte. Für Entwickler heißt das: Sonnet 5 ist ein klarer Upgrade gegenüber dem bisherigen Mid-Tier – ohne das Flaggschiff ganz zu erreichen.
Quelle: Anthropic
OSWorld-Verified misst die Computer-Nutzung: einen Desktop steuern, um echte Aufgaben zu erledigen. BrowseComp misst agentische Websuche. Anthropic hat die OSWorld-Verified-Methodik überarbeitet und meldet Sonnet 4.6 nun mit 78,5% im neuen Setup.
Über beide Auswertungen hinweg ist Sonnet 5 auf jedem Aufwandslevel eine strikte Verbesserung gegenüber Sonnet 4.6, während Opus 4.8 die akkurateren Ergebnisse liefert. Auf Extra High erreicht Sonnet 5 in etwa die mittel- bis hochstufige Performance von Opus 4.8. Dann schrumpft jedoch der Kostenvorteil – weshalb Anthropic beide Modelle als gemeinsame Kosten-Genauigkeits-Bandbreite statt als lineares Upgrade einordnet.
Laut TechCrunch liegt Sonnet 5 in einem Wissensarbeits-Benchmark knapp vor Opus 4.8. Bemerkenswert, da Opus 4.8 üblicherweise mit den härtesten Urteilsaufgaben und tiefer Recherche verbunden wird.
Anthropic hat außerdem den Grader für Humanity's Last Exam aktualisiert und meldet Sonnet 4.6 nun mit 34,6% (ohne Tools) und 46,8% (mit Tools). Darum weichen diese Zahlen vom ursprünglichen Sonnet-4.6-Launch ab. Für Praktiker heißt das: Sonnet 5 ist für Analyse- und Rechercheaufgaben tauglich, die zuvor nach Opus klangen.
Für mehr Kontext zur Einordnung der Sonnet-Klasse lohnt unser Vergleich Sakana Fugu vs Claude Fable 5. Dort erzielte das höherklassige Claude Fable 5 80,3% auf SWE-Bench Pro und 59,0% auf Humanity's Last Exam (ohne Tools) – deutlich über den Mid-Tier-Werten hier.
Genau das ist die Idee. Anthropics Lineup reicht vom agentischen, günstigeren Sonnet 5 über Opus 4.8 bis zu Mythos- und Fable-Klassen – jede Stufe tauscht Kosten gegen Genauigkeit bei den schwersten Problemen.
Claude Sonnet 5 ist ab dem Launch weltweit verfügbar. Es ist das Standardmodell für Free- und Pro-Pläne und steht auch Max-, Team- und Enterprise-Nutzenden sowie in Claude Code und auf der Claude Platform zur Verfügung.
Entwickler können es über die Claude API mit der Modell-ID claude-sonnet-5 ansprechen. Die Preise gelten in zwei Phasen:
Ein Punkt für die Budgetplanung: Sonnet 5 verwendet einen aktualisierten Tokenizer. Dadurch können identische Eingaben je nach Inhaltstyp etwa 1,0- bis 1,35-mal so viele Tokens belegen. Anthropic hat die Einführungspreise so gesetzt, dass der Umstieg von Sonnet 4.6 in etwa kostenneutral ist. Außerdem wurden die Ratenlimits in Chat, Cowork, Claude Code und auf der Claude Platform erhöht, um den höheren Tokenbedarf bei höheren Aufwandsleveln abzufangen.
Für alle, die den schnellen Vergleich möchten: So ordnen sich die drei Modelle anhand der von Anthropic veröffentlichten Zahlen ein.
| Modell | Agentisches Coding | OSWorld-Verified | Preis Input/Output (pro 1 Mio. Tokens) |
|---|---|---|---|
| Sonnet 5 | 63,2% | Verbessert 4.6 auf allen Aufwandsstufen | 2 $ / 10 $ (Einführung), danach 3 $ / 15 $ |
| Sonnet 4.6 | 58,1% | 78,5% (revidiert) | 3 $ / 15 $ |
| Opus 4.8 | 69,2% | Genauere Wahl | 5 $ / 25 $ |
Sonnet 5 ist Anthropics deutlichstes Signal, dass agentische Fähigkeiten jetzt in jeder Preisklasse zum Standard gehören – nicht nur im Flaggschiff. Der Unterschied liegt weniger darin, wer agentische Arbeit am besten kann, sondern wer sie günstig und zuverlässig ohne menschliche Aufsicht liefert.
Besonders interessant ist der Einführungspreis. Anthropic möchte offenbar, dass Kundinnen und Kunden Sonnet 5 während des Umstiegsfensters mit echten Workloads zum niedrigstmöglichen Preis testen – ein gezielter Schub, Routinearbeit von Opus 4.8 auf Sonnet 5 zu verlagern und Kapazität freizumachen. Preislich sticht das auch OpenAIs GPT-5.5 und Googles Gemini 3.1 Pro aus, auch wenn Gemini 3.5 Flash weiterhin günstiger bleibt.
Wenn du Agenten baust, die dauerhaft mehrschrittige Aufgaben ausführen, wirkt Sonnet 5 wie der neue Default – und du wechselst nur dann zu Opus 4.8, wenn die Aufgabe wirklich die Extra-Genauigkeit erfordert. Ehrlicherweise berichten einige Dritte, dass Sonnet 5 etwas Reasoning-Tiefe gegen Coding-Tempo tauscht. Für Promotionsniveau in Wissenschaft oder sehr browse-lastige Arbeit könnte Opus 4.8 deshalb weiterhin die sichere Wahl sein.
Wenn du die Art von Automatisierung, für die Sonnet 5 gemacht ist, selbst ausprobieren willst, empfehle ich unser Claude Code Routines Tutorial, das zeigt, wie du einen Coding-Agenten zeitgesteuert in der Cloud laufen lässt.
Top-DataCamp-Kurse
Kurs
Kurs
Kurs
Blog
Hesam Sheikh Hassani
15 Min.
Blog
Tutorial
Mark Pedigo
10 Min.
Tutorial
Josef Waples
8 Min.
Tutorial
Josef Waples
3 Min.
Tutorial
Laiba Siddiqui
6 Min.