Curso
Introducción a los modelos Claude
3 h
14.5K
Anthropic lanzó Claude Sonnet 5 el 30 de junio de 2026 con un mensaje claro: es el modelo Sonnet más "agentic" que ha publicado. Puede planificar, manejar herramientas como navegadores y terminales, y funcionar de forma autónoma a un nivel que, hasta hace poco, solo alcanzaban los modelos Opus de mayor tamaño.
La gran afirmación es que Sonnet 5 rinde casi como Opus 4.8 en razonamiento, uso de herramientas, programación y trabajo de conocimiento, pero a menor precio. En el benchmark de programación agentic publicado por Anthropic, Sonnet 5 obtiene un 63,2% frente al 69,2% de Opus 4.8 y al 58,1% de Sonnet 4.6. En un benchmark de trabajo de conocimiento, Sonnet 5 incluso supera ligeramente a Opus 4.8.
En este artículo, repaso todas las novedades de Claude Sonnet 5: sus funciones, los benchmarks y cuánto cuesta. Si quieres más contexto de Anthropic, echa un vistazo a nuestra guía reciente sobre los comandos slash de Claude Code y a nuestro análisis de Claude Tag.
Claude Sonnet 5 es el modelo de gama media de Anthropic, por debajo de la línea Opus y diseñado para asumir trabajo agentic que antes requería los modelos Opus, más caros. Sustituye a Sonnet 4.6, lanzado en febrero de 2026, y utiliza un tokenizador actualizado que cambia cómo procesa el texto.
Para muchos desarrolladores, la era agentic empezó con modelos de la clase Sonnet como Claude Sonnet 3.5, 3.6 y 3.7, los primeros lanzamientos de Claude que mostraron verdadera soltura en programación y uso de herramientas. Más recientemente, las mayores mejoras agentic se habían desplazado a los modelos de la clase Opus, y Sonnet 5 es el intento de Anthropic de volver a elevar la gama media hacia la frontera.
Fuente: Anthropic
La cifra más reveladora es la relación coste-rendimiento. Los propios gráficos de Anthropic muestran que Sonnet 4.6 quedaba muy por debajo de Opus 4.8 en las evaluaciones agentic BrowseComp (búsqueda) y OSWorld-Verified (uso de ordenador). Ahora Sonnet 5 y Opus 4.8 cubren un mismo rango: Sonnet 5 ofrece menor coste y Opus 4.8 mayor precisión a un precio más alto.
Las mejoras de Sonnet 5 giran en torno a un tema: terminar tareas agentic de principio a fin sin quedarse a medias. Estas son las capacidades que más destacan.
El mayor cambio práctico de Sonnet 5 es la continuidad en la ejecución. Los testers de acceso anticipado de Anthropic informaron de que el modelo completa tareas complejas donde versiones anteriores de Sonnet se quedaban a medio camino, y que verifica su propia salida sin que se lo pidas.
Para imaginarlo en tu trabajo, piensa en encargarle una tarea que abarque dos sistemas: extraer resultados de tests fallidos de una ejecución de CI y luego abrir un pull request con la corrección. Los Sonnet anteriores tendían a parar tras la primera mitad. El ejemplo de Anthropic incluía actualizar niveles de cuentas en Salesforce y enviar un anuncio de lanzamiento a contactos enterprise en una sola pasada, un flujo que, según un ingeniero de Zapier, antes se atascaba a mitad.
Para quienes construyen agentes, esta es la diferencia entre un modelo que redacta un plan y otro que lo ejecuta. Reduce las veces que una persona tiene que intervenir para empujar al agente.
Sonnet 5 admite niveles de esfuerzo ajustables, de modo que puedes subir o bajar la profundidad de razonamiento según la tarea y el presupuesto. Anthropic lo plantea como una forma de encontrar el punto justo entre Sonnet 5 y Opus 4.8 en lugar de elegir un único modelo y ceñirte a él.
En su nivel máximo de razonamiento Extra High, Sonnet 5 rinde aproximadamente como el ajuste medio-alto de Opus 4.8 en OSWorld-Verified y BrowseComp. El matiz es que ejecutar Sonnet 5 a ese nivel puede costar más que Opus 4.8 a un ajuste comparable, así que Opus 4.8 sigue siendo la mejor opción para algunas tareas que exigen máxima precisión.
Si ya utilizas Claude Code, los niveles de esfuerzo te resultarán familiares. Cubrimos el comando /effort y sus niveles en nuestro tutorial de comandos slash de Claude Code.
Sonnet 5 llega con mejoras de seguridad medibles frente a Sonnet 4.6, lo cual importa cuando un agente toca sistemas en producción. En las evaluaciones previas al despliegue, Anthropic encontró que rechaza mejor solicitudes maliciosas y resiste mejor intentos de secuestro en ataques de prompt injection.
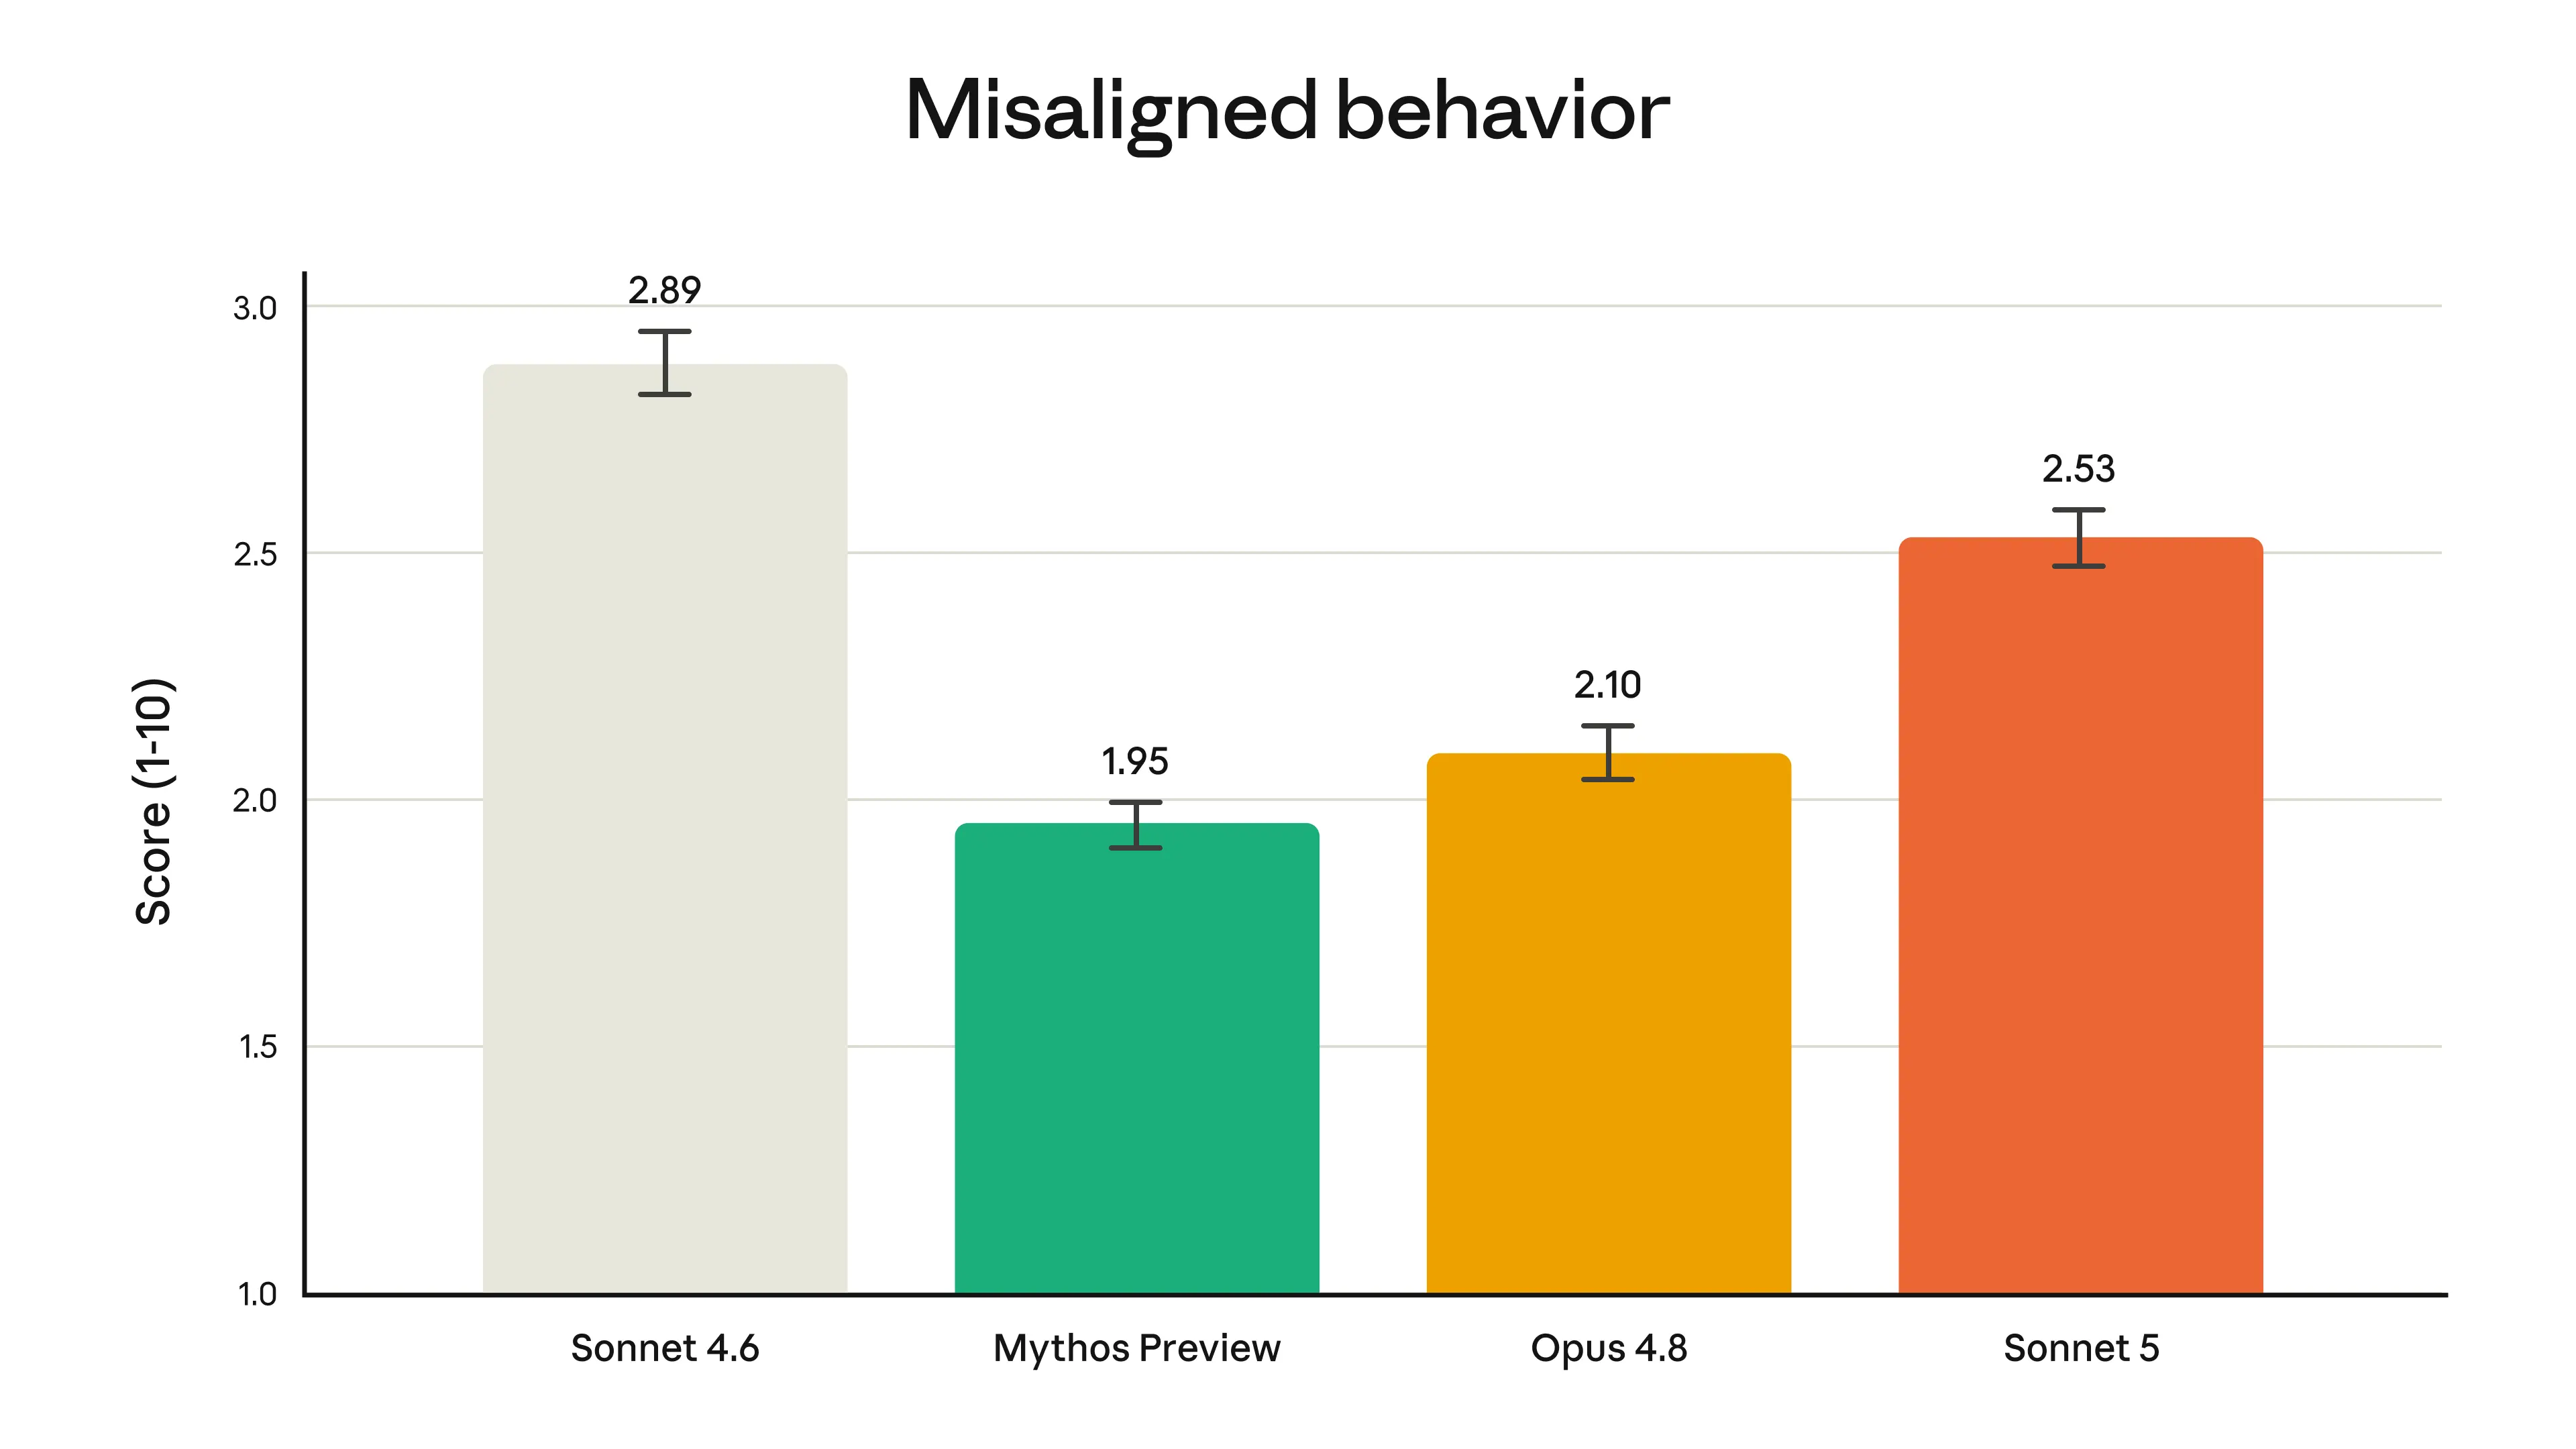
El modelo también muestra menores tasas de alucinación y servilismo que Sonnet 4.6, y obtuvo una puntuación inferior (más segura) en la auditoría de comportamiento automatizada de Anthropic, que cubre conductas desalineadas como la colaboración con usos indebidos y el engaño. El cofundador de Lovable lo resumió bien: un modelo que sabe cuándo decir que no es tan importante como uno que sabe construir.
El aviso es que Sonnet 5 aún muestra tasas más altas de comportamiento desalineado que el más capaz Opus 4.8 y la vista previa de Claude Mythos, así que es más seguro que su predecesor, pero no el más seguro de la gama de Anthropic.
Fuente: Anthropic
Sonnet 5 se lanza con protecciones cibernéticas en tiempo real activadas por defecto, las mismas presentes en Claude Opus 4.7 y 4.8. Detectan y bloquean usos peligrosos a medida que ocurren.
En las evaluaciones de Anthropic, Sonnet 5 tiene habilidades cibernéticas peligrosas sustancialmente más débiles que Opus 4.8 y Mythos 5. En una prueba creada con Mozilla para desarrollar exploits de vulnerabilidades en Firefox 147, ni Sonnet 5 ni Sonnet 4.6 produjeron nunca un exploit funcional (ambos marcaron 0,0%), aunque Sonnet 5 mostró una tasa ligeramente mayor de éxitos parciales, que Anthropic atribuye a mejoras de inteligencia general más que a entrenamiento en ciberseguridad.
Para investigadores de seguridad que necesiten menos barreras, Anthropic recomienda Opus 4.8. Las protecciones de Sonnet 5 son menos estrictas que las que llegaron con Fable 5, que bloqueaba un abanico más amplio de tareas de ciberseguridad.
El relato de benchmarks de Anthropic para Sonnet 5 es coherente: mejora claramente a Sonnet 4.6 y se sitúa justo por debajo de Opus 4.8 en las evaluaciones publicadas hasta ahora. Las cifras siguientes proceden de los materiales de lanzamiento de Anthropic. Nota de cautela: revisores independientes han informado de cifras diferentes para los mismos benchmarks, probablemente por variación en datasets, configuración de contexto o andamiajes de agente, así que toma los grandes números como dependientes de la configuración.
| Sonnet 5 | Sonnet 4.6 | Opus 4.8 De referencia |
|
|---|---|---|---|
| Programación agentic SWE-bench Pro |
63,2% | 58,1% | 69,2% |
| Programación agentic Terminal-Bench 2.1 |
80,4% | 67,0% | 82,7% |
| Razonamiento multidisciplinar Humanity's Last Exam |
43,2% sin herramientas 57,4% con herramientas |
34,6% sin herramientas 46,8% con herramientas |
49,8% sin herramientas 57,9% con herramientas |
| Uso de ordenador OSWorld-Verified |
81,2% | 78,5% | 83,4% |
| Trabajo de conocimiento GDPval-AA v2 |
1618 | 1395 | 1615 |
En el benchmark de programación agentic publicado por Anthropic, Sonnet 5 obtiene un 63,2%, frente al 69,2% de Opus 4.8 y al 58,1% de Sonnet 4.6. Este benchmark mide si un modelo puede escribir, ejecutar y corregir código en varios pasos en lugar de producir un único fragmento.
La distancia respecto a Opus 4.8 es de unos 6 puntos, mientras que el salto sobre Sonnet 4.6 ronda los 5 puntos. Para desarrolladores, esto significa que Sonnet 5 es una mejora clara frente al anterior modelo de gama media, aunque sin igualar al buque insignia.
Fuente: Anthropic
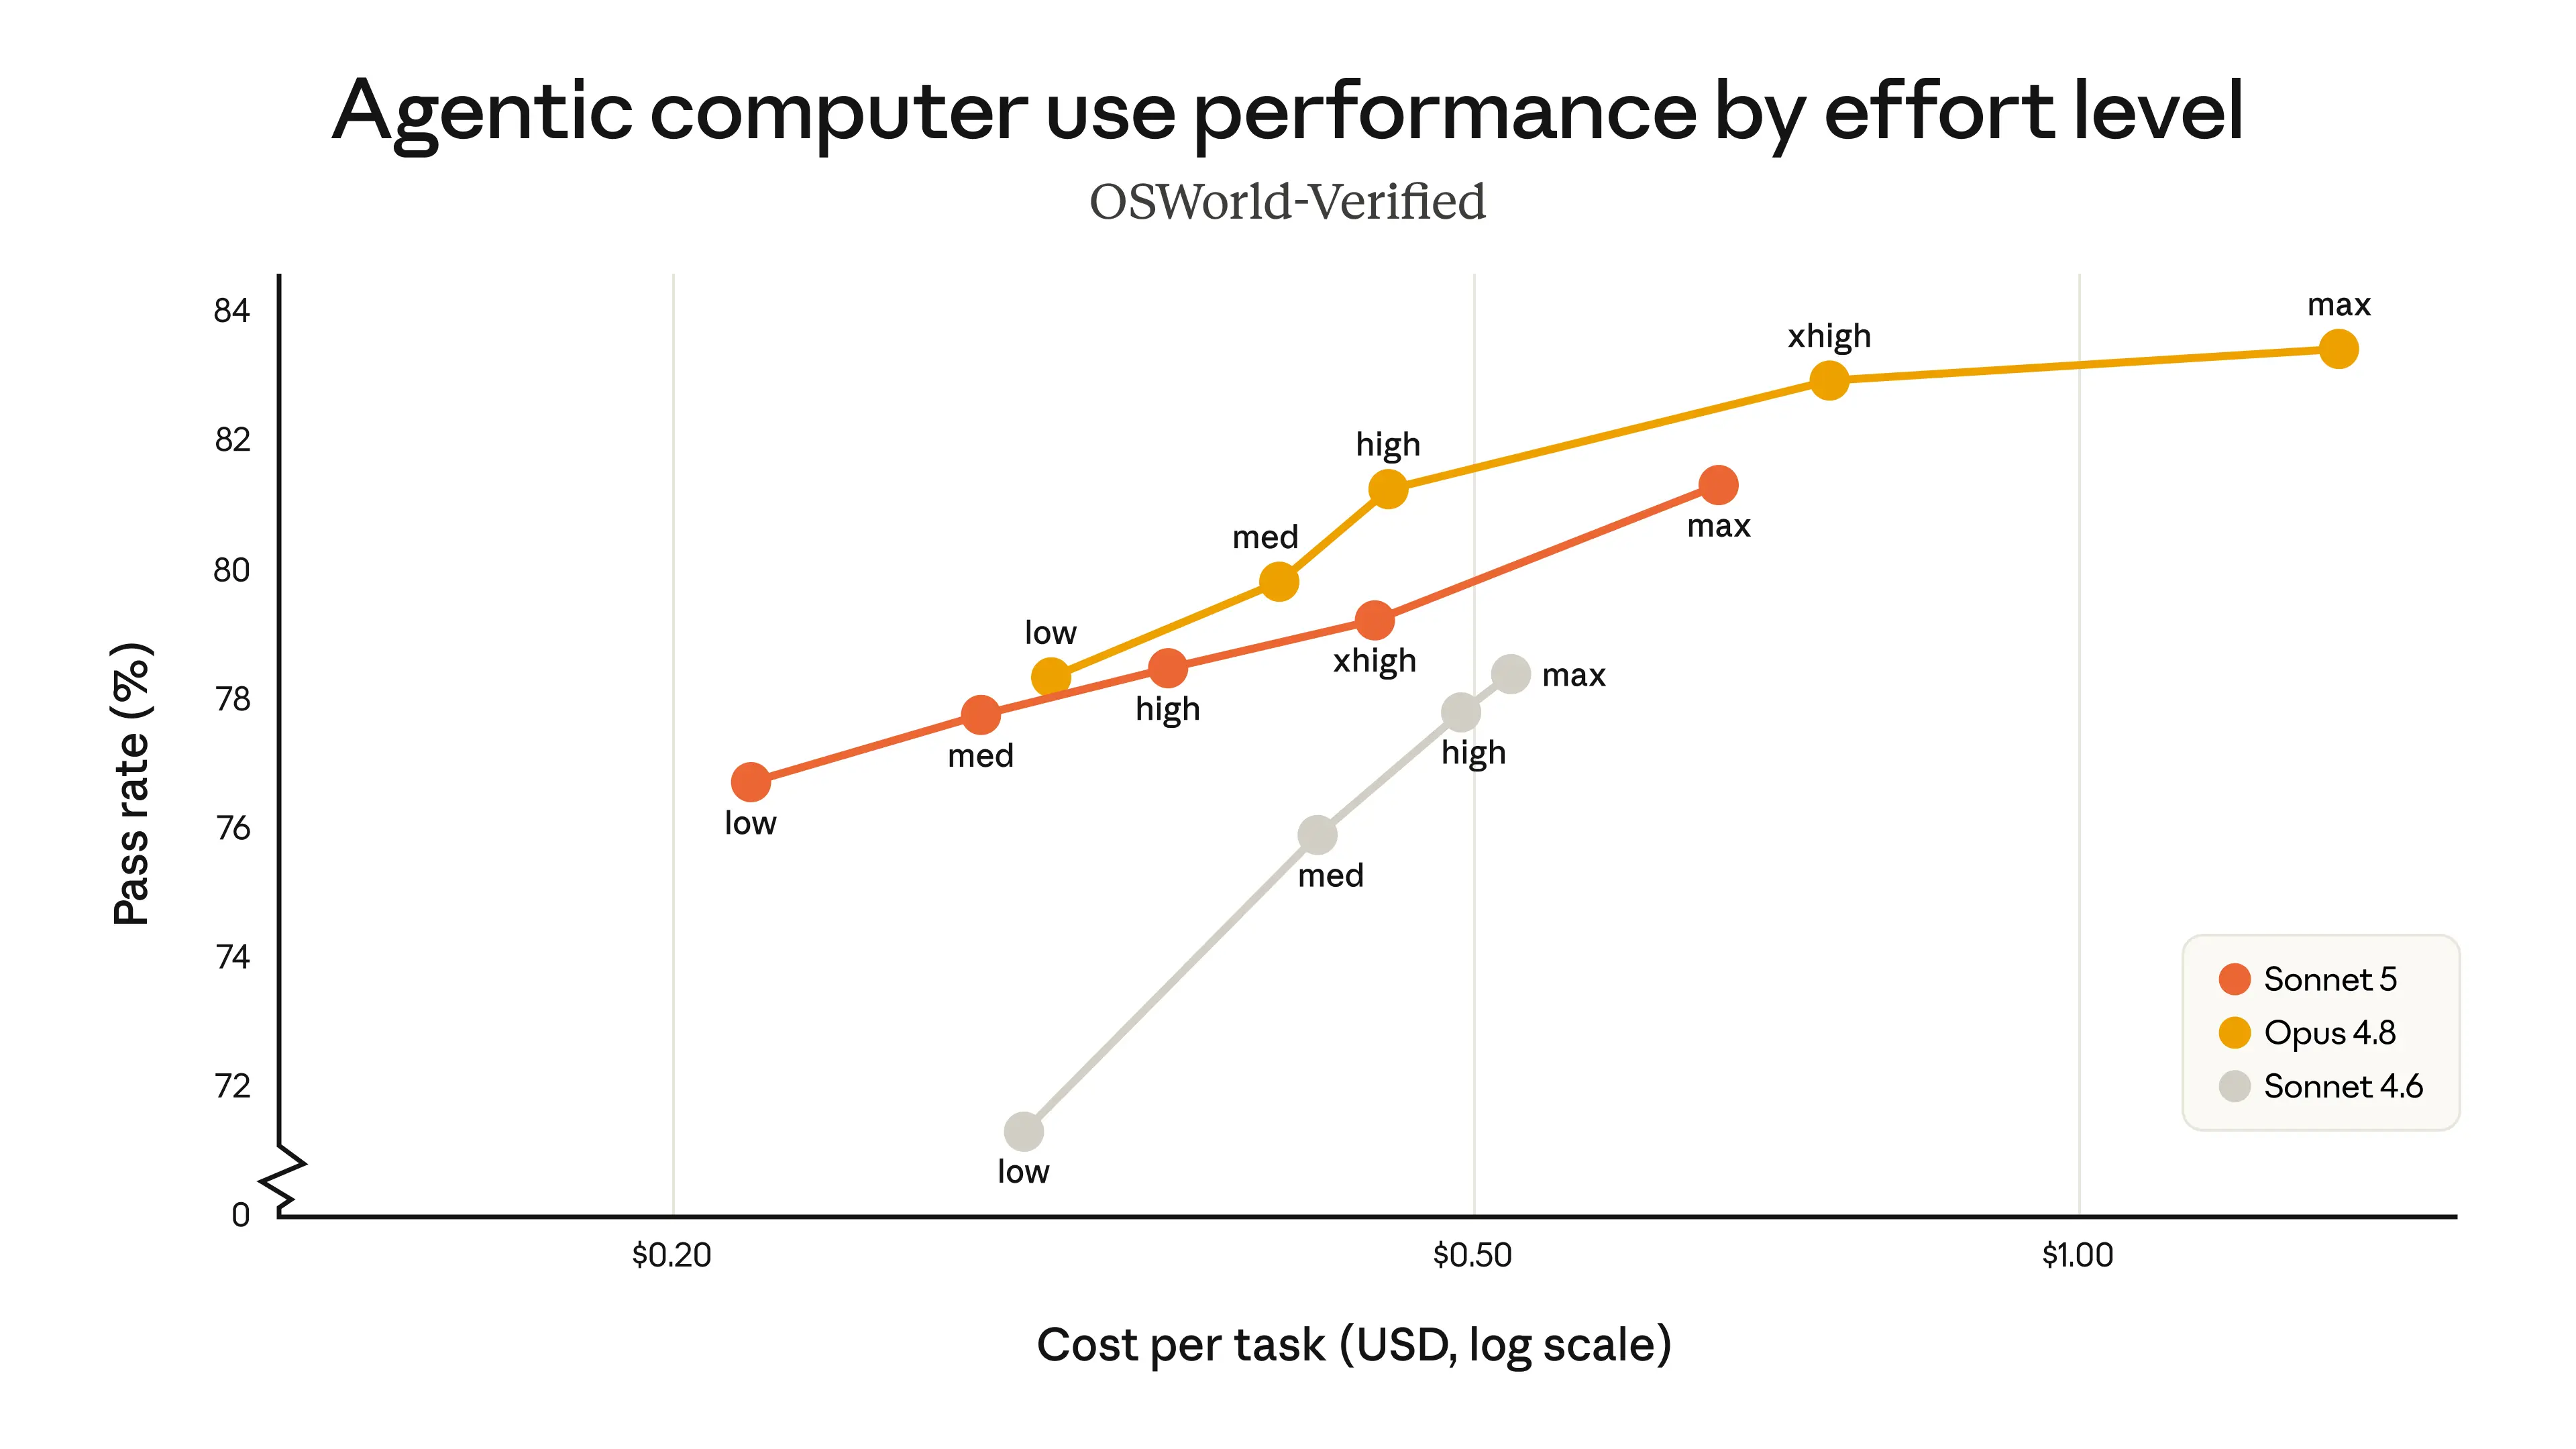
OSWorld-Verified mide la capacidad de usar un ordenador, controlando un escritorio para completar tareas reales, y BrowseComp mide la búsqueda web agentic. Anthropic actualizó su metodología de OSWorld-Verified y ahora informa de Sonnet 4.6 con un 78,5% en la configuración revisada.
En ambas evaluaciones, Sonnet 5 mejora de forma consistente a Sonnet 4.6 en todos los niveles de esfuerzo, mientras que Opus 4.8 sigue siendo la opción de mayor precisión. En esfuerzo Extra High, Sonnet 5 alcanza aproximadamente el rendimiento medio-alto de Opus 4.8, pero a ese punto la ventaja de coste se reduce, de ahí que Anthropic plantee los dos modelos como un único rango coste-precisión más que una simple sustitución.
En un benchmark de trabajo de conocimiento, Sonnet 5 supera ligeramente a Opus 4.8, según informó TechCrunch. Es relevante porque Opus 4.8 suele asociarse a los juicios más complejos y la investigación profunda.
Anthropic también actualizó su corrector para Humanity's Last Exam y ahora informa de Sonnet 4.6 con un 34,6% (sin herramientas) y un 46,8% (con herramientas), por eso esas cifras difieren del lanzamiento original de Sonnet 4.6. Para profesionales, el resultado en trabajo de conocimiento sugiere que Sonnet 5 es viable para análisis e investigación que antes parecían terreno de Opus.
Para un contexto más amplio sobre dónde se sitúa la gama Sonnet, nuestra cobertura de Sakana Fugu vs Claude Fable 5 es útil. En esa comparación, el superior Claude Fable 5 obtuvo un 80,3% en SWE-Bench Pro y un 59,0% en Humanity's Last Exam (sin herramientas), muy por encima de las cifras de gama media aquí.
Esa diferencia es la clave. La gama de Anthropic va desde el Sonnet 5, agentic y de menor coste, hasta Opus 4.8 y las clases Mythos y Fable, con cada nivel intercambiando coste por precisión en los problemas más difíciles.
Claude Sonnet 5 está disponible en todas partes desde el día de lanzamiento. Es el modelo predeterminado para los planes Free y Pro, y está disponible para usuarios Max, Team y Enterprise, además de en Claude Code y en la Claude Platform.
Los desarrolladores pueden llamarlo a través de la API de Claude usando el ID de modelo claude-sonnet-5. La tarificación funciona en dos fases:
Un detalle a tener en cuenta en el presupuesto: Sonnet 5 usa un tokenizador actualizado, así que la misma entrada puede mapearse a más tokens que antes, aproximadamente entre 1,0 y 1,35 veces según el tipo de contenido. Anthropic fijó el precio de lanzamiento para que la transición desde Sonnet 4.6 sea aproximadamente neutra en coste. La empresa también elevó los límites de tasa en Chat, Cowork, Claude Code y la Claude Platform para absorber el mayor uso de tokens que conllevan los niveles de esfuerzo altos.
Para quien quiera la comparación rápida, así quedan los tres modelos según las cifras publicadas por Anthropic.
| Modelo | Programación agentic | OSWorld-Verified | Precio de entrada / salida (por 1 M de tokens) |
|---|---|---|---|
| Sonnet 5 | 63,2% | Mejora a 4.6 en todos los niveles de esfuerzo | 2 $ / 10 $ (lanzamiento), luego 3 $ / 15 $ |
| Sonnet 4.6 | 58,1% | 78,5% (revisado) | 3 $ / 15 $ |
| Opus 4.8 | 69,2% | Opción de mayor precisión | 5 $ / 25 $ |
Sonnet 5 es la confirmación más clara de Anthropic de que la capacidad agentic ya es la expectativa base en todas las gamas de precio, no solo una función de los modelos estrella. El factor diferencial ya no es quién hace mejor el trabajo agentic, sino quién lo hace de forma barata y fiable sin supervisión humana.
Lo más interesante es el precio de lanzamiento. Anthropic parece querer que los clientes prueben Sonnet 5 con cargas reales al menor coste posible durante la ventana de migración, lo que suena a un empujón deliberado para mover a la gente de Opus 4.8 en el trabajo agentic rutinario y liberar esa capacidad. También recorta precio frente a GPT-5.5 de OpenAI y Gemini 3.1 Pro de Google, aunque Gemini 3.5 Flash sigue siendo más barato.
Si estás creando agentes que ejecutan tareas sostenidas y de varios pasos, Sonnet 5 apunta a ser el nuevo modelo por defecto al que acudir primero, subiendo a Opus 4.8 solo cuando una tarea necesite de verdad ese plus de precisión. El aviso honesto es que algunos revisores independientes ven que Sonnet 5 intercambia profundidad de razonamiento por velocidad de programación, así que para ciencia a nivel de doctorado o tareas muy intensivas de navegación, Opus 4.8 puede seguir siendo la opción más segura.
Si quieres poner en práctica el tipo de automatización para el que está pensado Sonnet 5, te recomiendo nuestro tutorial de Claude Code Routines, que te guía para ejecutar un agente de programación en la nube con una planificación periódica.
Cursos destacados de DataCamp
Curso
Curso
Curso
blog
Abid Ali Awan
9 min
blog
Ryan Ong
8 min
blog
Matt Crabtree
13 min
blog
Josep Ferrer
8 min
Tutorial
Abid Ali Awan
Tutorial
Dimitri Didmanidze
8 min