Curso
Introdução aos modelos Claude
3 h
14.5K
A Anthropic lançou o Claude Sonnet 5 em 30 de junho de 2026, e a proposta é direta: este é o modelo Sonnet mais "agente" que a empresa já colocou no ar. Ele consegue planejar, usar ferramentas como navegadores e terminais e operar de forma autônoma em um nível que, até pouco tempo atrás, só modelos maiores da classe Opus alcançavam.
A principal afirmação é que o Sonnet 5 chega perto do Opus 4.8 em raciocínio, uso de ferramentas, programação e tarefas de conhecimento — mas com preço menor. No benchmark de programação agentiva publicado pela Anthropic, o Sonnet 5 marcou 63,2% contra 69,2% do Opus 4.8 e 58,1% do Sonnet 4.6. Em um benchmark de trabalho intelectual, o Sonnet 5 chegou a superar o Opus 4.8 por uma pequena margem.
Neste artigo, eu explico tudo o que há de novo no Claude Sonnet 5, passando pelos recursos, explorando os benchmarks e detalhando quanto ele custa. Se você quiser mais contexto sobre a Anthropic, veja nosso guia recente sobre os comandos de barra do Claude Code e nossa análise do Claude Tag.
O Claude Sonnet 5 é o modelo intermediário da Anthropic, abaixo da linha Opus, criado para dar conta de trabalhos agentivos que antes exigiam os modelos Opus mais caros. Ele substitui o Sonnet 4.6, lançado em fevereiro de 2026, e usa um tokenizador atualizado que muda como o modelo processa texto.
Para muitos desenvolvedores, a era agentiva começou com modelos da classe Sonnet, como Claude Sonnet 3.5, 3.6 e 3.7, os primeiros lançamentos do Claude a mostrarem competência real em programação e uso de ferramentas. Mais recentemente, os maiores saltos em agentividade migraram para a classe Opus, e o Sonnet 5 é a tentativa da Anthropic de elevar novamente o nível intermediário para perto da fronteira.
Fonte: Anthropic
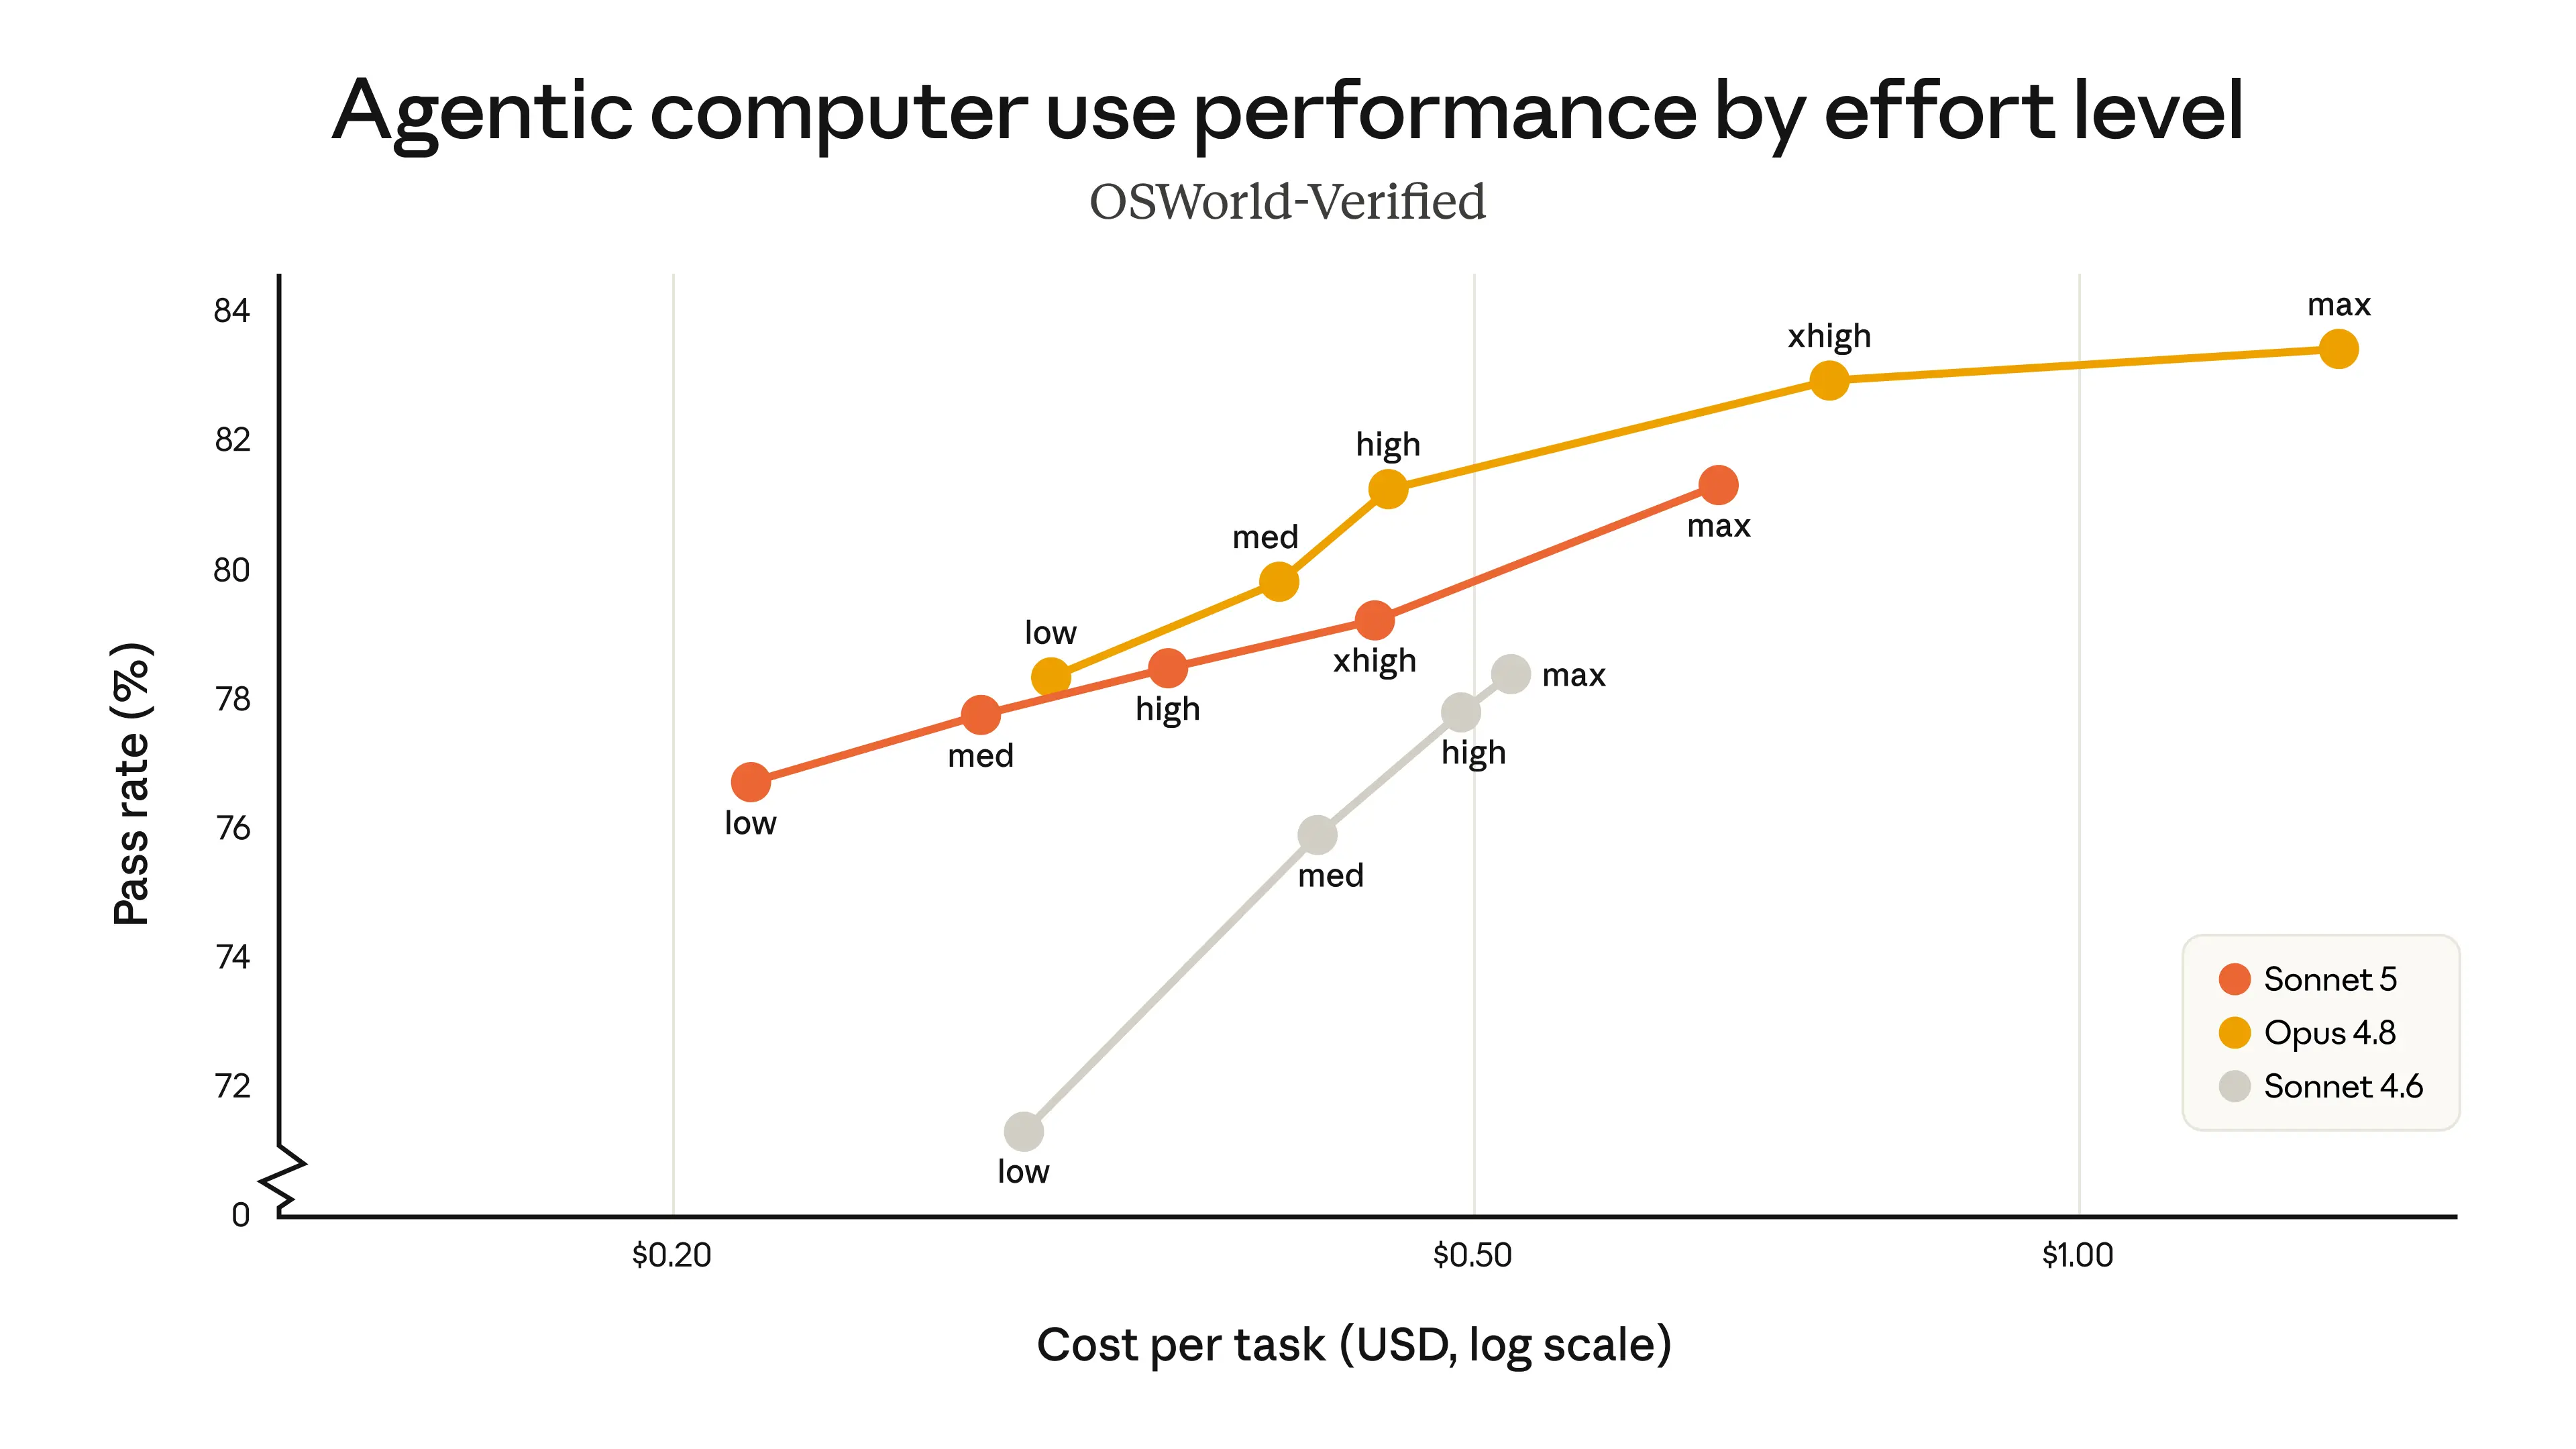
O número mais revelador é a relação custo-desempenho. Os próprios gráficos da Anthropic mostram que o Sonnet 4.6 ficou bem abaixo do Opus 4.8 nos testes BrowseComp (busca agentiva) e OSWorld-Verified (uso do computador). Agora, Sonnet 5 e Opus 4.8 ocupam a mesma faixa, com o Sonnet 5 oferecendo menor custo e o Opus 4.8 maior acurácia por um preço mais alto.
As melhorias do Sonnet 5 giram em torno de um tema: concluir tarefas agentivas de ponta a ponta sem parar no meio. Veja os destaques.
A maior mudança prática é a capacidade de levar a tarefa até o fim. Testadores de early access da Anthropic relataram que o modelo conclui tarefas complexas em que versões anteriores do Sonnet travavam no meio do caminho — e que ele checa seu próprio output sem precisar ser solicitado.
Para visualizar isso no seu dia a dia, pense em atribuir um trabalho que passa por dois sistemas: extrair testes com falha de uma execução de CI e depois abrir um pull request com a correção. Versões anteriores do Sonnet tendiam a parar após a primeira metade. O exemplo da própria Anthropic envolveu atualizar os níveis de contas no Salesforce e enviar um anúncio de lançamento para contatos enterprise em uma única passada — um fluxo que, segundo um engenheiro da Zapier, costumava travar no meio.
Para quem está construindo agentes, isso é a diferença entre um modelo que só rascunha um plano e outro que de fato executa. Diminui o número de vezes em que um humano precisa intervir para empurrar o agente adiante.
O Sonnet 5 permite ajustar níveis de esforço, para aumentar ou reduzir a profundidade de raciocínio conforme a tarefa e o orçamento. A Anthropic posiciona isso como um jeito de encontrar o ponto ideal entre o Sonnet 5 e o Opus 4.8, em vez de escolher um modelo e ficar preso a ele.
No nível Extra High de raciocínio, o Sonnet 5 performa aproximadamente como o Opus 4.8 no ajuste médio a alto no OSWorld-Verified e no BrowseComp. O porém é que rodar o Sonnet 5 nesse nível pode sair mais caro do que o Opus 4.8 em um ajuste comparável, então o Opus 4.8 continua sendo a melhor opção para algumas tarefas que exigem máxima acurácia.
Se você já usa o Claude Code, os níveis de esforço vão soar familiares. Nós cobrimos o comando /effort e seus níveis no nosso tutorial de comandos de barra do Claude Code.
O Sonnet 5 chega com melhorias mensuráveis de segurança em relação ao Sonnet 4.6, algo crucial quando um agente interage com sistemas em produção. Nas avaliações pré-implantação da Anthropic, ele se saiu melhor em recusar solicitações maliciosas e resistir a tentativas de sequestro em ataques de prompt injection.
O modelo também apresenta taxas menores de alucinação e bajulação do que o Sonnet 4.6, além de pontuação mais baixa (portanto, mais segura) na auditoria comportamental automatizada da Anthropic, que cobre comportamentos desalinhados como cooperação com mau uso e engano. O cofundador da Lovable resumiu bem: um modelo que sabe dizer não é tão importante quanto um que sabe construir.
O alerta é que o Sonnet 5 ainda mostra taxas mais altas de comportamento desalinhado do que o mais capaz Opus 4.8 e o Claude Mythos Preview, então ele é mais seguro do que seu antecessor, mas não é o modelo mais seguro do portfólio da Anthropic.
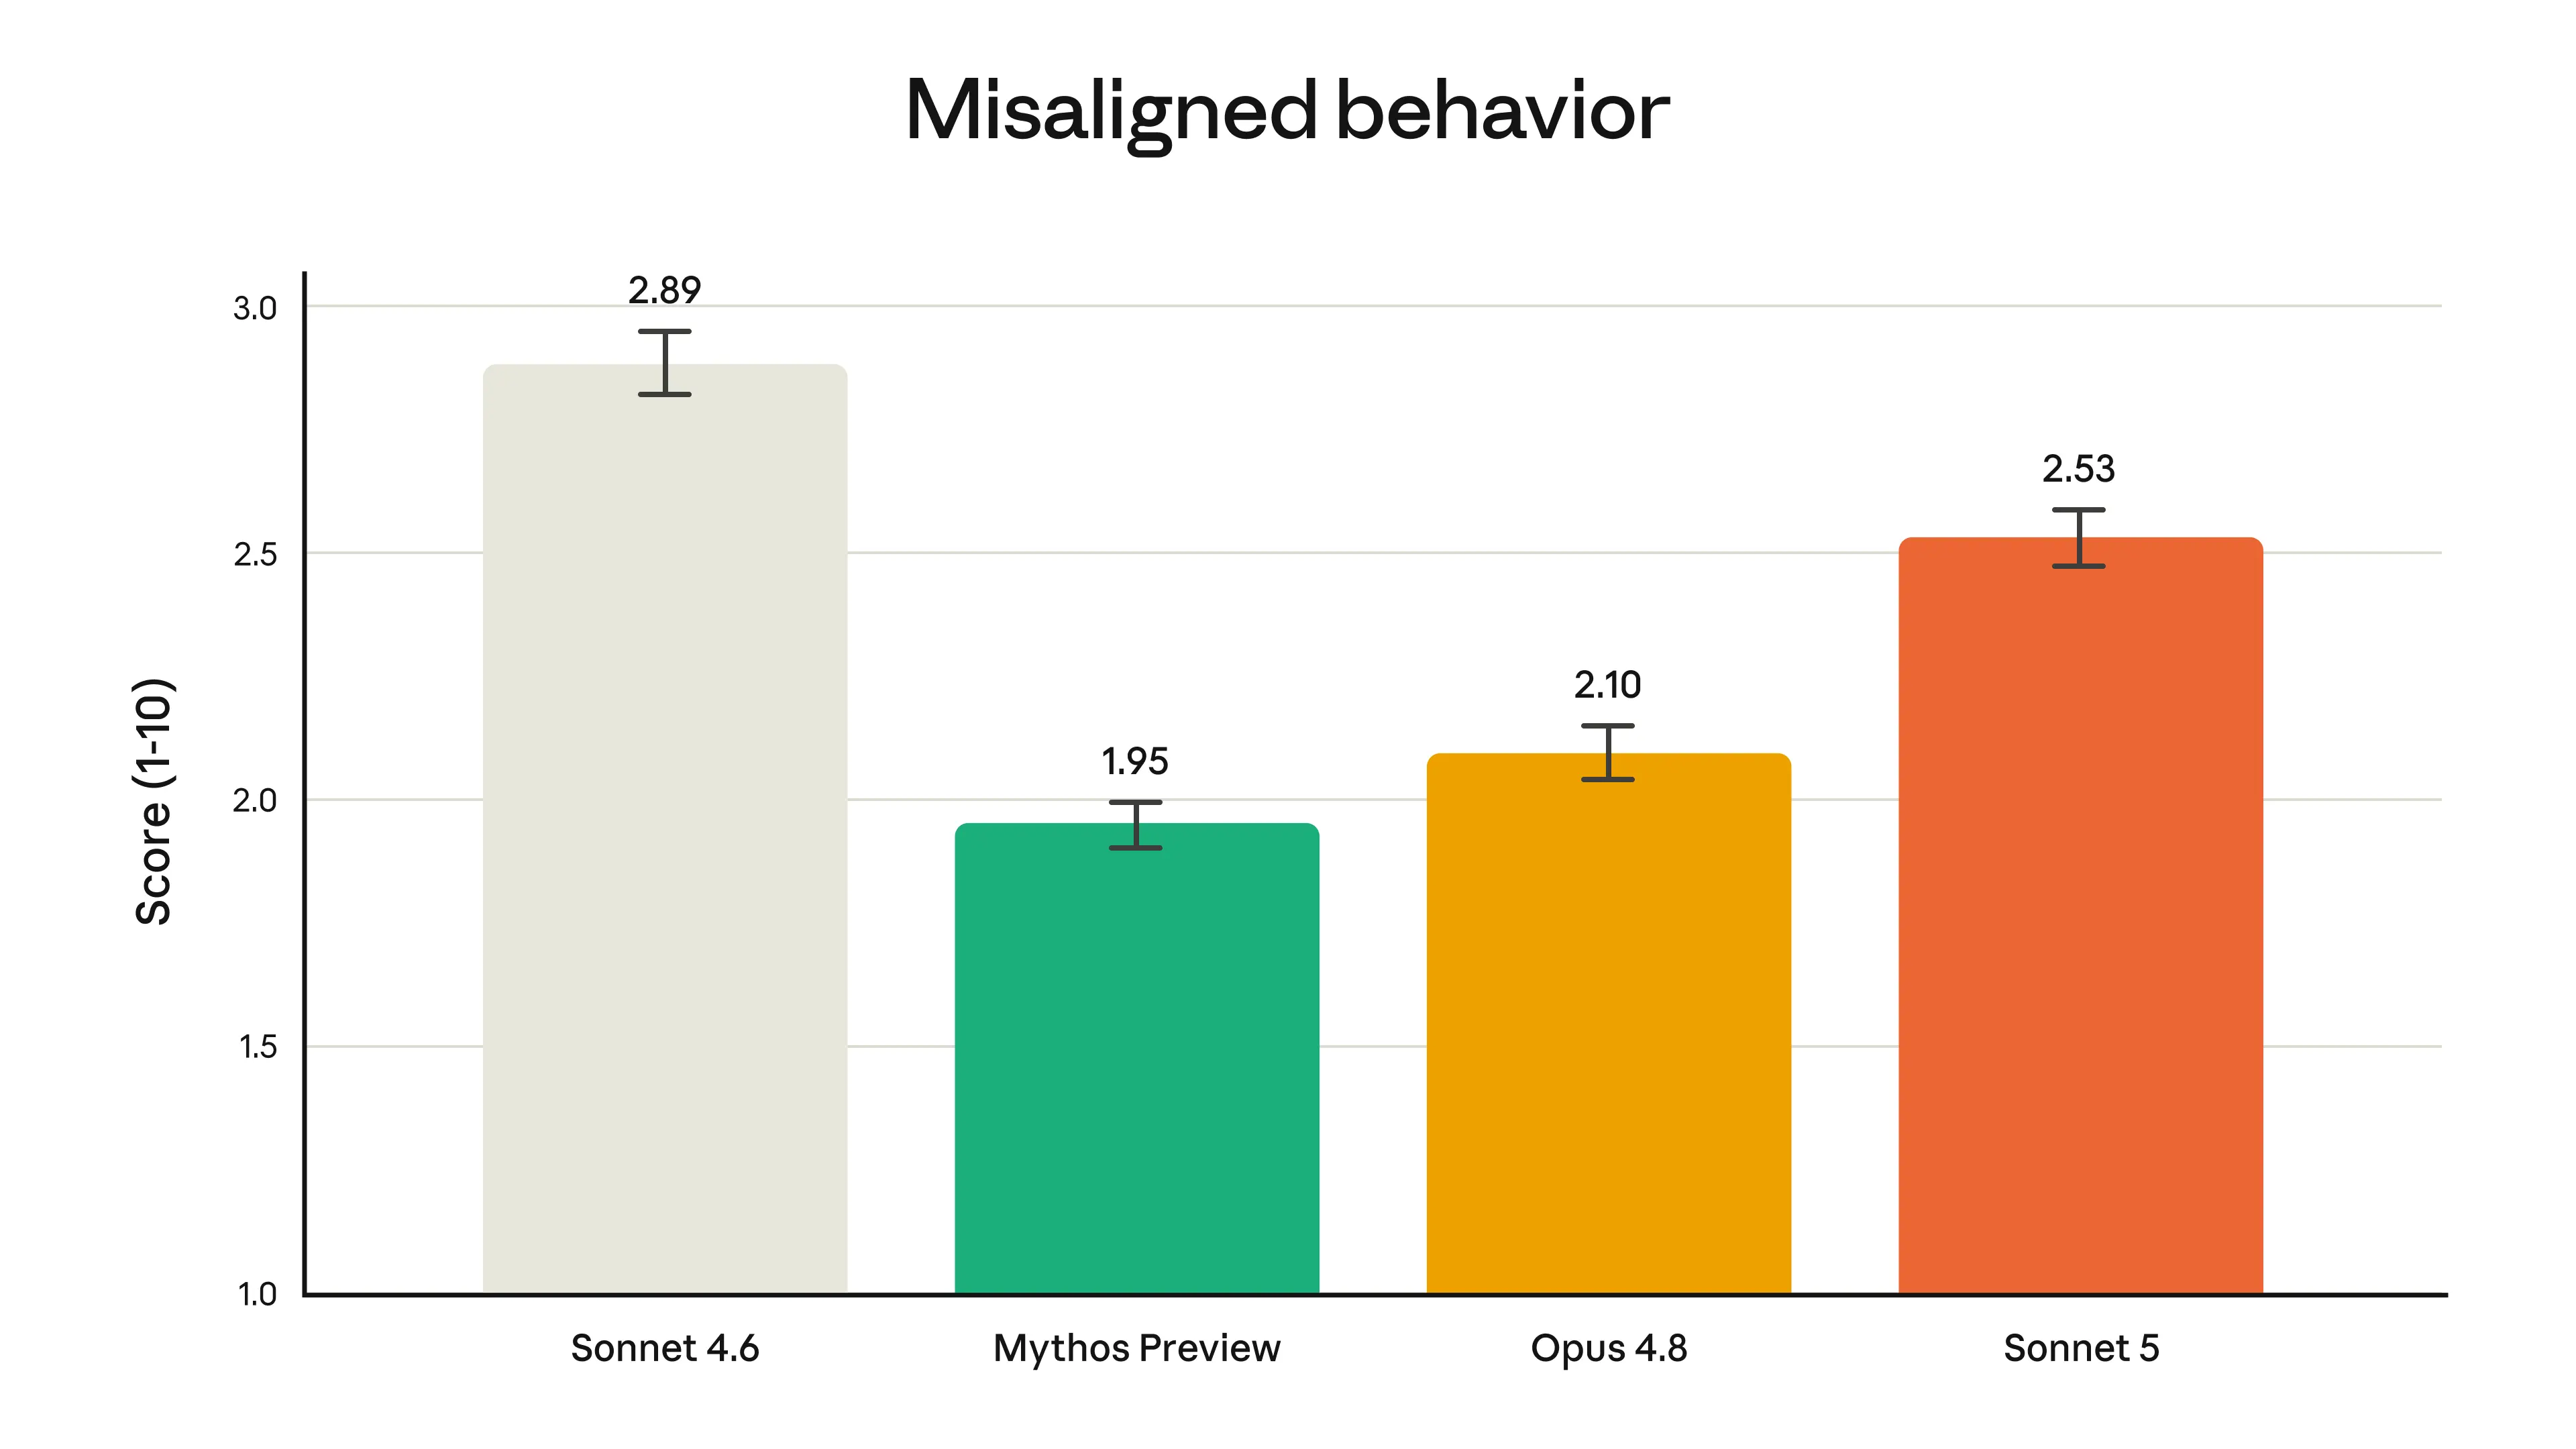
Fonte: Anthropic
O Sonnet 5 estreia com proteções cibernéticas em tempo real ativadas por padrão, as mesmas presentes no Claude Opus 4.7 e 4.8. Elas detectam e bloqueiam usos perigosos conforme acontecem.
Nas avaliações da Anthropic, o Sonnet 5 tem habilidades de ciberataque perigosas substancialmente mais fracas do que o Opus 4.8 e o Mythos 5. Em um teste desenvolvido com a Mozilla para explorar vulnerabilidades no Firefox 147, nem o Sonnet 5 nem o Sonnet 4.6 produziram um exploit funcional (ambos com 0,0%), embora o Sonnet 5 tenha mostrado uma taxa de sucesso parcial um pouco maior — algo que a Anthropic atribui a ganhos gerais de inteligência, não a treinamento específico em cibersegurança.
Para pesquisadores de segurança que precisam de menos restrições, a Anthropic recomenda o Opus 4.8. As proteções do Sonnet 5 são menos rígidas do que as que vieram no Fable 5, que bloqueava uma gama mais ampla de tarefas de cibersegurança.
A narrativa de benchmarks da Anthropic para o Sonnet 5 é consistente: ele melhora claramente em relação ao Sonnet 4.6 e fica logo abaixo do Opus 4.8 nas avaliações publicadas até agora. Os números abaixo vêm dos materiais de lançamento da Anthropic. Um alerta: avaliadores independentes relataram valores diferentes para os mesmos benchmarks, provavelmente por causa de variações em datasets, configurações de contexto ou scaffolds de agentes — então trate os números como dependentes da configuração.
| Sonnet 5 | Sonnet 4.6 | Opus 4.8 Para referência |
|
|---|---|---|---|
| Programação agentiva SWE-bench Pro |
63,2% | 58,1% | 69,2% |
| Programação agentiva Terminal-Bench 2.1 |
80,4% | 67,0% | 82,7% |
| Raciocínio multidisciplinar Humanity's Last Exam |
43,2% sem ferramentas 57,4% com ferramentas |
34,6% sem ferramentas 46,8% com ferramentas |
49,8% sem ferramentas 57,9% com ferramentas |
| Uso de computador OSWorld-Verified |
81,2% | 78,5% | 83,4% |
| Trabalho de conhecimento GDPval-AA v2 |
1618 | 1395 | 1615 |
No benchmark de programação agentiva publicado pela Anthropic, o Sonnet 5 marca 63,2%, contra 69,2% do Opus 4.8 e 58,1% do Sonnet 4.6. Esse benchmark mede se um modelo consegue escrever, rodar e corrigir código em múltiplas etapas, em vez de produzir um único trecho.
A distância para o Opus 4.8 é de cerca de 6 pontos, enquanto o salto sobre o Sonnet 4.6 é de aproximadamente 5 pontos. Para desenvolvedores, isso significa que o Sonnet 5 é uma atualização clara em relação ao modelo intermediário anterior, embora ainda não alcance o topo de linha.
Fonte: Anthropic
O OSWorld-Verified mede habilidade de uso do computador, controlando um desktop para concluir tarefas reais, e o BrowseComp mede busca agentiva na web. A Anthropic atualizou a metodologia do OSWorld-Verified e agora reporta o Sonnet 4.6 em 78,5% na configuração revisada.
Nos dois testes, o Sonnet 5 melhora consistentemente em relação ao Sonnet 4.6 em todos os níveis de esforço, enquanto o Opus 4.8 segue como a opção de maior acurácia. No esforço Extra High, o Sonnet 5 chega aproximadamente ao desempenho médio-alto do Opus 4.8, mas, nesse ponto, a vantagem de custo diminui — por isso a Anthropic apresenta os dois modelos como uma faixa única custo-acurácia, não como um upgrade direto.
Em um benchmark de trabalho intelectual, o Sonnet 5 supera ligeiramente o Opus 4.8, segundo o TechCrunch. Isso chama atenção porque o Opus 4.8 costuma ser o modelo associado às decisões mais difíceis e a pesquisas profundas.
A Anthropic também atualizou o avaliador do Humanity's Last Exam e agora reporta o Sonnet 4.6 com 34,6% (sem ferramentas) e 46,8% (com ferramentas), motivo pelo qual esses números diferem do lançamento original do Sonnet 4.6. Para quem está na prática, o resultado em trabalho de conhecimento sugere que o Sonnet 5 é viável para análise e pesquisa que antes pareciam território do Opus.
Para uma visão mais ampla de onde a linha Sonnet se posiciona, nossa cobertura de Sakana Fugu vs Claude Fable 5 ajuda. Nessa comparação, o Claude Fable 5, de nível superior, marcou 80,3% no SWE-Bench Pro e 59,0% no Humanity's Last Exam (sem ferramentas), bem acima dos números do nível intermediário aqui.
Essa distribuição é proposital. O portfólio da Anthropic vai do Sonnet 5 — agentivo e mais acessível — passando pelo Opus 4.8 e pelas classes Mythos e Fable, com cada nível trocando custo por acurácia nos problemas mais difíceis.
O Claude Sonnet 5 está disponível globalmente desde o lançamento. Ele é o modelo padrão dos planos Free e Pro, e também está disponível para usuários Max, Team e Enterprise, além do Claude Code e da Claude Platform.
Desenvolvedores podem chamá-lo via API do Claude usando o ID do modelo claude-sonnet-5. A precificação funciona em duas fases:
Um ponto para considerar no orçamento: o Sonnet 5 usa um tokenizador atualizado, então a mesma entrada pode gerar mais tokens do que antes — algo entre 1,0 e 1,35 vez, dependendo do tipo de conteúdo. A Anthropic definiu o preço promocional para que a migração do Sonnet 4.6 fique aproximadamente neutra em custo. A empresa também elevou os rate limits no Chat, Cowork, Claude Code e na Claude Platform para lidar com o consumo maior de tokens trazido pelos níveis de esforço mais altos.
Para quem quer um comparativo rápido, é assim que os três modelos se alinham segundo os números publicados pela Anthropic.
| Modelo | Programação agentiva | OSWorld-Verified | Preço de entrada / saída (por 1M tokens) |
|---|---|---|---|
| Sonnet 5 | 63,2% | Melhora em relação ao 4.6 em todos os níveis de esforço | US$ 2 / US$ 10 (promo), depois US$ 3 / US$ 15 |
| Sonnet 4.6 | 58,1% | 78,5% (revisado) | US$ 3 / US$ 15 |
| Opus 4.8 | 69,2% | Opção de maior acurácia | US$ 5 / US$ 25 |
O Sonnet 5 é o recado mais claro da Anthropic de que capacidade agentiva agora é expectativa básica em todas as faixas de preço — não um recurso exclusivo do topo de linha. O diferencial deixou de ser quem faz trabalho agentivo melhor; passa a ser quem faz isso com custo baixo e confiabilidade, sem supervisão humana.
O que mais chama a atenção é o preço promocional. A Anthropic parece querer que os clientes testem o Sonnet 5 em cargas reais com o menor custo possível durante a janela de migração — um movimento deliberado para tirar rotinas agentivas do Opus 4.8 e liberar essa capacidade. No preço, ele também pressiona o GPT-5.5 da OpenAI e o Gemini 3.1 Pro do Google, embora o Gemini 3.5 Flash siga mais barato.
Se você está construindo agentes que executam tarefas sustentadas e de múltiplas etapas, o Sonnet 5 parece o novo padrão para começar — subindo para o Opus 4.8 apenas quando a tarefa realmente exigir a acurácia extra. O alerta honesto é que alguns reviews independentes veem o Sonnet 5 trocando profundidade de raciocínio por velocidade de código; para ciência em nível de PhD ou tarefas com muita navegação, o Opus 4.8 pode continuar sendo a escolha mais segura.
Se quiser colocar a mão na massa com o tipo de automação para o qual o Sonnet 5 foi projetado, recomendo nosso tutorial de Routines do Claude Code, que mostra como rodar um agente de programação em horários agendados na nuvem.
Principais cursos da DataCamp
Curso
Curso
Curso
blog
Abid Ali Awan
9 min
blog
Richie Cotton
7 min
blog
Josep Ferrer
8 min
blog
Javier Canales Luna
9 min
blog
Richie Cotton
Tutorial
Abid Ali Awan