Kurs
Konzepte großer Sprachmodelle (LLMs)
2 Std.
109.7K
LLM-Distillation zielt darauf ab, die Leistung eines großen Sprachmodells bei deutlich kleinerer Größe und geringerem Rechenbedarf nachzubilden.
Stell dir eine erfahrene Professorin vor, die ihr Fachwissen an eine neue Studentin weitergibt. Das Professorinnenmodell (Teacher) vermittelt komplexe Konzepte und Einsichten, während das Studierendenmodell (Student) lernt, diese Lehren in vereinfachter und effizienterer Form umzusetzen.
So bleiben die Kernkompetenzen des Teachers erhalten und der Student wird für schnelle, vielseitige Anwendungen optimiert.
Die zunehmende Größe und die Rechenanforderungen großer Sprachmodelle bremsen ihre breite Nutzung und Produktivsetzung. Leistungsstarke Hardware und steigender Energieverbrauch schränken die Zugänglichkeit ein – besonders in ressourcenarmen Umgebungen wie Mobilgeräten oder Edge-Computing-Plattformen.
LLM-Distillation begegnet diesen Hürden mit kleineren, schnelleren Modellen – ideal für die Integration auf mehr Geräten und Plattformen.
Das demokratisiert den Zugang zu fortgeschrittener KI und stützt Echtzeitanwendungen, in denen Geschwindigkeit und Effizienz zählen. Durch besser zugängliche und skalierbare KI-Lösungen treibt LLM-Distillation die praktische Umsetzung von KI voran.
Bei der LLM-Distillation kommen mehrere Techniken zum Einsatz, damit das Studierendenmodell Schlüsselinformationen behält und zugleich effizienter arbeitet. Hier sind die Mechanismen, die den Wissenstransfer wirksam machen.
Das Teacher-Student-Paradigma ist das Herzstück der LLM-Distillation und treibt den Wissenstransfer an. Ein großes, leistungsfähiges Modell gibt sein Wissen an ein kleineres, leichteres Modell weiter.
Das Teachermodell – oft ein State-of-the-Art-Sprachmodell mit umfangreichem Training und Rechenressourcen – dient als reichhaltige Wissensquelle. Das Studierendenmodell lernt, dieses Verhalten nachzuahmen und das Wissen zu verinnerlichen.
Seine Hauptaufgabe: die Ausgaben des Teachers zu reproduzieren – bei deutlich kleinerer Größe und geringerem Compute-Bedarf. Dazu beobachtet es Vorhersagen, Anpassungen und Reaktionen des Teachers auf verschiedene Eingaben und lernt daraus.
So erreicht der Student eine vergleichbare Leistung und ein ähnliches Verständnis – ideal für den Einsatz in Umgebungen mit knappen Ressourcen.
Für den Wissenstransfer kommen verschiedene Verfahren zum Einsatz. Sie sorgen dafür, dass der Student effizient lernt und die wesentlichen Fähigkeiten des Teachers übernimmt. Zu den wichtigsten Techniken gehören:
Ein zentrales Verfahren ist die Knowledge Distillation (KD). Dabei trainiert man den Studenten anhand der Ausgabewahrscheinlichkeiten des Teachers, den sogenannten Soft Targets, ergänzend zu den echten Labels, den Hard Targets.
Soft Targets zeigen die Vorhersagen des Teachers als Wahrscheinlichkeitsverteilung und nicht nur als „richtig/falsch“. Diese Zusatzinformation hilft dem Studenten, feine Muster und implizites Wissen des Teachers zu erfassen.
Mit Soft Targets versteht der Student die Entscheidungslogik des Teachers besser – das steigert Genauigkeit und Zuverlässigkeit und macht das Training effizienter.
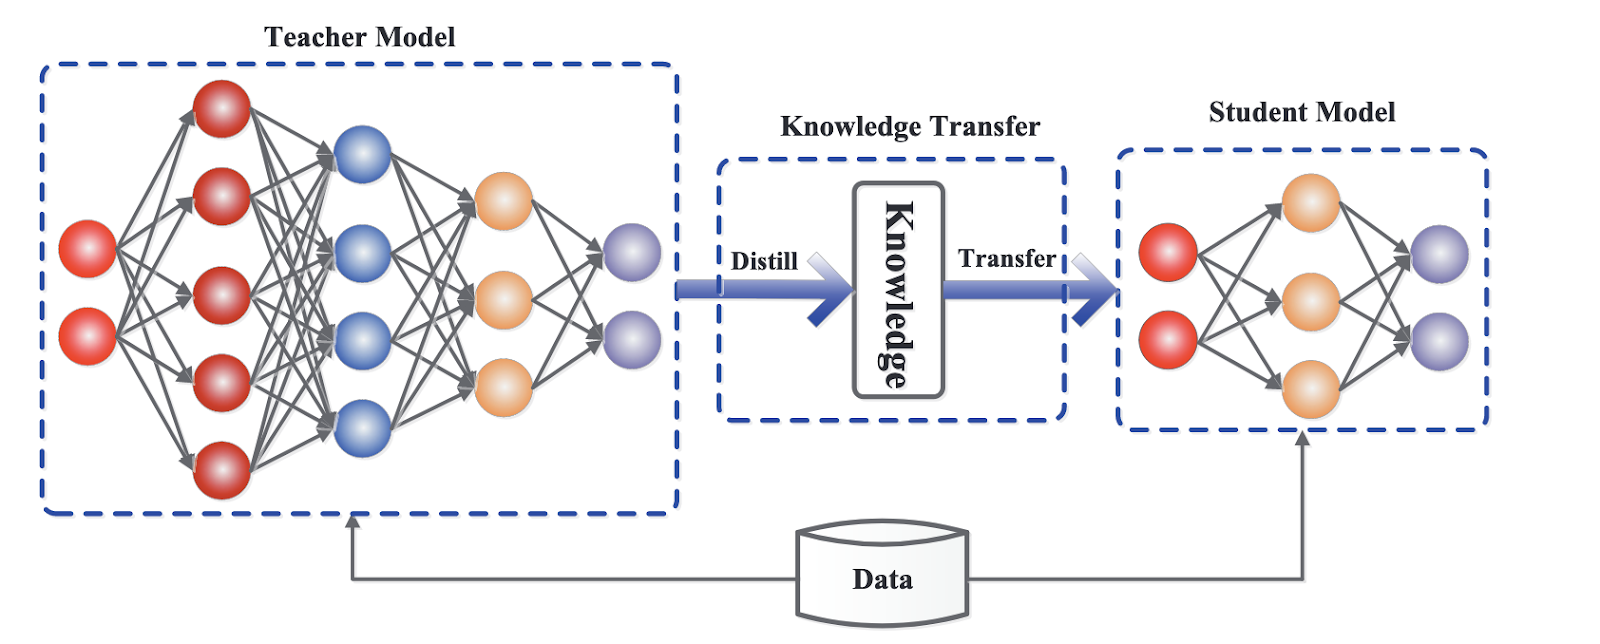
Allgemeiner Rahmen für Knowledge Distillation. Quelle
Neben KD gibt es weitere Verfahren, die die LLM-Distillation verbessern können:
LLM-Distillation bringt deutliche Vorteile für Nutzbarkeit und Effizienz von Sprachmodellen – und macht sie für vielfältige Anwendungen praxistauglich.
Hier die wichtigsten Pluspunkte:
Ein Kernvorteil ist die spürbare Verkleinerung. Der Student übernimmt viel vom Können des Teachers – bei nur einem Bruchteil der Größe.
Das führt zu:
Die geringere Größe zahlt direkt auf die Inferenzgeschwindigkeit ein – entscheidend für Anwendungen mit Echtzeitanforderungen.
Konkret bedeutet das:
Ein weiterer Pluspunkt sind sinkende Kosten. Kleinere Modelle benötigen weniger Rechenleistung – das spart in mehreren Bereichen:
Distillierte LLMs sind vielseitiger und leichter zu deployen – über viele Plattformen hinweg. Das hat konkrete Auswirkungen:
Die Vorteile gehen über Effizienz und Kosten hinaus. Distillierte Sprachmodelle lassen sich in vielen Natural-Language-Processing (NLP)-Aufgaben und branchenspezifischen Use Cases einsetzen – KI wird so in vielen Feldern nutzbar.
Distillierte LLMs glänzen in zahlreichen NLP-Aufgaben. Ihre kompakte Größe und starke Performance prädestinieren sie für Echtzeit und begrenzte Rechenleistung.
Sie ermöglichen kleinere, schnellere Chatbots für Service und Support. Diese verstehen Anfragen in Echtzeit und antworten flüssig – ohne großen Compute-Bedarf.
Mit distillierten LLMs betriebene Tools fassen Nachrichten, Dokumente oder Social Feeds prägnant zusammen. Nutzer erfassen die Kernaussagen, ohne lange Texte zu lesen.
Übersetzungen werden schneller und auf mehr Geräten verfügbar. Die Modelle laufen auf Smartphones, Tablets und sogar offline – mit geringer Latenz und niedrigerem Rechenaufwand.
Neben Standardaufgaben überzeugen distillierte LLMs auch in spezialisierten Szenarien mit hohem Tempo und Präzision.
Distillierte LLMs gehen über generische NLP-Aufgaben hinaus und treiben Prozesse, Nutzererlebnisse und Innovation in vielen Branchen.
Im Gesundheitswesen verarbeiten sie Akten und Diagnosedaten effizienter – für schnellere, genauere Diagnosen. Als Teil medizinischer Geräte unterstützen sie Ärztinnen und Ärzte mit Analyse in Echtzeit.
Die Finanzbranche profitiert von besseren Betrugserkennungssystemen und personalisierten Interaktionen. Sie erkennen Muster in Transaktionen und Anfragen schnell, verhindern Betrug und liefern individuelle Beratung.
In der Bildung ermöglichen sie adaptive Lernsysteme und persönliche Tutoring-Plattformen. Leistungen werden analysiert und Lerninhalte passgenau empfohlen.
Die Umsetzung umfasst mehrere Schritte sowie spezialisierte Frameworks und Bibliotheken. Hier sind Tools und Schritte, um ein großes Sprachmodell zu distillieren.
Zur Vereinfachung der Distillation stehen einige Frameworks bereit – mit jeweils eigenen Stärken.
Die Hugging Face Transformers-Bibliothek ist ein beliebtes Tool. Sie bietet eine Distiller-Klasse, die den Wissenstransfer vom Teacher zum Student vereinfacht.
Mit der Distiller-Klasse lassen sich vortrainierte Modelle nutzen, auf spezifische Datensätze feinabstimmen und Distillationstechniken kombinieren, um optimale Ergebnisse zu erzielen.
Neben Hugging Face Transformers unterstützen auch andere Bibliotheken die LLM-Distillation:
Distiller komprimiert Deep-Learning-Modelle – inklusive Distillation – und liefert Utilities für mehr Effizienz.Für erfolgreiche LLM-Distillation braucht es Planung und saubere Ausführung. Die zentralen Schritte:
Zunächst wird ein passender Datensatz vorbereitet, der die Zielaufgaben realistisch abbildet – damit der Student gut generalisiert.
Datenaugmentation erweitert den Beispielspeicher und verbessert das Lernen.
Die Wahl eines geeigneten Teachermodells ist entscheidend: gut vortrainiert, hohe Genauigkeit auf den Zielaufgaben. Qualität und Eigenschaften des Teachers prägen die Studentleistung direkt.
Der Prozess umfasst:
Die Leistung des distillierten Modells sollte gezielt überprüft werden. Gängige Kennzahlen sind:
Eine ausführlichere Betrachtung findest du in meinem Artikel zu LLM-Evaluation: Metriken, Methoden, Best Practices.
Neben vielen Vorteilen gibt es Hürden, die man für eine erfolgreiche Umsetzung adressieren sollte.
Eine zentrale Herausforderung ist potenzieller Wissensverlust. Feine Nuancen des Teachers werden im Prozess nicht immer vollständig übernommen – besonders bei Aufgaben mit tiefem oder spezialisiertem Verständnis kann die Leistung sinken.
Diese Strategien helfen, Verluste zu mindern:
Sorgfältiges Tuning ist entscheidend. Wichtige Hyperparameter wie Temperatur und Learning Rate beeinflussen das Lernen stark:
Die Wirksamkeit des distillierten Modells muss belegt werden – im Vergleich zu Teacher und Baselines. So wird sichtbar, wie gut Funktionalität erhalten oder sogar verbessert wurde.
Wichtige Metriken dafür sind:
Diese Empfehlungen erhöhen die Erfolgsquote der LLM-Distillation – mit Fokus auf Experiment, Evaluation und Strategie.
Das Feld entwickelt sich rasant. Hier ein Blick auf Trends, offene Fragen und neue Techniken in der LLM-Distillation.
Aktuelle Arbeiten bringen neue Verfahren und Architekturen hervor, um Effizienz und Wirkung der Distillation zu erhöhen. Bemerkenswert sind etwa:
Trotz Fortschritten bleiben Fragen offen:
Um diese Herausforderungen zu meistern, entstehen laufend neue Techniken. Vielversprechend sind:
LLM-Distillation macht große Sprachmodelle praxistauglicher und effizienter. Durch die Übertragung des wesentlichen Wissens vom komplexen Teacher auf einen kleineren Student bleibt die Leistung hoch, während Größe und Rechenbedarf sinken.
So entstehen schnellere, besser zugängliche KI-Anwendungen – von Echtzeit-NLP bis zu Spezialfällen in Gesundheitswesen und Finanzen. Die Umsetzung erfordert Planung und die richtigen Tools, liefert aber klare Vorteile wie geringere Kosten und breitere Einsatzmöglichkeiten.
Mit weiterem Forschungsfortschritt wird LLM-Distillation eine Schlüsselrolle bei der Demokratisierung von KI spielen – und starke Modelle in mehr Kontexten nutzbar machen.
Lerne mehr über LLMs mit diesen Kursen!
Kurs
Kurs
Kurs