Cours
Concepts des grands modèles de langage (LLM)
2 h
109.8K
La distillation d’LLM vise à reproduire les performances d’un grand modèle de langage tout en réduisant sa taille et ses besoins de calcul.
Imaginez un professeur chevronné partageant son expertise avec un nouvel étudiant. Le professeur, qui représente le modèle enseignant, transmet des concepts complexes et des éclairages, tandis que le modèle élève apprend à les reproduire de manière plus simple et plus efficace.
Ce processus permet de conserver le cœur des compétences du professeur tout en optimisant l’élève pour des usages plus rapides et plus polyvalents.
La taille croissante et les exigences de calcul des grands modèles de langage freinent leur adoption et leur déploiement à grande échelle. Le besoin de matériel hautes performances et une consommation énergétique en hausse limitent souvent leur accessibilité, notamment dans des environnements contraints comme les appareils mobiles ou les plateformes d’edge computing.
La distillation d’LLM répond à ces défis en produisant des modèles plus petits et plus rapides, idéaux pour une intégration sur un éventail plus large d’appareils et de plateformes.
Cette innovation démocratise l’accès à une IA avancée et soutient les applications en temps réel où vitesse et efficacité sont cruciales. En rendant l’IA plus accessible et scalable, la distillation d’LLM accélère sa mise en œuvre concrète.
La distillation d’LLM s’appuie sur plusieurs techniques pour que le modèle élève conserve l’essentiel tout en gagnant en efficacité. Voici les mécanismes clés qui rendent ce transfert performant.
Le paradigme professeur–élève est au cœur de la distillation, et pilote le transfert de connaissances. Un modèle plus grand et avancé transmet son savoir à un modèle plus compact et léger.
Le modèle enseignant, souvent à l’état de l’art et entraîné avec de vastes ressources, sert de source riche d’information. L’élève, lui, apprend en imitant son comportement et en intériorisant ses connaissances.
La mission première de l’élève est de reproduire les sorties du professeur, tout en restant bien plus petit et économe en calcul. Il observe les prédictions, ajustements et réponses du professeur face à divers inputs pour apprendre.
Ainsi, il peut atteindre des performances comparables, prêtes pour des déploiements en environnements contraints.
Diverses techniques permettent de transférer le savoir du professeur vers l’élève. Elles visent à rendre l’apprentissage efficace tout en préservant l’essentiel des capacités du modèle enseignant. En voici les principales.
L’une des techniques phares est la knowledge distillation (KD). L’élève est entraîné à partir des probabilités de sortie du professeur, appelées soft targets, en complément des étiquettes de vérité terrain, dites hard targets.
Les soft targets offrent une vision nuancée des prédictions du professeur, sous forme de distribution de probabilités plutôt qu’une réponse unique. Ces informations aident l’élève à capter des motifs subtils et des connaissances fines encodées dans les réponses du professeur.
Grâce aux soft targets, l’élève comprend mieux le processus de décision du professeur, ce qui améliore précision et fiabilité. Cette approche préserve l’essentiel du savoir tout en rendant l’entraînement plus fluide et efficace.
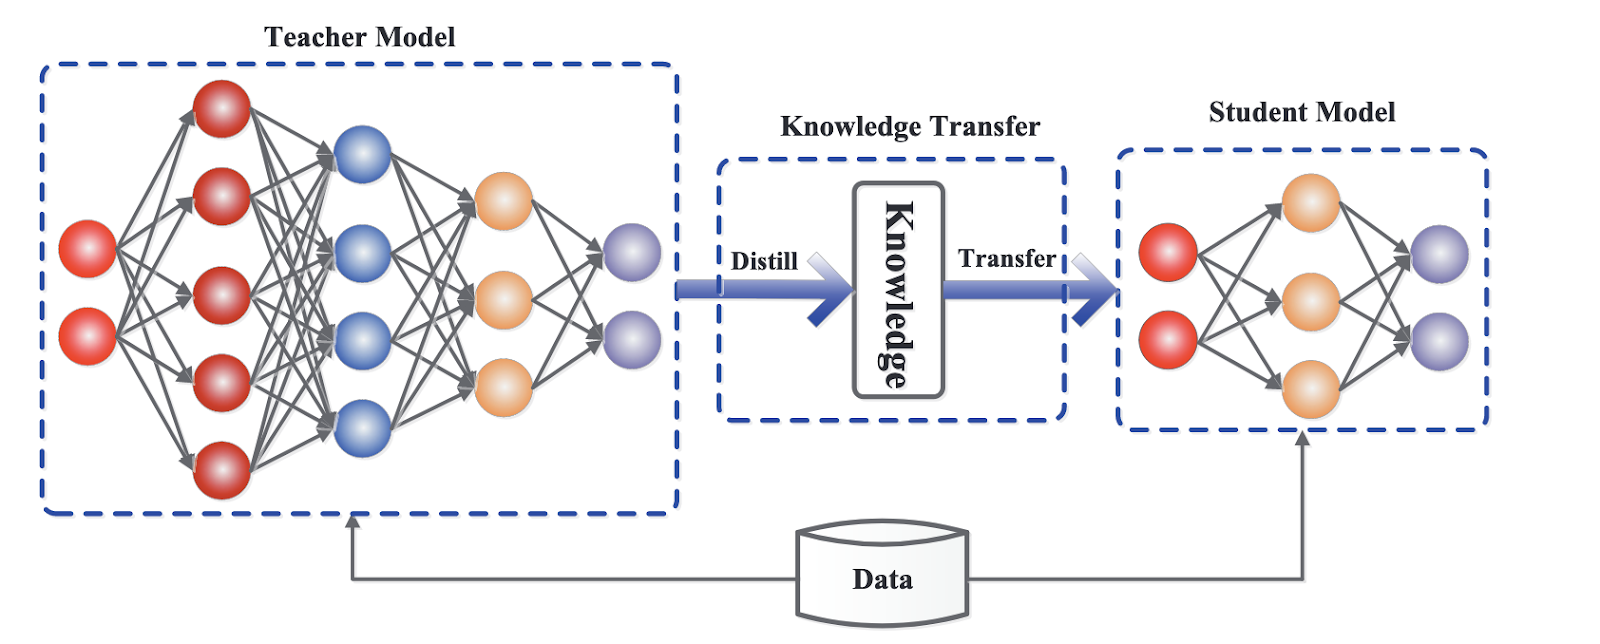
Cadre générique de la knowledge distillation. Source
Au-delà de la KD, plusieurs méthodes renforcent la distillation des LLM :
La distillation d’LLM apporte des bénéfices majeurs qui renforcent l’utilisabilité et l’efficacité des modèles, les rendant plus adaptés à de nombreux usages.
Voici les principaux avantages.
Un bénéfice clé est la création de modèles nettement plus compacts. En transférant les connaissances d’un grand professeur à un élève plus petit, on conserve l’essentiel des capacités tout en divisant la taille.
Cette réduction implique :
La compacité des modèles distillés se traduit directement par une inférence plus rapide, essentielle pour les applications en temps réel.
Concrètement :
Autre avantage notable : la baisse des coûts de calcul. Des modèles plus petits exigent moins de ressources, ce qui génère des économies :
Les LLM distillés sont plus polyvalents et accessibles, et se déploient sur davantage de plateformes. Cela implique :
Les bénéfices de la distillation dépassent l’efficacité et les coûts. Les modèles distillés s’appliquent à un large éventail de tâches de traitement du langage naturel (NLP) et de cas d’usage sectoriels, rendant l’IA accessible dans de nombreux domaines.
Les LLM distillés excellent dans de nombreuses tâches NLP. Leur compacité et leurs performances en font des candidats idéaux pour le temps réel et les environnements à faible puissance de calcul.
Ils permettent de créer des chatbots plus petits et plus rapides pour la relation client. Ces agents comprennent et répondent aux requêtes en temps réel, sans besoins massifs en calcul.
Des outils de synthèse propulsés par des LLM distillés condensent articles, documents ou fils sociaux en résumés clairs, pour saisir l’essentiel en un coup d’œil.
Des modèles distillés rendent la traduction plus rapide et accessible sur tous types d’appareils. Déployables sur mobile, tablette et même hors ligne, ils réduisent la latence et l’empreinte de calcul.
Au-delà des usages courants, les LLM distillés excellent aussi là où rapidité et précision sont décisives.
Les LLM distillés ne se limitent pas aux tâches génériques. Ils transforment aussi de nombreux secteurs en améliorant les processus, l’expérience utilisateur et l’innovation.
Dans le secteur de la santé, ils accélèrent l’analyse des dossiers et données diagnostiques, pour des décisions plus rapides et plus justes. Déployés dans des dispositifs médicaux, ils assistent médecins et soignants en temps réel.
La finance profite de modèles distillés pour mieux détecter la fraude et améliorer les interactions clients. Ils analysent plus vite les transactions et requêtes, préviennent les abus et personnalisent le conseil.
En éducation, ils facilitent des systèmes d’apprentissage adaptatifs et des plateformes de tutorat personnalisées, qui analysent les performances et proposent des contenus sur mesure.
La mise en œuvre requiert des étapes structurées et des frameworks adaptés. Voici les outils et phases clés pour distiller un grand modèle de langage.
Plusieurs outils facilitent la distillation, avec des fonctionnalités dédiées.
La bibliothèque Hugging Face transformers propose une classe Distiller qui simplifie le transfert de connaissances du professeur vers l’élève.
Avec Distiller, on réutilise des modèles pré-entraînés, on les ajuste sur des jeux de données ciblés et on applique des techniques de distillation pour des résultats optimaux.
Outre Hugging Face Transformers, d’autres bibliothèques prennent en charge la distillation d’LLM :
Distiller permet de compresser des modèles profonds, dont la distillation, avec des utilitaires pour piloter le processus.La distillation exige une planification rigoureuse. Voici les étapes essentielles.
Préparez un jeu de données représentatif des tâches visées, pour favoriser la généralisation du modèle élève.
Des techniques d’augmentation peuvent enrichir le jeu de données et diversifier les exemples.
Sélectionnez un professeur pré-entraîné et performant sur les tâches cibles. La qualité de l’enseignant influe directement sur les performances de l’élève.
Le processus comprend :
Évaluez le modèle distillé pour vérifier qu’il répond aux critères attendus. Mesures courantes :
Je traite l’évaluation des LLM plus en détail dans cet article : LLM Evaluation: Metrics, Methodologies, Best Practices.
Malgré ses atouts, la distillation présente des défis qu’il faut anticiper pour réussir sa mise en œuvre.
Un risque majeur est la perte d’informations fines. Certaines nuances du professeur peuvent ne pas être pleinement captées par l’élève, surtout pour des tâches nécessitant une compréhension approfondie ou experte.
Pour atténuer ce risque :
Un réglage soigné est vital. Des hyperparamètres comme la température et le taux d’apprentissage influencent fortement l’apprentissage de l’élève :
L’évaluation est indispensable pour vérifier que le modèle distillé répond aux critères de performance, en comparaison avec le professeur et d’autres bases de référence.
Concentrez-vous notamment sur :
Respecter quelques principes accroît l’efficacité de la distillation : expérimentation, évaluation continue et mise en œuvre stratégique.
La distillation d’LLM évolue rapidement. Voici les tendances, défis actuels et techniques émergentes.
Les recherches récentes proposent de nouvelles techniques et architectures pour rendre la distillation plus efficace. Parmi elles :
Malgré les progrès, plusieurs défis demeurent :
De nouvelles approches voient le jour pour relever ces défis et faire avancer le domaine :
La distillation d’LLM est une technique clé pour rendre les grands modèles de langage plus pratiques et efficaces. En transférant l’essentiel du savoir d’un professeur complexe vers un élève plus compact, elle préserve les performances tout en réduisant la taille et les besoins de calcul.
Ce procédé ouvre la voie à des applications d’IA plus rapides et accessibles, du NLP temps réel à des usages spécialisés en santé et en finance. La mise en œuvre demande de la préparation et les bons outils, mais les gains — coûts moindres et déploiements plus larges — sont considérables.
À mesure que la recherche progresse, la distillation jouera un rôle croissant pour démocratiser l’IA, en rendant des modèles puissants plus accessibles et utilisables dans des contextes variés.
Formez-vous aux LLM avec ces cours !
Cours
Cours
Cours