
课程
AI 安全与风险管理
2 小时
11.8K
实践并学习路径你的进步。
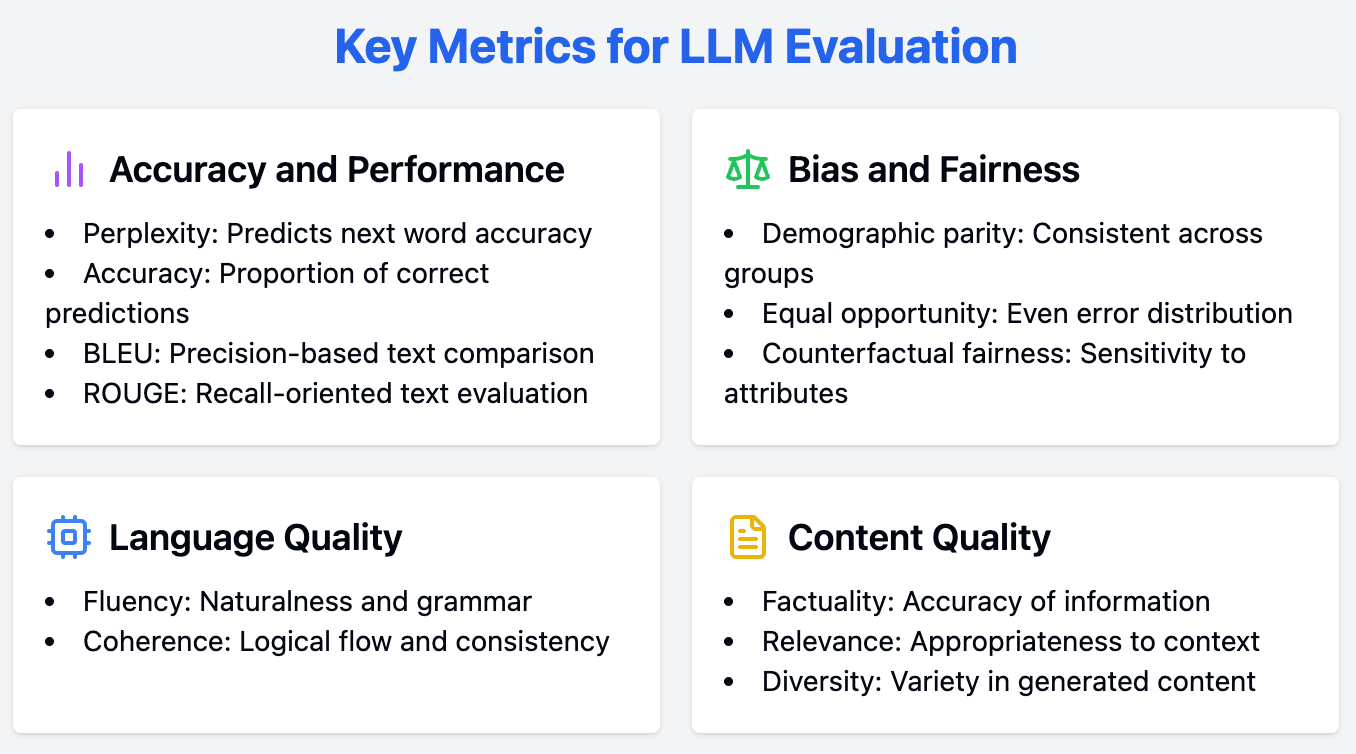
使用 Google 继续评估 LLM 需要综合方法,采用多种度量来衡量其表现的不同方面。本文将探讨 LLM 的关键评估标准,包括准确性与性能、偏见与公平性,以及其他重要指标。
准确衡量性能是理解 LLM 能力的重要一步。本节将深入介绍用于评估准确性与性能的主要指标。
困惑度是评估与衡量 LLM 预测序列下一个词能力的基础指标。其计算方式大致如下:
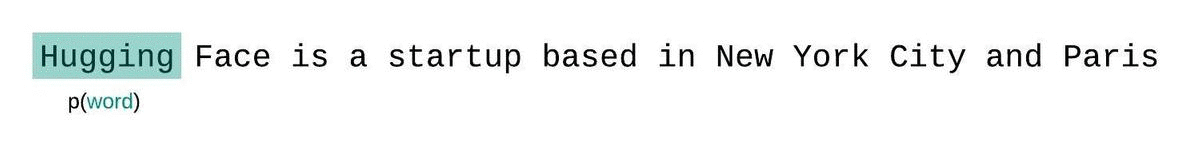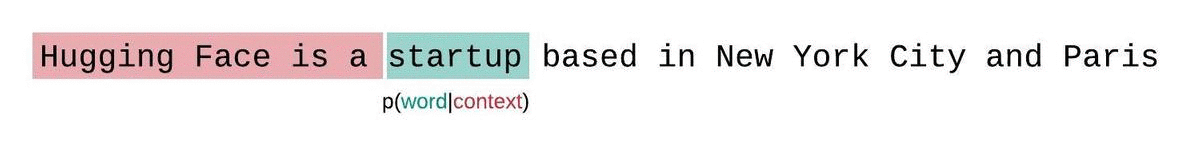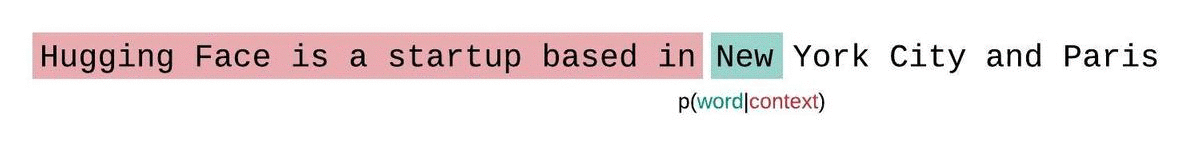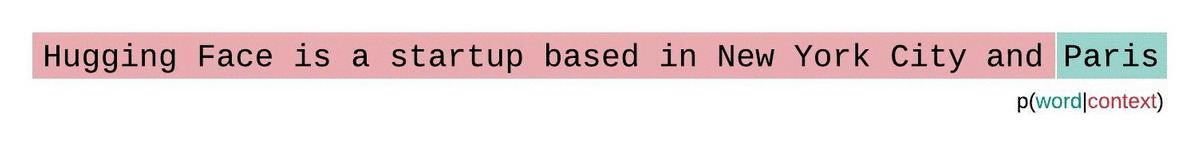
更低的困惑度分数表明模型对下一个词的预测更准确,反映出更佳的性能。本质上,它量化了一个概率分布或预测模型对样本的预测程度。
对于 LLM,较低的困惑度意味着模型对其词预测更有把握,从而生成更连贯、语境更契合的文本。
准确率是分类任务中广泛使用的指标,表示模型做出正确预测的比例。尽管该指标通常直观,但在开放式生成任务中往往可能产生误导。
例如,在生成具有创造性或语境细微差别的文本时,输出的“正确性”并不像情感分析或主题分类等任务那样容易定义。因此,尽管准确率对特定任务有用,但评估 LLM 时应辅以其他指标。
BLEU(Bilingual Evaluation Understudy)与 ROUGE(Recall-Oriented Understudy for Gisting Evaluation)用于通过与参考文本对比来评估生成文本的质量。
BLEU 侧重精确率:如果机器翻译使用的词语与人工翻译完全一致,就会获得较高的 BLEU 分数。例如,若人工参考为“The cat is on the mat.”,机器输出为“The cat sits on the mat.”,由于词语高度重合,BLEU 分数会较高。
ROUGE 则侧重召回率:它检查机器生成文本是否涵盖了人工参考中的所有重要观点。比如,人工撰写的摘要为“The study found that people who exercise regularly tend to have lower blood pressure.”,如果 AI 生成的摘要是“Exercise linked to lower blood pressure.”,尽管表述不同,但因抓住了要点,ROUGE 会给出较高分数。
这些指标对机器翻译、摘要与文本生成等任务尤为有益,能够量化模型输出与人工参考文本的一致程度。
确保公平并降低偏见对 LLM 的公平应用至关重要。以下是评估 LLM 偏见与公平性的关键指标。
人口统计均衡指模型在不同人口群体间的表现是否一致。它评估由种族、性别或年龄等属性定义的各群体中正向结果的比例。
实现人口统计均衡意味着模型的预测不偏向任何特定群体,从而确保其应用中的公平与公正。
机会均等等指标关注模型错误是否在不同人口群体间均衡分布。它评估各群体的假阴性率,验证模型是否不会对某些群体产生不成比例的失败。
该指标在强调公平与平等准入的应用中至关重要,如招聘算法或贷款审批流程。
反事实公平评估:如果某些敏感属性发生变化,模型的预测是否会随之改变。其方法是生成反事实样本,在保持其他特征不变的情况下,改变敏感属性(如性别或种族)。
若模型预测会因该变化而改变,则表明与该敏感属性相关的偏见。反事实公平有助于识别与缓解其他指标未必能显现的偏见。
除性能与公平之外,其他评估标准也有助于对 LLM 进行全面考察。本节重点介绍这些方面。
流畅度评估生成文本的自然程度与语法正确性。一个流畅的 LLM 能产出易读易懂、贴近人类语言表达的文本。
可通过自动化工具或人工评审进行,关注语法、句法与整体可读性等方面。
连贯性用于分析生成文本的逻辑流与一致性。连贯的文本在结构与思想推进上清晰有序,便于读者理解。对于论文或文章等篇幅较长的文本,保持一致的叙述尤为重要。
事实性评估 LLM 提供信息的准确度,尤其在信息检索类任务中。该指标确认模型生成的文本不仅看似合理,而且在事实层面正确。
事实性对于新闻生成、教育内容与客户支持等以提供准确信息为主要目标的应用不可或缺。
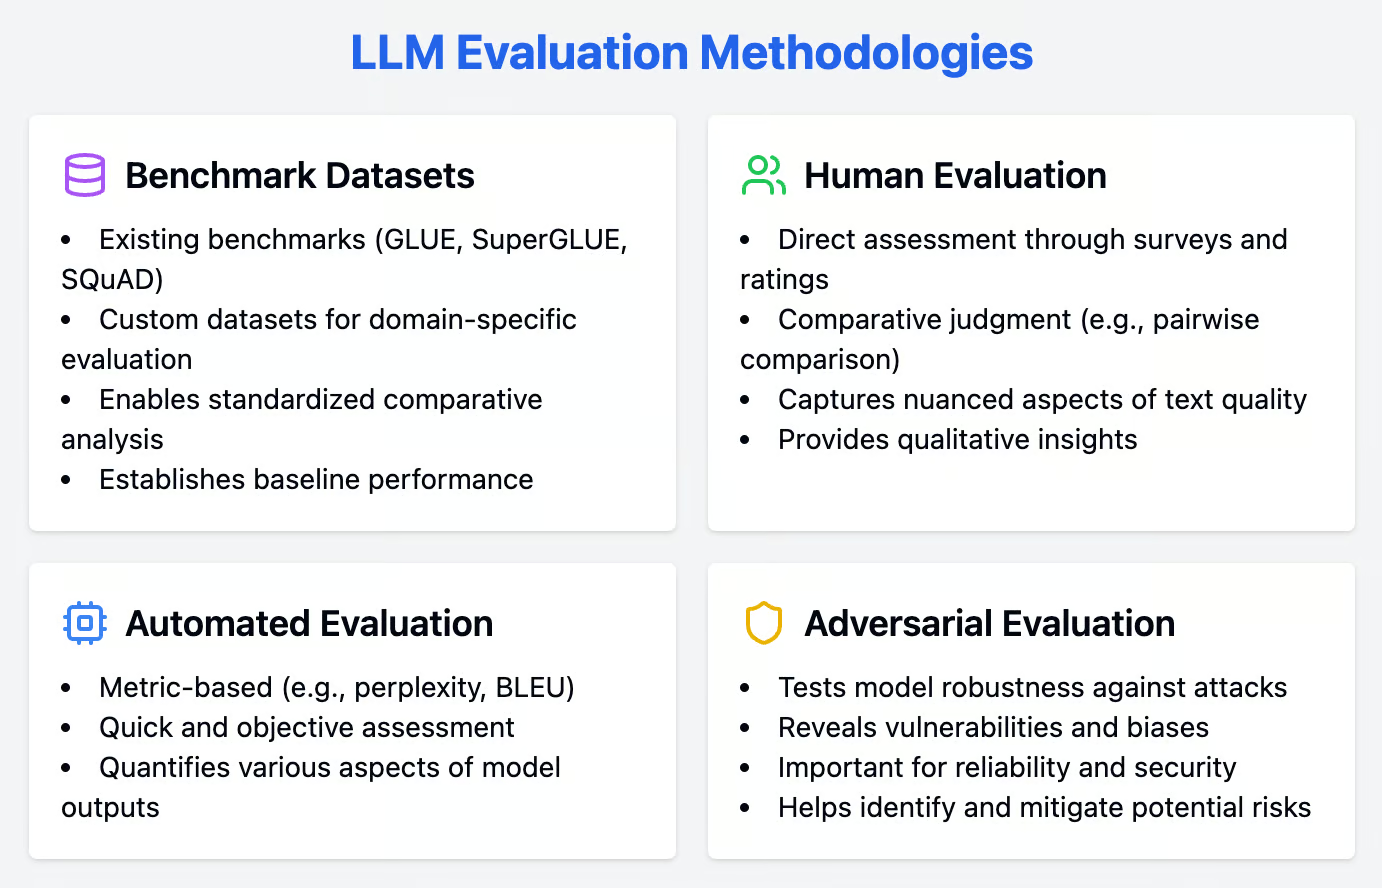
对 LLM 的稳健评估需要结合定量与定性方法。本节将介绍多种方法,如基准数据集、人工评估技术与自动化评估方法,以全面检验 LLM 的表现。
基准数据集是评估 LLM 的有力工具,提供标准化任务,便于不同模型间的对比分析。它们有助于建立性能基线,并推动基准测试。
基准数据集是评估 LLM 的重要工具,提供标准化任务,便于不同模型间的对比分析。以下是一些针对各类自然语言处理(NLP)任务的常用基准数据集:
尽管现有基准极为有用,构建自定义数据集对于特定领域的评估同样关键。自定义数据集可使评估过程贴合具体应用或行业的独特需求与挑战。
例如,某医疗机构可以构建由病历与临床记录组成的数据集,以评估 LLM 处理医学术语与语境的能力。自定义数据集可确保模型表现契合真实场景,提供更具相关性与可操作性的洞见。
人工评估方法对于衡量自动化指标可能忽视的细微层面不可或缺。此类技术依赖人类评审的直接反馈,提供关于模型表现的定性见解。
人工评估仍是衡量 LLM 输出质量的金标准。直接评估方法通过问卷与评分量表收集评审意见。
此类方法可捕捉文本质量的细微方面,如流畅度、连贯性与相关性,而这些往往是自动化指标难以覆盖的。评审者还能就具体优劣势提供定性反馈,帮助定位改进方向。
比较判断采用成对比较等技术,让评审者直接对比不同模型的输出。相较绝对评分量表,此法更能降低个体评分的主观性,从而更可靠。
评审者需从成对生成文本中选出更优者,以提供相对排序。比较判断对于微调模型与选择最佳变体尤为有用。
自动化评估方法能够快速、客观地衡量 LLM 表现。它们采用多种指标量化模型输出的不同方面,确保评估全面。
自动化指标提供了快速客观的评估途径。诸如困惑度与 BLEU 等指标被广泛用于评估文本生成的不同维度。
如前所述,困惑度衡量模型的预测能力,分数越低表示性能越好。另一方面,BLEU 通过与参考文本对比来评估生成文本的质量,侧重于n 元语法(n-grams)的精确性。
对抗性评估是指让 LLM 遭受对抗性攻击以测试其鲁棒性。这些攻击旨在利用模型的弱点与偏见,揭示常规评估方法未必显现的脆弱点。
对抗性攻击可能向模型输入略作修改或带有误导性的数据,以分析其响应。这种方法适用于高度重视可靠性与安全性的应用,有助于识别并缓解潜在风险。
要有效评估 LLM 的能力,应遵循系统性的策略。采用最佳实践可确保评估过程全面、透明,并贴合您的独特需求。以下为应遵循的最佳实践。
|
最佳实践 |
说明 |
示例场景 |
相关指标 |
|
明确目标 |
在开始评估前确定 LLM 应实现的任务与目标。 |
提升某 LLM 的机器翻译性能 |
BLEU/ROUGE 分数 |
|
考虑受众 |
根据 LLM 的目标用户进行评估,兼顾其期望与需求。 |
用于生成文本的 LLM |
困惑度、流畅度、连贯性 |
|
透明与可复现 |
确保评估过程有充分文档记录,并可由他人复现实证与改进。 |
公开发布用于评估 LLM 能力的数据集与代码 |
任何与具体任务与目标相符的相关指标 |
本指南全面梳理了评估 LLM 的关键指标与方法,从困惑度与准确率到偏见与公平性的衡量。
通过结合定量与定性的评估技术并遵循最佳实践,我们能够对这些模型进行全面而可靠的评估。
掌握上述知识后,我们将更有能力选择与部署最契合需求的 LLM,确保其在所选应用中的最佳性能与可靠性。
精选 AI 课程
课程
课程
实践并学习路径你的进步。
使用 Google 继续