

{count, plural, other {课程}}
构建可扩展的 Agentic 系统
{hours} 小时 {minutes} 分钟
22K
OpenAI 的最新消息对 GPT-5 mini 用户尤其有吸引力:全新的 GPT-5.4 mini 模型速度提升一倍,并在各方面带来更好的表现。此外,OpenAI 还发布了其最高效模型类别的最新版本 GPT-5.4 nano。
在本文中,我们将为您介绍 GPT-5.4 mini 和 nano 是什么、与 GPT-5.4 相比表现如何,以及哪些人能从 OpenAI 最新的“快车道”模型中受益。
同时,别忘了查看我们的 GPT-5.4 与 Claude Opus 对比,以及我们的 OpenAI Frontier 指南。
GPT-5.4 mini 是 OpenAI 最新的小型 LLM,用于替代 GPT-5 mini。它在延续前代模型的基础上带来多项显著性能提升,同时速度翻倍,这是其主要卖点之一。
在 API 中,它支持广泛的功能:
GPT-5.4 nano 是 OpenAI 最新模型系列中最小的版本,用于替代 GPT-5 nano。顾名思义,它比 mini 模型更高效,但性能更低一些。不过,在许多基准测试中,GPT-5.4 nano 依然优于旧的 mini 模型 GPT-5 mini。
它所支持的功能不如 mini 模型全面,但提供了当今常见的 API 功能,如图像输入、工具使用、函数调用和结构化输出。
此次更新在选择合适模型时提供了更多灵活性,需要在性能与时延、价格之间做经典权衡。
OpenAI 建议将 mini 和 nano 用于不希望出现卡顿的应用。基本上,凡是需要即时响应、用户对延迟非常不耐受的场景,都适合使用这两类模型。
对于需要强推理且容错空间很小的任务、多模态场景,以及具备代理能力的任务,GPT-5.4 仍是首选。
让我们来看一下 LLM 基准测试。有一些值得注意的结果:
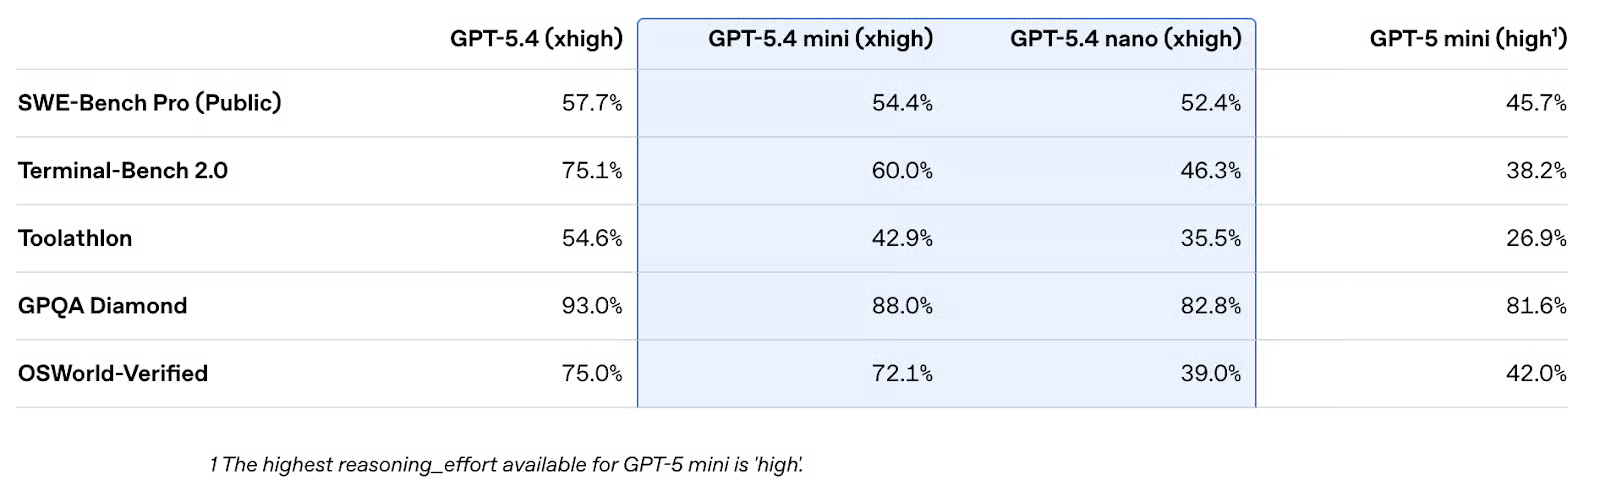
另一个令我们立刻注意到的点是,(几乎)所有类别中的分数排序都一致:GPT-5.4 > GPT-5.4 mini > GPT-5.4 nano > GPT-5 mini。在所有已公布的分数中,唯一的例外是旧的 mini 模型在视觉与计算机操作领域胜过了 GPT-5.4 nano,而这并非 nano 的目标方向。
不过,目前还不清楚新的“xhigh”推理强度等级能带来多大差异,此前的 GPT-5 mini 并不具备该选项。
当然,性能并非一切。正如 OpenAI 提供的图表所示,他们试图强调边际收益递减这一点。在四款对比模型中,GPT-5.4 最慢且最昂贵。
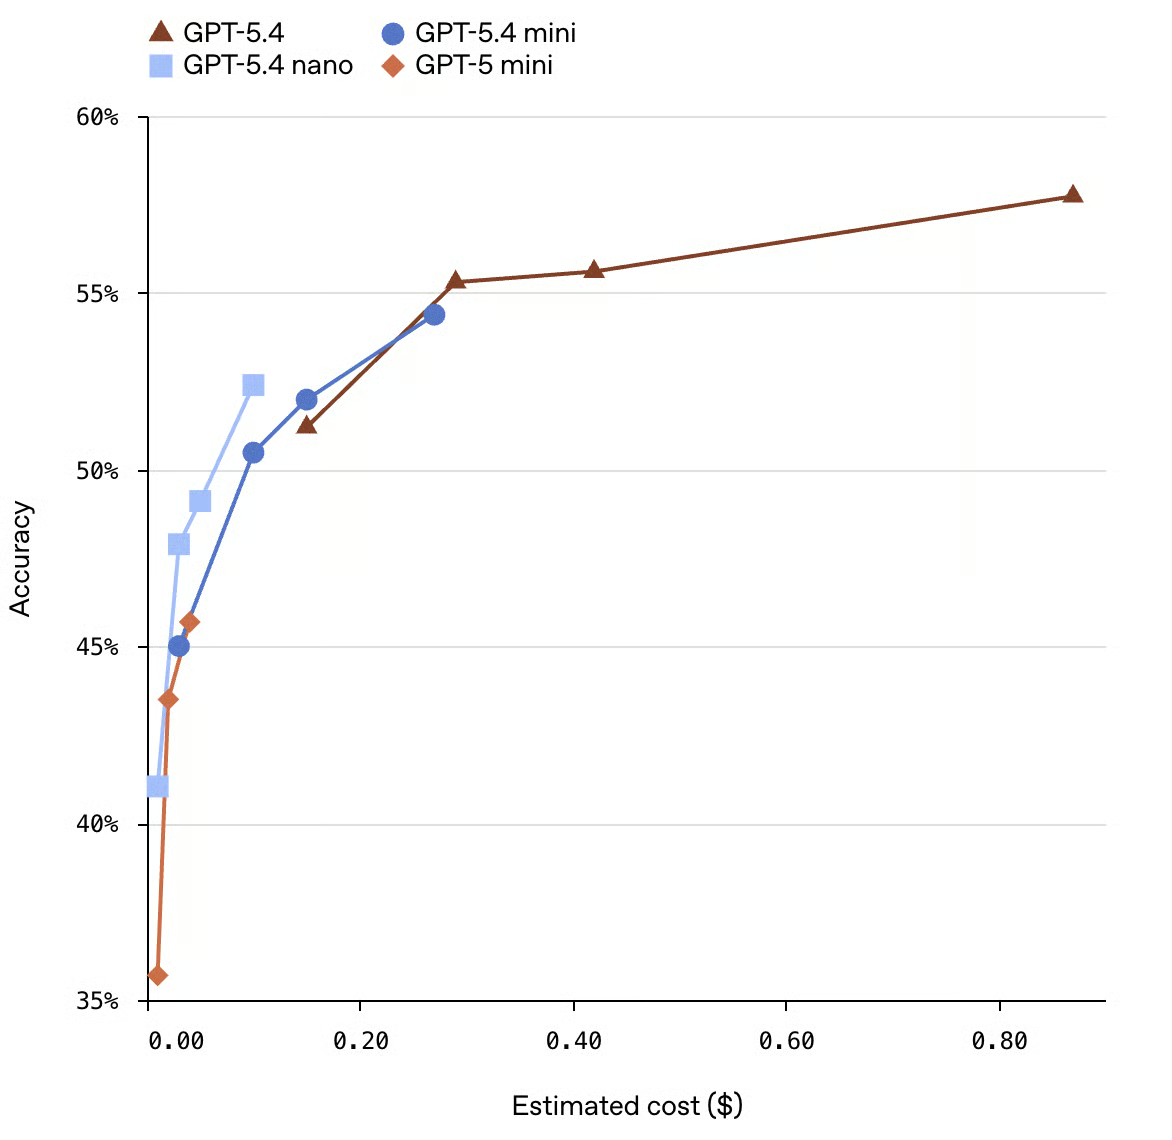
这些曲线展示了边际收益递减:您可以投入更多算力/资金来提升模型,只能获得有限的精度增益,且提升幅度会越来越小。GPT-5.4 最后的几个百分点成本远高于最初的几个百分点。这类图表有助于工程师判断,在特定应用中,为了额外 3–4% 的精度是否值得付出相应成本。
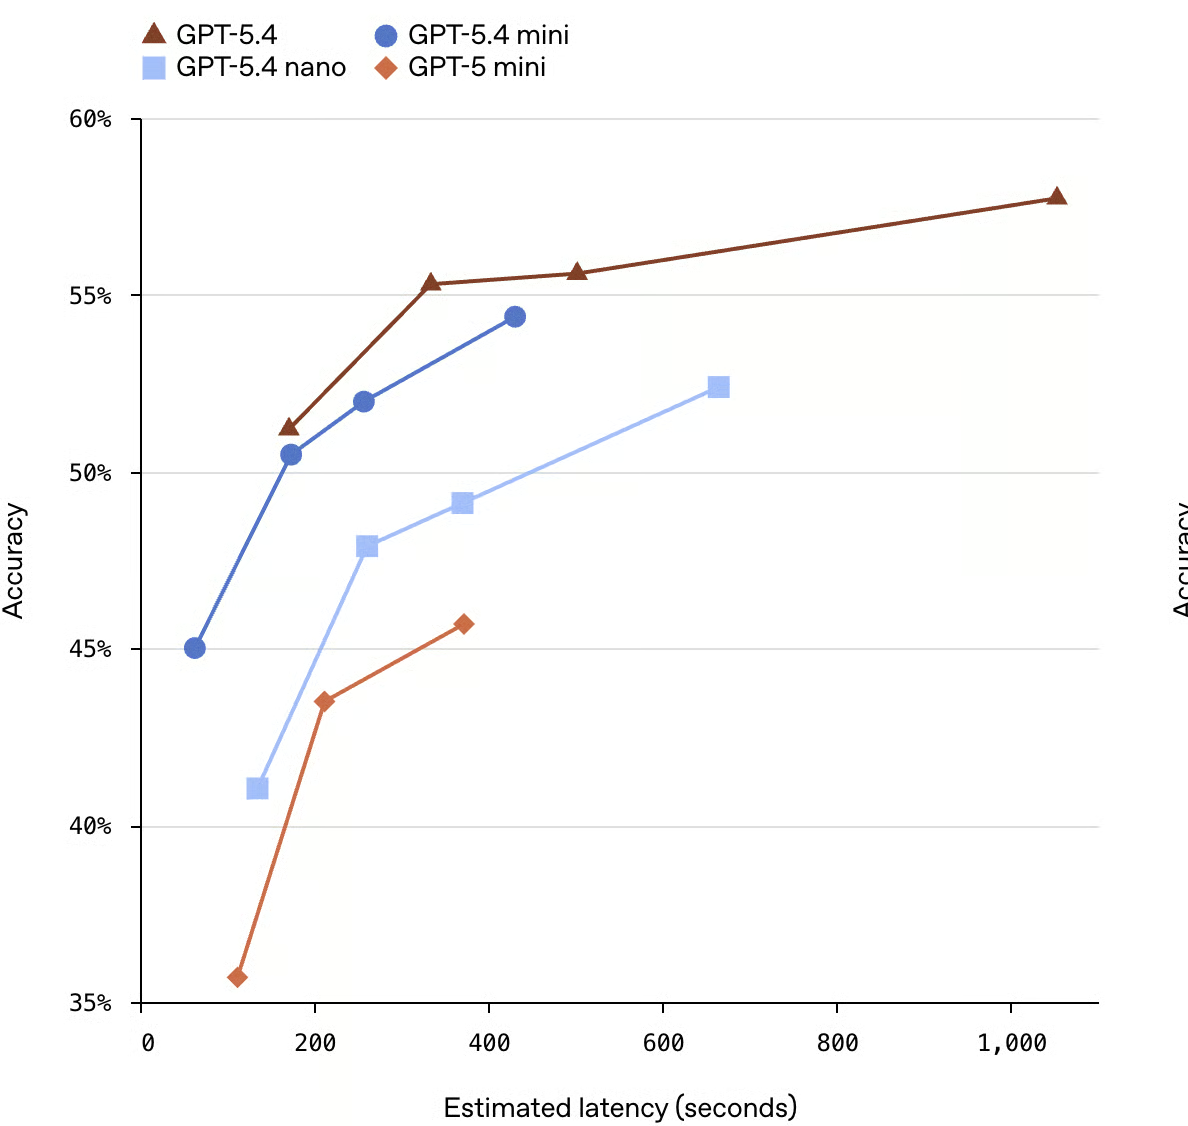
不过我们也必须对该图进行审慎解读:纵轴从 35% 开始,而非 0%。这确实会夸大不同模型之间的视觉差异。与从 0% 开始的图相比,从 35% 开始的图上,GPT-5.4 相对 GPT-5 mini 的领先幅度看起来更大。
此外,OpenAI 指出这些时延数据并非来源于真实的生产环境,而是建模估算。这里有一点不太一致:OpenAI 就基础设施决策提出了不少建议,但图表却只给出了建模估算。
我们也觉得不带误差线的建模估算有些奇怪。如果 OpenAI 选择加入误差线,我敢打赌其中会有不少重叠。
您现在应该已经可以在 ChatGPT 浏览器界面、Codex 和 API 中使用 GPT‑5.4 mini。在 ChatGPT 中,它是 Free 和 Go 层用户的默认“Thinking”模型,也是其他用户在达到 GPT-5.4 Thinking 速率上限后的回退模型。
不过,GPT‑5.4 nano 目前仅通过 API 提供。
GPT-5.4 mini 的价格为每 100 万输入 Token 0.75 美元、每 100 万输出 Token 4.50 美元。再次强调,GPT‑5.4 nano 仅在 API 中提供,价格为每 100 万输入 Token 0.20 美元、每 100 万输出 Token 1.25 美元。上述价格均对应 400k 的上下文窗口。
显然,这比 OpenAI 的旗舰模型(每 100 万输入/输出 Token 分别为 2.50/15 美元)便宜得多。
真正有意思的是,GPT-5.4 nano 的定价低于许多竞争对手的低性能小模型,尤其是 Claude Haiku 4.5,其价格为每百万输入 Token 1 美元、每百万输出 Token 5 美元。也就是说,OpenAI 在两项定价上都压低了 Claude Haiku。
但在测试中,这些模型表现如何?两者对比略显棘手,因为评测所用的测试变体不同。SWE-bench 的结果完全不可比,因为版本不同。Claude Haiku 4.5 在 SWE-bench Verified 上的得分为 73.3%,而 GPT-5.4 nano 在 SWE-bench Pro(Public)上的得分为 52.4%。Pro 是更难、也更近期的测试。
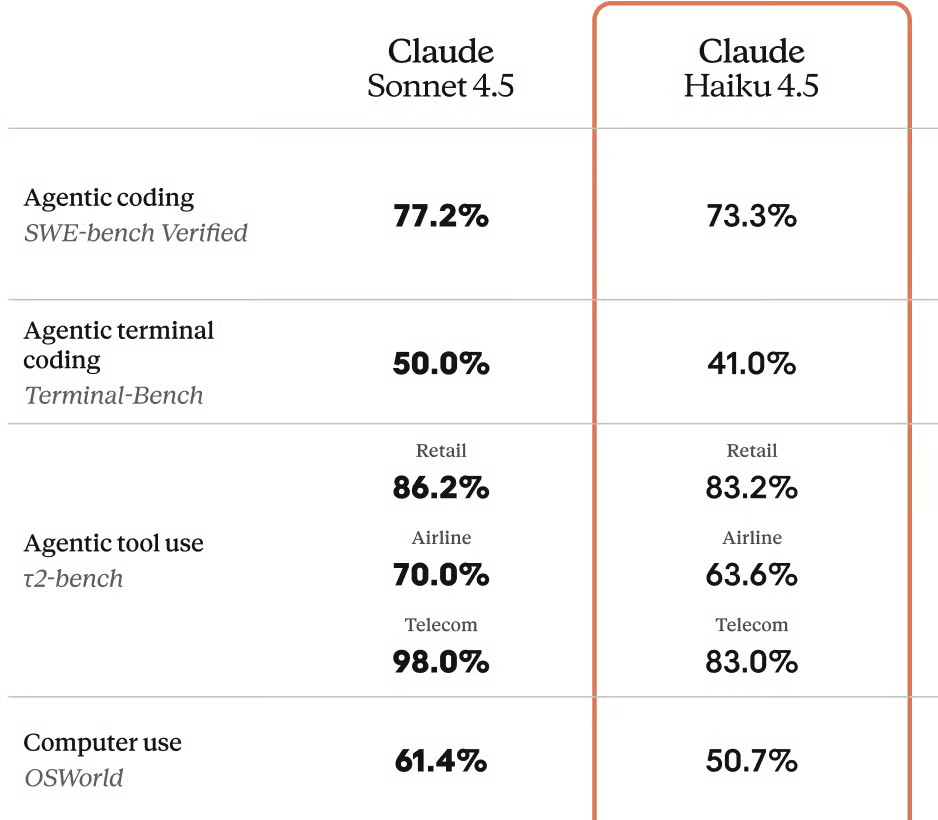
Claude Haiku 4.5 在 OSWorld 上的得分为 50.7%
在两项最干净、可一一对应的对比中,GPT-5.4 nano 均领先。
不过,在 OSWorld 的计算机操作方面,Haiku 4.5 或许占优,但同样由于基准测试变体不同,比较并不轻松。
OSWorld-Verified 更难,但近 12% 的差距看起来相当显著。我们在评价这一差距时更为谨慎,因为与 SWE-bench Verified 和 SWE-bench Pro 不同——在那两者中已知在 Verified 表现出色的模型在 Pro 中往往更差——目前缺少足够证据表明 OSWorld 与 OSWorld-Verified 之间也存在同样的规律。
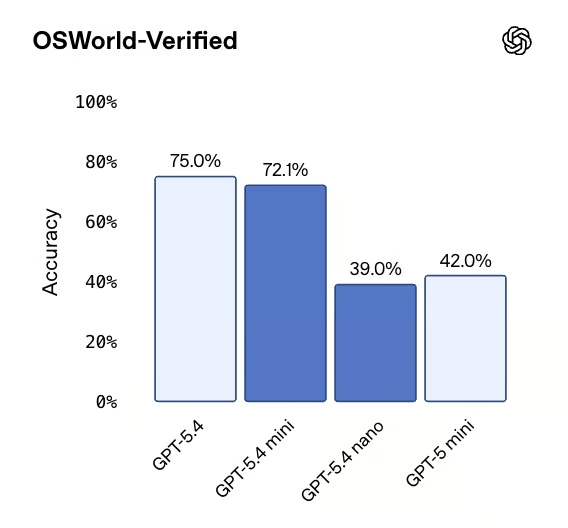
GPT-5.4 nano 在 OSWorld-Verified 上的得分为 39%
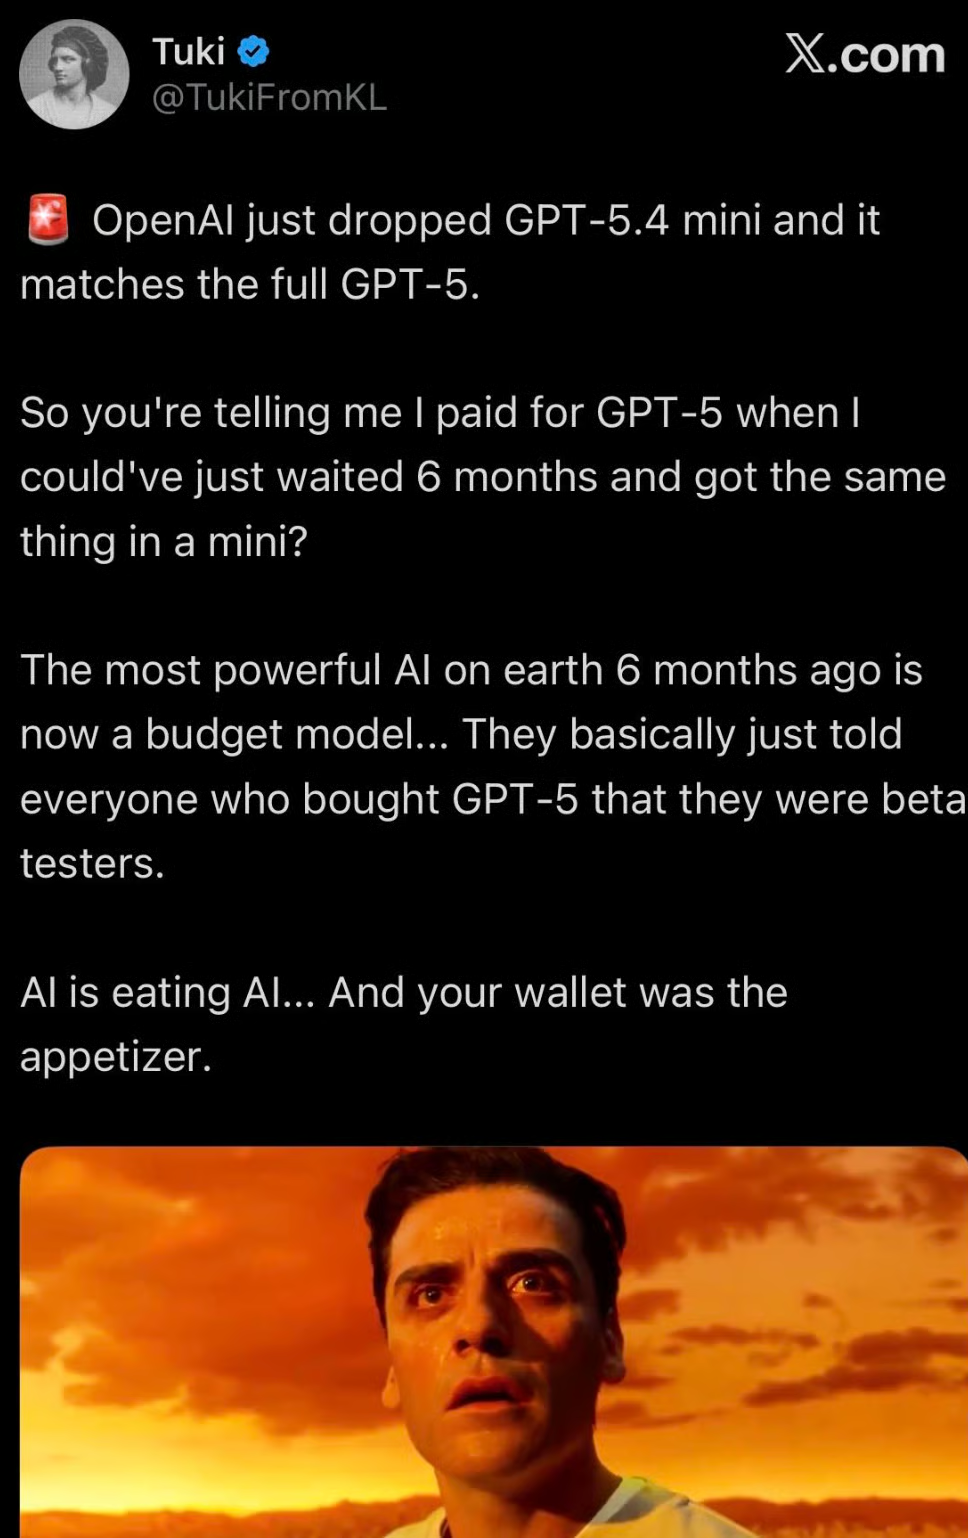
许多线上反馈指出一个在科技行业屡见不鲜的规律:去年的旗舰成为今年的免费层。这些都在预料之中,但变化的速度仍令人惊讶。
有人说前沿 AI 的“折旧”速度是有史以来最快的。人们在想,您今天花高价购买的模型,六个月后是否仍然物有所值。有时,开发者也许并不想简单替换模型,特别是当他们已经进行了微调,或已经做过成本与性能的校准时。
基准测试呈现出一条清晰的性能阶梯:从 GPT-5.4 到 5.4 mini 再到 5.4 nano。但对许多任务而言,实际选择更多取决于时延和预算,而不是再去挤出几个百分点的精度。
对于许多生产应用,GPT-5.4 mini 可成为很好的新默认选择,因为它的质量足以让人感到前沿,同时在高吞吐使用下也足够便宜且快速。
GPT-5.4 nano 更像是面向大型实时、高度敏感时延工作负载的专家型模型。它也非常适合作为子代理,处理由高性能 Thinking 模型下放的、更容易的“批量”工作。
在一个“去年的旗舰成为今年的 mini”的世界里,设计能够轻松替换模型的系统,比针对单个模型版本进行优化更优。推荐学习我们的课程 Building Scalable Agentic Systems,该课程正面回应了这个问题,并教您使用如 Model Context Protocol(MCP) 等代理框架。
代理型 AI 课程
{count, plural, other {课程}}
{count, plural, other {学习路径}}
{count, plural, other {学习路径}}