

कोर्स
स्केलेबल एजेंटिक सिस्टम बनाना
1 घंटा 30 मिनट
21.6K
OpenAI की ताज़ा खबरें GPT-5 mini के उपयोगकर्ताओं के लिए खास तौर पर दिलचस्प हैं: नया GPT-5.4 mini मॉडल दोगुना तेज़ है और हर क्षेत्र में बेहतर प्रदर्शन लाता है। इसके साथ ही, OpenAI ने अपनी सबसे दक्ष मॉडल श्रेणी का नवीनतम संस्करण GPT-5.4 nano भी जारी किया है।
इस लेख में, हम बताएंगे कि GPT-5.4 mini और nano क्या हैं, ये GPT-5.4 की तुलना में कैसा प्रदर्शन करते हैं, और OpenAI के नवीनतम “फास्ट लेन” मॉडलों से किसे सबसे ज़्यादा फ़ायदा हो सकता है।
हमारा GPT-5.4 बनाम Claude Opus तुलना और OpenAI Frontier गाइड भी ज़रूर देखें।
GPT-5.4 mini OpenAI का नवीनतम छोटा LLM है, जो GPT-5 mini की जगह लेता है। यह अपने पूर्ववर्ती के प्रदर्शन में कई महत्वपूर्ण सुधार लाता है और दोगुना तेज़ है—जो इसका एक बड़ा आकर्षण है।
API में, यह कई सुविधाओं का व्यापक दायरा सपोर्ट करता है:
GPT-5.4 nano OpenAI की नई मॉडल लाइन का सबसे छोटा संस्करण है, जो GPT-5 nano की जगह लेता है। नाम से ही स्पष्ट है कि यह mini मॉडल से भी अधिक दक्ष है, हालांकि प्रदर्शन थोड़ा कम है। फिर भी, GPT-5.4 nano कई बेंचमार्क में पुराने mini मॉडल GPT-5 mini को पछाड़ता है।
यह mini मॉडल जितनी सुविधाएँ सपोर्ट नहीं करता, लेकिन आज की मानक API सुविधाएँ—जैसे इमेज इनपुट, टूल उपयोग, फ़ंक्शन कॉलिंग, और स्ट्रक्चर्ड आउटपुट—प्रदान करता है।
नया रिलीज़ सही मॉडल चुनने में लचीलापन देता है—एक तरफ़ प्रदर्शन, और दूसरी तरफ़ विलंबता (latency) और कीमत के बीच क्लासिक संतुलन को देखते हुए।
OpenAI mini और nano की सिफारिश उन डेवलपर्स के लिए करता है जो ऐसे ऐप्लिकेशन बना रहे हैं जहाँ आप देरी नहीं चाहते। यानी, जहाँ इंटरफ़ेस को तुरंत प्रतिक्रिया देनी चाहिए और उपयोगकर्ता विलंब को बर्दाश्त नहीं करेंगे।
जहाँ गहन तर्क (reasoning), कम त्रुटि-सहनशीलता, मल्टीमॉडलिटी और एजेंटिक कार्य ज़रूरी हों, वहाँ GPT-5.4 पहली पसंद बना रहता है।
आइए LLM बेंचमार्क पर नज़र डालें। कुछ उल्लेखनीय परिणाम:
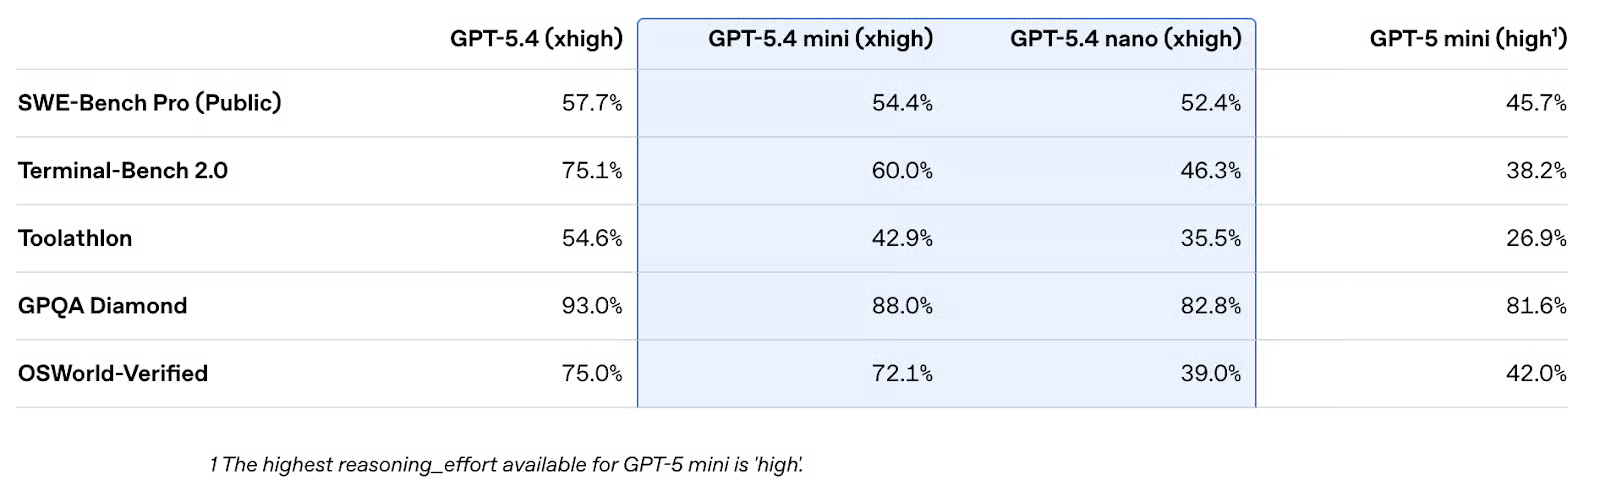
एक और बात जिसने हमें तुरंत ध्यान खींचा, वह यह कि (लगभग) सभी श्रेणियों में बेंचमार्क स्कोर का क्रम एक जैसा रहा: GPT-5.4 > GPT-5.4 mini > GPT-5.4 nano > GPT-5 mini। प्रकाशित सभी स्कोरों में, एकमात्र अपवाद यह था कि पुराना mini मॉडल विज़न और कंप्यूटर-उपयोग डोमेन में GPT-5.4 nano से आगे रहा—जो nano के लक्ष्य क्षेत्र नहीं हैं।
हालाँकि, यह स्पष्ट नहीं है कि नए “xhigh” reasoning effort स्तर से कितना फ़र्क पड़ता है, जो GPT-5 mini के लिए उपलब्ध नहीं था।
परफ़ॉर्मेंस ही सब कुछ नहीं होता। OpenAI घटते प्रतिफल (diminishing returns) का बिंदु भी रेखांकित कर रहा है, जैसा कि उनके दिए ग्राफ़ में दिखता है। तुलना किए गए चार मॉडलों में GPT-5.4 सबसे धीमा और सबसे महँगा है।
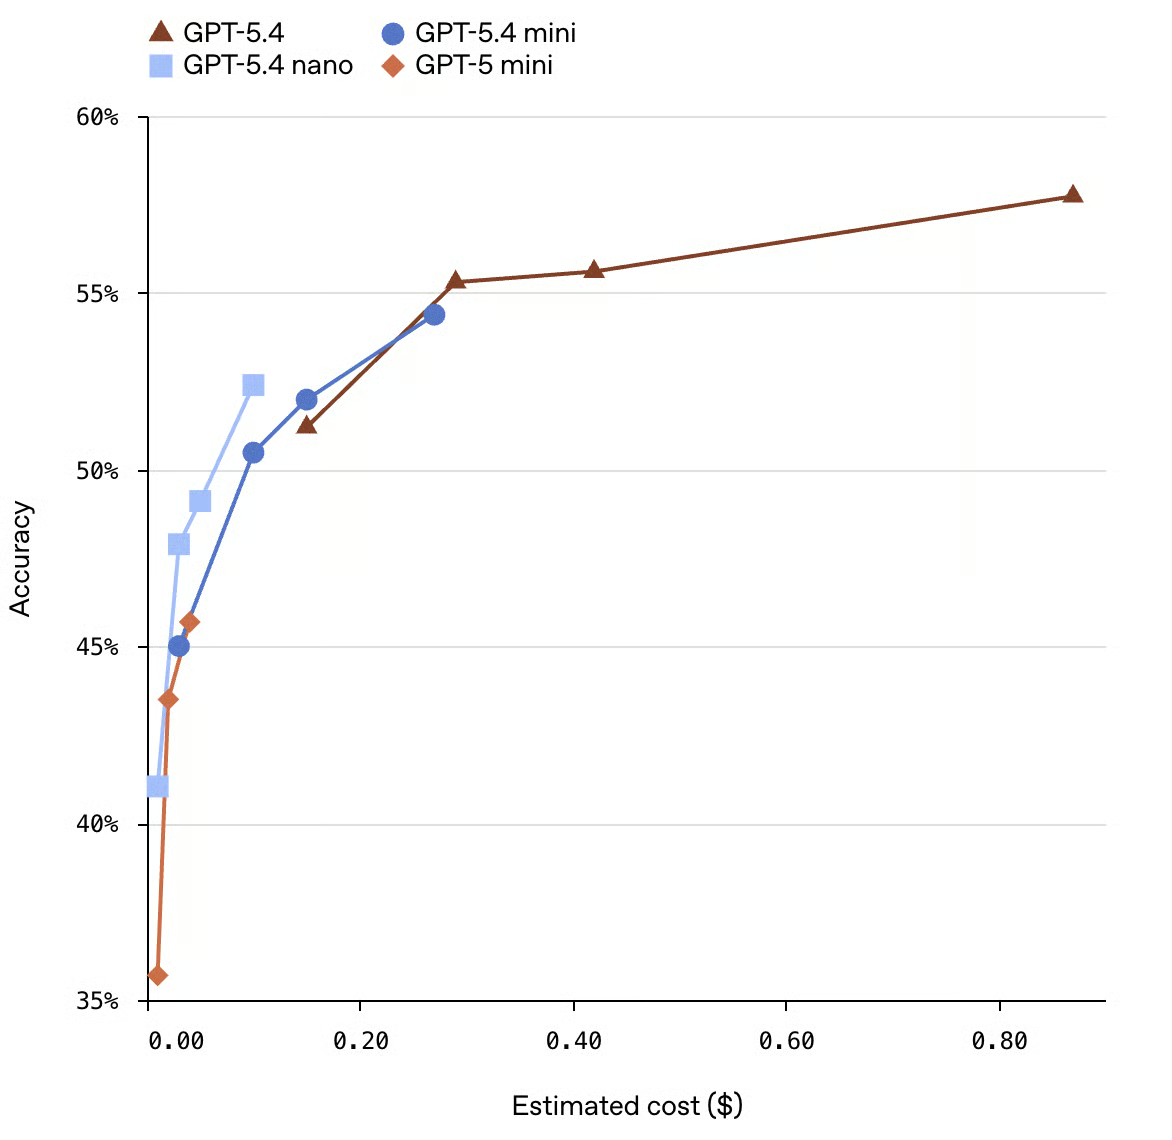
कर्व घटते प्रतिफल दर्शाते हैं: आप मॉडल पर अधिक कंप्यूट/पैसा खर्च करें तो सटीकता में मामूली बढ़त मिलती है, पर छलांगें छोटी होती जाती हैं। GPT-5.4 के अंतिम कुछ प्रतिशत अंकों की कीमत शुरुआती अंकों से काफ़ी ज़्यादा होती है। इस तरह के चार्ट इंजीनियरों को तय करने में मदद करते हैं कि उनकी विशिष्ट ऐप्लिकेशन में अतिरिक्त 3–4% सटीकता वाकई लागत के लायक है या नहीं।
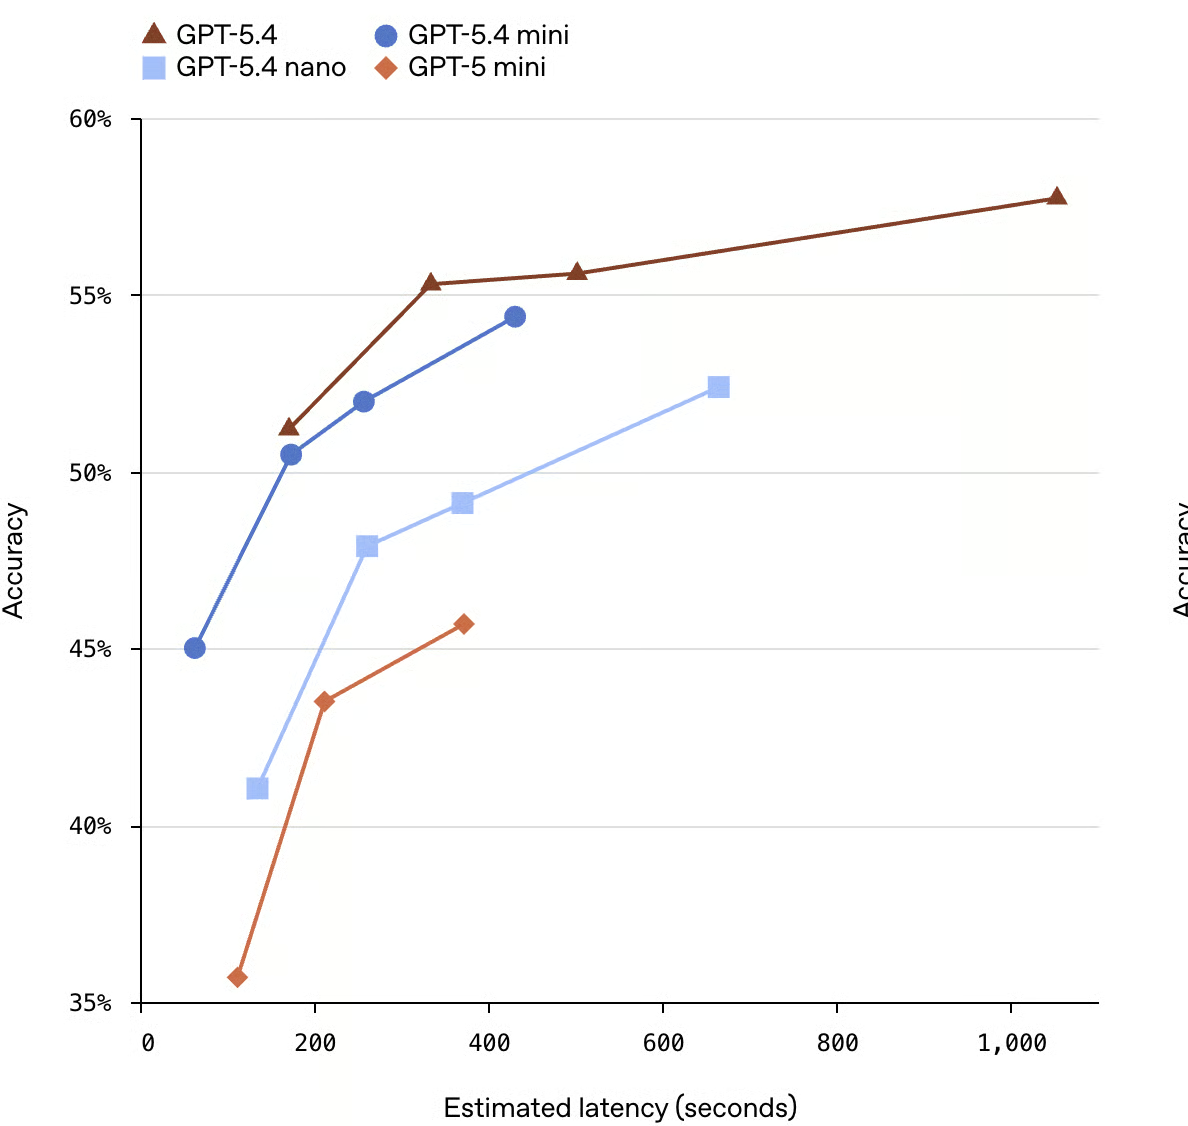
फिर भी, हम इस ग्राफ़ का आलोचनात्मक मूल्यांकन करने के लिए बाध्य महसूस करते हैं: Y-अक्ष 0% से नहीं, 35% से शुरू होता है। इससे मॉडलों के बीच दृश्य अंतर वाकई बढ़ा-चढ़ा कर दिखता है। 35% से शुरू होने वाले चार्ट में GPT-5.4 की बढ़त GPT-5 mini पर जितनी दिखाई देती है, 0 से शुरू होने पर उतनी बड़ी नहीं लगेगी।
साथ ही, OpenAI बताता है कि ये विलंबता आँकड़े वास्तविक प्रोडक्शन रन से नहीं हैं; ये मॉडल्ड अनुमान हैं। इसमें थोड़ा असंगत सा लगता है—OpenAI इंफ्रास्ट्रक्चर निर्णयों पर कई सुझाव दे रहा है, और उनका चार्ट सिर्फ़ मॉडलिंग अनुमान दिखाता है।
हमें बिना एरर बार के मॉडलिंग अनुमानों को देखना भी अटपटा लगता है। मेरा मानना है कि अगर OpenAI ने एरर बार शामिल किए होते, तो वे काफ़ी हद तक ओवरलैप करते।
आपको ChatGPT ब्राउज़र UI, Codex और API में GPT‑5.4 mini पहले से दिख जाना चाहिए। ChatGPT में, यह Free और Go टियर के उपयोगकर्ताओं के लिए डिफ़ॉल्ट “Thinking” मॉडल है, और अन्य सभी उपयोगकर्ताओं के लिए फ़ॉलबैक मॉडल जो अपने GPT-5.4 Thinking रेट-लिमिट तक पहुँच चुके हैं।
हालाँकि, GPT‑5.4 nano केवल API के माध्यम से उपलब्ध है।
GPT-5.4 mini की कीमत 1M इनपुट टोकन पर $0.75 और 1M आउटपुट टोकन पर $4.50 है। GPT‑5.4 nano, जो फिर से सिर्फ़ API में उपलब्ध है, की कीमत 1M इनपुट टोकन पर $0.20 और 1M आउटपुट टोकन पर $1.25 है। इन कीमतों पर आपको 400k कॉन्टेक्स्ट विंडो मिलती है।
यह स्पष्ट रूप से OpenAI के फ़्लैगशिप मॉडल ($2.50/$15 प्रति 1M इनपुट/आउटपुट) से काफ़ी सस्ता है।
सबसे दिलचस्प बात यह है कि GPT-5.4 nano की कीमत कई प्रतिस्पर्धियों के कम-प्रदर्शन वाले छोटे मॉडलों से भी कम है—विशेषकर Claude Haiku 4.5, जिसकी कीमत 1M इनपुट टोकन पर $1 और 1M आउटपुट टोकन पर $5 है। यानी OpenAI ने दोनों ही मामलों में Claude Haiku की कीमतों को कम करके दिखाया है।
लेकिन टेस्ट में मॉडल कैसे तुलना करते हैं? तुलना थोड़ी मुश्किल है क्योंकि इन्हें अलग-अलग टेस्ट वेरियंट्स पर आँका गया है। SWE-bench के परिणाम बिल्कुल तुलनीय नहीं हैं क्योंकि इनके संस्करण पूरी तरह अलग हैं। Claude Haiku 4.5 का SWE-bench Verified पर स्कोर 73.3% है, और GPT-5.4 nano का SWE-bench Pro (Public) पर 52.4%। Pro अधिक कठिन और हालिया टेस्ट है।
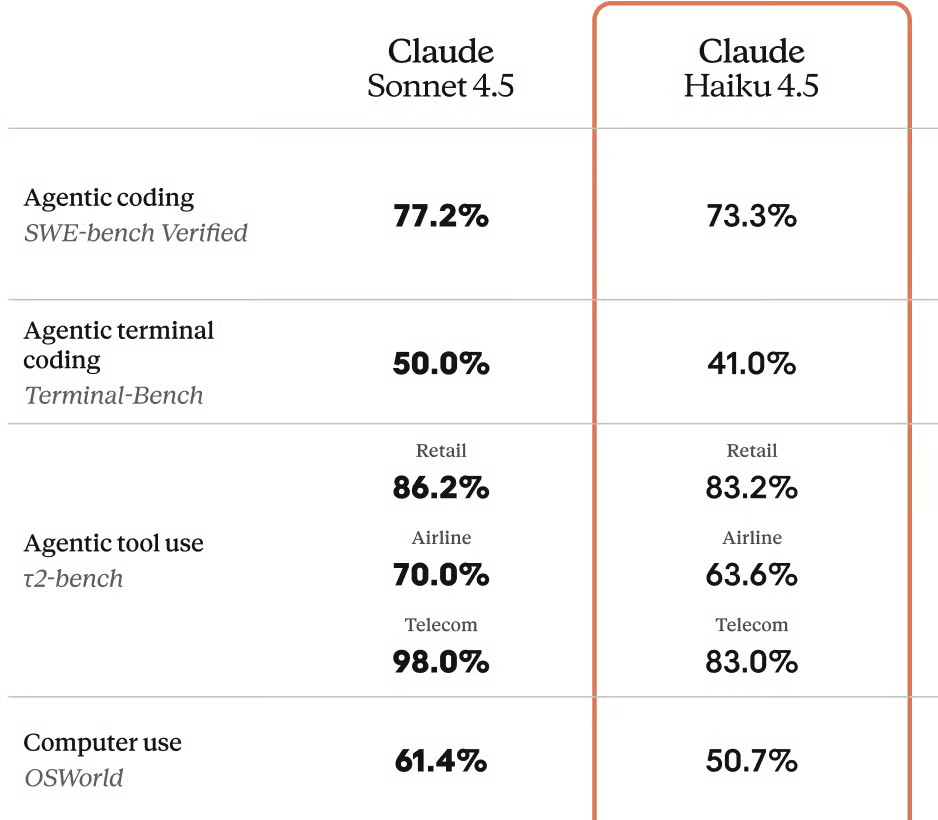
OSWorld पर Claude Haiku 4.5 का स्कोर 50.7%
दो सबसे साफ़-सुथरी तुलनाओं में, GPT-5.4 nano दोनों पर आगे है।
हालाँकि, OSWorld कंप्यूटर-उपयोग में Haiku 4.5 को बढ़त हो सकती है, लेकिन फिर भी बेंचमार्क वेरियंट तुलना को कठिन बना देते हैं।
OSWorld-Verified अधिक कठिन टेस्ट है, लेकिन लगभग 12% का अंतर काफ़ी महत्वपूर्ण दिखता है। हम इस फ़ासले को नज़रअंदाज़ करने में थोड़ा सावधानी बरतते हैं, क्योंकि SWE-bench Verified और SWE-bench Pro के विपरीत—जहाँ यह ज्ञात है कि Verified पर अच्छा करने वाले मॉडल अक्सर Pro पर कम करते हैं—OSWorld और OSWorld-Verified के मामले में उसी कहानी का सबूत कम है।
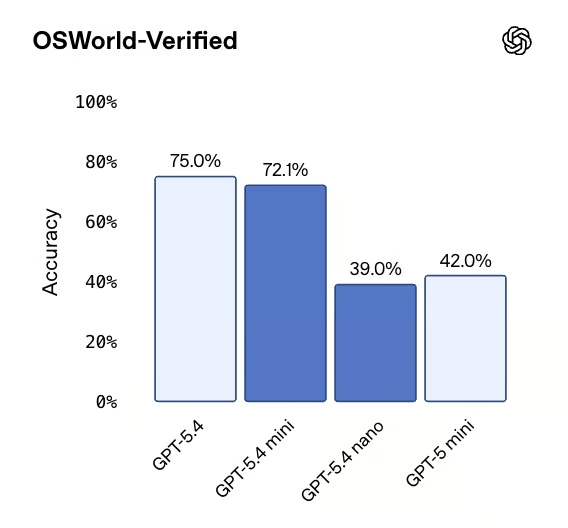
OSWorld-Verified पर GPT-5.4 nano का स्कोर 39%
ऑनलाइन प्रतिक्रियाओं में टेक की जानी-पहचानी प्रवृत्ति दिखी: पिछले साल का फ़्लैगशिप अगले साल का फ़्री टियर बन जाता है। यह अपेक्षित है, पर बदलाव की रफ़्तार चौंकाने वाली है।
कहा जा रहा है कि फ़्रंटियर AI में अब तक बने किसी भी प्रोडक्ट की तुलना में सबसे तेज़ मूल्यह्रास (depreciation) है। लोग सोच रहे हैं कि जिस मॉडल के लिए आप आज प्रीमियम दे रहे हैं, क्या छह महीने बाद वह अब भी क़ीमती लगेगा? कई बार, डेवलपर सिर्फ़ मॉडल बदलना नहीं चाहेंगे—खासकर अगर उन्होंने फाइन-ट्यूनिंग की हो या लागत और प्रदर्शन की कुछ कैलिब्रेशन की हों।
बेंचमार्क GPT-5.4 से 5.4 mini होकर 5.4 nano तक एक साफ़ परफ़ॉर्मेंस सीढ़ी दिखाते हैं। लेकिन कई कार्यों में व्यावहारिक चुनाव कुछ अतिरिक्त प्रतिशत अंक निचोड़ने से ज़्यादा, विलंबता और बजट पर निर्भर करता है।
कई प्रोडक्शन ऐप्स के लिए, GPT-5.4 mini एक बढ़िया नया डिफ़ॉल्ट हो सकता है—गुणवत्ता इतनी अच्छी कि फ़्रंटियर जैसी लगे, और कीमत व गति इतनी कि बड़े पैमाने पर उपयोग संभव हो।
GPT-5.4 nano वास्तविक-समय के बड़े, अत्यधिक विलंबता-संवेदनशील वर्कलोड का अधिक विशेषज्ञ है। यह उच्च-प्रदर्शन Thinking मॉडलों द्वारा सौंपे गए आसान “थोक” कार्यों के लिए सस्ते सब-एजेंट के रूप में भी बढ़िया है।
एक ऐसी दुनिया में जहाँ पिछले साल का फ़्लैगशिप इस साल का “mini” बन जाता है, ऐसे सिस्टम डिज़ाइन करना बेहतर है जो मॉडलों को आसानी से बदल सकें—बजाय एकल मॉडल रिलीज़ के लिए अनुकूलन करने के। मैं हमारा कोर्स Building Scalable Agentic Systems लेने की सिफारिश करता/करती हूँ, जो इसी प्रश्न को संबोधित करता है और आपको Model Context Protocol (MCP) जैसे एजेंटिक फ़्रेमवर्क का उपयोग सिखाता है।
एजेंटिक AI कोर्स
कोर्स
लर्निंग पाथ
लर्निंग पाथ