Apache Hadoop,通常简称为Hadoop,是一个强大的开源框架,通过将海量数据集分布在由经济实惠的通用硬件构成的集群上进行处理与存储。它的优势在于可扩展性和灵活性,能够同时处理结构化与非结构化数据。
在本文中,我将带您逐步了解构成 Hadoop 的关键组件——它如何在大规模下存储、处理和管理数据。读完后,您将清楚地了解这项基础技术如何融入大数据生态系统。
Hadoop 生态系统概览
Hadoop 不是单一工具。它是一个生态系统,包含多个模块,协同完成数据存储、处理和资源协调。
Hadoop 的核心模块
Hadoop 由四个基础模块组成:
- HDFS(Hadoop Distributed File System):一种分布式存储系统,将文件拆分为数据块并分布到集群各处。
- MapReduce:一种在各节点间并行处理数据的编程模型。
- YARN(Yet Another Resource Negotiator):在集群中管理资源并调度作业。
- Hadoop Common:支持其他模块的一组共享库和实用工具。
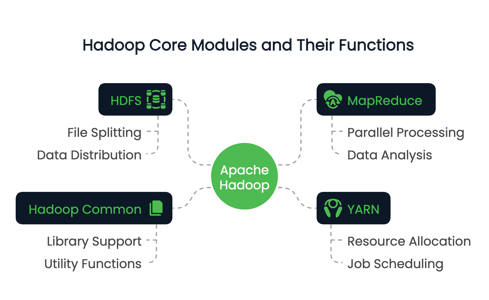
这些模块协同工作,构建出能够处理 PB 级数据的分布式计算环境。
想要比较不同平台上的分布式数据处理,请查看 Big Data Fundamentals with PySpark课程,它提供与 Hadoop 相辅相成的上手机会。
Hadoop 在大数据中的角色
Hadoop 的主要作用在于应对在大数据处理中的核心挑战,即可扩展性。
传统系统在存储和计算方面常常难以应对超过单机能力的数据集。Hadoop 通过将数据分布到多个节点并并行执行计算来解决这一问题。
因此,Hadoop 能高效处理 TB 乃至 PB 级数据。除了可扩展性之外,Hadoop 还通过数据副本实现深度容错,并允许组织使用通用硬件构建高性价比的数据基础设施。
Hadoop 的关键特性
我们已经讨论了 Hadoop 的角色和结构,下面来看 Hadoop 最有价值的一些属性,包括:
- 分布式存储与处理,使其能够存储并查询超大规模数据集。
- 横向扩展,无需高端机器。
- 数据本地性优化,将计算移动到数据所在位置。
- 通过副本与任务重试实现对故障的韧性。
这些特性使 Hadoop 非常适合批处理、日志分析和 ETL 流水线。Hadoop 也是一则关于 分布式计算的经典案例,计算在多个节点上并行进行,以提升效率与规模。
接下来,我们将详细解读 Hadoop 的每个核心模块。
想检验您的 Hadoop 知识或为数据岗位做准备?这里有 2025 年的 24 道 Hadoop 面试题与答案,助您起步。
Hadoop 分布式文件系统(HDFS)
在四大组件中,HDFS 是 Hadoop 的主要存储系统。它旨在可靠地将海量数据存储在我们前文提到的机器集群中。其架构专为访问大型数据集而设计,并针对容错性、可扩展性和数据本地性进行了优化。
架构与组件
HDFS 架构围绕主从模型展开。顶层是 NameNode,负责管理元数据——本质上是文件系统的目录树以及每个文件位置的信息。它不存储实际数据。
DataNode 是工作马。它们管理节点所连接的存储,并响应来自客户端的读/写请求。每个 DataNode 都会定期向 NameNode 报告心跳与块报告,以确保状态跟踪一致。
最后,HDFS 还包含 Secondary NameNode,但不要与故障切换节点混淆。它的作用是定期检查点化 NameNode 的元数据,以减少启动时间和内存开销。
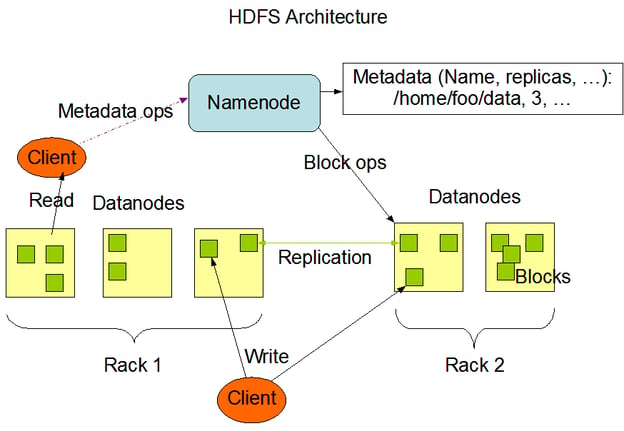
HDFS 架构。图像来源:Apache Hadoop 文档
HDFS 中数据如何存储
当文件写入 HDFS 时,会被拆分为固定大小的64MB 数据块。每个数据块随后分布到不同的 DataNode 上。这种分布策略支持数据访问时的并行性,并增强容错能力。
HDFS 中的数据不是只存一份。每个数据块都会被复制(默认三份),并分散在集群中。读取时,系统会从最近的可用副本拉取数据,以最大化吞吐量并最小化延迟。写入会先到一个副本,然后再传播到其他副本,从而在不形成即时瓶颈的情况下确保持久性。
这种块级设计也使 HDFS 能够横向扩展。向集群添加新节点后,系统会重新均衡数据,以利用新增的容量。
若想与其他大数据格式做比较,了解 Apache Parquet如何为分析型工作负载优化列式存储。
HDFS 的容错机制
HDFS以故障为常态而构建。在大型分布式系统中,节点故障是预期之内而非例外。HDFS 通过副本机制确保数据可用性。如果某个 DataNode 宕机,NameNode 会通过心跳丢失检测到故障,并调度将丢失的数据块复制到健康节点上。
此外,系统会持续监控数据块健康状态,并按需触发复制。冗余存储策略与主动监控相结合,确保不会有任何单点故障影响数据完整性或访问。
MapReduce 框架
接下来是 Hadoop 的处理引擎 MapReduce。它通过将任务拆分为更小的、彼此独立的操作并并行执行,实现对大型数据集的分布式计算。
该模型简化了复杂的数据转换,尤其适合分布式环境下的批处理。
MapReduce 概览
MapReduce 遵循两个阶段的编程模型:Map 与 Reduce 阶段。
在 Map 阶段,输入数据集被划分为更小的分片,每个分片被处理以生成键值对。这些中间结果随后会在传递给 Reduce 阶段之前被洗牌并排序,最终在 Reduce 中聚合或转换为最终输出。
该模型对大规模词频统计、日志过滤或数据集连接等任务非常有效。
开发者通过自定义 map() 与 reduce() 函数实现逻辑,由框架在集群上统一编排。
MapReduce 作业的执行流程
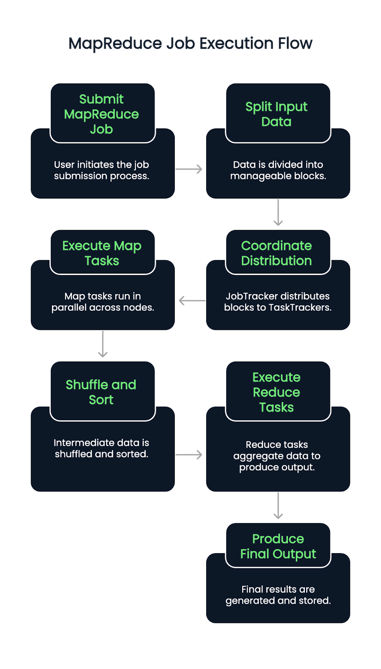
当提交一个 MapReduce 作业时,输入数据首先被切分为数据块。随后由 JobTracker(或启用 YARN 的版本中的 ResourceManager)协调将这些数据块分配给可用的 TaskTracker 或 NodeManager。
Map 任务在各节点并行执行,读取输入分片并输出中间键值对。这些键值对随后会自动进行洗牌和排序。该阶段完成后,Reduce 任务开始运行,拉取分组后的数据并应用聚合逻辑生成最终结果。
该过程通过将任务尽量分配到数据所在位置来保证数据本地性,最大限度减少网络拥塞并提升吞吐量。任务故障会被自动检测并重新分配,有助于系统的韧性。
MapReduce 的优势与局限
MapReduce 具有多项明显优势:
- 在大规模批处理中的出色并行性
- 可在成千上万台节点间扩展
- 通过任务重试与检查点实现的强容错性
但它也存在权衡:
- 模型延迟较高,不太适合实时处理
- 编写自定义 MapReduce 作业工作量大且调试困难
- 缺乏类似 Apache Spark 等新工具的交互性与灵活性。
在 Hadoop 与 Spark 之间犹豫不决?阅读我们的指南,了解哪种大数据框架更适合您。
YARN:Yet Another Resource Negotiator
YARN 充当 Hadoop 的资源管理层。它将作业调度与资源分配从处理模型中分离出来,帮助 Hadoop 支持 MapReduce 之外的多种数据处理引擎。
在 Hadoop 架构中的角色
YARN 是管理整个集群计算资源的中央平台。它会将可用系统资源分配给多个应用并协调执行。此种关注点分离有助于 Hadoop 高效扩展,并为支持 Apache Spark、Hive、Tez 等其他框架打开大门。
YARN 的关键组件
YARN 引入了三个组件:
- ResourceManager: 主守护进程(后台程序),负责管理所有资源并调度应用。
- NodeManager: 每个节点上的代理,监控资源使用并向 ResourceManager 回报。
- ApplicationMaster: 作业特定的操作,向 ResourceManager 申请资源并与 NodeManager 协调执行。
每个应用(如一个 MapReduce 作业)都有自己的 ApplicationMaster,从而实现更好的故障隔离与作业跟踪。
YARN 的资源管理流程
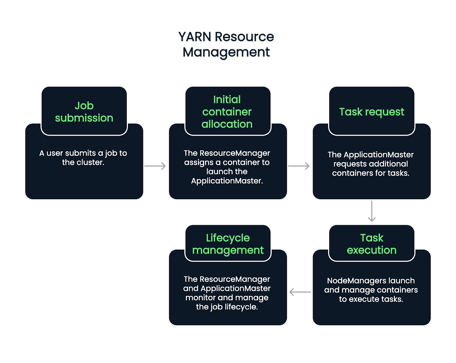
流程从用户提交作业开始。ResourceManager 接收作业并分配一个容器来启动 ApplicationMaster。随后,ApplicationMaster 会根据当前工作负载与资源可用性,请求更多容器来执行任务。
NodeManager 负责启动并管理这些容器,容器内运行各个任务。在作业生命周期中,ResourceManager 与 ApplicationMaster 负责监控、故障恢复与完成上报。因此,整体上是一个五步流程。
- 作业提交: 用户向集群提交作业。
- 初始容器分配: ResourceManager 接收作业并分配一个容器来启动 ApplicationMaster。
- 任务请求: ApplicationMaster 根据工作负载与可用资源,请求额外容器以运行具体任务。
- 任务执行: NodeManager 启动并管理这些容器,容器负责执行任务。
- 生命周期管理: ResourceManager 与 ApplicationMaster 协同监控作业进度、处理故障并确认任务完成。在作业整个生命周期中,它们负责监控、故障恢复与完成报告。
Hadoop Common 与实用工具
将 Hadoop 各组件粘合在一起的是 Hadoop Common。它是所有模块所需的库、配置文件与实用工具的集合。
什么是 Hadoop Common
Hadoop Common 提供使 HDFS、YARN 与 MapReduce 能够通信与协同的基础代码与工具,包括 Java 库、文件系统客户端以及在生态系统中通用的 API。
它还确保模块之间的一致性与兼容性,使开发者可以在一组共享原语之上构建。
配置与工具的重要性
正确配置 Hadoop 至关重要。Hadoop Common 存放诸如 core-site.xml 等配置文件,这些文件定义了默认行为,如文件系统 URI 与 I/O 设置。
Hadoop Common 包含的命令行工具与脚本支持启动服务、检查节点健康与管理作业等任务。系统管理员与开发者在日常集群运维中大多依赖这些工具。
Hadoop 的实际应用
只要涉及海量数据集、分布式处理或批量分析,Hadoop 很可能就会用上。更具体地说,Hadoop 被广泛用于各行业处理海量的结构化与非结构化数据。其分布式设计与开源的灵活性使其在数据密集型任务中具备多面手的优势。
受益于 Hadoop 的行业
金融、医疗、通信、电商与社交媒体等组织都在常规使用 Hadoop。它帮助银行进行实时欺诈检测,支持医疗领域的基因组研究,并为在线零售的推荐引擎提供支撑。
示例用例
- 日志处理: 汇聚并分析来自服务器与应用的日志数据。
- 推荐系统: 构建推荐内容或产品的模型。
- 欺诈检测: 识别交易中的可疑行为模式。
这些场景受益于 Hadoop 在处理超大规模数据时的容错与并行能力。
若想了解一种现代的、云原生的 Hadoop 替代方案,可试试 Introduction to Databricks课程,它支持 Spark 等可扩展工具。
与其他工具的集成
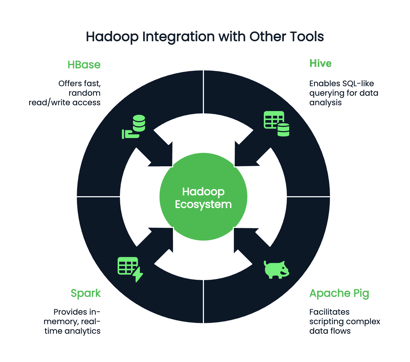
Hadoop 很少单独使用,它可以与数百种辅助程序集成。根据您的偏好与编码环境,您可以将 Hadoop 与以下工具配合使用:
- Hive: 用于类 SQL 查询
- Apache Pig: 用于编写复杂数据流脚本
- Spark: 用于内存内、实时分析
- HBase: 用于对大型数据集进行快速的随机读/写访问
结语
尽管 Hadoop 不再像过去那样频频被提及,但它仍是大数据领域的基石技术。对于任何从事大规模系统的数据专业人士而言,理解 Hadoop 依然十分重要。其核心组件——用于存储的 HDFS、用于处理的 MapReduce、用于资源管理的 YARN,以及提供基础实用工具的 Hadoop Common——持续影响着数据工作流的设计与扩展方式。
在着手部署或优化之前,请先深入理解数据如何在 Hadoop 集群中分布与配置。这样的知识将简化故障排查与性能调优,并为集成 Apache Spark 与 Hive 等强大工具以实现更先进的分析铺平道路。
如需了解更多大数据处理内容,请查看:


Apache Hadoop,通常简称为Hadoop,是一个强大的开源框架,通过将海量数据集分布在由经济实惠的通用硬件构成的集群上进行处理与存储。它的优势在于可扩展性和灵活性,能够同时处理结构化与非结构化数据。
在本文中,我将带您逐步了解构成 Hadoop 的关键组件——它如何在大规模下存储、处理和管理数据。读完后,您将清楚地了解这项基础技术如何融入大数据生态系统。
Hadoop 生态系统概览
Hadoop 不是单一工具。它是一个生态系统,包含多个模块,协同完成数据存储、处理和资源协调。
Hadoop 的核心模块
Hadoop 由四个基础模块组成:
这些模块协同工作,构建出能够处理 PB 级数据的分布式计算环境。
想要比较不同平台上的分布式数据处理,请查看 Big Data Fundamentals with PySpark课程,它提供与 Hadoop 相辅相成的上手机会。
Hadoop 在大数据中的角色
Hadoop 的主要作用在于应对在大数据处理中的核心挑战,即可扩展性。
传统系统在存储和计算方面常常难以应对超过单机能力的数据集。Hadoop 通过将数据分布到多个节点并并行执行计算来解决这一问题。
因此,Hadoop 能高效处理 TB 乃至 PB 级数据。除了可扩展性之外,Hadoop 还通过数据副本实现深度容错,并允许组织使用通用硬件构建高性价比的数据基础设施。
Hadoop 的关键特性
我们已经讨论了 Hadoop 的角色和结构,下面来看 Hadoop 最有价值的一些属性,包括:
这些特性使 Hadoop 非常适合批处理、日志分析和 ETL 流水线。Hadoop 也是一则关于 分布式计算的经典案例,计算在多个节点上并行进行,以提升效率与规模。
接下来,我们将详细解读 Hadoop 的每个核心模块。
想检验您的 Hadoop 知识或为数据岗位做准备?这里有 2025 年的 24 道 Hadoop 面试题与答案,助您起步。
Hadoop 分布式文件系统(HDFS)
在四大组件中,HDFS 是 Hadoop 的主要存储系统。它旨在可靠地将海量数据存储在我们前文提到的机器集群中。其架构专为访问大型数据集而设计,并针对容错性、可扩展性和数据本地性进行了优化。
架构与组件
HDFS 架构围绕主从模型展开。顶层是 NameNode,负责管理元数据——本质上是文件系统的目录树以及每个文件位置的信息。它不存储实际数据。
DataNode 是工作马。它们管理节点所连接的存储,并响应来自客户端的读/写请求。每个 DataNode 都会定期向 NameNode 报告心跳与块报告,以确保状态跟踪一致。
最后,HDFS 还包含 Secondary NameNode,但不要与故障切换节点混淆。它的作用是定期检查点化 NameNode 的元数据,以减少启动时间和内存开销。
HDFS 架构。图像来源:Apache Hadoop 文档
HDFS 中数据如何存储
当文件写入 HDFS 时,会被拆分为固定大小的64MB 数据块。每个数据块随后分布到不同的 DataNode 上。这种分布策略支持数据访问时的并行性,并增强容错能力。
HDFS 中的数据不是只存一份。每个数据块都会被复制(默认三份),并分散在集群中。读取时,系统会从最近的可用副本拉取数据,以最大化吞吐量并最小化延迟。写入会先到一个副本,然后再传播到其他副本,从而在不形成即时瓶颈的情况下确保持久性。
这种块级设计也使 HDFS 能够横向扩展。向集群添加新节点后,系统会重新均衡数据,以利用新增的容量。
若想与其他大数据格式做比较,了解 Apache Parquet如何为分析型工作负载优化列式存储。
HDFS 的容错机制
HDFS以故障为常态而构建。在大型分布式系统中,节点故障是预期之内而非例外。HDFS 通过副本机制确保数据可用性。如果某个 DataNode 宕机,NameNode 会通过心跳丢失检测到故障,并调度将丢失的数据块复制到健康节点上。
此外,系统会持续监控数据块健康状态,并按需触发复制。冗余存储策略与主动监控相结合,确保不会有任何单点故障影响数据完整性或访问。
MapReduce 框架
接下来是 Hadoop 的处理引擎 MapReduce。它通过将任务拆分为更小的、彼此独立的操作并并行执行,实现对大型数据集的分布式计算。
该模型简化了复杂的数据转换,尤其适合分布式环境下的批处理。
MapReduce 概览
MapReduce 遵循两个阶段的编程模型:Map 与 Reduce 阶段。
在 Map 阶段,输入数据集被划分为更小的分片,每个分片被处理以生成键值对。这些中间结果随后会在传递给 Reduce 阶段之前被洗牌并排序,最终在 Reduce 中聚合或转换为最终输出。
该模型对大规模词频统计、日志过滤或数据集连接等任务非常有效。
开发者通过自定义
map()与reduce()函数实现逻辑,由框架在集群上统一编排。MapReduce 作业的执行流程
当提交一个 MapReduce 作业时,输入数据首先被切分为数据块。随后由 JobTracker(或启用 YARN 的版本中的 ResourceManager)协调将这些数据块分配给可用的 TaskTracker 或 NodeManager。
Map 任务在各节点并行执行,读取输入分片并输出中间键值对。这些键值对随后会自动进行洗牌和排序。该阶段完成后,Reduce 任务开始运行,拉取分组后的数据并应用聚合逻辑生成最终结果。
该过程通过将任务尽量分配到数据所在位置来保证数据本地性,最大限度减少网络拥塞并提升吞吐量。任务故障会被自动检测并重新分配,有助于系统的韧性。
MapReduce 的优势与局限
MapReduce 具有多项明显优势:
但它也存在权衡:
在 Hadoop 与 Spark 之间犹豫不决?阅读我们的指南,了解哪种大数据框架更适合您。
YARN:Yet Another Resource Negotiator
YARN 充当 Hadoop 的资源管理层。它将作业调度与资源分配从处理模型中分离出来,帮助 Hadoop 支持 MapReduce 之外的多种数据处理引擎。
在 Hadoop 架构中的角色
YARN 是管理整个集群计算资源的中央平台。它会将可用系统资源分配给多个应用并协调执行。此种关注点分离有助于 Hadoop 高效扩展,并为支持 Apache Spark、Hive、Tez 等其他框架打开大门。
YARN 的关键组件
YARN 引入了三个组件:
每个应用(如一个 MapReduce 作业)都有自己的 ApplicationMaster,从而实现更好的故障隔离与作业跟踪。
YARN 的资源管理流程
流程从用户提交作业开始。ResourceManager 接收作业并分配一个容器来启动 ApplicationMaster。随后,ApplicationMaster 会根据当前工作负载与资源可用性,请求更多容器来执行任务。
NodeManager 负责启动并管理这些容器,容器内运行各个任务。在作业生命周期中,ResourceManager 与 ApplicationMaster 负责监控、故障恢复与完成上报。因此,整体上是一个五步流程。
Hadoop Common 与实用工具
将 Hadoop 各组件粘合在一起的是 Hadoop Common。它是所有模块所需的库、配置文件与实用工具的集合。
什么是 Hadoop Common
Hadoop Common 提供使 HDFS、YARN 与 MapReduce 能够通信与协同的基础代码与工具,包括 Java 库、文件系统客户端以及在生态系统中通用的 API。
它还确保模块之间的一致性与兼容性,使开发者可以在一组共享原语之上构建。
配置与工具的重要性
正确配置 Hadoop 至关重要。Hadoop Common 存放诸如
core-site.xml等配置文件,这些文件定义了默认行为,如文件系统 URI 与 I/O 设置。Hadoop Common 包含的命令行工具与脚本支持启动服务、检查节点健康与管理作业等任务。系统管理员与开发者在日常集群运维中大多依赖这些工具。
Hadoop 的实际应用
只要涉及海量数据集、分布式处理或批量分析,Hadoop 很可能就会用上。更具体地说,Hadoop 被广泛用于各行业处理海量的结构化与非结构化数据。其分布式设计与开源的灵活性使其在数据密集型任务中具备多面手的优势。
受益于 Hadoop 的行业
金融、医疗、通信、电商与社交媒体等组织都在常规使用 Hadoop。它帮助银行进行实时欺诈检测,支持医疗领域的基因组研究,并为在线零售的推荐引擎提供支撑。
示例用例
这些场景受益于 Hadoop 在处理超大规模数据时的容错与并行能力。
若想了解一种现代的、云原生的 Hadoop 替代方案,可试试 Introduction to Databricks课程,它支持 Spark 等可扩展工具。
与其他工具的集成
Hadoop 很少单独使用,它可以与数百种辅助程序集成。根据您的偏好与编码环境,您可以将 Hadoop 与以下工具配合使用:
结语
尽管 Hadoop 不再像过去那样频频被提及,但它仍是大数据领域的基石技术。对于任何从事大规模系统的数据专业人士而言,理解 Hadoop 依然十分重要。其核心组件——用于存储的 HDFS、用于处理的 MapReduce、用于资源管理的 YARN,以及提供基础实用工具的 Hadoop Common——持续影响着数据工作流的设计与扩展方式。
在着手部署或优化之前,请先深入理解数据如何在 Hadoop 集群中分布与配置。这样的知识将简化故障排查与性能调优,并为集成 Apache Spark 与 Hive 等强大工具以实现更先进的分析铺平道路。
如需了解更多大数据处理内容,请查看: