Hadoop 和 Spark 是大数据领域中最突出的两个框架,但它们在处理大规模数据方面采取了截然不同的方法。Hadoop 借助其稳健的 HDFS 存储系统和 MapReduce 计算模型,让分布式计算范式更为普及;而 Spark 则以内存计算架构和灵活的编程模型改写了游戏规则。
本教程将深入比较 Hadoop 与 Spark 的差异,包括架构、性能、成本考量和集成方式。阅读完毕后,您将清晰理解各自的优劣势,以及各框架擅长的使用场景;这种理解将帮助您在构建大数据解决方案时做出更具战略性的决策。
理解 Hadoop 与 Spark
在深入细节之前,让我们先了解 Hadoop 与 Spark 的基本概念与起源,看看这些强大的框架如何应对大数据挑战。
什么是 Hadoop?
Hadoop 是一个开源框架,旨在在计算机集群上存储和处理大型数据集。自 2006 年开发以来,Hadoop 使组织能够处理单机难以承受的海量数据。通过将数据分布到多个节点,它不仅提升了处理能力,还通过冗余提供可靠性,确保即使单台机器发生故障,系统仍能稳定运行。
Hadoop 框架的关键组件包括:
- Hadoop 分布式文件系统(HDFS): 作为存储基础,将文件切分为数据块并分布到整个集群。
- MapReduce: 通过将计算任务拆分为可在集群中并行运行的小单元来处理数据。
- YARN(Yet Another Resource Negotiator): 通过在可用机器间分配计算资源与调度任务来高效管理资源。
Hadoop 的主要优势之一是性价比高,它允许组织使用标准的通用硬件,而非昂贵的专用设备。这种务实理念也体现在其处理哲学上。
Hadoop 的批处理导向设计擅长在整体吞吐量比处理速度更重要的场景,特别适用于历史数据分析和不需要即时结果的复杂ETL(抽取、转换、加载) 作业。
什么是 Apache Spark?
Apache Spark 于 2010 年诞生,旨在回应 Hadoop 在大数据处理方法上的局限。它最初在加州大学伯克利分校开发,后成为 Apache 项目。Spark 解决了 Hadoop MapReduce 对磁盘操作的高度依赖,其突破性创新是实施内存计算,通过最大限度减少磁盘读写,大幅缩短许多数据工作负载的处理时间。
Spark 围绕其核心处理引擎构建了多个紧密集成的组件,提供统一平台:
- Spark SQL: 处理结构化数据
- MLlib: 实现机器学习算法
- GraphX: 处理图数据
- Spark Streaming: 实时分析数据
这种一体化设计意味着团队可以用单一框架应对多种数据挑战,而无需切换多个专用工具。
尽管不同,Spark 与 Hadoop 往往是互补而非竞争的技术。由于 Spark 不包含自有存储系统,它通常依赖 Hadoop 的 HDFS 进行持久化存储。
此外,Spark 可运行在 Hadoop 的 YARN 资源管理器之上,使组织能够在现有 Hadoop 环境中轻松引入 Spark 的处理能力。这种兼容性提供了务实的升级路径,让企业在不放弃 Hadoop 基础设施投入的前提下,享受 Spark 的优势。
Hadoop 与 Spark 性能比较
在评估大数据框架时,对于有时效性数据处理需求的组织而言,性能往往是决定性因素。
处理速度
Hadoop 的 MapReduce 是基于磁盘的处理系统,在每个计算阶段之间都会从磁盘读取数据、处理并将结果写回磁盘。此类磁盘 I/O 会带来显著延迟,尤其对于需要对同一数据进行多次迭代的算法而言。
这种方法在大规模数据批处理方面有效,但为可靠性与吞吐量牺牲了速度。
相比之下,Spark 主要在内存中执行计算,极大减少磁盘操作。对于许多工作负载,特别是机器学习中使用的迭代算法,Spark 执行任务的速度可比 Hadoop MapReduce 快至 100 倍。
当需要近实时处理或算法需多次遍历同一数据集时,这种性能优势尤为明显。
内存利用
Hadoop 的设计假设可用内存有限,因此在内存方面更为节省,但速度较慢。它高度依赖磁盘存储,可通过内存与磁盘间不断交换数据来处理远超可用内存的数据集。
这种方式使 Hadoop 适用于在内存资源有限的集群上处理极大规模数据集。
Spark 的性能优势源于其积极使用内存。通过在各处理阶段将数据缓存于 RAM,Spark 避免了代价高昂的磁盘操作。但这要求具备足够的内存资源来容纳工作数据集。
当内存受限时,Spark 的优势会减弱,因为它会开始将数据溢写到磁盘;尽管如此,其智能内存管理通常仍优于 Hadoop 的“磁盘优先”方法。
真实环境下的性能考量
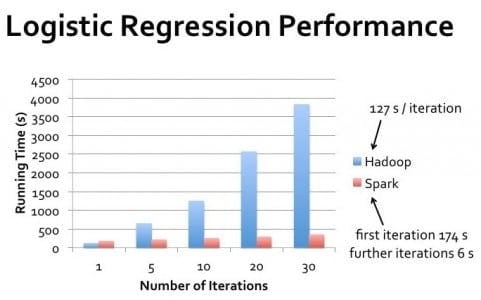
Hadoop 与 Spark 在真实场景中的性能差距取决于具体用例。对于超大数据集的单次批处理,且数据量远超可用内存时,Hadoop 的性能可能接近 Spark。
但在迭代处理、交互式查询和流处理方面,Spark 一贯表现更优。
值得注意的是,性能不仅仅是“速度”的问题。Hadoop 在需要高容错且可在明确批处理窗口内运行的场景中表现出色。
Spark 则更适用于需要快速得到结果的场景,如交互式数据探索、实时分析和需对数据集多次遍历的机器学习应用。
集群管理:Hadoop 集群 vs Spark 集群
Hadoop 与 Spark 都依赖集群来高效处理海量数据,但它们对资源的管理方式不同,从而影响性能与运维管理。
什么是集群及其必要性
集群是由多个互联计算机(节点)组成的集合,共同作为一个系统工作。当数据量超过单机高效处理能力时,大数据处理就需要集群。通过将计算工作负载分布到多台机器,集群使组织能够处理否则难以管理的 PB 级数据。
集群还提供容错与高可用性。一台机器故障时,集群中的其他机器可接管其工作,确保持续运行。这种韧性对停机代价高昂的生产环境至关重要。
此外,集群支持水平扩展——通过增加机器来提升处理能力——这通常比升级单台系统更具成本效益。
对于有志于该领域的专业人士而言,理解集群是 数据工程中的一项基础技能。
Hadoop 集群架构
Hadoop 集群采用主从式架构,不同节点承担专门角色。 NameNode 是 HDFS 的主节点,维护文件位置与权限等元数据。DataNode 存储实际数据块并向 NameNode 汇报。
在处理层面, ResourceManager 负责分配集群资源,各机器上的 NodeManager 执行任务。
HDFS 会将数据复制到多个 DataNode,通常为每个数据块保留三份副本。该复制策略确保即便单个节点失败,数据仍可用,但需要额外的存储容量。
Hadoop 的集群设计强调数据本地性,尽量将计算任务调度到数据所在节点,以减少网络传输。
Hadoop 集群的运维传统上需要较高专业度(专业人士常通过准备 Hadoop 面试题来展示相关知识),尽管现代发行版已包含简化配置与监控的管理工具。
扩展 Hadoop 集群需要添加新节点并在扩展后的基础设施间重新平衡数据,这可能是需要精心规划的手动过程。
Spark 集群架构
Spark 可在多种集群配置下运行,包括独立模式、Hadoop YARN、Apache Mesos 或 Kubernetes。无论何种部署,Spark 都遵循 driver-executor 模型。Driver 程序包含应用的主函数,并创建 SparkContext,与集群管理器协作分配资源。
资源分配完成后,Spark 会在工作节点上启动 executors。这些 executors 是 JVM 进程,负责运行任务并将数据存储在内存或磁盘中。不同于 Hadoop 在集群节点上持续驻留的方式,Spark 的 executors 可根据应用需求动态分配与释放,从而潜在提升资源利用率。
感兴趣的读者可通过诸如 面向机器学习的 Apache Spark等实践教程进一步探索 Spark 的能力。
Spark 不包含自有的分布式存储系统,而是利用现有方案,如 HDFS、Amazon S3 或其他兼容存储系统。计算与存储的这种解耦提供了灵活性,但需要仔细配置以确保最佳的数据访问模式。
诸如 Spark SQL 与 sparklyr 等工具提供了与该架构交互的便捷方式。
集群管理的关键差异
Hadoop 的集群管理更偏向基础设施中心,资源分配相对静态,注重数据本地性。该设计适用于稳定集群中的长时间批处理作业,节点变化不频繁的场景。
然而,它对变化的工作负载响应较弱,扩容时需要更多人工干预。
Spark 提供更动态的资源管理,特别是在 Kubernetes 等现代编排平台上运行时。它可根据当前需求调整资源分配,并在不需要时释放资源。
这种弹性对工作负载波动较大或共用基础设施承载多个应用的组织而言极具价值。
理解这些差异对于正在追求 数据工程师认证或准备 Spark 面试题的专业人士至关重要。
对于刚开始进入大数据领域的组织而言,Spark 更灵活的部署选项与更简单的编程模型,通常更易上手。
然而,在数据量极其庞大且以存储管理为主要关注点的环境中,Hadoop 成熟的 HDFS 生态仍具优势,能与 Spark 的处理能力形成互补。若想了解 Spark 与其他流技术的比较,读者可参考 Flink vs. Spark 等内容。
Hadoop MapReduce vs. Spark 的处理模型
前文讨论了性能层面的影响,而理解两者的基本处理模型有助于解释它们为何在架构上差异显著。
Hadoop MapReduce 框架
MapReduce 遵循刚性编程范式,包含两个主要阶段:map 与 reduce。map 阶段并行地对每条记录应用函数,生成中间键值对。
这些键值对会经过强制性的 shuffle 与排序阶段,将相同键的数据分组。
最终,reduce 阶段对分组后的值进行聚合,产出最终结果。这种结构化方式意味着复杂操作需要将多个 MapReduce 作业级联起来。
开发 MapReduce 应用通常需要编写低层代码,显式定义 map 与 reduce 函数。
尽管 Apache Pig 和 Apache Hive 等框架提供了更高层的抽象,但底层执行仍遵循严格的 MapReduce 模式,从而对算法设计与优化空间造成限制。
Spark 的数据处理模型
Spark 引入了 弹性分布式数据集(RDD) 作为核心抽象——不可变、分区的集合,可以通过血统信息进行恢复。与 MapReduce 不同,Spark 不强制固定的处理模式,而是提供两类操作:transformation(创建新的 RDD)与 action(返回结果)。
这种灵活性允许超越 map-reduce 范式的多样处理模式。
Spark 已超越 RDD,提供更高层抽象,如 DataFrame 与 Dataset,提供类似关系型数据库优化的模式感知处理。这些抽象与面向流处理、 SQL、 机器学习 与图处理的专用库相结合,使开发者能以显著少于等效 MapReduce 实现的代码量来表达复杂工作流,同时在不同处理范式间保持统一的编程模型。
Spark 与 Hadoop 的成本考量
在评估大数据框架时,组织需要考虑的不仅是技术能力,还包括部署与运维的财务影响。
硬件需求与影响
Hadoop 与 Spark 在硬件偏好上有本质差异,会影响基础设施成本。Hadoop 设计上优先考虑磁盘存储而非内存,适合内存有限但硬盘容量可观的通用硬件。
这种架构可降低初始硬件投资,尤其是在处理极大数据集、基于内存的方案成本高昂的情况下。
Spark 的内存处理模型带来性能优势,但需要显著更多的每节点内存。合理配置的 Spark 集群通常需要高内存配置的服务器——视工作负载而定,每节点常在 16GB 到 256GB。
尽管内存价格逐年下降,这一需求与以磁盘为中心的 Hadoop 部署相比,仍可能提高硬件开支。
运维开销
运维成本不仅包括硬件采购,还包括持续的维护、电力、制冷与机房空间。Hadoop 集群由于依赖众多配备大量存储的通用服务器,物理占用通常更大。
更大的占用意味着更高的电力、制冷与机架空间成本。
Spark 集群有时可凭借更高效的计算资源利用,以更少的节点实现同等处理能力,从而可能减少数据中心占用与相关成本。不过,所需的高规格机器每节点耗电更高,可能部分抵消这些节省。
开发与人力成本
实现与维护的复杂性会显著影响总体拥有成本。Hadoop 生态传统上需要精通 Java 编程与 Unix 管理的专门技能,且由于 MapReduce 编程冗长,开发周期可能偏长。
Spark 提供更易用的 Python、Scala、R 与 Java API,可能缩短开发时间并降低人力成本。
更直观的编程模型可降低学习曲线与开发时长,使组织以更少的专才更快落地解决方案。
成本优化策略
对于成本敏感的组织,混合方案往往最具价值。在存储层使用 HDFS、在处理层利用 Spark,能将 Hadoop 的高性价比存储与 Spark 的高效处理相结合。基于云的部署(如 AWS EMR、Azure HDInsight、Google Dataproc)允许按用量付费,无需大量前期资本开支。
组织还应考虑扩展成本。Hadoop 传统上需要手动干预来扩容,增加运维开销。Spark 对 Kubernetes 等容器编排平台的兼容,使其能够更自动化、弹性地扩缩,将资源供给更好地匹配实际需求,潜在减少闲置容量。
Hadoop 与 Spark 对比表
下表对二者差异进行了总结:
|
Feature
|
Hadoop
|
Spark
|
|
Processing Model
|
Batch processing using MapReduce
|
In-memory processing using RDDs, DataFrames, and Datasets
|
|
Performance
|
Slower due to disk I/O between stages
|
Up to 100x faster for iterative and in-memory workloads
|
|
Memory Usage
|
Disk-centric, low memory requirements
|
Memory-intensive, high RAM requirements
|
|
Ease of Development
|
Verbose; requires writing map & reduce logic explicitly
|
High-level APIs in Python, Scala, R, Java; less boilerplate
|
|
Fault Tolerance
|
Data replication via HDFS
|
RDD lineage enables recomputation in case of failure
|
|
Real-time Processing
|
Not ideal; batch only
|
Supports real-time processing via Spark Streaming
|
|
Cluster Manager
|
YARN
|
Standalone, YARN, Mesos, or Kubernetes
|
|
Storage
|
Comes with HDFS
|
Depends on external storage (e.g., HDFS, S3, GCS)
|
|
Cost
|
Lower hardware cost (commodity machines, disk-based)
|
Higher memory cost but better resource utilization per workload
|
|
Best For
|
Batch jobs, massive-scale storage, historical data analysis
|
Machine learning, stream processing, interactive analytics
|
|
Integration
|
Strong Hadoop ecosystem (Hive, Pig, etc.)
|
Unified APIs for SQL, MLlib, GraphX, and Streaming in a single platform
|
结论
Hadoop 与 Spark 在大数据处理上更像是互补而非单纯的竞争关系。Hadoop 以其高性价比的存储系统(HDFS)和面向批处理的能力,在处理以吞吐量为先的海量数据集时表现突出。
Spark 则凭借内存计算能力,在迭代算法、交互式分析与实时处理需求方面展现出卓越性能。
如果您希望进一步了解这两项技术,DataCamp 提供了多种资源:

Hadoop 和 Spark 是大数据领域中最突出的两个框架,但它们在处理大规模数据方面采取了截然不同的方法。Hadoop 借助其稳健的 HDFS 存储系统和 MapReduce 计算模型,让分布式计算范式更为普及;而 Spark 则以内存计算架构和灵活的编程模型改写了游戏规则。
本教程将深入比较 Hadoop 与 Spark 的差异,包括架构、性能、成本考量和集成方式。阅读完毕后,您将清晰理解各自的优劣势,以及各框架擅长的使用场景;这种理解将帮助您在构建大数据解决方案时做出更具战略性的决策。
理解 Hadoop 与 Spark
在深入细节之前,让我们先了解 Hadoop 与 Spark 的基本概念与起源,看看这些强大的框架如何应对大数据挑战。
什么是 Hadoop?
Hadoop 是一个开源框架,旨在在计算机集群上存储和处理大型数据集。自 2006 年开发以来,Hadoop 使组织能够处理单机难以承受的海量数据。通过将数据分布到多个节点,它不仅提升了处理能力,还通过冗余提供可靠性,确保即使单台机器发生故障,系统仍能稳定运行。
Hadoop 框架的关键组件包括:
Hadoop 的主要优势之一是性价比高,它允许组织使用标准的通用硬件,而非昂贵的专用设备。这种务实理念也体现在其处理哲学上。
Hadoop 的批处理导向设计擅长在整体吞吐量比处理速度更重要的场景,特别适用于历史数据分析和不需要即时结果的复杂ETL(抽取、转换、加载) 作业。
什么是 Apache Spark?
Apache Spark 于 2010 年诞生,旨在回应 Hadoop 在大数据处理方法上的局限。它最初在加州大学伯克利分校开发,后成为 Apache 项目。Spark 解决了 Hadoop MapReduce 对磁盘操作的高度依赖,其突破性创新是实施内存计算,通过最大限度减少磁盘读写,大幅缩短许多数据工作负载的处理时间。
Spark 围绕其核心处理引擎构建了多个紧密集成的组件,提供统一平台:
这种一体化设计意味着团队可以用单一框架应对多种数据挑战,而无需切换多个专用工具。
尽管不同,Spark 与 Hadoop 往往是互补而非竞争的技术。由于 Spark 不包含自有存储系统,它通常依赖 Hadoop 的 HDFS 进行持久化存储。
此外,Spark 可运行在 Hadoop 的 YARN 资源管理器之上,使组织能够在现有 Hadoop 环境中轻松引入 Spark 的处理能力。这种兼容性提供了务实的升级路径,让企业在不放弃 Hadoop 基础设施投入的前提下,享受 Spark 的优势。
Hadoop 与 Spark 性能比较
在评估大数据框架时,对于有时效性数据处理需求的组织而言,性能往往是决定性因素。
处理速度
Hadoop 的 MapReduce 是基于磁盘的处理系统,在每个计算阶段之间都会从磁盘读取数据、处理并将结果写回磁盘。此类磁盘 I/O 会带来显著延迟,尤其对于需要对同一数据进行多次迭代的算法而言。
这种方法在大规模数据批处理方面有效,但为可靠性与吞吐量牺牲了速度。
相比之下,Spark 主要在内存中执行计算,极大减少磁盘操作。对于许多工作负载,特别是机器学习中使用的迭代算法,Spark 执行任务的速度可比 Hadoop MapReduce 快至 100 倍。
当需要近实时处理或算法需多次遍历同一数据集时,这种性能优势尤为明显。
内存利用
Hadoop 的设计假设可用内存有限,因此在内存方面更为节省,但速度较慢。它高度依赖磁盘存储,可通过内存与磁盘间不断交换数据来处理远超可用内存的数据集。
这种方式使 Hadoop 适用于在内存资源有限的集群上处理极大规模数据集。
Spark 的性能优势源于其积极使用内存。通过在各处理阶段将数据缓存于 RAM,Spark 避免了代价高昂的磁盘操作。但这要求具备足够的内存资源来容纳工作数据集。
当内存受限时,Spark 的优势会减弱,因为它会开始将数据溢写到磁盘;尽管如此,其智能内存管理通常仍优于 Hadoop 的“磁盘优先”方法。
真实环境下的性能考量
Hadoop 与 Spark 在真实场景中的性能差距取决于具体用例。对于超大数据集的单次批处理,且数据量远超可用内存时,Hadoop 的性能可能接近 Spark。
但在迭代处理、交互式查询和流处理方面,Spark 一贯表现更优。
值得注意的是,性能不仅仅是“速度”的问题。Hadoop 在需要高容错且可在明确批处理窗口内运行的场景中表现出色。
Spark 则更适用于需要快速得到结果的场景,如交互式数据探索、实时分析和需对数据集多次遍历的机器学习应用。
集群管理:Hadoop 集群 vs Spark 集群
Hadoop 与 Spark 都依赖集群来高效处理海量数据,但它们对资源的管理方式不同,从而影响性能与运维管理。
什么是集群及其必要性
集群是由多个互联计算机(节点)组成的集合,共同作为一个系统工作。当数据量超过单机高效处理能力时,大数据处理就需要集群。通过将计算工作负载分布到多台机器,集群使组织能够处理否则难以管理的 PB 级数据。
集群还提供容错与高可用性。一台机器故障时,集群中的其他机器可接管其工作,确保持续运行。这种韧性对停机代价高昂的生产环境至关重要。
此外,集群支持水平扩展——通过增加机器来提升处理能力——这通常比升级单台系统更具成本效益。
对于有志于该领域的专业人士而言,理解集群是 数据工程中的一项基础技能。
Hadoop 集群架构
Hadoop 集群采用主从式架构,不同节点承担专门角色。 NameNode 是 HDFS 的主节点,维护文件位置与权限等元数据。DataNode 存储实际数据块并向 NameNode 汇报。
在处理层面, ResourceManager 负责分配集群资源,各机器上的 NodeManager 执行任务。
HDFS 会将数据复制到多个 DataNode,通常为每个数据块保留三份副本。该复制策略确保即便单个节点失败,数据仍可用,但需要额外的存储容量。
Hadoop 的集群设计强调数据本地性,尽量将计算任务调度到数据所在节点,以减少网络传输。
Hadoop 集群的运维传统上需要较高专业度(专业人士常通过准备 Hadoop 面试题来展示相关知识),尽管现代发行版已包含简化配置与监控的管理工具。
扩展 Hadoop 集群需要添加新节点并在扩展后的基础设施间重新平衡数据,这可能是需要精心规划的手动过程。
Spark 集群架构
Spark 可在多种集群配置下运行,包括独立模式、Hadoop YARN、Apache Mesos 或 Kubernetes。无论何种部署,Spark 都遵循 driver-executor 模型。Driver 程序包含应用的主函数,并创建 SparkContext,与集群管理器协作分配资源。
资源分配完成后,Spark 会在工作节点上启动 executors。这些 executors 是 JVM 进程,负责运行任务并将数据存储在内存或磁盘中。不同于 Hadoop 在集群节点上持续驻留的方式,Spark 的 executors 可根据应用需求动态分配与释放,从而潜在提升资源利用率。
感兴趣的读者可通过诸如 面向机器学习的 Apache Spark等实践教程进一步探索 Spark 的能力。
Spark 不包含自有的分布式存储系统,而是利用现有方案,如 HDFS、Amazon S3 或其他兼容存储系统。计算与存储的这种解耦提供了灵活性,但需要仔细配置以确保最佳的数据访问模式。
诸如 Spark SQL 与 sparklyr 等工具提供了与该架构交互的便捷方式。
集群管理的关键差异
Hadoop 的集群管理更偏向基础设施中心,资源分配相对静态,注重数据本地性。该设计适用于稳定集群中的长时间批处理作业,节点变化不频繁的场景。
然而,它对变化的工作负载响应较弱,扩容时需要更多人工干预。
Spark 提供更动态的资源管理,特别是在 Kubernetes 等现代编排平台上运行时。它可根据当前需求调整资源分配,并在不需要时释放资源。
这种弹性对工作负载波动较大或共用基础设施承载多个应用的组织而言极具价值。
理解这些差异对于正在追求 数据工程师认证或准备 Spark 面试题的专业人士至关重要。
对于刚开始进入大数据领域的组织而言,Spark 更灵活的部署选项与更简单的编程模型,通常更易上手。
然而,在数据量极其庞大且以存储管理为主要关注点的环境中,Hadoop 成熟的 HDFS 生态仍具优势,能与 Spark 的处理能力形成互补。若想了解 Spark 与其他流技术的比较,读者可参考 Flink vs. Spark 等内容。
Hadoop MapReduce vs. Spark 的处理模型
前文讨论了性能层面的影响,而理解两者的基本处理模型有助于解释它们为何在架构上差异显著。
Hadoop MapReduce 框架
MapReduce 遵循刚性编程范式,包含两个主要阶段:map 与 reduce。map 阶段并行地对每条记录应用函数,生成中间键值对。
这些键值对会经过强制性的 shuffle 与排序阶段,将相同键的数据分组。
最终,reduce 阶段对分组后的值进行聚合,产出最终结果。这种结构化方式意味着复杂操作需要将多个 MapReduce 作业级联起来。
开发 MapReduce 应用通常需要编写低层代码,显式定义 map 与 reduce 函数。
尽管 Apache Pig 和 Apache Hive 等框架提供了更高层的抽象,但底层执行仍遵循严格的 MapReduce 模式,从而对算法设计与优化空间造成限制。
Spark 的数据处理模型
Spark 引入了 弹性分布式数据集(RDD) 作为核心抽象——不可变、分区的集合,可以通过血统信息进行恢复。与 MapReduce 不同,Spark 不强制固定的处理模式,而是提供两类操作:transformation(创建新的 RDD)与 action(返回结果)。
这种灵活性允许超越 map-reduce 范式的多样处理模式。
Spark 已超越 RDD,提供更高层抽象,如 DataFrame 与 Dataset,提供类似关系型数据库优化的模式感知处理。这些抽象与面向流处理、 SQL、 机器学习 与图处理的专用库相结合,使开发者能以显著少于等效 MapReduce 实现的代码量来表达复杂工作流,同时在不同处理范式间保持统一的编程模型。
Spark 与 Hadoop 的成本考量
在评估大数据框架时,组织需要考虑的不仅是技术能力,还包括部署与运维的财务影响。
硬件需求与影响
Hadoop 与 Spark 在硬件偏好上有本质差异,会影响基础设施成本。Hadoop 设计上优先考虑磁盘存储而非内存,适合内存有限但硬盘容量可观的通用硬件。
这种架构可降低初始硬件投资,尤其是在处理极大数据集、基于内存的方案成本高昂的情况下。
Spark 的内存处理模型带来性能优势,但需要显著更多的每节点内存。合理配置的 Spark 集群通常需要高内存配置的服务器——视工作负载而定,每节点常在 16GB 到 256GB。
尽管内存价格逐年下降,这一需求与以磁盘为中心的 Hadoop 部署相比,仍可能提高硬件开支。
运维开销
运维成本不仅包括硬件采购,还包括持续的维护、电力、制冷与机房空间。Hadoop 集群由于依赖众多配备大量存储的通用服务器,物理占用通常更大。
更大的占用意味着更高的电力、制冷与机架空间成本。
Spark 集群有时可凭借更高效的计算资源利用,以更少的节点实现同等处理能力,从而可能减少数据中心占用与相关成本。不过,所需的高规格机器每节点耗电更高,可能部分抵消这些节省。
开发与人力成本
实现与维护的复杂性会显著影响总体拥有成本。Hadoop 生态传统上需要精通 Java 编程与 Unix 管理的专门技能,且由于 MapReduce 编程冗长,开发周期可能偏长。
Spark 提供更易用的 Python、Scala、R 与 Java API,可能缩短开发时间并降低人力成本。
更直观的编程模型可降低学习曲线与开发时长,使组织以更少的专才更快落地解决方案。
成本优化策略
对于成本敏感的组织,混合方案往往最具价值。在存储层使用 HDFS、在处理层利用 Spark,能将 Hadoop 的高性价比存储与 Spark 的高效处理相结合。基于云的部署(如 AWS EMR、Azure HDInsight、Google Dataproc)允许按用量付费,无需大量前期资本开支。
组织还应考虑扩展成本。Hadoop 传统上需要手动干预来扩容,增加运维开销。Spark 对 Kubernetes 等容器编排平台的兼容,使其能够更自动化、弹性地扩缩,将资源供给更好地匹配实际需求,潜在减少闲置容量。
Hadoop 与 Spark 对比表
下表对二者差异进行了总结:
Feature
Hadoop
Spark
Processing Model
Batch processing using MapReduce
In-memory processing using RDDs, DataFrames, and Datasets
Performance
Slower due to disk I/O between stages
Up to 100x faster for iterative and in-memory workloads
Memory Usage
Disk-centric, low memory requirements
Memory-intensive, high RAM requirements
Ease of Development
Verbose; requires writing map & reduce logic explicitly
High-level APIs in Python, Scala, R, Java; less boilerplate
Fault Tolerance
Data replication via HDFS
RDD lineage enables recomputation in case of failure
Real-time Processing
Not ideal; batch only
Supports real-time processing via Spark Streaming
Cluster Manager
YARN
Standalone, YARN, Mesos, or Kubernetes
Storage
Comes with HDFS
Depends on external storage (e.g., HDFS, S3, GCS)
Cost
Lower hardware cost (commodity machines, disk-based)
Higher memory cost but better resource utilization per workload
Best For
Batch jobs, massive-scale storage, historical data analysis
Machine learning, stream processing, interactive analytics
Integration
Strong Hadoop ecosystem (Hive, Pig, etc.)
Unified APIs for SQL, MLlib, GraphX, and Streaming in a single platform
结论
Hadoop 与 Spark 在大数据处理上更像是互补而非单纯的竞争关系。Hadoop 以其高性价比的存储系统(HDFS)和面向批处理的能力,在处理以吞吐量为先的海量数据集时表现突出。
Spark 则凭借内存计算能力,在迭代算法、交互式分析与实时处理需求方面展现出卓越性能。
如果您希望进一步了解这两项技术,DataCamp 提供了多种资源: