Apache Hadoop, vaak gewoon Hadoop genoemd, is een krachtig open-sourceframework dat is gebouwd om enorme datasets te verwerken en op te slaan door ze te verdelen over clusters van betaalbare, standaardhardware. De kracht zit in schaalbaarheid en flexibiliteit, waardoor het met zowel gestructureerde als ongestructureerde data kan werken.
In deze post neem ik je mee langs de belangrijkste componenten van Hadoop—hoe het data op grote schaal opslaat, verwerkt en beheert. Aan het einde heb je een duidelijk beeld van hoe deze basistechnologie past in bigdata-ecosystemen.
Overzicht van het Hadoop-ecosysteem
Hadoop is geen losse tool. Het is een ecosysteem dat uit meerdere modules bestaat die samenwerken voor databeheer, -verwerking en resourcecoördinatie.
Kernmodules van Hadoop
Hadoop bestaat uit vier basismodules:
- HDFS (Hadoop Distributed File System): Een gedistribueerd opslagsysteem dat bestanden in blokken opsplitst en over een cluster verdeelt.
- MapReduce: Een programmeermodel om data parallel over nodes te verwerken.
- YARN (Yet Another Resource Negotiator): Beheert resources en plant taken in het cluster.
- Hadoop Common: Een set gedeelde bibliotheken en hulpprogramma's die andere modules ondersteunen.
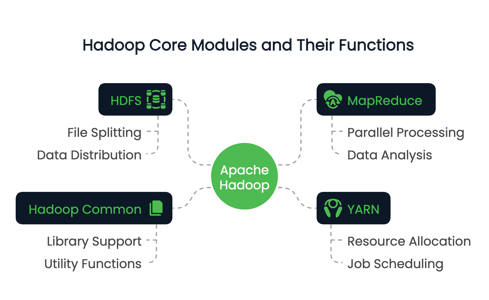
Deze modules werken samen om een gedistribueerde computenomgeving te creëren die petabytes aan data aankan.
Wil je verkennen hoe gedistribueerde dataverwerking zich over platforms verhoudt, biedt de cursus Big Data Fundamentals with PySpark een praktische introductie die je begrip van Hadoop aanvult.
Rol van Hadoop in big data
De primaire rol van Hadoop ligt in het vermogen om een kernuitdaging in big data-verwerking aan te pakken, namelijk schaalbaarheid.
Traditionele systemen hebben vaak moeite met datasets die de capaciteit van één machine te boven gaan, zowel qua opslag als rekenkracht. Hadoop lost dit op door data over veel nodes te verdelen en berekeningen parallel uit te voeren.
Zo kan Hadoop terabytes of zelfs petabytes aan data efficiënt verwerken. Naast schaalbaarheid heeft Hadoop ook sterke fouttolerantie door datareplica's en stelt het organisaties in staat om kosteneffectieve datainfrastructuur op te bouwen met standaardhardware.
Belangrijkste kenmerken van Hadoop
We hebben de rol en structuur van Hadoop besproken; laten we nu kijken naar enkele van de meest waardevolle eigenschappen. Dit zijn onder andere:
- Gedistribueerde opslag en verwerking, waardoor het extreem grote datasets kan opslaan en bevragen.
- Horizontale schaalbaarheid zonder high-end machines.
- Optimalisatie van datalocaliteit: de berekening naar de data brengen.
- Weerbaarheid tegen fouten via replicatie en het opnieuw uitvoeren van taken.
Deze eigenschappen maken Hadoop zeer geschikt voor batchverwerking, loganalyse en ETL-pijplijnen. Hadoop is een klassiek casestudy in gedistribueerd rekenen, waarbij berekeningen over meerdere nodes plaatsvinden om efficiëntie en schaal te vergroten.
Laten we nu elk van de kernmodules van Hadoop in detail bekijken.
Je Hadoop-kennis valideren of je voorbereiden op een datarol? Hier zijn 24 Hadoop-sollicitatievragen en antwoorden voor 2025 om je op weg te helpen.
Hadoop Distributed File System (HDFS)
Van de vier hoofdcomponenten is HDFS het primaire opslagsysteem van Hadoop. Het is ontworpen om betrouwbaar enorme hoeveelheden data op te slaan over een cluster van machines, zoals we eerder bespraken. De architectuur is opgezet voor dit type toegang tot grote datasets en is geoptimaliseerd voor fouttolerantie, schaalbaarheid en datalocaliteit.
Architectuur en componenten
De HDFS-architectuur draait om een master-slavemodel. Bovenaan staat de NameNode, die de metadata beheert—kortom, de mappenstructuur van het bestandssysteem en informatie over de locatie van elk bestand. Het slaat niet de daadwerkelijke data op.
De DataNodes zijn de werkpaarden. Ze beheren de opslag die aan de nodes is gekoppeld en bedienen lees-/schrijfverzoeken van clients. Elke DataNode rapporteert regelmatig terug aan de NameNode met een heartbeat en blokrapporten om een consistente statusbewaking te garanderen.
Ten slotte omvat HDFS een Secondary NameNode, die je niet moet verwarren met een failover-node. In plaats daarvan maakt deze periodiek een checkpoint van de metadata van de NameNode om de opstarttijd en geheugendruk te verminderen.
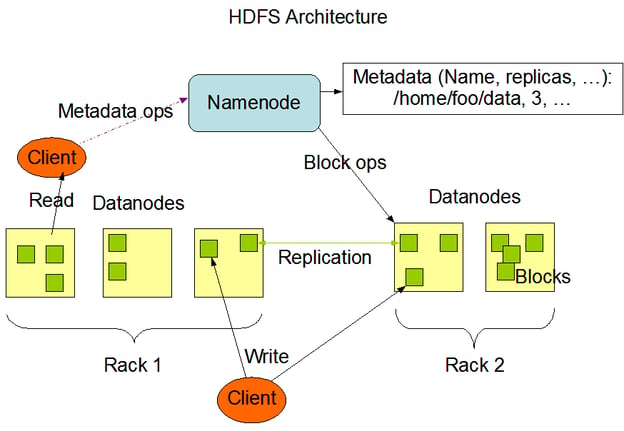
De HDFS-architectuur. Afbeeldingsbron: Apache Hadoop-documentatie
Hoe data in HDFS wordt opgeslagen
Wanneer een bestand naar HDFS wordt geschreven, wordt het opgesplitst in vaste blokken van 64 MB. Elk blok wordt vervolgens over verschillende DataNodes verspreid. Deze verdelingsstrategie ondersteunt parallellisme tijdens data-toegang en verhoogt de fouttolerantie.
Data in HDFS wordt niet slechts één keer opgeslagen. Elk blok wordt gerepliceerd (standaard drie kopieën) en over het cluster verspreid. Tijdens een leesbewerking haalt het systeem data op van de dichtstbijzijnde beschikbare replica om de doorvoer te maximaliseren en de latentie te minimaliseren. Schrijfbewerkingen gaan eerst naar één replica en verspreiden zich daarna naar de andere, wat duurzaamheid waarborgt zonder directe knelpunten.
Dit ontwerp op blokniveau stelt HDFS ook in staat om horizontaal te schalen. Er kunnen nieuwe nodes aan het cluster worden toegevoegd, waarna het systeem data herverdeelt om extra capaciteit te benutten.
Ter vergelijking met andere bigdataformaten: verken hoe Apache Parquet kolomgebaseerde opslag optimaliseert voor analytische workloads.
Fouttolerantie in HDFS
HDFS is gebouwd met falen in gedachten. In grote gedistribueerde systemen worden node-uitval verwacht, niet als uitzondering gezien. HDFS waarborgt datatoegankelijkheid via het replicatiemechanisme. Als een DataNode uitvalt, detecteert de NameNode het falen via gemiste heartbeats en plant de replicatie van verloren blokken naar gezonde nodes.
Bovendien bewaakt het systeem voortdurend de gezondheid van blokken en start waar nodig replicatie. De redundante opslagstrategie, gecombineerd met proactieve monitoring, zorgt ervoor dat geen enkel single point of failure de dataintegriteit of -toegang kan ondermijnen.
MapReduce-framework
Vervolgens komt de verwerkingsengine van Hadoop, MapReduce. Het maakt gedistribueerde berekeningen over grote datasets mogelijk door taken op te delen in kleinere, onafhankelijke bewerkingen die parallel kunnen worden uitgevoerd.
Het model vereenvoudigt complexe datatransformaties en is vooral geschikt voor batchverwerking in een gedistribueerde omgeving.
Overzicht van MapReduce
MapReduce volgt een programmeermodel in twee fasen: de Map- en Reduce-fase.
Tijdens de Map-fase wordt de inputdataset verdeeld in kleinere stukken en wordt elk stuk verwerkt om key-valueparen te produceren. Deze tussentijdse resultaten worden vervolgens geshuffeld en gesorteerd voordat ze naar de Reduce-fase gaan, waar ze worden geaggregeerd of getransformeerd tot eindresultaten.
Dit model is zeer effectief voor taken zoals het tellen van woordfrequenties, het filteren van logs of het joinen van datasets op schaal.
Ontwikkelaars implementeren eigen logica via map()- en reduce()-functies, die het framework over het cluster orkestreert.
Uitvoeringsstroom van een MapReduce-job
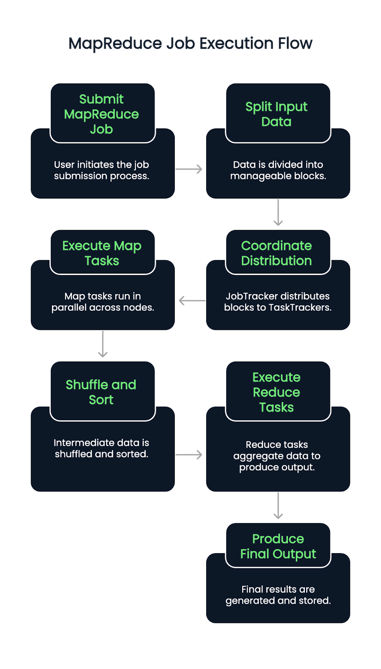
Wanneer een MapReduce-job wordt ingediend, wordt de inputdata eerst opgesplitst in blokken. Een JobTracker (of ResourceManager in YARN-versies) coördineert vervolgens de verdeling van deze blokken over beschikbare TaskTrackers of NodeManagers.
De Map-taken worden parallel over nodes uitgevoerd, lezen input-splits en produceren tussentijdse key-valueparen. Deze paren worden automatisch geshuffeld en gesorteerd. Zodra deze fase is voltooid, starten de Reduce-taken, die gegroepeerde data binnenhalen en aggregatielogica toepassen om de uiteindelijke output te produceren.
Het proces waarborgt datalocaliteit door taken toe te wijzen dicht bij waar de data zich bevindt, wat netwerkcongestie minimaliseert en de doorvoer verbetert. Taakfouten worden gedetecteerd en automatisch opnieuw toegewezen, wat bijdraagt aan de veerkracht van het systeem.
Voordelen en beperkingen van MapReduce
MapReduce biedt verschillende duidelijke voordelen:
- Uitstekend parallellisme voor grootschalige batchverwerking
- Schaalbaarheid over duizenden nodes
- Sterke fouttolerantie door taken opnieuw uit te voeren en te checkpointen
Maar er zijn ook afwegingen:
- Het model heeft hoge latentie en is daarom minder ideaal voor realtimeverwerking
- Aangepaste MapReduce-jobs schrijven kan veel werk zijn en lastig te debuggen
- Het mist de interactiviteit en flexibiliteit van nieuwere tools zoals Apache Spark.
Twijfel je tussen Hadoop en Spark? Lees onze gids om te bepalen welk Big Data-framework bij je past.
YARN: Yet Another Resource Negotiator
YARN fungeert als Hadoops resourcemanagementlaag. Het scheidt jobplanning en resource-toewijzing van het verwerkingsmodel, waardoor Hadoop meerdere dataverwerkingsengines naast MapReduce kan ondersteunen.
Rol in de Hadoop-architectuur
YARN treedt op als het centrale platform voor het beheren van rekenresources in het cluster. Het wijst beschikbare systeemresources toe aan meerdere applicaties en coördineert de uitvoering. Deze scheiding van verantwoordelijkheden helpt Hadoop efficiënt op te schalen en maakt ondersteuning van andere frameworks zoals Apache Spark, Hive en Tez mogelijk.
Belangrijke YARN-componenten
YARN introduceert drie componenten:
- ResourceManager: De masterdaemon (achtergrondprogramma) die alle resources beheert en applicaties plant.
- NodeManager: Een agent per node die het resourcegebruik monitort en rapporteert aan de ResourceManager.
- ApplicationMaster: Een taakspecifieke operatie die resources van de ResourceManager gebruikt en de uitvoering met NodeManagers coördineert.
Elke applicatie (zoals een MapReduce-job) heeft een eigen ApplicationMaster, wat zorgt voor betere foutisolatie en jobtracking.
YARN-resourcebeheerproces
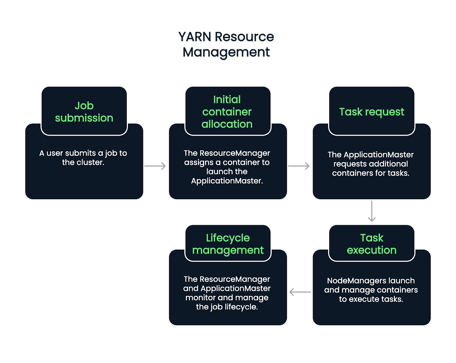
De stroom begint wanneer een gebruiker een job indient. De ResourceManager accepteert de job en wijst een container toe om de ApplicationMaster te starten. Vanaf daar vraagt de ApplicationMaster meer containers aan om taken uit te voeren, gebaseerd op de huidige werklast en beschikbaarheid.
NodeManagers starten en beheren deze containers, die individuele taken draaien. Gedurende de hele levenscyclus van de job verzorgen de ResourceManager en ApplicationMaster de monitoring, foutafhandeling en rapportage van afronding. Het gaat dus om een proces in vijf stappen.
- Indienen van de job: Een gebruiker dient een job in bij het cluster.
- Initiële containertoewijzing: De ResourceManager accepteert de job en wijst een container toe om de ApplicationMaster te starten.
- Taakverzoek: De ApplicationMaster vraagt extra containers aan om specifieke taken te draaien, op basis van werklast en beschikbare resources.
- Taakuitvoering: NodeManagers starten en beheren deze containers, die de taken uitvoeren.
- Levenscyclusbeheer: De ResourceManager en ApplicationMaster werken samen om de voortgang te monitoren, fouten af te handelen en taakafronding te bevestigen. Gedurende de hele levenscyclus van de job verzorgen de ResourceManager en ApplicationMaster de monitoring, herstel bij falen en rapportage van voltooiing.
Hadoop Common en utilities
De lijm die alle componenten van Hadoop bij elkaar houdt, is Hadoop Common. Het is een verzameling bibliotheken, configuratiebestanden en hulpprogramma's die door alle modules nodig zijn.
Wat is Hadoop Common
Hadoop Common levert de basiscode en tools waarmee HDFS, YARN en MapReduce kunnen communiceren en coördineren. Dit omvat Java-bibliotheken, bestandsclients en API's die in het hele ecosysteem worden gebruikt.
Het zorgt ook voor consistentie en compatibiliteit tussen modules, zodat ontwikkelaars kunnen bouwen op een gedeelde set bouwstenen.
Een goede configuratie van Hadoop is cruciaal. Hadoop Common bevat configuratiebestanden zoals core-site.xml, die standaardgedrag definiëren zoals filesystem-URI's en I/O-instellingen.
De commandlinetools en scripts in Hadoop Common ondersteunen taken zoals services starten, de gezondheid van nodes controleren en jobs beheren. Op de meeste van deze tools vertrouwen systeembeheerders en ontwikkelaars voor dagelijkse clusteroperaties.
Toepassingen van Hadoop in de praktijk
Als er gebruik wordt gemaakt van enorme datasets, gedistribueerde verwerking of batchanalyses, is de kans groot dat Hadoop wordt ingezet. Concreter: Hadoop wordt in diverse sectoren gebruikt om enorme hoeveelheden gestructureerde en ongestructureerde data te verwerken. Het gedistribueerde ontwerp en de open-sourceflexibiliteit maken het veelzijdig voor data-intensieve taken.
Sectoren die Hadoop benutten
Organisaties in financiën, gezondheidszorg, telecommunicatie, e-commerce en sociale media gebruiken routinematig Hadoop. Het helpt banken fraude in realtime te detecteren, ondersteunt genomisch onderzoek in de gezondheidszorg en maakt aanbevelingssystemen mogelijk in online retail.
Voorbeelden van use-cases
- Logverwerking: Logdata van servers en applicaties aggregeren en analyseren.
- Aanbevelingssystemen: Modellen bouwen die content of producten suggereren.
- Fraudedetectie: Verdachte gedragspatronen in transacties identificeren.
Deze scenario's profiteren van Hadoop's vermogen om grote datasets met fouttolerantie en parallellisme te verwerken.
Voor een modern, cloud-native alternatief voor Hadoop kun je de cursus Introduction to Databricks proberen, die Spark en andere schaalbare tools ondersteunt.
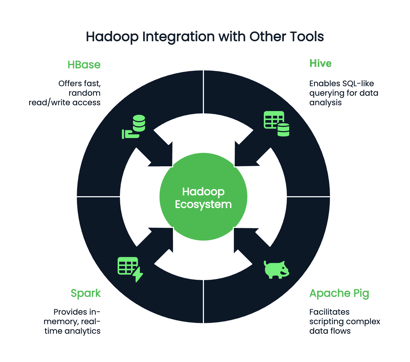
Hadoop werkt zelden geïsoleerd en kan integreren met honderden aanvullende programma's. Afhankelijk van je voorkeuren en je programmeeromgeving kun je Hadoop combineren met:
- Hive: Voor SQL-achtige query's
- Apache Pig: Voor het scripten van complexe datastromen
- Spark: Voor in-memory, realtime analytics
- HBase: Voor snelle, willekeurige lees-/schrijftoegang tot grote datasets
Conclusie
Hoewel Hadoop misschien niet meer het modewoord is dat het ooit was, blijft het een basistechnologie in het bigdatalandschap. Inzicht in Hadoop is nog steeds enorm waardevol voor elke dataprofessional die met grootschalige systemen werkt. De kerncomponenten—HDFS voor opslag, MapReduce voor verwerking, YARN voor resourcebeheer en Hadoop Common voor essentiële utilities—blijven bepalen hoe dataworkflows worden ontworpen en opgeschaald.
Voordat je met implementatie of optimalisatie begint, neem de tijd om te begrijpen hoe data wordt verdeeld en geconfigureerd binnen een Hadoop-cluster. Die kennis vereenvoudigt troubleshooting en performance-tuning en effent de weg voor integratie met krachtige tools zoals Apache Spark en Hive voor geavanceerdere analyses.
Voor meer over bigdataverwerking, bekijk:




Apache Hadoop, vaak gewoon Hadoop genoemd, is een krachtig open-sourceframework dat is gebouwd om enorme datasets te verwerken en op te slaan door ze te verdelen over clusters van betaalbare, standaardhardware. De kracht zit in schaalbaarheid en flexibiliteit, waardoor het met zowel gestructureerde als ongestructureerde data kan werken.
In deze post neem ik je mee langs de belangrijkste componenten van Hadoop—hoe het data op grote schaal opslaat, verwerkt en beheert. Aan het einde heb je een duidelijk beeld van hoe deze basistechnologie past in bigdata-ecosystemen.
Overzicht van het Hadoop-ecosysteem
Hadoop is geen losse tool. Het is een ecosysteem dat uit meerdere modules bestaat die samenwerken voor databeheer, -verwerking en resourcecoördinatie.
Kernmodules van Hadoop
Hadoop bestaat uit vier basismodules:
Deze modules werken samen om een gedistribueerde computenomgeving te creëren die petabytes aan data aankan.
Wil je verkennen hoe gedistribueerde dataverwerking zich over platforms verhoudt, biedt de cursus Big Data Fundamentals with PySpark een praktische introductie die je begrip van Hadoop aanvult.
Rol van Hadoop in big data
De primaire rol van Hadoop ligt in het vermogen om een kernuitdaging in big data-verwerking aan te pakken, namelijk schaalbaarheid.
Traditionele systemen hebben vaak moeite met datasets die de capaciteit van één machine te boven gaan, zowel qua opslag als rekenkracht. Hadoop lost dit op door data over veel nodes te verdelen en berekeningen parallel uit te voeren.
Zo kan Hadoop terabytes of zelfs petabytes aan data efficiënt verwerken. Naast schaalbaarheid heeft Hadoop ook sterke fouttolerantie door datareplica's en stelt het organisaties in staat om kosteneffectieve datainfrastructuur op te bouwen met standaardhardware.
Belangrijkste kenmerken van Hadoop
We hebben de rol en structuur van Hadoop besproken; laten we nu kijken naar enkele van de meest waardevolle eigenschappen. Dit zijn onder andere:
Deze eigenschappen maken Hadoop zeer geschikt voor batchverwerking, loganalyse en ETL-pijplijnen. Hadoop is een klassiek casestudy in gedistribueerd rekenen, waarbij berekeningen over meerdere nodes plaatsvinden om efficiëntie en schaal te vergroten.
Laten we nu elk van de kernmodules van Hadoop in detail bekijken.
Je Hadoop-kennis valideren of je voorbereiden op een datarol? Hier zijn 24 Hadoop-sollicitatievragen en antwoorden voor 2025 om je op weg te helpen.
Hadoop Distributed File System (HDFS)
Van de vier hoofdcomponenten is HDFS het primaire opslagsysteem van Hadoop. Het is ontworpen om betrouwbaar enorme hoeveelheden data op te slaan over een cluster van machines, zoals we eerder bespraken. De architectuur is opgezet voor dit type toegang tot grote datasets en is geoptimaliseerd voor fouttolerantie, schaalbaarheid en datalocaliteit.
Architectuur en componenten
De HDFS-architectuur draait om een master-slavemodel. Bovenaan staat de NameNode, die de metadata beheert—kortom, de mappenstructuur van het bestandssysteem en informatie over de locatie van elk bestand. Het slaat niet de daadwerkelijke data op.
De DataNodes zijn de werkpaarden. Ze beheren de opslag die aan de nodes is gekoppeld en bedienen lees-/schrijfverzoeken van clients. Elke DataNode rapporteert regelmatig terug aan de NameNode met een heartbeat en blokrapporten om een consistente statusbewaking te garanderen.
Ten slotte omvat HDFS een Secondary NameNode, die je niet moet verwarren met een failover-node. In plaats daarvan maakt deze periodiek een checkpoint van de metadata van de NameNode om de opstarttijd en geheugendruk te verminderen.
De HDFS-architectuur. Afbeeldingsbron: Apache Hadoop-documentatie
Hoe data in HDFS wordt opgeslagen
Wanneer een bestand naar HDFS wordt geschreven, wordt het opgesplitst in vaste blokken van 64 MB. Elk blok wordt vervolgens over verschillende DataNodes verspreid. Deze verdelingsstrategie ondersteunt parallellisme tijdens data-toegang en verhoogt de fouttolerantie.
Data in HDFS wordt niet slechts één keer opgeslagen. Elk blok wordt gerepliceerd (standaard drie kopieën) en over het cluster verspreid. Tijdens een leesbewerking haalt het systeem data op van de dichtstbijzijnde beschikbare replica om de doorvoer te maximaliseren en de latentie te minimaliseren. Schrijfbewerkingen gaan eerst naar één replica en verspreiden zich daarna naar de andere, wat duurzaamheid waarborgt zonder directe knelpunten.
Dit ontwerp op blokniveau stelt HDFS ook in staat om horizontaal te schalen. Er kunnen nieuwe nodes aan het cluster worden toegevoegd, waarna het systeem data herverdeelt om extra capaciteit te benutten.
Ter vergelijking met andere bigdataformaten: verken hoe Apache Parquet kolomgebaseerde opslag optimaliseert voor analytische workloads.
Fouttolerantie in HDFS
HDFS is gebouwd met falen in gedachten. In grote gedistribueerde systemen worden node-uitval verwacht, niet als uitzondering gezien. HDFS waarborgt datatoegankelijkheid via het replicatiemechanisme. Als een DataNode uitvalt, detecteert de NameNode het falen via gemiste heartbeats en plant de replicatie van verloren blokken naar gezonde nodes.
Bovendien bewaakt het systeem voortdurend de gezondheid van blokken en start waar nodig replicatie. De redundante opslagstrategie, gecombineerd met proactieve monitoring, zorgt ervoor dat geen enkel single point of failure de dataintegriteit of -toegang kan ondermijnen.
MapReduce-framework
Vervolgens komt de verwerkingsengine van Hadoop, MapReduce. Het maakt gedistribueerde berekeningen over grote datasets mogelijk door taken op te delen in kleinere, onafhankelijke bewerkingen die parallel kunnen worden uitgevoerd.
Het model vereenvoudigt complexe datatransformaties en is vooral geschikt voor batchverwerking in een gedistribueerde omgeving.
Overzicht van MapReduce
MapReduce volgt een programmeermodel in twee fasen: de Map- en Reduce-fase.
Tijdens de Map-fase wordt de inputdataset verdeeld in kleinere stukken en wordt elk stuk verwerkt om key-valueparen te produceren. Deze tussentijdse resultaten worden vervolgens geshuffeld en gesorteerd voordat ze naar de Reduce-fase gaan, waar ze worden geaggregeerd of getransformeerd tot eindresultaten.
Dit model is zeer effectief voor taken zoals het tellen van woordfrequenties, het filteren van logs of het joinen van datasets op schaal.
Ontwikkelaars implementeren eigen logica via
map()- enreduce()-functies, die het framework over het cluster orkestreert.Uitvoeringsstroom van een MapReduce-job
Wanneer een MapReduce-job wordt ingediend, wordt de inputdata eerst opgesplitst in blokken. Een JobTracker (of ResourceManager in YARN-versies) coördineert vervolgens de verdeling van deze blokken over beschikbare TaskTrackers of NodeManagers.
De Map-taken worden parallel over nodes uitgevoerd, lezen input-splits en produceren tussentijdse key-valueparen. Deze paren worden automatisch geshuffeld en gesorteerd. Zodra deze fase is voltooid, starten de Reduce-taken, die gegroepeerde data binnenhalen en aggregatielogica toepassen om de uiteindelijke output te produceren.
Het proces waarborgt datalocaliteit door taken toe te wijzen dicht bij waar de data zich bevindt, wat netwerkcongestie minimaliseert en de doorvoer verbetert. Taakfouten worden gedetecteerd en automatisch opnieuw toegewezen, wat bijdraagt aan de veerkracht van het systeem.
Voordelen en beperkingen van MapReduce
MapReduce biedt verschillende duidelijke voordelen:
Maar er zijn ook afwegingen:
Twijfel je tussen Hadoop en Spark? Lees onze gids om te bepalen welk Big Data-framework bij je past.
YARN: Yet Another Resource Negotiator
YARN fungeert als Hadoops resourcemanagementlaag. Het scheidt jobplanning en resource-toewijzing van het verwerkingsmodel, waardoor Hadoop meerdere dataverwerkingsengines naast MapReduce kan ondersteunen.
Rol in de Hadoop-architectuur
YARN treedt op als het centrale platform voor het beheren van rekenresources in het cluster. Het wijst beschikbare systeemresources toe aan meerdere applicaties en coördineert de uitvoering. Deze scheiding van verantwoordelijkheden helpt Hadoop efficiënt op te schalen en maakt ondersteuning van andere frameworks zoals Apache Spark, Hive en Tez mogelijk.
Belangrijke YARN-componenten
YARN introduceert drie componenten:
Elke applicatie (zoals een MapReduce-job) heeft een eigen ApplicationMaster, wat zorgt voor betere foutisolatie en jobtracking.
YARN-resourcebeheerproces
De stroom begint wanneer een gebruiker een job indient. De ResourceManager accepteert de job en wijst een container toe om de ApplicationMaster te starten. Vanaf daar vraagt de ApplicationMaster meer containers aan om taken uit te voeren, gebaseerd op de huidige werklast en beschikbaarheid.
NodeManagers starten en beheren deze containers, die individuele taken draaien. Gedurende de hele levenscyclus van de job verzorgen de ResourceManager en ApplicationMaster de monitoring, foutafhandeling en rapportage van afronding. Het gaat dus om een proces in vijf stappen.
Hadoop Common en utilities
De lijm die alle componenten van Hadoop bij elkaar houdt, is Hadoop Common. Het is een verzameling bibliotheken, configuratiebestanden en hulpprogramma's die door alle modules nodig zijn.
Wat is Hadoop Common
Hadoop Common levert de basiscode en tools waarmee HDFS, YARN en MapReduce kunnen communiceren en coördineren. Dit omvat Java-bibliotheken, bestandsclients en API's die in het hele ecosysteem worden gebruikt.
Het zorgt ook voor consistentie en compatibiliteit tussen modules, zodat ontwikkelaars kunnen bouwen op een gedeelde set bouwstenen.
Belang van configuratie en tools
Een goede configuratie van Hadoop is cruciaal. Hadoop Common bevat configuratiebestanden zoals
core-site.xml, die standaardgedrag definiëren zoals filesystem-URI's en I/O-instellingen.De commandlinetools en scripts in Hadoop Common ondersteunen taken zoals services starten, de gezondheid van nodes controleren en jobs beheren. Op de meeste van deze tools vertrouwen systeembeheerders en ontwikkelaars voor dagelijkse clusteroperaties.
Toepassingen van Hadoop in de praktijk
Als er gebruik wordt gemaakt van enorme datasets, gedistribueerde verwerking of batchanalyses, is de kans groot dat Hadoop wordt ingezet. Concreter: Hadoop wordt in diverse sectoren gebruikt om enorme hoeveelheden gestructureerde en ongestructureerde data te verwerken. Het gedistribueerde ontwerp en de open-sourceflexibiliteit maken het veelzijdig voor data-intensieve taken.
Sectoren die Hadoop benutten
Organisaties in financiën, gezondheidszorg, telecommunicatie, e-commerce en sociale media gebruiken routinematig Hadoop. Het helpt banken fraude in realtime te detecteren, ondersteunt genomisch onderzoek in de gezondheidszorg en maakt aanbevelingssystemen mogelijk in online retail.
Voorbeelden van use-cases
Deze scenario's profiteren van Hadoop's vermogen om grote datasets met fouttolerantie en parallellisme te verwerken.
Voor een modern, cloud-native alternatief voor Hadoop kun je de cursus Introduction to Databricks proberen, die Spark en andere schaalbare tools ondersteunt.
Integratie met andere tools
Hadoop werkt zelden geïsoleerd en kan integreren met honderden aanvullende programma's. Afhankelijk van je voorkeuren en je programmeeromgeving kun je Hadoop combineren met:
Conclusie
Hoewel Hadoop misschien niet meer het modewoord is dat het ooit was, blijft het een basistechnologie in het bigdatalandschap. Inzicht in Hadoop is nog steeds enorm waardevol voor elke dataprofessional die met grootschalige systemen werkt. De kerncomponenten—HDFS voor opslag, MapReduce voor verwerking, YARN voor resourcebeheer en Hadoop Common voor essentiële utilities—blijven bepalen hoe dataworkflows worden ontworpen en opgeschaald.
Voordat je met implementatie of optimalisatie begint, neem de tijd om te begrijpen hoe data wordt verdeeld en geconfigureerd binnen een Hadoop-cluster. Die kennis vereenvoudigt troubleshooting en performance-tuning en effent de weg voor integratie met krachtige tools zoals Apache Spark en Hive voor geavanceerdere analyses.
Voor meer over bigdataverwerking, bekijk: