Apache Hadoop, çoğunlukla yalnızca Hadoop olarak anılan, uygun maliyetli, standart donanım kümelerine dağıtarak çok büyük veri kümelerini işlemek ve depolamak üzere oluşturulmuş güçlü bir açık kaynak çerçevedir. Gücünü ölçeklenebilirlik ve esneklikten alır; hem yapılandırılmış hem de yapılandırılmamış verilerle çalışabilir.
Bu yazıda, Hadoop’u oluşturan temel bileşenleri—veriyi nasıl depoladığı, işlediği ve büyük ölçekte yönettiğini—adım adım ele alacağım. Sonunda, bu temel teknolojinin büyük veri ekosistemlerine nasıl oturduğuna dair net bir resme sahip olacaksınız.
Hadoop Ekosistemine Genel Bakış
Hadoop tek bir araç değildir. Veri depolamayı, işlemeyi ve kaynak koordinasyonunu birlikte yöneten birden fazla modülden oluşan bir ekosistemdir.
Hadoop’un çekirdek modülleri
Hadoop dört temel modülden oluşur:
- HDFS (Hadoop Distributed File System): Dosyaları bloklara ayırıp bir küme genelinde dağıtan dağıtık bir depolama sistemi.
- MapReduce: Veriyi düğümler arasında paralel olarak işlemek için kullanılan bir programlama modeli.
- YARN (Yet Another Resource Negotiator): Kümede kaynakları yönetir ve işleri zamanlar.
- Hadoop Common: Diğer modülleri destekleyen paylaşılan kütüphaneler ve yardımcı araçların bir seti.
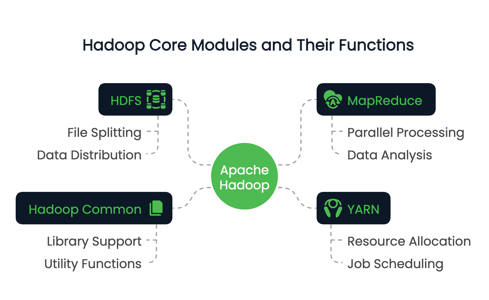
Bu modüller, petabaytlarca veriyi kaldırabilen bir dağıtık hesaplama ortamı oluşturmak için birlikte çalışır.
Dağıtık veri işlemenin platformlar arasında nasıl karşılaştırıldığına göz atmak için, Big Data Fundamentals with PySpark kursu, Hadoop bilginizi tamamlayan uygulamalı bir giriş sunar.
Büyük veride Hadoop’un rolü
Hadoop’un birincil rolü, büyük veri işlemede temel bir sorunu, yani ölçeklenebilirliği, ele alma yeteneğinde yatar.
Geleneksel sistemler, tek bir makinenin depolama ve işlem kapasitesini aşan veri kümeleriyle sıklıkla zorlanır. Hadoop bunu, veriyi çok sayıda düğüme dağıtarak ve hesaplamaları paralel olarak yürüterek çözer.
Böylece Hadoop terabaytlarca hatta petabaytlarca veriyi verimli biçimde işleyebilir. Ölçeklenebilirliğinin ötesinde, Hadoop veri çoğaltma yoluyla derin bir hata toleransına sahiptir ve kuruluşların standart donanım kullanarak uygun maliyetli veri altyapıları kurmasına olanak tanır.
Hadoop’un temel özellikleri
Hadoop’un rolünü ve yapısını ele aldık; şimdi de en değerli özelliklerinden bazılarına bakalım. Bunlar şunları içerir:
- Dağıtık depolama ve işleme sayesinde son derece büyük veri kümelerini saklayabilir ve sorgulayabilir.
- Üst düzey makineler gerektirmeden yatay ölçeklenebilirlik.
- Veri yerelliği optimizasyonu; hesaplamayı verinin bulunduğu yere taşır.
- Çoğaltma ve görevi yeniden yürütme yoluyla arızalara dayanıklılık.
Bu özellikler, Hadoop’u toplu veri işleme, günlük analizi ve ETL boru hatları için uygun hale getirir. Hadoop, dağıtık hesaplama alanında klasik bir vaka incelemesidir; burada verimliliği ve ölçeği artırmak için hesaplama birden fazla düğümde gerçekleşir.
Şimdi, Hadoop’un her bir çekirdek modülüne ayrıntılı olarak bakalım.
Hadoop bilginizi doğrulamak veya bir veri rolüne hazırlık yapmak mı istiyorsunuz? Başlamak için 2025 için 24 Hadoop mülakat sorusu ve yanıtı burada.
Hadoop Dağıtık Dosya Sistemi (HDFS)
Dört ana bileşen arasında, HDFS Hadoop’un birincil depolama sistemidir. Önceki bölümlerde tartıştığımız gibi, çok büyük miktardaki veriyi güvenilir biçimde bir makine kümesi genelinde depolamak üzere tasarlanmıştır. Mimarisi bu tür büyük veri kümelerine erişim için kurgulanmıştır ve hata toleransı, ölçeklenebilirlik ve veri yerelliği için optimize edilmiştir.
Mimari ve bileşenler
HDFS mimarisi bir ana-köle modeli etrafında şekillenir. En üstte, dosya sisteminin dizin ağacını ve her dosyanın konumuna ilişkin bilgileri yani metaveriyi yöneten NameNode bulunur. Gerçek veriyi depolamaz.
DataNode’lar işin yükünü çeker. Düğümlere bağlı depolamayı yönetir ve istemcilerden gelen okuma/yazma isteklerine hizmet ederler. Her DataNode, tutarlı durum takibini sağlamak için düzenli olarak NameNode’a kalp atışı ve blok raporları gönderir.
Son olarak, HDFS bir İkincil NameNode içerir; bu, bir yedek devralma düğümüyle karıştırılmamalıdır. Bunun yerine, NameNode’un metaverisini periyodik olarak kontrol noktalarına alır; bu da başlatma süresini ve bellek yükünü azaltır.
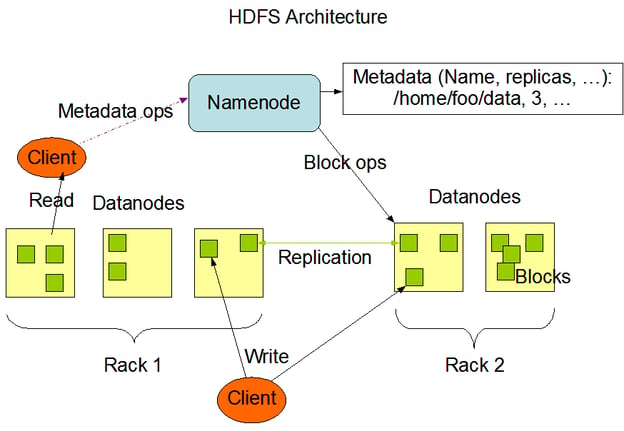
HDFS mimarisi. Görsel kaynağı: Apache Hadoop dokümantasyonu
Veri HDFS’te nasıl depolanır
Bir dosya HDFS’ye yazıldığında sabit boyutlu 64MB bloklara bölünür. Her blok daha sonra farklı DataNode’lara dağıtılır. Bu dağıtım stratejisi veri erişimi sırasında paralelliği destekler ve hata toleransını artırır.
HDFS’te veri yalnızca bir kez depolanmaz. Her blok çoğaltılır (varsayılan üç kopyadır) ve küme genelinde yayılır. Okuma işlemi sırasında, sistem bant genişliğini en üst düzeye çıkarmak ve gecikmeyi en aza indirmek için veriyi en yakın uygun replikadan çeker. Yazmalar önce bir replikaya gider, ardından diğerlerine yayılır; bu da anlık darboğaz oluşturmadan dayanıklılığı sağlar.
Bu blok düzeyi tasarım, HDFS’in yatay olarak ölçeklenmesine de olanak tanır. Küme içine yeni düğümler eklenebilir ve sistem ek kapasiteden yararlanmak için veriyi yeniden dengeler.
Diğer büyük veri formatlarıyla karşılaştırma için, Apache Parquet’in analitik iş yükleri için sütunlu depolamayı nasıl optimize ettiğini keşfedin.
HDFS’te hata toleransı
HDFS, arızayı göz önünde bulundurarak inşa edilmiştir. Büyük dağıtık sistemlerde düğüm arızaları istisna değil, beklenen durumlardır. HDFS, çoğaltma mekanizmasıyla veri erişilebilirliğini güvence altına alır. Bir DataNode devre dışı kalırsa, NameNode kaçırılan kalp atışlarından arızayı tespit eder ve kaybolan blokların sağlıklı düğümlere çoğaltılmasını planlar.
Ayrıca sistem, blok sağlığını sürekli izler ve gerektiğinde çoğaltma başlatır. Yedekli depolama stratejisi, proaktif izleme ile birleşerek tek bir arıza noktasının veri bütünlüğünü veya erişimini tehlikeye atmasını engeller.
MapReduce Çerçevesi
Sırada Hadoop’un işleme motoru MapReduce var. Görevleri daha küçük, bağımsız ve paralel yürütülebilen işlemlere bölerek büyük veri kümeleri üzerinde dağıtık hesaplama yapmayı sağlar.
Model, karmaşık veri dönüşümlerini basitleştirir ve özellikle dağıtık bir ortamda toplu işlemeye uygundur.
MapReduce’a genel bakış
MapReduce, Map ve Reduce olmak üzere iki aşamalı bir programlama modelini izler.
Map aşamasında giriş veri kümesi daha küçük parçalara bölünür ve her parça anahtar-değer çiftleri üretmek üzere işlenir. Bu ara sonuçlar, Reduce aşamasına aktarılmadan önce karıştırılır ve sıralanır; Reduce aşamasında birleştirilir veya nihai çıktılara dönüştürülür.
Bu model, kelime sıklığı sayımı, günlüklerin filtrelenmesi veya büyük ölçekte veri kümelerinin birleştirilmesi gibi görevler için oldukça etkilidir.
Geliştiriciler, çerçevenin küme genelinde düzenlediği map() ve reduce() fonksiyonları aracılığıyla özel mantık uygular.
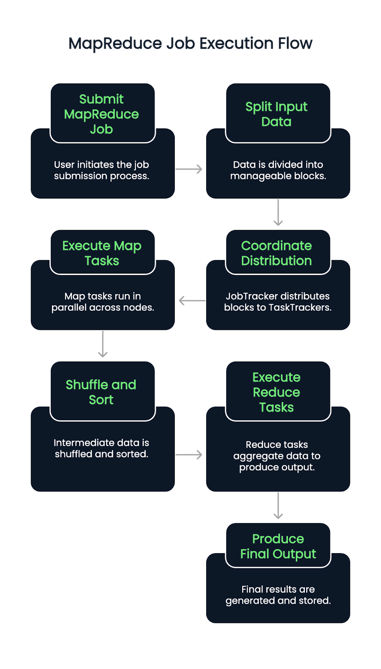
Bir MapReduce işinin yürütme akışı
Bir MapReduce işi gönderildiğinde, giriş verisi önce bloklara bölünür. Bir JobTracker (veya YARN etkin sürümlerde ResourceManager) daha sonra bu blokların mevcut TaskTracker’lar veya NodeManager’lar arasında dağıtımını koordine eder.
Map görevleri düğümler genelinde paralel olarak yürütülür; giriş bölümlerini okuyup ara anahtar-değer çiftleri üretir. Bu çiftler otomatik olarak karıştırılır ve sıralanır. Bu aşama tamamlandığında Reduce görevleri başlar; gruplanmış veriyi alır ve nihai çıktıyı üretmek için birleştirme mantığını uygular.
Süreç, görevleri verinin bulunduğu yere yakın atayarak veri yerelliğini garanti eder; bu da ağ tıkanıklığını azaltır ve bant genişliğini artırır. Görev arızaları tespit edilir ve otomatik olarak yeniden atanır; bu da sistemin dayanıklılığına katkı sağlar.
MapReduce’un faydaları ve sınırlamaları
MapReduce birkaç belirgin avantaj sunar:
- Büyük ölçekli toplu işler için mükemmel paralellik
- Binlerce düğüm arasında ölçeklenebilirlik
- Görev yeniden yürütme ve kontrol noktalarıyla güçlü hata toleransı
Ancak bazı ödünleri de vardır:
- Model gecikme açısından ağırdır; bu nedenle gerçek zamanlı işleme için daha az idealdir
- Özel MapReduce işleri yazmak zahmetli olabilir ve hata ayıklaması zordur
- Daha yeni araçların sunduğu etkileşim ve esnekliğin bir kısmı Apache Spark gibi araçlara kıyasla sınırlıdır.
Hadoop ile Spark arasında karar mı veriyorsunuz? Hangi Büyük Veri çerçevesinin size uygun olduğuna dair rehberimizi okuyun.
YARN: Yet Another Resource Negotiator
YARN, Hadoop’un kaynak yönetim katmanı olarak hizmet eder. İş zamanlamayı ve kaynak tahsisini işleme modelinden ayırarak, Hadoop’un MapReduce dışında birden fazla veri işleme motorunu desteklemesine yardımcı olur.
Hadoop mimarisindeki rolü
YARN, küme genelindeki hesaplama kaynaklarını yönetmek için merkezi bir platform görevi görür. Mevcut sistem kaynaklarını çeşitli uygulamalara tahsis eder ve yürütmeyi koordine eder. Bu sorumluluk ayrımı, Hadoop’un verimli biçimde ölçeklenmesine yardımcı olur ve Apache Spark, Hive ve Tez gibi diğer çerçevelerin desteklenmesinin önünü açar.
YARN’ın temel bileşenleri
YARN üç bileşen sunar:
- ResourceManager: Tüm kaynakları yöneten ve uygulamaları zamanlayan ana daemon (arka plan programı).
- NodeManager: Düğüm başına çalışan; kaynak kullanımını izleyip ResourceManager’a raporlayan ajan.
- ApplicationMaster: ResourceManager’dan kaynakları kullanan ve NodeManager’larla yürütmeyi koordine eden işe özgü işlem.
Her uygulamanın (örneğin bir MapReduce işinin) kendi ApplicationMaster’ı vardır; bu da daha iyi arıza yalıtımı ve iş takibi sağlar.
YARN kaynak yönetim süreci
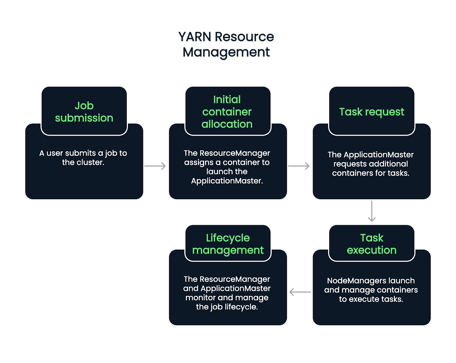
Akış, bir kullanıcı bir iş gönderdiğinde başlar. ResourceManager işi kabul eder ve ApplicationMaster’ı başlatmak için bir konteyner atar. Buradan, ApplicationMaster mevcut iş yükü ve uygunluğa göre görevleri yürütmek için daha fazla konteyner talep eder.
NodeManager’lar bu konteynerleri başlatır ve yönetir; konteynerler bireysel görevleri yürütür. İş yaşam döngüsü boyunca ResourceManager ve ApplicationMaster izleme, arızadan kurtarma ve tamamlama raporlamasını üstlenir. Yani yaklaşık beş adımlı bir süreçtir.
- İş gönderimi: Bir kullanıcı kümeye iş gönderir.
- İlk konteyner tahsisi: ResourceManager işi kabul eder ve ApplicationMaster’ı başlatmak için bir konteyner atar.
- Görev talebi: ApplicationMaster, iş yükü ve mevcut kaynaklara göre belirli görevleri yürütmek üzere ek konteynerler talep eder.
- Görev yürütme: NodeManager’lar bu konteynerleri başlatır ve yönetir; konteynerler görevleri yerine getirir.
- Yaşam döngüsü yönetimi: ResourceManager ve ApplicationMaster, iş ilerlemesini izlemek, arızaları ele almak ve görev tamamlanmasını doğrulamak için birlikte çalışır.İş yaşam döngüsü boyunca ResourceManager ve ApplicationMaster izleme, arızadan kurtarma ve tamamlama raporlamasını üstlenir.
Hadoop Common ve Yardımcı Araçlar
Hadoop’un tüm bileşenlerini bir araya getiren tutkal, Hadoop Common’dır. Tüm modüllerin ihtiyaç duyduğu kütüphaneler, yapılandırma dosyaları ve yardımcı araçlardan oluşan bir koleksiyondur.
Hadoop Common nedir
Hadoop Common, HDFS, YARN ve MapReduce’un iletişim kurup koordinasyon sağlamasına imkân veren temel kod ve araçları sunar. Buna Java kütüphaneleri, dosya sistemi istemcileri ve ekosistem genelinde kullanılan API’ler dahildir.
Ayrıca modüller arasında tutarlılık ve uyumluluk sağlar; geliştiricilerin paylaşılan bir ilkel seti üzerinde geliştirme yapmasına olanak tanır.
Yapılandırma ve araçların önemi
Hadoop’un doğru yapılandırılması kritik önemdedir. Hadoop Common, dosya sistemi URI’leri ve G/Ç ayarları gibi varsayılan davranışları tanımlayan core-site.xml gibi yapılandırma dosyalarını barındırır.
Hadoop Common’a dahil komut satırı araçları ve betikler; servisleri başlatma, düğüm sağlığını kontrol etme ve işleri yönetme gibi görevleri destekler. Sistem yöneticileri ve geliştiriciler, günlük küme işlemleri için çoğunlukla bu araçlara güvenir.
Hadoop’un Gerçek Dünya Uygulamaları
Eğer devasa veri kümeleri, dağıtık işleme veya toplu analitik kullanılıyorsa, Hadoop muhtemelen kullanılıyordur. Daha somut olarak, Hadoop; yapılandırılmış ve yapılandırılmamış devasa veri hacimlerini işlemek için çeşitli sektörlerde kullanılır. Dağıtık tasarımı ve açık kaynak esnekliği, onu veri yoğun görevler için çok yönlü kılar.
Hadoop’dan yararlanan sektörler
Finans, sağlık, telekomünikasyon, e-ticaret ve sosyal medya alanındaki kuruluşlar rutin olarak Hadoop kullanır. Bankaların gerçek zamanlı dolandırıcılık tespitine yardımcı olur, sağlıkta genomik araştırmaları destekler ve çevrim içi perakendede öneri motorlarını mümkün kılar.
Örnek kullanım durumları
- Günlük (log) işleme: Sunuculardan ve uygulamalardan gelen günlük verilerini toplama ve analiz etme.
- Öneri sistemleri: İçerik veya ürün öneren modeller oluşturma.
- Dolandırıcılık tespiti: İşlemler genelinde şüpheli davranış kalıplarını belirleme.
Bu senaryolar, Hadoop’un büyük veri kümelerini hata toleransı ve paralellik ile ele alma becerisinden faydalanır.
Hadoop’a çağdaş, bulut yerlisi bir alternatif için, Introduction to Databricks kursunu deneyin; Spark ve diğer ölçeklenebilir araçları destekler.
Diğer araçlarla entegrasyon
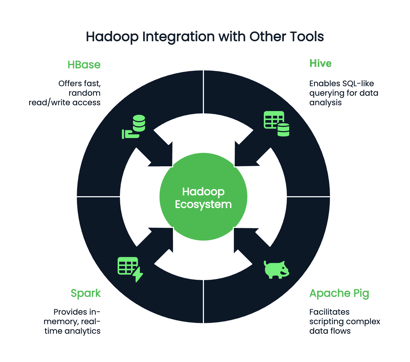
Hadoop nadiren tek başına çalışır ve yüzlerce yardımcı programla entegre olabilir. Tercihlerinize ve kodlama ortamınıza bağlı olarak Hadoop’u şu araçlarla eşleştirebilirsiniz:
- Hive: SQL benzeri sorgulama için
- Apache Pig: Karmaşık veri akışlarını betiklemek için
- Spark: Bellek içi, gerçek zamanlı analitik için
- HBase: Büyük veri kümelerine hızlı, rastgele okuma/yazma erişimi için
Sonuç
Hadoop eskisi kadar popüler bir moda sözcük olmasa da, büyük veri dünyasında temel bir teknoloji olmaya devam ediyor. Büyük ölçekli sistemlerle çalışan her veri profesyoneli için Hadoop’u anlamak hâlâ son derece değerlidir. Temel bileşenleri—depolama için HDFS, işleme için MapReduce, kaynak yönetimi için YARN ve temel yardımcı araçlar için Hadoop Common—veri iş akışlarının nasıl tasarlanıp ölçeklendirildiğini şekillendirmeyi sürdürüyor.
Kuruluma veya optimizasyona geçmeden önce, verinin bir Hadoop kümesi içinde nasıl dağıtıldığını ve yapılandırıldığını anlamaya zaman ayırın. Bu bilgi, sorun gidermeyi ve performans ayarını kolaylaştırır ve daha gelişmiş analitik için Apache Spark ve Hive gibi güçlü araçların entegrasyonunun yolunu açar.
Büyük veri işleme hakkında daha fazlası için şunlara göz atın:





Apache Hadoop, çoğunlukla yalnızca Hadoop olarak anılan, uygun maliyetli, standart donanım kümelerine dağıtarak çok büyük veri kümelerini işlemek ve depolamak üzere oluşturulmuş güçlü bir açık kaynak çerçevedir. Gücünü ölçeklenebilirlik ve esneklikten alır; hem yapılandırılmış hem de yapılandırılmamış verilerle çalışabilir.
Bu yazıda, Hadoop’u oluşturan temel bileşenleri—veriyi nasıl depoladığı, işlediği ve büyük ölçekte yönettiğini—adım adım ele alacağım. Sonunda, bu temel teknolojinin büyük veri ekosistemlerine nasıl oturduğuna dair net bir resme sahip olacaksınız.
Hadoop Ekosistemine Genel Bakış
Hadoop tek bir araç değildir. Veri depolamayı, işlemeyi ve kaynak koordinasyonunu birlikte yöneten birden fazla modülden oluşan bir ekosistemdir.
Hadoop’un çekirdek modülleri
Hadoop dört temel modülden oluşur:
Bu modüller, petabaytlarca veriyi kaldırabilen bir dağıtık hesaplama ortamı oluşturmak için birlikte çalışır.
Dağıtık veri işlemenin platformlar arasında nasıl karşılaştırıldığına göz atmak için, Big Data Fundamentals with PySpark kursu, Hadoop bilginizi tamamlayan uygulamalı bir giriş sunar.
Büyük veride Hadoop’un rolü
Hadoop’un birincil rolü, büyük veri işlemede temel bir sorunu, yani ölçeklenebilirliği, ele alma yeteneğinde yatar.
Geleneksel sistemler, tek bir makinenin depolama ve işlem kapasitesini aşan veri kümeleriyle sıklıkla zorlanır. Hadoop bunu, veriyi çok sayıda düğüme dağıtarak ve hesaplamaları paralel olarak yürüterek çözer.
Böylece Hadoop terabaytlarca hatta petabaytlarca veriyi verimli biçimde işleyebilir. Ölçeklenebilirliğinin ötesinde, Hadoop veri çoğaltma yoluyla derin bir hata toleransına sahiptir ve kuruluşların standart donanım kullanarak uygun maliyetli veri altyapıları kurmasına olanak tanır.
Hadoop’un temel özellikleri
Hadoop’un rolünü ve yapısını ele aldık; şimdi de en değerli özelliklerinden bazılarına bakalım. Bunlar şunları içerir:
Bu özellikler, Hadoop’u toplu veri işleme, günlük analizi ve ETL boru hatları için uygun hale getirir. Hadoop, dağıtık hesaplama alanında klasik bir vaka incelemesidir; burada verimliliği ve ölçeği artırmak için hesaplama birden fazla düğümde gerçekleşir.
Şimdi, Hadoop’un her bir çekirdek modülüne ayrıntılı olarak bakalım.
Hadoop bilginizi doğrulamak veya bir veri rolüne hazırlık yapmak mı istiyorsunuz? Başlamak için 2025 için 24 Hadoop mülakat sorusu ve yanıtı burada.
Hadoop Dağıtık Dosya Sistemi (HDFS)
Dört ana bileşen arasında, HDFS Hadoop’un birincil depolama sistemidir. Önceki bölümlerde tartıştığımız gibi, çok büyük miktardaki veriyi güvenilir biçimde bir makine kümesi genelinde depolamak üzere tasarlanmıştır. Mimarisi bu tür büyük veri kümelerine erişim için kurgulanmıştır ve hata toleransı, ölçeklenebilirlik ve veri yerelliği için optimize edilmiştir.
Mimari ve bileşenler
HDFS mimarisi bir ana-köle modeli etrafında şekillenir. En üstte, dosya sisteminin dizin ağacını ve her dosyanın konumuna ilişkin bilgileri yani metaveriyi yöneten NameNode bulunur. Gerçek veriyi depolamaz.
DataNode’lar işin yükünü çeker. Düğümlere bağlı depolamayı yönetir ve istemcilerden gelen okuma/yazma isteklerine hizmet ederler. Her DataNode, tutarlı durum takibini sağlamak için düzenli olarak NameNode’a kalp atışı ve blok raporları gönderir.
Son olarak, HDFS bir İkincil NameNode içerir; bu, bir yedek devralma düğümüyle karıştırılmamalıdır. Bunun yerine, NameNode’un metaverisini periyodik olarak kontrol noktalarına alır; bu da başlatma süresini ve bellek yükünü azaltır.
HDFS mimarisi. Görsel kaynağı: Apache Hadoop dokümantasyonu
Veri HDFS’te nasıl depolanır
Bir dosya HDFS’ye yazıldığında sabit boyutlu 64MB bloklara bölünür. Her blok daha sonra farklı DataNode’lara dağıtılır. Bu dağıtım stratejisi veri erişimi sırasında paralelliği destekler ve hata toleransını artırır.
HDFS’te veri yalnızca bir kez depolanmaz. Her blok çoğaltılır (varsayılan üç kopyadır) ve küme genelinde yayılır. Okuma işlemi sırasında, sistem bant genişliğini en üst düzeye çıkarmak ve gecikmeyi en aza indirmek için veriyi en yakın uygun replikadan çeker. Yazmalar önce bir replikaya gider, ardından diğerlerine yayılır; bu da anlık darboğaz oluşturmadan dayanıklılığı sağlar.
Bu blok düzeyi tasarım, HDFS’in yatay olarak ölçeklenmesine de olanak tanır. Küme içine yeni düğümler eklenebilir ve sistem ek kapasiteden yararlanmak için veriyi yeniden dengeler.
Diğer büyük veri formatlarıyla karşılaştırma için, Apache Parquet’in analitik iş yükleri için sütunlu depolamayı nasıl optimize ettiğini keşfedin.
HDFS’te hata toleransı
HDFS, arızayı göz önünde bulundurarak inşa edilmiştir. Büyük dağıtık sistemlerde düğüm arızaları istisna değil, beklenen durumlardır. HDFS, çoğaltma mekanizmasıyla veri erişilebilirliğini güvence altına alır. Bir DataNode devre dışı kalırsa, NameNode kaçırılan kalp atışlarından arızayı tespit eder ve kaybolan blokların sağlıklı düğümlere çoğaltılmasını planlar.
Ayrıca sistem, blok sağlığını sürekli izler ve gerektiğinde çoğaltma başlatır. Yedekli depolama stratejisi, proaktif izleme ile birleşerek tek bir arıza noktasının veri bütünlüğünü veya erişimini tehlikeye atmasını engeller.
MapReduce Çerçevesi
Sırada Hadoop’un işleme motoru MapReduce var. Görevleri daha küçük, bağımsız ve paralel yürütülebilen işlemlere bölerek büyük veri kümeleri üzerinde dağıtık hesaplama yapmayı sağlar.
Model, karmaşık veri dönüşümlerini basitleştirir ve özellikle dağıtık bir ortamda toplu işlemeye uygundur.
MapReduce’a genel bakış
MapReduce, Map ve Reduce olmak üzere iki aşamalı bir programlama modelini izler.
Map aşamasında giriş veri kümesi daha küçük parçalara bölünür ve her parça anahtar-değer çiftleri üretmek üzere işlenir. Bu ara sonuçlar, Reduce aşamasına aktarılmadan önce karıştırılır ve sıralanır; Reduce aşamasında birleştirilir veya nihai çıktılara dönüştürülür.
Bu model, kelime sıklığı sayımı, günlüklerin filtrelenmesi veya büyük ölçekte veri kümelerinin birleştirilmesi gibi görevler için oldukça etkilidir.
Geliştiriciler, çerçevenin küme genelinde düzenlediği
map()vereduce()fonksiyonları aracılığıyla özel mantık uygular.Bir MapReduce işinin yürütme akışı
Bir MapReduce işi gönderildiğinde, giriş verisi önce bloklara bölünür. Bir JobTracker (veya YARN etkin sürümlerde ResourceManager) daha sonra bu blokların mevcut TaskTracker’lar veya NodeManager’lar arasında dağıtımını koordine eder.
Map görevleri düğümler genelinde paralel olarak yürütülür; giriş bölümlerini okuyup ara anahtar-değer çiftleri üretir. Bu çiftler otomatik olarak karıştırılır ve sıralanır. Bu aşama tamamlandığında Reduce görevleri başlar; gruplanmış veriyi alır ve nihai çıktıyı üretmek için birleştirme mantığını uygular.
Süreç, görevleri verinin bulunduğu yere yakın atayarak veri yerelliğini garanti eder; bu da ağ tıkanıklığını azaltır ve bant genişliğini artırır. Görev arızaları tespit edilir ve otomatik olarak yeniden atanır; bu da sistemin dayanıklılığına katkı sağlar.
MapReduce’un faydaları ve sınırlamaları
MapReduce birkaç belirgin avantaj sunar:
Ancak bazı ödünleri de vardır:
Hadoop ile Spark arasında karar mı veriyorsunuz? Hangi Büyük Veri çerçevesinin size uygun olduğuna dair rehberimizi okuyun.
YARN: Yet Another Resource Negotiator
YARN, Hadoop’un kaynak yönetim katmanı olarak hizmet eder. İş zamanlamayı ve kaynak tahsisini işleme modelinden ayırarak, Hadoop’un MapReduce dışında birden fazla veri işleme motorunu desteklemesine yardımcı olur.
Hadoop mimarisindeki rolü
YARN, küme genelindeki hesaplama kaynaklarını yönetmek için merkezi bir platform görevi görür. Mevcut sistem kaynaklarını çeşitli uygulamalara tahsis eder ve yürütmeyi koordine eder. Bu sorumluluk ayrımı, Hadoop’un verimli biçimde ölçeklenmesine yardımcı olur ve Apache Spark, Hive ve Tez gibi diğer çerçevelerin desteklenmesinin önünü açar.
YARN’ın temel bileşenleri
YARN üç bileşen sunar:
Her uygulamanın (örneğin bir MapReduce işinin) kendi ApplicationMaster’ı vardır; bu da daha iyi arıza yalıtımı ve iş takibi sağlar.
YARN kaynak yönetim süreci
Akış, bir kullanıcı bir iş gönderdiğinde başlar. ResourceManager işi kabul eder ve ApplicationMaster’ı başlatmak için bir konteyner atar. Buradan, ApplicationMaster mevcut iş yükü ve uygunluğa göre görevleri yürütmek için daha fazla konteyner talep eder.
NodeManager’lar bu konteynerleri başlatır ve yönetir; konteynerler bireysel görevleri yürütür. İş yaşam döngüsü boyunca ResourceManager ve ApplicationMaster izleme, arızadan kurtarma ve tamamlama raporlamasını üstlenir. Yani yaklaşık beş adımlı bir süreçtir.
Hadoop Common ve Yardımcı Araçlar
Hadoop’un tüm bileşenlerini bir araya getiren tutkal, Hadoop Common’dır. Tüm modüllerin ihtiyaç duyduğu kütüphaneler, yapılandırma dosyaları ve yardımcı araçlardan oluşan bir koleksiyondur.
Hadoop Common nedir
Hadoop Common, HDFS, YARN ve MapReduce’un iletişim kurup koordinasyon sağlamasına imkân veren temel kod ve araçları sunar. Buna Java kütüphaneleri, dosya sistemi istemcileri ve ekosistem genelinde kullanılan API’ler dahildir.
Ayrıca modüller arasında tutarlılık ve uyumluluk sağlar; geliştiricilerin paylaşılan bir ilkel seti üzerinde geliştirme yapmasına olanak tanır.
Yapılandırma ve araçların önemi
Hadoop’un doğru yapılandırılması kritik önemdedir. Hadoop Common, dosya sistemi URI’leri ve G/Ç ayarları gibi varsayılan davranışları tanımlayan
core-site.xmlgibi yapılandırma dosyalarını barındırır.Hadoop Common’a dahil komut satırı araçları ve betikler; servisleri başlatma, düğüm sağlığını kontrol etme ve işleri yönetme gibi görevleri destekler. Sistem yöneticileri ve geliştiriciler, günlük küme işlemleri için çoğunlukla bu araçlara güvenir.
Hadoop’un Gerçek Dünya Uygulamaları
Eğer devasa veri kümeleri, dağıtık işleme veya toplu analitik kullanılıyorsa, Hadoop muhtemelen kullanılıyordur. Daha somut olarak, Hadoop; yapılandırılmış ve yapılandırılmamış devasa veri hacimlerini işlemek için çeşitli sektörlerde kullanılır. Dağıtık tasarımı ve açık kaynak esnekliği, onu veri yoğun görevler için çok yönlü kılar.
Hadoop’dan yararlanan sektörler
Finans, sağlık, telekomünikasyon, e-ticaret ve sosyal medya alanındaki kuruluşlar rutin olarak Hadoop kullanır. Bankaların gerçek zamanlı dolandırıcılık tespitine yardımcı olur, sağlıkta genomik araştırmaları destekler ve çevrim içi perakendede öneri motorlarını mümkün kılar.
Örnek kullanım durumları
Bu senaryolar, Hadoop’un büyük veri kümelerini hata toleransı ve paralellik ile ele alma becerisinden faydalanır.
Hadoop’a çağdaş, bulut yerlisi bir alternatif için, Introduction to Databricks kursunu deneyin; Spark ve diğer ölçeklenebilir araçları destekler.
Diğer araçlarla entegrasyon
Hadoop nadiren tek başına çalışır ve yüzlerce yardımcı programla entegre olabilir. Tercihlerinize ve kodlama ortamınıza bağlı olarak Hadoop’u şu araçlarla eşleştirebilirsiniz:
Sonuç
Hadoop eskisi kadar popüler bir moda sözcük olmasa da, büyük veri dünyasında temel bir teknoloji olmaya devam ediyor. Büyük ölçekli sistemlerle çalışan her veri profesyoneli için Hadoop’u anlamak hâlâ son derece değerlidir. Temel bileşenleri—depolama için HDFS, işleme için MapReduce, kaynak yönetimi için YARN ve temel yardımcı araçlar için Hadoop Common—veri iş akışlarının nasıl tasarlanıp ölçeklendirildiğini şekillendirmeyi sürdürüyor.
Kuruluma veya optimizasyona geçmeden önce, verinin bir Hadoop kümesi içinde nasıl dağıtıldığını ve yapılandırıldığını anlamaya zaman ayırın. Bu bilgi, sorun gidermeyi ve performans ayarını kolaylaştırır ve daha gelişmiş analitik için Apache Spark ve Hive gibi güçlü araçların entegrasyonunun yolunu açar.
Büyük veri işleme hakkında daha fazlası için şunlara göz atın: