Apache Hadoop, yang sering disebut Hadoop saja, adalah kerangka kerja open-source yang kuat untuk memproses dan menyimpan kumpulan data berukuran masif dengan mendistribusikannya ke klaster perangkat keras komoditas yang terjangkau. Kekuatan utamanya terletak pada skalabilitas dan fleksibilitas, memungkinkannya bekerja dengan data terstruktur maupun tidak terstruktur.
Dalam tulisan ini, saya akan membahas komponen kunci yang membentuk Hadoop—bagaimana ia menyimpan, memproses, dan mengelola data dalam skala besar. Di akhir, Anda akan mendapatkan gambaran jelas tentang bagaimana teknologi fondasional ini menyatu dalam ekosistem big data.
Gambaran Umum Ekosistem Hadoop
Hadoop bukanlah satu alat tunggal. Ini adalah ekosistem yang mencakup berbagai modul yang bekerja bersama untuk mengelola penyimpanan data, pemrosesan, dan koordinasi sumber daya.
Modul inti Hadoop
Hadoop terdiri dari empat modul fondasional:
- HDFS (Hadoop Distributed File System): Sistem penyimpanan terdistribusi yang membagi file menjadi blok-blok dan mendistribusikannya ke seluruh klaster.
- MapReduce: Model pemrograman untuk memproses data secara paralel di berbagai node.
- YARN (Yet Another Resource Negotiator): Mengelola sumber daya dan menjadwalkan pekerjaan di klaster.
- Hadoop Common: Kumpulan pustaka dan utilitas bersama yang mendukung modul lain.
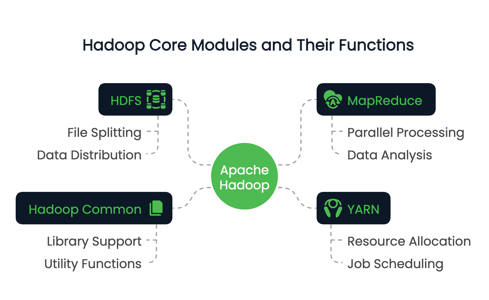
Modul-modul ini bekerja bersama untuk menciptakan lingkungan komputasi terdistribusi yang mampu menangani data dalam skala petabyte.
Untuk menjelajahi bagaimana pemrosesan data terdistribusi dibandingkan di berbagai platform, kursus Big Data Fundamentals with PySpark memberikan pengantar praktis yang melengkapi pemahaman Anda tentang Hadoop.
Peran Hadoop dalam big data
Peran utama Hadoop terletak pada kemampuannya mengatasi tantangan inti dalam big data pemrosesan, yaitu skalabilitas.
Sistem tradisional sering kesulitan dengan kumpulan data yang melebihi kapasitas satu mesin, baik dari sisi penyimpanan maupun komputasi. Hadoop menyelesaikan ini dengan mendistribusikan data ke banyak node dan mengeksekusi komputasi secara paralel.
Dengan demikian, Hadoop dapat memproses terabyte bahkan petabyte data secara efisien. Selain skalabilitasnya, Hadoop juga memiliki toleransi kesalahan yang tinggi melalui replikasi data dan memungkinkan organisasi membangun infrastruktur data yang hemat biaya menggunakan perangkat keras komoditas.
Fitur utama Hadoop
Kita telah membahas peran dan struktur Hadoop, sekarang mari lihat beberapa atribut paling berharga dari Hadoop. Ini mencakup:
- Penyimpanan dan pemrosesan terdistribusi yang memungkinkannya menyimpan kumpulan data yang sangat besar dan menjalankan kueri atasnya.
- Skalabilitas horizontal tanpa memerlukan mesin kelas atas.
- Optimisasi lokalitas data, memindahkan komputasi ke lokasi tempat data berada.
- Ketahanan terhadap kegagalan melalui replikasi dan eksekusi ulang tugas.
Fitur-fitur ini membuat Hadoop sangat cocok untuk pemrosesan data batch, analisis log, dan pipeline ETL. Hadoop adalah studi kasus klasik dalam komputasi terdistribusi, di mana komputasi terjadi di banyak node untuk meningkatkan efisiensi dan skala.
Sekarang, mari kita lihat masing-masing modul inti Hadoop secara rinci.
Ingin memvalidasi pengetahuan Hadoop Anda atau bersiap untuk peran data? Berikut 24 pertanyaan dan jawaban wawancara Hadoop untuk 2025 sebagai permulaan.
Hadoop Distributed File System (HDFS)
Dari empat komponen utama, HDFS adalah sistem penyimpanan utama Hadoop. Sistem ini dirancang untuk menyimpan sejumlah besar data secara andal di seluruh klaster mesin seperti yang dibahas sebelumnya. Arsitekturnya disusun untuk akses ke kumpulan data besar dan dioptimalkan untuk toleransi kesalahan, skalabilitas, dan lokalitas data.
Arsitektur dan komponen
Arsitektur HDFS berpusat pada model master-slave. Di puncak terdapat NameNode, yang mengelola metadata—pada dasarnya pohon direktori sistem file dan informasi tentang lokasi setiap file. NameNode tidak menyimpan data sebenarnya.
DataNode adalah tulang punggungnya. Mereka mengelola penyimpanan yang terpasang pada node dan melayani permintaan baca/tulis dari klien. Setiap DataNode secara berkala melapor kembali ke NameNode dengan heartbeat dan laporan blok untuk memastikan pelacakan status yang konsisten.
Terakhir, HDFS menyertakan Secondary NameNode, yang tidak sama dengan node failover. Sebaliknya, ia secara berkala melakukan checkpoint metadata NameNode untuk mengurangi waktu startup dan beban memori.
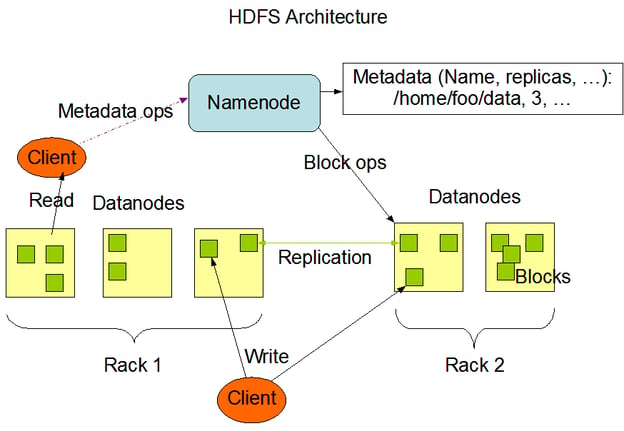
Arsitektur HDFS. Sumber gambar: Dokumentasi Apache Hadoop
Bagaimana data disimpan di HDFS
Saat sebuah file ditulis ke HDFS, file tersebut dipecah menjadi blok 64MB berukuran tetap. Setiap blok kemudian didistribusikan ke berbagai DataNode. Strategi distribusi ini mendukung paralelisme selama akses data dan meningkatkan toleransi kesalahan.
Data di HDFS tidak hanya disimpan satu kali. Setiap blok direplikasi (bawaan tiga salinan) dan disebarkan ke seluruh klaster. Selama operasi baca, sistem mengambil data dari replika terdekat yang tersedia untuk memaksimalkan throughput dan meminimalkan latensi. Penulisan dilakukan ke satu replika terlebih dahulu lalu dipropagasikan ke replika lain, memastikan daya tahan tanpa hambatan langsung.
Desain pada level blok ini juga memungkinkan HDFS berskala secara horizontal. Node baru dapat ditambahkan ke klaster, dan sistem akan menyeimbangkan ulang data untuk memanfaatkan kapasitas tambahan.
Untuk perbandingan dengan format big data lainnya, jelajahi bagaimana Apache Parquet mengoptimalkan penyimpanan kolumnar untuk beban kerja analitik.
Toleransi kesalahan di HDFS
HDFS dibangun dengan mempertimbangkan kegagalan. Dalam sistem terdistribusi besar, kegagalan node adalah hal yang diharapkan, bukan pengecualian. HDFS memastikan ketersediaan data melalui mekanisme replikasi. Jika sebuah DataNode mati, NameNode mendeteksi kegagalan melalui heartbeat yang terlewat dan menjadwalkan replikasi blok yang hilang ke node yang sehat.
Selain itu, sistem terus memantau kesehatan blok dan memulai replikasi sesuai kebutuhan. Strategi penyimpanan redundan, dikombinasikan dengan pemantauan proaktif, memastikan tidak ada satu titik kegagalan pun yang dapat mengompromikan integritas atau akses data.
Kerangka Kerja MapReduce
Berikutnya adalah mesin pemrosesan Hadoop, MapReduce. Ini memungkinkan komputasi terdistribusi atas kumpulan data besar dengan memecah tugas menjadi operasi yang lebih kecil dan independen yang dapat dieksekusi secara paralel.
Model ini menyederhanakan transformasi data yang kompleks dan sangat cocok untuk pemrosesan batch dalam lingkungan terdistribusi.
Gambaran umum MapReduce
MapReduce mengikuti model pemrograman dua fase: fase Map dan Reduce.
Selama fase Map, kumpulan data masukan dibagi menjadi potongan-potongan kecil, dan setiap potongan diproses untuk menghasilkan pasangan kunci-nilai. Hasil antara ini kemudian di-shuffle dan diurutkan sebelum diteruskan ke fase Reduce, di mana hasil tersebut diagregasi atau diubah menjadi keluaran final.
Model ini sangat efektif untuk tugas seperti menghitung frekuensi kata, memfilter log, atau melakukan join kumpulan data dalam skala besar.
Pengembang mengimplementasikan logika kustom melalui fungsi map() dan reduce(), yang diorkestrasi kerangka kerja di seluruh klaster.
Alur eksekusi sebuah job MapReduce
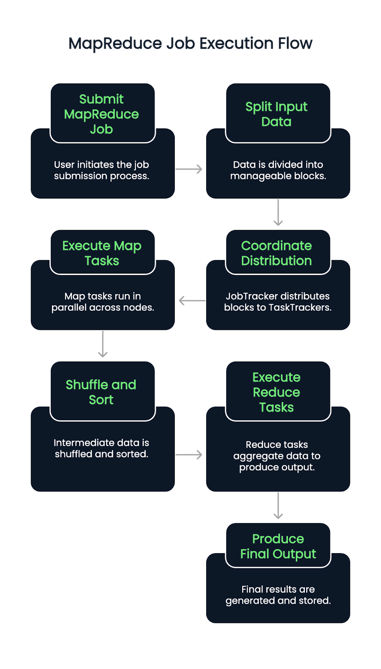
Saat sebuah job MapReduce dikirimkan, data masukan terlebih dahulu dipecah menjadi blok-blok. JobTracker (atau ResourceManager pada versi yang mendukung YARN) kemudian mengoordinasikan distribusi blok-blok ini ke TaskTracker atau NodeManager yang tersedia.
Tugas Map dieksekusi secara paralel di berbagai node, membaca input split dan menghasilkan pasangan kunci-nilai antara. Pasangan ini kemudian di-shuffle dan diurutkan secara otomatis. Setelah fase ini selesai, tugas Reduce dimulai, mengambil data yang telah dikelompokkan dan menerapkan logika agregasi untuk menghasilkan keluaran akhir.
Proses ini menjamin lokalitas data dengan menugaskan pekerjaan sedekat mungkin dengan lokasi data berada, meminimalkan kemacetan jaringan dan meningkatkan throughput. Kegagalan tugas dideteksi dan ditugaskan ulang secara otomatis, yang berkontribusi pada ketahanan sistem.
Keuntungan dan keterbatasan MapReduce
MapReduce menawarkan beberapa keunggulan jelas:
- Paralelisme yang sangat baik untuk pemrosesan batch skala besar
- Skalabilitas hingga ribuan node
- Toleransi kesalahan yang kuat melalui eksekusi ulang tugas dan checkpointing
Namun, ada juga kompromi:
- Model ini berlatensi tinggi, sehingga kurang ideal untuk pemrosesan real-time
- Menulis job MapReduce kustom bisa sangat berat dan sulit untuk di-debug
- Kekurangan interaktivitas dan fleksibilitas dibanding alat yang lebih baru seperti Apache Spark.
Bingung memilih antara Hadoop dan Spark? Baca panduan kami tentang kerangka kerja Big Data yang tepat untuk Anda.
YARN: Yet Another Resource Negotiator
YARN berfungsi sebagai lapisan manajemen sumber daya Hadoop. YARN memisahkan penjadwalan pekerjaan dan alokasi sumber daya dari model pemrosesan, membantu Hadoop mendukung banyak mesin pemrosesan data di luar MapReduce.
Peran dalam arsitektur Hadoop
YARN bertindak sebagai platform pusat untuk mengelola sumber daya komputasi di seluruh klaster. YARN mengalokasikan sumber daya sistem yang tersedia ke beberapa aplikasi dan mengoordinasikan eksekusi. Pemisahan tanggung jawab ini membantu Hadoop berskala secara efisien dan membuka dukungan untuk kerangka kerja lain seperti Apache Spark, Hive, dan Tez.
Komponen kunci YARN
YARN memperkenalkan tiga komponen:
- ResourceManager: Daemon master (program latar) yang mengelola semua sumber daya dan menjadwalkan aplikasi.
- NodeManager: Agen per-node yang memantau penggunaan sumber daya dan melapor kembali ke ResourceManager.
- ApplicationMaster: Operasi spesifik job yang menggunakan sumber daya dari ResourceManager dan mengoordinasikan eksekusi dengan NodeManager.
Setiap aplikasi (seperti job MapReduce) memiliki ApplicationMaster sendiri, yang memungkinkan isolasi kesalahan dan pelacakan job yang lebih baik.
Proses manajemen sumber daya YARN
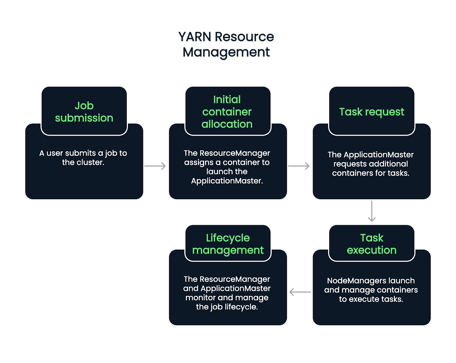
Alur dimulai saat pengguna mengirimkan sebuah job. ResourceManager menerima job tersebut dan menetapkan sebuah container untuk memulai ApplicationMaster. Dari sana, ApplicationMaster meminta lebih banyak container untuk mengeksekusi tugas, berdasarkan beban kerja saat ini dan ketersediaan.
NodeManager meluncurkan dan mengelola container-container ini, yang menjalankan tugas individual. Sepanjang siklus hidup job, ResourceManager dan ApplicationMaster menangani pemantauan, pemulihan kegagalan, dan pelaporan penyelesaian. Jadi, ini adalah proses sekitar lima langkah.
- Pengiriman job: Pengguna mengirimkan job ke klaster.
- Alokasi container awal: ResourceManager menerima job dan menetapkan sebuah container untuk meluncurkan ApplicationMaster.
- Permintaan tugas: ApplicationMaster meminta container tambahan untuk menjalankan tugas tertentu, berdasarkan beban kerja dan sumber daya yang tersedia.
- Eksekusi tugas: NodeManager meluncurkan dan mengelola container-container ini, yang menjalankan tugas.
- Manajemen siklus hidup: ResourceManager dan ApplicationMaster bekerja sama untuk memantau kemajuan job, menangani kegagalan, dan mengonfirmasi penyelesaian tugas. Sepanjang siklus hidup job, ResourceManager dan ApplicationMaster menangani pemantauan, pemulihan kegagalan, dan pelaporan penyelesaian.
Hadoop Common dan Utilitas
Perekat yang menyatukan semua komponen Hadoop adalah Hadoop Common. Ini adalah kumpulan pustaka, file konfigurasi, dan utilitas yang dibutuhkan oleh semua modul.
Apa itu Hadoop Common
Hadoop Common menyediakan kode dan alat fondasional yang memungkinkan HDFS, YARN, dan MapReduce untuk berkomunikasi dan berkoordinasi. Ini mencakup pustaka Java, klien sistem file, dan API yang digunakan di seluruh ekosistem.
Hadoop Common juga memastikan konsistensi dan kompatibilitas antar modul, memungkinkan pengembang membangun di atas serangkaian primitif bersama.
Pentingnya konfigurasi dan alat
Konfigurasi Hadoop yang tepat sangat krusial. Hadoop Common menyimpan file konfigurasi seperti core-site.xml, yang mendefinisikan perilaku bawaan seperti URI sistem file dan pengaturan I/O.
Alat dan skrip command-line yang disertakan dalam Hadoop Common mendukung tugas seperti memulai layanan, memeriksa kesehatan node, dan mengelola job. Sebagian besar alat ini menjadi andalan administrator sistem dan pengembang untuk operasi klaster sehari-hari.
Aplikasi Dunia Nyata dari Hadoop
Jika melibatkan kumpulan data masif, pemrosesan terdistribusi, atau analitik batch, kemungkinan Hadoop digunakan. Lebih spesifiknya, Hadoop digunakan di berbagai industri untuk memproses volume data terstruktur dan tidak terstruktur yang sangat besar. Desain terdistribusi dan fleksibilitas open-source membuatnya serbaguna untuk tugas-tugas intensif data.
Industri yang memanfaatkan Hadoop
Organisasi di bidang keuangan, kesehatan, telekomunikasi, e-niaga, dan media sosial secara rutin menggunakan Hadoop. Hadoop membantu bank mendeteksi penipuan secara real-time, mendukung penelitian genomik di bidang kesehatan, dan memungkinkan mesin rekomendasi di ritel online.
Contoh kasus penggunaan
- Pemrosesan log: Mengagregasi dan menganalisis data log dari server dan aplikasi.
- Sistem rekomendasi: Membangun model yang menyarankan konten atau produk.
- Deteksi penipuan: Mengidentifikasi pola perilaku mencurigakan di berbagai transaksi.
Skenario-skenario ini mendapat manfaat dari kemampuan Hadoop menangani kumpulan data besar dengan toleransi kesalahan dan paralelisme.
Untuk alternatif modern berbasis cloud dari Hadoop, coba kursus Introduction to Databricks, yang mendukung Spark dan alat berskala lainnya.
Integrasi dengan alat lain
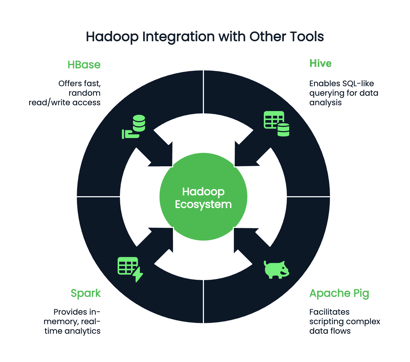
Hadoop jarang bekerja secara terisolasi dan dapat diintegrasikan dengan ratusan program aksesori. Bergantung pada preferensi dan lingkungan pengodean Anda, Anda dapat memasangkan Hadoop dengan:
- Hive: Untuk kueri mirip SQL
- Apache Pig: Untuk pemrograman alur data yang kompleks
- Spark: Untuk analitik real-time di memori
- HBase: Untuk akses baca/tulis acak yang cepat terhadap kumpulan data besar
Kesimpulan
Meski Hadoop mungkin tidak lagi menjadi kata kunci sepopuler dulu, ia tetap merupakan teknologi fondasional dalam lanskap big data. Memahami Hadoop masih sangat berharga bagi profesional data yang bekerja dengan sistem berskala besar. Komponen intinya—HDFS untuk penyimpanan, MapReduce untuk pemrosesan, YARN untuk manajemen sumber daya, dan Hadoop Common untuk utilitas esensial—terus membentuk cara alur kerja data dirancang dan diskalakan.
Sebelum masuk ke penerapan atau pengoptimalan, luangkan waktu untuk memahami bagaimana data didistribusikan dan dikonfigurasi dalam klaster Hadoop. Pengetahuan itu menyederhanakan pemecahan masalah dan penyetelan kinerja serta membuka jalan untuk mengintegrasikan alat tangguh seperti Apache Spark dan Hive untuk analitik yang lebih canggih.
Untuk informasi lebih lanjut tentang pemrosesan big data, lihat:




Apache Hadoop, yang sering disebut Hadoop saja, adalah kerangka kerja open-source yang kuat untuk memproses dan menyimpan kumpulan data berukuran masif dengan mendistribusikannya ke klaster perangkat keras komoditas yang terjangkau. Kekuatan utamanya terletak pada skalabilitas dan fleksibilitas, memungkinkannya bekerja dengan data terstruktur maupun tidak terstruktur.
Dalam tulisan ini, saya akan membahas komponen kunci yang membentuk Hadoop—bagaimana ia menyimpan, memproses, dan mengelola data dalam skala besar. Di akhir, Anda akan mendapatkan gambaran jelas tentang bagaimana teknologi fondasional ini menyatu dalam ekosistem big data.
Gambaran Umum Ekosistem Hadoop
Hadoop bukanlah satu alat tunggal. Ini adalah ekosistem yang mencakup berbagai modul yang bekerja bersama untuk mengelola penyimpanan data, pemrosesan, dan koordinasi sumber daya.
Modul inti Hadoop
Hadoop terdiri dari empat modul fondasional:
Modul-modul ini bekerja bersama untuk menciptakan lingkungan komputasi terdistribusi yang mampu menangani data dalam skala petabyte.
Untuk menjelajahi bagaimana pemrosesan data terdistribusi dibandingkan di berbagai platform, kursus Big Data Fundamentals with PySpark memberikan pengantar praktis yang melengkapi pemahaman Anda tentang Hadoop.
Peran Hadoop dalam big data
Peran utama Hadoop terletak pada kemampuannya mengatasi tantangan inti dalam big data pemrosesan, yaitu skalabilitas.
Sistem tradisional sering kesulitan dengan kumpulan data yang melebihi kapasitas satu mesin, baik dari sisi penyimpanan maupun komputasi. Hadoop menyelesaikan ini dengan mendistribusikan data ke banyak node dan mengeksekusi komputasi secara paralel.
Dengan demikian, Hadoop dapat memproses terabyte bahkan petabyte data secara efisien. Selain skalabilitasnya, Hadoop juga memiliki toleransi kesalahan yang tinggi melalui replikasi data dan memungkinkan organisasi membangun infrastruktur data yang hemat biaya menggunakan perangkat keras komoditas.
Fitur utama Hadoop
Kita telah membahas peran dan struktur Hadoop, sekarang mari lihat beberapa atribut paling berharga dari Hadoop. Ini mencakup:
Fitur-fitur ini membuat Hadoop sangat cocok untuk pemrosesan data batch, analisis log, dan pipeline ETL. Hadoop adalah studi kasus klasik dalam komputasi terdistribusi, di mana komputasi terjadi di banyak node untuk meningkatkan efisiensi dan skala.
Sekarang, mari kita lihat masing-masing modul inti Hadoop secara rinci.
Ingin memvalidasi pengetahuan Hadoop Anda atau bersiap untuk peran data? Berikut 24 pertanyaan dan jawaban wawancara Hadoop untuk 2025 sebagai permulaan.
Hadoop Distributed File System (HDFS)
Dari empat komponen utama, HDFS adalah sistem penyimpanan utama Hadoop. Sistem ini dirancang untuk menyimpan sejumlah besar data secara andal di seluruh klaster mesin seperti yang dibahas sebelumnya. Arsitekturnya disusun untuk akses ke kumpulan data besar dan dioptimalkan untuk toleransi kesalahan, skalabilitas, dan lokalitas data.
Arsitektur dan komponen
Arsitektur HDFS berpusat pada model master-slave. Di puncak terdapat NameNode, yang mengelola metadata—pada dasarnya pohon direktori sistem file dan informasi tentang lokasi setiap file. NameNode tidak menyimpan data sebenarnya.
DataNode adalah tulang punggungnya. Mereka mengelola penyimpanan yang terpasang pada node dan melayani permintaan baca/tulis dari klien. Setiap DataNode secara berkala melapor kembali ke NameNode dengan heartbeat dan laporan blok untuk memastikan pelacakan status yang konsisten.
Terakhir, HDFS menyertakan Secondary NameNode, yang tidak sama dengan node failover. Sebaliknya, ia secara berkala melakukan checkpoint metadata NameNode untuk mengurangi waktu startup dan beban memori.
Arsitektur HDFS. Sumber gambar: Dokumentasi Apache Hadoop
Bagaimana data disimpan di HDFS
Saat sebuah file ditulis ke HDFS, file tersebut dipecah menjadi blok 64MB berukuran tetap. Setiap blok kemudian didistribusikan ke berbagai DataNode. Strategi distribusi ini mendukung paralelisme selama akses data dan meningkatkan toleransi kesalahan.
Data di HDFS tidak hanya disimpan satu kali. Setiap blok direplikasi (bawaan tiga salinan) dan disebarkan ke seluruh klaster. Selama operasi baca, sistem mengambil data dari replika terdekat yang tersedia untuk memaksimalkan throughput dan meminimalkan latensi. Penulisan dilakukan ke satu replika terlebih dahulu lalu dipropagasikan ke replika lain, memastikan daya tahan tanpa hambatan langsung.
Desain pada level blok ini juga memungkinkan HDFS berskala secara horizontal. Node baru dapat ditambahkan ke klaster, dan sistem akan menyeimbangkan ulang data untuk memanfaatkan kapasitas tambahan.
Untuk perbandingan dengan format big data lainnya, jelajahi bagaimana Apache Parquet mengoptimalkan penyimpanan kolumnar untuk beban kerja analitik.
Toleransi kesalahan di HDFS
HDFS dibangun dengan mempertimbangkan kegagalan. Dalam sistem terdistribusi besar, kegagalan node adalah hal yang diharapkan, bukan pengecualian. HDFS memastikan ketersediaan data melalui mekanisme replikasi. Jika sebuah DataNode mati, NameNode mendeteksi kegagalan melalui heartbeat yang terlewat dan menjadwalkan replikasi blok yang hilang ke node yang sehat.
Selain itu, sistem terus memantau kesehatan blok dan memulai replikasi sesuai kebutuhan. Strategi penyimpanan redundan, dikombinasikan dengan pemantauan proaktif, memastikan tidak ada satu titik kegagalan pun yang dapat mengompromikan integritas atau akses data.
Kerangka Kerja MapReduce
Berikutnya adalah mesin pemrosesan Hadoop, MapReduce. Ini memungkinkan komputasi terdistribusi atas kumpulan data besar dengan memecah tugas menjadi operasi yang lebih kecil dan independen yang dapat dieksekusi secara paralel.
Model ini menyederhanakan transformasi data yang kompleks dan sangat cocok untuk pemrosesan batch dalam lingkungan terdistribusi.
Gambaran umum MapReduce
MapReduce mengikuti model pemrograman dua fase: fase Map dan Reduce.
Selama fase Map, kumpulan data masukan dibagi menjadi potongan-potongan kecil, dan setiap potongan diproses untuk menghasilkan pasangan kunci-nilai. Hasil antara ini kemudian di-shuffle dan diurutkan sebelum diteruskan ke fase Reduce, di mana hasil tersebut diagregasi atau diubah menjadi keluaran final.
Model ini sangat efektif untuk tugas seperti menghitung frekuensi kata, memfilter log, atau melakukan join kumpulan data dalam skala besar.
Pengembang mengimplementasikan logika kustom melalui fungsi
map()danreduce(), yang diorkestrasi kerangka kerja di seluruh klaster.Alur eksekusi sebuah job MapReduce
Saat sebuah job MapReduce dikirimkan, data masukan terlebih dahulu dipecah menjadi blok-blok. JobTracker (atau ResourceManager pada versi yang mendukung YARN) kemudian mengoordinasikan distribusi blok-blok ini ke TaskTracker atau NodeManager yang tersedia.
Tugas Map dieksekusi secara paralel di berbagai node, membaca input split dan menghasilkan pasangan kunci-nilai antara. Pasangan ini kemudian di-shuffle dan diurutkan secara otomatis. Setelah fase ini selesai, tugas Reduce dimulai, mengambil data yang telah dikelompokkan dan menerapkan logika agregasi untuk menghasilkan keluaran akhir.
Proses ini menjamin lokalitas data dengan menugaskan pekerjaan sedekat mungkin dengan lokasi data berada, meminimalkan kemacetan jaringan dan meningkatkan throughput. Kegagalan tugas dideteksi dan ditugaskan ulang secara otomatis, yang berkontribusi pada ketahanan sistem.
Keuntungan dan keterbatasan MapReduce
MapReduce menawarkan beberapa keunggulan jelas:
Namun, ada juga kompromi:
Bingung memilih antara Hadoop dan Spark? Baca panduan kami tentang kerangka kerja Big Data yang tepat untuk Anda.
YARN: Yet Another Resource Negotiator
YARN berfungsi sebagai lapisan manajemen sumber daya Hadoop. YARN memisahkan penjadwalan pekerjaan dan alokasi sumber daya dari model pemrosesan, membantu Hadoop mendukung banyak mesin pemrosesan data di luar MapReduce.
Peran dalam arsitektur Hadoop
YARN bertindak sebagai platform pusat untuk mengelola sumber daya komputasi di seluruh klaster. YARN mengalokasikan sumber daya sistem yang tersedia ke beberapa aplikasi dan mengoordinasikan eksekusi. Pemisahan tanggung jawab ini membantu Hadoop berskala secara efisien dan membuka dukungan untuk kerangka kerja lain seperti Apache Spark, Hive, dan Tez.
Komponen kunci YARN
YARN memperkenalkan tiga komponen:
Setiap aplikasi (seperti job MapReduce) memiliki ApplicationMaster sendiri, yang memungkinkan isolasi kesalahan dan pelacakan job yang lebih baik.
Proses manajemen sumber daya YARN
Alur dimulai saat pengguna mengirimkan sebuah job. ResourceManager menerima job tersebut dan menetapkan sebuah container untuk memulai ApplicationMaster. Dari sana, ApplicationMaster meminta lebih banyak container untuk mengeksekusi tugas, berdasarkan beban kerja saat ini dan ketersediaan.
NodeManager meluncurkan dan mengelola container-container ini, yang menjalankan tugas individual. Sepanjang siklus hidup job, ResourceManager dan ApplicationMaster menangani pemantauan, pemulihan kegagalan, dan pelaporan penyelesaian. Jadi, ini adalah proses sekitar lima langkah.
Hadoop Common dan Utilitas
Perekat yang menyatukan semua komponen Hadoop adalah Hadoop Common. Ini adalah kumpulan pustaka, file konfigurasi, dan utilitas yang dibutuhkan oleh semua modul.
Apa itu Hadoop Common
Hadoop Common menyediakan kode dan alat fondasional yang memungkinkan HDFS, YARN, dan MapReduce untuk berkomunikasi dan berkoordinasi. Ini mencakup pustaka Java, klien sistem file, dan API yang digunakan di seluruh ekosistem.
Hadoop Common juga memastikan konsistensi dan kompatibilitas antar modul, memungkinkan pengembang membangun di atas serangkaian primitif bersama.
Pentingnya konfigurasi dan alat
Konfigurasi Hadoop yang tepat sangat krusial. Hadoop Common menyimpan file konfigurasi seperti
core-site.xml, yang mendefinisikan perilaku bawaan seperti URI sistem file dan pengaturan I/O.Alat dan skrip command-line yang disertakan dalam Hadoop Common mendukung tugas seperti memulai layanan, memeriksa kesehatan node, dan mengelola job. Sebagian besar alat ini menjadi andalan administrator sistem dan pengembang untuk operasi klaster sehari-hari.
Aplikasi Dunia Nyata dari Hadoop
Jika melibatkan kumpulan data masif, pemrosesan terdistribusi, atau analitik batch, kemungkinan Hadoop digunakan. Lebih spesifiknya, Hadoop digunakan di berbagai industri untuk memproses volume data terstruktur dan tidak terstruktur yang sangat besar. Desain terdistribusi dan fleksibilitas open-source membuatnya serbaguna untuk tugas-tugas intensif data.
Industri yang memanfaatkan Hadoop
Organisasi di bidang keuangan, kesehatan, telekomunikasi, e-niaga, dan media sosial secara rutin menggunakan Hadoop. Hadoop membantu bank mendeteksi penipuan secara real-time, mendukung penelitian genomik di bidang kesehatan, dan memungkinkan mesin rekomendasi di ritel online.
Contoh kasus penggunaan
Skenario-skenario ini mendapat manfaat dari kemampuan Hadoop menangani kumpulan data besar dengan toleransi kesalahan dan paralelisme.
Untuk alternatif modern berbasis cloud dari Hadoop, coba kursus Introduction to Databricks, yang mendukung Spark dan alat berskala lainnya.
Integrasi dengan alat lain
Hadoop jarang bekerja secara terisolasi dan dapat diintegrasikan dengan ratusan program aksesori. Bergantung pada preferensi dan lingkungan pengodean Anda, Anda dapat memasangkan Hadoop dengan:
Kesimpulan
Meski Hadoop mungkin tidak lagi menjadi kata kunci sepopuler dulu, ia tetap merupakan teknologi fondasional dalam lanskap big data. Memahami Hadoop masih sangat berharga bagi profesional data yang bekerja dengan sistem berskala besar. Komponen intinya—HDFS untuk penyimpanan, MapReduce untuk pemrosesan, YARN untuk manajemen sumber daya, dan Hadoop Common untuk utilitas esensial—terus membentuk cara alur kerja data dirancang dan diskalakan.
Sebelum masuk ke penerapan atau pengoptimalan, luangkan waktu untuk memahami bagaimana data didistribusikan dan dikonfigurasi dalam klaster Hadoop. Pengetahuan itu menyederhanakan pemecahan masalah dan penyetelan kinerja serta membuka jalan untuk mengintegrasikan alat tangguh seperti Apache Spark dan Hive untuk analitik yang lebih canggih.
Untuk informasi lebih lanjut tentang pemrosesan big data, lihat: