Apache Hadoop, spesso chiamato semplicemente Hadoop, è un potente framework open-source progettato per elaborare e archiviare dataset enormi distribuendoli su cluster di hardware economico e di largo consumo. La sua forza sta nella scalabilità e nella flessibilità, che gli consentono di lavorare sia con dati strutturati che non strutturati.
In questo post, ti guiderò attraverso i componenti chiave che rendono Hadoop ciò che è: come archivia, elabora e gestisce i dati su larga scala. Alla fine, avrai un quadro chiaro di come questa tecnologia fondamentale si inserisce negli ecosistemi di big data.
Panoramica dell’ecosistema Hadoop
Hadoop non è un singolo strumento. È un ecosistema che include più moduli che lavorano insieme per gestire l’archiviazione dei dati, l’elaborazione e il coordinamento delle risorse.
Moduli core di Hadoop
Hadoop è composto da quattro moduli fondamentali:
- HDFS (Hadoop Distributed File System): Un sistema di archiviazione distribuito che divide i file in blocchi e li distribuisce su un cluster.
- MapReduce: Un modello di programmazione per elaborare i dati in parallelo tra i nodi.
- YARN (Yet Another Resource Negotiator): Gestisce le risorse e pianifica i job nel cluster.
- Hadoop Common: Un insieme di librerie e utility condivise che supportano gli altri moduli.
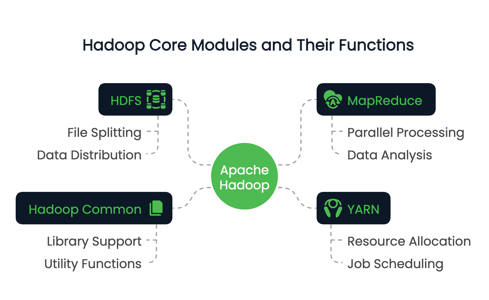
Questi moduli lavorano insieme per creare un ambiente di calcolo distribuito in grado di gestire petabyte di dati.
Per esplorare come il processing distribuito si confronta tra diverse piattaforme, il corso Big Data Fundamentals with PySpark offre un’introduzione pratica che completa la tua comprensione di Hadoop.
Ruolo di Hadoop nei big data
Il ruolo principale di Hadoop risiede nella sua capacità di affrontare una sfida centrale nell’ambito big data dell’elaborazione, ovvero la scalabilità.
I sistemi tradizionali spesso faticano con dataset che superano la capacità di una singola macchina, sia in termini di storage che di calcolo. Hadoop risolve questo problema distribuendo i dati su molti nodi ed eseguendo le computazioni in parallelo.
Così Hadoop può elaborare in modo efficiente terabyte o addirittura petabyte di dati. Oltre alla scalabilità, Hadoop offre anche un’elevata tolleranza ai guasti grazie alla replica dei dati e consente alle organizzazioni di costruire infrastrutture dati convenienti utilizzando hardware di largo consumo.
Caratteristiche chiave di Hadoop
Abbiamo parlato del ruolo e della struttura di Hadoop, ora vediamo alcune delle caratteristiche più preziose di Hadoop. Tra queste:
- Archiviazione ed elaborazione distribuite che consentono di archiviare dataset estremamente grandi e interrogarli.
- Scalabilità orizzontale senza richiedere macchine di fascia alta.
- Ottimizzazione della località dei dati, spostando il calcolo dove risiedono i dati.
- Resilienza ai guasti tramite replica e riesecuzione dei task.
Queste caratteristiche rendono Hadoop adatto all’elaborazione batch, all’analisi dei log e alle pipeline ETL. Hadoop è un caso di studio classico nell’informatica distribuita, in cui il calcolo avviene su più nodi per aumentare efficienza e scala.
Ora vediamo nel dettaglio ciascuno dei moduli core di Hadoop.
Vuoi verificare le tue conoscenze su Hadoop o prepararti per un ruolo data? Ecco 24 domande e risposte su Hadoop per i colloqui del 2025 per iniziare.
Hadoop Distributed File System (HDFS)
Dei quattro componenti principali, HDFS è il sistema di archiviazione primario di Hadoop. È progettato per archiviare in modo affidabile le enormi quantità di dati su un cluster di macchine di cui abbiamo parlato in precedenza. La sua architettura è pensata per questo tipo di accesso a grandi dataset ed è ottimizzata per tolleranza ai guasti, scalabilità e località dei dati.
Architettura e componenti
L’architettura HDFS ruota attorno a un modello master-slave. Al vertice c’è il NameNode, che gestisce i metadati — in sostanza, l’albero delle directory del file system e le informazioni sull’ubicazione di ciascun file. Non archivia i dati effettivi.
I DataNode sono i cavalli di battaglia. Gestiscono lo storage collegato ai nodi e servono le richieste di lettura/scrittura dei client. Ogni DataNode invia regolarmente al NameNode un heartbeat e i report dei blocchi per garantire un monitoraggio coerente dello stato.
Infine, HDFS include un Secondary NameNode, da non confondere con un nodo di failover. Piuttosto, effettua periodicamente checkpoint dei metadati del NameNode per ridurre i tempi di avvio e l’overhead di memoria.
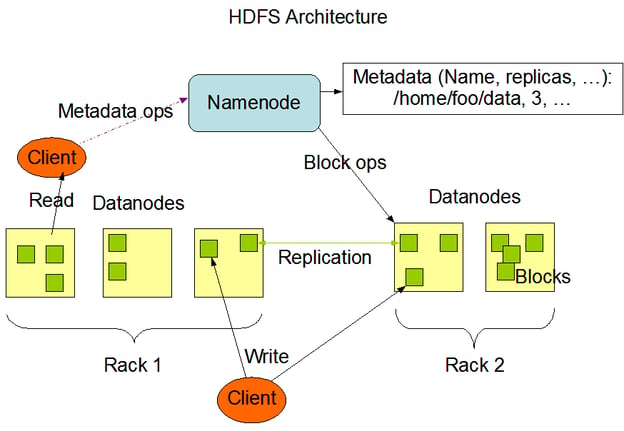
L’architettura HDFS. Fonte immagine: documentazione Apache Hadoop
Come vengono archiviati i dati in HDFS
Quando un file viene scritto su HDFS, viene suddiviso in blocchi da 64 MB a dimensione fissa. Ogni blocco viene quindi distribuito su diversi DataNode. Questa strategia di distribuzione supporta il parallelismo durante l’accesso ai dati e aumenta la tolleranza ai guasti.
I dati in HDFS non vengono archiviati una sola volta. Ogni blocco viene replicato (l’impostazione predefinita è tre copie) e distribuito nel cluster. Durante una lettura, il sistema estrae i dati dalla replica disponibile più vicina per massimizzare il throughput e ridurre la latenza. Le scritture vanno prima a una replica e poi si propagano alle altre, garantendo durabilità senza colli di bottiglia immediati.
Questo design a livello di blocco consente anche a HDFS di scalare orizzontalmente. Si possono aggiungere nuovi nodi al cluster e il sistema ribilancia i dati per utilizzare la capacità aggiuntiva.
Per un confronto con altri formati big data, explora come Apache Parquet ottimizza l’archiviazione colonnare per carichi analitici.
Tolleranza ai guasti in HDFS
HDFS è progettato pensando ai guasti. Nei grandi sistemi distribuiti, i guasti dei nodi sono previsti, non eccezionali. HDFS garantisce la disponibilità dei dati tramite il meccanismo di replica. Se un DataNode si arresta, il NameNode rileva il guasto tramite heartbeat mancati e pianifica la replica dei blocchi persi su nodi sani.
Inoltre, il sistema monitora costantemente lo stato dei blocchi e avvia la replica quando necessario. La strategia di archiviazione ridondante, unita al monitoraggio proattivo, garantisce che nessun singolo punto di guasto possa compromettere l’integrità o l’accesso ai dati.
Framework MapReduce
Passiamo ora al motore di elaborazione di Hadoop, MapReduce. Consente la computazione distribuita su grandi dataset suddividendo i task in operazioni più piccole e indipendenti che possono essere eseguite in parallelo.
Il modello semplifica trasformazioni dati complesse ed è particolarmente adatto all’elaborazione batch in un ambiente distribuito.
Panoramica di MapReduce
MapReduce segue un modello di programmazione in due fasi: Map e Reduce.
Durante la fase Map, il dataset di input viene diviso in blocchi più piccoli e ciascun blocco viene elaborato per produrre coppie chiave-valore. Questi risultati intermedi vengono poi rimescolati e ordinati prima di passare alla fase Reduce, dove vengono aggregati o trasformati negli output finali.
Questo modello è molto efficace per attività come contare la frequenza delle parole, filtrare log o unire dataset su larga scala.
Gli sviluppatori implementano la logica personalizzata tramite le funzioni map() e reduce(), che il framework orchestra nel cluster.
Flusso di esecuzione di un job MapReduce
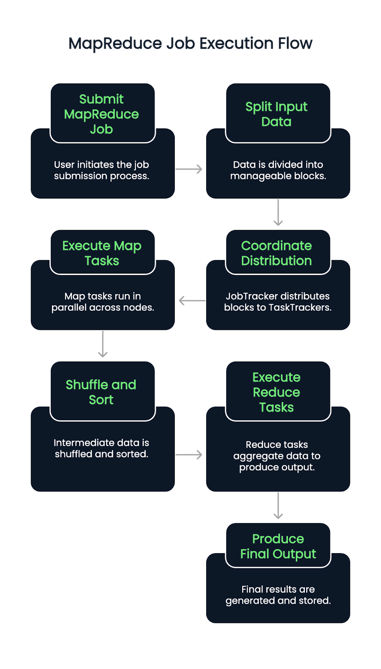
Quando si invia un job MapReduce, i dati di input vengono prima suddivisi in blocchi. Un JobTracker (o ResourceManager nelle versioni abilitate a YARN) coordina quindi la distribuzione di questi blocchi tra i TaskTracker o NodeManager disponibili.
I task Map vengono eseguiti in parallelo sui nodi, leggendo gli split di input ed emettendo coppie chiave-valore intermedie. Queste coppie vengono poi automaticamente rimescolate e ordinate. Una volta completata questa fase, iniziano i task Reduce, che acquisiscono i dati raggruppati e applicano la logica di aggregazione per produrre l’output finale.
Il processo garantisce la località dei dati assegnando i task vicino a dove risiedono i dati, riducendo la congestione di rete e migliorando il throughput. I guasti dei task vengono rilevati e riassegnati automaticamente, contribuendo alla resilienza del sistema.
Vantaggi e limiti di MapReduce
MapReduce offre diversi vantaggi evidenti:
- Eccellente parallelismo per l’elaborazione batch su larga scala
- Scalabilità su migliaia di nodi
- Forte tolleranza ai guasti tramite riesecuzione dei task e checkpointing
Ma comporta anche dei compromessi:
- Il modello introduce latenza elevata, quindi è meno adatto all’elaborazione in tempo reale
- Scrivere job MapReduce personalizzati può richiedere molto sforzo ed è difficile da fare il debug
- Manca dell’interattività e della flessibilità di strumenti più recenti come Apache Spark.
Sei indeciso tra Hadoop e Spark? Leggi la nostra guida per capire quale framework Big Data fa per te.
YARN: Yet Another Resource Negotiator
YARN funge da layer di gestione delle risorse di Hadoop. Separa la pianificazione dei job e l’allocazione delle risorse dal modello di elaborazione, aiutando Hadoop a supportare più motori di elaborazione dati oltre a MapReduce.
Ruolo nell’architettura Hadoop
YARN agisce come piattaforma centrale per gestire le risorse di calcolo nel cluster. Alloca le risorse di sistema disponibili a diverse applicazioni e ne coordina l’esecuzione. Questa separazione delle responsabilità aiuta Hadoop a scalare in modo efficiente e apre la strada al supporto di altri framework come Apache Spark, Hive e Tez.
Componenti chiave di YARN
YARN introduce tre componenti:
- ResourceManager: Il demone master (programma in background) che gestisce tutte le risorse e pianifica le applicazioni.
- NodeManager: Un agente per nodo che monitora l’utilizzo delle risorse e riporta al ResourceManager.
- ApplicationMaster: Un’operazione specifica per il job che utilizza le risorse del ResourceManager e coordina l’esecuzione con i NodeManager.
Ogni applicazione (come un job MapReduce) ha il proprio ApplicationMaster, il che consente un migliore isolamento dei guasti e il tracciamento dei job.
Processo di gestione delle risorse in YARN
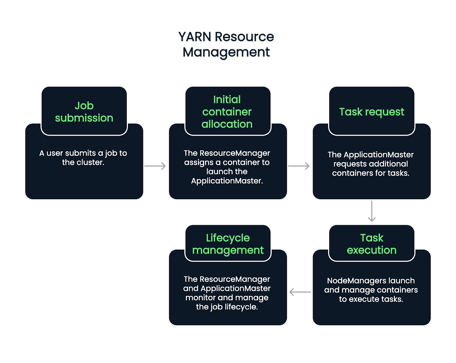
Il flusso inizia quando un utente invia un job. Il ResourceManager accetta il job e assegna un container per avviare l’ApplicationMaster. Da lì, l’ApplicationMaster richiede altri container per eseguire i task, in base al carico di lavoro e alla disponibilità attuali.
I NodeManager avviano e gestiscono questi container, che eseguono i singoli task. Durante l’intero ciclo di vita del job, ResourceManager e ApplicationMaster si occupano di monitoraggio, ripristino dai guasti e report di completamento. In pratica, è un processo in cinque passaggi.
- Invio del job: Un utente invia un job al cluster.
- Allocazione iniziale del container: Il ResourceManager accetta il job e assegna un container per avviare l’ApplicationMaster.
- Richiesta dei task: L’ApplicationMaster richiede container aggiuntivi per eseguire task specifici, in base al carico di lavoro e alle risorse disponibili.
- Esecuzione dei task: I NodeManager avviano e gestiscono questi container, che portano a termine i task.
- Gestione del ciclo di vita: Il ResourceManager e l’ApplicationMaster collaborano per monitorare l’avanzamento del job, gestire i guasti e confermare il completamento dei task. Durante l’intero ciclo di vita del job, il ResourceManager e l’ApplicationMaster si occupano di monitoraggio, ripristino dai guasti e report di completamento.
Hadoop Common e utility
La colla che tiene insieme tutti i componenti di Hadoop è Hadoop Common. È una raccolta di librerie, file di configurazione e utility necessarie a tutti i moduli.
Che cos’è Hadoop Common
Hadoop Common fornisce il codice e gli strumenti di base che consentono a HDFS, YARN e MapReduce di comunicare e coordinarsi. Include librerie Java, client del file system e API utilizzate in tutto l’ecosistema.
Garantisce inoltre coerenza e compatibilità tra i moduli, consentendo agli sviluppatori di costruire su un set condiviso di primitive.
Importanza della configurazione e degli strumenti
La corretta configurazione di Hadoop è fondamentale. Hadoop Common ospita file di configurazione come core-site.xml, che definiscono i comportamenti predefiniti come gli URI del file system e le impostazioni di I/O.
Gli strumenti e gli script da riga di comando inclusi in Hadoop Common supportano attività come l’avvio dei servizi, il controllo dello stato dei nodi e la gestione dei job. Su molti di questi strumenti fanno affidamento amministratori di sistema e sviluppatori per le operazioni quotidiane del cluster.
Applicazioni reali di Hadoop
Se si usano dataset enormi, elaborazione distribuita o analisi batch, è probabile che si usi Hadoop. Più nello specifico, Hadoop è utilizzato in vari settori per elaborare enormi volumi di dati strutturati e non strutturati. Il suo design distribuito e la flessibilità open-source lo rendono versatile per i task data-intensive.
Settori che sfruttano Hadoop
Organizzazioni in finanza, sanità, telecomunicazioni, e-commerce e social media utilizzano regolarmente Hadoop. Aiuta le banche a rilevare frodi in tempo reale, supporta la ricerca genomica in ambito sanitario e abilita i motori di raccomandazione nel retail online.
Esempi d’uso
- Elaborazione dei log: aggregazione e analisi dei dati di log da server e applicazioni.
- Sistemi di raccomandazione: creazione di modelli che suggeriscono contenuti o prodotti.
- Rilevamento frodi: identificazione di pattern di comportamento sospetti tra le transazioni.
Questi scenari traggono vantaggio dalla capacità di Hadoop di gestire grandi dataset con tolleranza ai guasti e parallelismo.
Per un’alternativa moderna e cloud-native a Hadoop, prova il corso Introduction to Databricks, che supporta Spark e altri strumenti scalabili.
Integrazione con altri strumenti
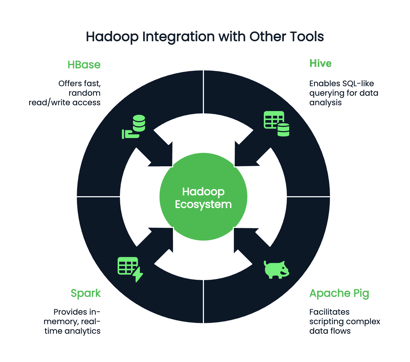
Hadoop raramente lavora in isolamento e può integrarsi con centinaia di programmi accessori. A seconda delle tue preferenze e dell’ambiente di sviluppo, potresti affiancare a Hadoop:
- Hive: per query in stile SQL
- Apache Pig: per scriptare flussi di dati complessi
- Spark: per analytics in-memory e in tempo reale
- HBase: per accesso veloce e casuale in lettura/scrittura a grandi dataset
Conclusione
Anche se Hadoop non è più il termine di tendenza di un tempo, rimane una tecnologia fondamentale nel panorama dei big data. Capire Hadoop è ancora estremamente prezioso per chiunque lavori con sistemi su larga scala. I suoi componenti core — HDFS per lo storage, MapReduce per l’elaborazione, YARN per la gestione delle risorse e Hadoop Common per le utility essenziali — continuano a influenzare il modo in cui si progettano e scalano i workflow dei dati.
Prima di lanciarti in distribuzione o ottimizzazione, prenditi il tempo per capire come i dati sono distribuiti e configurati all’interno di un cluster Hadoop. Questa conoscenza semplifica la risoluzione dei problemi e l’ottimizzazione delle prestazioni e apre la strada all’integrazione di strumenti potenti come Apache Spark e Hive per analytics più sofisticati.
Per saperne di più sull’elaborazione dei big data, dai un’occhiata a:





Apache Hadoop, spesso chiamato semplicemente Hadoop, è un potente framework open-source progettato per elaborare e archiviare dataset enormi distribuendoli su cluster di hardware economico e di largo consumo. La sua forza sta nella scalabilità e nella flessibilità, che gli consentono di lavorare sia con dati strutturati che non strutturati.
In questo post, ti guiderò attraverso i componenti chiave che rendono Hadoop ciò che è: come archivia, elabora e gestisce i dati su larga scala. Alla fine, avrai un quadro chiaro di come questa tecnologia fondamentale si inserisce negli ecosistemi di big data.
Panoramica dell’ecosistema Hadoop
Hadoop non è un singolo strumento. È un ecosistema che include più moduli che lavorano insieme per gestire l’archiviazione dei dati, l’elaborazione e il coordinamento delle risorse.
Moduli core di Hadoop
Hadoop è composto da quattro moduli fondamentali:
Questi moduli lavorano insieme per creare un ambiente di calcolo distribuito in grado di gestire petabyte di dati.
Per esplorare come il processing distribuito si confronta tra diverse piattaforme, il corso Big Data Fundamentals with PySpark offre un’introduzione pratica che completa la tua comprensione di Hadoop.
Ruolo di Hadoop nei big data
Il ruolo principale di Hadoop risiede nella sua capacità di affrontare una sfida centrale nell’ambito big data dell’elaborazione, ovvero la scalabilità.
I sistemi tradizionali spesso faticano con dataset che superano la capacità di una singola macchina, sia in termini di storage che di calcolo. Hadoop risolve questo problema distribuendo i dati su molti nodi ed eseguendo le computazioni in parallelo.
Così Hadoop può elaborare in modo efficiente terabyte o addirittura petabyte di dati. Oltre alla scalabilità, Hadoop offre anche un’elevata tolleranza ai guasti grazie alla replica dei dati e consente alle organizzazioni di costruire infrastrutture dati convenienti utilizzando hardware di largo consumo.
Caratteristiche chiave di Hadoop
Abbiamo parlato del ruolo e della struttura di Hadoop, ora vediamo alcune delle caratteristiche più preziose di Hadoop. Tra queste:
Queste caratteristiche rendono Hadoop adatto all’elaborazione batch, all’analisi dei log e alle pipeline ETL. Hadoop è un caso di studio classico nell’informatica distribuita, in cui il calcolo avviene su più nodi per aumentare efficienza e scala.
Ora vediamo nel dettaglio ciascuno dei moduli core di Hadoop.
Vuoi verificare le tue conoscenze su Hadoop o prepararti per un ruolo data? Ecco 24 domande e risposte su Hadoop per i colloqui del 2025 per iniziare.
Hadoop Distributed File System (HDFS)
Dei quattro componenti principali, HDFS è il sistema di archiviazione primario di Hadoop. È progettato per archiviare in modo affidabile le enormi quantità di dati su un cluster di macchine di cui abbiamo parlato in precedenza. La sua architettura è pensata per questo tipo di accesso a grandi dataset ed è ottimizzata per tolleranza ai guasti, scalabilità e località dei dati.
Architettura e componenti
L’architettura HDFS ruota attorno a un modello master-slave. Al vertice c’è il NameNode, che gestisce i metadati — in sostanza, l’albero delle directory del file system e le informazioni sull’ubicazione di ciascun file. Non archivia i dati effettivi.
I DataNode sono i cavalli di battaglia. Gestiscono lo storage collegato ai nodi e servono le richieste di lettura/scrittura dei client. Ogni DataNode invia regolarmente al NameNode un heartbeat e i report dei blocchi per garantire un monitoraggio coerente dello stato.
Infine, HDFS include un Secondary NameNode, da non confondere con un nodo di failover. Piuttosto, effettua periodicamente checkpoint dei metadati del NameNode per ridurre i tempi di avvio e l’overhead di memoria.
L’architettura HDFS. Fonte immagine: documentazione Apache Hadoop
Come vengono archiviati i dati in HDFS
Quando un file viene scritto su HDFS, viene suddiviso in blocchi da 64 MB a dimensione fissa. Ogni blocco viene quindi distribuito su diversi DataNode. Questa strategia di distribuzione supporta il parallelismo durante l’accesso ai dati e aumenta la tolleranza ai guasti.
I dati in HDFS non vengono archiviati una sola volta. Ogni blocco viene replicato (l’impostazione predefinita è tre copie) e distribuito nel cluster. Durante una lettura, il sistema estrae i dati dalla replica disponibile più vicina per massimizzare il throughput e ridurre la latenza. Le scritture vanno prima a una replica e poi si propagano alle altre, garantendo durabilità senza colli di bottiglia immediati.
Questo design a livello di blocco consente anche a HDFS di scalare orizzontalmente. Si possono aggiungere nuovi nodi al cluster e il sistema ribilancia i dati per utilizzare la capacità aggiuntiva.
Per un confronto con altri formati big data, explora come Apache Parquet ottimizza l’archiviazione colonnare per carichi analitici.
Tolleranza ai guasti in HDFS
HDFS è progettato pensando ai guasti. Nei grandi sistemi distribuiti, i guasti dei nodi sono previsti, non eccezionali. HDFS garantisce la disponibilità dei dati tramite il meccanismo di replica. Se un DataNode si arresta, il NameNode rileva il guasto tramite heartbeat mancati e pianifica la replica dei blocchi persi su nodi sani.
Inoltre, il sistema monitora costantemente lo stato dei blocchi e avvia la replica quando necessario. La strategia di archiviazione ridondante, unita al monitoraggio proattivo, garantisce che nessun singolo punto di guasto possa compromettere l’integrità o l’accesso ai dati.
Framework MapReduce
Passiamo ora al motore di elaborazione di Hadoop, MapReduce. Consente la computazione distribuita su grandi dataset suddividendo i task in operazioni più piccole e indipendenti che possono essere eseguite in parallelo.
Il modello semplifica trasformazioni dati complesse ed è particolarmente adatto all’elaborazione batch in un ambiente distribuito.
Panoramica di MapReduce
MapReduce segue un modello di programmazione in due fasi: Map e Reduce.
Durante la fase Map, il dataset di input viene diviso in blocchi più piccoli e ciascun blocco viene elaborato per produrre coppie chiave-valore. Questi risultati intermedi vengono poi rimescolati e ordinati prima di passare alla fase Reduce, dove vengono aggregati o trasformati negli output finali.
Questo modello è molto efficace per attività come contare la frequenza delle parole, filtrare log o unire dataset su larga scala.
Gli sviluppatori implementano la logica personalizzata tramite le funzioni
map()ereduce(), che il framework orchestra nel cluster.Flusso di esecuzione di un job MapReduce
Quando si invia un job MapReduce, i dati di input vengono prima suddivisi in blocchi. Un JobTracker (o ResourceManager nelle versioni abilitate a YARN) coordina quindi la distribuzione di questi blocchi tra i TaskTracker o NodeManager disponibili.
I task Map vengono eseguiti in parallelo sui nodi, leggendo gli split di input ed emettendo coppie chiave-valore intermedie. Queste coppie vengono poi automaticamente rimescolate e ordinate. Una volta completata questa fase, iniziano i task Reduce, che acquisiscono i dati raggruppati e applicano la logica di aggregazione per produrre l’output finale.
Il processo garantisce la località dei dati assegnando i task vicino a dove risiedono i dati, riducendo la congestione di rete e migliorando il throughput. I guasti dei task vengono rilevati e riassegnati automaticamente, contribuendo alla resilienza del sistema.
Vantaggi e limiti di MapReduce
MapReduce offre diversi vantaggi evidenti:
Ma comporta anche dei compromessi:
Sei indeciso tra Hadoop e Spark? Leggi la nostra guida per capire quale framework Big Data fa per te.
YARN: Yet Another Resource Negotiator
YARN funge da layer di gestione delle risorse di Hadoop. Separa la pianificazione dei job e l’allocazione delle risorse dal modello di elaborazione, aiutando Hadoop a supportare più motori di elaborazione dati oltre a MapReduce.
Ruolo nell’architettura Hadoop
YARN agisce come piattaforma centrale per gestire le risorse di calcolo nel cluster. Alloca le risorse di sistema disponibili a diverse applicazioni e ne coordina l’esecuzione. Questa separazione delle responsabilità aiuta Hadoop a scalare in modo efficiente e apre la strada al supporto di altri framework come Apache Spark, Hive e Tez.
Componenti chiave di YARN
YARN introduce tre componenti:
Ogni applicazione (come un job MapReduce) ha il proprio ApplicationMaster, il che consente un migliore isolamento dei guasti e il tracciamento dei job.
Processo di gestione delle risorse in YARN
Il flusso inizia quando un utente invia un job. Il ResourceManager accetta il job e assegna un container per avviare l’ApplicationMaster. Da lì, l’ApplicationMaster richiede altri container per eseguire i task, in base al carico di lavoro e alla disponibilità attuali.
I NodeManager avviano e gestiscono questi container, che eseguono i singoli task. Durante l’intero ciclo di vita del job, ResourceManager e ApplicationMaster si occupano di monitoraggio, ripristino dai guasti e report di completamento. In pratica, è un processo in cinque passaggi.
Hadoop Common e utility
La colla che tiene insieme tutti i componenti di Hadoop è Hadoop Common. È una raccolta di librerie, file di configurazione e utility necessarie a tutti i moduli.
Che cos’è Hadoop Common
Hadoop Common fornisce il codice e gli strumenti di base che consentono a HDFS, YARN e MapReduce di comunicare e coordinarsi. Include librerie Java, client del file system e API utilizzate in tutto l’ecosistema.
Garantisce inoltre coerenza e compatibilità tra i moduli, consentendo agli sviluppatori di costruire su un set condiviso di primitive.
Importanza della configurazione e degli strumenti
La corretta configurazione di Hadoop è fondamentale. Hadoop Common ospita file di configurazione come
core-site.xml, che definiscono i comportamenti predefiniti come gli URI del file system e le impostazioni di I/O.Gli strumenti e gli script da riga di comando inclusi in Hadoop Common supportano attività come l’avvio dei servizi, il controllo dello stato dei nodi e la gestione dei job. Su molti di questi strumenti fanno affidamento amministratori di sistema e sviluppatori per le operazioni quotidiane del cluster.
Applicazioni reali di Hadoop
Se si usano dataset enormi, elaborazione distribuita o analisi batch, è probabile che si usi Hadoop. Più nello specifico, Hadoop è utilizzato in vari settori per elaborare enormi volumi di dati strutturati e non strutturati. Il suo design distribuito e la flessibilità open-source lo rendono versatile per i task data-intensive.
Settori che sfruttano Hadoop
Organizzazioni in finanza, sanità, telecomunicazioni, e-commerce e social media utilizzano regolarmente Hadoop. Aiuta le banche a rilevare frodi in tempo reale, supporta la ricerca genomica in ambito sanitario e abilita i motori di raccomandazione nel retail online.
Esempi d’uso
Questi scenari traggono vantaggio dalla capacità di Hadoop di gestire grandi dataset con tolleranza ai guasti e parallelismo.
Per un’alternativa moderna e cloud-native a Hadoop, prova il corso Introduction to Databricks, che supporta Spark e altri strumenti scalabili.
Integrazione con altri strumenti
Hadoop raramente lavora in isolamento e può integrarsi con centinaia di programmi accessori. A seconda delle tue preferenze e dell’ambiente di sviluppo, potresti affiancare a Hadoop:
Conclusione
Anche se Hadoop non è più il termine di tendenza di un tempo, rimane una tecnologia fondamentale nel panorama dei big data. Capire Hadoop è ancora estremamente prezioso per chiunque lavori con sistemi su larga scala. I suoi componenti core — HDFS per lo storage, MapReduce per l’elaborazione, YARN per la gestione delle risorse e Hadoop Common per le utility essenziali — continuano a influenzare il modo in cui si progettano e scalano i workflow dei dati.
Prima di lanciarti in distribuzione o ottimizzazione, prenditi il tempo per capire come i dati sono distribuiti e configurati all’interno di un cluster Hadoop. Questa conoscenza semplifica la risoluzione dei problemi e l’ottimizzazione delle prestazioni e apre la strada all’integrazione di strumenti potenti come Apache Spark e Hive per analytics più sofisticati.
Per saperne di più sull’elaborazione dei big data, dai un’occhiata a: