如果让我用一个词来概括全新的 AI 时代,那就是规模。自 2022 年 11 月 OpenAI 推出基于网页的 GPT-3 界面(即 ChatGPT)以来,由于大众的广泛使用,大型语言模型的热度显著攀升。
“规模”不仅体现在这些模型的流行程度上,也体现在其训练所用的海量数据、超高的参数数量,以及它们所能胜任的多样化任务。
在我看来,这类模型的爆发最初让大型语言模型(LLM)成为焦点。两年之后,随着该领域的发展,我认为更流行的术语已经转向基础模型。
但什么是基础模型?又是什么让一个模型称为“基础”?
与 LLM 不同,基础模型在社区中已存在多年。本文将探讨 基础模型的概念,重点关注其关键特征、应用以及在 AI 时代的未来。
什么是基础模型?
取一种 AI 架构,例如Transformer,并用海量多样的数据进行训练:来自 Common Crawl 和书籍的文本、图像、YouTube 视频等。
由于这些数据广泛、通用且多模态,最终得到的模型会成为一个具备广博知识的大型通用系统。这就是基础模型:一种多才多用的通用模型,作为构建专业化 AI 应用的“基础”。
这些基础模型可以通过微调、提示(prompting)或其他迁移学习技术来适配特定任务。理念在于,一旦在某一领域进行专门化,模型仍将保留底座模型强大的泛化能力和涌现能力。
历史发展
早期的 AI 系统大多基于规则,且高度依赖特定领域,因此需要为每个任务编写专用程序。2000 年代初,机器学习兴起,标志着向数据驱动方法的转变,尽管当时仍局限于特定任务。
深度学习的突破大约在 2012 年到来,使更复杂的模式识别和先进的生成模型成为可能,两个重要里程碑是:2014 年的生成对抗网络和2017 年的 Transformer。
AI 的发展在很大程度上得益于计算能力(如GPU、TPU)的进步以及海量数据集的可用性,这些都推动了越来越大型模型的训练,进而催生了基础模型。
传统 AI 系统与基础模型之间的差异,也体现在其规模上。例如,传统 AI 系统通常在精心整理的小型数据集上训练,而基础模型使用海量、多样且往往非结构化的数据。此外,基础模型具备很强的泛化能力,能够处理更复杂、更广泛的任务;而传统 AI 系统在应对新任务时通常需要重新训练或进行大量改造。
基础模型的关键特征
有一些特征使基础模型独具一格:
泛化能力
泛化指模型在未见过的任务上表现良好的能力,或者更具体地说,在训练集之外的数据上表现良好的能力。基础模型之所以有价值,很大程度上源于这一特性。与此密切相关的是,这些模型还可能展现出在训练时未计划、但在大规模下自然出现的意外能力,即所谓的涌现行为。
虽然泛化是模型训练的预期结果,但涌现能力往往难以预测,因为模型并未为这些用途进行明确训练。
此外,这些模型具有可扩展性,即通过增大模型规模(连同数据量和算力资源)即可提升性能。尽管更大的模型往往更善于泛化,但仅靠增大规模并不能保证泛化能力一定提升。不过,涌现行为与模型规模高度相关。
多模态
多模态是指 AI 模型处理并融合多种类型数据(如文本、图像、视频等)的能力。基础模型可以是多模态的,但这并非必需条件。
多模态的一个关键方面是跨模态理解,即模型能够理解并关联不同类型数据中的信息。例如,结合文本与图像为图片生成字幕,或回答有关视觉内容的问题。多模态带来更丰富的交互,并为需要文本、视觉与音频协同工作的应用打开大门,如机器人或医疗系统。
若想更深入了解多模态,欢迎阅读我们的文章 什么是多模态 AI?
适应性
最后,基础模型的另一关键点在于, 它们可作为面向特定领域模型的底座。因此,我们可以基于较小的、特定领域的数据集,通过调整其权重来适配具体任务或领域,同时受益于其多模态、泛化能力等特性。这一过程称为微调,您可在我们的LLM 微调指南中进一步了解。
常见的微调技术包括:
- 监督式微调:在带标签的数据集上针对特定任务训练模型。这是最常见的微调策略。
- 迁移学习:此思路是冻结模型的早期层(捕捉通用知识),仅微调后期层以聚焦领域特征。
- 持续预训练:在初始训练阶段之后,使用领域数据对已有模型进行进一步训练。该技术常用于让模型随时间与新数据保持同步。
基础模型 vs 大型语言模型
大型语言模型是基础模型的一个特化类型,其训练数据完全或主要为文本。LLM 还可以进一步针对具体任务进行微调,如机器翻译或摘要生成。
下表有助于突出这两类模型的差异与共性:
|
方面
|
基础模型
|
大型语言模型
|
|
范围
|
通用模型,通常在多模态数据上训练。
|
基础模型的子集,仅在文本数据上训练,有时会针对特定任务进行微调。
|
|
训练数据
|
多样(且通常为多模态)的数据集。
|
以文本语料为主。
|
|
架构*
|
多种架构:Transformer、卷积神经网络(CNN),或依据数据类型的混合架构。
|
通常为基于 Transformer 的架构。
|
|
用例
|
多模态通用任务。
|
聚焦语言任务:翻译、摘要、聊天机器人、代码生成等。
当下在社会各界广受欢迎。可在我们的指南中找到最流行的开源模型。
|
* 我们将在下一节对基础模型的架构做进一步阐述。
从更实际的例子来看,最初 ChatGPT 网页界面所用的 GPT 模型是 GPT-3。它是纯文本的大型语言模型,用户只能通过提示与之交互。由于 LLM 属于基础模型的子集,GPT-3 也属于基础模型。
如今,当我们进入 ChatGPT 界面时,可以看到在提示旁边可以附加图像。这是因为现在界面背后的模型是 GPT-4。GPT-4 则是一种多模态的基础模型。
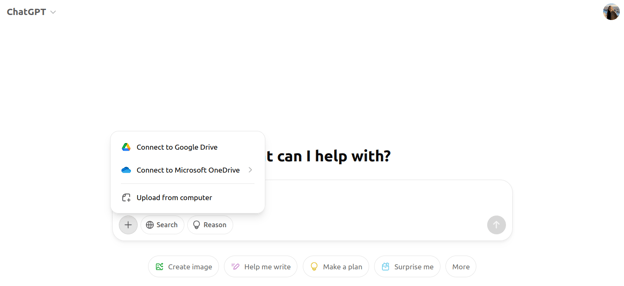
ChatGPT 多模态界面的截图。
基础模型的架构
由于我们最早接触到的大型模型多为 LLM,大家往往认为基础模型背后只有 Transformer 架构。
然而,在 Transformer 流行之前,循环神经网络(RNN)曾是文本类基础模型的主流架构。
在图像生成领域,扩散模型如今已成为这些最前沿系统的中坚。知名模型包括 Stable Diffusion 与 DALL-E,但在它们之前,卷积神经网络(CNN) 就已被广泛采用!
扩散模型之所以被视为图像生成的基础模型,原因与前文相同:它们能够生成高质量、多样化的图像,并可针对图像编辑、修复(inpainting)等特定任务进行微调。
基础模型的应用
凭借通用性与适应性,基础模型被广泛用于各类领域,其中包括:
1. 自然语言处理
如前所述,基础模型在自然语言处理方面取得了长足进步。像 ChatGPT 这样的模型所展现的类人能力,使其在客户服务应用中不可或缺。如今的在线对话代理多半基于 LLM,相较早期依赖规则系统的聊天机器人,能够进行更自然、连贯的交流。
这些模型也驱动着机器翻译应用,如Google 翻译与DeepL。如今使用这些工具,您会发现它们比十年前更为准确,也更具上下文意识。
如果您对自然语言应用感兴趣,课程“开发 AI 应用”将助您一臂之力!
2. 计算机视觉
例如 CLIP 和 DALL-E等模型结合了文本与图像理解,使图像字幕生成与 文生图等应用成为可能,而这些在此前的架构中尚不可行。
在工具方面,Adobe Photoshop已将扩散模型引入其编辑工具,例如内容识别填充等 AI 功能,用于自动补全与修复图像。
3. 跨领域应用
最后,还有一些多模态应用,能够同时处理并融合来自多个领域的数据。例如在自动驾驶系统中,特斯拉 和 Waymo(谷歌的自动驾驶项目)使用多模态系统,将来自摄像头的视觉数据、雷达信号与激光雷达传感器数据,与文本与上下文信息相结合,以进行环境感知与导航。
这些跨领域应用正在重塑行业,使系统更加灵活、可适应且智能,而此前受限于更窄的模型能力。
了解以上应用后,我们可以如图所示对模型进行可视化分类:
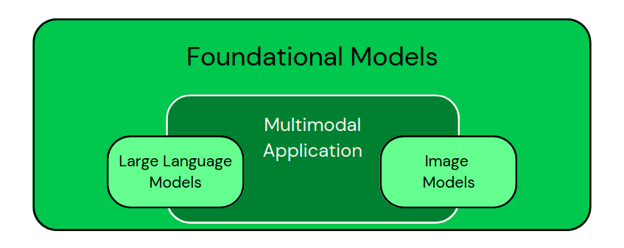
将特定领域模型归类为基础模型的子集。多模态应用融合不同类型的数据。- 作者制图
如果您考虑构建由这些模型驱动的应用,文章《5 个可用生成式 AI 模型构建的项目》能给您带来不错的灵感。
基础模型的挑战与伦理考量
如我们所见,基础模型能力更强,但也伴随着若干挑战与伦理问题:
计算成本
训练这些模型在时间与能源方面都极其资源密集型。即便训练完成,这些模型在推理阶段仍需大量资源,尤其在实时应用中,使得规模化部署成本高昂。随着模型规模与复杂度的增加,计算负担也随之上升。
对于较小的研究机构和公司来说,成本尤为棘手,它们可能无力从零训练大型模型,从而让大公司在该领域的研究中占据主导。依我之见,预训练开源模型的可用性将在一定程度上缓解这一问题。
环境影响
与成本密切相关的是,这类模型的环境影响日益引发关注。训练大型 AI 模型会消耗大量能源,导致较高的碳足迹。
随着 AI 的普及和越来越大的模型被预训练,可持续性方面的担忧也在加剧。人们正通过更高效的算法与硬件、以及在数据中心采用可再生能源来降低能耗,但这一问题仍至关重要。
偏见与公平
基础模型同样无法避免偏见风险。与许多深度学习算法一样,这一风险源于其训练所用的大量现实世界数据。模型难免会继承数据中存在的偏见,从而在敏感应用中导致不公平结果或歧视。
缓解偏见至关重要,可通过实施公平性算法、丰富训练数据多样性,并定期审计模型,确保其不会延续有害偏见等策略来实现。
监管问题
最后,围绕基础模型使用的监管问题日益凸显。随着这些模型变得更强大并广泛部署于各行各业,各国政府与国际机构正致力于建立 AI 安全与问责框架。
确保遵循全球标准(如欧盟《人工智能法案》)将对管控 AI 部署相关风险至关重要,包括隐私问题与虚假信息。您可通过 DataCamp 的欧盟 AI 法案基础技能路径快速了解相关法规。
基础模型的未来趋势
基础模型最突出的趋势之一是多模态能力的演进。这些模型正日益被设计为在统一框架中处理并融合多种类型的数据。
这种多模态方法让 AI 系统更好地理解并与世界互动,甚至有人声称其方式与人类认知相似。随着这些能力的成熟,我相信它们将促成更完善的应用。
另一令人兴奋的趋势是实时适应性的前景。当前的基础模型需要大量预训练与微调才能适配特定任务。然而,未来模型有望更加动态,能够在遇到新数据或新环境时实时学习并适应。
这种可能性将使 AI 系统更有效地应对变化的条件,例如不断演变的用户偏好或数据中新出现的趋势。
最后,让模型更轻量、更易用的创新同样是降低能耗与成本、并实现基础 AI 技术普惠化的必要条件。
相关研究正致力于在不牺牲性能的前提下,降低这些模型的体量与资源需求。研究者正探索模型蒸馏、量化以及高效架构设计等技术,以打造更小、更快、更节能的模型。
此外,轻量化模型将支持在边缘设备(如智能手机与物联网设备)上部署,把 AI 能力更贴近终端用户的真实场景。
结语
我希望此时我们已经可以回答引言中的问题:“是什么让一个基础模型称为‘基础’?”
当一个模型具备通用性,能够在多样任务上实现泛化,并可针对更窄的任务进行专门化时,它就是基础模型。基础模型作为底座,支持在各个领域进行微调以开发任务特定模型。但其强大也伴随挑战,包括偏见与伦理问题,以及一些值得探索的新趋势。
如果您对类似内容感兴趣,欢迎查看 DataCamp 的AI 基础技能路径,涵盖与 AI 模型相关的诸多必备知识。


如果让我用一个词来概括全新的 AI 时代,那就是规模。自 2022 年 11 月 OpenAI 推出基于网页的 GPT-3 界面(即 ChatGPT)以来,由于大众的广泛使用,大型语言模型的热度显著攀升。
“规模”不仅体现在这些模型的流行程度上,也体现在其训练所用的海量数据、超高的参数数量,以及它们所能胜任的多样化任务。
在我看来,这类模型的爆发最初让大型语言模型(LLM)成为焦点。两年之后,随着该领域的发展,我认为更流行的术语已经转向基础模型。
但什么是基础模型?又是什么让一个模型称为“基础”?
与 LLM 不同,基础模型在社区中已存在多年。本文将探讨 基础模型的概念,重点关注其关键特征、应用以及在 AI 时代的未来。
什么是基础模型?
取一种 AI 架构,例如Transformer,并用海量多样的数据进行训练:来自 Common Crawl 和书籍的文本、图像、YouTube 视频等。
由于这些数据广泛、通用且多模态,最终得到的模型会成为一个具备广博知识的大型通用系统。这就是基础模型:一种多才多用的通用模型,作为构建专业化 AI 应用的“基础”。
这些基础模型可以通过微调、提示(prompting)或其他迁移学习技术来适配特定任务。理念在于,一旦在某一领域进行专门化,模型仍将保留底座模型强大的泛化能力和涌现能力。
历史发展
早期的 AI 系统大多基于规则,且高度依赖特定领域,因此需要为每个任务编写专用程序。2000 年代初,机器学习兴起,标志着向数据驱动方法的转变,尽管当时仍局限于特定任务。
深度学习的突破大约在 2012 年到来,使更复杂的模式识别和先进的生成模型成为可能,两个重要里程碑是:2014 年的生成对抗网络和2017 年的 Transformer。
AI 的发展在很大程度上得益于计算能力(如GPU、TPU)的进步以及海量数据集的可用性,这些都推动了越来越大型模型的训练,进而催生了基础模型。
传统 AI 系统与基础模型之间的差异,也体现在其规模上。例如,传统 AI 系统通常在精心整理的小型数据集上训练,而基础模型使用海量、多样且往往非结构化的数据。此外,基础模型具备很强的泛化能力,能够处理更复杂、更广泛的任务;而传统 AI 系统在应对新任务时通常需要重新训练或进行大量改造。
基础模型的关键特征
有一些特征使基础模型独具一格:
泛化能力
泛化指模型在未见过的任务上表现良好的能力,或者更具体地说,在训练集之外的数据上表现良好的能力。基础模型之所以有价值,很大程度上源于这一特性。与此密切相关的是,这些模型还可能展现出在训练时未计划、但在大规模下自然出现的意外能力,即所谓的涌现行为。
虽然泛化是模型训练的预期结果,但涌现能力往往难以预测,因为模型并未为这些用途进行明确训练。
此外,这些模型具有可扩展性,即通过增大模型规模(连同数据量和算力资源)即可提升性能。尽管更大的模型往往更善于泛化,但仅靠增大规模并不能保证泛化能力一定提升。不过,涌现行为与模型规模高度相关。
多模态
多模态是指 AI 模型处理并融合多种类型数据(如文本、图像、视频等)的能力。基础模型可以是多模态的,但这并非必需条件。
多模态的一个关键方面是跨模态理解,即模型能够理解并关联不同类型数据中的信息。例如,结合文本与图像为图片生成字幕,或回答有关视觉内容的问题。多模态带来更丰富的交互,并为需要文本、视觉与音频协同工作的应用打开大门,如机器人或医疗系统。
若想更深入了解多模态,欢迎阅读我们的文章 什么是多模态 AI?
适应性
最后,基础模型的另一关键点在于, 它们可作为面向特定领域模型的底座。因此,我们可以基于较小的、特定领域的数据集,通过调整其权重来适配具体任务或领域,同时受益于其多模态、泛化能力等特性。这一过程称为微调,您可在我们的LLM 微调指南中进一步了解。
常见的微调技术包括:
基础模型 vs 大型语言模型
大型语言模型是基础模型的一个特化类型,其训练数据完全或主要为文本。LLM 还可以进一步针对具体任务进行微调,如机器翻译或摘要生成。
下表有助于突出这两类模型的差异与共性:
方面
基础模型
大型语言模型
范围
通用模型,通常在多模态数据上训练。
基础模型的子集,仅在文本数据上训练,有时会针对特定任务进行微调。
训练数据
多样(且通常为多模态)的数据集。
以文本语料为主。
架构*
多种架构:Transformer、卷积神经网络(CNN),或依据数据类型的混合架构。
通常为基于 Transformer 的架构。
用例
多模态通用任务。
聚焦语言任务:翻译、摘要、聊天机器人、代码生成等。
当下在社会各界广受欢迎。可在我们的指南中找到最流行的开源模型。
* 我们将在下一节对基础模型的架构做进一步阐述。
从更实际的例子来看,最初 ChatGPT 网页界面所用的 GPT 模型是 GPT-3。它是纯文本的大型语言模型,用户只能通过提示与之交互。由于 LLM 属于基础模型的子集,GPT-3 也属于基础模型。
如今,当我们进入 ChatGPT 界面时,可以看到在提示旁边可以附加图像。这是因为现在界面背后的模型是 GPT-4。GPT-4 则是一种多模态的基础模型。
ChatGPT 多模态界面的截图。
基础模型的架构
由于我们最早接触到的大型模型多为 LLM,大家往往认为基础模型背后只有 Transformer 架构。
然而,在 Transformer 流行之前,循环神经网络(RNN)曾是文本类基础模型的主流架构。
在图像生成领域,扩散模型如今已成为这些最前沿系统的中坚。知名模型包括 Stable Diffusion 与 DALL-E,但在它们之前,卷积神经网络(CNN) 就已被广泛采用!
扩散模型之所以被视为图像生成的基础模型,原因与前文相同:它们能够生成高质量、多样化的图像,并可针对图像编辑、修复(inpainting)等特定任务进行微调。
基础模型的应用
凭借通用性与适应性,基础模型被广泛用于各类领域,其中包括:
1. 自然语言处理
如前所述,基础模型在自然语言处理方面取得了长足进步。像 ChatGPT 这样的模型所展现的类人能力,使其在客户服务应用中不可或缺。如今的在线对话代理多半基于 LLM,相较早期依赖规则系统的聊天机器人,能够进行更自然、连贯的交流。
这些模型也驱动着机器翻译应用,如Google 翻译与DeepL。如今使用这些工具,您会发现它们比十年前更为准确,也更具上下文意识。
如果您对自然语言应用感兴趣,课程“开发 AI 应用”将助您一臂之力!
2. 计算机视觉
例如 CLIP 和 DALL-E等模型结合了文本与图像理解,使图像字幕生成与 文生图等应用成为可能,而这些在此前的架构中尚不可行。
在工具方面,Adobe Photoshop已将扩散模型引入其编辑工具,例如内容识别填充等 AI 功能,用于自动补全与修复图像。
3. 跨领域应用
最后,还有一些多模态应用,能够同时处理并融合来自多个领域的数据。例如在自动驾驶系统中,特斯拉 和 Waymo(谷歌的自动驾驶项目)使用多模态系统,将来自摄像头的视觉数据、雷达信号与激光雷达传感器数据,与文本与上下文信息相结合,以进行环境感知与导航。
这些跨领域应用正在重塑行业,使系统更加灵活、可适应且智能,而此前受限于更窄的模型能力。
了解以上应用后,我们可以如图所示对模型进行可视化分类:
将特定领域模型归类为基础模型的子集。多模态应用融合不同类型的数据。- 作者制图
如果您考虑构建由这些模型驱动的应用,文章《5 个可用生成式 AI 模型构建的项目》能给您带来不错的灵感。
基础模型的挑战与伦理考量
如我们所见,基础模型能力更强,但也伴随着若干挑战与伦理问题:
计算成本
训练这些模型在时间与能源方面都极其资源密集型。即便训练完成,这些模型在推理阶段仍需大量资源,尤其在实时应用中,使得规模化部署成本高昂。随着模型规模与复杂度的增加,计算负担也随之上升。
对于较小的研究机构和公司来说,成本尤为棘手,它们可能无力从零训练大型模型,从而让大公司在该领域的研究中占据主导。依我之见,预训练开源模型的可用性将在一定程度上缓解这一问题。
环境影响
与成本密切相关的是,这类模型的环境影响日益引发关注。训练大型 AI 模型会消耗大量能源,导致较高的碳足迹。
随着 AI 的普及和越来越大的模型被预训练,可持续性方面的担忧也在加剧。人们正通过更高效的算法与硬件、以及在数据中心采用可再生能源来降低能耗,但这一问题仍至关重要。
偏见与公平
基础模型同样无法避免偏见风险。与许多深度学习算法一样,这一风险源于其训练所用的大量现实世界数据。模型难免会继承数据中存在的偏见,从而在敏感应用中导致不公平结果或歧视。
缓解偏见至关重要,可通过实施公平性算法、丰富训练数据多样性,并定期审计模型,确保其不会延续有害偏见等策略来实现。
监管问题
最后,围绕基础模型使用的监管问题日益凸显。随着这些模型变得更强大并广泛部署于各行各业,各国政府与国际机构正致力于建立 AI 安全与问责框架。
确保遵循全球标准(如欧盟《人工智能法案》)将对管控 AI 部署相关风险至关重要,包括隐私问题与虚假信息。您可通过 DataCamp 的欧盟 AI 法案基础技能路径快速了解相关法规。
基础模型的未来趋势
基础模型最突出的趋势之一是多模态能力的演进。这些模型正日益被设计为在统一框架中处理并融合多种类型的数据。
这种多模态方法让 AI 系统更好地理解并与世界互动,甚至有人声称其方式与人类认知相似。随着这些能力的成熟,我相信它们将促成更完善的应用。
另一令人兴奋的趋势是实时适应性的前景。当前的基础模型需要大量预训练与微调才能适配特定任务。然而,未来模型有望更加动态,能够在遇到新数据或新环境时实时学习并适应。
这种可能性将使 AI 系统更有效地应对变化的条件,例如不断演变的用户偏好或数据中新出现的趋势。
最后,让模型更轻量、更易用的创新同样是降低能耗与成本、并实现基础 AI 技术普惠化的必要条件。
相关研究正致力于在不牺牲性能的前提下,降低这些模型的体量与资源需求。研究者正探索模型蒸馏、量化以及高效架构设计等技术,以打造更小、更快、更节能的模型。
此外,轻量化模型将支持在边缘设备(如智能手机与物联网设备)上部署,把 AI 能力更贴近终端用户的真实场景。
结语
我希望此时我们已经可以回答引言中的问题:“是什么让一个基础模型称为‘基础’?”
当一个模型具备通用性,能够在多样任务上实现泛化,并可针对更窄的任务进行专门化时,它就是基础模型。基础模型作为底座,支持在各个领域进行微调以开发任务特定模型。但其强大也伴随挑战,包括偏见与伦理问题,以及一些值得探索的新趋势。
如果您对类似内容感兴趣,欢迎查看 DataCamp 的AI 基础技能路径,涵盖与 AI 模型相关的诸多必备知识。