

कोर्स
Large Language Models (LLMs) कॉन्सेप्ट्स
2 घंटा
113.2K
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंयदि मुझे नए AI युग का वर्णन एक शब्द में करना हो, तो वह होगा स्केल. नवंबर 2022 में OpenAI ने GPT-3 के वेब-आधारित इंटरफेस, ChatGPT, को जारी किया, तब से बड़े भाषा मॉडलों की लोकप्रियता आम जनता में व्यापक उपयोग के कारण तेज़ी से बढ़ी है।
स्केल शब्द केवल इन मॉडलों की लोकप्रियता पर ही नहीं, बल्कि उनके प्रशिक्षण में इस्तेमाल होने वाले विशाल डेटा, भारी संख्या में पैरामीटर, और उनके द्वारा किए जा सकने वाले विविध कार्यों पर भी लागू होता है।
मेरी नज़र में, इन मॉडलों के बूम ने शुरुआत में लार्ज लैंग्वेज मॉडल्स (LLMs) को केंद्र में ला दिया। दो साल बाद, इस क्षेत्र में प्रगति के साथ, मुझे लगता है कि लोकप्रिय शब्द फाउंडेशनल मॉडल हो गया है।
लेकिन फाउंडेशनल मॉडल होते क्या हैं? और किस आधार पर कोई मॉडल फाउंडेशनल कहलाता है?
LLMs के विपरीत, फाउंडेशनल मॉडल समुदाय में लंबे समय से मौजूद हैं। इस लेख में, हम फाउंडेशनल मॉडल की अवधारणा का अन्वेषण करेंगे—उनकी प्रमुख विशेषताओं, उपयोगों, और AI युग में भविष्य पर केंद्रित होकर।
एक AI आर्किटेक्चर लीजिए, जैसे कि ट्रांसफॉर्मर, और उसे विविध प्रकार के विशाल डेटा पर प्रशिक्षित करें: Common Crawl और किताबों का पाठ, छवियाँ, YouTube वीडियो, इत्यादि।
क्योंकि यह डेटा व्यापक, सामान्य और मल्टीमॉडल है, परिणामी मॉडल एक बड़ा, सामान्य-उद्देश्य प्रणाली बन जाता है जिसमें व्यापक ज्ञान होता है। यही फाउंडेशनल मॉडल है: एक बहुमुखी, सामान्य-उद्देश्य मॉडल जो विशेषीकृत AI अनुप्रयोगों का “आधार” बनता है।
इन फाउंडेशन मॉडलों को फाइन-ट्यूनिंग, प्रॉम्प्टिंग, या अन्य ट्रांसफर-लर्निंग तकनीकों से विशिष्ट कार्यों के लिए अनुकूलित किया जा सकता है। विचार यह है कि एक विशेष डोमेन में विशेषज्ञ बनने के बाद भी, मॉडल बेस मॉडल की मजबूत जनरलाइज़ेशन क्षमता और उभरती क्षमताएँ बनाए रखेगा।
प्रारंभिक AI सिस्टम ज्यादातर नियम-आधारित और अत्यंत डोमेन-विशिष्ट थे, इसलिए कार्य-विशिष्ट प्रोग्रामिंग की आवश्यकता होती थी। 2000 के शुरुआती वर्षों में मशीन लर्निंग का उदय हुआ, जिसने डेटा-चालित दृष्टिकोणों की ओर बदलाव लाया, हालांकि यह तब भी विशिष्ट कार्यों तक सीमित था।
डीप लर्निंग में सफलता लगभग 2012 के आसपास आई, जिसने अधिक जटिल पैटर्न पहचान और उन्नत जेनरेटिव मॉडलों को सक्षम किया, दो बड़े माइलस्टोन के साथ: 2014 में जनरेटिव एडवर्सेरियल नेटवर्क और 2017 में ट्रांसफॉर्मर्स।
AI की वृद्धि को कंप्यूटिंग शक्ति (जैसे GPUs, TPUs) और विशाल डेटासेट की उपलब्धता ने बहुत सहारा दिया है, जिनकी बदौलत लगातार बड़े मॉडलों का प्रशिक्षण संभव हुआ और फाउंडेशनल मॉडलों का उदय हुआ।
पारंपरिक AI सिस्टम और फाउंडेशनल मॉडलों में अंतर उनके स्केल से भी परिभाषित होता है। क्यूरेटेड डेटासेट पर प्रशिक्षण से हटकर, फाउंडेशनल मॉडलों में विशाल, विविध और अक्सर असंरचित डेटा का उपयोग इस बदलाव का उदाहरण है। साथ ही, फाउंडेशनल मॉडल मजबूत जनरलाइज़ेशन क्षमता दिखाते हैं, जिससे वे अधिक जटिल और विविध कार्यों को संभाल सकते हैं, जबकि पारंपरिक AI सिस्टम को नए कार्यों के लिए आमतौर पर फिर से प्रशिक्षण या बड़े बदलावों की ज़रूरत पड़ती है।
कुछ खास गुण फाउंडेशनल मॉडलों को विशिष्ट बनाते हैं:
जनरलाइज़ेशन से तात्पर्य मॉडल की उस क्षमता से है कि वह अनदेखे कार्यों पर, या ठोस रूप से कहें तो, अपने प्रशिक्षण सेट से परे डेटा पर अच्छा प्रदर्शन करे। फाउंडेशनल मॉडल इसी गुण के कारण विशेष रूप से मूल्यवान हैं। इससे जुड़ा एक और पहलू यह है कि ये मॉडल कभी-कभी प्रशिक्षण में नियोजित न की गई, पर स्केल पर उभरने वाली अप्रत्याशित क्षमताएँ दिखा सकते हैं, जिसे एमर्जेंट बिहेवियर कहा जाता है।
जहाँ जनरलाइज़ेशन मॉडल प्रशिक्षण का अपेक्षित परिणाम है, वहीं उभरती क्षमताएँ अक्सर अप्रत्याशित होती हैं, क्योंकि मॉडलों को स्पष्ट रूप से उन उद्देश्यों के लिए प्रशिक्षित नहीं किया जाता।
साथ ही, ये मॉडल स्केलेबल होते हैं, यानी उनके प्रदर्शन को मॉडल का आकार (डेटा और कंप्यूट संसाधनों के साथ) बढ़ाकर सुधारा जा सकता है। बड़े मॉडल सामान्यतः बेहतर जनरलाइज़ करते हैं, लेकिन सिर्फ आकार बढ़ा देने से बेहतर जनरलाइज़ेशन की गारंटी नहीं होती। हालांकि, उभरते व्यवहार का मॉडल आकार से गहरा संबंध है।
मल्टीमॉडैलिटी का मतलब है कि AI मॉडल कई प्रकार के डेटा—जैसे पाठ, छवियाँ, वीडियो, इत्यादि—को प्रोसेस और एकीकृत कर सके। फाउंडेशनल मॉडल मल्टीमॉडल हो सकते हैं, लेकिन यह अनिवार्य नहीं है।
मल्टीमॉडैलिटी का एक प्रमुख पहलू है क्रॉस-मोडल समझ, जहाँ मॉडल विभिन्न प्रकार के डेटा के बीच जानकारी को समझ और जोड़ सके। उदाहरण के लिए, पाठ और छवियों को मिलाकर तस्वीरों के लिए कैप्शन बनाना या दृश्य सामग्री पर प्रश्नों के उत्तर देना। मल्टीमॉडैलिटी अधिक समृद्ध इंटरैक्शन सक्षम करती है और उन अनुप्रयोगों के लिए मार्ग खोलती है जहाँ पाठ, विज़न और ऑडियो को साथ काम करना होता है, जैसे रोबोटिक्स या हेल्थकेयर सिस्टम।
मल्टीमॉडैलिटी की विस्तृत व्याख्या के लिए हमारा लेख What is Multimodal AI? पढ़ें।
अंत में, फाउंडेशनल मॉडलों का एक और प्रमुख पहलू यह है कि वे डोमेन-विशिष्ट मॉडलों के आधार के रूप में काम कर सकते हैं। अतः, हम उन्हें छोटे, डोमेन-विशिष्ट डेटासेट पर उनके वज़न समायोजित करके विशिष्ट कार्यों या डोमेनों के लिए अनुकूलित कर सकते हैं, साथ ही उनकी मल्टीमॉडैलिटी, जनरलाइज़ेशन क्षमता और अन्य गुणों का लाभ उठाते हुए। इस प्रक्रिया को फाइन-ट्यूनिंग कहते हैं, जिसके बारे में आप हमारे LLMs फाइन-ट्यूनिंग गाइड में और जान सकते हैं।
कुछ फाइन-ट्यूनिंग तकनीकों में शामिल हैं:
लार्ज लैंग्वेज मॉडल फाउंडेशनल मॉडलों का एक विशेष प्रकार हैं जो केवल या मुख्यतः पाठ्य डेटा पर प्रशिक्षित होते हैं। किसी LLM को आगे विशेष कार्यों, जैसे भाषा अनुवाद या संक्षेपण, के लिए फाइन-ट्यून किया जा सकता है।
निम्न तालिका दोनों श्रेणियों के बीच अंतरों और समानताओं को उजागर करने में मदद कर सकती है:
|
पहलू |
फाउंडेशनल मॉडल |
लार्ज लैंग्वेज मॉडल |
|
परिधि |
सामान्य-उद्देश्य मॉडल जो आम तौर पर मल्टीमॉडल डेटा पर प्रशिक्षित होते हैं। |
फाउंडेशनल मॉडलों का उपसमुच्चय, जो केवल पाठ डेटा पर प्रशिक्षित होते हैं, और कभी-कभी किसी विशिष्ट कार्य के लिए फाइन-ट्यून किए जाते हैं। |
|
प्रशिक्षण डेटा |
विविध (और सामान्यतः मल्टीमॉडल) डेटासेट। |
मुख्यतः टेक्स्ट कॉर्पोरा। |
|
आर्किटेक्चर* |
एकाधिक आर्किटेक्चर: ट्रांसफॉर्मर्स, कॉन्वोल्यूशनल न्यूरल नेटवर्क्स (CNNs), या डेटा प्रकार के अनुसार हाइब्रिड आर्किटेक्चर। |
आमतौर पर ट्रांसफॉर्मर-आधारित आर्किटेक्चर। |
|
उपयोग के मामले |
मल्टीमॉडल सामान्य कार्य। |
भाषा-केंद्रित कार्य: अनुवाद, संक्षेपण, चैटबॉट, कोड जनरेशन, आदि। आजकल समाज में अत्यधिक लोकप्रिय। हमारे गाइड में सबसे लोकप्रिय ओपन-सोर्स मॉडल देखें। |
* अगला खंड फाउंडेशनल मॉडलों के आर्किटेक्चर पर थोड़ी और रोशनी डालेगा।
यदि हम एक व्यावहारिक उदाहरण सोचें, तो ChatGPT वेब इंटरफेस में इस्तेमाल किया गया पहला GPT मॉडल GPT-3 था। यह पूर्णतः पाठ-आधारित लार्ज लैंग्वेज मॉडल था, और उपयोगकर्ता केवल प्रॉम्प्टिंग के माध्यम से इससे बातचीत कर सकते थे। क्योंकि LLMs फाउंडेशनल मॉडलों का उपसमुच्चय हैं, GPT-3 भी एक फाउंडेशनल मॉडल था।
आजकल, जब हम ChatGPT इंटरफेस में प्रवेश करते हैं, तो दिखता है कि हम प्रॉम्प्ट के साथ छवियाँ भी संलग्न कर सकते हैं। ऐसा इसलिए है क्योंकि अब इंटरफेस के पीछे GPT-4 मॉडल है। GPT-4 एक मल्टीमॉडल फाउंडेशनल मॉडल है।
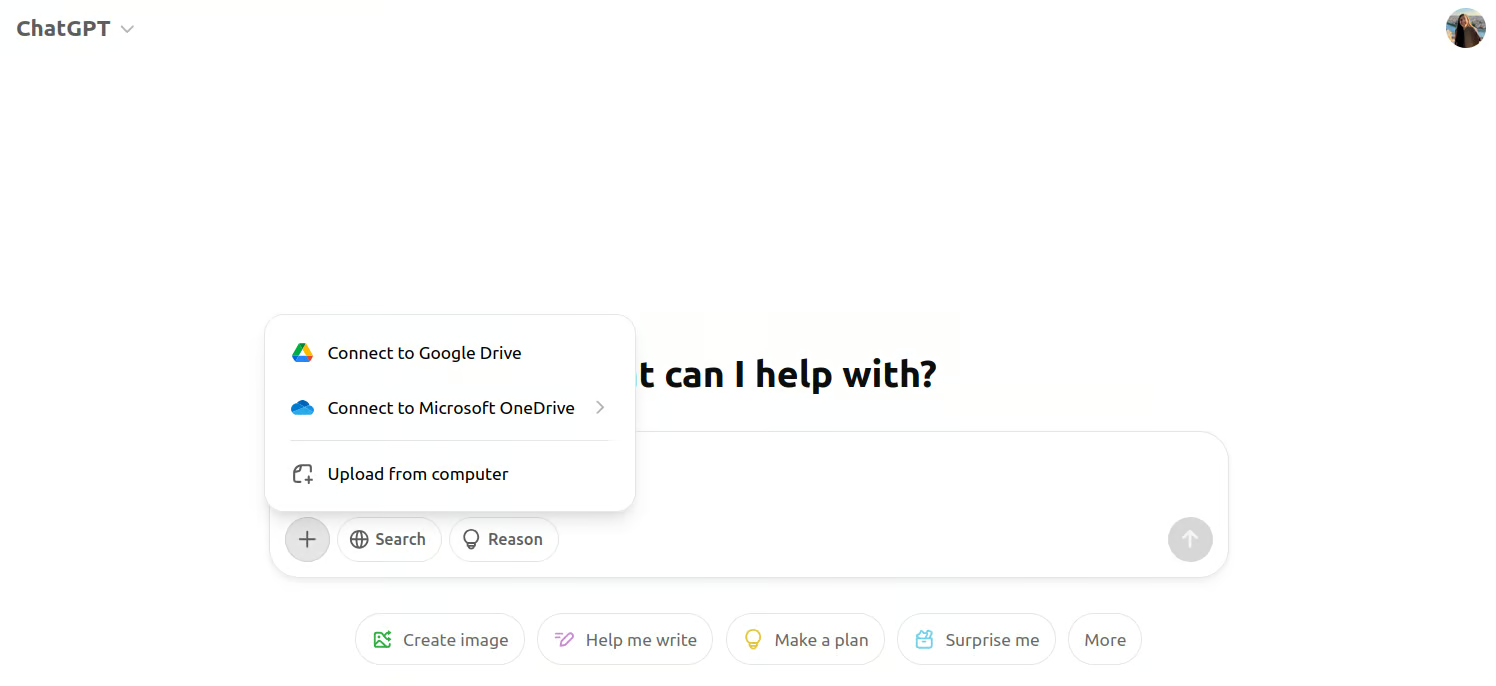
ChatGPT के मल्टीमॉडल इंटरफेस का स्क्रीनशॉट।
क्योंकि इन बड़े मॉडलों से हमारा पहला परिचय LLMs के ज़रिए हुआ, लोग अक्सर मान लेते हैं कि फाउंडेशनल मॉडलों के पीछे केवल ट्रांसफॉर्मर आर्किटेक्चर ही है।
हालाँकि, रिकरेंट न्यूरल नेटवर्क्स (RNNs) ट्रांसफॉर्मर्स के लोकप्रिय होने से पहले, पाठ-आधारित फाउंडेशनल मॉडलों के लिए प्राथमिक आर्किटेक्चर थे।
छवि जनरेशन के क्षेत्र में, डिफ्यूज़न मॉडल अब अत्याधुनिक प्रणालियों की रीढ़ हैं। कुछ प्रसिद्ध मॉडल Stable Diffusion और DALL-E हैं, लेकिन कॉन्वोल्यूशनल न्यूरल नेटवर्क्स (CNNs) उनसे पहले इस्तेमाल होते थे!
डिफ्यूज़न मॉडल छवि जनरेशन के लिए फाउंडेशनल माने जाते हैं, उन्हीं कारणों से जिनका ऊपर उल्लेख हुआ: वे उच्च-गुणवत्ता और विविध छवियाँ बना सकते हैं और इमेज एडिटिंग या इनपेंटिंग जैसे विशेष कार्यों के लिए फाइन-ट्यून किए जा सकते हैं।
फाउंडेशनल मॉडल अपनी बहुमुखी प्रतिभा और अनुकूलनशीलता के कारण विभिन्न क्षेत्रों में उपयोग होते हैं, जिनमें से कुछ हैं:
जैसा कि पहले चर्चा हुई, फाउंडेशनल मॉडलों ने प्राकृतिक भाषा प्रक्रमण में उल्लेखनीय प्रगति की है। ChatGPT जैसे मॉडलों की मानवीय-सी क्षमताओं ने इन्हें ग्राहक सेवा अनुप्रयोगों, उदाहरण के तौर पर, अपरिहार्य बना दिया है। आजकल के ऑनलाइन संवाद एजेंट लगभग सभी LLM-आधारित हैं, जो पुराने नियम-आधारित चैटबॉट्स की तुलना में अधिक स्वाभाविक और सुसंगत बातचीत कर सकते हैं।
ये मॉडल भाषा अनुवाद जैसे Google Translate और DeepL जैसे अनुप्रयोगों को भी शक्ति देते हैं। यदि आप आज ये टूल्स उपयोग करें, तो पाएँगे कि ये दस साल पहले की तुलना में अधिक सटीक और संदर्भ-सचेत हो गए हैं।
यदि आप नैचुरल लैंग्वेज अनुप्रयोगों में रुचि रखते हैं, तो कोर्स “Developing AI Applications” आपको बढ़त दिलाएगा!
CLIP और DALL-E जैसे मॉडल, उदाहरण के लिए, पाठ और छवि समझ को संयोजित करते हैं, जिससे इमेज कैप्शनिंग और टेक्स्ट-टू-इमेज जनरेशन जैसे अनुप्रयोग संभव हुए हैं, जो पहले की आर्किटेक्चरों से संभव न थे।
टूल्स में, Adobe Photoshop ने अपने संपादन टूल्स में डिफ्यूज़न मॉडलों को शामिल किया है, जैसे Content-Aware Fill और अन्य AI-चालित सुविधाएँ, जो स्वचालित इमेज कंप्लीशन और इनपेंटिंग के लिए हैं।
अंततः, कुछ मल्टीमॉडल अनुप्रयोग भी हैं जो एक साथ कई डोमेनों से डेटा को प्रोसेस और एकीकृत कर सकते हैं। उदाहरण के लिए, स्वायत्त प्रणालियों में, Tesla और Waymo—Google की स्वायत्त वाहन परियोजना—कैमरों से दृश्य डेटा, रडार सिग्नल और LiDAR सेंसर को पाठ्य और प्रासंगिक जानकारी के साथ संयोजित करने वाली मल्टीमॉडल प्रणालियों का उपयोग करते हैं ताकि परिवेश को समझकर नेविगेट कर सकें।
ये क्रॉस-डोमेन अनुप्रयोग उद्योगों को बदल रहे हैं, अधिक गतिशील, अनुकूलनशील और बुद्धिमान प्रणालियाँ सक्षम कर रहे हैं जो पहले संकीर्ण मॉडलों तक सीमित थीं।
इन अनुप्रयोगों को देखने के बाद, हम नीचे दी गई छवि की तरह मॉडलों को दृश्य रूप से वर्गीकृत कर सकते हैं:
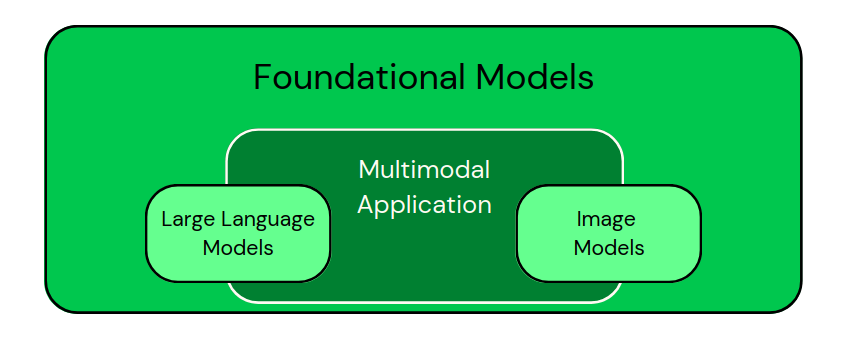
फाउंडेशनल मॉडलों के उपसमुच्चय के रूप में डोमेन-विशिष्ट मॉडलों का वर्गीकरण। मल्टीमॉडल अनुप्रयोग भिन्न-भिन्न प्रकार के डेटा को संयोजित करते हैं। - लेखक द्वारा छवि
यदि आप इन मॉडलों द्वारा संचालित अनुप्रयोग बनाना चाहते हैं, तो लेख “5 Projects You Can Build with Generative AI Models” आपको बेहतरीन विचार देगा।
जैसा कि हमने देखा, फाउंडेशनल मॉडलों की क्षमताएँ अधिक हैं, लेकिन हमें यह भी समझना चाहिए कि इनके साथ कई चुनौतियाँ और नैतिक विचार आते हैं:
इन मॉडलों को प्रशिक्षित करना समय और ऊर्जा के लिहाज़ से अत्यंत संसाधन-गहन है। प्रशिक्षण के बाद भी, विशेषकर रीयल-टाइम अनुप्रयोगों में, इन्फरेंस के लिए पर्याप्त संसाधनों की आवश्यकता रहती है, जिससे बड़े पैमाने पर संचालन महँगा हो जाता है। जैसे-जैसे मॉडल बड़े और अधिक जटिल होते हैं, कम्प्यूटेशनल बोझ भी बढ़ता है।
यह लागत छोटे शोध संस्थानों और कंपनियों के लिए विशेष रूप से चुनौतीपूर्ण है, जिनके पास शून्य से बड़े मॉडलों को प्रशिक्षित करने के वित्तीय साधन नहीं होते, जिससे बड़ी कंपनियाँ इस क्षेत्र के शोध पर हावी हो सकती हैं। मेरी राय में, प्री-ट्रेंड ओपन-सोर्स मॉडलों की उपलब्धता दोनों तरह से मदद करेगी।
लागत से निकटता से जुड़ा हुआ है इन मॉडलों का पर्यावरणीय प्रभाव, जो बढ़ती चिंता का विषय है। बड़े AI मॉडलों का प्रशिक्षण अत्यधिक ऊर्जा खपत करता है, जिससे उच्च कार्बन फुटप्रिंट बनता है।
AI के बढ़ते उपयोग और लगातार बड़े मॉडलों की प्री-ट्रेनिंग से स्थिरता को लेकर चिंताएँ बढ़ रही हैं। अधिक कुशल एल्गोरिदम और हार्डवेयर के माध्यम से ऊर्जा खपत घटाने, और डाटा सेंटर्स में नवीकरणीय ऊर्जा अपनाने के प्रयास हो रहे हैं, फिर भी मुद्दा गंभीर बना हुआ है।
फाउंडेशनल मॉडल पक्षपात के जोखिम से मुक्त नहीं हैं। कई डीप लर्निंग एल्गोरिद्म की तरह, यह जोखिम उस विशाल वास्तविक-विश्व डेटा से आता है जिस पर इन्हें प्रशिक्षित किया जाता है। मॉडल अनिवार्य रूप से डेटा में मौजूद पक्षपात को विरासत में ले लेते हैं, जो संवेदनशील अनुप्रयोगों में अन्यायपूर्ण परिणाम या भेदभाव का कारण बन सकता है।
पक्षपात को कम करना आवश्यक है, और यह निष्पक्षता एल्गोरिद्म लागू करने, प्रशिक्षण डेटासेट में विविधता लाने, और यह सुनिश्चित करने के लिए मॉडलों का नियमित ऑडिट करने जैसी रणनीतियों से संभव है कि वे हानिकारक पक्षपात को आगे न बढ़ाएँ।
अंततः, फाउंडेशनल मॉडलों के उपयोग को लेकर नियामक चिंताएँ अधिक स्पष्ट हो रही हैं। जैसे-जैसे ये मॉडल अधिक शक्तिशाली होते जा रहे हैं और विभिन्न उद्योगों में उपयोग हो रहे हैं, सरकारें और अंतरराष्ट्रीय संस्थाएँ AI सुरक्षा और जवाबदेही के लिए रूपरेखाएँ स्थापित करने पर काम कर रही हैं।
EU के AI अधिनियम जैसे वैश्विक मानकों का अनुपालन सुनिश्चित करना AI परिनियोजन से जुड़े जोखिमों—जिसमें गोपनीयता मुद्दे और ग़लत जानकारी शामिल हैं—का प्रबंधन करने के लिए महत्वपूर्ण होगा। ऐसी विनियमों से अवगत होने के लिए DataCamp का EU AI Act Fundamentals स्किल ट्रैक देखें।
फाउंडेशनल मॉडलों की सबसे प्रमुख प्रवृत्तियों में से एक है मल्टीमॉडल क्षमताओं का विकास। ये मॉडल बढ़ते हुए इस तरह से डिज़ाइन किए जा रहे हैं कि वे विविध प्रकार के डेटा को एकीकृत ढाँचे में प्रोसेस और संयोजित कर सकें।
यह मल्टीमॉडल दृष्टिकोण AI प्रणालियों को दुनिया को बेहतर समझने और उससे बेहतर इंटरैक्ट करने देता है—कुछ लोग तो कहते हैं कि यह मानवीय अनुभूति का अनुकरण भी करता है। जैसे-जैसे ये क्षमताएँ परिपक्व होंगी, मुझे यक़ीन है कि वे अधिक समग्र अनुप्रयोगों को सक्षम करेंगी।
एक और रोमांचक प्रवृत्ति है रीयल-टाइम अनुकूलनशीलता की संभावना। वर्तमान फाउंडेशनल मॉडल्स को विशिष्ट कार्यों के लिए अनुकूल होने में व्यापक प्री-ट्रेनिंग और फाइन-ट्यूनिंग की आवश्यकता होती है। हालाँकि, भविष्य के मॉडल अधिक गतिशील होने की उम्मीद है, जो नए डेटा या परिवेश मिलने पर रीयल-टाइम में सीखने और अनुकूलन में सक्षम होंगे।
यह संभावना AI प्रणालियों को बदलती परिस्थितियों—जैसे उपयोगकर्ता वरीयताओं में बदलाव या डेटा में उभरते रुझान—का अधिक प्रभावी ढंग से जवाब देने में सक्षम बनाएगी।
अंत में, मॉडलों को अधिक हल्का और सुलभ बनाना भी ऊर्जा खपत और लागत घटाने, तथा फाउंडेशनल AI तकनीकों के उपयोग का लोकतंत्रीकरण करने के लिए आवश्यक है।
चल रहे शोध का उद्देश्य मॉडलों के आकार और संसाधन आवश्यकताओं को उनके प्रदर्शन से समझौता किए बिना कम करना है। मॉडल डिस्टिलेशन, क्वांटाइज़ेशन, और कुशल आर्किटेक्चर डिज़ाइन जैसी तकनीकों का उपयोग कर छोटे, तेज़ और अधिक ऊर्जा-कुशल मॉडल बनाए जा रहे हैं।
इसके अलावा, हल्के मॉडल्स स्मार्टफोन्स और IoT डिवाइसेज़ जैसे एज डिवाइसेज़ पर परिनियोजन सक्षम करेंगे, जिससे वास्तविक दुनिया के अनुप्रयोगों में AI क्षमताएँ अंतिम-उपयोगकर्ताओं के और नज़दीक आएँगी।
मैं यह सुनिश्चित करना चाहूँगा कि इस बिंदु पर, हम प्रस्तावना में पूछे गए प्रश्न का उत्तर दे सकें: “किस आधार पर कोई मॉडल फाउंडेशनल कहलाता है?”
कोई मॉडल तब फाउंडेशनल होता है जब वह सामान्य-उद्देश्य का हो, विविध कार्यों में जनरलाइज़ करने में सक्षम हो, और विभिन्न संकरे कार्यों के लिए विशेषीकृत किया जा सके। फाउंडेशनल मॉडल विभिन्न डोमेनों में फाइन-ट्यूनिंग के लिए आधार बनकर टास्क-विशिष्ट मॉडलों के विकास को सक्षम करते हैं। हालाँकि, उनकी शक्ति के साथ चुनौतियाँ भी आती हैं—जिनमें पक्षपात और नैतिक चिंताएँ शामिल हैं—और कुछ नई भविष्य प्रवृत्तियाँ भी खोजने लायक हैं।
यदि आप ऐसे और कंटेंट में रुचि रखते हैं, तो DataCamp का AI Fundamentals स्किल ट्रैक देखें, जो AI मॉडलों के साथ काम करने के लिए कई आवश्यकताओं को कवर करता है।
टॉप DataCamp कोर्स
कोर्स
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें