Yeni yapay zekâ çağını tek bir kelimeyle tanımlamam gerekseydi, bu ölçek olurdu. OpenAI, Kasım 2022'de GPT-3 için web tabanlı arayüz olan ChatGPT'yi yayımladığından beri, Büyük Dil Modelleri genel kamuoyu tarafından yaygın biçimde kullanılmaları sayesinde büyük ölçüde popülerlik kazandı.
Bu ölçek terimi yalnızca bu modellerin popülerliği için değil, aynı zamanda eğitildikleri muazzam veri miktarları, yüksek parametre sayıları ve gerçekleştirebildikleri çeşitli görevler için de geçerlidir.
Benim açımdan, bu tür modellerdeki patlama başlangıçta Büyük Dil Modellerini (LLM) odağa yerleştirdi. İki yıl sonra, bu alandaki gelişmeler sayesinde popüler terimin temel modeller olarak değiştiğini düşünüyorum.
Peki temel modeller nedir? Bir modeli temel yapan nedir?
LLM'lerin aksine, temel modeller toplulukta uzun zamandır var. Bu yazıda temel modeller kavramını; temel özellikleri, kullanım alanları ve yapay zekâ çağındaki gelecekleri bağlamında inceleyeceğiz.
Temel Modeller Nelerdir?
Bir yapay zekâ mimarisini, örneğin bir transformerı, Common Crawl ve kitaplardan metinler, görseller, YouTube videoları ve daha fazlası gibi çok çeşitli ve büyük miktarda veri üzerinde eğitin.
Bu veriler geniş, genel ve çok kipli (multimodal) olduğundan, ortaya çıkan model kapsamlı bilgiye sahip büyük, genel amaçlı bir sisteme dönüşür. Bu bir temel modeldir: özel yapay zekâ uygulamaları inşa etmek için bir “temel” işlevi gören, çok yönlü, genel amaçlı bir model.
Bu temel modeller ince ayar, yönlendirme (prompting) veya diğer aktarım öğrenmesi teknikleriyle belirli görevlere uyarlanabilir. Fikir şudur: belirli bir alanda uzmanlaştırıldığında, model taban modelin güçlü genelleme özelliklerini ve ortaya çıkan yeteneklerini korur.
Tarihsel gelişim
Erken dönem yapay zekâ sistemleri çoğunlukla kural tabanlı ve alanlarına çok özgüydü; bu da görev özelinde programlama gerektiriyordu. 2000'lerin başı, veri odaklı yaklaşımlara geçişi temsil eden makine öğrenmesinin yükselişiyle anıldı; ancak yine de belirli görevlerle sınırlıydı.
Derin öğrenmedeki atılım 2012 civarında geldi; daha karmaşık örüntü tanıma ve gelişmiş üretken modelleri mümkün kıldı. İki önemli dönüm noktası vardı: 2014'te üretici çekişmeli ağlar (GAN) ve 2017'de transformerlar.
Yapay zekânın büyümesi, hesaplama gücündeki ilerlemeler (örn. GPU'lar, TPU'lar) ve devasa veri kümelerinin erişilebilirliği sayesinde büyük ölçüde desteklendi; bu durum giderek daha büyük modellerin eğitilmesini mümkün kıldı ve temel modellerin ortaya çıkmasına yol açtı.
Geleneksel yapay zekâ sistemleri ile temel modeller arasındaki fark aynı zamanda ölçekle de tanımlanır. Geleneksel sistemlerde seçili veri kümeleri üzerinde eğitimden, temel modellerde devasa, çeşitli ve çoğu zaman yapılandırılmamış verilerin kullanılmasına geçiş bunun bir örneğidir. Ayrıca temel modeller güçlü genelleme yetenekleri sergiler ve daha karmaşık ve çeşitli görevlerin üstesinden gelebilirken, geleneksel sistemler genellikle yeni görevler için yeniden eğitim veya kapsamlı değişiklikler gerektirir.
Temel Modellerin Başlıca Özellikleri
Temel Modelleri benzersiz kılan bazı özel özellikler vardır:
Genelleme yetenekleri
Genelleme, bir modelin görülmemiş görevlerde veya somut olarak eğitim kümesinin ötesindeki verilerde iyi performans gösterme yeteneğini ifade eder. Temel modeller bu özellikleri nedeniyle özellikle değerlidir. Buna yakından bağlı olarak, bu modellerde ölçekte ortaya çıkan ve eğitim sırasında planlanmamış beklenmedik yetenekler de görülebilir; buna ortaya çıkan davranış denir.
Genelleme model eğitiminden beklenen bir sonuçken, ortaya çıkan yetenekler çoğu zaman öngörülemez; zira modeller bu amaçlar için açıkça eğitilmez.
Ayrıca bu modeller ölçeklenebilirdir; yani model boyutunu (veri ve hesaplama kaynaklarıyla birlikte) artırarak performansları iyileştirilebilir. Daha büyük modeller genellemede daha iyi olma eğilimi gösterse de, tek başına model boyutu daha iyi genelleme garantisi vermez. Ancak, ortaya çıkan davranışlar model boyutuyla güçlü biçimde ilişkilidir.
Çok kipli yapı (multimodality)
Çok kipli yapı, bir yapay zekâ modelinin metin, görsel, video ve daha fazlası gibi birden çok türde veriyi işleme ve birleştirme yeteneğini ifade eder. Temel Modeller çok kipli olabilir; ancak bu bir zorunluluk değildir.
Çok kipli yapının kilit yönlerinden biri kipler arası (cross-modal) anlayıştır; modelin farklı veri türlerindeki bilgileri kavrayıp ilişkilendirebilmesidir. Örneğin, metin ve görselleri birleştirerek fotoğraflar için altyazılar üretmek veya görsel içerikle ilgili soruları yanıtlamak. Çok kipli yapı, daha zengin etkileşimleri mümkün kılar ve metin, görme ve sesin birlikte çalışması gereken robotik ya da sağlık sistemleri gibi uygulamalara kapı açar.
Çok kipli yapının daha derinlemesine açıklaması için şu makalemizi okuyabilirsiniz: Multimodal Yapay Zekâ Nedir?
Uyarlanabilirlik
Son olarak, temel modellerin bir diğer önemli yönü, alanlara özgü modeller için bir temel görevini görebilmeleridir. Bu nedenle, ağırlıklarını daha küçük ve alanına özgü bir veri kümesine göre ayarlayarak onları belirli görevlere veya alanlara uyarlayabilir; aynı zamanda çok kipli yapılarından, genelleme yeteneklerinden ve diğer özelliklerinden yararlanabiliriz. Bu sürece ince ayar (fine-tuning) denir; daha fazlasını LLM'lere ince ayar rehberimizde öğrenebilirsiniz.
Bazı ince ayar teknikleri şunlardır:
- Denetimli ince ayar: Model, belirli bir görev için etiketli bir veri kümesi üzerinde eğitilir. Bu, en yaygın ince ayar stratejisidir.
- Aktarım öğrenmesi: Bu durumda fikir, modelin erken katmanlarını (genel bilgiyi yakalayan) sabitlemek ve yalnızca daha geç katmanlara alanına özgü özelliklere odaklanacak şekilde ince ayar yapmaktır.
- Sürekli ön eğitim: Mevcut bir modelin ilk eğitim aşamasından sonra, alanına özgü veriler kullanılarak daha ileri eğitilmesi süreci. Bu teknik genellikle modeli zaman içinde yeni verilerle güncel tutmak için kullanılır.
Temel Modeller ve Büyük Dil Modelleri
Büyük dil modelleri, yalnızca ya da ağırlıklı olarak metin verileri üzerinde eğitilen özel bir temel model türüdür. Bir LLM; dil çevirisi veya özetleme gibi belirli görevler için daha da ince ayar yapılabilir.
Aşağıdaki tablo, her iki model kategorisi arasındaki farkları ve benzerlikleri vurgulamaya yardımcı olabilir:
|
Boyut
|
Genellikle çok kipli veriler üzerinde eğitilen genel amaçlı modeller.
|
Yalnızca metin verileri üzerinde eğitilen ve bazen belirli bir görev için ince ayar yapılan Temel Modellerin bir alt kümesi.
|
|
Eğitim Verisi
|
Çeşitli (ve genellikle çok kipli) veri kümeleri.
|
Ağırlıklı olarak metin derlemeleri.
|
|
Mimari*
|
Birden çok mimari: Transformerlar, Evrişimli Sinir Ağları (CNN) veya veri türüne bağlı hibrit mimariler.
|
Genellikle Transformer tabanlı mimari.
|
|
Kullanım durumları
|
Çok kipli genel görevler.
|
Dile odaklı görevler: çeviri, özetleme, sohbet botu, kod üretimi vb.
Günümüzde toplum genelinde popüler. En popüler açık kaynak modelleri rehberimizde bulabilirsiniz.
|
* Bir sonraki bölümde Temel Modeller için mimariler üzerinde biraz daha duracağız.
Daha pratik bir örnek düşünürsek, ChatGPT web arayüzünde kullanılan ilk GPT modeli GPT-3'tü. Bu, tamamen metinsel bir büyük dil modeliydi ve kullanıcılar yalnızca yönlendirerek (prompt) etkileşim kurabiliyordu. LLM'ler temel modellerin bir alt kümesi olduğundan GPT-3 aynı zamanda bir temel modeldi.
Günümüzde ChatGPT arayüzüne girdiğimizde, yönlendirmeye görseller de ekleyebildiğimizi görüyoruz. Bunun nedeni artık arayüzün arkasında GPT-4'ün bulunması. GPT-4 ise çok kipli bir temel modeldir.
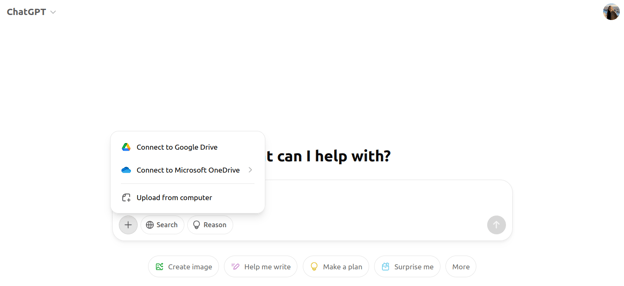
ChatGPT'nin çok kipli arayüzünün ekran görüntüsü.
Temel Modellerin Mimarisi
Bu büyük modellerle ilk etkileşimimiz LLM'ler üzerinden olduğu için, insanlar genellikle temel modellerin arkasındaki tek mimarinin Transformer olduğunu düşünme eğilimindedir.
Oysa Tekrarlayan Sinir Ağları (RNN), Transformerlar popülerlik kazanmadan önce metin tabanlı Temel Modeller için başvurulan mimariydi.
Görsel üretimi alanında ise difüzyon modelleri artık son teknoloji sistemlerin belkemiğidir. Stable Diffusion ve DALL-E gibi iyi bilinen modeller vardır; ancak Evrişimli Sinir Ağları (CNN) bundan önce kullanılıyordu!
Difüzyon modelleri, daha önce tartıştığımız nedenlerle görsel üretimi için temel kabul edilir: yüksek kaliteli, çeşitli görseller üretebilir ve görsel düzenleme veya inpainting gibi belirli görevlere yönelik ince ayar yapılabilir.
Temel Modellerin Uygulamaları
Temel Modeller çok yönlülükleri ve uyarlanabilirlikleri nedeniyle çeşitli alanlarda kullanılır; bunlardan bazıları şunlardır:
1. Doğal dil işleme
Daha önce tartıştığımız gibi, Temel Modeller Doğal Dil İşleme alanında kayda değer gelişmeler sağladı. ChatGPT gibi modellerin insan benzeri yetenekleri, bu modelleri örneğin müşteri hizmetleri uygulamalarında vazgeçilmez kıldı. Artık çevrimiçi sohbet ajanlarının tamamı büyük olasılıkla LLM tabanlı ve önceki kural tabanlı sohbet botlarına kıyasla daha doğal, tutarlı sohbetler yürütebiliyor.
Bu modeller, Google Çeviri ve DeepL gibi dil çevirisi uygulamalarını da besler. Bu araçları şimdi kullanırsanız, on yıl öncesine göre daha doğru ve bağlamsal olarak daha isabetli hâle geldiklerini fark edeceksiniz.
Doğal dil uygulamalarıyla ilgileniyorsanız, “Yapay Zekâ Uygulamaları Geliştirme” kursu size ivme kazandıracaktır!
2. Bilgisayarlı görü
CLIP ve DALL-E gibi modeller, metin ve görsel anlayışını birleştirir; bu da daha önceki mimarilerle mümkün olmayan görsel altyazılama ve metinden görsele üretim gibi uygulamaları mümkün kılar.
Araçlar arasında Adobe Photoshop, İçeriğe Duyarlı Dolgu (Content-Aware Fill) ve otomatik görsel tamamlama ile inpainting gibi diğer yapay zekâ destekli özelliklerine difüzyon modellerini entegre etti.
3. Alanlar arası uygulamalar
Son olarak, aynı anda birden çok alandan gelen verileri işleyip bütünleştirebilen çok kipli uygulamalar da vardır. Örneğin otonom sistemlerde, Tesla ve Waymo - Google'ın otonom araç projesi - kameralarından görsel verileri, radar sinyallerini ve LiDAR sensörlerini metinsel ve bağlamsal bilgilerle birleştiren çok kipli sistemler kullanır; böylece çevreyi anlamlandırıp gezinirler.
Bu alanlar arası uygulamalar, daha dar modellerin sınırladığı endüstrileri dönüştürerek daha dinamik, uyarlanabilir ve akıllı sistemleri mümkün kılıyor.
Bu uygulamaları gördükten sonra, modelleri aşağıdaki görselde olduğu gibi görsel olarak sınıflandırabiliriz:
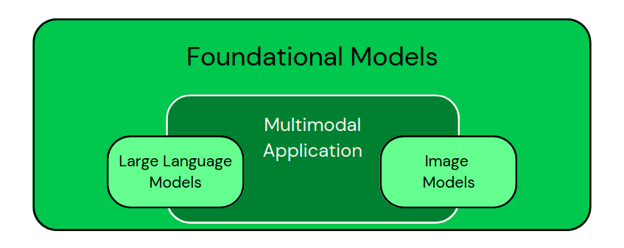
Temel Modellerin alt kümeleri olarak alanlara özgü modellerin sınıflandırılması. Çok kipli uygulamalar farklı veri türlerini birleştirir. - Görsel: Yazar
Bu modellerle desteklenen uygulamalar geliştirmeyi düşünüyorsanız, “Üretken Yapay Zekâ Modelleriyle Geliştirebileceğiniz 5 Proje” makalesi size harika fikirler verecektir.
Temel Modellerin Zorlukları ve Etik Hususlar
Gördüğümüz üzere, temel modeller daha büyük yeteneklere sahip; ancak beraberinde çeşitli zorluklar ve etik hususlar da getirirler:
Hesaplama maliyetleri
Bu modellerin eğitimi, zaman ve enerji açısından son derece kaynak yoğundur. Eğitildikten sonra bile özellikle gerçek zamanlı uygulamalarda çıkarım için ciddi kaynak talep ederler; bu da ölçekli işletmeyi pahalı hâle getirir. Modeller büyüyüp karmaşıklaştıkça hesaplama yükü de artar.
Maliyet, özellikle büyük modelleri sıfırdan eğitmek için mali imkânları yetersiz olabilen daha küçük araştırma kurumları ve şirketler için zorludur; bu da büyük şirketlerin bu alandaki araştırmalara hükmetmesine yol açabilir. Bana göre, önceden eğitilmiş açık kaynak modellerin erişilebilirliği her iki açıdan da yardımcı olacaktır.
Çevresel etki
Maliyetle yakından ilişkili olarak, bu tür modellerin çevresel etkisi büyüyen bir endişe kaynağıdır. Büyük yapay zekâ modellerinin eğitimi ciddi miktarda enerji tüketir ve yüksek karbon ayak izine katkıda bulunur.
Yapay zekânın artan kullanımı ve giderek daha büyük modellerin ön eğitimi, sürdürülebilirlikle ilgili endişeleri yoğunlaştırıyor. Veri merkezlerinde daha verimli algoritmalar ve donanım yoluyla enerji tüketimini azaltmaya ve yenilenebilir enerji kaynaklarını benimsemeye yönelik çabalar sürse de konu kritikliğini koruyor.
Önyargı ve adalet
Temel modeller önyargı riskinden muaf değildir. Birçok derin öğrenme algoritmasında olduğu gibi, bu risk, eğitildikleri büyük miktarda gerçek dünya verisinden kaynaklanır. Modeller, veride bulunan önyargıları kaçınılmaz olarak miras alır; bu da hassas uygulamalarda adaletsiz sonuçlara veya ayrımcılığa yol açabilir.
Önyargıyı azaltmak esastır ve adalet algoritmalarını uygulamak, eğitim veri kümelerini çeşitlendirmek ve modellerin zararlı önyargıları sürdürmediğinden emin olmak için düzenli denetimler yapmak gibi stratejilerle başarılabilir.
Düzenleyici kaygılar
Son olarak, temel modellerin kullanımını çevreleyen düzenleyici kaygılar daha belirgin hâle geliyor. Bu modeller güçlendikçe ve çeşitli sektörlerde devreye alındıkça, hükümetler ve uluslararası kuruluşlar yapay zekâ güvenliği ve hesap verebilirliğine dair çerçeveler oluşturmaya çalışıyor.
AB'nin Yapay Zekâ Yasası gibi küresel standartlara uyumu sağlamak, yapay zekâ dağıtımıyla ilişkili riskleri yönetmek için kritik öneme sahiptir; buna mahremiyet sorunları ve yanlış bilgi de dâhildir. Bu tür düzenlemeler hakkında bilgi sahibi olmak için DataCamp'in AB Yapay Zekâ Yasası Temelleri beceri yolunu inceleyebilirsiniz.
Temel Modellerde Gelecek Trendler
Temel modellerdeki en belirgin trendlerden biri, çok kipli yeteneklerin evrimidir. Bu modeller giderek daha fazla, çeşitli veri türlerini tek bir birleşik çerçevede işleyip bütünleştirecek şekilde tasarlanıyor.
Bu çok kipli yaklaşım, bazılarınca insan bilişini yansıttığı iddia edilen bir biçimde, yapay zekâ sistemlerinin dünyayı daha iyi anlamasına ve etkileşim kurmasına olanak tanır. Bu yetenekler olgunlaştıkça, daha eksiksiz uygulamaları mümkün kılacaklarından eminim.
Bir diğer heyecan verici trend ise gerçek zamanlı uyarlanabilirlik olasılığıdır. Mevcut temel modellerin, belirli görevlere uyum sağlamak için kapsamlı ön eğitim ve ince ayar gereksinimi vardır. Ancak gelecekteki modellerin daha dinamik hâle gelmesi; yeni veri veya ortamlarla karşılaştıkça gerçek zamanlı olarak öğrenip uyum sağlayabilmesi beklenmektedir.
Bu imkân, kullanıcı tercihleri gibi değişen koşullara veya verilerde ortaya çıkan trendlere daha etkili tepkiler vermeyi sağlayacaktır.
Son olarak, modelleri daha hafif ve erişilebilir hâle getirmeye yönelik yenilikler; hem enerji tüketimini ve maliyeti azaltmak hem de temel yapay zekâ teknolojilerinin kullanımını demokratikleştirmek için gereklidir.
Devam eden araştırmalar, performanstan ödün vermeden bu modellerin boyutunu ve kaynak gereksinimlerini azaltmayı hedefliyor. Model damıtma (distillation), niceleme (quantization) ve verimli mimari tasarımı gibi teknikler, daha küçük, daha hızlı ve daha enerji verimli modeller oluşturmak için inceleniyor.
Ayrıca, hafif modeller akıllı telefonlar ve IoT cihazları gibi uç cihazlarda dağıtımı mümkün kılarak, yapay zekâ yeteneklerini gerçek dünya uygulamalarında son kullanıcılara daha da yaklaştıracaktır.
Son Düşünceler
Bu noktada, girişte sorduğumuz şu soruyu ele alabildiğimizden emin olmak isterim: “Bir modeli temel yapan nedir?”.
Bir model, genel amaçlı olduğunda; çeşitli görevler arasında genelleyebildiğinde ve farklı, daha dar görevler için uzmanlaştırılabildiğinde temeldir. Temel modeller, çeşitli alanlarda ince ayara temel teşkil ederek görev özelinde modellerin geliştirilmesini mümkün kılar. Ancak güçleri; önyargı ve etik hususlar dâhil olmak üzere zorluklarla birlikte gelir ve keşfedilecek yeni gelecek trendleri vardır.
Bunun gibi içeriklere ilgi duyuyorsanız, DataCamp'in Yapay Zekâ Temelleri beceri yolunu inceleyebilirsiniz; bu yol, yapay zekâ modelleriyle çalışmak için gereken birçok temel konuyu kapsar.




Yeni yapay zekâ çağını tek bir kelimeyle tanımlamam gerekseydi, bu ölçek olurdu. OpenAI, Kasım 2022'de GPT-3 için web tabanlı arayüz olan ChatGPT'yi yayımladığından beri, Büyük Dil Modelleri genel kamuoyu tarafından yaygın biçimde kullanılmaları sayesinde büyük ölçüde popülerlik kazandı.
Bu ölçek terimi yalnızca bu modellerin popülerliği için değil, aynı zamanda eğitildikleri muazzam veri miktarları, yüksek parametre sayıları ve gerçekleştirebildikleri çeşitli görevler için de geçerlidir.
Benim açımdan, bu tür modellerdeki patlama başlangıçta Büyük Dil Modellerini (LLM) odağa yerleştirdi. İki yıl sonra, bu alandaki gelişmeler sayesinde popüler terimin temel modeller olarak değiştiğini düşünüyorum.
Peki temel modeller nedir? Bir modeli temel yapan nedir?
LLM'lerin aksine, temel modeller toplulukta uzun zamandır var. Bu yazıda temel modeller kavramını; temel özellikleri, kullanım alanları ve yapay zekâ çağındaki gelecekleri bağlamında inceleyeceğiz.
Temel Modeller Nelerdir?
Bir yapay zekâ mimarisini, örneğin bir transformerı, Common Crawl ve kitaplardan metinler, görseller, YouTube videoları ve daha fazlası gibi çok çeşitli ve büyük miktarda veri üzerinde eğitin.
Bu veriler geniş, genel ve çok kipli (multimodal) olduğundan, ortaya çıkan model kapsamlı bilgiye sahip büyük, genel amaçlı bir sisteme dönüşür. Bu bir temel modeldir: özel yapay zekâ uygulamaları inşa etmek için bir “temel” işlevi gören, çok yönlü, genel amaçlı bir model.
Bu temel modeller ince ayar, yönlendirme (prompting) veya diğer aktarım öğrenmesi teknikleriyle belirli görevlere uyarlanabilir. Fikir şudur: belirli bir alanda uzmanlaştırıldığında, model taban modelin güçlü genelleme özelliklerini ve ortaya çıkan yeteneklerini korur.
Tarihsel gelişim
Erken dönem yapay zekâ sistemleri çoğunlukla kural tabanlı ve alanlarına çok özgüydü; bu da görev özelinde programlama gerektiriyordu. 2000'lerin başı, veri odaklı yaklaşımlara geçişi temsil eden makine öğrenmesinin yükselişiyle anıldı; ancak yine de belirli görevlerle sınırlıydı.
Derin öğrenmedeki atılım 2012 civarında geldi; daha karmaşık örüntü tanıma ve gelişmiş üretken modelleri mümkün kıldı. İki önemli dönüm noktası vardı: 2014'te üretici çekişmeli ağlar (GAN) ve 2017'de transformerlar.
Yapay zekânın büyümesi, hesaplama gücündeki ilerlemeler (örn. GPU'lar, TPU'lar) ve devasa veri kümelerinin erişilebilirliği sayesinde büyük ölçüde desteklendi; bu durum giderek daha büyük modellerin eğitilmesini mümkün kıldı ve temel modellerin ortaya çıkmasına yol açtı.
Geleneksel yapay zekâ sistemleri ile temel modeller arasındaki fark aynı zamanda ölçekle de tanımlanır. Geleneksel sistemlerde seçili veri kümeleri üzerinde eğitimden, temel modellerde devasa, çeşitli ve çoğu zaman yapılandırılmamış verilerin kullanılmasına geçiş bunun bir örneğidir. Ayrıca temel modeller güçlü genelleme yetenekleri sergiler ve daha karmaşık ve çeşitli görevlerin üstesinden gelebilirken, geleneksel sistemler genellikle yeni görevler için yeniden eğitim veya kapsamlı değişiklikler gerektirir.
Temel Modellerin Başlıca Özellikleri
Temel Modelleri benzersiz kılan bazı özel özellikler vardır:
Genelleme yetenekleri
Genelleme, bir modelin görülmemiş görevlerde veya somut olarak eğitim kümesinin ötesindeki verilerde iyi performans gösterme yeteneğini ifade eder. Temel modeller bu özellikleri nedeniyle özellikle değerlidir. Buna yakından bağlı olarak, bu modellerde ölçekte ortaya çıkan ve eğitim sırasında planlanmamış beklenmedik yetenekler de görülebilir; buna ortaya çıkan davranış denir.
Genelleme model eğitiminden beklenen bir sonuçken, ortaya çıkan yetenekler çoğu zaman öngörülemez; zira modeller bu amaçlar için açıkça eğitilmez.
Ayrıca bu modeller ölçeklenebilirdir; yani model boyutunu (veri ve hesaplama kaynaklarıyla birlikte) artırarak performansları iyileştirilebilir. Daha büyük modeller genellemede daha iyi olma eğilimi gösterse de, tek başına model boyutu daha iyi genelleme garantisi vermez. Ancak, ortaya çıkan davranışlar model boyutuyla güçlü biçimde ilişkilidir.
Çok kipli yapı (multimodality)
Çok kipli yapı, bir yapay zekâ modelinin metin, görsel, video ve daha fazlası gibi birden çok türde veriyi işleme ve birleştirme yeteneğini ifade eder. Temel Modeller çok kipli olabilir; ancak bu bir zorunluluk değildir.
Çok kipli yapının kilit yönlerinden biri kipler arası (cross-modal) anlayıştır; modelin farklı veri türlerindeki bilgileri kavrayıp ilişkilendirebilmesidir. Örneğin, metin ve görselleri birleştirerek fotoğraflar için altyazılar üretmek veya görsel içerikle ilgili soruları yanıtlamak. Çok kipli yapı, daha zengin etkileşimleri mümkün kılar ve metin, görme ve sesin birlikte çalışması gereken robotik ya da sağlık sistemleri gibi uygulamalara kapı açar.
Çok kipli yapının daha derinlemesine açıklaması için şu makalemizi okuyabilirsiniz: Multimodal Yapay Zekâ Nedir?
Uyarlanabilirlik
Son olarak, temel modellerin bir diğer önemli yönü, alanlara özgü modeller için bir temel görevini görebilmeleridir. Bu nedenle, ağırlıklarını daha küçük ve alanına özgü bir veri kümesine göre ayarlayarak onları belirli görevlere veya alanlara uyarlayabilir; aynı zamanda çok kipli yapılarından, genelleme yeteneklerinden ve diğer özelliklerinden yararlanabiliriz. Bu sürece ince ayar (fine-tuning) denir; daha fazlasını LLM'lere ince ayar rehberimizde öğrenebilirsiniz.
Bazı ince ayar teknikleri şunlardır:
Temel Modeller ve Büyük Dil Modelleri
Büyük dil modelleri, yalnızca ya da ağırlıklı olarak metin verileri üzerinde eğitilen özel bir temel model türüdür. Bir LLM; dil çevirisi veya özetleme gibi belirli görevler için daha da ince ayar yapılabilir.
Aşağıdaki tablo, her iki model kategorisi arasındaki farkları ve benzerlikleri vurgulamaya yardımcı olabilir:
Boyut
Genellikle çok kipli veriler üzerinde eğitilen genel amaçlı modeller.
Yalnızca metin verileri üzerinde eğitilen ve bazen belirli bir görev için ince ayar yapılan Temel Modellerin bir alt kümesi.
Eğitim Verisi
Çeşitli (ve genellikle çok kipli) veri kümeleri.
Ağırlıklı olarak metin derlemeleri.
Mimari*
Birden çok mimari: Transformerlar, Evrişimli Sinir Ağları (CNN) veya veri türüne bağlı hibrit mimariler.
Genellikle Transformer tabanlı mimari.
Kullanım durumları
Çok kipli genel görevler.
Dile odaklı görevler: çeviri, özetleme, sohbet botu, kod üretimi vb.
Günümüzde toplum genelinde popüler. En popüler açık kaynak modelleri rehberimizde bulabilirsiniz.
* Bir sonraki bölümde Temel Modeller için mimariler üzerinde biraz daha duracağız.
Daha pratik bir örnek düşünürsek, ChatGPT web arayüzünde kullanılan ilk GPT modeli GPT-3'tü. Bu, tamamen metinsel bir büyük dil modeliydi ve kullanıcılar yalnızca yönlendirerek (prompt) etkileşim kurabiliyordu. LLM'ler temel modellerin bir alt kümesi olduğundan GPT-3 aynı zamanda bir temel modeldi.
Günümüzde ChatGPT arayüzüne girdiğimizde, yönlendirmeye görseller de ekleyebildiğimizi görüyoruz. Bunun nedeni artık arayüzün arkasında GPT-4'ün bulunması. GPT-4 ise çok kipli bir temel modeldir.
ChatGPT'nin çok kipli arayüzünün ekran görüntüsü.
Temel Modellerin Mimarisi
Bu büyük modellerle ilk etkileşimimiz LLM'ler üzerinden olduğu için, insanlar genellikle temel modellerin arkasındaki tek mimarinin Transformer olduğunu düşünme eğilimindedir.
Oysa Tekrarlayan Sinir Ağları (RNN), Transformerlar popülerlik kazanmadan önce metin tabanlı Temel Modeller için başvurulan mimariydi.
Görsel üretimi alanında ise difüzyon modelleri artık son teknoloji sistemlerin belkemiğidir. Stable Diffusion ve DALL-E gibi iyi bilinen modeller vardır; ancak Evrişimli Sinir Ağları (CNN) bundan önce kullanılıyordu!
Difüzyon modelleri, daha önce tartıştığımız nedenlerle görsel üretimi için temel kabul edilir: yüksek kaliteli, çeşitli görseller üretebilir ve görsel düzenleme veya inpainting gibi belirli görevlere yönelik ince ayar yapılabilir.
Temel Modellerin Uygulamaları
Temel Modeller çok yönlülükleri ve uyarlanabilirlikleri nedeniyle çeşitli alanlarda kullanılır; bunlardan bazıları şunlardır:
1. Doğal dil işleme
Daha önce tartıştığımız gibi, Temel Modeller Doğal Dil İşleme alanında kayda değer gelişmeler sağladı. ChatGPT gibi modellerin insan benzeri yetenekleri, bu modelleri örneğin müşteri hizmetleri uygulamalarında vazgeçilmez kıldı. Artık çevrimiçi sohbet ajanlarının tamamı büyük olasılıkla LLM tabanlı ve önceki kural tabanlı sohbet botlarına kıyasla daha doğal, tutarlı sohbetler yürütebiliyor.
Bu modeller, Google Çeviri ve DeepL gibi dil çevirisi uygulamalarını da besler. Bu araçları şimdi kullanırsanız, on yıl öncesine göre daha doğru ve bağlamsal olarak daha isabetli hâle geldiklerini fark edeceksiniz.
Doğal dil uygulamalarıyla ilgileniyorsanız, “Yapay Zekâ Uygulamaları Geliştirme” kursu size ivme kazandıracaktır!
2. Bilgisayarlı görü
CLIP ve DALL-E gibi modeller, metin ve görsel anlayışını birleştirir; bu da daha önceki mimarilerle mümkün olmayan görsel altyazılama ve metinden görsele üretim gibi uygulamaları mümkün kılar.
Araçlar arasında Adobe Photoshop, İçeriğe Duyarlı Dolgu (Content-Aware Fill) ve otomatik görsel tamamlama ile inpainting gibi diğer yapay zekâ destekli özelliklerine difüzyon modellerini entegre etti.
3. Alanlar arası uygulamalar
Son olarak, aynı anda birden çok alandan gelen verileri işleyip bütünleştirebilen çok kipli uygulamalar da vardır. Örneğin otonom sistemlerde, Tesla ve Waymo - Google'ın otonom araç projesi - kameralarından görsel verileri, radar sinyallerini ve LiDAR sensörlerini metinsel ve bağlamsal bilgilerle birleştiren çok kipli sistemler kullanır; böylece çevreyi anlamlandırıp gezinirler.
Bu alanlar arası uygulamalar, daha dar modellerin sınırladığı endüstrileri dönüştürerek daha dinamik, uyarlanabilir ve akıllı sistemleri mümkün kılıyor.
Bu uygulamaları gördükten sonra, modelleri aşağıdaki görselde olduğu gibi görsel olarak sınıflandırabiliriz:
Temel Modellerin alt kümeleri olarak alanlara özgü modellerin sınıflandırılması. Çok kipli uygulamalar farklı veri türlerini birleştirir. - Görsel: Yazar
Bu modellerle desteklenen uygulamalar geliştirmeyi düşünüyorsanız, “Üretken Yapay Zekâ Modelleriyle Geliştirebileceğiniz 5 Proje” makalesi size harika fikirler verecektir.
Temel Modellerin Zorlukları ve Etik Hususlar
Gördüğümüz üzere, temel modeller daha büyük yeteneklere sahip; ancak beraberinde çeşitli zorluklar ve etik hususlar da getirirler:
Hesaplama maliyetleri
Bu modellerin eğitimi, zaman ve enerji açısından son derece kaynak yoğundur. Eğitildikten sonra bile özellikle gerçek zamanlı uygulamalarda çıkarım için ciddi kaynak talep ederler; bu da ölçekli işletmeyi pahalı hâle getirir. Modeller büyüyüp karmaşıklaştıkça hesaplama yükü de artar.
Maliyet, özellikle büyük modelleri sıfırdan eğitmek için mali imkânları yetersiz olabilen daha küçük araştırma kurumları ve şirketler için zorludur; bu da büyük şirketlerin bu alandaki araştırmalara hükmetmesine yol açabilir. Bana göre, önceden eğitilmiş açık kaynak modellerin erişilebilirliği her iki açıdan da yardımcı olacaktır.
Çevresel etki
Maliyetle yakından ilişkili olarak, bu tür modellerin çevresel etkisi büyüyen bir endişe kaynağıdır. Büyük yapay zekâ modellerinin eğitimi ciddi miktarda enerji tüketir ve yüksek karbon ayak izine katkıda bulunur.
Yapay zekânın artan kullanımı ve giderek daha büyük modellerin ön eğitimi, sürdürülebilirlikle ilgili endişeleri yoğunlaştırıyor. Veri merkezlerinde daha verimli algoritmalar ve donanım yoluyla enerji tüketimini azaltmaya ve yenilenebilir enerji kaynaklarını benimsemeye yönelik çabalar sürse de konu kritikliğini koruyor.
Önyargı ve adalet
Temel modeller önyargı riskinden muaf değildir. Birçok derin öğrenme algoritmasında olduğu gibi, bu risk, eğitildikleri büyük miktarda gerçek dünya verisinden kaynaklanır. Modeller, veride bulunan önyargıları kaçınılmaz olarak miras alır; bu da hassas uygulamalarda adaletsiz sonuçlara veya ayrımcılığa yol açabilir.
Önyargıyı azaltmak esastır ve adalet algoritmalarını uygulamak, eğitim veri kümelerini çeşitlendirmek ve modellerin zararlı önyargıları sürdürmediğinden emin olmak için düzenli denetimler yapmak gibi stratejilerle başarılabilir.
Düzenleyici kaygılar
Son olarak, temel modellerin kullanımını çevreleyen düzenleyici kaygılar daha belirgin hâle geliyor. Bu modeller güçlendikçe ve çeşitli sektörlerde devreye alındıkça, hükümetler ve uluslararası kuruluşlar yapay zekâ güvenliği ve hesap verebilirliğine dair çerçeveler oluşturmaya çalışıyor.
AB'nin Yapay Zekâ Yasası gibi küresel standartlara uyumu sağlamak, yapay zekâ dağıtımıyla ilişkili riskleri yönetmek için kritik öneme sahiptir; buna mahremiyet sorunları ve yanlış bilgi de dâhildir. Bu tür düzenlemeler hakkında bilgi sahibi olmak için DataCamp'in AB Yapay Zekâ Yasası Temelleri beceri yolunu inceleyebilirsiniz.
Temel Modellerde Gelecek Trendler
Temel modellerdeki en belirgin trendlerden biri, çok kipli yeteneklerin evrimidir. Bu modeller giderek daha fazla, çeşitli veri türlerini tek bir birleşik çerçevede işleyip bütünleştirecek şekilde tasarlanıyor.
Bu çok kipli yaklaşım, bazılarınca insan bilişini yansıttığı iddia edilen bir biçimde, yapay zekâ sistemlerinin dünyayı daha iyi anlamasına ve etkileşim kurmasına olanak tanır. Bu yetenekler olgunlaştıkça, daha eksiksiz uygulamaları mümkün kılacaklarından eminim.
Bir diğer heyecan verici trend ise gerçek zamanlı uyarlanabilirlik olasılığıdır. Mevcut temel modellerin, belirli görevlere uyum sağlamak için kapsamlı ön eğitim ve ince ayar gereksinimi vardır. Ancak gelecekteki modellerin daha dinamik hâle gelmesi; yeni veri veya ortamlarla karşılaştıkça gerçek zamanlı olarak öğrenip uyum sağlayabilmesi beklenmektedir.
Bu imkân, kullanıcı tercihleri gibi değişen koşullara veya verilerde ortaya çıkan trendlere daha etkili tepkiler vermeyi sağlayacaktır.
Son olarak, modelleri daha hafif ve erişilebilir hâle getirmeye yönelik yenilikler; hem enerji tüketimini ve maliyeti azaltmak hem de temel yapay zekâ teknolojilerinin kullanımını demokratikleştirmek için gereklidir.
Devam eden araştırmalar, performanstan ödün vermeden bu modellerin boyutunu ve kaynak gereksinimlerini azaltmayı hedefliyor. Model damıtma (distillation), niceleme (quantization) ve verimli mimari tasarımı gibi teknikler, daha küçük, daha hızlı ve daha enerji verimli modeller oluşturmak için inceleniyor.
Ayrıca, hafif modeller akıllı telefonlar ve IoT cihazları gibi uç cihazlarda dağıtımı mümkün kılarak, yapay zekâ yeteneklerini gerçek dünya uygulamalarında son kullanıcılara daha da yaklaştıracaktır.
Son Düşünceler
Bu noktada, girişte sorduğumuz şu soruyu ele alabildiğimizden emin olmak isterim: “Bir modeli temel yapan nedir?”.
Bir model, genel amaçlı olduğunda; çeşitli görevler arasında genelleyebildiğinde ve farklı, daha dar görevler için uzmanlaştırılabildiğinde temeldir. Temel modeller, çeşitli alanlarda ince ayara temel teşkil ederek görev özelinde modellerin geliştirilmesini mümkün kılar. Ancak güçleri; önyargı ve etik hususlar dâhil olmak üzere zorluklarla birlikte gelir ve keşfedilecek yeni gelecek trendleri vardır.
Bunun gibi içeriklere ilgi duyuyorsanız, DataCamp'in Yapay Zekâ Temelleri beceri yolunu inceleyebilirsiniz; bu yol, yapay zekâ modelleriyle çalışmak için gereken birçok temel konuyu kapsar.