

Cursus
Concepten van Large Language Models (LLMs)
2 uur
113.4K
Oefen en volg je voortgang.
Ga Verder Met GoogleAls ik het nieuwe AI-tijdperk in één woord zou moeten omschrijven, dan is het schaal. Sinds OpenAI in november 2022 de webinterface voor GPT-3, bekend als ChatGPT, uitbracht, is de populariteit van Large Language Models aanzienlijk gegroeid door het brede gebruik door het grote publiek.
De term schaal slaat niet alleen op de populariteit van deze modellen, maar ook op de enorme hoeveelheden data waarop ze zijn getraind, het grote aantal parameters en de diverse taken die ze kunnen uitvoeren.
Vanuit mijn perspectief zette de boom van dit soort modellen in eerste instantie Large Language Models (LLM's) centraal. Twee jaar later, door de vooruitgang in dit veld, denk ik dat de populaire term is verschoven naar foundation models.
Maar wat zijn foundation models? En wat maakt een model een foundation model?
In tegenstelling tot LLM's bestaan foundation models al heel lang in de community. In dit artikel verkennen we het concept van foundation models, met de focus op hun belangrijkste kenmerken, toepassingen en toekomst in het AI-tijdperk.
Neem een AI-architectuur, zoals een transformer, en train die op enorme hoeveelheden diverse data: tekst van Common Crawl en boeken, afbeeldingen, YouTube-video's en meer.
Omdat deze data breed, algemeen en multimodaal is, wordt het resulterende model een groot, algemeen inzetbaar systeem met veel kennis. Dit is een foundation model: een veelzijdig, algemeen inzetbaar model dat dient als “fundament” voor het bouwen van gespecialiseerde AI-toepassingen.
Deze foundation models kunnen worden aangepast aan specifieke taken via fine-tuning, prompting of andere transfer learning-technieken. Het idee is dat het model, zodra het is gespecialiseerd in een specifiek domein, de sterke generalisatie-eigenschappen en emergente vermogens van het basismodel behoudt.
Vroege AI-systemen waren meestal regelgebaseerd en zeer domeinspecifiek, en vereisten dus taakspecifieke programmering. De vroege jaren 2000 werden gekenmerkt door de opkomst van machine learning als verschuiving naar datagedreven benaderingen, al bleef het beperkt tot specifieke taken.
De doorbraak van deep learning kwam rond 2012, waardoor complexere patroonherkenning en geavanceerde generatieve modellen mogelijk werden, met twee grote mijlpalen: generative adversarial networks in 2014 en transformers in 2017.
De groei van AI is sterk ondersteund door vooruitgang in rekenkracht (bijv. GPU's, TPU's) en de beschikbaarheid van enorme datasets, wat het trainen van steeds grotere modellen mogelijk heeft gemaakt en geleid heeft tot de opkomst van foundation models.
Het verschil tussen traditionele AI-systemen en foundation models wordt ook bepaald door hun schaal. De verschuiving van trainen op samengestelde datasets in traditionele AI-systemen naar het gebruik van enorme, diverse en vaak ongestructureerde data in foundation models is daar een voorbeeld van. Bovendien vertonen foundation models sterke generalisatiecapaciteiten, waardoor ze complexere en diverse taken aankunnen, terwijl traditionele AI-systemen voor nieuwe taken doorgaans opnieuw getraind of ingrijpend aangepast moeten worden.
Er zijn enkele bijzondere kenmerken die foundation models uniek maken:
Generalisatie verwijst naar het vermogen van een model om goed te presteren op onzichtbare taken of, concreet, op data buiten de trainingsset. Foundation models zijn juist vanwege deze eigenschap bijzonder waardevol. Hieraan nauw verwant is dat deze modellen ook onverwachte vermogens kunnen vertonen, niet gepland tijdens het trainen, die op schaal ontstaan, bekend als emergent gedrag.
Hoewel generalisatie een verwacht resultaat is van het trainen van modellen, zijn emergente vermogens vaak onvoorspelbaar, omdat modellen daar niet expliciet voor getraind zijn.
Daarnaast zijn deze modellen schaalbaar, wat betekent dat hun prestaties kunnen verbeteren door de modelgrootte te vergroten (samen met data en rekenkracht). Hoewel grotere modellen doorgaans beter generaliseren, garandeert alleen de modelgrootte geen betere generalisatie. Emergent gedrag correleert echter sterk met de modelgrootte.
Multimodaliteit verwijst naar het vermogen van een AI-model om meerdere soorten data te verwerken en te integreren, zoals tekst, afbeeldingen, video en meer. Hoewel foundation models multimodaal kúnnen zijn, is dit geen vereiste.
Een van de kernaspecten van multimodaliteit is crossmodaal begrip, waarbij het model informatie over verschillende datatypen heen kan begrijpen en verbinden. Bijvoorbeeld tekst en afbeeldingen combineren om bijschriften voor foto's te genereren of vragen over visuele content te beantwoorden. Multimodaliteit maakt rijkere interacties mogelijk en opent de deur naar toepassingen waarin tekst, beeld en audio moeten samenwerken, zoals in robotica of zorgsystemen.
Voor een meer diepgaande uitleg van multimodaliteit kun je ons artikel lezen, Wat is multimodale AI?
Tot slot is een ander belangrijk aspect van foundation models dat ze kunnen dienen als basis voor domeinspecifieke modellen. We kunnen ze dus aanpassen aan specifieke taken of domeinen door hun gewichten bij te stellen op basis van een kleinere, domeinspecifieke dataset, terwijl we profiteren van hun multimodaliteit, generalisatievermogen en andere eigenschappen. Dit proces staat bekend als fine-tuning. Leer er meer over in onze gids voor het fine-tunen van LLM's.
Enkele fine-tuningtechnieken zijn:
Large language models zijn een gespecialiseerde vorm van foundation models die uitsluitend of overwegend op tekstdata zijn getraind. Een LLM kan verder worden gefine-tuned voor specifieke taken, zoals taalkundige vertaling of samenvatten.
De volgende tabel kan helpen om de verschillen en overeenkomsten tussen beide modelcategorieën te benadrukken:
|
Aspect |
Foundation model |
Large language model |
|
Reikwijdte |
Algemeen inzetbare modellen die doorgaans op multimodale data zijn getraind. |
Subset van foundation models, uitsluitend op tekstdata getraind, en soms gefine-tuned voor een specifieke taak. |
|
Trainingsdata |
Diverse (en doorgaans multimodale) datasets. |
Voornamelijk tekstcorpora. |
|
Architectuur* |
Meerdere architecturen: transformers, convolutionele neurale netwerken (CNN's) of hybride architecturen afhankelijk van het datatype. |
Meestal transformergebaseerde architectuur. |
|
Use-cases |
Multimodale algemene taken. |
Gefocust op taaltaken: vertaling, samenvatten, chatbot, codegeneratie, enz. Tegenwoordig populair in de hele samenleving. Vind de meest populaire open-sourcemodellen in onze gids. |
* We lichten in de volgende sectie de architecturen voor foundation models verder toe.
Als we aan een praktischer voorbeeld denken: het eerste GPT-model in de ChatGPT-webinterface was GPT-3. Dat was een puur tekstueel large language model, en gebruikers konden er alleen via prompting mee interageren. Omdat LLM's een subset van foundation models zijn, was GPT-3 ook een foundation model.
Tegenwoordig zien we in de ChatGPT-interface dat we naast de prompt ook afbeeldingen kunnen toevoegen. Dat komt doordat GPT-4 nu het model achter de interface is. GPT-4 is een multimodaal foundation model.
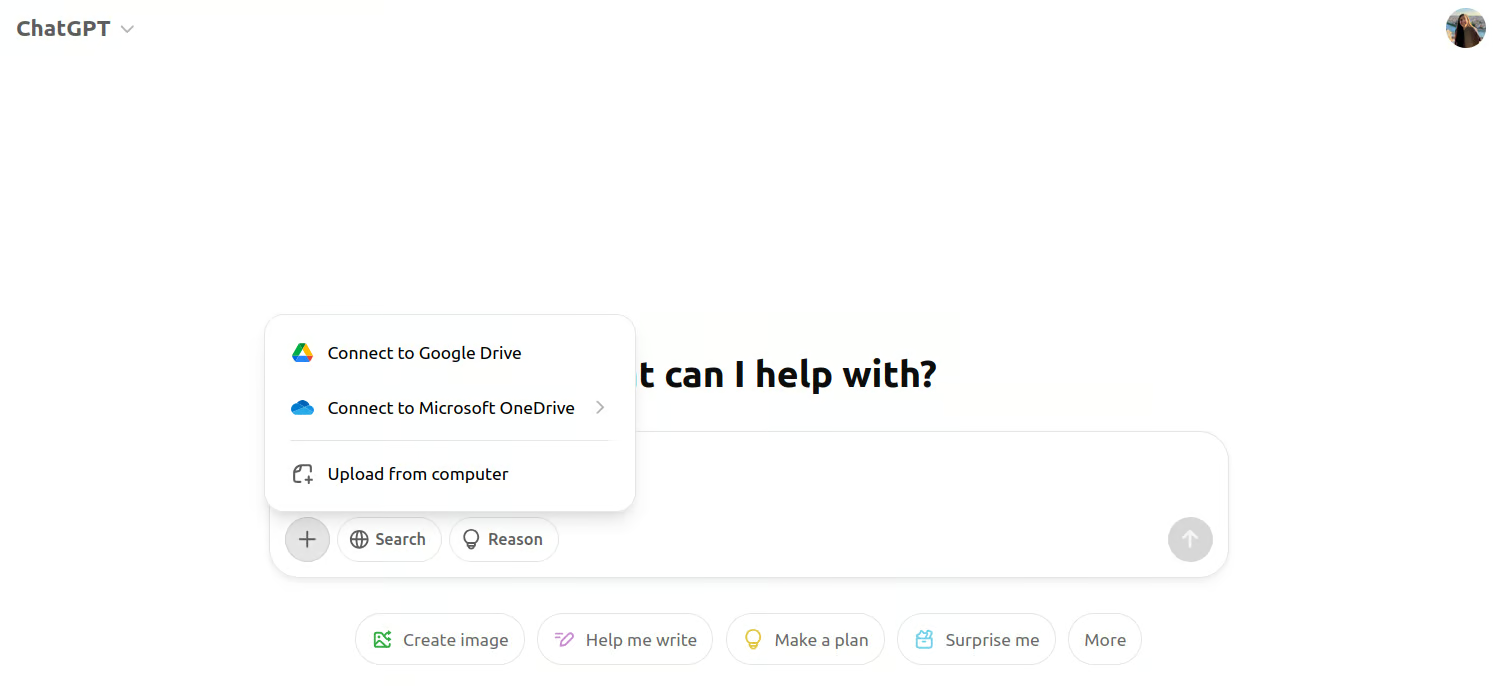
Screenshot van de multimodale interface van ChatGPT.
Omdat onze eerste interactie met die grote modellen via LLM's was, denken mensen vaak dat de transformerarchitectuur de enige is achter foundation models.
Echter, recurrente neurale netwerken (RNN's) waren vóór de opkomst van transformers de standaardarchitectuur voor tekstgebaseerde foundation models.
Op het gebied van beeldgeneratie vormen diffusie modellen tegenwoordig de ruggengraat van deze state-of-the-art systemen. Enkele bekende modellen zijn Stable Diffusion en DALL-E, maar convolutionele neurale netwerken (CNN's) werden daarvoor gebruikt!
Diffusiemodellen worden als foundational beschouwd voor beeldgeneratie om dezelfde redenen als eerder besproken: ze kunnen hoogwaardige, diverse afbeeldingen genereren en worden gefine-tuned voor specifieke taken zoals beeldbewerking of inpainting.
Foundation models worden in verschillende domeinen gebruikt vanwege hun veelzijdigheid en aanpasbaarheid. Enkele voorbeelden:
Zoals eerder besproken hebben foundation models opmerkelijke verbeteringen gebracht in natural language processing. De mensachtige capaciteiten van modellen zoals ChatGPT hebben deze modellen onmisbaar gemaakt in bijvoorbeeld klantenservice-toepassingen. Elke online conversatieagent is nu waarschijnlijk volledig LLM-gebaseerd en kan natuurlijkere, samenhangendere gesprekken voeren dan eerdere chatbots die op regels waren gebaseerd.
Deze modellen drijven ook toepassingen aan voor taalvertaling zoals Google Translate en DeepL. Als je deze tools nu gebruikt, merk je dat ze nauwkeuriger en contextbewuster zijn dan tien jaar geleden.
Als je geïnteresseerd bent in toepassingen voor natuurlijke taal, geeft de cursus “Developing AI Applications” je een flinke boost!
Modellen zoals CLIP en DALL-E combineren bijvoorbeeld tekst- en beeldbegrip, wat toepassingen mogelijk maakt als beeldbeschrijving en tekst-naar-beeldgeneratie, wat met eerdere architecturen niet haalbaar was.
Onder de tools heeft Adobe Photoshop diffusiemodellen geïntegreerd in zijn bewerkingsfuncties, zoals in Content-Aware Fill en andere AI-gestuurde functies voor automatische beeldaanvulling en inpainting.
Tot slot zijn er ook multimodale toepassingen die gelijktijdig data uit meerdere domeinen kunnen verwerken en integreren. Bijvoorbeeld in autonome systemen gebruiken Tesla en Waymo – Google's project voor autonome voertuigen – multimodale systemen die visuele data van camera's, radarsignalen en LiDAR-sensoren combineren met tekstuele en contextuele informatie om te navigeren en de omgeving te begrijpen.
Deze cross-domeintoepassingen transformeren industrieën door dynamischere, beter aanpasbare en intelligentere systemen mogelijk te maken die voorheen werden beperkt door smallere modellen.
Na deze toepassingen kunnen we de modellen visueel indelen zoals in de onderstaande afbeelding:
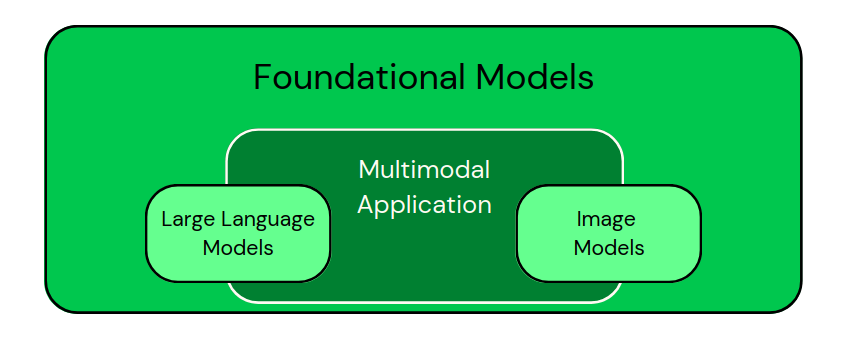
Classificatie van domeinspecifieke modellen als subsets van foundation models. Multimodale toepassingen combineren verschillende soorten data. - Afbeelding door de auteur
Als je overweegt om toepassingen te bouwen die door deze modellen worden aangedreven, geeft het artikel “5 Projects You Can Build with Generative AI Models” je alvast wat mooie ideeën.
Zoals we hebben gezien, hebben foundation models grotere capaciteiten, maar we moeten ons er ook van bewust zijn dat ze gepaard gaan met verschillende uitdagingen en ethische overwegingen:
Het trainen van deze modellen is zeer resource-intensief in termen van tijd en energie. Ook na het trainen vergen deze modellen aanzienlijke middelen voor inferentie, vooral in realtime toepassingen, waardoor ze duur zijn om op schaal te draaien. Naarmate de modellen groter en complexer worden, neemt ook de rekenlast toe.
De kosten zijn vooral een uitdaging voor kleinere onderzoeksinstellingen en bedrijven, die mogelijk niet de financiële middelen hebben om grote modellen from scratch te trainen, waardoor grote bedrijven de onderzoeksagenda kunnen domineren. Naar mijn mening helpt de beschikbaarheid van voorgetrainde open-sourcemodellen in beide richtingen.
Nauw verbonden met de kosten is de milieu-impact van dit soort modellen, die een groeiende zorg is. Het trainen van grote AI-modellen verbruikt een aanzienlijke hoeveelheid energie en draagt bij aan een hoge CO2-voetafdruk.
Het toenemende gebruik van AI en het voortrainen van steeds grotere modellen versterkt de zorgen over duurzaamheid. Er worden inspanningen geleverd om het energieverbruik te verminderen met efficiëntere algoritmen en hardware, en door het gebruik van hernieuwbare energie in datacenters, maar het blijft een cruciale kwestie.
Foundation models zijn niet vrij van het risico op bias. Zoals bij veel deep learning-algoritmen komt dit risico voort uit de enorme hoeveelheden real-world data waarop ze zijn getraind. Modellen nemen onvermijdelijk biases uit de data over, wat kan leiden tot oneerlijke uitkomsten of discriminatie in gevoelige toepassingen.
Het beperken van bias is essentieel en kan worden aangepakt met strategieën zoals fairness-algoritmen, het diversifiëren van trainingsdatasets en het regelmatig auditen van modellen om te zorgen dat ze schadelijke vooroordelen niet in stand houden.
Tot slot nemen de regelgevende zorgen rond het gebruik van foundation models toe. Naarmate deze modellen krachtiger worden en in verschillende sectoren worden ingezet, werken overheden en internationale instanties aan kaders voor AI-veiligheid en verantwoording.
Zorgen voor naleving van wereldwijde standaarden, zoals de EU AI Act, zal cruciaal zijn om risico's bij AI-implementatie te beheersen, waaronder privacykwesties en desinformatie. Je kunt bijblijven met dergelijke regelgeving via DataCamp's EU AI Act Fundamentals skill track.
Een van de meest in het oog springende trends in foundation models is de evolutie van multimodale capaciteiten. Deze modellen worden in toenemende mate ontworpen om diverse soorten data te verwerken en te integreren in één kader.
Deze multimodale aanpak laat AI-systemen de wereld beter begrijpen en ermee interacteren; sommigen beweren zelfs op een manier die het menselijk denken weerspiegelt. Naarmate deze mogelijkheden volwassen worden, ben ik ervan overtuigd dat ze completere toepassingen mogelijk maken.
Een andere spannende trend is het perspectief van realtime aanpasbaarheid. Huidige foundation models vereisen uitgebreide pre-training en fine-tuning om zich aan specifieke taken aan te passen. Toekomstige modellen zullen echter dynamischer worden en in staat zijn om in realtime te leren en zich aan te passen wanneer ze nieuwe data of omgevingen tegenkomen.
Deze mogelijkheid stelt AI-systemen in staat om effectiever te reageren op veranderende omstandigheden, zoals evoluerende gebruikersvoorkeuren of opkomende trends in data.
Ten slotte zijn innovaties om modellen lichter en toegankelijker te maken ook nodig om zowel het energieverbruik en de kosten te verlagen als het gebruik van foundational AI-technologieën te democratiseren.
Lopend onderzoek richt zich op het verkleinen van de omvang en het middelenverbruik van deze modellen zonder hun prestaties te ondermijnen. Technieken zoals modeldistillatie, kwantisatie en efficiënte architectuurontwerpen worden onderzocht om kleinere, snellere en energiezuinigere modellen te creëren.
Bovendien maken lichte modellen inzet op edge-apparaten mogelijk, zoals smartphones en IoT-apparaten, waardoor AI-mogelijkheden dichter bij eindgebruikers in realistische toepassingen komen.
Ik wil er graag voor zorgen dat we op dit punt de vraag uit de inleiding kunnen beantwoorden: “Wat maakt een foundation model een foundation model?”.
Een model is een foundation model wanneer het algemeen inzetbaar is, kan generaliseren over diverse taken en kan worden gespecialiseerd voor verschillende, smallere taken. Foundation models maken de ontwikkeling mogelijk van taakspecifieke modellen en dienen als basis voor fine-tuning in uiteenlopende domeinen. Hun kracht gaat echter gepaard met uitdagingen, waaronder bias en ethische vraagstukken, en er zijn nieuwe toekomsttrends te verkennen.
Als je meer van dit soort content wilt, bekijk dan de skill track AI Fundamentals van DataCamp, die veel van de essentials behandelt die je nodig hebt om met AI-modellen te werken.
Topcursussen op DataCamp
Cursus
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

