

Kursus
Konsep Large Language Models (LLM)
2 jam
113.4K
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan GoogleJika saya harus menggambarkan era AI baru dengan satu kata, itu adalah skala. Sejak OpenAI merilis antarmuka berbasis web untuk GPT-3, yang dikenal sebagai ChatGPT, pada November 2022, popularitas Model Bahasa Besar meningkat pesat karena digunakan secara luas oleh masyarakat umum.
Istilah skala tidak hanya berlaku untuk popularitas model-model ini, tetapi juga untuk jumlah data yang sangat besar yang digunakan untuk melatihnya, banyaknya parameter, dan beragamnya tugas yang dapat mereka lakukan.
Dari sudut pandang saya, ledakan model-model jenis ini awalnya menempatkan Model Bahasa Besar (LLM) di pusat perhatian. Dua tahun kemudian, berkat kemajuan di bidang ini, saya yakin istilah yang populer kini bergeser ke model fondasi.
Namun, apa itu model fondasi? Dan apa yang membuat sebuah model disebut fondasi?
Berbeda dengan LLM, model fondasi telah lama hadir di komunitas. Dalam artikel ini, kita akan mengeksplorasi konsep model fondasi, dengan fokus pada karakteristik utama, penerapan, dan masa depannya di era AI.
Ambil sebuah arsitektur AI, seperti transformer, lalu latih dengan jumlah data yang sangat besar dan beragam: teks dari Common Crawl dan buku, gambar, video YouTube, dan lainnya.
Karena data ini luas, umum, dan multimodal, model yang dihasilkan menjadi sistem besar serbaguna dengan pengetahuan yang luas. Inilah model fondasi: model serbaguna untuk berbagai keperluan yang menjadi “fondasi” untuk membangun aplikasi AI yang lebih khusus.
Model-model fondasi ini dapat diadaptasi ke tugas spesifik melalui fine-tuning, prompting, atau teknik transfer learning lainnya. Idenya adalah, setelah dispesialisasi dalam domain tertentu, model akan mempertahankan kemampuan generalisasi yang kuat dan kemampuan emergen dari model dasar.
Sistem AI awal sebagian besar berbasis aturan dan sangat spesifik domain, sehingga memerlukan pemrograman khusus tugas. Awal 2000-an ditandai dengan kemunculan pembelajaran mesin sebagai pergeseran menuju pendekatan berbasis data, meskipun masih terbatas pada tugas-tugas tertentu.
Terobosan deep learning terjadi sekitar 2012, memungkinkan pengenalan pola yang lebih kompleks dan model generatif tingkat lanjut, dengan dua tonggak utama: generative adversarial networks pada 2014 dan transformer pada 2017.
Pertumbuhan AI sangat didukung oleh kemajuan daya komputasi (misalnya, GPU, TPU) dan ketersediaan dataset masif, yang memungkinkan pelatihan model yang semakin besar, sehingga memunculkan model fondasi.
Perbedaan antara sistem AI tradisional dan model fondasi juga ditentukan oleh skalanya. Peralihan dari pelatihan pada dataset terkurasi dalam sistem AI tradisional ke penggunaan data yang masif, beragam, dan sering kali tidak terstruktur dalam model fondasi adalah salah satu contohnya. Selain itu, model fondasi menunjukkan kemampuan generalisasi yang kuat, memungkinkan mereka menangani tugas yang lebih kompleks dan beragam, sedangkan sistem AI tradisional biasanya memerlukan pelatihan ulang atau modifikasi luas untuk tugas baru.
Ada beberapa karakteristik khusus yang membuat Model Fondasi unik:
Generalisasi mengacu pada kemampuan model untuk berkinerja baik pada tugas yang belum pernah dilihat atau, secara konkret, pada data di luar himpunan latihannya. Model fondasi sangat berharga karena sifat ini. Berkaitan erat dengan itu, model-model ini juga dapat menunjukkan kemampuan tak terduga, yang tidak direncanakan saat pelatihan, yang muncul pada skala besar, dikenal sebagai perilaku emergen.
Sementara generalisasi adalah hasil yang diharapkan dari pelatihan model, kemampuan emergen sering kali tidak terprediksi, karena model tidak secara eksplisit dilatih untuk tujuan tersebut.
Selain itu, model-model ini dapat diskalakan, artinya kinerjanya dapat ditingkatkan dengan memperbesar ukuran model (bersama data dan sumber daya komputasi). Meski model yang lebih besar cenderung lebih baik dalam generalisasi, ukuran model saja tidak menjamin peningkatan generalisasi. Namun, perilaku emergen sangat berkorelasi dengan ukuran model.
Multimodalitas merujuk pada kemampuan model AI untuk memproses dan mengintegrasikan berbagai jenis data, seperti teks, gambar, video, dan lainnya. Meski Model Fondasi dapat bersifat multimodal, ini bukan persyaratan.
Salah satu aspek kunci multimodalitas adalah pemahaman lintas-modal, di mana model dapat memahami dan mengaitkan informasi di berbagai jenis data. Misalnya, menggabungkan teks dan gambar untuk membuat keterangan gambar atau menjawab pertanyaan tentang konten visual. Multimodalitas memungkinkan interaksi yang lebih kaya dan membuka peluang bagi aplikasi di mana teks, visi, dan audio harus bekerja bersama, seperti pada robotika atau sistem layanan kesehatan.
Untuk penjelasan lebih mendalam tentang Multimodalitas, pertimbangkan membaca artikel kami, Apa itu AI Multimodal?
Terakhir, aspek kunci lain dari model fondasi adalah bahwa model tersebut dapat menjadi dasar bagi model khusus domain. Karena itu, kita dapat mengadaptasinya ke tugas atau domain tertentu dengan menyesuaikan bobotnya berdasarkan dataset yang lebih kecil dan khusus domain, sambil tetap mendapat manfaat dari multimodalitas, kemampuan generalisasi, dan sifat lainnya. Proses ini dikenal sebagai fine-tuning, yang dapat Anda pelajari lebih lanjut dalam panduan fine-tuning LLM kami.
Beberapa teknik fine-tuning meliputi:
Model bahasa besar adalah jenis khusus dari model fondasi yang dilatih secara eksklusif atau dominan pada data teks. Sebuah LLM dapat di-fine-tune lebih lanjut untuk tugas spesifik, seperti penerjemahan bahasa atau peringkasan.
Tabel berikut dapat membantu menyoroti perbedaan dan persamaan antara kedua kategori model tersebut:
|
Aspek |
Model Fondasi |
Model Bahasa Besar |
|
Cakupan |
Model serbaguna yang umumnya dilatih pada data multimodal. |
Subkumpulan dari Model Fondasi yang dilatih secara eksklusif pada data teks, dan terkadang di-fine-tune untuk tugas tertentu. |
|
Data Pelatihan |
Dataset yang beragam (dan umumnya multimodal). |
Utamanya korpus teks. |
|
Arsitektur* |
Banyak arsitektur: Transformer, Convolutional Neural Networks (CNN), atau arsitektur hibrida bergantung pada jenis data. |
Biasanya arsitektur berbasis Transformer. |
|
Use case |
Tugas umum multimodal. |
Berfokus pada tugas bahasa: penerjemahan, peringkasan, chatbot, pembuatan kode, dll. Kini populer di seluruh masyarakat. Temukan model open-source terpopuler di panduan kami. |
* Kami akan mengulas sedikit lebih lanjut tentang arsitektur untuk Model Fondasi di bagian berikutnya.
Jika kita memikirkan contoh yang lebih praktis, model GPT pertama yang digunakan dalam antarmuka web ChatGPT adalah GPT-3. Itu adalah model bahasa besar yang murni tekstual, dan pengguna hanya dapat berinteraksi dengannya melalui prompt. Karena LLM adalah subkumpulan dalam model fondasi, GPT-3 juga merupakan model fondasi.
Saat ini, ketika kita masuk ke antarmuka ChatGPT, kita dapat melihat bahwa kita bisa melampirkan gambar bersama prompt. Ini karena GPT-4 kini menjadi model di balik antarmuka tersebut. GPT-4 adalah model fondasi multimodal.
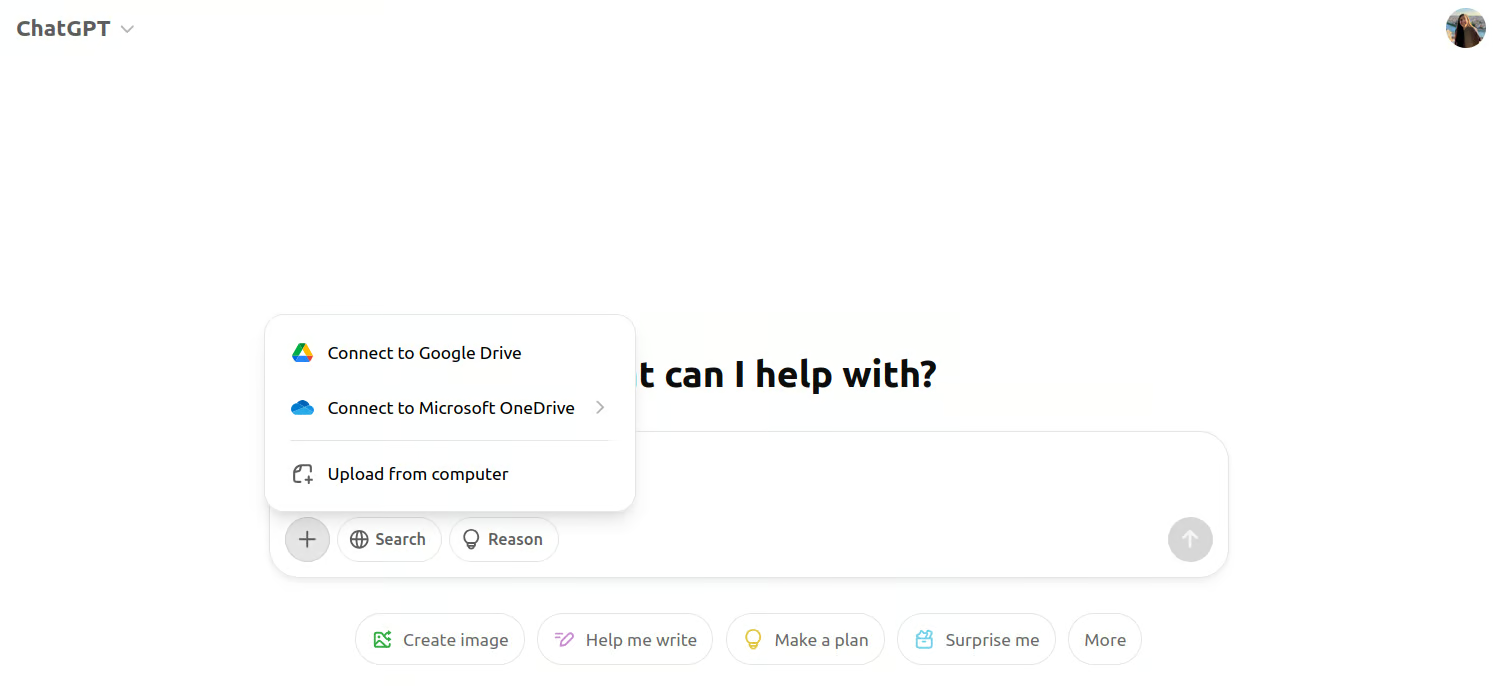
Tangkapan layar antarmuka multimodal ChatGPT.
Karena interaksi pertama kita dengan model besar tersebut adalah melalui LLM, orang cenderung berpikir bahwa arsitektur Transformer adalah satu-satunya yang digunakan di balik model fondasi.
Namun, Recurrent Neural Networks (RNN) adalah arsitektur andalan untuk model fondasi berbasis teks sebelum Transformer menjadi populer.
Dalam ranah pembuatan gambar, model difusi kini menjadi tulang punggung sistem tercanggih. Beberapa model yang dikenal luas termasuk Stable Diffusion dan DALL-E, tetapi Convolutional Neural Networks (CNN) telah digunakan sebelumnya!
Model difusi dianggap sebagai model fondasi untuk pembuatan gambar karena alasan yang telah dibahas: mereka dapat menghasilkan gambar yang beragam dan berkualitas tinggi serta dapat di-fine-tune untuk tugas tertentu seperti pengeditan gambar atau inpainting.
Model Fondasi digunakan di berbagai domain karena sifatnya yang serbaguna dan adaptif, beberapa di antaranya meliputi:
Seperti dibahas sebelumnya, Model Fondasi telah memberikan kemajuan luar biasa dalam Pemrosesan Bahasa Alami. Kemampuan menyerupai manusia dari model seperti ChatGPT membuat model-model ini tak tergantikan dalam aplikasi layanan pelanggan, misalnya. Agen percakapan online apa pun kini kemungkinan besar berbasis LLM, yang dapat terlibat dalam percakapan yang lebih alami dan koheren dibanding chatbot sebelumnya yang mengandalkan sistem berbasis aturan.
Model-model ini juga mendukung aplikasi dalam penerjemahan bahasa seperti Google Translate dan DeepL. Jika Anda menggunakan alat ini sekarang, Anda akan menyadari bahwa alat tersebut menjadi lebih akurat dan peka konteks dibanding sepuluh tahun lalu.
Jika Anda tertarik pada aplikasi bahasa alami, kursus “Mengembangkan Aplikasi AI” akan memberi Anda dorongan!
Model seperti CLIP dan DALL-E, misalnya, menggabungkan pemahaman teks dan gambar, memungkinkan aplikasi seperti pembuatan keterangan gambar dan pembuatan teks-ke-gambar, yang dulu tidak memungkinkan dengan arsitektur sebelumnya.
Di antara alat, Adobe Photoshop telah memasukkan model difusi ke dalam alat pengeditannya, seperti pada Content-Aware Fill dan fitur bertenaga AI lainnya untuk pelengkapan gambar otomatis dan inpainting.
Terakhir, ada juga aplikasi multimodal yang dapat memproses dan mengintegrasikan data dari berbagai domain secara bersamaan. Misalnya, dalam sistem otonom, Tesla dan Waymo - proyek kendaraan otonom Google - menggunakan sistem multimodal yang menggabungkan data visual dari kamera, sinyal radar, dan sensor LiDAR, dengan informasi tekstual dan kontekstual untuk bernavigasi dan memahami lingkungan.
Aplikasi lintas domain ini mentransformasi industri, memungkinkan sistem yang lebih dinamis, adaptif, dan cerdas yang sebelumnya dibatasi oleh model yang lebih sempit.
Setelah melihat penerapannya, kita dapat mengklasifikasikan model secara visual seperti pada gambar di bawah ini:
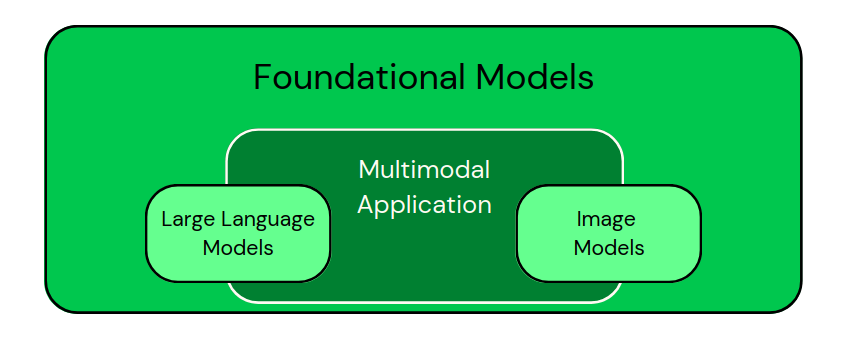
Klasifikasi model khusus domain sebagai subkumpulan Model Fondasi. Aplikasi multimodal menggabungkan berbagai jenis data. - Gambar oleh Penulis
Jika Anda mempertimbangkan untuk membangun aplikasi yang didukung oleh model-model ini, artikel “5 Proyek yang Dapat Anda Bangun dengan Model AI Generatif” akan memberi Anda beberapa ide bagus.
Seperti yang telah kita lihat, model fondasi memiliki kemampuan lebih besar, tetapi kita juga harus sadar bahwa model ini hadir dengan sejumlah tantangan dan pertimbangan etis:
Melatih model-model ini sangat membutuhkan sumber daya dari segi waktu dan energi. Setelah dilatih, model-model ini tetap menuntut sumber daya besar untuk inferensi, khususnya pada aplikasi waktu nyata, sehingga mahal untuk dioperasikan pada skala besar. Seiring model makin besar dan kompleks, beban komputasi juga meningkat.
Biaya menjadi tantangan khususnya bagi institusi riset dan perusahaan kecil, yang mungkin tidak memiliki kemampuan finansial untuk melatih model besar dari nol, sehingga perusahaan besar mendominasi riset di bidang ini. Menurut saya, ketersediaan model open-source yang telah dipra-latih akan membantu kedua belah pihak.
Berkaitan erat dengan biaya, dampak lingkungan dari jenis model ini menjadi keprihatinan yang meningkat. Melatih model AI besar mengonsumsi energi dalam jumlah besar, berkontribusi pada jejak karbon yang tinggi.
Meningkatnya penggunaan AI dan pra-pelatihan model yang semakin besar memperkuat kekhawatiran tentang keberlanjutan. Upaya dilakukan untuk mengurangi konsumsi energi melalui algoritma dan perangkat keras yang lebih efisien, serta adopsi sumber energi terbarukan di pusat data, tetapi isu ini tetap krusial.
Model fondasi tidak kebal dari risiko bias. Seperti banyak algoritma deep learning lainnya, risiko ini timbul dari banyaknya data dunia nyata yang digunakan untuk melatihnya. Model pada akhirnya mewarisi bias yang ada dalam data, yang dapat menyebabkan hasil tidak adil atau diskriminasi pada aplikasi sensitif.
Mengurangi bias sangat penting dan dapat dicapai melalui strategi seperti menerapkan algoritma keadilan, mendiversifikasi dataset pelatihan, dan mengaudit model secara berkala untuk memastikan model tidak meneruskan bias yang merugikan.
Terakhir, kekhawatiran regulasi terkait penggunaan model fondasi semakin menonjol. Seiring model-model ini semakin kuat dan diterapkan di berbagai industri, pemerintah dan badan internasional tengah menyusun kerangka kerja untuk keselamatan dan akuntabilitas AI.
Memastikan kepatuhan terhadap standar global, seperti AI Act UE, akan krusial untuk mengelola risiko terkait penerapan AI, termasuk isu privasi dan misinformasi. Anda dapat mempelajari regulasi tersebut melalui jalur keterampilan EU AI Act Fundamentals dari DataCamp.
Salah satu tren paling menonjol dalam model fondasi adalah evolusi kemampuan multimodal. Model-model ini kian dirancang untuk memproses dan mengintegrasikan beragam jenis data ke dalam kerangka terpadu.
Pendekatan multimodal ini memungkinkan sistem AI memahami dan berinteraksi dengan dunia dengan lebih baik, sebagian orang bahkan mengklaim bahwa hal itu mencerminkan kognisi manusia. Seiring kemampuan ini matang, saya yakin model akan memungkinkan aplikasi yang lebih lengkap.
Tren menarik lainnya adalah prospek adaptabilitas waktu nyata. Model fondasi saat ini memerlukan pra-pelatihan dan fine-tuning ekstensif untuk beradaptasi ke tugas tertentu. Namun, model masa depan diperkirakan akan menjadi lebih dinamis, mampu belajar dan beradaptasi secara waktu nyata saat mereka menemui data atau lingkungan baru.
Kemungkinan ini akan memungkinkan sistem AI merespons kondisi yang berubah dengan lebih efektif, seperti preferensi pengguna yang berkembang atau tren baru dalam data.
Terakhir, inovasi untuk membuat model lebih ringan dan mudah diakses juga menjadi kebutuhan untuk mengurangi konsumsi energi dan biaya, serta mendemokratisasi penggunaan teknologi AI fondasi.
Riset yang sedang berlangsung bertujuan mengurangi ukuran dan kebutuhan sumber daya model-model ini tanpa mengorbankan kinerjanya. Teknik seperti distilasi model, kuantisasi, dan desain arsitektur efisien sedang dieksplorasi untuk menciptakan model yang lebih kecil, lebih cepat, dan lebih hemat energi.
Selain itu, model ringan akan memungkinkan penerapan pada perangkat edge, seperti ponsel pintar dan perangkat IoT, menghadirkan kemampuan AI lebih dekat ke pengguna akhir dalam aplikasi dunia nyata.
Saya ingin memastikan bahwa, pada titik ini, kita dapat menjawab pertanyaan yang diajukan di pendahuluan: “Apa yang membuat sebuah model fondasi disebut fondasi?”.
Sebuah model disebut fondasi ketika ia serbaguna, mampu melakukan generalisasi di berbagai tugas, dan dapat dispesialisasi untuk beragam tugas yang lebih sempit. Model fondasi memungkinkan pengembangan model khusus tugas dengan menjadi dasar untuk fine-tuning di berbagai domain. Namun, kekuatannya hadir bersama tantangan, termasuk bias dan pertimbangan etis, serta sejumlah tren masa depan untuk dieksplorasi.
Jika Anda tertarik pada konten seperti ini, pertimbangkan untuk melihat AI Fundamentals dari DataCamp, yang membahas banyak hal penting yang diperlukan untuk bekerja dengan model AI.
Kursus Teratas DataCamp
Kursus
Kursus
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan Googleblogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt



