

Khóa học
Các khái niệm về Large Language Models (LLMs)
2 giờ
113.4K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleNếu phải dùng một từ để mô tả kỷ nguyên AI mới, đó sẽ là quy mô. Kể từ khi OpenAI ra mắt giao diện web cho GPT-3, được biết đến là ChatGPT, vào tháng 11/2022, mức độ phổ biến của các Mô hình Ngôn ngữ Lớn đã tăng mạnh nhờ việc được công chúng sử dụng rộng rãi.
Thuật ngữ quy mô không chỉ áp dụng cho mức độ phổ biến của các mô hình này mà còn cho khối lượng dữ liệu khổng lồ dùng để huấn luyện, số lượng tham số rất lớn, và phạm vi nhiệm vụ đa dạng mà chúng có thể thực hiện.
Theo quan điểm của tôi, cơn bùng nổ của các loại mô hình này ban đầu đặt Mô hình Ngôn ngữ Lớn (LLM) vào trung tâm. Hai năm sau, nhờ những tiến bộ trong lĩnh vực này, tôi tin rằng thuật ngữ phổ biến đã chuyển sang mô hình nền tảng.
Vậy mô hình nền tảng là gì? Và điều gì khiến một mô hình được coi là nền tảng?
Khác với LLM, các mô hình nền tảng đã tồn tại trong cộng đồng từ lâu. Trong bài viết này, chúng ta sẽ khám phá khái niệm về mô hình nền tảng, tập trung vào các đặc điểm then chốt, ứng dụng và tương lai của chúng trong kỷ nguyên AI.
Hãy lấy một kiến trúc AI, chẳng hạn như transformer, và huấn luyện nó trên lượng dữ liệu đa dạng khổng lồ: văn bản từ Common Crawl và sách, hình ảnh, video YouTube, và hơn thế nữa.
Vì dữ liệu này rộng, tổng quát và đa phương thức, mô hình thu được trở thành một hệ thống lớn, đa dụng với kiến thức phong phú. Đây là một mô hình nền tảng: một mô hình đa năng, dùng chung, đóng vai trò “nền tảng” để xây dựng các ứng dụng AI chuyên biệt.
Những mô hình nền tảng này có thể được điều chỉnh cho các tác vụ cụ thể thông qua fine-tuning, prompting hoặc các kỹ thuật học chuyển giao khác. Ý tưởng là một khi đã chuyên biệt hóa trong một miền cụ thể, mô hình vẫn giữ được khả năng khái quát mạnh và các năng lực nổi lên của mô hình gốc.
Các hệ thống AI thời kỳ đầu chủ yếu dựa trên luật và rất đặc thù miền, do đó cần lập trình theo từng nhiệm vụ. Những năm 2000 đánh dấu sự xuất hiện của học máy như một bước chuyển sang phương pháp dựa trên dữ liệu, dù vẫn còn giới hạn ở các tác vụ cụ thể.
Bước đột phá của học sâu đến khoảng năm 2012, cho phép nhận dạng mẫu phức tạp hơn và các mô hình sinh tiên tiến, với hai cột mốc lớn: mạng đối nghịch sinh (GAN) năm 2014 và transformer năm 2017.
Sự phát triển của AI được hỗ trợ mạnh mẽ bởi tiến bộ về năng lực tính toán (ví dụ, GPU, TPU) và sự sẵn có của các bộ dữ liệu khổng lồ, cho phép huấn luyện các mô hình ngày càng lớn, dẫn đến sự xuất hiện của mô hình nền tảng.
Sự khác biệt giữa các hệ thống AI truyền thống và mô hình nền tảng còn được xác định bởi quy mô. Sự chuyển dịch từ việc huấn luyện trên các bộ dữ liệu đã chọn lọc trong hệ thống AI truyền thống sang sử dụng dữ liệu khổng lồ, đa dạng và thường không có cấu trúc trong mô hình nền tảng là một ví dụ. Ngoài ra, mô hình nền tảng có khả năng khái quát mạnh, cho phép giải quyết các nhiệm vụ phức tạp và đa dạng hơn, trong khi hệ thống AI truyền thống thường cần huấn luyện lại hoặc chỉnh sửa lớn cho các nhiệm vụ mới.
Có một số đặc điểm đặc biệt khiến Mô hình Nền tảng trở nên khác biệt:
Khái quát hóa đề cập đến khả năng của mô hình thực hiện tốt trên các nhiệm vụ chưa từng thấy hoặc, cụ thể hơn, trên dữ liệu ngoài tập huấn luyện. Mô hình nền tảng đặc biệt có giá trị nhờ thuộc tính này. Liên quan mật thiết, các mô hình này cũng có thể thể hiện những năng lực bất ngờ, không được lên kế hoạch trong quá trình huấn luyện, xuất hiện khi ở quy mô lớn, được gọi là hành vi nổi lên.
Trong khi khái quát hóa là kết quả mong đợi của việc huấn luyện mô hình, các năng lực nổi lên thường khó dự đoán, vì mô hình không được huấn luyện tường minh cho các mục tiêu đó.
Ngoài ra, các mô hình này còn có khả năng mở rộng, nghĩa là hiệu năng có thể được cải thiện bằng cách tăng kích thước mô hình (cùng với dữ liệu và tài nguyên tính toán). Dù mô hình lớn hơn có xu hướng khái quát hóa tốt hơn, kích thước mô hình tự thân không đảm bảo khả năng khái quát hóa được cải thiện. Tuy nhiên, hành vi nổi lên có tương quan mạnh với kích thước mô hình.
Đa phương thức đề cập đến khả năng của mô hình AI trong việc xử lý và tích hợp nhiều loại dữ liệu, như văn bản, hình ảnh, video, v.v. Mô hình Nền tảng có thể là đa phương thức, nhưng đây không phải là yêu cầu bắt buộc.
Một khía cạnh then chốt của đa phương thức là hiểu biết xuyên phương thức, nơi mô hình có thể hiểu và liên kết thông tin giữa các loại dữ liệu khác nhau. Ví dụ, kết hợp văn bản và hình ảnh để tạo chú thích cho ảnh hoặc trả lời câu hỏi về nội dung trực quan. Đa phương thức cho phép tương tác phong phú hơn và mở ra các ứng dụng nơi văn bản, thị giác và âm thanh cần phối hợp, như trong robot hay hệ thống y tế.
Để có giải thích sâu hơn về Đa phương thức, hãy đọc bài viết Trí tuệ nhân tạo đa phương thức là gì?
Cuối cùng, một khía cạnh quan trọng khác của mô hình nền tảng là chúng có thể làm cơ sở cho các mô hình đặc thù miền. Vì vậy, ta có thể điều chỉnh chúng cho các nhiệm vụ hoặc miền cụ thể bằng cách tinh chỉnh trọng số dựa trên một bộ dữ liệu nhỏ hơn, đặc thù miền, đồng thời tận dụng tính đa phương thức, khả năng khái quát và các thuộc tính khác. Quá trình này được gọi là fine-tuning; bạn có thể tìm hiểu thêm trong hướng dẫn fine-tuning LLM.
Một số kỹ thuật fine-tuning bao gồm:
Mô hình ngôn ngữ lớn là một loại mô hình nền tảng chuyên biệt được huấn luyện hoàn toàn hoặc chủ yếu trên dữ liệu văn bản. Một LLM có thể được fine-tuning thêm cho các nhiệm vụ cụ thể, như dịch ngôn ngữ hoặc tóm tắt.
Bảng sau có thể giúp làm nổi bật những khác biệt và tương đồng giữa hai nhóm mô hình:
|
Khía cạnh |
Mô hình Nền tảng |
Mô hình Ngôn ngữ Lớn |
|
Phạm vi |
Mô hình đa dụng thường được huấn luyện trên dữ liệu đa phương thức. |
Tập con của Mô hình Nền tảng được huấn luyện hoàn toàn trên dữ liệu văn bản, và đôi khi được fine-tuning cho một nhiệm vụ cụ thể. |
|
Dữ liệu huấn luyện |
Các bộ dữ liệu đa dạng (và thường là đa phương thức). |
Chủ yếu là kho văn bản. |
|
Kiến trúc* |
Nhiều kiến trúc: Transformer, Mạng Nơ-ron Tích chập (CNN), hoặc kiến trúc lai tùy theo loại dữ liệu. |
Thường là kiến trúc dựa trên Transformer. |
|
Trường hợp sử dụng |
Nhiệm vụ tổng quát đa phương thức. |
Tập trung vào nhiệm vụ ngôn ngữ: dịch, tóm tắt, chatbot, sinh mã, v.v. Hiện rất phổ biến trong xã hội. Tìm các mô hình mã nguồn mở phổ biến nhất trong hướng dẫn của chúng tôi. |
* Chúng tôi sẽ trình bày kỹ hơn về kiến trúc cho Mô hình Nền tảng ở phần tiếp theo.
Nếu xét ví dụ thực tế hơn, mô hình GPT đầu tiên dùng trong giao diện web ChatGPT là GPT-3. Đó là một mô hình ngôn ngữ lớn thuần văn bản, và người dùng chỉ có thể tương tác thông qua prompt. Vì LLM là một tập con trong mô hình nền tảng, GPT-3 cũng là một mô hình nền tảng.
Ngày nay, khi vào giao diện ChatGPT, ta có thể đính kèm hình ảnh cùng với prompt. Đó là vì hiện nay GPT-4 là mô hình đứng sau giao diện. GPT-4 là một mô hình nền tảng đa phương thức.
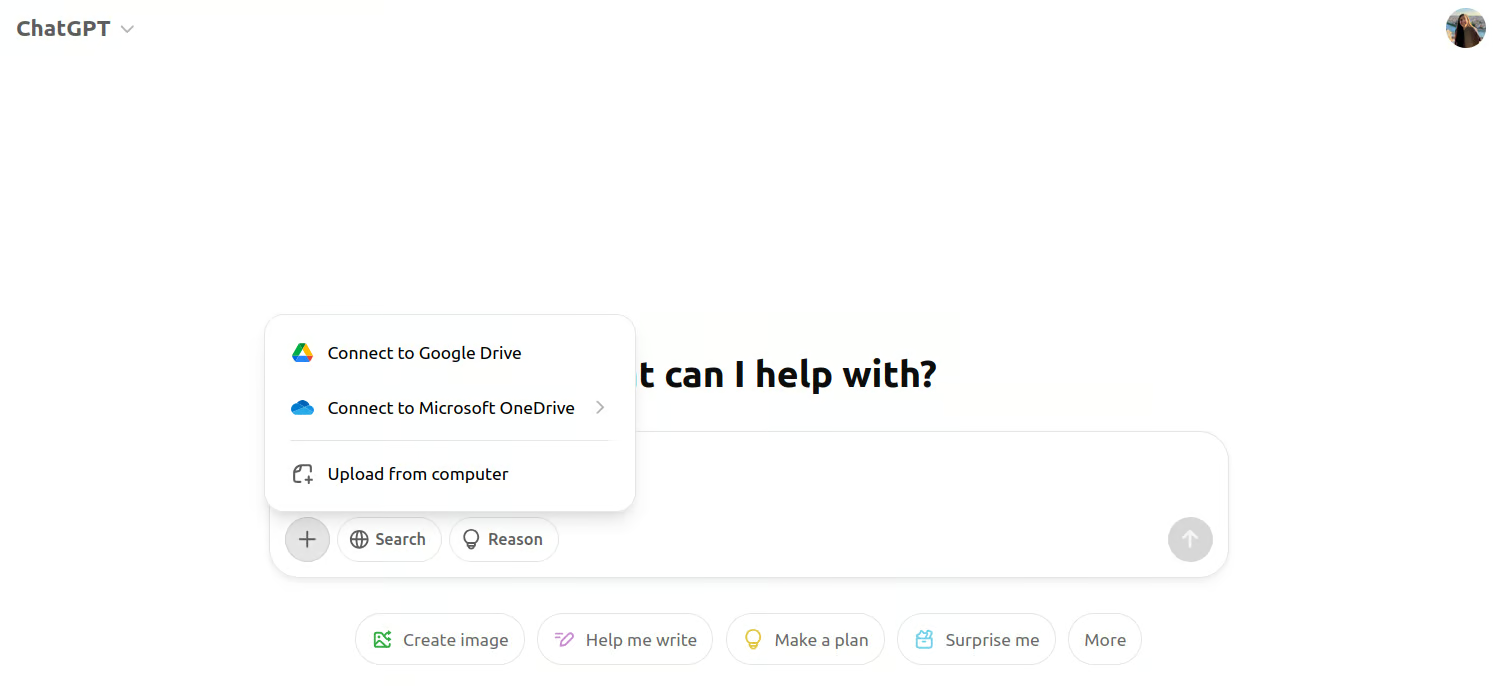
Ảnh chụp màn hình giao diện đa phương thức của ChatGPT.
Vì lần đầu chúng ta tương tác với các mô hình lớn là thông qua LLM, nhiều người có xu hướng nghĩ rằng kiến trúc Transformer là kiến trúc duy nhất đứng sau mô hình nền tảng.
Tuy nhiên, Mạng Nơ-ron Hồi quy (RNN) từng là kiến trúc ưa dùng cho các Mô hình Nền tảng dựa trên văn bản trước khi Transformer trở nên phổ biến.
Trong lĩnh vực sinh ảnh, mô hình khuếch tán (diffusion) hiện là xương sống của các hệ thống tiên tiến nhất. Một số mô hình nổi tiếng gồm Stable Diffusion và DALL-E, nhưng Mạng Nơ-ron Tích chập (CNN) đã được sử dụng trước đó!
Mô hình khuếch tán được xem là nền tảng cho sinh ảnh vì các lý do đã nêu: chúng có thể tạo ra hình ảnh đa dạng, chất lượng cao và có thể fine-tuning cho các tác vụ cụ thể như chỉnh sửa ảnh hoặc inpainting.
Mô hình Nền tảng được sử dụng trong nhiều lĩnh vực nhờ tính đa dụng và khả năng thích ứng; một số bao gồm:
Như đã đề cập, Mô hình Nền tảng đã cải thiện đáng kể lĩnh vực Xử lý ngôn ngữ tự nhiên. Các khả năng gần giống con người của những mô hình như ChatGPT khiến chúng không thể thiếu trong các ứng dụng chăm sóc khách hàng, chẳng hạn. Hầu hết các tác nhân hội thoại trực tuyến hiện nay có khả năng đều dựa trên LLM, có thể tham gia các cuộc trò chuyện tự nhiên, mạch lạc hơn so với chatbot trước đây vốn dựa vào hệ thống luật.
Các mô hình này cũng vận hành các ứng dụng dịch ngôn ngữ như Google Dịch và DeepL. Nếu bạn dùng các công cụ này hiện nay, bạn sẽ nhận ra chúng chính xác và hiểu ngữ cảnh tốt hơn nhiều so với mười năm trước.
Nếu bạn quan tâm đến các ứng dụng ngôn ngữ tự nhiên, khóa học “Phát triển Ứng dụng AI” sẽ giúp bạn tăng tốc!
Các mô hình như CLIP và DALL-E, chẳng hạn, kết hợp hiểu văn bản và hình ảnh, cho phép các ứng dụng như tạo chú thích ảnh và sinh ảnh từ văn bản, điều vốn không khả thi với các kiến trúc trước đây.
Trong số các công cụ, Adobe Photoshop đã tích hợp mô hình khuếch tán vào các công cụ chỉnh sửa, như trong Content-Aware Fill và các tính năng AI khác cho việc hoàn thiện ảnh và inpainting tự động.
Cuối cùng, còn có các ứng dụng đa phương thức có thể xử lý và tích hợp dữ liệu từ nhiều miền đồng thời. Ví dụ, trong các hệ thống tự hành, Tesla và Waymo - dự án xe tự hành của Google - sử dụng các hệ thống đa phương thức kết hợp dữ liệu hình ảnh từ camera, tín hiệu radar, cảm biến LiDAR, cùng với thông tin văn bản và ngữ cảnh để di chuyển và hiểu môi trường.
Những ứng dụng xuyên miền này đang chuyển đổi các ngành, cho phép các hệ thống năng động, thích ứng và thông minh hơn vốn trước đây bị giới hạn bởi các mô hình hẹp hơn.
Sau khi xem các ứng dụng đó, chúng ta có thể phân loại trực quan các mô hình như trong hình dưới đây:
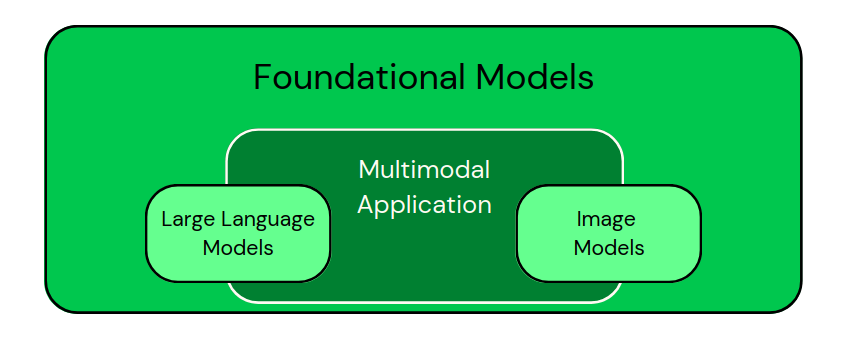
Phân loại các mô hình đặc thù miền là tập con của Mô hình Nền tảng. Ứng dụng đa phương thức kết hợp các loại dữ liệu khác nhau. - Hình do Tác giả thực hiện
Nếu bạn đang cân nhắc xây dựng các ứng dụng vận hành bởi những mô hình này, bài viết “5 dự án bạn có thể xây dựng với mô hình AI sinh” sẽ cho bạn những ý tưởng tuyệt vời.
Như chúng ta đã thấy, mô hình nền tảng có năng lực lớn hơn, nhưng cũng đi kèm nhiều thách thức và cân nhắc đạo đức:
Huấn luyện các mô hình này cực kỳ tốn tài nguyên về thời gian và năng lượng. Sau khi huấn luyện, các mô hình này vẫn đòi hỏi lượng tài nguyên đáng kể cho suy luận, đặc biệt trong các ứng dụng thời gian thực, khiến chi phí vận hành ở quy mô lớn trở nên đắt đỏ. Khi mô hình lớn hơn và phức tạp hơn, gánh nặng tính toán cũng tăng theo.
Chi phí là thách thức đặc biệt đối với các viện nghiên cứu và công ty nhỏ, vốn có thể thiếu nguồn lực tài chính để huấn luyện mô hình lớn từ đầu, tạo điều kiện cho các tập đoàn lớn thống trị nghiên cứu trong lĩnh vực này. Theo tôi, sự sẵn có của các mô hình mã nguồn mở đã được tiền huấn luyện sẽ giúp cân bằng cả hai phía.
Liên quan chặt chẽ tới chi phí, tác động môi trường của các loại mô hình này ngày càng được quan tâm. Huấn luyện các mô hình AI lớn tiêu thụ một lượng năng lượng đáng kể, góp phần tạo ra lượng khí thải carbon cao.
Việc sử dụng AI ngày càng gia tăng và tiền huấn luyện các mô hình ngày càng lớn khiến lo ngại về tính bền vững thêm gay gắt. Nỗ lực đang được thực hiện để giảm tiêu thụ năng lượng thông qua thuật toán và phần cứng hiệu quả hơn, cũng như áp dụng nguồn năng lượng tái tạo tại các trung tâm dữ liệu, nhưng vấn đề vẫn còn cấp thiết.
Mô hình nền tảng không miễn nhiễm với rủi ro thiên lệch. Như với nhiều thuật toán học sâu, rủi ro này xuất phát từ lượng dữ liệu thế giới thực khổng lồ mà chúng được huấn luyện. Mô hình tất yếu thừa hưởng các thiên lệch có trong dữ liệu, có thể dẫn đến kết quả không công bằng hoặc phân biệt đối xử trong các ứng dụng nhạy cảm.
Giảm thiểu thiên lệch là điều thiết yếu và có thể đạt được qua các chiến lược như triển khai thuật toán công bằng, đa dạng hóa bộ dữ liệu huấn luyện, và thường xuyên kiểm toán mô hình để đảm bảo chúng không duy trì các thiên lệch gây hại.
Cuối cùng, các quan ngại pháp lý xoay quanh việc sử dụng mô hình nền tảng đang trở nên rõ nét hơn. Khi các mô hình này mạnh mẽ hơn và được triển khai rộng rãi trong nhiều ngành, các chính phủ và tổ chức quốc tế đang nỗ lực xây dựng khung quản trị cho an toàn và trách nhiệm AI.
Đảm bảo tuân thủ các tiêu chuẩn toàn cầu, như Đạo luật AI của EU, sẽ rất quan trọng để quản lý rủi ro khi triển khai AI, bao gồm vấn đề quyền riêng tư và thông tin sai lệch. Bạn có thể cập nhật nhanh các quy định này với lộ trình kỹ năng EU AI Act Fundamentals của DataCamp.
Một trong những xu hướng nổi bật của mô hình nền tảng là sự phát triển năng lực đa phương thức. Các mô hình này ngày càng được thiết kế để xử lý và tích hợp nhiều loại dữ liệu trong một khung thống nhất.
Cách tiếp cận đa phương thức này cho phép hệ thống AI hiểu và tương tác với thế giới tốt hơn, thậm chí có người cho rằng theo cách phản chiếu nhận thức của con người. Khi các năng lực này trưởng thành, tôi tin chắc chúng sẽ cho phép những ứng dụng hoàn thiện hơn.
Một xu hướng thú vị khác là triển vọng thích ứng theo thời gian thực. Các mô hình nền tảng hiện tại cần tiền huấn luyện và fine-tuning đáng kể để thích ứng với các nhiệm vụ cụ thể. Tuy nhiên, các mô hình tương lai được kỳ vọng sẽ năng động hơn, có khả năng học và thích nghi theo thời gian thực khi gặp dữ liệu hoặc môi trường mới.
Khả năng này sẽ giúp hệ thống AI phản ứng hiệu quả hơn với điều kiện thay đổi, như sở thích người dùng tiến hóa hoặc các xu hướng mới nổi trong dữ liệu.
Cuối cùng, các đổi mới nhằm làm cho mô hình nhẹ hơn và dễ tiếp cận hơn cũng là yêu cầu để vừa giảm tiêu thụ năng lượng, chi phí, vừa dân chủ hóa việc sử dụng công nghệ AI nền tảng.
Nghiên cứu đang tiếp tục nhằm giảm kích thước và nhu cầu tài nguyên của các mô hình này mà không làm suy giảm hiệu năng. Các kỹ thuật như chưng cất mô hình (distillation), lượng tử hóa (quantization) và thiết kế kiến trúc hiệu quả đang được khám phá để tạo ra các mô hình nhỏ hơn, nhanh hơn và tiết kiệm năng lượng hơn.
Ngoài ra, các mô hình nhẹ sẽ cho phép triển khai trên thiết bị biên như điện thoại thông minh và thiết bị IoT, đưa năng lực AI đến gần người dùng cuối hơn trong các ứng dụng thực tế.
Tôi muốn chắc chắn rằng, đến thời điểm này, chúng ta có thể trả lời câu hỏi nêu ở phần mở đầu: “Điều gì khiến một mô hình nền tảng trở thành nền tảng?”.
Một mô hình được coi là nền tảng khi nó là mô hình đa dụng, có khả năng khái quát trên nhiều nhiệm vụ đa dạng và có thể chuyên biệt hóa cho các nhiệm vụ hẹp hơn. Mô hình nền tảng cho phép phát triển các mô hình đặc thù nhiệm vụ bằng cách làm nền tảng cho việc fine-tuning trong nhiều miền. Tuy nhiên, sức mạnh của chúng đi kèm các thách thức, bao gồm thiên lệch và cân nhắc đạo đức, cùng những xu hướng tương lai mới để khám phá.
Nếu bạn quan tâm đến thêm nội dung như thế này, hãy xem lộ trình kỹ năng AI Fundamentals của DataCamp, bao quát nhiều kiến thức thiết yếu để làm việc với các mô hình AI.
Các khóa học hàng đầu trên DataCamp
Khóa học
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
