

Corso
Concetti sui Large Language Models (LLM)
2 ore
113.3K
Pratica and corso your progress.
Continua Con GoogleSe dovessi descrivere la nuova era dell’IA con una parola, sceglierei scala. Da quando OpenAI ha rilasciato l’interfaccia web per GPT-3, conosciuta come ChatGPT, nel novembre 2022, la popolarità dei Large Language Model è cresciuta notevolmente grazie all’uso diffuso da parte del grande pubblico.
Scala si applica non solo alla popolarità di questi modelli, ma anche alle enormi quantità di dati su cui vengono addestrati, all’elevato numero di parametri e all’ampia gamma di compiti che possono svolgere.
Dal mio punto di vista, il boom di questo tipo di modelli ha inizialmente messo al centro i Large Language Model (LLM). Due anni dopo, grazie ai progressi in questo campo, credo che il termine di tendenza sia passato a foundation model.
Ma cosa sono i foundation model? E cosa rende un modello “fondazionale”?
A differenza degli LLM, i foundation model esistono nella comunità da moltissimo tempo. In questo articolo esploreremo il concetto di foundation model, concentrandoci sulle loro caratteristiche chiave, applicazioni e sul futuro nell’era dell’IA.
Prendi un’architettura di IA, come un transformer, e addestrala su enormi quantità di dati eterogenei: testi da Common Crawl e libri, immagini, video di YouTube e altro ancora.
Poiché questi dati sono ampi, generali e multimodali, il modello risultante diventa un sistema di grandi dimensioni e a uso generale, con una conoscenza estesa. Questo è un foundation model: un modello versatile e general-purpose che funge da “fondazione” per costruire applicazioni di IA specializzate.
Questi foundation model possono essere adattati a compiti specifici tramite fine-tuning, prompting o altre tecniche di transfer learning. L’idea è che, una volta specializzato in un dominio specifico, il modello mantenga le forti proprietà di generalizzazione e le capacità emergenti del modello base.
I primi sistemi di IA erano per lo più basati su regole e molto specifici per il dominio, richiedendo quindi una programmazione mirata al compito. I primi anni 2000 sono stati segnati dall’emergere del machine learning come passaggio verso approcci guidati dai dati, sebbene ancora limitati a compiti specifici.
La svolta del deep learning è arrivata intorno al 2012, consentendo un riconoscimento di pattern più complesso e modelli generativi avanzati, con due traguardi principali: le generative adversarial network nel 2014 e i transformer nel 2017.
La crescita dell’IA è stata fortemente sostenuta dai progressi nella potenza computazionale (ad es., GPU, TPU) e dalla disponibilità di dataset enormi, che hanno reso possibile addestrare modelli sempre più grandi, portando all’emergere dei foundation model.
La differenza tra i sistemi di IA tradizionali e i foundation model è definita anche dalla loro scala. Il passaggio dall’addestramento su dataset curati nei sistemi di IA tradizionali all’uso di dati massivi, diversificati e spesso non strutturati nei foundation model è un esempio. Inoltre, i foundation model mostrano forti capacità di generalizzazione, che permettono loro di affrontare compiti più complessi e vari, mentre i sistemi tradizionali di solito richiedono un riaddestramento o modifiche estese per nuovi compiti.
Ci sono alcune caratteristiche particolari che rendono unici i Foundation Model:
Per generalizzazione si intende la capacità di un modello di ottenere buone prestazioni su compiti non visti o, in concreto, su dati al di fuori del suo set di addestramento. I foundation model sono particolarmente preziosi per questa proprietà. Strettamente correlato, questi modelli possono anche mostrare abilità inattese, non previste in fase di training, che emergono su larga scala, note come comportamenti emergenti.
Mentre la generalizzazione è un risultato atteso dell’addestramento del modello, le capacità emergenti sono spesso imprevedibili, poiché i modelli non sono esplicitamente addestrati per tali scopi.
Inoltre, questi modelli sono scalabili, il che significa che le loro prestazioni possono migliorare aumentando la dimensione del modello (insieme a dati e risorse computazionali). Sebbene i modelli più grandi tendano a generalizzare meglio, la sola dimensione del modello non garantisce una generalizzazione migliore. Tuttavia, i comportamenti emergenti sono fortemente correlati alla dimensione del modello.
Per multimodalità si intende la capacità di un modello di IA di elaborare e integrare più tipi di dati, come testo, immagini, video e altro. Sebbene i Foundation Model possano essere multimodali, non è un requisito obbligatorio.
Uno degli aspetti chiave della multimodalità è la comprensione cross-modale, in cui il modello può comprendere e collegare informazioni tra tipi di dati diversi. Per esempio, combinare testo e immagini per generare didascalie per le foto o rispondere a domande su contenuti visivi. La multimodalità consente interazioni più ricche e apre la strada ad applicazioni in cui testo, visione e audio devono lavorare insieme, come nella robotica o nei sistemi sanitari.
Per un approfondimento sulla Multimodalità, ti consigliamo il nostro articolo, Che cos’è l’IA multimodale?
Infine, un altro aspetto chiave dei foundation model è che possono fungere da base per modelli specifici di dominio. Possiamo quindi adattarli a compiti o domini specifici regolando i loro pesi su un dataset più piccolo e specifico del dominio, beneficiando al contempo della loro multimodalità, capacità di generalizzazione e altre proprietà. Questo processo è noto come fine-tuning, di cui puoi saperne di più nella nostra guida al fine-tuning degli LLM.
Alcune tecniche di fine-tuning includono:
I Large Language Model sono un tipo specializzato di foundation model addestrato esclusivamente o prevalentemente su dati testuali. Un LLM può essere ulteriormente perfezionato per compiti specifici, come la traduzione o il riassunto.
La seguente tabella può aiutare a evidenziare differenze e somiglianze tra entrambe le categorie di modelli:
|
Aspetto |
Foundation Model |
Large Language Model |
|
Ambito |
Modelli general-purpose generalmente addestrati su dati multimodali. |
Sottoinsieme dei Foundation Model addestrati esclusivamente su dati testuali e talvolta perfezionati per un compito specifico. |
|
Dati di training |
Dataset eterogenei (e in genere multimodali). |
Principalmente corpora testuali. |
|
Architettura* |
Molteplici architetture: Transformer, Convolutional Neural Network (CNN) o architetture ibride a seconda del tipo di dato. |
Tipicamente architettura basata su Transformer. |
|
Casi d’uso |
Compiti generali multimodali. |
Incentrati su compiti linguistici: traduzione, riassunto, chatbot, generazione di codice, ecc. Oggi molto popolari nella società. Scopri i modelli open-source più popolari nella nostra guida. |
* Approfondiremo un po’ di più le architetture dei Foundation Model nella prossima sezione.
Pensando a un esempio più pratico, il primo modello GPT usato nell’interfaccia web di ChatGPT era GPT-3. Era un large language model puramente testuale e gli utenti potevano interagirci solo tramite prompt. Poiché gli LLM sono un sottoinsieme dei foundation model, anche GPT-3 era un foundation model.
Oggi, accedendo all’interfaccia di ChatGPT, possiamo allegare immagini insieme al prompt. Questo perché ora dietro l’interfaccia c’è GPT-4. GPT-4 è invece un foundation model multimodale.
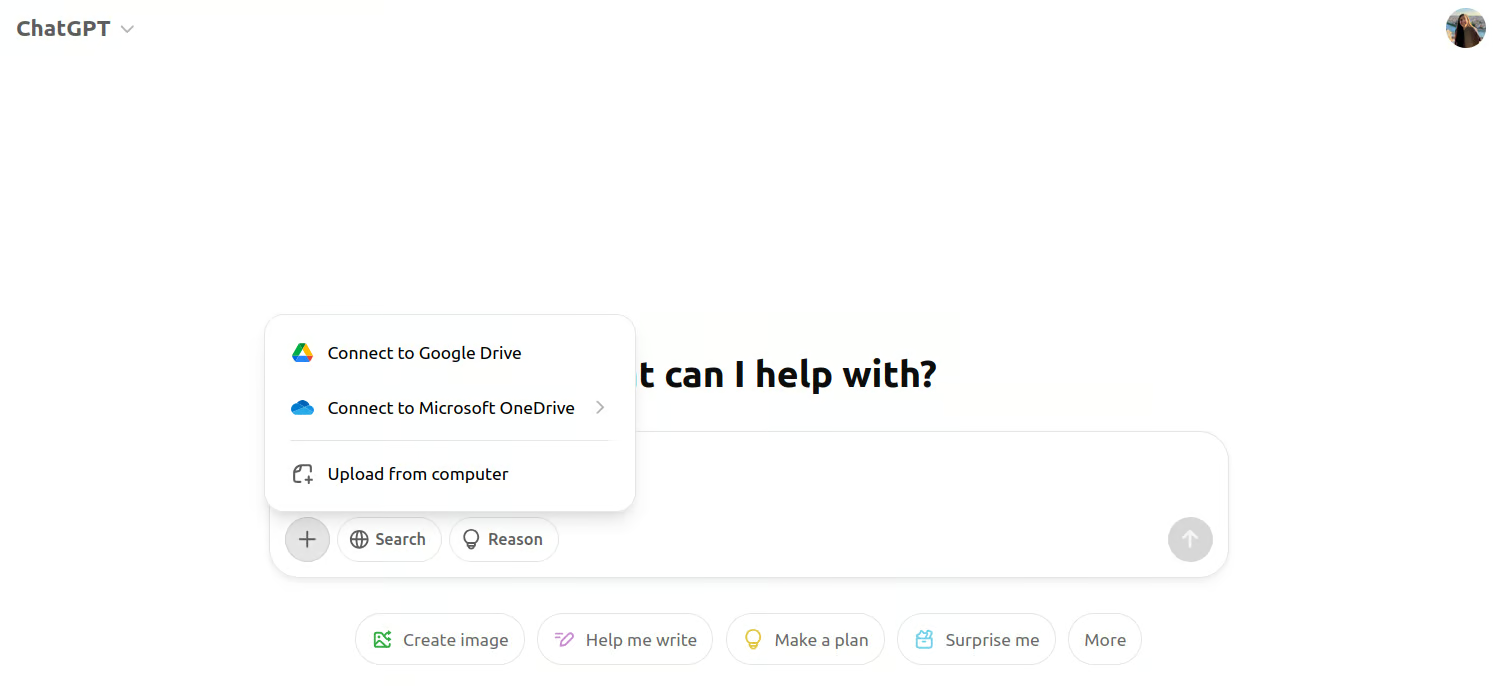
Screenshot dell’interfaccia multimodale di ChatGPT.
Poiché il nostro primo contatto con questi grandi modelli è avvenuto tramite gli LLM, si tende a pensare che l’architettura Transformer sia l’unica alla base dei foundation model.
Tuttavia, le Recurrent Neural Network (RNN) erano l’architettura di riferimento per i foundation model basati su testo prima che i Transformer diventassero popolari.
Nel campo della generazione di immagini, i modelli di diffusione sono oggi la spina dorsale di questi sistemi all’avanguardia. Alcuni modelli noti includono Stable Diffusion e DALL-E, ma le Convolutional Neural Network (CNN) venivano utilizzate prima di loro!
I modelli di diffusione sono considerati fondamentali per la generazione di immagini per le stesse ragioni discusse in precedenza: possono generare immagini di alta qualità e diversificate ed essere perfezionati per compiti specifici come l’editing o l’inpainting.
I Foundation Model sono utilizzati in vari domini grazie alla loro versatilità e adattabilità; tra questi:
Come già detto, i Foundation Model hanno portato notevoli miglioramenti nell’Elaborazione del Linguaggio Naturale. Le capacità simili a quelle umane di modelli come ChatGPT li hanno resi indispensabili in applicazioni di assistenza clienti, per esempio. Qualsiasi agente conversazionale online ora è probabilmente basato su LLM, in grado di sostenere conversazioni più naturali e coerenti rispetto ai precedenti chatbot basati su regole.
Questi modelli alimentano anche applicazioni di traduzione come Google Traduttore e DeepL. Usando questi strumenti oggi ti accorgerai che sono diventati più accurati e consapevoli del contesto rispetto a dieci anni fa.
Se ti interessano le applicazioni del linguaggio naturale, il corso “Developing AI Applications” ti darà una marcia in più!
Modelli come CLIP e DALL-E, ad esempio, combinano comprensione di testo e immagini, abilitando applicazioni come image captioning e generazione di immagini da testo, che non erano possibili con le architetture precedenti.
Tra gli strumenti, Adobe Photoshop ha incorporato i modelli di diffusione nei suoi strumenti di editing, ad esempio in Riempimento in base al contenuto e in altre funzionalità basate sull’IA per il completamento automatico delle immagini e l’inpainting.
Infine, esistono anche applicazioni multimodali che possono elaborare e integrare dati da più domini contemporaneamente. Per esempio, nei sistemi autonomi, Tesla e Waymo – il progetto di veicoli autonomi di Google – utilizzano sistemi multimodali che combinano dati visivi dalle telecamere, segnali radar e sensori LiDAR, con informazioni testuali e contestuali per navigare e comprendere l’ambiente.
Queste applicazioni cross-domain stanno trasformando i settori, abilitando sistemi più dinamici, adattabili e intelligenti che in precedenza erano limitati da modelli più ristretti.
Dopo aver visto queste applicazioni, possiamo classificare visivamente i modelli come nell’immagine seguente:
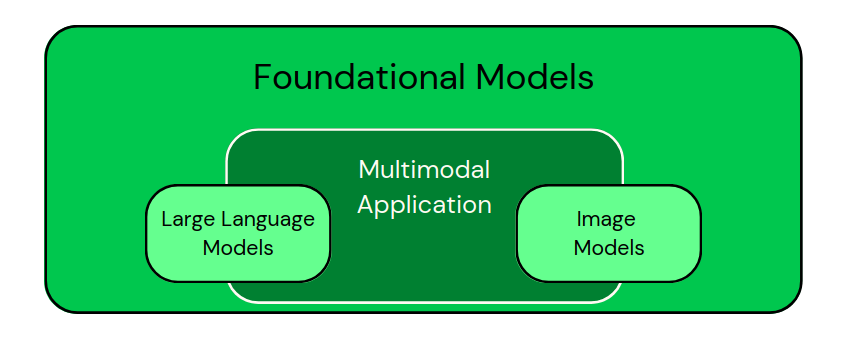
Classificazione dei modelli specifici di dominio come sottoinsiemi dei Foundation Model. Le applicazioni multimodali combinano diversi tipi di dati. - Immagine dell’autore
Se stai pensando di creare applicazioni basate su questi modelli, l’articolo “5 progetti che puoi creare con i modelli di IA generativa” ti darà ottimi spunti.
Come abbiamo visto, i foundation model hanno capacità maggiori, ma dobbiamo anche essere consapevoli che comportano diverse sfide e considerazioni etiche:
L’addestramento di questi modelli è altamente intensivo in termini di risorse di tempo ed energia. Una volta addestrati, questi modelli richiedono ancora risorse notevoli per l’inferenza, soprattutto nelle applicazioni in tempo reale, rendendoli costosi da usare su larga scala. Man mano che i modelli crescono in dimensioni e complessità, aumenta anche il carico computazionale.
Il costo è una sfida particolare per le istituzioni di ricerca e le aziende più piccole, che potrebbero non avere i mezzi per addestrare grandi modelli da zero, permettendo alle grandi aziende di dominare la ricerca in questo campo. A mio avviso, la disponibilità di modelli open-source pre-addestrati aiuterà in entrambi i sensi.
Strettamente legato ai costi, l’impatto ambientale di questi modelli è una preoccupazione crescente. L’addestramento di grandi modelli di IA consuma una quantità significativa di energia, contribuendo a un’elevata impronta di carbonio.
L’uso crescente dell’IA e il pre-training di modelli sempre più grandi intensificano le preoccupazioni sulla sostenibilità. Si stanno compiendo sforzi per ridurre il consumo energetico attraverso algoritmi e hardware più efficienti, nonché l’adozione di fonti rinnovabili nei data center, ma il problema resta cruciale.
I foundation model non sono esenti dal rischio di bias. Come per molti algoritmi di deep learning, questo rischio deriva dalle enormi quantità di dati reali su cui vengono addestrati. I modelli ereditano inevitabilmente i bias presenti nei dati, il che può portare a esiti ingiusti o discriminatori in applicazioni sensibili.
Mitigare il bias è essenziale e può essere ottenuto con strategie come l’implementazione di algoritmi per l’equità, la diversificazione dei dataset di training e audit regolari dei modelli per assicurarsi che non perpetuino bias dannosi.
Infine, le questioni regolatorie legate all’uso dei foundation model stanno diventando più pressanti. Man mano che questi modelli diventano più potenti e vengono distribuiti in vari settori, governi e organismi internazionali stanno lavorando per stabilire quadri normativi per la sicurezza e la responsabilità dell’IA.
Garantire la conformità agli standard globali, come l’AI Act dell’UE, sarà cruciale per gestire i rischi associati alla distribuzione dell’IA, inclusi problemi di privacy e disinformazione. Puoi aggiornarti su queste normative con lo skill track di DataCamp EU AI Act Fundamentals.
Una delle tendenze più evidenti nei foundation model è l’evoluzione delle capacità multimodali. Questi modelli sono sempre più progettati per elaborare e integrare diversi tipi di dati in un quadro unificato.
Questo approccio multimodale consente ai sistemi di IA di comprendere e interagire meglio con il mondo; alcuni sostengono persino che lo facciano in un modo che rispecchia la cognizione umana. Man mano che queste capacità maturano, sono certo che abiliteranno applicazioni più complete.
Un’altra tendenza entusiasmante è la prospettiva di un’adattabilità in tempo reale. Gli attuali foundation model richiedono un ampio pre-training e fine-tuning per adattarsi a compiti specifici. Tuttavia, ci si aspetta che i modelli futuri diventino più dinamici, capaci di apprendere e adattarsi in tempo reale quando incontrano nuovi dati o ambienti.
Questa possibilità consentirà ai sistemi di IA di rispondere in modo più efficace a condizioni in evoluzione, come le preferenze degli utenti o le nuove tendenze nei dati.
Infine, anche le innovazioni per rendere i modelli più leggeri e accessibili sono una necessità sia per ridurre il consumo energetico e i costi, sia per democratizzare l’uso delle tecnologie di IA fondazionale.
La ricerca in corso mira a ridurre le dimensioni e le richieste di risorse di questi modelli senza comprometterne le prestazioni. Si stanno esplorando tecniche come distillazione del modello, quantizzazione e progettazione di architetture efficienti per creare modelli più piccoli, veloci ed energeticamente efficienti.
Inoltre, i modelli leggeri consentiranno la distribuzione su dispositivi edge, come smartphone e dispositivi IoT, portando le capacità dell’IA più vicino agli utenti finali nelle applicazioni del mondo reale.
Vorrei assicurarmi che, a questo punto, possiamo rispondere alla domanda posta nell’introduzione: “Cosa rende un foundation model “fondazionale”?”.
Un modello è “fondazionale” quando è general-purpose, capace di generalizzare su compiti diversi e può essere specializzato per compiti più ristretti. I foundation model abilitano lo sviluppo di modelli specifici di compito fungendo da base per il fine-tuning in vari domini. Tuttavia, la loro potenza comporta sfide, tra cui bias e questioni etiche, e introduce nuove tendenze future da esplorare.
Se ti interessa altro contenuto come questo, dai un’occhiata allo skill track di DataCamp AI Fundamentals, che copre molti degli elementi essenziali per lavorare con i modelli di IA.
I migliori corsi DataCamp
Corso
Corso
Pratica and corso your progress.
Continua Con Googleblog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



