
知识图谱与 LLM 如何协同工作
现在,让我们看看如何利用知识图谱来增强 LLM。
用于语境理解的知识图谱
LLM 能生成行文良好的文本,但它无法评估文本的事实准确性。在多数情况下,原始训练数据集并不包含与具体实践任务相关的信息(例如特定用户手册),难以回答关于如何使用特定工具的用户问题。
若 LLM 能访问具备语境与领域特定的信息,它就可以利用这些知识构建有意义且正确的回答。KG 允许 LLM 以编程方式访问相关且真实的信息,从而更好地响应用户查询。
LLM 用于查询并对接知识图谱
知识图谱擅长以语义方式组织、存储与检索信息。然而,它们只能通过诸如 SPARQL(用于操作与检索 RDF 格式数据的数据库查询语言)等专用查询语言访问。
KG 的输出同样是代码形式,用户需要专门训练才能解读。LLM 通过将自然语言请求转换为查询语言,并把 KG 的输出生成易读的自然语言文本来弥合这一鸿沟,从而让非技术用户也能与 KG 交互。
动态知识集成
LLM 生成的文本取决于训练数据集,而当模型投入生产时,这些数据往往已经过时。持续用最新信息重训 LLM 资源开销巨大,因而不切实际。
然而,KG 与其他数据库一样,能够轻松实现实时更新。根据新信息更新节点之间的连接只需极少的计算开销。因此,通过与 KG 集成,LLM 可访问实时更新的信息并提供最新的回答。
示例工作流
以下步骤概述了一个将 KG 与 LLM 结合、为用户查询提供最新回答的示例工作流要点。
- 用户以自然语言输入查询。
- LLM 基于用户请求生成一种编程语言的查询。
- KG 接收来自 LLM 的查询,并以原始数据格式(如 JSON)返回相关信息。
- LLM 基于 KG 的输出生成自然语言回答。
- 用户以自然语言接收回答。
下图为上述步骤的示意图:
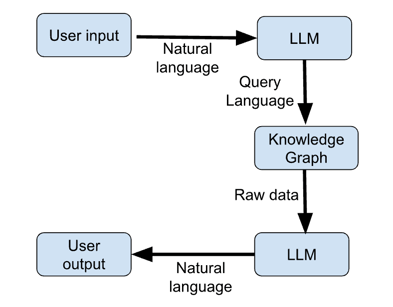
图 1:LLM + KG 工作流(作者制图)
知识图谱在生成式 AI 中的用例
将 KG 与 GenAI 集成可以实现许多用例。我们来看看其中最有意思的几个。
增强型对话式 AI
KG 向聊天机器人提供结构化、最新的知识库,机器人可编程式地访问,以获取时下信息并对用户查询给出更相关的回答。
KG 补充了聊天机器人基于训练数据集所具备的默认知识。机器人通过训练数据学会如何构造句子,并从 KG 获取与应用相关的特定信息。因此,借助 KG 还能在无需重训的情况下,将同一聊天机器人架构应用于不同场景。
个性化推荐
LLM 已被用作推荐引擎。
例如,LLM 可分析一篇文章的内容并推荐相关的文章。LLM 也用于打造交互式系统,用户可以“与”推荐引擎“对话”。
KG 能组织并存储用户行为、兴趣、互动等信息。LLM 可分析这些信息并用其生成定制化回应,从而让用户获得基于个人偏好的个性化推荐。
科学研究与特定领域应用
在医学、金融、法律等知识密集型领域,LLM 与 KG 的结合改善了信息获取的便捷性。
在医学中,它们可基于患者症状与病史给出可能的诊断。在金融中,它们通过更便捷地获取财报中的相关信息来辅助分析师工作。在法律中,它们可帮助律师检索相关判例与裁决,并为大型法律文书提供摘要。
实时知识检索
将大语言模型与知识图谱结合,对新闻聚合与股市分析等实时应用至关重要。
传统 LLM 对训练之后才发生的事件一无所知,因此无法就时事相关问题给出有意义的回答。
KG 善于实时处理与组织新信息,从而为 LLM 提供信息学后端,以应对基于时事(新闻聚合)与快速变化环境(如股市)的应用。
在生成式 AI 中实现知识图谱的工具与框架
前文讨论了 LLM 与 KG 的基本原理。本节介绍用于集成 KG 与 LLM 的工具与库。
图数据库工具
KG 最常见的实现方式是使用如下图数据库:
Neo4j
一款专用图数据库(仅支持图)。Neo4j 使用Cypher,这是一种声明式图查询语言,用于插入与检索信息。Cypher 在风格上与 SQL 类似,便于开发者上手。
Neo4j 高效管理复杂的互联数据,因为其底层数据存储引擎从零开始构建,契合图数据库用例。它可连接 Apache Kafka 等外部数据源,且易于水平扩展,因此是图数据库的常见之选。
ArangoDB
ArangoDB 是一款多模型图数据库。除图之外,它还支持 JSON 文档与键值存储。这使用户可以用难以直接转为图格式的其他信息来增强图数据。
由于这种灵活性,它常被偏好用于需处理多种数据类型的企业应用。它使用 Arango 查询语言(AQL)跨所有数据类型工作。在底层,ArangoDB 使用 RocksDB 作为数据存储引擎。
Amazon Neptune
亚马逊的 Neptune 同时支持属性图与 RDF(资源描述框架)模型,使用 SPARQL 与 Gremlin 查询语言。它可无缝集成进 AWS 基础设施,作为全托管图数据库运行,因而常被用于与现有企业基础设施集成。
用于集成的库
LLM 与图数据库优势互补,但通常无法直接对接。下文将介绍用于将数据在 KG 与 LLM 之间传递的集成库与框架。
RDFlib
RDFlib 是一个用于处理RDF 数据的开源 Python 包。它具备操作与查询 RDF 图的功能,便于与知识图谱集成。它可将 RDF 数据存储在内存、磁盘,或通过 SPARQL 端点进行远程存储。SPARQL 端点类似于 API 端点,可接收并处理远程 SPARQL 查询。
RDFlib 使用由主语-谓语-宾语三元组构成的图数据结构。三元组的每个组成部分都是 URI 或字面量。它提供了解析与序列化三元组、XML 及 JSON-LD 等数据类型的功能。
PyTorch Geometric
PyTorch Geometric(PyG)是一个基于 PyTorch 的库,用于创建并训练图神经网络(GNN)。GNN 是一种在图上运行、可接受图数据结构作为输入的神经网络架构。PyG 提供了将深度学习技术应用于图的功能。
PyG 自带多种预构建的 GNN 架构,可直接实现或通过消息传递 API 进一步扩展。
据称 PyG 适合包含数百万节点、且节点与边类型多样的大规模应用。该子领域也称为几何深度学习。
传统神经网络擅长编码线性关系,但现实世界数据往往复杂且多维。图更善于表示更高维度的相互关联,其中图中的任意节点都可能与其他任意节点有关联,这使图更适合存储复杂的现实关系。
LangChain
LangChain 于 2022 年推出,作为语言模型集成框架。它通过将 LLM 与其他相关工具(如 API 封装、Shell 脚本、网页爬取、PDF 阅读器、Google 文档、关系型数据库、向量数据库与图数据库(包括 KG))串联起来,帮助构建用户应用。因此,它常用于创建涉及 LLM 的应用。
OpenAI API
OpenAI API 免去了使用 PyG 等工具自行搭建管道的麻烦。OpenAI API 能接收用户的自然语言查询、理解其意图,并返回某种编程语言(如 SPARQL)的结构化查询。该查询被送入 KG,KG 返回相关数据。随后,这些数据与原始查询的语境一并发送回 OpenAI API,OpenAI 的 LLM 基于来自 KG 的数据生成自然语言回答。
OpenAI API 允许您根据任务与预算在多种 LLM 中进行选择。因此,您无需自行部署 LLM 或与 KG 对接的数据管道。
示例集成工作流
本节以伪代码给出一个集成管道的高层示例。
我们使用 Neo4j、LangChain 与 OpenAI API 演示如何构建一个基于 RAG 的聊天机器人。LLM 将基于 KG 中存储的信息生成回答。
## Import relevant packages
# Handling chat prompts
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.prompts.prompt import PromptTemplate
from langchain_openai import ChatOpenAI
# Implementing the Runnable protocol for chaining components
from langchain_core.runnables import (
RunnableBranch,
RunnableLambda,
RunnableParallel,
RunnablePassthrough,
# Processing text inputs in the chat
from langchain_core.messages import AIMessage, HumanMessage
from langchain_core.output_parsers import StrOutputParser
# Working with Neo4j graphs
from neo4j import GraphDatabase
from langchain_community.graphs import Neo4jGraph
from langchain_experimental.graph_transformers import LLMGraphTransformer
# Vector embeddings for the LLM
from langchain_openai import OpenAIEmbeddings
from langchain_community.vectorstores import Neo4jVector
# Load data from a source like Wiki, PDF documents, etc.
from langchain.document_loaders import WikipediaLoader
# Create a Neo4jGraph to store the KG
graph = Neo4jGraph()
# Load the document(s) based on which to build the KG. In this snippet, we use Wiki. In practice, this is a business-specific document
raw_documents = WikipediaLoader(...).load()
# Split the document into tokens
documents = create_tokens(raw_documents)
# Instantiate the LLM
llm = ChatOpenAI(model_name="...", …)
llm_transformer = LLMGraphTransformer(llm=llm)
# Use the LLM to convert the tokenized documents into graph entities
graph_docs = llm_transformer.convert_to_graph_documents(documents)
# Add the graph entities to the Neo4j graph
graph.add_graph_documents(graph_docs, …)
# Create a retriever to run on the graph
graph.query(
"CREATE FULLTEXT INDEX entity IF NOT EXISTS FOR (e:__Entity__) ON EACH [e.id]")
# Create a class to extract entities from the text corresponding to nodes from the graph
class Entities(BaseModel):
names: List[str] = Field(
...,
description="All the person, organization, or business entities that appear in the text",
)
# Create a prompt template
prompt = ChatPromptTemplate.from_messages(
[
(
"system",
"You are extracting organization and person entities from the text.",
),
(
"human",
"Use the given format to extract information from the following "
"input: {question}",
),
]
)
# Create a chain by piping the prompt to the LLM with the Entities class.
# This chain identifies entities in a given prompt string
entity_chain = prompt | llm.with_structured_output(Entities)
# Create a structured retriever to extract the entities in the query. Given a text query, it retrieves all the relevant nodes in the neighborhood of the entities in that query.
def structured_retriever(question: str) -> str:
result = ""
entities = entity_chain.invoke({"question": question})
for entity in entities.names:
response = graph.query(
# CYPHER QUERY TEMPLATE,
{"query": generate_full_text_query(entity)})
result += el['output'] for el in response
return result
# Chain together the different components
chain = (
RunnableParallel(
{
"context": _search_query | retriever,
"question": RunnablePassthrough(),
}
)
| prompt
| llm
| StrOutputParser()
)
# Invoke the chain
chain.invoke({"question": "The user’s question goes here"})结合知识图谱与 LLM 的最佳实践
KG 可增强 LLM 的能力,使其适用于实际用例。为获得最佳表现,我建议遵循以下最佳实践。
保持图谱最新
KG 包含了 LLM 据以生成回答的信息库。因此必须持续用最新信息更新图数据库。过时的 KG 会导致 LLM 给出过时的答案。
优化查询效率
LLM 与 KG 都是计算需求较高的复杂软件。如上一节所示,将二者串联涉及多步流程,从对用户查询进行分词与生成相应的图查询,到从 KG 检索信息并据此生成文本。
这可能导致低效与时延。如下所述的优化方法有助于尽量降低延迟。
- 缓存将常用数据存放于高速存储中,避免重复计算常见结果。
- 查询结果: 可使用键值存储保存对 KG 的常见查询结果。
- LLM 向量嵌入: 可缓存常见输入查询的嵌入向量,避免反复访问 LLM API,从而节省时间与成本。
- 查询优化涉及重写数据库查询并使用合适的索引,使数据库访问更高效。
- 索引 有助于快速访问图元素,如节点、关系及其属性。针对常用数据建立合适类型的索引,可加速查询与关系查找。
- 查询参数化 即为常见查询结构创建并缓存优化后的参数化版本,并用占位符替换用户查询词,使执行与返回更快速。
- 异步查询 可确保 LLM 无需等待 KG 返回响应。LLM 可以发出多个数据库查询,并在响应返回时逐步处理。
- 负载均衡 有助于将用户查询分发到副本数据库与多个语言模型上。识别瓶颈在 LLM 还是 KG,并对其进行水平扩展,以便其他链路组件可持续处理。
缩小语言模型规模
LLM 占用内存较大,常需昂贵硬件支持。可通过蒸馏与量化等技术来缩小模型规模:
- LLM 蒸馏是一种使用更小的“学生模型”复现更大“教师模型”响应的技术。仅教师模型在原始数据集上训练,学生模型只通过在大量输入上匹配教师响应来训练。此过程称为知识蒸馏,成本远低于从零训练模型。但学生模型在未见过的新查询上的表现可能不够可靠。
- LLM 量化是指降低模型权重的精度。AI 模型的大部分内存与计算开销源于对模型权重进行的大规模矩阵乘法。基础模型的权重通常以 32 位或 16 位浮点数表示;已有观察表明,将权重量化为 8 位整数(某些情况下甚至低至 1 位)可在显著缩小规模与成本的同时,获得可比的性能。
评估 LLM 性能
您应确保所选语言模型能良好处理其预期要应对的查询类型。
如 MLFlow 等工具可用于评估 LLM 在各类任务上的表现。正如用户需求会变化,知识图谱中存储的信息也会随时间改变。因此,部署后定期重新评估 LLM 的性能至关重要。可能需要在更新数据集上微调模型、使用更新版本,甚至更换新模型。
用领域数据微调 LLM
LLM 从 KG 获取信息,从其训练数据集中获得语言与推理能力。
基础 LLM 通常在覆盖全网的海量通用数据集上训练。用领域特定数据集进行微调,可增强其在该领域的推理能力,并使其能够用合适的结构与术语组织句子。比如,若要使用某医学 KG 来回答医学问题,我强烈建议先在医学文本数据集上对基础 LLM 进行微调。
结语
本文讨论了大语言模型(LLM)与知识图谱(KG)的基本原理及其如何相辅相成。我们还介绍了用于将 LLM 与 KG 结合以构建面向用户应用的一些常用工具。最后,我们给出了如何借助 LangChain 将 Neo4j 与 OpenAI 搭配使用的高层示例。
在理解这些基础概念后,您可以动手实践这些工具:
- 第一步,可先学习使用 Python 的 LLM 入门课程。
- 如果您已熟悉 LLM 基础,欢迎学习用 LangChain 构建检索增强生成(RAG)系统。
- 最后,若您要部署生产系统,建议学习LLMOps 概念课程。

大语言模型(LLM)已在从内容创作到问答系统的各类应用中大显身手。注意力机制帮助基于 Transformer 的模型写出行文流畅的句子并进行对话。
然而,LLM 在处理基于事实的信息时表现乏力,幻觉是常见问题。知识图谱(KG)有助于组织并可视化呈现信息。将 LLM 与 KG 结合,是解决 LLM 常见问题并让其更适用于信息检索场景的一种有前景的方法。
本文先从 KG 与 LLM 的第一性原理讲起,再讨论它们如何协同工作。我们还将涵盖实用示例以及将 KG 与 LLM 搭配时常用的工具。
什么是知识图谱?
知识图谱(KG)使用图结构来表示并存储知识库中的信息。图中的节点代表实体,如物体、地点、人物等;边则表示不同实体之间的关系(如“是客户”“出生于”等)。
KG 也被称为语义网络,因为它存储了不同实体之间如何相互关联的信息。
知识图谱的特性包括:
知识图谱自20 世纪 80 年代起便已存在。但在 2012 年谷歌知识图谱普及后才广为人知并被广泛应用。一些现代 KG 示例包括:
资源描述框架(RDF)
在图数据库的语境下,您也应了解资源描述框架(RDF)。
RDF 是一种在网页上表示结构化图数据的规范。它以三元组的形式表示数据。一个三元组由主语(网页上的资源)、宾语(另一资源)以及谓语(定义二者之间的关系)组成。
RDF 使用 URI 表达主语、宾语与谓语。这种链接结构形成一个有向标注图,因此 RDF 构成了语义网的基础。它有助于构建封装网页上各类资源关系的 KG。
什么是生成式 AI 与大语言模型(LLM)?
生成式 AI(GenAI)指能够基于用户提示创建(生成)新内容的软件模型。不同类型的 GenAI 系统可生成文本、图像、音乐、代码等。Transformer、扩散模型与 GAN 是常见的 GenAI 模型示例。
大语言模型(LLM)通常是基于 Transformer 的模型,使用深度学习技术在大规模文本数据集上训练。它们能够为句子补全、摘要生成、翻译、新文本生成等任务输出文本。