
Last chance! 50% off DataCamp Premium
Sale ends in
Buy Now

Oefen en volg je voortgang.
Ga verder met GoogleDoor verder te gaan, accepteer je ons Gebruiksvoorwaarden, onze Privacybeleid en dat je gegevens in de VS worden opgeslagen.Laten we nu bekijken hoe kennisgrafen LLM’s kunnen versterken.
LLM’s kunnen goedgeschreven tekst genereren, maar ze kunnen de feitelijke juistheid ervan niet beoordelen. In de meeste gevallen bevatte de oorspronkelijke trainingsdataset geen informatie (zoals een specifieke handleiding) die relevant is voor een praktische taak (zoals gebruikersvragen beantwoorden over het gebruik van een specifieke tool).
Een LLM met toegang tot contextuele en domeinspecifieke informatie kan die kennis gebruiken om betekenisvolle en correcte antwoorden te formuleren. KG’s geven LLM’s programmatiche toegang tot relevante en feitelijke informatie, waardoor ze beter op gebruikersvragen kunnen reageren.
Kennisgrafen zijn goed in het semantisch organiseren, opslaan en ophalen van informatie. Je kunt ze echter alleen benaderen via gespecialiseerde querytalen zoals SPARQL (een databasequerytaal voor het bewerken en ophalen van data in RDF-formaat).
De output van KG’s is ook in codevorm en gebruikers hebben specifieke training nodig om die te interpreteren. LLM’s overbruggen deze kloof door platte taal van gebruikers om te zetten naar een querytaal en door mensleesbare tekst te genereren uit de output van de KG. Zo kunnen niet-technische gebruikers met KG’s werken.
De tekst die LLM’s genereren is afhankelijk van de trainingsdataset, die vaak verouderd is tegen de tijd dat het LLM in productie gaat. LLM’s continu hertrainen op actuele informatie kost veel middelen en is dus onpraktisch.
KG’s kunnen daarentegen, net als andere databases, eenvoudig realtime worden bijgewerkt. Er is slechts een kleine rekenkundige overhead om de verbindingen tussen knopen op basis van nieuwe informatie bij te werken. Door te integreren met KG’s kunnen LLM’s dus informatie in realtime benaderen en actuele antwoorden geven.
De onderstaande stappen schetsen een voorbeeldworkflow die KG’s en LLM’s samen gebruikt om actuele antwoorden op gebruikersvragen te geven.
De onderstaande figuur toont een schematische weergave van deze stappen:
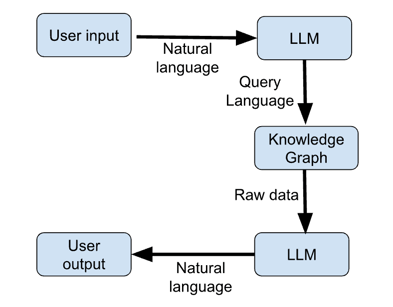
Figuur 1: LLM + KG-workflow (afbeelding door auteur)
Er zijn veel use-cases mogelijk dankzij de integratie van KG’s en GenAI. Laten we de interessantste bekijken.
KG’s bieden een gestructureerde en actuele kennisbron die een chatbot programmatisch kan benaderen om actuele informatie op te halen en relevantere antwoorden te geven op gebruikersvragen.
De KG vult de standaardkennis van de chatbot aan, die gebaseerd is op de trainingsdataset. De chatbot leert zinnen bouwen op basis van de trainingsdata en krijgt toepassingsspecifieke informatie uit de KG. Daardoor kun je met KG’s dezelfde chatbotarchitectuur voor verschillende toepassingen gebruiken zonder te hertrainen.
LLM’s zijn gebruikt als aanbevelingssystemen.
Zo kan een LLM de inhoud van een artikel analyseren en relevante artikelen aanbevelen. LLM’s worden ook gebruikt om interactieve systemen te maken, waarbij de gebruiker “kan praten” met de aanbevelingsmachine.
KG’s kunnen informatie over gebruikersgedrag, interesses, interacties enzovoort organiseren en opslaan. LLM’s kunnen deze informatie analyseren en gebruiken om op maat gemaakte reacties te genereren. Zo profiteren gebruikers van persoonlijke aanbevelingen op basis van hun individuele voorkeuren.
In kennisintensieve domeinen zoals geneeskunde, financiën en recht verbeteren LLM’s in combinatie met KG’s de toegankelijkheid van informatie.
In de geneeskunde suggereren ze mogelijke diagnoses op basis van symptomen en voorgeschiedenis. In de financiële sector ondersteunen ze analisten door relevante informatie uit financiële rapporten makkelijker toegankelijk te maken. In het recht helpen ze juristen bij het terugvinden van relevante jurisprudentie en het samenvatten van omvangrijke juridische documenten.
Het combineren van grote taalmodellen met kennisgrafen is cruciaal in realtime toepassingen zoals nieuwsaggregatie en aandelenmarktanalyse.
Traditionele LLM’s weten niets van gebeurtenissen die niet in hun training voorkwamen. Daardoor kunnen ze geen zinvolle antwoorden geven op vragen over actualiteiten.
KG’s zijn efficiënt in het verwerken en ordenen van nieuwe informatie in realtime. Zo vormen ze de informatica-backend voor LLM’s om toepassingen met actualiteiten (nieuwsaggregatie) en snel veranderende omgevingen (bijv. de aandelenmarkt) aan te kunnen.
De vorige secties bespraken de basisprincipes van LLM’s en KG’s. In deze sectie introduceren we de tools en libraries voor de integratie van KG’s en LLM’s.
KG’s worden meestal geïmplementeerd met grafdatabases zoals:
Een gespecialiseerde grafdatabase (werkt uitsluitend met grafen). Neo4j gebruikt Cypher, een declaratieve grafquerytaal, om informatie in te voegen en op te halen. Cypher lijkt qua stijl op SQL, wat het voor ontwikkelaars makkelijker maakt om te leren.
Neo4j beheert complex onderling verbonden data efficiënt omdat de onderliggende opslagengine vanaf de grond is opgebouwd voor grafdatabase-use-cases. Het is een populaire keuze omdat het verbinding maakt met externe databronnen zoals Apache Kafka en eenvoudig horizontaal schaalt.
ArangoDB is een multimodel-grafdatabase. Naast grafen ondersteunt het ook JSON-documenten en key-value stores. Hierdoor kun je grafen verrijken met andere informatie die zich niet eenvoudig laat omzetten naar grafformaat.
Dankzij deze flexibiliteit heeft het vaak de voorkeur in enterprise-toepassingen die met verschillende datatypes werken. Het gebruikt de Arango Query Language (AQL) om over alle datatypes heen te werken. Onder de motorkap gebruikt ArangoDB RocksDB als opslagengine.
Amazon Neptune ondersteunt property graphs en RDF (Resource Description Framework)-modellen. Het gebruikt de querytalen SPARQL en Gremlin. Het integreert naadloos in de AWS-infrastructuur om als volledig beheerde grafdatabase te draaien, waardoor het vaak wordt gekozen voor integratie met bestaande enterprise-infrastructuur.
LLM’s en grafdatabases vullen elkaar aan maar kunnen doorgaans niet direct met elkaar communiceren. In de volgende alinea’s bespreken we integratielibraries en frameworks die data van KG’s naar LLM’s en omgekeerd doorgeven.
RDFlib is een open-source Python-package voor werken met RDF-data. Het heeft functies om RDF-grafen te manipuleren en te bevragen. Dit vergemakkelijkt de integratie met kennisgrafen. Je kunt RDF-data in het geheugen, op schijf of op afstand via SPARQL-endpoints opslaan. Een SPARQL-endpoint, analoog aan een API-endpoint, kan externe SPARQL-queries ontvangen en verwerken.
RDFlib werkt met grafgebaseerde datastructuren die uit subject-predicaat-objecttriples bestaan. Elk onderdeel van de triple is een URI of een letterlijke waarde. Het heeft functies om triples, XML en andere datatypes zoals JSON-LD te parsen en te serialiseren.
PyTorch Geometric (PyG) is een op PyTorch gebaseerde library die is ontworpen om te trainen met Graph Neural Networks (GNN’s) te maken. Een GNN is een neurale netwerkarchitectuur die op grafen werkt en graafdatastructuren als input kan accepteren. PyG heeft functies om deep learning-technieken op grafen toe te passen.
PyG wordt geleverd met veel voorgebouwde GNN-architecturen die je direct kunt implementeren of verder kunt uitbreiden via de message-passing-API.
PyG zou geschikt zijn voor grootschalige toepassingen met miljoenen knopen over verschillende typen knopen en randen. Dit subveld staat ook bekend als geometrisch deep learning.
Traditionele neurale netwerken zijn goed in het encoderen van lineaire relaties, maar data uit de echte wereld is vaak complex en multidimensionaal. Grafen representeren beter hogere-dimensionale verbanden waarin elke knoop in een graaf met elke andere knoop kan samenhangen. Daardoor zijn grafen beter geschikt om complexe relaties uit de echte wereld op te slaan.
LangChain werd in 2022 gelanceerd als integratiekader voor taalmodellen. Het faciliteert het bouwen van gebruikersapplicaties door LLM’s te koppelen aan andere relevante tools, zoals API-wrappers, shellscripts, webscrapers, PDF-lezers, Google Docs, relationele databases, vectordatabases en grafdatabases (inclusief KG’s). Het wordt daarom veel gebruikt om toepassingen met LLM’s te bouwen.
OpenAI-API’s nemen de moeite weg om een pijplijn te bouwen met tools zoals PyG. De OpenAI API kan een natuurlijke-taalvraag van een gebruiker ontvangen, die begrijpen en een gestructureerde query in een programmeertaal (bijv. SPARQL) teruggeven. Deze query gaat naar de KG, die de relevante data retourneert. Die data gaat terug naar de OpenAI API, samen met de context van de oorspronkelijke vraag. Het OpenAI-LLM genereert vervolgens een antwoord in natuurlijke taal op basis van de data uit de KG.
Met OpenAI-API’s kun je kiezen uit verschillende LLM’s, afhankelijk van taak en budget. Je hoeft dus geen LLM’s te deployen of de datapijplijnen te bouwen om met de KG te koppelen.
In deze sectie geven we een illustratie op hoog niveau van een integratiepijplijn met pseudocode.
We gebruiken Neo4j, LangChain en de OpenAI API om de stappen te tonen voor het bouwen van een chatbot op basis van RAG. Het LLM genereert zijn antwoord op basis van informatie die in de KG is opgeslagen.
## Import relevant packages
# Handling chat prompts
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.prompts.prompt import PromptTemplate
from langchain_openai import ChatOpenAI
# Implementing the Runnable protocol for chaining components
from langchain_core.runnables import (
RunnableBranch,
RunnableLambda,
RunnableParallel,
RunnablePassthrough,
# Processing text inputs in the chat
from langchain_core.messages import AIMessage, HumanMessage
from langchain_core.output_parsers import StrOutputParser
# Working with Neo4j graphs
from neo4j import GraphDatabase
from langchain_community.graphs import Neo4jGraph
from langchain_experimental.graph_transformers import LLMGraphTransformer
# Vector embeddings for the LLM
from langchain_openai import OpenAIEmbeddings
from langchain_community.vectorstores import Neo4jVector
# Load data from a source like Wiki, PDF documents, etc.
from langchain.document_loaders import WikipediaLoader
# Create a Neo4jGraph to store the KG
graph = Neo4jGraph()
# Load the document(s) based on which to build the KG. In this snippet, we use Wiki. In practice, this is a business-specific document
raw_documents = WikipediaLoader(...).load()
# Split the document into tokens
documents = create_tokens(raw_documents)
# Instantiate the LLM
llm = ChatOpenAI(model_name="...", …)
llm_transformer = LLMGraphTransformer(llm=llm)
# Use the LLM to convert the tokenized documents into graph entities
graph_docs = llm_transformer.convert_to_graph_documents(documents)
# Add the graph entities to the Neo4j graph
graph.add_graph_documents(graph_docs, …)
# Create a retriever to run on the graph
graph.query(
"CREATE FULLTEXT INDEX entity IF NOT EXISTS FOR (e:__Entity__) ON EACH [e.id]")
# Create a class to extract entities from the text corresponding to nodes from the graph
class Entities(BaseModel):
names: List[str] = Field(
...,
description="All the person, organization, or business entities that appear in the text",
)
# Create a prompt template
prompt = ChatPromptTemplate.from_messages(
[
(
"system",
"You are extracting organization and person entities from the text.",
),
(
"human",
"Use the given format to extract information from the following "
"input: {question}",
),
]
)
# Create a chain by piping the prompt to the LLM with the Entities class.
# This chain identifies entities in a given prompt string
entity_chain = prompt | llm.with_structured_output(Entities)
# Create a structured retriever to extract the entities in the query. Given a text query, it retrieves all the relevant nodes in the neighborhood of the entities in that query.
def structured_retriever(question: str) -> str:
result = ""
entities = entity_chain.invoke({"question": question})
for entity in entities.names:
response = graph.query(
# CYPHER QUERY TEMPLATE,
{"query": generate_full_text_query(entity)})
result += el['output'] for el in response
return result
# Chain together the different components
chain = (
RunnableParallel(
{
"context": _search_query | retriever,
"question": RunnablePassthrough(),
}
)
| prompt
| llm
| StrOutputParser()
)
# Invoke the chain
chain.invoke({"question": "The user’s question goes here"})KG’s vergroten de mogelijkheden van LLM’s en maken ze relevanter voor praktische use-cases. Voor de beste prestaties raad ik de volgende best practices aan.
De KG bevat de kennisbron waarop het LLM zijn antwoorden baseert. Daarom is het noodzakelijk de grafdatabase continu met de nieuwste informatie bij te werken. Een verouderde KG leidt ertoe dat het LLM verouderde antwoorden geeft.
LLM’s en KG’s zijn complexe software met hoge rekenvereisten. Zoals in de vorige sectie te zien is, omvat het koppelen van LLM’s en KG’s veel stappen, van het tokenizen van de gebruikersvraag en het genereren van de relevante grafquery tot het ophalen van de informatie uit de KG en het genereren van tekst daaruit.
Dit kan leiden tot inefficiënties en vertraging tussen vraag en antwoord. Optimalisatie-methoden, zoals hieronder uitgelegd, helpen de latency te minimaliseren.
LLM’s zijn geheugenintensief en hebben vaak dure hardware nodig. Het helpt om AI-modellen te verkleinen met technieken zoals LLM-distillatie en kwantisatie:
Je moet ervoor zorgen dat het gekozen taalmodel goed presteert bij het soort vragen dat het moet afhandelen.
Tools zoals MLFlow helpen LLM-prestaties te evalueren bij verschillende taken. Net zoals de behoeften van gebruikers veranderen en evolueren, verandert ook de informatie in de kennisgraaf in de tijd. Daarom is het essentieel om de prestaties van het LLM periodiek na deployment opnieuw te evalueren. Mogelijk is het nodig het model te finetunen op een bijgewerkte dataset, een bijgewerkte modelversie te gebruiken of zelfs een nieuw model te deployen.
Het LLM haalt informatie uit de KG en zijn taal- en redeneervermogen uit de trainingsdataset.
Basismodellen zijn getraind op grote generieke datasets, meestal met tekst van het hele internet. Finetunen van het LLM op een domeinspecifieke dataset verbetert zijn redeneervermogen in dat domein en zorgt dat het zinnen met de juiste structuur en jargon kan bouwen. Wil je bijvoorbeeld een LLM gebruiken om medische vragen te beantwoorden met een medische KG, dan raad ik sterk aan het basis-LLM te finetunen op een dataset met medische teksten.
In dit artikel bespraken we de fundamentele principes van grote taalmodellen (LLM’s) en kennisgrafen (KG’s) en hoe ze elkaar aanvullen. We hebben ook enkele veelgebruikte tools geïntroduceerd om LLM’s en KG’s samen te gebruiken voor gebruikersgerichte toepassingen. Tot slot gaven we een illustratie op hoofdlijnen van hoe Neo4j en OpenAI samen met LangChain kunnen worden ingezet.
Na het begrijpen van deze basisconcepten kun je deze tools in de praktijk toepassen:

Leer meer over LLM’s met deze cursussen!
Cursus
Ontdek het volledige potentieel van LLM's met onze conceptuele cursus over LLM-toepassingen, trainingsmethoden, ethische overwegingen en het nieuwste onderzoek.
Cursus
Ontdek hoe je AI-gedreven applicaties bouwt met behulp van LLM's, prompts, ketens en agents in LangChain.
Oefen en volg je voortgang.
Ga verder met GoogleDoor verder te gaan, accepteer je ons Gebruiksvoorwaarden, onze Privacybeleid en dat je gegevens in de VS worden opgeslagen.
Grote taalmodellen (LLM’s) zijn enorm nuttig gebleken in allerlei toepassingen, van contentcreatie tot vraag-en-antwoordsystemen. Het attention-mechanisme helpt transformermodellen om goedlopende zinnen te schrijven en gesprekken te voeren.
Toch hebben LLM’s moeite met feitelijke informatie, en hallucinaties komen vaak voor. Kennisgrafen (KG’s) helpen informatie te ordenen en visueel weer te geven. LLM’s en KG’s combineren is een veelbelovende aanpak om veelvoorkomende LLM-problemen op te lossen en ze nuttiger te maken voor informatieterugwinning.
In dit artikel leg ik eerst de basisprincipes van KG’s en LLM’s uit en bespreek daarna hoe ze samenwerken. We behandelen ook praktische voorbeelden en de meest gebruikte tools om KG’s met LLM’s te gebruiken.
Wat zijn kennisgrafen?
Een kennisgraaf (KG) slaat een kennisbank op met behulp van grafgebaseerde datastructuren om de onderliggende informatie te representeren en te bewaren. De knopen in de graaf staan voor entiteiten, zoals objecten, plaatsen, personen, enzovoort. De randen representeren de relaties (zoals “is een klant”, “is geboren in”, enz.) tussen verschillende entiteiten.
KG’s worden ook wel semantische netwerken genoemd omdat ze informatie opslaan over hoe verschillende entiteiten met elkaar samenhangen.
Kenmerken van kennisgrafen:
Kennisgrafen bestaan al sinds de jaren 80. Ze werden echter pas echt bekend en breed gebruikt nadat de Google Knowledge Graph in 2012 populair werd. Enkele moderne voorbeelden van KG’s zijn:
Resource Description Framework (RDF)
In de context van grafdatabases is het ook handig het Resource Description Framework (RDF) te begrijpen.
RDF is een specificatie voor het representeren van gestructureerde grafdata op het web. Het stelt data voor in de vorm van triples. Een triple bestaat uit een subject (een bron op het web), een object (een andere bron) en een predicaat dat de relatie daartussen definieert.
RDF drukt subject, object en predicaat uit met URI’s. Deze gelinkte structuur vormt een gerichte gelabelde graaf. RDF vormt daarmee de basis van het semantische web. Het is nuttig om KG’s te bouwen die relaties tussen uiteenlopende bronnen op het web omvatten.
Wat zijn generatieve AI en grote taalmodellen (LLM’s)?
Generatieve AI (GenAI) verwijst naar softwaremodellen die nieuwe content kunnen creëren (genereren) op basis van prompts van de gebruiker. Verschillende soorten GenAI-systemen kunnen tekst, afbeeldingen, muziek, code en meer genereren. Transformers, diffusers en GAN’s zijn voorbeelden van gangbare GenAI-modellen.
Grote taalmodellen ((LLM’s) zijn doorgaans transformergebaseerde modellen die met deep learning-technieken zijn getraind op grote tekstdatasets. Ze kunnen tekstuele output genereren voor taken zoals zinsaanvulling, samenvatten, vertalen, nieuwe tekst genereren, enzovoort.