Khóa học
Các khái niệm về Large Language Models (LLMs)
2 giờ
113.4K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleGiờ hãy xem cách đồ thị tri thức có thể được dùng để nâng cao LLM.
LLM có khả năng tạo văn bản trôi chảy, nhưng chúng không tự đánh giá được tính chính xác về mặt sự kiện/tri thức. Phần lớn trường hợp, tập dữ liệu huấn luyện ban đầu không có thông tin (chẳng hạn một sổ tay hướng dẫn cụ thể) liên quan đến một tác vụ thực tế (như trả lời câu hỏi của người dùng về cách dùng một công cụ cụ thể).
Một LLM được truy cập thông tin theo ngữ cảnh và theo miền có thể dùng tri thức đó để xây dựng phản hồi có ý nghĩa và chính xác. KG cho phép LLM truy cập có lập trình đến thông tin phù hợp và có căn cứ, nhờ đó phản hồi tốt hơn với câu hỏi của người dùng.
Đồ thị tri thức giỏi trong việc tổ chức, lưu trữ và truy xuất thông tin theo ngữ nghĩa. Tuy nhiên, chúng chỉ có thể được truy cập qua các ngôn ngữ truy vấn chuyên biệt như SPARQL (một ngôn ngữ truy vấn cơ sở dữ liệu để thao tác và truy xuất dữ liệu lưu theo định dạng RDF).
Đầu ra của KG cũng ở dạng mã và người dùng cần đào tạo cụ thể để diễn giải. LLM lấp đầy khoảng trống này bằng cách chuyển yêu cầu ngôn ngữ tự nhiên của người dùng sang ngôn ngữ truy vấn và tạo văn bản dễ đọc từ đầu ra của KG. Nhờ đó, người dùng không chuyên có thể tương tác với KG.
Văn bản do LLM tạo phụ thuộc vào tập dữ liệu huấn luyện, vốn thường đã lỗi thời vào thời điểm LLM được đưa vào sản xuất. Liên tục huấn luyện lại LLM trên thông tin cập nhật tốn nhiều tài nguyên và do vậy không thực tế.
Tuy nhiên, KG, như bất kỳ cơ sở dữ liệu nào khác, có thể dễ dàng được cập nhật theo thời gian thực. Chỉ cần một lượng nhỏ chi phí tính toán để cập nhật các kết nối giữa các nút dựa trên thông tin mới. Vì vậy, bằng cách tích hợp với KG, LLM có thể truy cập thông tin được cập nhật theo thời gian thực và cung cấp phản hồi mới nhất.
Các bước dưới đây phác thảo quy trình ví dụ sử dụng chung KG và LLM để cung cấp phản hồi cập nhật cho câu hỏi của người dùng.
Hình dưới đây cho thấy sơ đồ phác họa các bước này:
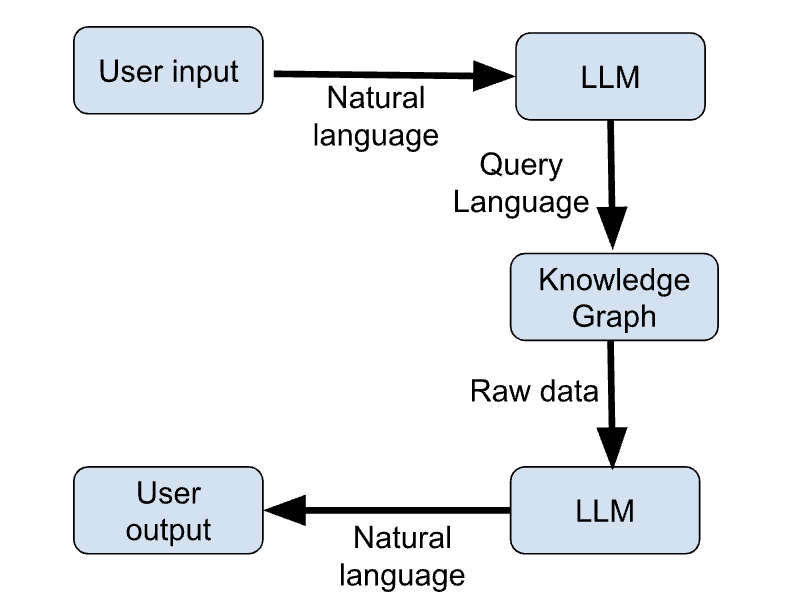
Hình 1: Quy trình LLM + KG (hình minh họa của tác giả)
Có nhiều trường hợp sử dụng nhờ tích hợp KG và GenAI. Hãy cùng điểm qua những trường hợp thú vị nhất.
KG cung cấp một kho tri thức có cấu trúc và được cập nhật mà chatbot có thể truy cập theo lập trình để lấy thông tin hiện thời và cung cấp phản hồi phù hợp hơn cho câu hỏi của người dùng.
KG bổ sung cho nền tảng tri thức mặc định của chatbot, vốn dựa trên tập dữ liệu huấn luyện. Chatbot học cách xây dựng câu từ tập huấn luyện và lấy thông tin đặc thù ứng dụng từ KG. Nhờ đó, việc dùng KG cũng cho phép sử dụng cùng một kiến trúc chatbot cho các ứng dụng khác nhau mà không cần huấn luyện lại.
LLM đã được dùng làm động cơ gợi ý.
Ví dụ, một LLM có thể phân tích nội dung một bài viết và gợi ý các bài liên quan. LLM cũng được dùng để tạo hệ thống tương tác, nơi người dùng có thể “trò chuyện với” động cơ gợi ý.
KG có thể tổ chức và lưu trữ thông tin về hành vi người dùng, sở thích, tương tác, v.v. LLM có thể phân tích thông tin này và dùng để tạo phản hồi phù hợp. Nhờ đó, người dùng nhận được gợi ý cá nhân hóa dựa trên ưu tiên riêng của họ.
Trong các lĩnh vực dựa trên tri thức như y học, tài chính và pháp luật, LLM kết hợp với KG cải thiện khả năng truy cập thông tin.
Trong y học, chúng gợi ý chẩn đoán có thể dựa trên triệu chứng và tiền sử bệnh nhân. Trong tài chính, chúng hỗ trợ nhà phân tích bằng cách giúp truy cập thông tin liên quan từ các báo cáo tài chính dễ dàng hơn. Trong pháp luật, chúng hỗ trợ luật sư bằng cách truy xuất các án lệ, phán quyết liên quan và cung cấp tóm tắt các tài liệu pháp lý lớn.
Kết hợp Mô hình Ngôn ngữ Lớn với Đồ thị Tri thức là yếu tố then chốt trong các ứng dụng thời gian thực như tổng hợp tin tức và phân tích thị trường chứng khoán.
Các LLM truyền thống không biết về những sự kiện chưa xảy ra trong thời gian huấn luyện. Vì thế, chúng không thể đưa ra phản hồi có ý nghĩa cho các câu hỏi dựa trên thời sự.
KG hiệu quả trong xử lý và tổ chức thông tin mới theo thời gian thực. Do đó, chúng cung cấp hậu trường tin học cho LLM để xử lý các ứng dụng dựa trên thời sự (tổng hợp tin) và môi trường thay đổi nhanh (ví dụ thị trường chứng khoán).
Các phần trước đã bàn về nguyên lý cơ bản của LLM và KG. Phần này giới thiệu các công cụ và thư viện dùng để tích hợp KG và LLM.
KG thường được triển khai bằng các cơ sở dữ liệu đồ thị như:
Một cơ sở dữ liệu đồ thị chuyên dụng (chỉ làm việc với đồ thị). Neo4j sử dụng Cypher, một ngôn ngữ truy vấn đồ thị khai báo, để chèn và truy xuất thông tin. Cypher có phong cách tương tự SQL, giúp nhà phát triển dễ học hơn.
Neo4j quản lý hiệu quả dữ liệu phức tạp có nhiều liên kết vì động cơ lưu trữ dữ liệu nền của nó được xây dựng từ đầu để phù hợp với các trường hợp sử dụng cơ sở dữ liệu đồ thị. Đây là lựa chọn phổ biến vì nó kết nối được với các nguồn dữ liệu bên ngoài như Apache Kafka và dễ mở rộng theo chiều ngang.
ArangoDB là cơ sở dữ liệu đồ thị đa mô hình. Ngoài đồ thị, nó còn hỗ trợ tài liệu JSON và kho khóa-giá trị. Điều này cho phép người dùng bổ sung đồ thị bằng những thông tin khó chuyển đổi sang dạng đồ thị.
Nhờ tính linh hoạt này, nó thường được ưa chuộng cho các ứng dụng doanh nghiệp xử lý nhiều loại dữ liệu. Nó dùng Arango Query Language (AQL) để làm việc xuyên suốt các kiểu dữ liệu. Bên dưới, ArangoDB sử dụng RocksDB làm động cơ lưu trữ dữ liệu.
Neptune của Amazon hỗ trợ mô hình đồ thị thuộc tính và RDF (Resource Description Framework). Nó sử dụng các ngôn ngữ truy vấn SPARQL và Gremlin. Nó tích hợp liền mạch vào hạ tầng AWS để vận hành như một cơ sở dữ liệu đồ thị được quản lý hoàn toàn, trở thành lựa chọn phổ biến để tích hợp với hạ tầng hiện có cho ứng dụng doanh nghiệp.
LLM và cơ sở dữ liệu đồ thị bổ trợ cho nhau nhưng nói chung không thể giao tiếp trực tiếp. Ở các đoạn sau, chúng tôi thảo luận các thư viện và khung tích hợp dùng để dẫn dữ liệu từ KG vào LLM và ngược lại.
RDFlib là gói Python mã nguồn mở để làm việc với dữ liệu RDF. Nó có các hàm thao tác và truy vấn đồ thị RDF. Điều này tạo thuận lợi cho việc tích hợp với đồ thị tri thức. Nó cho phép lưu dữ liệu RDF trong bộ nhớ, trên đĩa, hoặc từ xa qua các đầu mút SPARQL. Một đầu mút SPARQL, tương tự đầu mút API, có thể nhận và xử lý truy vấn SPARQL từ xa.
RDFlib làm việc với cấu trúc dữ liệu dạng đồ thị gồm các bộ ba chủ ngữ–vị ngữ–tân ngữ. Mỗi thành phần của bộ ba là một URI hoặc giá trị literal. Nó có các hàm để phân tích và tuần tự hóa bộ ba, XML và các kiểu dữ liệu khác như JSON-LD.
PyTorch Geometric (PyG) là một thư viện dựa trên PyTorch được thiết kế để tạo và huấn luyện Mạng Nơ-ron Đồ thị (GNN). GNN là kiến trúc mạng nơ-ron vận hành trên đồ thị và có thể nhận cấu trúc dữ liệu đồ thị làm đầu vào. PyG có các hàm áp dụng kỹ thuật học sâu cho đồ thị.
PyG đi kèm nhiều kiến trúc GNN dựng sẵn có thể triển khai trực tiếp hoặc mở rộng thêm qua API truyền thông điệp (message passing).
PyG được cho là phù hợp cho các ứng dụng quy mô lớn với hàng triệu nút trên nhiều loại nút và cạnh khác nhau. Tiểu lĩnh vực này còn được gọi là học sâu hình học.
Các mạng nơ-ron truyền thống giỏi mã hóa các quan hệ tuyến tính, nhưng dữ liệu thế giới thực có xu hướng phức tạp và đa chiều. Đồ thị thể hiện tốt hơn các kết nối bậc cao nơi bất kỳ nút nào cũng có thể liên quan đến bất kỳ nút nào khác. Điều này khiến đồ thị phù hợp hơn để lưu trữ các mối quan hệ phức tạp của thế giới thực.
LangChain ra mắt năm 2022 như một khung tích hợp mô hình ngôn ngữ. Nó hỗ trợ xây dựng ứng dụng người dùng bằng cách xâu chuỗi LLM với các công cụ liên quan khác, như trình bao bọc API, script shell, trình thu thập web, trình đọc PDF, Google Docs, cơ sở dữ liệu quan hệ, cơ sở dữ liệu vector và cơ sở dữ liệu đồ thị (bao gồm KG). Do đó, nó thường được dùng để tạo các ứng dụng liên quan đến LLM.
OpenAI API loại bỏ sự phức tạp khi xây dựng pipeline bằng các công cụ như PyG. OpenAI API có thể nhận truy vấn ngôn ngữ tự nhiên của người dùng, hiểu nó và trả về một truy vấn có cấu trúc trong một ngôn ngữ lập trình (ví dụ SPARQL). Truy vấn này được đưa vào KG, nơi trả về dữ liệu liên quan. Dữ liệu này được gửi lại cho OpenAI API cùng với ngữ cảnh của truy vấn gốc. LLM của OpenAI tạo phản hồi ngôn ngữ tự nhiên dựa trên dữ liệu thu từ KG.
OpenAI API cho phép bạn chọn từ nhiều LLM khác nhau, tùy thuộc vào tác vụ và ngân sách. Nhờ vậy, bạn không cần triển khai LLM hoặc các pipeline dữ liệu để giao tiếp với KG.
Phần này cung cấp minh họa cấp cao về một pipeline tích hợp bằng giả mã.
Chúng tôi dùng Neo4j, LangChain và OpenAI API để mô tả các bước tạo chatbot dựa trên RAG. LLM tạo phản hồi dựa trên thông tin lưu trong KG.
## Import relevant packages

# Handling chat prompts
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.prompts.prompt import PromptTemplate
from langchain_openai import ChatOpenAI

# Implementing the Runnable protocol for chaining components
from langchain_core.runnables import (
    RunnableBranch,
    RunnableLambda,
    RunnableParallel,
    RunnablePassthrough,

# Processing text inputs in the chat
from langchain_core.messages import AIMessage, HumanMessage
from langchain_core.output_parsers import StrOutputParser

# Working with Neo4j graphs
from neo4j import GraphDatabase
from langchain_community.graphs import Neo4jGraph
from langchain_experimental.graph_transformers import LLMGraphTransformer

# Vector embeddings for the LLM
from langchain_openai import OpenAIEmbeddings
from langchain_community.vectorstores import Neo4jVector

# Load data from a source like Wiki, PDF documents, etc.
from langchain.document_loaders import WikipediaLoader

# Create a Neo4jGraph to store the KG
graph = Neo4jGraph()

# Load the document(s) based on which to build the KG. In this snippet, we use Wiki. In practice, this is a business-specific document
raw_documents = WikipediaLoader(...).load()

# Split the document into tokens
documents = create_tokens(raw_documents)

# Instantiate the LLM
llm = ChatOpenAI(model_name="...", …)
llm_transformer = LLMGraphTransformer(llm=llm)

# Use the LLM to convert the tokenized documents into graph entities
graph_docs = llm_transformer.convert_to_graph_documents(documents)

# Add the graph entities to the Neo4j graph
graph.add_graph_documents(graph_docs, …)

# Create a retriever to run on the graph
graph.query(
    "CREATE FULLTEXT INDEX entity IF NOT EXISTS FOR (e:__Entity__) ON EACH [e.id]")

# Create a class to extract entities from the text corresponding to nodes from the graph
class Entities(BaseModel):
    names: List[str] = Field(
        ...,
        description="All the person, organization, or business entities that appear in the text",
    )

# Create a prompt template
prompt = ChatPromptTemplate.from_messages(
    [
        (
            "system",
            "You are extracting organization and person entities from the text.",
        ),
        (
            "human",
            "Use the given format to extract information from the following "
            "input: {question}",
        ),
    ]
)

# Create a chain by piping the prompt to the LLM with the Entities class.
# This chain identifies entities in a given prompt string
entity_chain = prompt | llm.with_structured_output(Entities)


# Create a structured retriever to extract the entities in the query. Given a text query, it retrieves all the relevant nodes in the neighborhood of the entities in that query.

def structured_retriever(question: str) -> str:
    result = ""
    entities = entity_chain.invoke({"question": question})
    for entity in entities.names:
        response = graph.query(
        # CYPHER QUERY TEMPLATE,
        {"query": generate_full_text_query(entity)})
        result += el['output'] for el in response
    return result

# Chain together the different components
chain = (
    RunnableParallel(
        {
            "context": _search_query | retriever,
            "question": RunnablePassthrough(),
        }
    )
    | prompt
    | llm
    | StrOutputParser()
)

# Invoke the chain
chain.invoke({"question": "The user’s question goes here"})KG mở rộng năng lực của LLM và khiến chúng phù hợp với các trường hợp sử dụng thực tế. Để đạt hiệu năng tốt nhất, tôi khuyến nghị các thực tiễn sau.
KG chứa kho thông tin dựa trên đó LLM xây dựng phản hồi. Do vậy, cần liên tục cập nhật cơ sở dữ liệu đồ thị với thông tin mới nhất. Một KG lỗi thời sẽ dẫn đến LLM đưa ra câu trả lời lỗi thời.
LLM và KG là phần mềm phức tạp với yêu cầu tính toán nặng. Như đã nêu ở phần trước, xâu chuỗi LLM và KG gồm nhiều bước, từ token hóa câu hỏi của người dùng, tạo truy vấn đồ thị phù hợp đến truy xuất thông tin từ KG và tạo văn bản từ đó.
Điều này có thể dẫn đến kém hiệu quả và độ trễ giữa truy vấn và phản hồi. Các phương pháp tối ưu hóa, như giải thích dưới đây, giúp giảm thiểu độ trễ.
LLM là các mô hình tốn bộ nhớ và thường cần phần cứng đắt tiền để chạy. Việc giảm kích thước mô hình AI bằng các kỹ thuật như Distillation và Quantization cho LLM là hữu ích:
Bạn nên đảm bảo mô hình ngôn ngữ đã chọn hoạt động tốt với loại truy vấn nó được kỳ vọng xử lý.
Các công cụ như MLFlow giúp đánh giá hiệu năng LLM trên nhiều tác vụ. Cũng như nhu cầu của người dùng thay đổi và phát triển, thông tin lưu trong đồ thị tri thức cũng thay đổi theo thời gian. Do đó, điều cốt yếu là định kỳ đánh giá lại hiệu năng của LLM sau khi triển khai. Có thể cần tinh chỉnh mô hình trên tập dữ liệu cập nhật, dùng phiên bản mô hình mới hơn, hoặc thậm chí triển khai một mô hình mới.
LLM lấy thông tin từ KG và năng lực ngôn ngữ, lập luận từ tập dữ liệu huấn luyện của nó.
Các LLM nền tảng được huấn luyện trên tập dữ liệu tổng quát lớn, thường lấy văn bản từ khắp internet. Tinh chỉnh LLM trên tập dữ liệu theo miền giúp nâng cao khả năng lập luận trong miền đó và cho phép nó xây dựng câu với cấu trúc, thuật ngữ phù hợp. Ví dụ, để dùng LLM trả lời câu hỏi y khoa bằng một KG y khoa, tôi đặc biệt khuyến nghị tinh chỉnh LLM nền trên một tập văn bản y khoa.
Trong bài viết này, chúng ta đã thảo luận các nguyên lý cơ bản của Mô hình Ngôn ngữ Lớn (LLM) và Đồ thị Tri thức (KG) và cách chúng bổ trợ cho nhau. Chúng ta cũng giới thiệu một số công cụ thường dùng để sử dụng LLM và KG cùng nhau nhằm xây dựng ứng dụng hướng người dùng. Cuối cùng, chúng ta minh họa ở cấp cao cách dùng kết hợp Neo4j và OpenAI thông qua LangChain.
Sau khi hiểu các khái niệm nền tảng này, bạn có thể áp dụng các công cụ trong thực tế:
Tìm hiểu thêm về LLM với các khóa học này!
Khóa học
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
